之前写过召回率怎么测:建 ground truth、按 query 类型分层、算 recall@k。那套东西测的是「找对材料没有」。但线上跑过 RAG 的都知道,材料找对了,答案照样能写砸------幻觉、答非所问、漏掉关键限制条件,全发生在生成这一端。
答案质量也得持续测,问题是人工全检做不起:一天几百条回答,标注一条要两分钟。自然的解法是让模型评模型,LLM-as-Judge。但直接上手就用的,大多踩在最后一步:judge 自己评得准不准,没人测过。
这篇把完整流程复盘一遍:最小实现、评分维度设计,以及最关键的------用人工标注校准 judge,一致率从 68% 提到 91% 的过程。
一、先想清楚:评估系统为谁服务
两个用途,设计不一样:
- 上线前回归:改了 prompt、换了模型、调了检索参数,拿固定用例集跑一遍,防止越改越差。要求稳定、可复现。
- 上线后抽检:每天从真实回答里抽样跑 judge,盯质量趋势。要求便宜、快。
我们项目的做法:80 条回归用例(从历史 badcase 和高频 query 攒的),上线前必跑;线上每天抽 30 条真实回答过 judge。两个场景共用同一套 judge 逻辑,只是输入来源不同。
二、最小实现:输入四元组,输出结构化结果
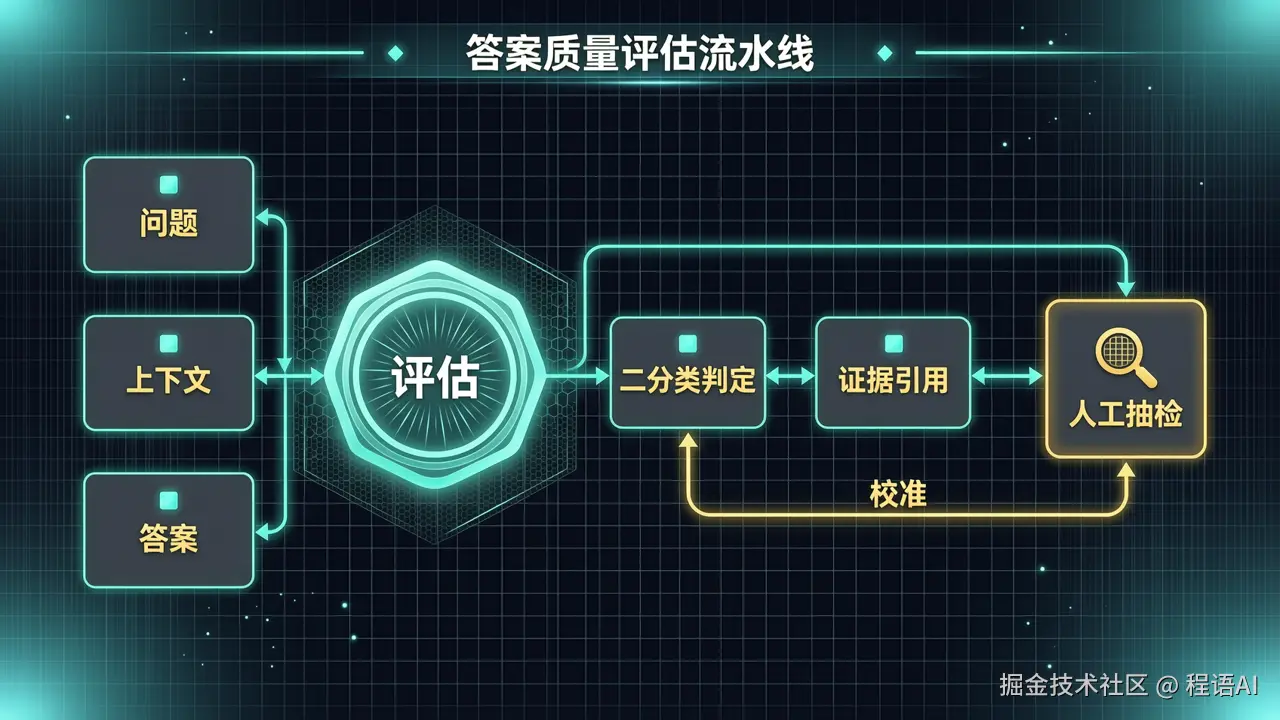
每条评估的输入是四元组:问题、检索上下文、答案、(可选)参考答案。judge 的输出强制结构化,别让它自由发挥:
python
JUDGE_PROMPT = """你在评估一个知识库问答系统的答案质量。
只依据给定的上下文判断,不要使用你自己的知识。

问题:{question}
上下文:{context}
答案:{answer}

按以下维度评估:
1. faithfulness:答案中的每个关键事实是否都能在上下文中找到依据?
   逐条列出答案的关键断言,逐条判断有无依据,并引用上下文原文作为证据。
2. relevance:答案是否真正回应了问题?有没有答非所问或漏掉关键限制条件?

输出 JSON:
{{
  "faithful": true/false,
  "unsupported_claims": ["没有依据的断言"],
  "evidence": ["对应的上下文原文片段"],
  "relevant": true/false,
  "reason": "一句话理由"
}}
"""
三个设计要点:
- 「只依据上下文」写进 prompt 第一行。judge 最大的幻觉来源是它自己的世界知识------它觉得答案「说得对」,就放过无依据的断言。
- 要求引用证据。让 judge 输出依据原文片段,既能逼它真的去读上下文,也让人工复核时十秒能看完一条。
- 输出用 JSON Schema 约束,解析失败就重试。评估流水线不该因为一次格式抽风而中断。
三、评分维度:拆开,而且尽量二分类
第一版我让 judge 打 1-5 分,结果分布根本没法用:换了个 judge 模型,均分从 3.8 变到 4.2,但人工看答案质量明明没变。分数尺度的漂移比答案质量的漂移还大。
后来改成两个独立的二分类判断:
- faithful(忠实度):答案的每个关键断言是否有上下文依据。这条防幻觉。
- relevant(相关性):是否真正回应了问题,关键限制条件有没有丢。这条防答非所问。
二分类的好处是判断标准可以写得非常具体,judge 之间、人和 judge 之间都容易对齐。「这条答案 3 分还是 4 分」永远吵不出结果,「这个断言在上下文里有没有依据」是可以核对的。
四、关键一步:拿人工标注校准 judge
judge 上线前,先回答一个问题:它评得准不准?
做法:抽 100 条历史回答,人工逐条标注 faithful / relevant(就是前面那两个二分类),作为金标准,然后跑 judge 算一致率。
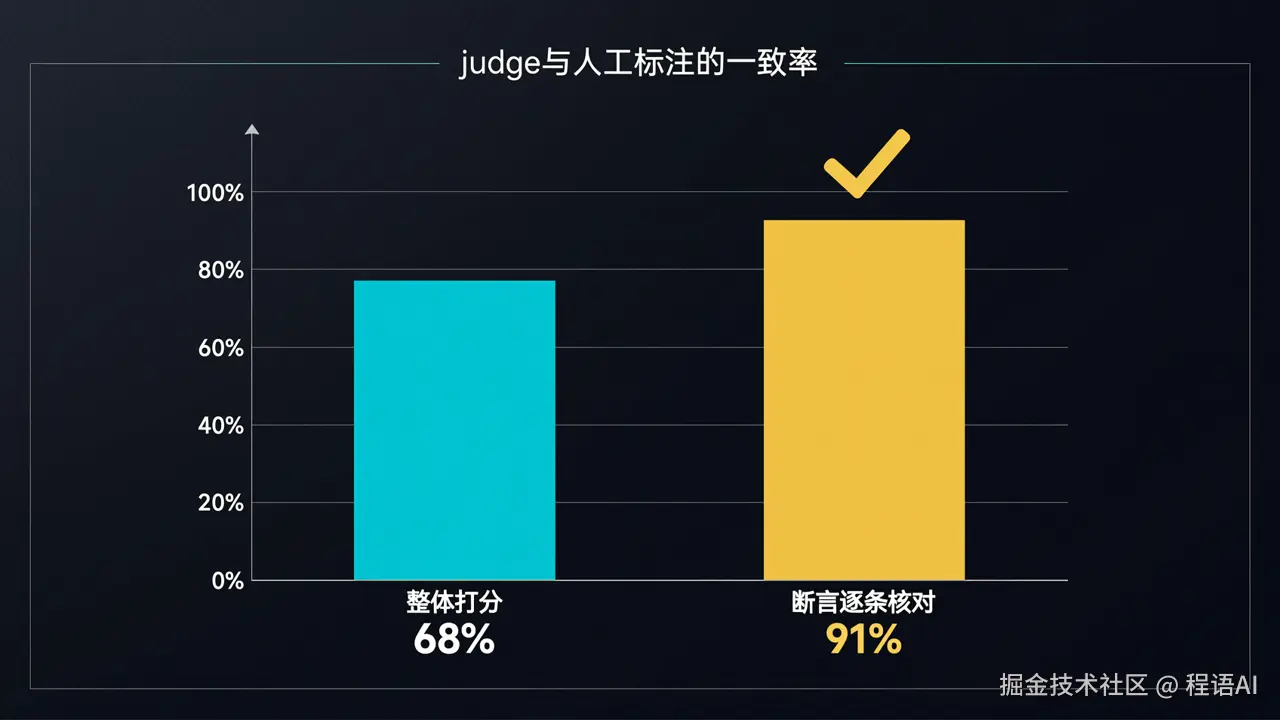
第一版(1-5 打分再映射成合格/不合格):一致率 68%。 分歧高度集中:judge 把含幻觉断言的答案打到 3 分,映射规则算「合格」,人工全判不合格。judge 的打分习惯是「部分正确就部分给分」,但业务上一个关键事实错误的答案就是不合格,没有中间态。
第二版(先拆断言再逐条核对):一致率 91%。 改的就是第二节 prompt 里的那个动作------不让 judge 对答案整体下判断,而是先把答案拆成原子断言,逐条找依据,最后「有一条无依据即 faithful=false」。判断粒度变细之后,judge 和人的分歧大幅收窄。
剩下 9% 的分歧也值得看:主要是上下文本身表述含糊的案例,人工之间都有分歧,这种该回归标注集本身,不必硬凑 100%。
五、judge 的已知偏差与防御
校准完也别全信,judge 有几个系统性偏差要在工程上防:
- 偏爱长答案。答案越长 judge 越宽容。防御:faithful 按断言逐条核对,长度不影响单条断言的判断;relevant 的判断标准里写明「冗余不扣分也不加分」。
- 偏爱同门模型。用 A 模型生成、A 模型评审,分数偏高。防御:judge 用与生成模型不同家的模型,重要回归可双 judge 交叉。
- judge 也会幻觉。它会引用一段上下文里根本不存在的话当「证据」。防御:evidence 字段程序化校验------输出的引用片段必须在上下文中能精确匹配到,匹配不上这条评估作废重跑。一行字符串包含判断就能实现,性价比极高。
六、落地:成本与节奏
这套东西的成本低得可以忽略:一条评估大约几千 token,80 条回归用例跑一轮几块钱,每天 30 条线上抽检一个月也就一杯奶茶钱。真正的成本在前期:攒 80 条有代表性的回归用例、标 100 条校准样本,大概各一天。
节奏建议:
- 先攒回归用例集,没有它,每次改 prompt 都是在盲改;
- judge 二分类 + 断言拆解 + 证据引用,一次写对;
- 用 100 条人工标注算一致率,低于 85% 先改 judge,别急着信它的结论;
- 上线后每日抽检看趋势,分数异常先查 judge 是否漂移,再查业务。
一句话总结:LLM-as-Judge 的价值在「让质量评估可每日执行」,但它的判断本身也是一个需要被评估的模型输出。不校准的 judge,等于给系统请了个不称职的质检员,还发了免检章。
原文首发于公众号「程语AI」。我是成风,十几年研发,现一人公司做 AI 应用工程化,欢迎评论区交流。