本文是「Android 应用性能优化」系列第三篇。前两篇解决的是内容出现之后 的流畅度(XML 渲染层级与 Overdraw、Compose Recomposition 重组)。这一篇回到更早的时刻:用户点下图标,到第一帧及完整内容出现之前。
读完本文你将掌握:看懂冷启动全链路与源码执行顺序 → 用三级工具链定位时间花在哪一段 → 四刀优化(SDK 初始化分级与 DAG 演进、ContentProvider 治理、主线程重活移出与 TTID/TTFD 权衡、Baseline Profile 与 Startup Profile)→ 用 Macrobenchmark 在双真机上做可重复的量化验收。
环境说明 :文中所有耗时数据均来自配套开源演示工程 StartupDemo 在两台跨代真机------小米 6 (骁龙 835,Android 9 / API 28)与小米 13 Pro(骁龙 8 Gen 2,Android 16 / API 36)上的非 debuggable Release/Benchmark 构建实测(每步 10 次冷启动取中位数),详见文末「附:演示工程与测量环境」。
一、问题提出:用户点开 App,要转好一会儿才出内容
产品又来了。
"启动太慢了,点开图标之后要等一会儿才有内容,特别是存量中低端机型的用户在应用商店评论里提了好几次。"
先别猜原因,把它量出来。
第一步:确保是冷启动。 先杀掉进程,再启动并等待首帧完成:
bash
adb shell am force-stop com.example.startupdemo
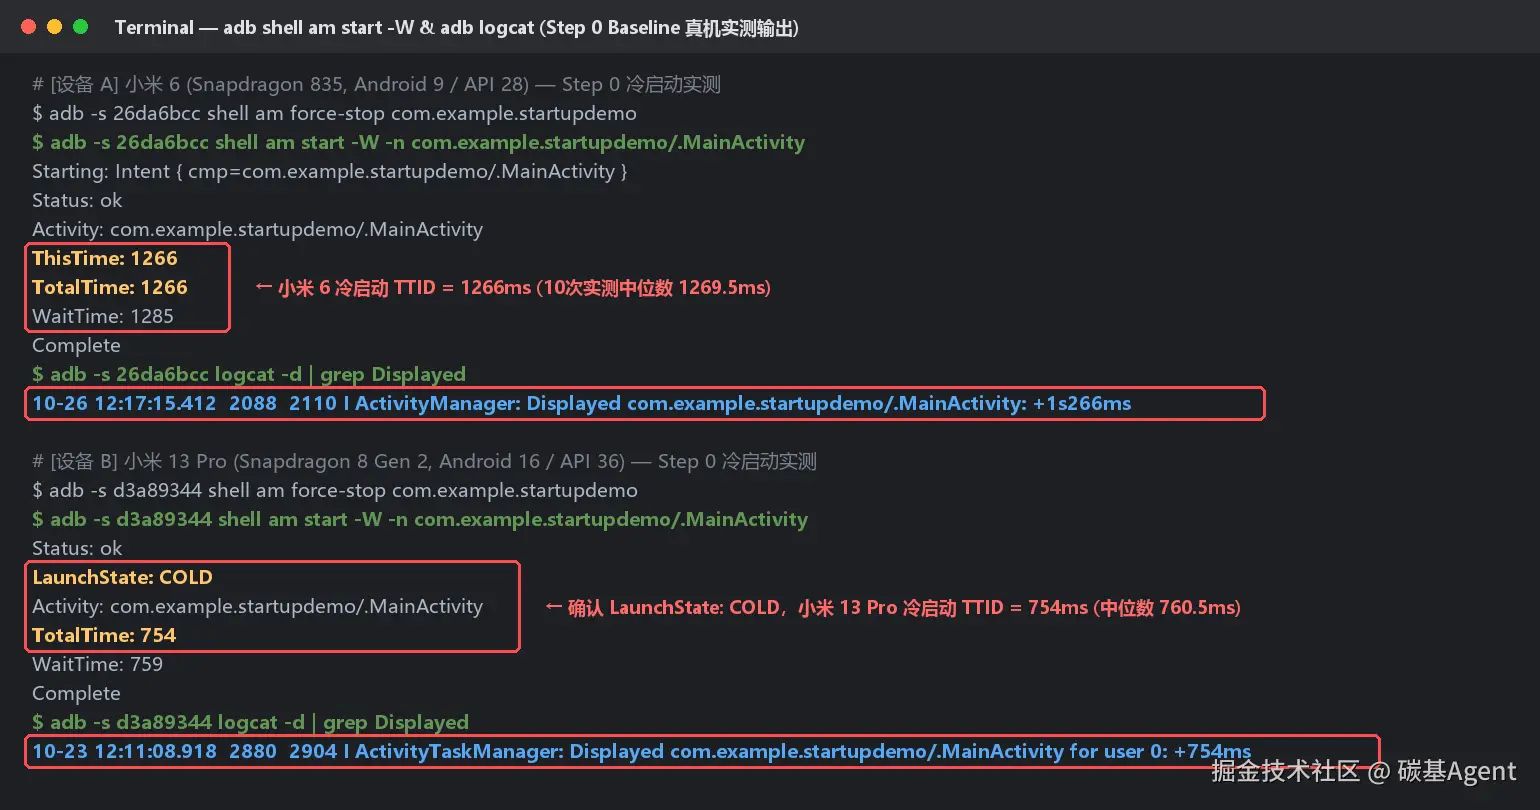
adb shell am start -W -n com.example.startupdemo/.MainActivity在我们的两台测试真机上,未优化基线版本(step0-baseline)实测输出如下:
text
# 设备 A:小米 6(骁龙 835,Android 9 / API 28)
Starting: Intent { cmp=com.example.startupdemo/.MainActivity }
Status: ok
Activity: com.example.startupdemo/.MainActivity
ThisTime: 1266
TotalTime: 1266
WaitTime: 1285
Complete

# 设备 B:小米 13 Pro(骁龙 8 Gen 2,Android 16 / API 36)
Starting: Intent { cmp=com.example.startupdemo/.MainActivity }
Status: ok
LaunchState: COLD
Activity: com.example.startupdemo/.MainActivity
TotalTime: 754
WaitTime: 759
Complete
注:10 次冷启动实测中,小米 6 的
TotalTime中位数为 1269.5ms (WaitTime中位数 1288.5ms ),小米 13 Pro 的TotalTime中位数为 760.5ms (WaitTime中位数 766.0ms )。Android 10+ 会在输出中直接标明LaunchState: COLD。
第二步:看 Logcat 里的 Displayed 日志。 系统在第一帧绘制并提交完成后会打印一行:
text
# 小米 6 (Android 9,tag 为 ActivityManager)
10-26 12:17:15.412  2088  2110 I ActivityManager: Displayed com.example.startupdemo/.MainActivity: +1s266ms

# 小米 13 Pro (Android 16,tag 为 ActivityTaskManager)
10-23 12:11:08.918  2880  2904 I ActivityTaskManager: Displayed com.example.startupdemo/.MainActivity for user 0: +754ms
(日志的 tag 随系统版本不同,Android 9 及以下为 ActivityManager,Android 10 及以上为 ActivityTaskManager,直接 adb logcat -d | grep Displayed 即可。)
这个数字到底算快还是慢?Android 官方文档(App startup time)有一条明确的红线:Android vitals 把冷启动 ≥ 5 秒 视为过长(温启动 ≥ 2 秒,热启动 ≥ 1.5 秒)。而 Vitals 默认统计的核心指标,是 TTID(Time To Initial Display,首帧显示时间) 。在体感层面,一旦冷启动超过 1 秒,用户就能明显感知到过渡等待。
知道了总时间,下一个问题才是关键:这 1269.5ms(旗舰机 760.5ms)到底花在了哪里?
很多人的第一反应是"首页布局太重"或者"网络请求太慢"。但在官方对冷启动的划分里,首页的布局和渲染只是最后一段,前面还有进程创建、ContentProvider 初始化、Application 创建、Activity 创建。要下刀优化,先得把这条全链路拆明白。
二、相关知识点讲解
2.1 冷启动全链路:时间被切成了哪几段
冷启动(Cold Start)指的是应用"从零开始"启动:在这之前,系统里还没有这个应用的进程。官方文档把它拆成以下五个阶段:
text
① 加载并启动应用(系统 SystemServer / Launcher)
   └─ 解析 Intent、检查权限、显示 Starting Window(SplashScreen)
        ↓
② 创建应用进程(系统 Zygote fork)
   └─ fork 新进程、初始化 ART 虚拟机、调用 ActivityThread.main()
        ↓
③ 创建并绑定 Application 对象(ActivityThread.handleBindApplication)
   ├─ Application.attachBaseContext()
   ├─ installContentProviders() → 所有 ContentProvider.onCreate()  ← 先于 Application.onCreate()!
   └─ Instrumentation.callApplicationOnCreate() → Application.onCreate()
        ↓
④ 创建并启动主 Activity(ActivityThread.performLaunchActivity)
   └─ Activity.onCreate() → onStart() → onResume()
        ↓
⑤ 首次绘制(ViewRootImpl.performTraversals / Choreographer#doFrame)
   └─ measure / layout / draw + RenderThread 渲染提交(前两篇的主题)
        ↓
首帧出现 = TTID (Displayed)这五段里,①② 是系统在做,应用层基本无法直接干预;③④⑤ 全是你的代码(或你引入的第三方库代码),每一段都是优化的刀口。
请特别注意阶段 ③ 里一个极具隐蔽性的源码细节:翻开 AOSP ActivityThread.handleBindApplication() 的源码可以看到,系统在调用 app.attachBaseContext() 之后,会先调用 installContentProviders() 逐个执行所有已注册 ContentProvider 的 onCreate(),最后才调用 mInstrumentation.callApplicationOnCreate(app) 执行 Application.onCreate()------而且它们全部串行运行在主线程上。后面我们会亲眼看到这个机制在真实项目里的杀伤力。
2.2 两个指标:TTID 与 TTFD
| 指标 | 全称与含义 | 如何采集 | 局限性 |
|---|---|---|---|
| TTID | Time To Initial Display(首帧显示时间):系统完成第一帧绘制并上屏的时间 | 系统自动计算,Logcat 的 Displayed 日志与 Macrobenchmark 的 timeToInitialDisplayMs 即是 |
只反映"第一帧画出来有多快",哪怕第一帧是纯白屏或空壳骨架,TTID 也会算作完成 |
| TTFD | Time To Full Display(完全绘制时间):应用异步数据加载完成、用户真正可以开始交互的时间 | 需要开发者在核心内容渲染就绪时主动调用 Activity.reportFullyDrawn()(Compose 中使用 ReportDrawnWhen { ... }),系统打印 Fully drawn 日志 |
依赖正确的上报时机;若未上报,Macrobenchmark 不会输出 timeToFullDisplayMs |
两个指标缺一不可:只盯 TTID,很容易做出"首帧极快,但用户面对空白骨架干等半天"的假优化。 后面 Step 3 会结合双真机实测数据专门剖析这两个指标的博弈。
2.3 诊断工具链:先让时间"可见"
冷启动优化最忌讳"盲人摸象"。一套标准的工程诊断工具链由浅入深分为三层:
第一层:am start -W 与 Displayed / Fully drawn 日志。 最快、最粗:几秒钟就能告诉你一次启动总共花了多久,适合快速冒烟,但它是个黑盒------不告诉你时间花在哪一段。
第二层:Perfetto 系统跟踪 + 自定义 Trace 打点。 这是定位"时间花在哪一段"的主力显微镜。用 android.os.Trace 给关键初始化代码包一层 traceSection:
kotlin
import android.os.Trace

inline fun <T> traceSection(name: String, block: () -> T): T {
    Trace.beginSection(name)
    try {
        return block()
    } finally {
        Trace.endSection()
    }
}

// 在初始化代码中使用
override fun onCreate() {
    super.onCreate()
    traceSection("init.crash") { CrashReporter.init(this) }
}
录制 trace 时,应用不能直接用 Debug 包(Debug 包关闭了编译器优化且带有调试连接开销,启动耗时失真严重),建议用开启 R8 的 Release 构建 ,并在 AndroidManifest.xml 的 <application> 下加上:
xml
<profileable android:shell="true" />然后用 perfetto 命令或 Android Studio Profiler 抓取启动 trace,拖入 Perfetto UI (ui.perfetto.dev),就能在主线程时间线上看清每一个 traceSection 的精确起止与耗时。
第三层:Jetpack Macrobenchmark。 前两个工具告诉你"某一次启动"发生了什么;但由于冷启动受系统 I/O 缓存、CPU 频率调度影响会有波动,单次数据不能作为验收依据。Macrobenchmark 负责回答「多次冷启动的统计分布是什么」:
kotlin
@get:Rule val rule = MacrobenchmarkRule()

@Test
fun coldStartup() = rule.measureRepeated(
    packageName = "com.example.startupdemo",
    metrics = listOf(StartupTimingMetric()),
    startupMode = StartupMode.COLD,
    iterations = 10,
    setupBlock = { pressHome() }
) {
    startActivityAndWait()
}
它会自动重复杀进程、冷启动 10 次以上,输出 timeToInitialDisplayMs 与 timeToFullDisplayMs 的最小值(min)、中位数(median)和最大值(max)。本文后续所有步骤的验收对比,全部采用 10 次冷启动的中位数。
2.4 冷启动变慢的三大元凶
元凶 ①:Application.onCreate() 里同步、串行初始化一堆 SDK
kotlin
class DemoApp : Application() {
    override fun onCreate() {
        super.onCreate()
        CrashReporter.init(this)     // 崩溃采集
        AnalyticsSdk.init(this)      // 统计分析
        PushSdk.init(this)           // 消息推送
        MapSdk.init(this)            // 地图组件
        AppDatabaseInitializer.initAndQuery(this) // 数据库
        HttpInitializer.init(this)   // 网络与图片库
        // ......业务每迭代一个版本、每接一个 SDK 就往里加一行
    }
}
这些初始化全部串行、全部霸占主线程、全部卡在第一帧之前。每个 SDK 负责人都会跟你说"我的初始化很快,只要几十毫秒",但十几个 SDK 叠在一起,就是几百毫秒甚至上秒的白屏。
元凶 ②:ContentProvider 在你看不见的地方"抢跑"
很多第三方 SDK(以及早期的 Jetpack 库)为了标榜"零配置接入,连 Application.onCreate() 都不用写一行代码",会在自己 AAR 的 AndroidManifest.xml 里偷偷注册一个 ContentProvider。借助 2.1 节讲过的机制,系统会在 Application.onCreate() 之前自动实例化这些 Provider 并调用它们的 onCreate()。
经过 Gradle 的 Manifest Merger 合并后,这些 Provider 全部进入了你的最终 APK。结果就是:你在自己的 DemoApp.kt 和 AndroidManifest.xml 里一行代码都没写,启动主线程上却已经跑了一串你毫不知情的初始化逻辑。
怎么把它们揪出来?在 Android Studio 里打开 app/src/main/AndroidManifest.xml,切换到底部的 Merged Manifest 标签页(或者直接查看构建产物 app/build/intermediates/merged_manifests/release/processReleaseManifest/AndroidManifest.xml),搜索 <provider>:
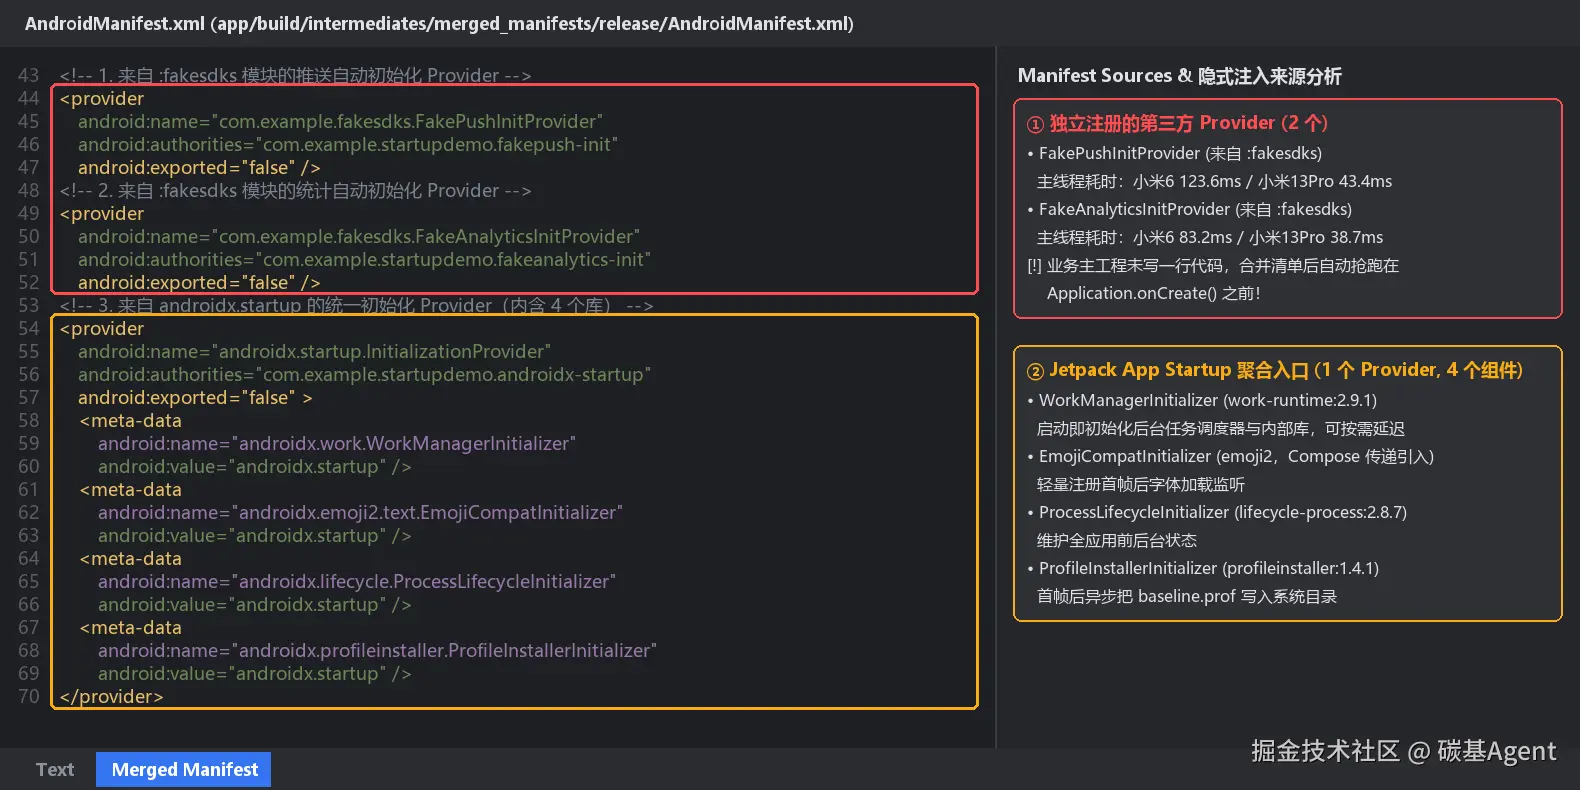
可以看到,在我们的演示工程中,虽然业务主模块的 AndroidManifest.xml 里一个 <provider> 都没写,合并后的清单里却赫然躺着 3 个 <provider>(涉及 6 个初始化组件) :两个来自第三方 SDK 模块(FakePushInitProvider、FakeAnalyticsInitProvider),还有一个是 Jetpack App Startup 的 InitializationProvider(内部又挂载了 WorkManager、EmojiCompat、ProcessLifecycle、ProfileInstaller 四个初始化器)。
元凶 ③:首个 Activity 在主线程上做 I/O 与解析重活
kotlin
override fun onCreate(savedInstanceState: Bundle?) {
    super.onCreate(savedInstanceState)
    // ❌ 主线程同步读取大文件 + 解析 500 条商品 JSON,完成前一个像素都画不出来
    val products = traceSection("activity.loadProducts") {
        ProductLoader.loadFromAssets(this)
    }
    setContent { ProductListScreen(products) }
}
文件读取、数据库同步查询、大 JSON 反序列化,一旦放在首屏 Activity.onCreate() 里同步执行,setContent 和后续的首帧绘制就只能干等。
2.5 Baseline Profile 与 Startup Profile:让首帧代码少走"解释执行"与缺页中断
即便你把不该在主线程做的事都挪走了,主线程在冷启动期间依然要执行成千上万个方法(尤其是 Jetpack Compose,它作为随 APK 分发的库,不像传统 Android View 那样预编译在系统镜像 boot.art 里)。
从 Android 7.0(API 24)引入混合编译机制开始,应用刚安装完首次启动时,DEX 字节码尚未经过 AOT(Ahead-Of-Time)编译,大量方法必须走解释执行(Interpreter)或即时编译(JIT),这构成了冷启动的另一笔隐形开销。
Baseline Profile(基准配置文件) 是随 APK 一起打包的一份"热点类与方法清单"(源码位于 src/main/baseline-prof.txt,AGP 构建时通过 CompileArtProfileTask 结合 R8 混淆映射表编译成二进制格式,存放在 APK 的 assets/dexopt/baseline.prof 中)。它的作用机制如下:
- 有 Google Play(或支持 Cloud/Baseline Profile 的应用商店)时 :应用在安装期间 ,系统直接读取
assets/dexopt/baseline.prof,以speed-profile模式把清单中的热点方法提前 AOT 编译成机器码,让用户的第一次启动就跳过解释执行。 - 国内应用市场 / 本地安装(无 Google Play)时有用吗?有用! 通过引入
androidx.profileinstaller:profileinstaller,ProfileInstallerInitializer会在应用首次启动第一帧绘制完成后,在后台将assets/dexopt/baseline.prof转码写入系统目录/data/misc/profiles/cur/0/<packageName>/primary.prof。这样无需等待用户反复使用很长时间去慢慢积累 JIT 热点,只要设备进入空闲+充电状态触发系统bg-dexopt-job(或测试时通过cmd package compile -m speed-profile触发),ART 就能立即按这份清单完成预编译。 - 配合 Startup Profile(启动配置文件) 优化 DEX 布局 :在 AGP 8.2+ 中,开启
includeInStartupProfile = true还会指导 R8 在打包期进行 DEX 布局优化(DEX Layout Optimizations) ------将启动关键路径上的类全部紧凑排列到主classes.dex头部,大幅减少冷启动类加载时的磁盘缺页中断(Page Fault)。
同时必须认清它的边界:Baseline Profile 优化的是"CPU 执行已有代码的速度",对线程阻塞、文件 I/O 等待或锁竞争帮不上忙。 因此它适合作为排空主线程重活之后的"最后一刀"。
三、具体实例应用展示:StartupDemo 四刀实战
案例场景:商品列表 App 的冷启动全链路优化
关于演示工程 :本文的所有实测数据来自配套开源工程 StartupDemo(仓库包含
step0-baseline至step4-baseline-profile五个累积式 Git Tag)。
- 真实组件 :工程中的 Room (真实 SQLite 建表与同步查询
init.db)、WorkManager (androidx.work调度器)、OkHttp + Coil (真实磁盘缓存与ImageLoader初始化init.http)、App Startup 、Lifecycle Process 、ProfileInstaller 均为官方真实库。- 模拟 SDK :推送(
PushSdk)、统计(AnalyticsSdk)、地图(MapSdk)、崩溃采集(CrashReporter)以及两个隐式注册的第三方 Provider(FakePushInitProvider、FakeAnalyticsInitProvider)独立封装在:fakesdks模块中。为了保证 100% 真实可测,模拟模块严禁使用Thread.sleep,全部采用真实的本地文件读写、JSON 序列化/反序列化与 SHA-256 摘要迭代计算 (所有工作量常数固定在SimConfig.kt中,五个阶段完全一致)。它们的耗时量级用于让启动瓶颈在 Perfetto 时间线上清晰可见,请不要把文中的具体毫秒数当作任何特定商业 SDK 的真实耗时。
Step 0:诊断现场,先看工具,再动代码
在动手改一行代码之前,我们先在 step0-baseline 版本上抓取 Perfetto trace 并运行 10 次冷启动基准测试。
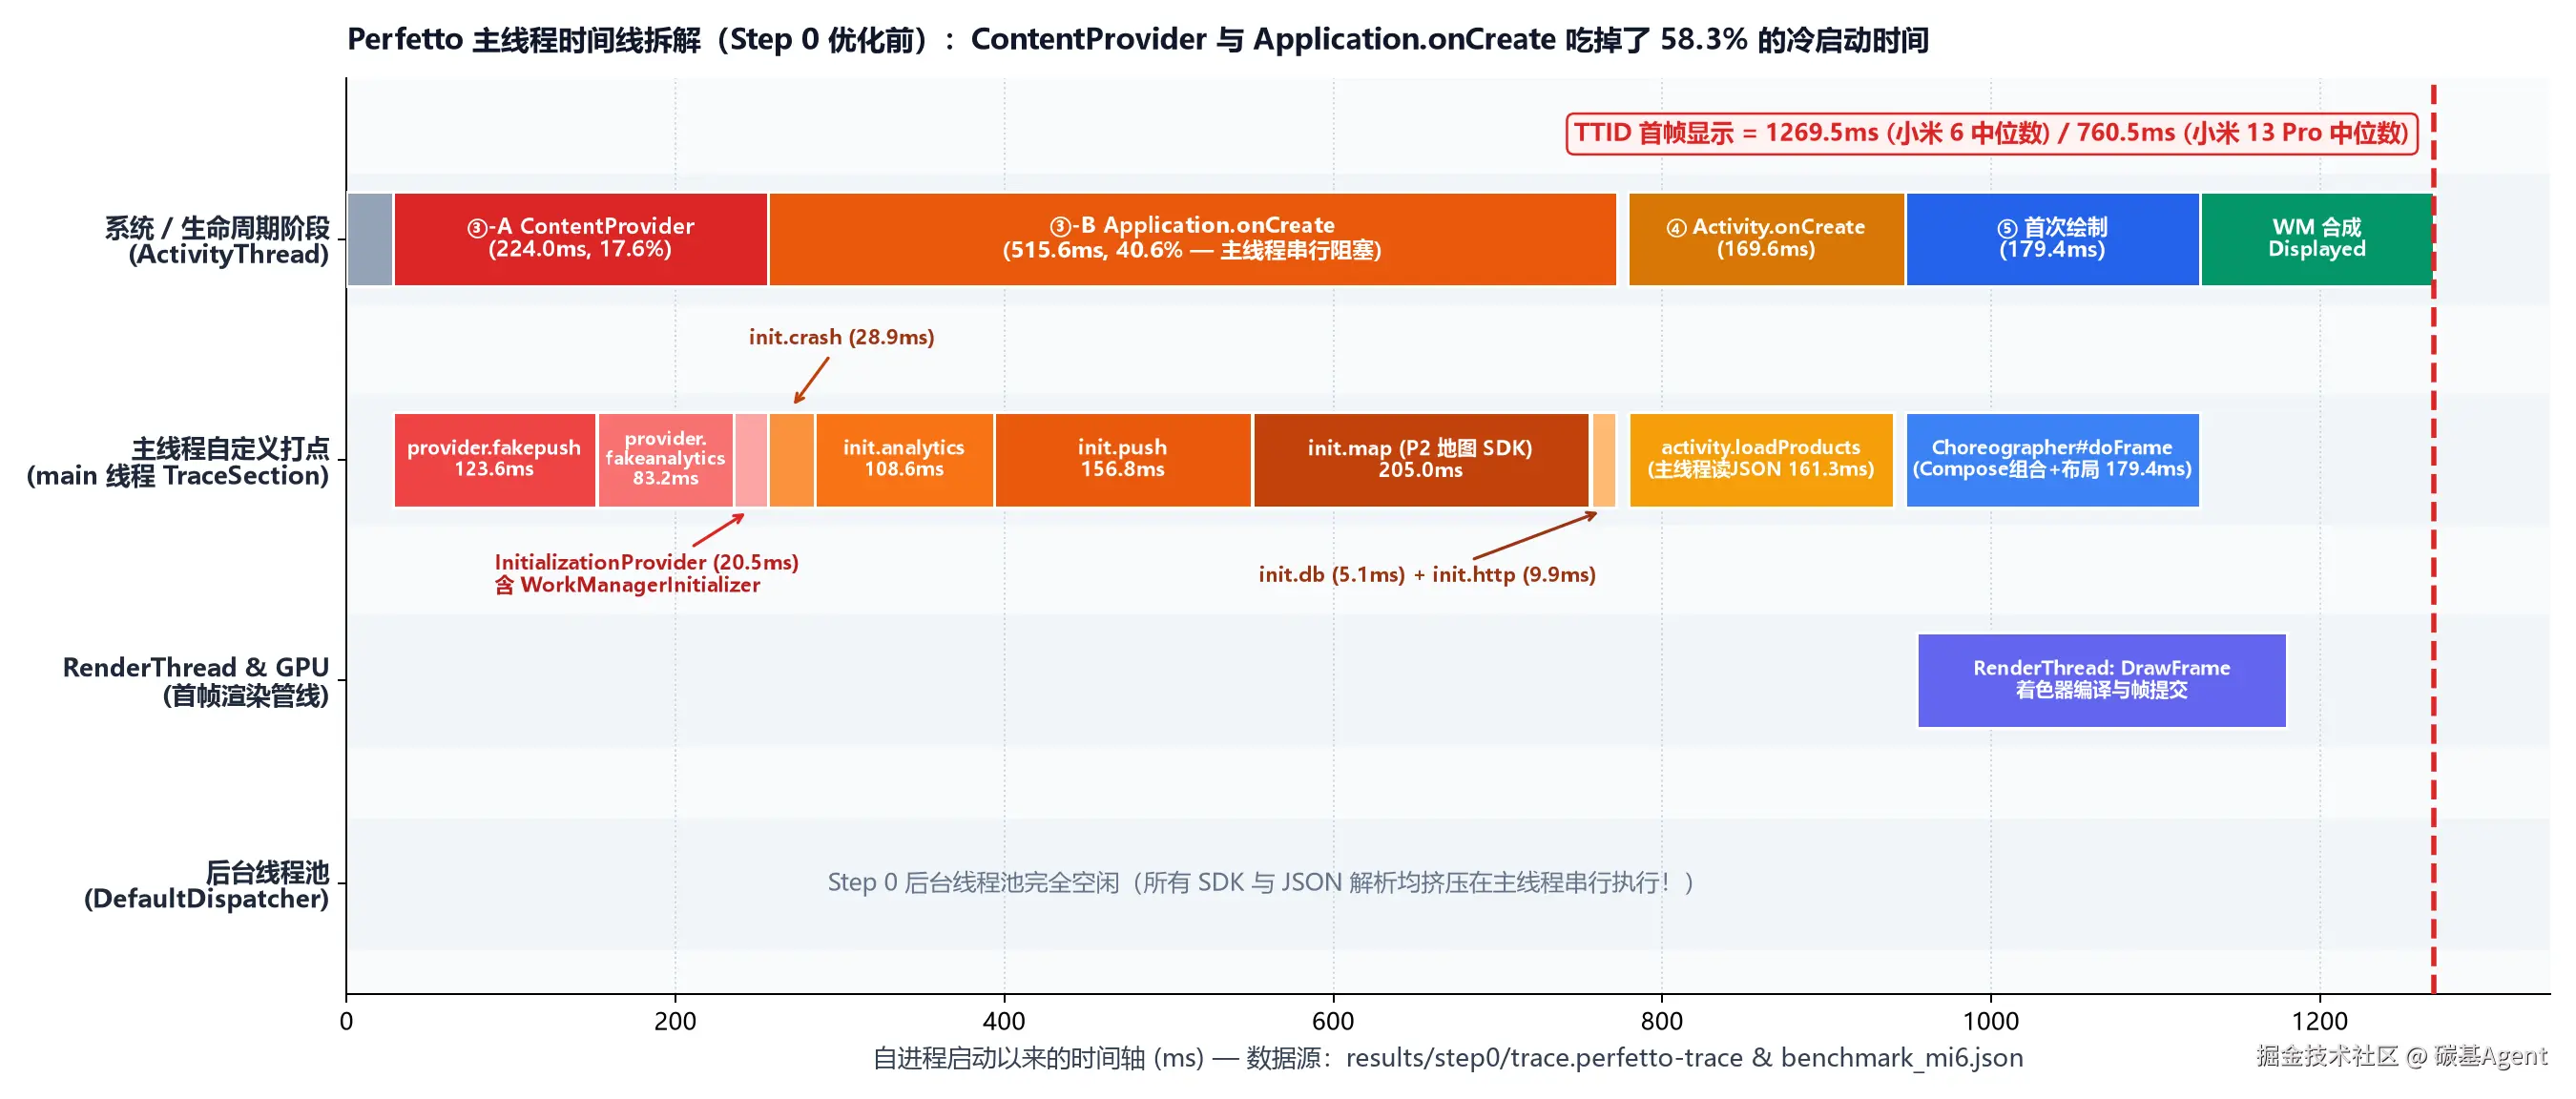
把两台真机上 Step 0 各阶段的实测中位数整理出来:
| 阶段 / 自定义 TraceSection | 小米 6(骁龙 835, API 28)耗时中位数 | 小米 13 Pro(骁龙 8 Gen 2, API 36)耗时中位数 | 所在线程 |
|---|---|---|---|
③-A ContentProvider 阶段 (全部 Provider 的 onCreate) |
224.0ms(占 TTID 17.6%) | 74.3ms(占 TTID 9.8%) | main |
├─ provider.fakepush(FakePushInitProvider) |
123.6ms | 43.4ms | main |
├─ provider.fakeanalytics(FakeAnalyticsInitProvider) |
83.2ms | 38.7ms | main |
└─ InitializationProvider(含 WorkManagerInitializer 等 4 项) |
17.2ms | 2.2ms | main |
③-B Application.onCreate 阶段 |
515.6ms(占 TTID 40.6%) | 192.5ms(占 TTID 25.3%) | main |
├─ init.crash(崩溃采集 SDK,P0) |
28.9ms | 10.6ms | main |
├─ init.analytics(统计 SDK,P1) |
108.6ms | 41.0ms | main |
├─ init.push(推送 SDK,P1) |
156.8ms | 59.4ms | main |
├─ init.map(地图 SDK,P2) |
205.0ms | 77.5ms | main |
├─ init.db(Room 数据库打开与初始查询) |
5.1ms | 1.4ms | main |
└─ init.http(OkHttp + Coil ImageLoader 创建) |
9.9ms | 1.9ms | main |
④ Activity.onCreate 阶段 |
169.6ms(占 TTID 13.4%) | 226.8ms(占 TTID 29.8%) | main |
└─ 其中 activity.loadProducts(读取并解析 500 条商品 JSON) |
161.3ms | 210.4ms | main |
⑤ 首次绘制阶段 (Choreographer#doFrame:Compose 组合/布局/绘制) |
179.4ms(占 TTID 14.1%) | 214.1ms(占 TTID 28.2%) | main |
| TTID(冷启动 10 次中位数,Min--Max) | 1269.5ms(1258--1344ms) | 760.5ms(741--1024ms) | --- |
从这张表和 Perfetto 时间线上,我们可以得出三个铁证:
- 执行顺序铁证 :在
bindApplication阶段,provider.fakepush(28.0ms ~ 151.6ms)、provider.fakeanalytics(152.3ms ~ 235.5ms)和InitializationProvider确实全部排在Application.onCreate(256.0ms ~ 772.5ms)之前执行。 - 认知翻转 :在小米 6 上,真正用于画首页的第一帧绘制(
179.4ms)只占总启动时间的 14.1% ;而ContentProvider(224.0ms)+Application.onCreate(515.6ms)两项加起来吃掉了 739.6ms,占去冷启动总时长的 58.3%! 在第一帧开始测量布局之前,主线程已经在初始化泥潭里挣扎了近 0.9 秒。 - 跨代差距放大效应 :同样的同步阻塞代码,在骁龙 8 Gen 2 旗舰机上耗时 760.5ms,而在骁龙 835 机型上膨胀到了 1269.5ms(仅
Application.onCreate就从 192.5ms 放大到 515.6ms,差出 2.7 倍)。这也是为什么开发同学只用顶配测试机自测时觉得"还行",一发版却被存量机型用户投诉启动卡死。
病因锁定了,下面按收益从大到小依次下四刀。
Step 1:第一刀------给 Application.onCreate 里的初始化分级(对应 Tag:step1-init-tiering)
不是所有 SDK 都必须在第一帧之前初始化。我们把 Application.onCreate() 里的任务按「什么时候真正需要它」分成三级:
| 级别 | 定义 | 典型代表 | 处理方式 |
|---|---|---|---|
| P0 | 首帧前必须完成,否则会漏采启动期异常,且本身极轻量 | CrashReporter(崩溃采集) |
保留在 Application.onCreate 主线程同步执行 |
| P1 | 不影响首帧渲染,但启动后需尽快就绪 | PushSdk、AnalyticsSdk |
派发到后台协程/线程池异步执行(不阻塞主线程) |
| P2 | 只有进入特定二级页面或触发特定功能时才用到 | MapSdk(地图组件,耗时 205ms) |
彻底移出启动路径,改为 by lazy 按需懒加载 |
注:在 Step 0 的实测中,真实的
Room(init.db5.1ms)和OkHttp/Coil(init.http9.9ms)合计约 15ms,为严格控制实验变量,我们在本演示工程中保持这两项原状不动;但在真实大型项目中,如果数据库含复杂 Migration 或网络层有重型证书校验,同样应归入 P1/P2 异步或懒加载。
改造后的 DemoApp.kt:
kotlin
// P2:第一次点击"地图"入口访问时才触发初始化,启动期耗时为 0
object MapSdkHolder {
    lateinit var appContext: Context

    val instance: MapSdk by lazy {
        traceSection("init.map") { MapSdk.init(appContext) }
    }
}

class DemoApp : Application() {
    private val appScope = CoroutineScope(SupervisorJob() + Dispatchers.Default)

    override fun onCreate() {
        super.onCreate()
        MapSdkHolder.appContext = applicationContext

        traceSection("app.onCreate") {
            // P0:首帧前必须完成,且很轻
            traceSection("init.crash") { CrashReporter.init(this) }

            // P1:不挡首帧,丢到后台线程池异步执行
            appScope.launch {
                traceSection("init.push") { PushSdk.init(this@DemoApp) }
                traceSection("init.analytics") { AnalyticsSdk.init(this@DemoApp) }
            }

            // Room 与 OkHttp/Coil 保持原状
            traceSection("init.db") { AppDatabaseInitializer.initAndQuery(this) }
            traceSection("init.http") { HttpInitializer.init(this) }
        }
    }
}
⚠️ 动手改之前必须确认的三个前提
- SDK 是否允许在子线程初始化 :不少包含 UI/WebView 或内部直接创建
Handler()(未传Looper.getMainLooper())的 SDK 强依赖主线程,放子线程会直接抛RuntimeException: Can't create handler inside thread that has not called Looper.prepare()。改造前务必查阅文档或反编译确认。 - 初始化之间有没有拓扑依赖 :如果
AnalyticsSdk内部读取了DeviceIdSdk生成的设备号,就不能把二者毫无同步地丢进并发线程池乱序执行。 - 隐私合规红线 :涉及采集 Android ID、OAID、MAC、位置等个人信息的 SDK(如统计、推送、广告),绝对不能在用户点击《隐私政策》弹窗"同意"之前初始化(哪怕是在后台线程也不行,工信部合规检测会直接通过 Hook 调用栈判定违规)。
💡 工业界进阶:当 SDK 从 5 个变成 50 个(DAG 启动任务调度框架)
在演示工程里,我们只有几个 SDK,手写 appScope.launch + by lazy 非常清爽。但在中大型商业 App 里,启动任务往往多达三四十个,且彼此存在复杂的依赖关系(例如:网络库 + 设备指纹 → 登录态恢复 → ABTest 配置拉取)。
此时业界通用做法是引入基于有向无环图(DAG)的启动框架(如阿里的 Alpha、锚点机制 Anchors 或自研协程 DAG 调度器):
- 将每个初始化动作封装成
StartupTask,声明dependencies()、runOnMainThread()和needWait()(是否需要阻塞等待其完成后再进首屏)。 - 启动器在编译期或启动初构建拓扑图,自动利用
CountDownLatch/CompletableDeferred在主线程与后台多线程之间并发调度,消解手写回调地狱。
实测验证(Step 1):
text
# 小米 6(骁龙 835, API 28)
Application.onCreate 主线程耗时:515.6ms  →  48.3ms  (-90.6%)
Step 1 后 TTID(10 次中位数)  :1269.5ms →  811.0ms (-458.5ms / -36.1%)

# 小米 13 Pro(骁龙 8 Gen 2, API 36)
Application.onCreate 主线程耗时:192.5ms  →  21.8ms  (-88.7%)
Step 1 后 TTID(10 次中位数)  :760.5ms  →  441.0ms (-319.5ms / -42.0%)
仅这一刀,就在小米 6 上砍掉了 458.5ms ,在小米 13 Pro 上砍掉了 319.5ms,是整个优化过程中单步收益最大的一刀。
Step 2:第二刀------治理 ContentProvider(对应 Tag:step2-provider-governance)
Step 1 把 Application.onCreate 压到了 48.3ms,但回头看 Perfetto,前面的 ContentProvider 阶段依然占着 223.4ms(小米 13 Pro 上 98.4ms)。
我们把 Merged Manifest 里的所有 <provider> 及其内部 <meta-data> 拉出一张表,逐一审视去留:
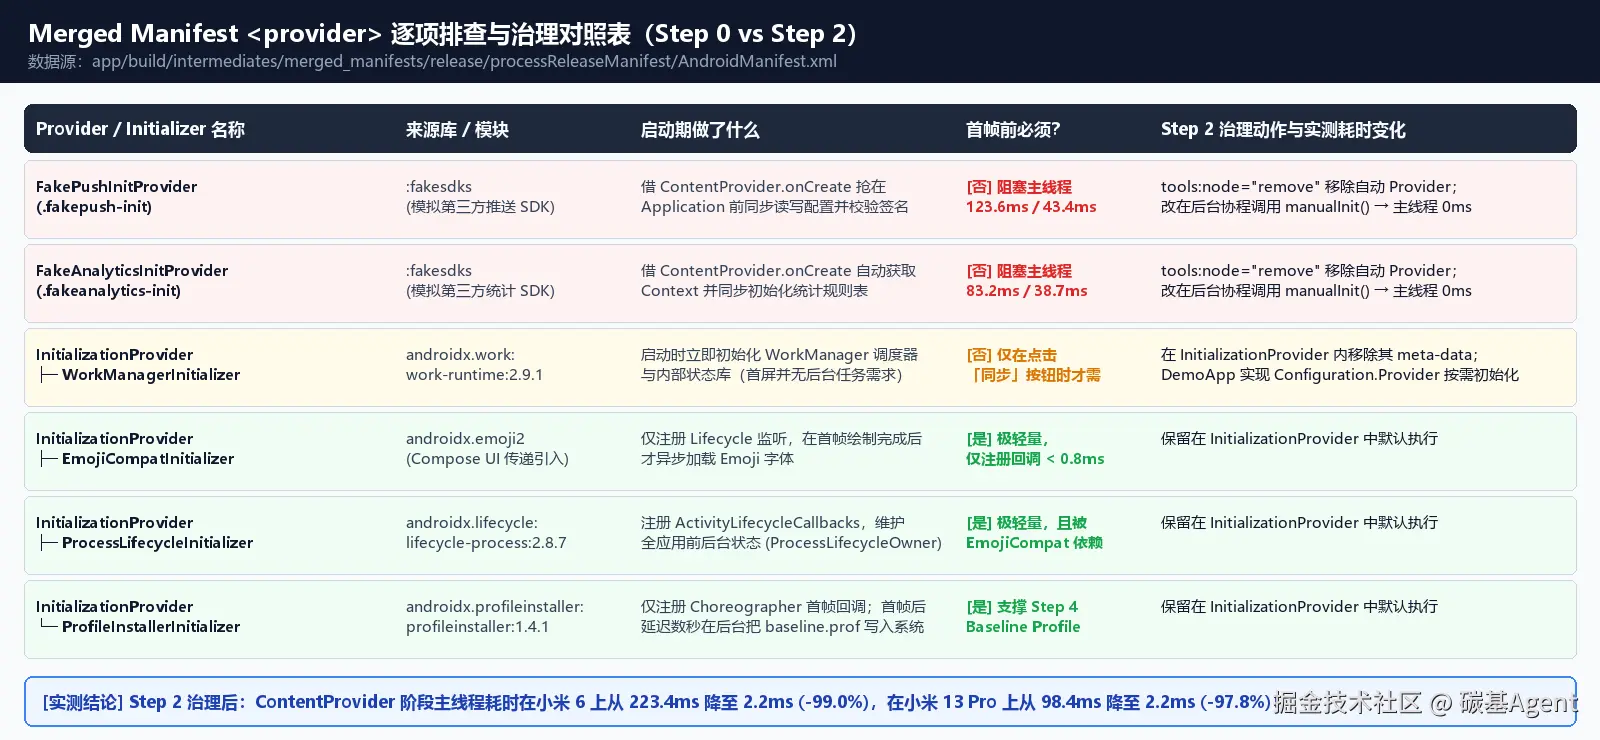
不同来源的 Provider,治理手段完全不同,分为三种情况:
情况 A:基于 Jetpack App Startup 的组件(如 WorkManager)
先厘清一个常见误区:Jetpack App Startup 不是用来"异步加速"的,它的核心作用是"把多个库各自注册的 ContentProvider 合并成一个 InitializationProvider",从而省掉多个 Provider 实例化的系统开销,并提供轻量级依赖顺序声明。 但 InitializationProvider 里的所有 Initializer.create() 默认依然是在主线程同步执行的!
对于像 WorkManager 这样挂在 InitializationProvider 下、但首屏根本不需要用到的重型组件,官方推荐的做法是在 app/src/main/AndroidManifest.xml 里用 tools:node="remove" 移除它的自动初始化 meta-data:
xml
<provider
    android:name="androidx.startup.InitializationProvider"
    android:authorities="${applicationId}.androidx-startup"
    android:exported="false"
    tools:node="merge">
    <!-- 移除 WorkManager 的自动初始化,改为按需初始化 -->
    <meta-data
        android:name="androidx.work.WorkManagerInitializer"
        android:value="androidx.startup"
        tools:node="remove" />
</provider>
然后让 DemoApp 实现 Configuration.Provider 接口。这样 WorkManager 在启动期间完全不执行任何代码,直到用户点击列表页右上角的「同步」按钮、首次调用 WorkManager.getInstance(context) 时,才会按需读取该配置完成初始化:
kotlin
class DemoApp : Application(), Configuration.Provider {
    override val workManagerConfiguration: Configuration
        get() = Configuration.Builder()
            .setMinimumLoggingLevel(android.util.Log.INFO)
            .build()
}
情况 B:第三方库自己注册的独立 ContentProvider
对于 :fakesdks 隐式注入的 FakePushInitProvider 和 FakeAnalyticsInitProvider,我们在主工程 AndroidManifest.xml 中使用 tools:node="remove" 将它们彻底剥离,随后在 DemoApp 的后台协程里手动调用它们的初始化入口:
xml
<!-- Step 2: 移除第三方库自动注册的 ContentProvider,交由应用自己在后台协程初始化 -->
<provider
    android:name="com.example.fakesdks.FakePushInitProvider"
    android:authorities="${applicationId}.fakepush-init"
    tools:node="remove" />

<provider
    android:name="com.example.fakesdks.FakeAnalyticsInitProvider"
    android:authorities="${applicationId}.fakeanalytics-init"
    tools:node="remove" />
⚠️ 风险警示 :只有当第三方库明确提供了手动初始化 API (或你能确认其内部 Context 可由手动初始化注入)时,才能移除它的 Provider!如果某个闭源 SDK 仅在自己的
ContentProvider.onCreate()里给内部静态变量sContext赋值,且没有暴露任何其它入口,贸然tools:node="remove"会导致该 SDK 在运行时抛出NullPointerException。移除前务必查清文档或反编译确认,移除后必须做完整的功能回归测试。
情况 C:你自己的基础库想收敛 ContentProvider
如果你在开发团队内部的组件库,千万不要每个模块自己去注册一个 ContentProvider 拿 Context,统一改写为实现 App Startup 的 Initializer<T>,共用唯一的 InitializationProvider:
kotlin
class MySdkInitializer : Initializer<MySdk> {
    override fun create(context: Context): MySdk = MySdk.init(context)
    override fun dependencies(): List<Class<out Initializer<*>>> = emptyList()
}
实测验证(Step 2):
重新编译检查 app/build/intermediates/merged_manifests/release/processReleaseManifest/AndroidManifest.xml,FakePushInitProvider、FakeAnalyticsInitProvider 与 WorkManagerInitializer 已从合并清单中彻底消失。真机实测结果:
text
# 小米 6(骁龙 835, API 28)
ContentProvider 阶段耗时:223.4ms →  2.2ms   (-99.0%)
Step 2 后 TTID(中位数):811.0ms →  646.5ms (-164.5ms / -20.3%)

# 小米 13 Pro(骁龙 8 Gen 2, API 36)
ContentProvider 阶段耗时:98.4ms  →  2.2ms   (-97.8%)
Step 2 后 TTID(中位数):441.0ms →  306.0ms (-135.0ms / -30.6%)
Step 3:第三刀------把首个 Activity 的重活移出主线程(对应 Tag:step3-activity-offload)
经过前两刀,ContentProvider(2.2ms)和 Application.onCreate(63.9ms)都已经很轻了。此时在小米 6 上,主线程最大的阻塞块变成了 MainActivity.onCreate 里的同步读取并解析 500 条商品 JSON(耗时 163.1ms)。
我们将文件读取与解析移入 MainViewModel 的 Dispatchers.IO 协程,首帧直接渲染轻量级骨架屏 SkeletonList(),等数据解析完成后再自动刷新为 ProductList(),并用 ReportDrawnWhen 上报 TTFD:
kotlin
// ❌ 之前(Step 0 ~ Step 2):主线程同步读文件 + 解析 JSON,首帧必须等它跑完
override fun onCreate(savedInstanceState: Bundle?) {
    super.onCreate(savedInstanceState)
    val products = traceSection("activity.loadProducts") {
        ProductLoader.loadFromAssets(this)
    }
    setContent { ProductListScreen(products = products) }
}
kotlin
// ✅ 之后(Step 3):首帧先显示骨架屏,IO 线程解析完成后自动刷新并上报 TTFD
class MainViewModel(app: Application) : AndroidViewModel(app) {
    private val _products = MutableStateFlow<List<Product>?>(null)
    val products: StateFlow<List<Product>?> = _products

    init {
        viewModelScope.launch(Dispatchers.IO) {
            _products.value = traceSection("activity.loadProducts") {
                ProductLoader.loadFromAssets(getApplication())
            }
        }
    }
}

class MainActivity : ComponentActivity() {
    private val vm: MainViewModel by viewModels()

    override fun onCreate(savedInstanceState: Bundle?) {
        super.onCreate(savedInstanceState)
        val initialFlow = vm.products
        setContent {
            val list by initialFlow.collectAsState()
            MaterialTheme {
                // list == null 时渲染 SkeletonList(),非空时渲染真实列表
                ProductListScreen(products = list)
            }

            // 当真实商品列表到达并完成组合绘制后,调用 reportFullyDrawn() 上报 TTFD
            ReportDrawnWhen { list != null }
        }
    }
}
实测验证与深度发现(Step 3 的 TTID vs TTFD 博弈):
text
# 小米 6(骁龙 835, API 28)
Activity.onCreate 主线程耗时:172.2ms → 13.1ms  (-92.4%)
Step 3 后 TTID(中位数)    :646.5ms → 481.5ms (-165.0ms / -25.5%,首帧骨架屏)
Step 3 后 TTFD(中位数)    :646.5ms → 567.0ms (-79.5ms  / -12.3%,真实商品列表)

# 小米 13 Pro(骁龙 8 Gen 2, API 36)
Activity.onCreate 主线程耗时:59.7ms  → 9.7ms   (-83.8%)
Step 3 后 TTID(中位数)    :306.0ms → 237.5ms (-68.5ms  / -22.4%)
Step 3 后 TTFD(中位数) :306.0ms → 238.0ms (-68.0ms / -22.2%)请仔细看上面两组真实数据------两台跨代真机展现出了截然不同却又完全自洽的现象:
- 在小米 6(骁龙 835)上:TTID 暴降 165.0ms,但 TTFD 只降了 79.5ms,二者拉开了 85.5ms 的差距! 为什么?翻看
step3/benchmark_mi6.json里的分段数据就能真相大白:在 Step 2 中,activity.loadProducts在主线程独占运行时只需 163.1ms ;而在 Step 3 移到Dispatchers.IO后,它的耗时反而拉长到了 226.0ms ! 原因在于:我们在 Step 1 和 Step 2 把 4 个模拟 SDK 的初始化全丢进了后台协程,现在 Step 3 又把商品 JSON 解析也丢进了后台协程。在骁龙 835 有限的 CPU 核心上,多个后台线程与主线程的 Compose 首次渲染同时争抢 CPU 时间片 ,导致数据加载完成的时间(567.0ms)比首帧骨架屏上屏的时间(481.5ms)晚了 85.5ms。 这也给我们敲响了警钟:把任务丢到后台线程绝不是"免费午餐"。如果后台线程塞满了高 CPU 消耗的 P1 任务,它们不仅会拖慢首屏业务数据的加载(拉高 TTFD),还会反过来抢占主线程的 CPU 周期! 在生产环境中,首屏数据请求应享有高于普通 P1 SDK 初始化的调度优先级。 - 在小米 13 Pro(骁龙 8 Gen 2)上:TTID 与 TTFD 同步降到了 238ms! 因为骁龙 8 Gen 2 的多核并行算力极为充裕,
Dispatchers.IO线程仅用 59.0ms (在进程启动后第141.8ms)就已经把 500 条商品解析完毕并塞进了StateFlow------而此时主线程还在忙着做首次 Compose 组合与 RenderThread 着色器初始化(第201.3ms才完成首帧绘制)。结果后台数据跑赢了首帧渲染,第一帧直接画出了完整商品列表,TTID 与 TTFD 同时受益!
Step 4:第四刀------Baseline Profile,最后一刀(对应 Tag:step4-baseline-profile)
前三刀都是「让主线程少做事 」,此时主线程只剩下 init.crash、轻量级 Activity.onCreate 以及首次绘制(在小米 6 上耗时 190.0ms ,成了新的第一大头)。第四刀的目标是:「让主线程必须做的事执行得更快」。
1. 编写生成器并采集 Profile。 在工程的 :baselineprofile 模块中,利用 BaselineProfileRule 覆盖冷启动到首屏渲染的完整路径(同时设置 includeInStartupProfile = true 开启 DEX 布局优化):
kotlin
@RunWith(AndroidJUnit4::class)
@LargeTest
class BaselineProfileGenerator {
    @get:Rule val rule = BaselineProfileRule()

    @Test
    fun generate() = rule.collect(
        packageName = "com.example.startupdemo",
        includeInStartupProfile = true
    ) {
        pressHome()
        startActivityAndWait()
    }
}
生成的规则文件存放在 app/src/main/baseline-prof.txt 中(包含 HSPLcom/example/startupdemo/... 等热点启动方法与 Lcom/example/startupdemo/...; 启动类)。当执行 ./gradlew assembleRelease 时,AGP 的 mergeReleaseArtProfile 与 compileReleaseArtProfile 任务会将其与 Jetpack Compose、Room、Lifecycle 等库自带的规则合并(本工程合并后共包含 com/example/ 下 80 条规则及数千条 Jetpack 规则),编译为 APK 内的 assets/dexopt/baseline.prof。
2. 用 Macrobenchmark 验证 None 与 Partial 的真实收益:
kotlin
@RunWith(AndroidJUnit4::class)
@LargeTest
class StartupBenchmarks {
    @get:Rule val rule = MacrobenchmarkRule()

    @Test fun startupNoProfile() = startup(CompilationMode.None())
    @Test fun startupWithProfile() =
        startup(CompilationMode.Partial(BaselineProfileMode.Require))

    private fun startup(mode: CompilationMode) = rule.measureRepeated(
        packageName = "com.example.startupdemo",
        metrics = listOf(StartupTimingMetric()),
        compilationMode = mode,
        startupMode = StartupMode.COLD,
        iterations = 10,
        setupBlock = { pressHome() }
    ) {
        startActivityAndWait()
    }
}
这里 CompilationMode.Partial(BaselineProfileMode.Require) 的 Require 非常关键:它会强制通过 ProfileInstallReceiver 安装 APK 内置的 baseline.prof 并执行 cmd package compile -f -m speed-profile,如果 Profile 安装或编译失败会直接报错终止,避免测出"以为生效、实则没生效"的假数据。
📝 API 34+ 测量提示:在 Android 14(API 34)及更高版本(如我们的测试机小米 13 Pro,Android 16 / API 36)上,系统在应用首次启动后会由 ART 后台机制触发部分预编译,且新架构大核的解释/JIT 执行本身极快,因此要在报告中明确记录设备的 API 级别。
实测验证(Step 4:CompilationMode.None() vs CompilationMode.Partial(Require)):
text
# 小米 6(骁龙 835, Android 9 / API 28)
CompilationMode.None()   : TTID = 490.5ms, TTFD = 578.5ms, 首次绘制 FirstDraw = 193.1ms
CompilationMode.Partial(): TTID = 380.5ms, TTFD = 424.0ms, 首次绘制 FirstDraw = 112.4ms
→ 首次绘制耗时直降 41.8%(193.1ms → 112.4ms),TTID 进一步下降 110.0ms (-22.4%)!

# 小米 13 Pro(骁龙 8 Gen 2, Android 16 / API 36)
CompilationMode.None()   : TTID 中位数 = 246.0ms(范围 224.0--364.0ms)
CompilationMode.Partial(): TTID 中位数 = 238.0ms(范围 224.0--272.0ms)
→ TTID 中位数改善 8.0ms (-3.3%),最大长尾耗时从 364.0ms 压降至 272.0ms (-25.3%)!
可以看到,在中低端机型(小米 6)上,由于 CPU 单核性能有限,Compose 大量类的首次解释执行与 JIT 编译原本要花 193.1ms ;开启 Baseline Profile 预编译为机器码后,首次绘制骤降到 112.4ms(提速 41.8%) ,连带后台 JSON 解析也从 226.4ms 加快到 183.2ms,整体 TTID 从 490.5ms 降到 380.5ms(提速 22.4%) ,TTFD 从 578.5ms 降到 424.0ms(提速 26.7%)!
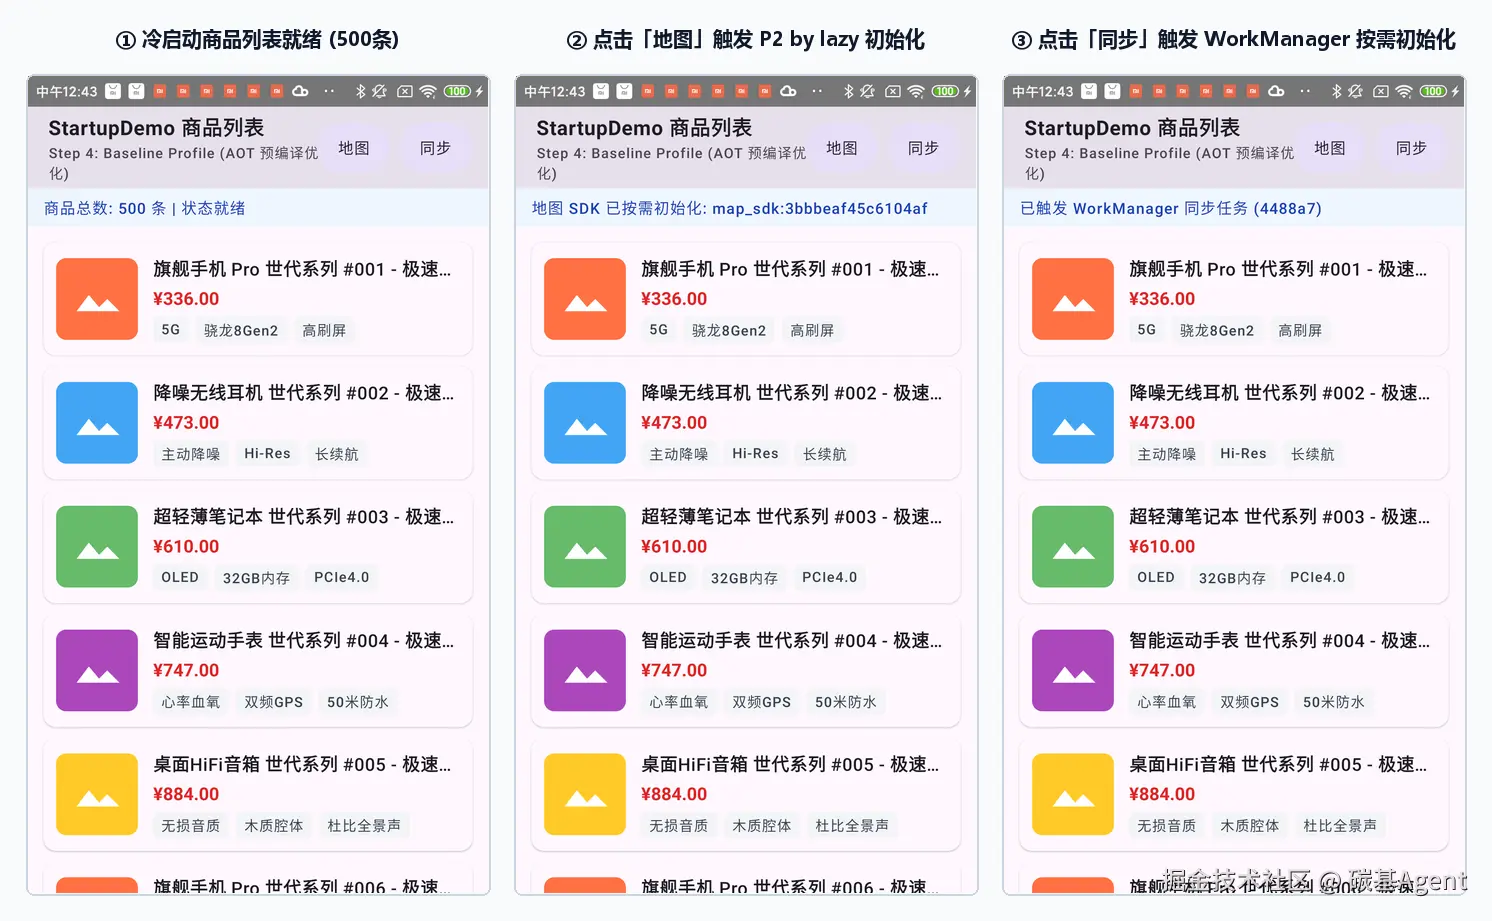
同时,我们还验证了 Step 1 的 P2 地图懒加载按钮与 Step 2 的 WorkManager 按需同步按钮,功能 100% 正常可用:
量化对比:双真机全链路实测总表
数据来源:StartupDemo/results/ 下的
summary_mi6.csv、summary_mi13pro.csv及step0~step4下的benchmark.json。每组均为非 debuggable Release 构建、冷启动(COLD)连续 10 次取中位数(括号内为最小值--最大值)。
表 1:设备 A --- 小米 6(骁龙 835,Android 9 / API 28)全阶段演进对比
| 指标 | Step 0 (baseline) |
Step 1 (init-tiering) |
Step 2 (provider-gov) |
Step 3 (activity-offload) |
Step 4 (None 无 Profile) |
Step 4 (Partial 有 Profile) |
总降幅 (Step 0 → Step 4) |
|---|---|---|---|---|---|---|---|
| TTID 中位数 (范围) | 1269.5ms (1258--1344) | 811.0ms (796--875) | 646.5ms (620--1030) | 481.5ms (464--878) | 490.5ms (470--906) | 380.5ms (366*--400) | -889.0ms (-70.0%) |
| TTFD 中位数 | 1269.5ms | 811.0ms | 646.5ms | 567.0ms | 578.5ms | 424.0ms | -845.5ms (-66.6%) |
| ContentProvider 阶段 | 224.0ms | 223.4ms | 2.2ms | 2.2ms | 2.2ms | 2.2ms | -221.8ms (-99.0%) |
Application.onCreate |
515.6ms | 48.3ms | 63.9ms | 62.5ms | 64.2ms | 53.8ms | -461.8ms (-89.6%) |
Activity.onCreate |
169.6ms | 170.5ms | 172.2ms | 13.1ms | 13.7ms | 12.8ms | -156.8ms (-92.5%) |
首次绘制 (FirstDraw) |
179.4ms | 183.6ms | 195.3ms | 190.0ms | 193.1ms | 112.4ms | -67.0ms (-37.3%) |
*注:小米 6 的 Step 4 (
Partial) 第 10 轮因am force-stop与系统桌面切换竞态出现了一次 109.0ms 的非完整冷启动异常点(已在原始数据benchmark_mi6.json中保留并标注),其余 9 轮有效冷启动最小值为 366.0ms,10 轮中位数为 380.5ms(9 轮中位数为 381.0ms)。
表 2:设备 B --- 小米 13 Pro(骁龙 8 Gen 2,Android 16 / API 36)全阶段演进对比
| 指标 | Step 0 (baseline) |
Step 1 (init-tiering) |
Step 2 (provider-gov) |
Step 3 (activity-offload) |
Step 4 (None 无 Profile) |
Step 4 (Partial 有 Profile) |
总降幅 (Step 0 → Step 4) |
|---|---|---|---|---|---|---|---|
| TTID 中位数 (范围) | 760.5ms (741--1024) | 441.0ms (399--842) | 306.0ms (252--383) | 237.5ms (212--277) | 246.0ms (224--364) | 238.0ms (224--272) | -522.5ms (-68.7%) |
| TTFD 中位数 | 760.5ms | 441.0ms | 306.0ms | 238.0ms | 246.1ms | 238.1ms | -522.4ms (-68.7%) |
| ContentProvider 阶段 | 74.3ms | 98.4ms | 2.2ms | 2.2ms | 2.2ms | 2.2ms | -72.1ms (-97.0%) |
Application.onCreate |
192.5ms | 21.8ms | 26.0ms | 25.6ms | 25.4ms | 27.1ms | -165.4ms (-85.9%) |
Activity.onCreate |
226.8ms | 62.2ms | 59.7ms | 9.7ms | 10.3ms | 11.2ms | -215.6ms (-95.1%) |
首次绘制 (FirstDraw) |
214.1ms | 168.3ms | 118.2ms | 162.3ms | 102.6ms | 114.6ms | -99.5ms (-46.5%) |
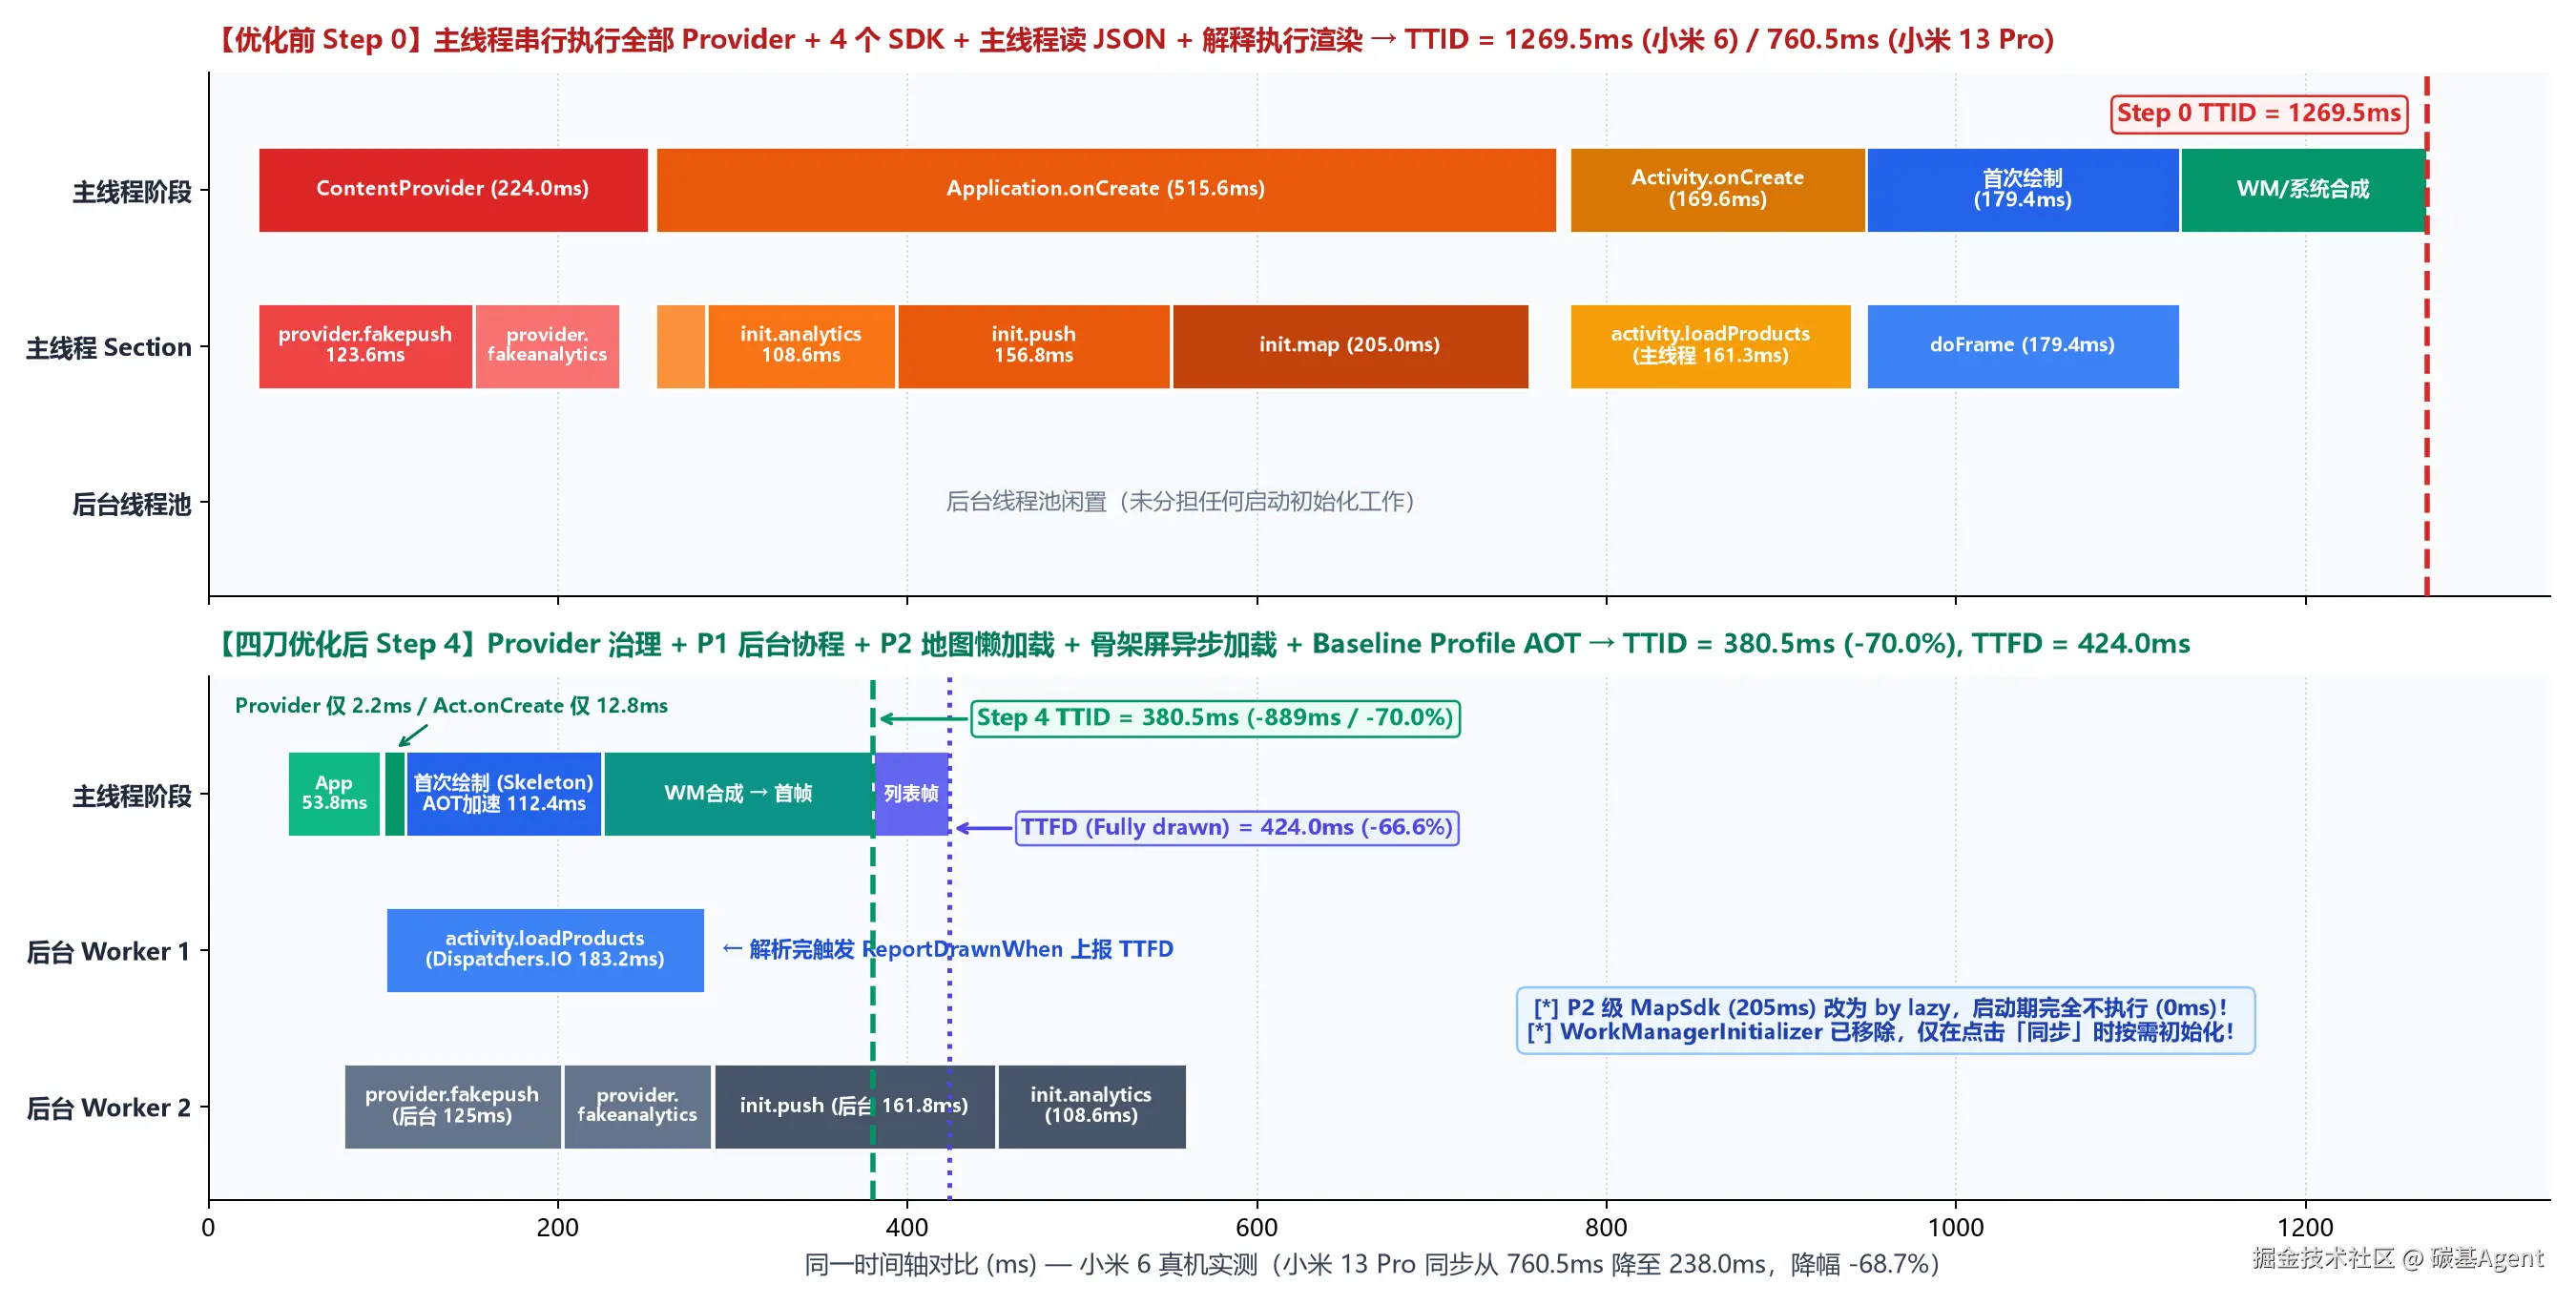
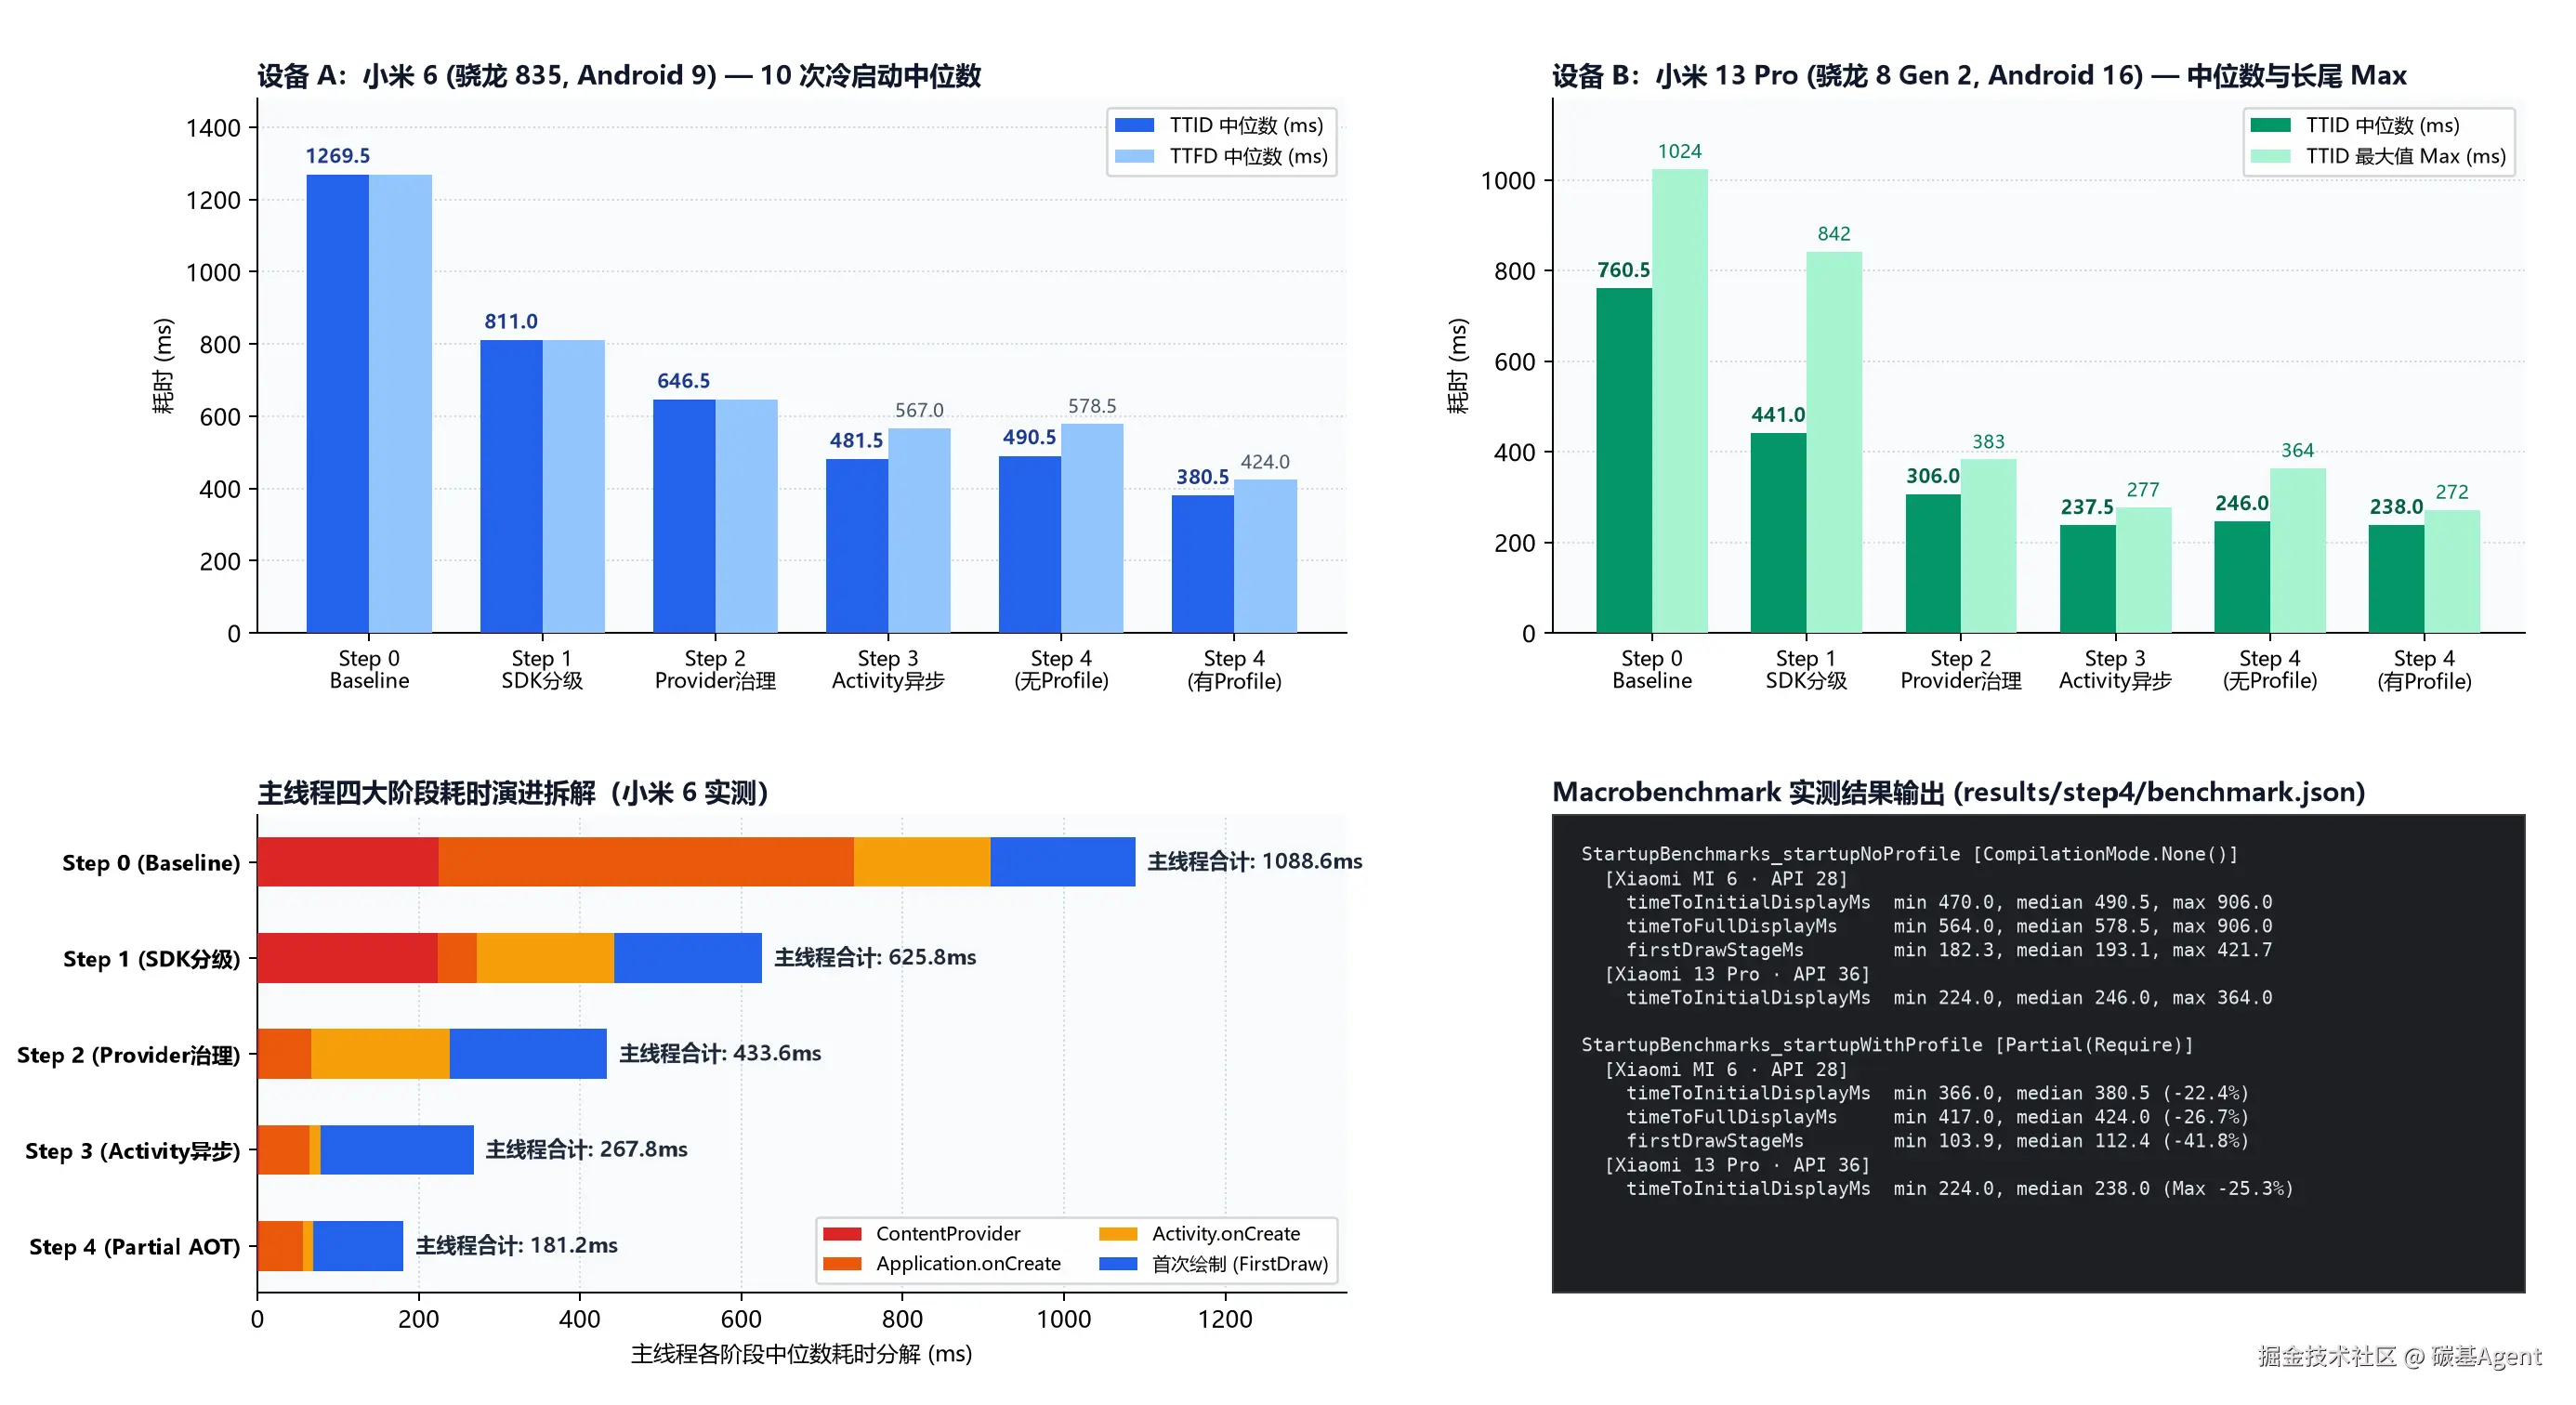
把两台真机的四刀演进放在一起看,冷启动优化的全局图景一目了然:
- 在小米 6 上,冷启动 TTID 从 1269.5ms 降至 380.5ms(提速 70.0%) ,TTFD 从 1269.5ms 降至 424.0ms(提速 66.6%) ;应用内主线程总耗时从 1088.6ms 压缩到了 181.2ms。
- 在小米 13 Pro 上,冷启动 TTID 从 760.5ms 降至 238.0ms(提速 68.7%),实现了点按图标即秒开的丝滑体验。
四、总结
速查表:5 条冷启动优化原则
text
✅ 1. 先测量,再优化
      TTID 和 TTFD 都要看;用 Perfetto + 自定义 Trace.beginSection 找到"时间花在哪一段",
      用 Macrobenchmark 取多轮冷启动中位数做验收,绝不凭单次 Logcat 下结论。

✅ 2. Application.onCreate 里的初始化必须分级
      P0 首帧前必须(要轻)/ P1 首帧后尽快(后台协程/线程池)/ P2 用到再初始化(by lazy)。
      改之前先确认三件事:能否子线程初始化、有没有拓扑依赖(复杂场景上 DAG 调度器)、是否受隐私合规约束。

✅ 3. 警惕 App 里你看不见的隐式初始化
      在 Merged Manifest 里审查所有 <provider>;
      基于 App Startup 的组件(如 WorkManager)可移除 meta-data 改为按需初始化;
      第三方库独立注册的 Provider,确认支持手动初始化后用 tools:node="remove" 剥离并做完整回归。

✅ 4. 首个 Activity 不要在主线程做 I/O 与重度解析
      首帧先出骨架屏,数据在 Dispatchers.IO 加载后刷新;
      TTID 好看不等于用户体验好,必须配合 ReportDrawnWhen / reportFullyDrawn() 同时看 TTFD,
      并警惕后台 P1 线程过多反过来与首屏数据加载争抢 CPU。

✅ 5. Baseline Profile + Startup Profile 作为最后一刀
      它通过 AOT 预编译与 DEX 布局重排让主线程代码执行更快,但治不了主线程阻塞;
      国内环境务必集成 androidx.profileinstaller 落地,并用 Macrobenchmark 对比 None 与 Partial(Require)。
方法论升华
前两篇优化的是"画面如何高效渲染",这一篇优化的是"画面出现之前主线程在忙什么"。
回顾整套四刀实战,冷启动优化的本质其实只有一句话:在第一帧出现之前,让主线程少做事,或者让它必须做的事更快。
- 让主线程少做事 :SDK 初始化分级(Step 1)、
ContentProvider治理(Step 2)、首屏Activity重活外移(Step 3)。 - 让主线程做的事更快:Baseline Profile 引导式 AOT 编译与 Startup Profile DEX 布局优化(Step 4)。
而这一切能够落地的前提,是先用 Perfetto 把原本黑盒的时间"看见",再用真机多轮统计数据说话,而不是凭感觉猜瓶颈。
下篇预告
启动速度和渲染流畅度都解决了,接下来是另一类让用户"用着用着莫名其妙变卡、最后在后台甚至前台被系统无情杀掉"的隐形杀手:内存。
下一篇,我们来讲 Android 内存泄漏与内存抖动的排查与治理:LeakCanary 到底是怎么自动发现泄漏的,工作中最常踩的泄漏模式有哪些,以及怎么从一份看似天书的 Heap Dump(.hprof)里把"谁持有了谁"那条最短强引用链(GC Roots Shortest Path)一眼看明白。
附:演示工程与测量环境
- 演示工程仓库 :github.com/shuhui-sh/S...(包含
:app、:fakesdks、:baselineprofile三个模块,以及step0-baseline、step1-init-tiering、step2-provider-governance、step3-activity-offload、step4-baseline-profile五个累积式 Git Tag)。 - 原始数据与复现产物 :全部保存在 StartupDemo/results/ 目录下:
results/device.md:两台测试真机的硬件、系统固件与安全补丁详情。results/merged_manifest_providers.txt:Step 0 与 Step 2 的 Merged Manifest<provider>完整清单及 XML diff。results/summary.csv、summary_mi6.csv、summary_mi13pro.csv:两台真机在各阶段的 10 次冷启动中位数汇总表。results/step0/~results/step4/:每个阶段的benchmark.json(含 10 次原始分段数据)、am_start_w.txt以及真机录制的.perfetto-trace文件。results/FINDINGS.md:对 5 条核心实验假设(H1--H5)的逐项验证报告。
- 测试设备与软件版本 :
- 设备 A(主力基线机) :Xiaomi MI 6(骁龙 835
msm8998,6GB RAM,Android 9 / API 28,MIUIV11.0.5.0.PCACNXM)。 - 设备 B(旗舰对照机) :Xiaomi 13 Pro
2210132C(骁龙 8 Gen 2SM8550,8GB RAM,Android 16 / API 36,HyperOSOS3.0.312.0.WMBCNXM)。 - 工具链版本 :JDK
17.0.0.1、Gradle8.7、AGP8.5.2、Kotlin2.0.21、Compose BOM2024.10.01、Room2.6.1、WorkManager2.9.1、OkHttp4.12.0、Coil2.7.0、App Startup1.1.1、ProfileInstaller1.4.1、AndroidX Benchmark1.3.3。
- 设备 A(主力基线机) :Xiaomi MI 6(骁龙 835
- 官方参考文档 :
本文收录于《Android 性能优化》专栏
系列文章
- Android 渲染优化实战:从看懂 Overdraw 到用 ConstraintLayout 一套布局适配所有屏幕
- 你在 XML 时代学的渲染优化,进了 Compose 大多不再是重点------Recomposition 才是新的战场
- 点击图标到内容出现,你的 App 在这几秒里做了什么:Android 冷启动全链路优化实战(本篇)
下一篇想聊聊内存泄漏:页面都关了,对象为什么还活着,LeakCanary 又是怎么把它揪出来的。