摘要:不用微信、不装新 App,用飞书机器人做入口、Dify 做编排、FastAPI 做接入层,把日常丢进来的链接、图片、语音、文件变成可检索的知识库,并每天自动生成一份日报。本文拆解整条链路的关键设计,以及 12 个真实踩过的坑。
技术栈:Python 3.10+ / FastAPI / Dify(Chatflow + 知识库)/ 飞书开放平台 / SQLite / ffmpeg
适合读者:想自建个人知识库的后端开发、正在对接飞书事件回调的工程师、被「抓取 + 转写 + 入库」链路折磨过的人。
一、背景:为什么入口选飞书,而不是微信
个人知识库最理想的产品形态,是「看到什么,随手一丢」。
绝大多数人第一反应是从微信里自动收集,但个人微信没有给开发者留正规入口:要么走非官方协议(封号风险 + 随时失效),要么用企业微信绕一大圈。调研到这里基本就卡住了。
飞书是另一条路。自建应用 + 机器人,官方把该给的都给全了:
- 事件订阅(
im.message.receive_v1) - 回调验签与 URL 校验
- 消息资源下载(文件、图片、语音、视频)
- 主动发消息
代价是入口必须迁移到飞书。对我这种本来就在飞书里办公的人,这笔交易划算。
最终形态是一个「投喂 - 消化 - 复盘」的闭环:
- 投喂:私聊、群聊、转发卡片,都算输入
- 消化:自动抓正文、解析文档、OCR / 视觉理解、ASR 转写
- 沉淀:按内容哈希增量写入 Dify 知识库,带标签
- 复盘:每天定时生成日报,逐条解读 + 整体整合
二、整体架构
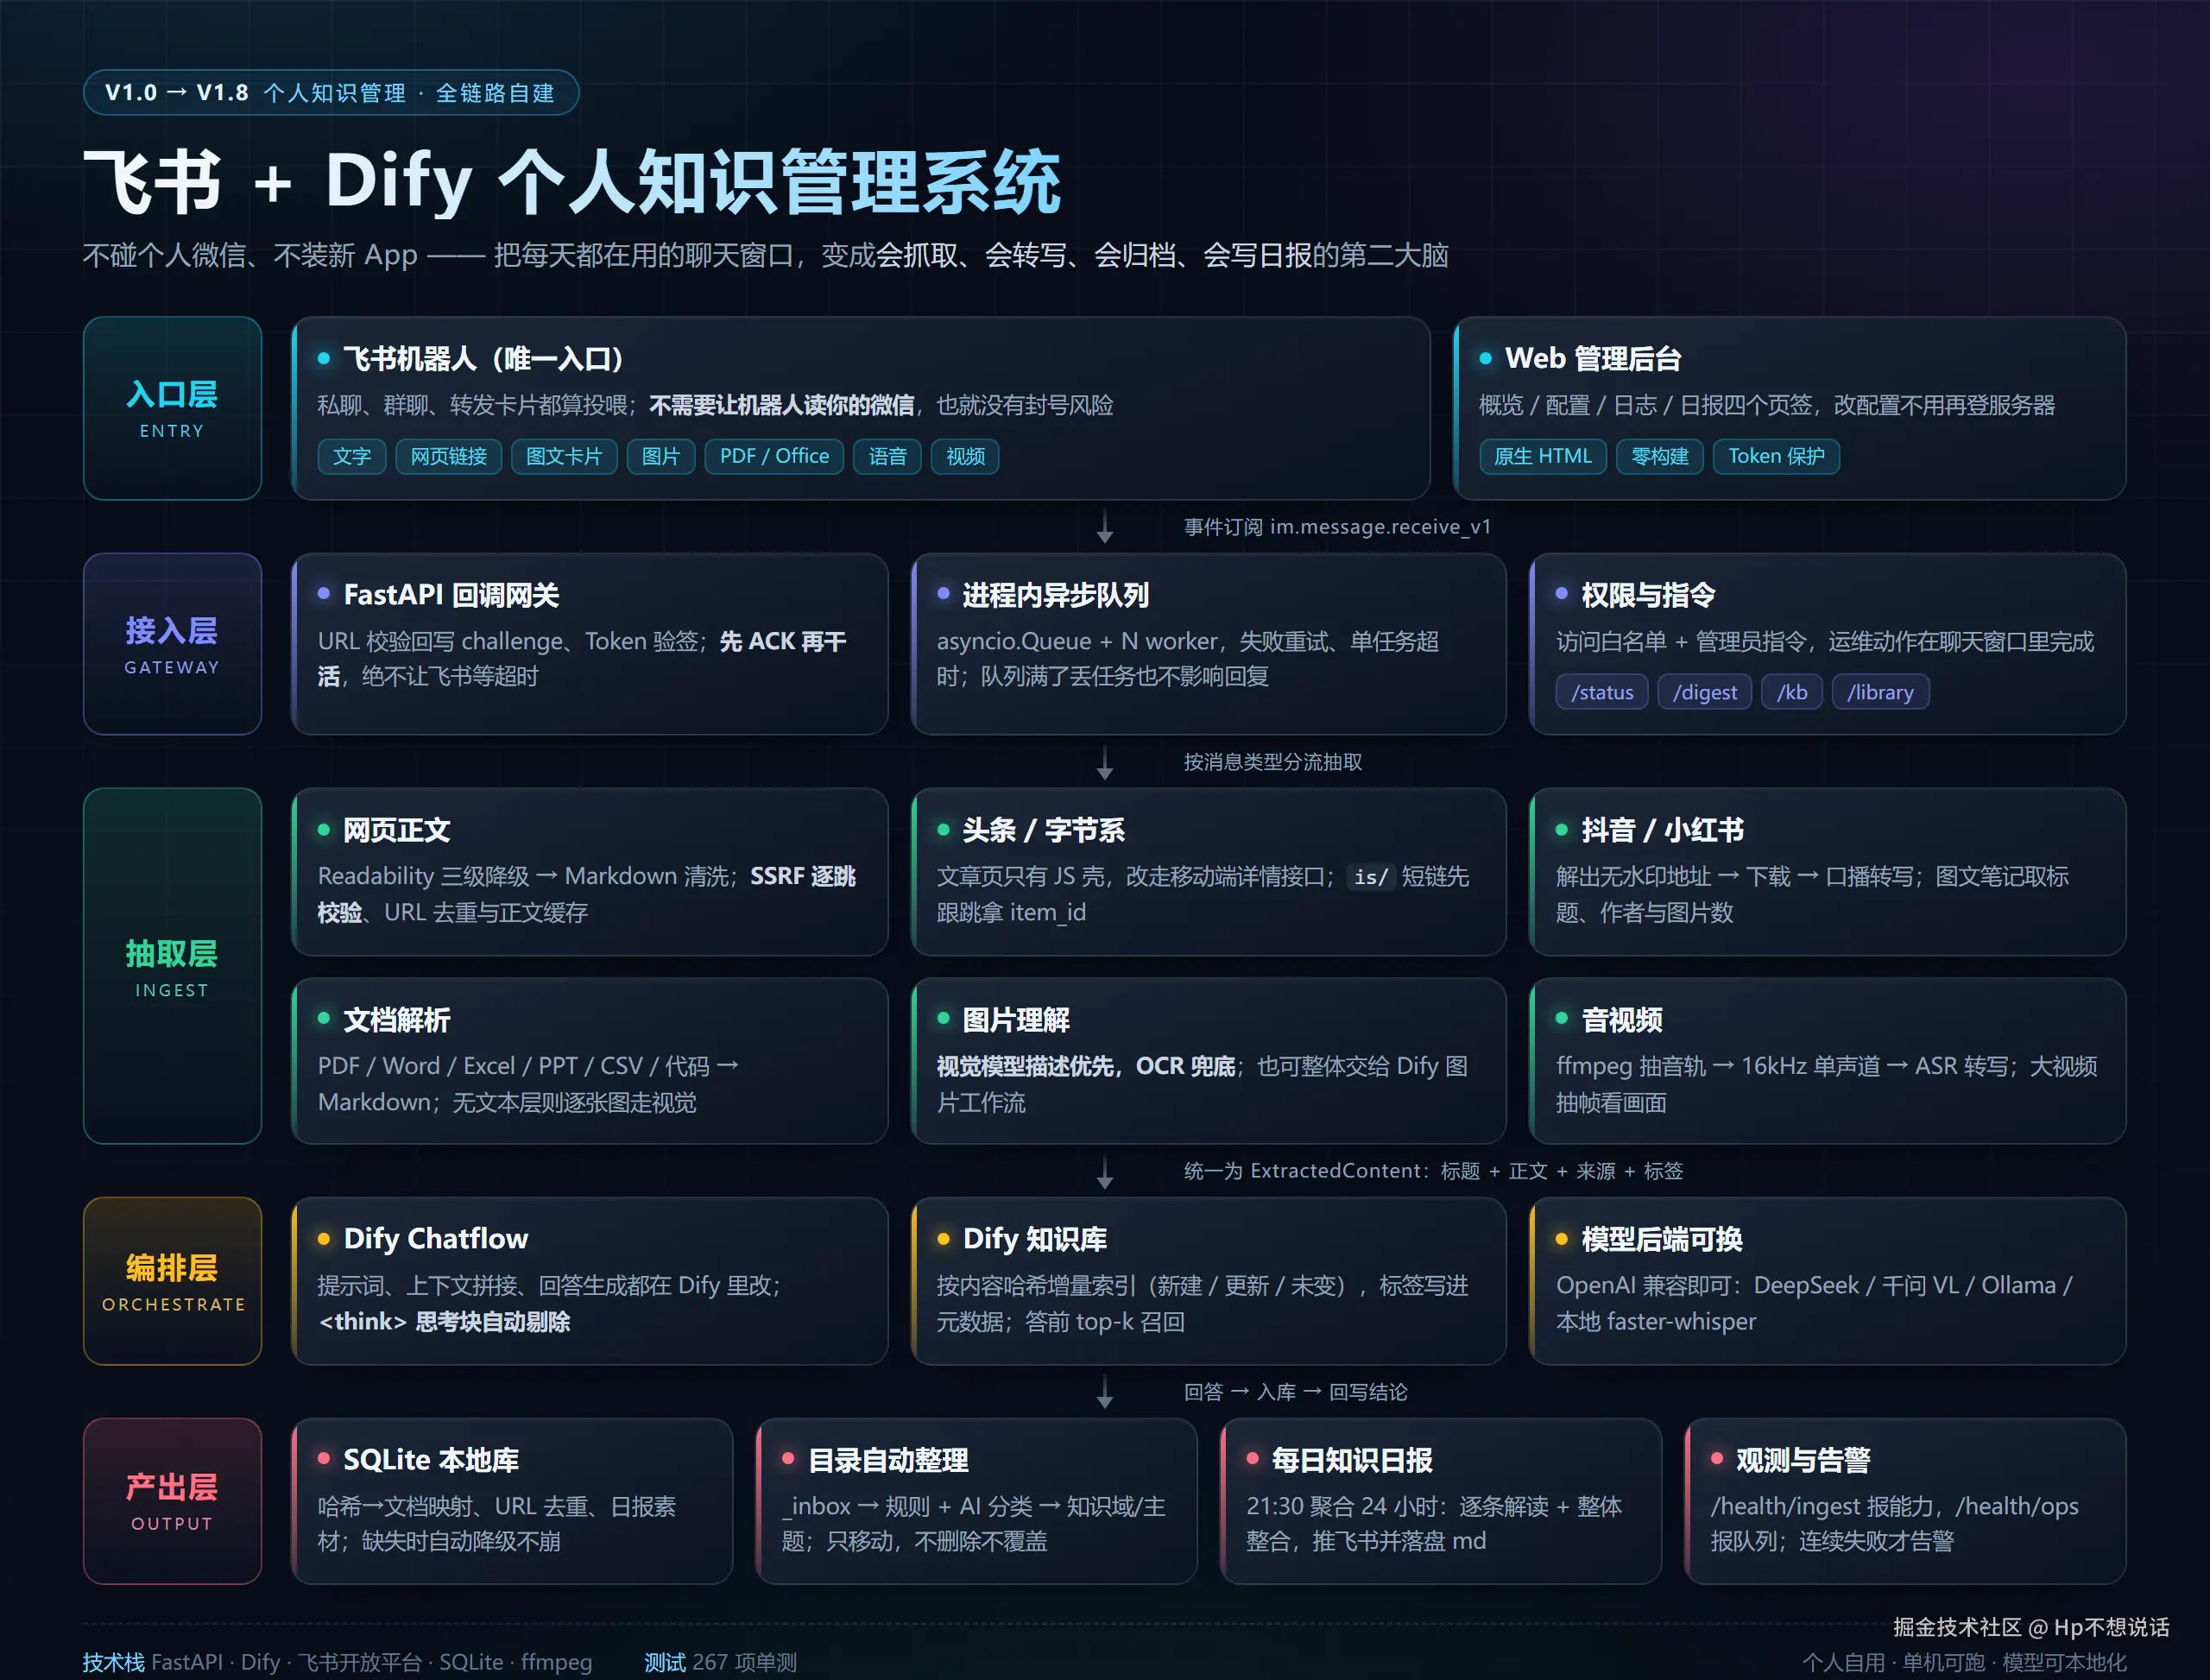
五层划分,从上到下:
| 层 | 职责 | 关键点 |
|---|---|---|
| 入口层 | 飞书机器人 + Web 管理后台 | 私聊/群聊/转发卡片统一入口;后台零构建,FastAPI 直接托管 |
| 接入层 | FastAPI 回调网关 + 异步队列 | 验签后立即 ACK,重活丢后台 |
| 抽取层 | 网页 / 头条 / 短视频 / 文档 / 图片 / 音视频 | 六条通道,最终收敛成一个数据模型 |
| 编排层 | Dify Chatflow + 知识库 + 模型后端 | 提示词不改代码;模型可换 DeepSeek / 千问 / Ollama |
| 产出层 | SQLite / 目录归档 / 日报 / 指标 | 去重映射、归档、复盘、可观测 |
设计上最关键的一条:抽取层对外只暴露一个统一结构。
从这里往后,业务代码不需要知道「这条内容是网页、是 PDF、还是一段语音」。这条约束带来的收益,在后续每加一种来源时都会体现一次。
三、链路拆解
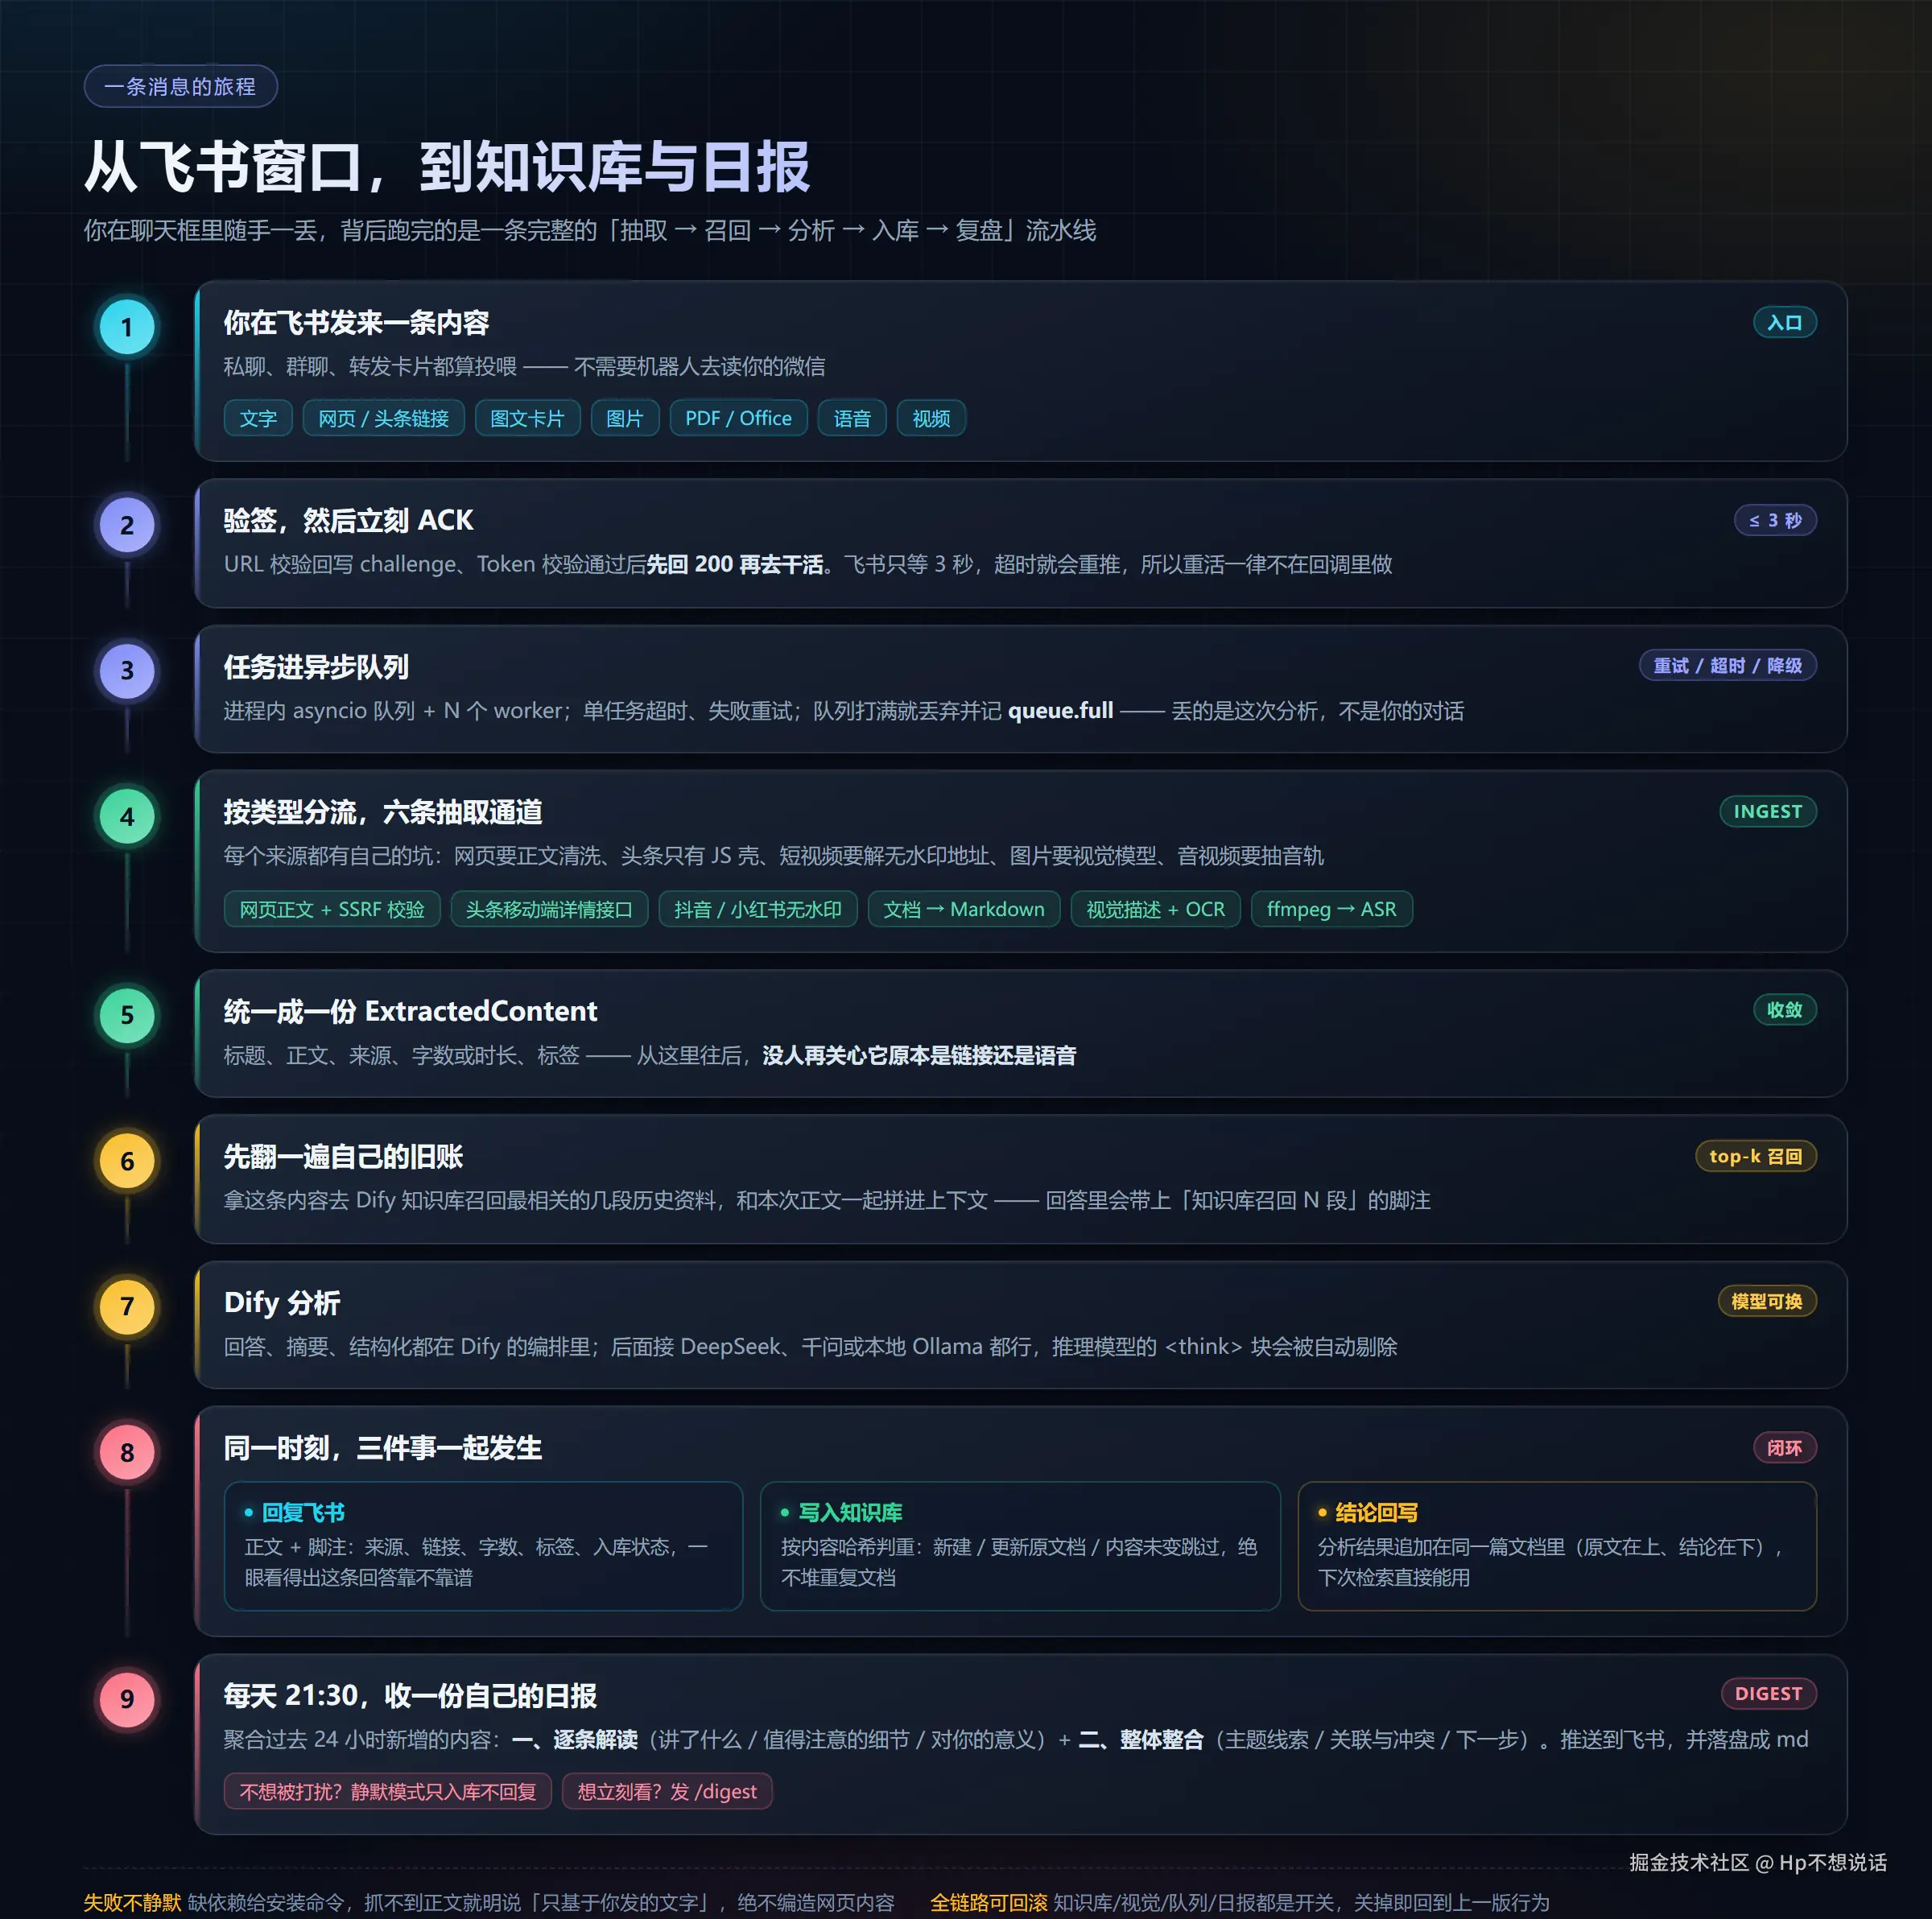
3.1 回调层:3 秒内必须返回
飞书的事件回调有超时限制(约 3 秒),超时会重推。所以回调里不允许做任何慢操作------下载 100MB 视频、跑十分钟语音转写,都不能出现在这个函数里。
骨架大致是这样(省略了日志与异常分支):
bash
@router.post("/event")
async def handle_feishu_event(
    request: Request,
    background: BackgroundTasks,
    settings: AppSettings = Depends(get_settings),
    feishu: FeishuClient = Depends(_feishu_client_dep),
    processor: KnowledgeProcessor = Depends(_processor_dep),
) -> dict[str, Any]:
    raw = await request.json()

    # 1) URL 校验:飞书保存回调地址时的一次性请求
    verification = extract_url_verification(raw)
    if verification is not None:
        if not verify_token(verification.token, settings.feishu):
            raise HTTPException(status_code=401, detail="invalid token")
        return URLVerificationResponse(challenge=verification.challenge).model_dump()

    # 2) 事件幂等:同一个 event_id 只处理一次
    if not get_event_deduper(settings.ingest.dedupe_db_path).begin(dedupe_key, payload_json):
        return {"code": 0, "msg": "duplicate"}

    # 3) 立刻 ACK,把重活交给后台
    background.add_task(_guarded_dispatch, feishu=feishu, processor=processor, ...)
    return {"code": 0, "msg": "ok"}
三个细节值得说:
(1)Token 校验用 hmac.compare_digest。 常量时间比较,避免时序侧信道;校验失败直接 401,不进业务。
(2)全局异常兜底必须存在。 FastAPI 抛 500 时,飞书会重试,如果错误是持续性的(比如密钥配错),就会形成无意义的重推风暴。这里统一捕获异常、记日志、返回 500 且不泄露密钥。
(3)BackgroundTasks 只是权宜之计。 它在同一个事件循环里执行,进程重启任务就没了。所以还叠加了一层「事件落库 + 重启恢复」,见下一节。
3.2 四道防线
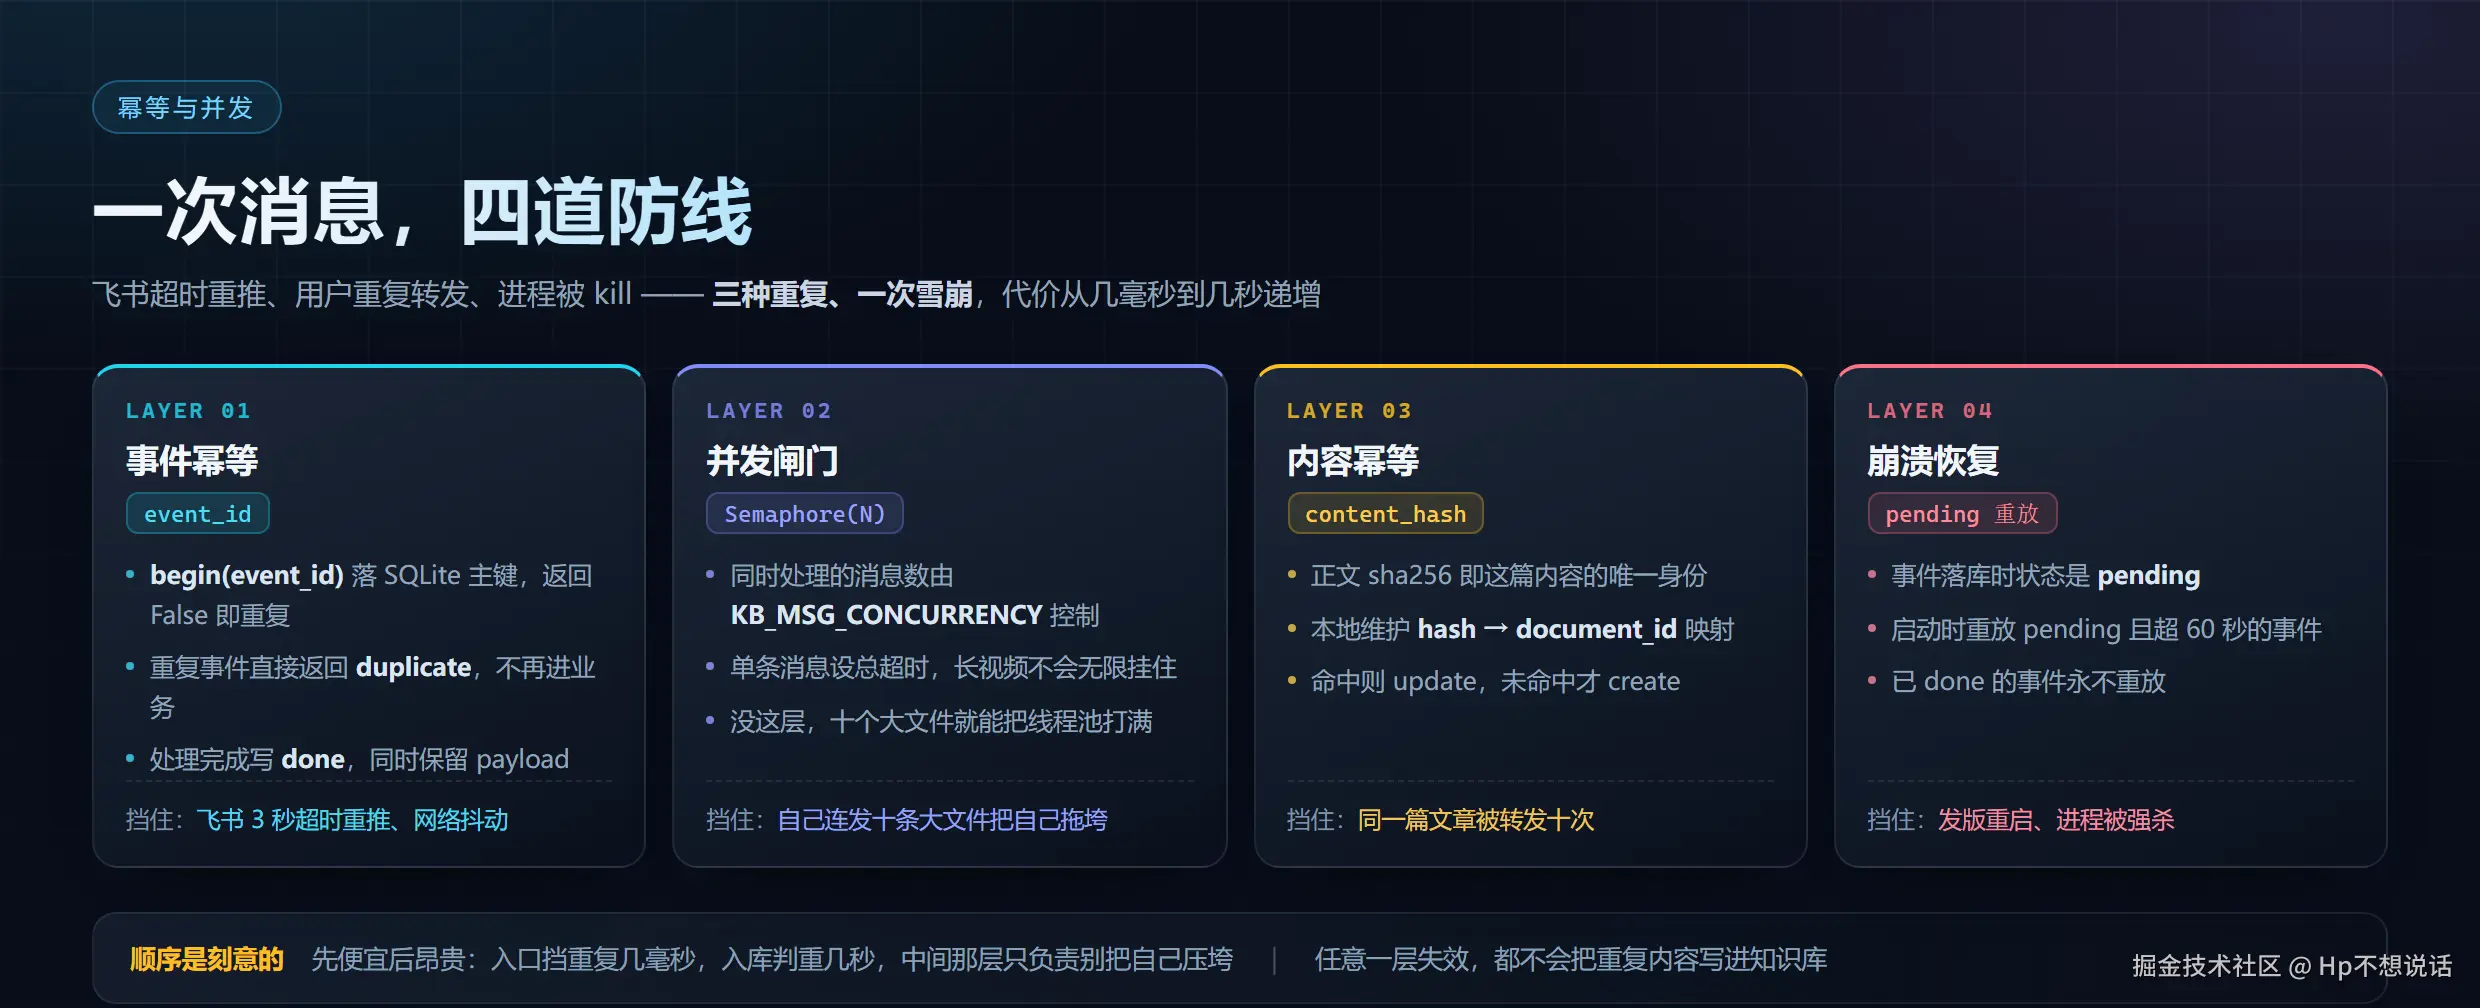
这条链路会碰到三种重复,外加一次「雪崩」:
事件层(毫秒级) :飞书超时重推、网络抖动。用 event_id 在 SQLite 里做主键,begin() 返回 False 就判定重复,业务层直接返回。
并发层(秒级) :用户连发十个大文件。加了 asyncio.Semaphore(KB_MSG_CONCURRENCY) 做并发闸门,再给单条消息设总超时。没有这层,十个大文件就能把默认线程池打满,后面的回调开始排队,直接撞上 3 秒超时。
内容层(秒级) :同一篇文章被转发十次。用正文的 sha256 作为内容身份,本地维护 content_hash → document_id 映射,命中就更新、没命中才新建。
恢复层 :事件落库时状态是 pending,处理完写 done。进程启动时把所有 pending 且超过 60 秒的事件重新派发------发版重启时正在处理的消息不会丢,已完成的也不会重放。
顺序是刻意的:先便宜后昂贵。入口挡重复只要几毫秒,入库前判重要几秒,中间那层只负责别把自己压垮。
3.3 抽取层:所有来源收敛到一个模型
网页、文件、图片、音视频,最终都产出同一个 ExtractedContent:
bash
@dataclass(slots=True)
class ExtractedContent:
    source_kind: SourceKind          # text / web / file / image / audio / video
    source_ref: str = ""             # URL 或文件名
    title: str = ""
    markdown: str = ""               # 优先字段,保留标题 / 列表 / 表格结构
    text: str = ""                   # 退化字段,markdown 为空时兜底
    content_sha256: str = ""
    from_cache: bool = False
    warnings: list[str] = field(default_factory=list)
    meta: dict[str, Any] = field(default_factory=dict)
    # 省略 mime_type / byte_size / binary 等字段

    @property
    def ok(self) -> bool:
        """是否存在可用正文。"""
        return bool((self.markdown or self.text).strip())

    @property
    def body(self) -> str:
        return self.markdown or self.text

    def context(self, max_chars: int) -> tuple[str, bool]:
        """生成喂给 Dify 的正文块,超出上限会截断并标注。"""
        return clip(clean_text(self.body), max_chars)
两个不起眼但很实用的属性:
ok:判断「有没有拿到可用正文」。抓取失败时上层据此走降级分支,而不是把空字符串丢给模型,再让模型编一段内容出来。context():截断时会在末尾补一行「内容过长,已截断」,避免模型误以为看到的是全文。
另外,模型输出和入库正文,都会先过一遍 strip_think_tags:
bash
_THINK_NAME = r"(?:think|thinking|reasoning|thought)"
# 成对出现
_THINK_BLOCK_RE = re.compile(
    rf"<\s*{_THINK_NAME}\s*>.*?<\s*/\s*{_THINK_NAME}\s*>", re.DOTALL | re.IGNORECASE
)
# 未闭合(流式被截断):标签之后全是思考过程,整段丢弃
_THINK_TAIL_RE = re.compile(rf"<\s*{_THINK_NAME}\s*>.*\Z", re.DOTALL | re.IGNORECASE)
推理型模型(deepseek-r1、qwq)或者 Dify 里带 Agent/ReAct 节点的工作流,会把思考过程写进 answer。不处理的话,用户看到的是模型的自言自语,而且这些内容会被一并写进知识库。
3.4 知识库:增量索引与结论回写
入库的核心就是这段分支:
bash
body = strip_think_tags(evidence.body)
content_hash = evidence.content_sha256 or sha256_bytes(body.encode("utf-8"))
tags = build_tags(evidence, user_remark=user_remark)
text, _ = _clip_for_kb(body, settings.max_chars)

known = await asyncio.to_thread(self._lookup, content_hash)

if known is not None:
    if not settings.upsert_enabled:
        return KbRecord(..., action="unchanged")   # 重复内容直接跳过

    # 重新抓取同一来源时,把上次的分析结论接回正文后面
    stored = await asyncio.to_thread(self._load_doc, content_hash)
    if stored is not None and stored[5]:
        text = _with_analysis(text, stored[5])

    await self._client.update_document_by_text(
        dataset_id, known[1], name=name, text=text, tags=tags
    )
    action = "updated"
else:
    created = await self._client.create_document_by_text(
        dataset_id, name=name, text=text, tags=tags
    )
    action = "created"
这里有几个刻意为之的设计:
哈希映射落在本地 SQLite,而不是只信 Dify。 即使知识库被重建,内容没变的消息也不会重复建文档。
更新时要把旧结论接回去。 否则「重新抓取 → 整篇替换」会把上一轮存进文档的分析结果抹掉。
标签写进文档元数据。 tags / source_kind / source_ref / content_hash 都通过元数据接口写进去;老版本 Dify 没有这个接口时自动跳过,不影响主流程。
回答之后还会回写。 每轮问答结束,把模型的结论以 【分析结果】 为界追加到同一篇文档:原文在上、结论在下。同一来源重复分析时整段替换,不会越堆越长。
这一条是整套系统里我最满意的部分------「AI + 知识库」的常见问题是结论散落在聊天记录里,而这里结论回到了知识库,下次检索能直接命中。
3.5 产出层:日报与可观测
- 日报:定时聚合过去 24 小时新增条目,两段式------「逐条解读」(讲了什么 / 有什么细节 / 对我意味着什么)+「整体整合」(主题线索 / 关联与冲突 / 下一步)。推送到飞书,同时落盘 markdown。
- 指标 :
/health/ingest报能力(哪些依赖装了、哪些没装),/health/ops报运行状态(队列积压、失败计数、SQLite 实现)。 - 告警:同一类操作连续失败 N 次才推送,触发后清零,避免刷屏。
四、12 个踩坑记录
这部分是我认为比架构图更有价值的内容。
| # | 现象 | 根因 | 处理 |
|---|---|---|---|
| 1 | 飞书保存回调提示「返回数据不是合法的 JSON」 | 阿里云 DNS 的「隐性 URL」是 iframe 嵌套、「显性 URL」是 302,都无法承载 Webhook | 改 A 记录 + Nginx 反代,路径与 POST body 原样透传 |
| 2 | 回调填 http 地址,飞书校验一直失败 | 301 重定向会把 POST 降级成 GET | 给该路径单独加 307,保留请求方法 |
| 3 | 头条链接抓不到正文 | 文章页只有 JS 壳(byted_acrawler),服务端渲染为空 |
改走移动端详情接口;is/ 短链先跟跳拿 item_id |
| 4 | 抖音 / 小红书链接拿到的也是空壳 | 页面 JS 渲染 + 签名接口 | 从 _ROUTER_DATA / __INITIAL_STATE__ 里取无水印地址、标题、作者 |
| 5 | 调用百炼 ASR 报 ReadError / 连接被掐断 |
百炼没有 /v1/audio/transcriptions 端点 |
用同步 ASR(chat/completions + base64),或用「上传 OSS + 异步任务」 |
| 6 | 传 base64 给 ASR 报 HTTP 400: url error |
用的是异步模型(fun-asr / *-filetrans),它只接受公网 URL |
自动切换到同步语音模型;坚持用异步就走 OSS 中转 |
| 7 | 本地 Whisper 报 转写失败:ReadError |
ffmpeg 输出到 pipe:1 时 WAV 头是 0xFFFFFFFF,PyAV 读不了 |
输出落临时文件,不走管道 |
| 8 | Dify 图片工作流报 img in input form must be a list of files |
工作流的文件变量是列表类型,传单个对象会 400 | 默认按数组传,单文件变量时自动改传对象 |
| 9 | 知识库写入一直失败,但应用本身能用 | 用了应用 API Key,而不是知识库 API Key | 在 Dify 知识库页面单独创建知识库密钥 |
| 10 | 回复里夹带 <think>推理过程</think> |
推理型模型 / Agent 节点的输出特性 | 回复与入库前统一剥离,含未闭合标签 |
| 11 | 服务启动即崩,报 No module named '_sqlite3' |
源码编译的 Python 缺 sqlite-devel,C 扩展没编出来 |
pip install pysqlite3-binary 并做回落;根治要重编译 |
| 12 | pip install 直接解码失败 |
requirements.txt 里的中文注释在 GBK 环境下被误读 |
依赖文件保持纯 ASCII 注释 |
再补两个不那么像「坑」、但影响很大的点:
大图片的 base64 有上限。 云端视觉接口普遍限制单文件 < 7MB,超过就得先压缩或转公网 URL。所以上传前会先缩放重编码,压不下去才退回 OCR。
<think> 未闭合的情况一定会遇到。 流式输出被截断、模型忘记收尾,都会留下半个标签。只做「成对匹配」是不够的,必须额外处理「标签之后整段丢弃」。
五、能力边界
自建系统最怕写成「什么都能做」。实际边界如下:
| 维度 | 现状 |
|---|---|
| 多用户 | 不支持。SQLite 单机,队列在进程内,适合个人自用 |
| 强依赖 | Dify 挂了,只剩一个会下载文件的爬虫 |
| 反爬 | 头条 / 抖音通道随时可能失效,属于持续维护成本 |
| 入口 | 只覆盖飞书,读不到微信、朋友圈 |
| 长音视频 | 45 分钟播客要转几分钟,超出上限会截断 |
| 分发 | 单机部署,没有多租户与统一元数据(PostgreSQL 待做) |
六、如何自检
这套系统在「缺依赖」这件事上刻意做了透明化,几个接口可以快速判断状态:
bash
# 能力自检:哪些能力可用、缺什么
curl http://127.0.0.1:8000/health/ingest

# 运行状态:队列、失败计数、SQLite 实现
curl http://127.0.0.1:8000/health/ops

# 抽取层离线自检:起本地 HTTP 服务跑真实链路,不需要飞书和 Dify
python scripts/smoke_ingest.py判断标准很简单:能力缺失时必须给出可执行的下一步。
少装 ffmpeg,不能只回一句「转写失败」,而要给出 apt install ffmpeg;没开文件下载权限,要指出去开放平台勾哪个权限;链接抓不到,要明说「以下回答仅基于你发送的文字」,并且约束模型不许编造。
这条原则看起来是体验问题,实际上是数据质量问题------一个静默失败的抽取器,会持续喂给模型一段空白。
七、小结
回过头看,这个项目真正难的不是接 Dify,也不是写爬虫,而是三件事:
- 把不可靠的输入变可靠:抓取会失败、转写会为空、模型会跑偏,每一处都要有降级路径和明确提示。
- 让重复操作变得安全:事件、并发、内容、重启,四层防护各管一段。
- 让结论回到数据里:回答不是终点,回写才是。知识库应该越用越厚,而不是越用越乱。
如果你也在做类似的东西,建议的顺序是:先把抽取层做扎实,再谈向量检索和编排。知识库的质量上限由抽取层决定,不是由模型决定的。
本文涉及的架构图、流程图与幂等设计图均为原创,代码片段为精简示意,省略了日志、异常与参数校验分支。