在上一篇《# 01 | 不做算法,做交付:我如何用全栈底子,切入大模型企业级落地?》里,我聊到了传统开发者在 AI 时代的切入点。
今天这篇,咱们不聊高深的算法和微调。我们要做的是:把大模型当做一个需要被严格管控的"超级微服务",给它套上一个企业级的 API 网关。
为什么要做这个?因为在真实的 ToB 交付中,如果让业务代码直接连接底层的模型接口,不仅面临极大的安全裸奔风险,一旦未来底层模型从 Ollama 换成 vLLM 甚至商业大模型,上层业务代码全部要重构。
所以,咱们的第一仗,就是用十几年沉淀的运维和全栈底子,在底层模型和业务系统之间,砌一堵"防撞墙"。
🏗️ 架构设计:用微服务思维解耦
这套架构非常简单,但完全遵循了生产环境的安全隔离原则:
- Nginx(边缘层) :处理跨域,反向代理。最重要的是,它必须解决流式输出(SSE)时的数据缓冲问题。
- Django(网关层) :负责
API Key鉴权,统一输入输出标准(完美兼容 OpenAI 格式),屏蔽底层差异。 - Ollama(算力层) :藏在 Docker 内部的
internal网络中,彻底断开外网,只允许网关层访问,防止算力被白嫖或接口被恶意攻击。
底层框架我选了 Django 5.0 + ASGI 异步模式,配合 httpx 库来处理请求。生产环境绝不能拿简单的阻塞式脚本来糊弄。
🔨 实战排雷:那些教程里永远不会告诉你的坑
代码很快就写完了,但这套环境在服务器上跑起来,真的是一波三折。下面是我这半天的真实排错记录,每一个坑都够折腾半天的。
💥 坑一:Docker 镜像拉取的"幽灵超时"
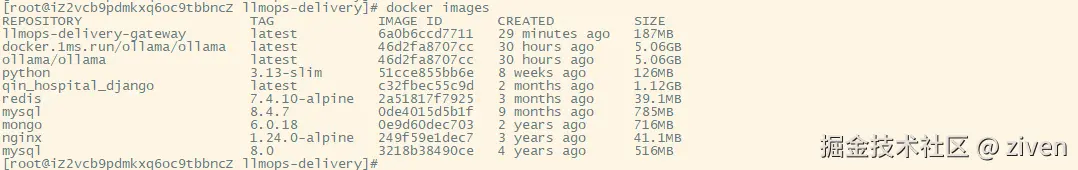
一开始直接跑 docker compose up,结果卡在拉取 ollama/ollama 镜像上,报错 context deadline exceeded。
排查与解决 :一看就是国内网络问题。我先清理了 Docker 悬空镜像和 2.7GB 的构建缓存。配置了加速源还是不行。最后直接换了带前缀的完整镜像源 docker pull docker.1ms.run/ollama/ollama:latest,拉下来后打个官方 Tag 骗过 Compose,才顺利过关。
💥 坑二:Ollama 的启动陷阱与内网预装载
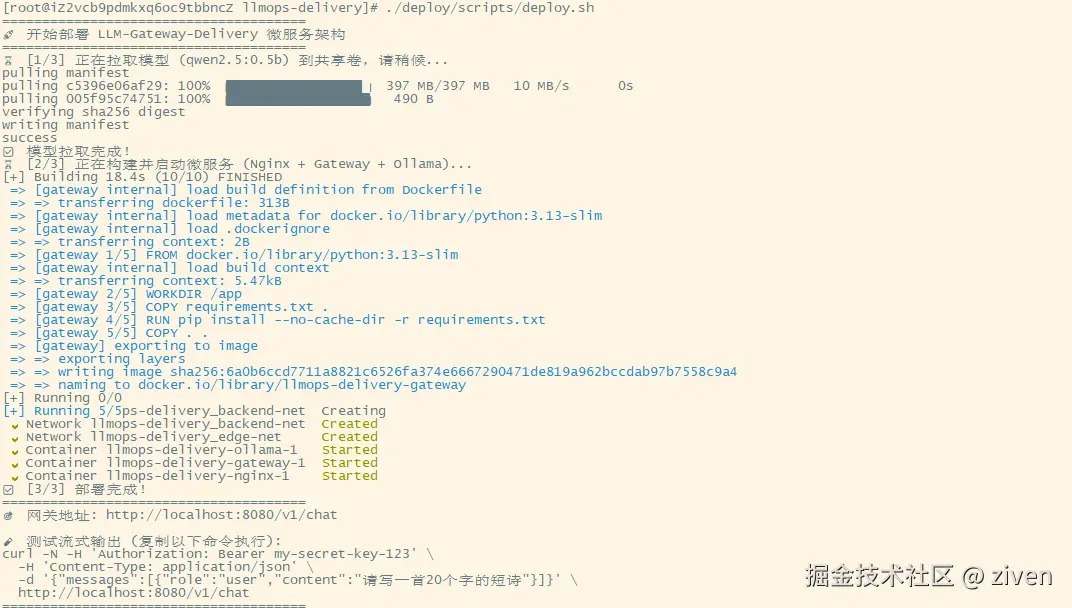
为了做内网隔离,我写了一个部署脚本。原本想通过 docker run --rm ollama/ollama ollama pull qwen 先把模型下到共享卷里。
结果直接报错:Error: unknown command "ollama" for "ollama"。
排查与解决 :查了文档才发现,官方镜像的 Entrypoint 默认就是 ollama,我又加了一个多余的命令。
更重要的是,因为容器的内部网络是断网的,不能直接拉取。最终我改成了"曲线救国":先用宿主机网络起一个临时的后台容器(serve),再通过 docker exec 进去执行 pull。模型下完后销毁临时容器。这样就算以后去了断网的政企机房,也能用这个脚本一键导入模型。
💥 坑三:Nginx 的"吞字"惨案
网关起起来了,鉴权也测通了,结果用 curl -N 测流式输出时,前端死活不出字,等了十几秒,突然一大段话一次性全糊在屏幕上,毫无"打字机"体验。
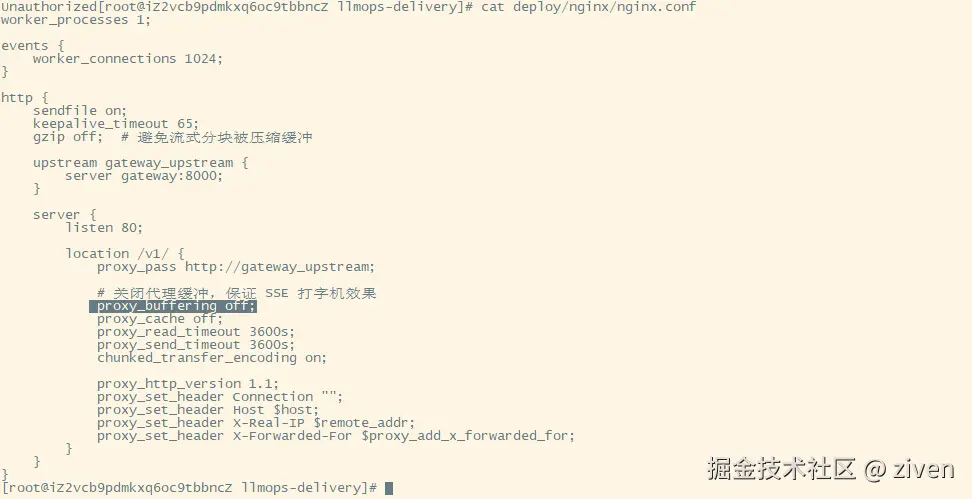
排查与解决 :老运维一眼就能看穿,Nginx 默认开启了 proxy_buffering。它在等后端把数据全部生成完,才一次性转发给客户端。
在 nginx.conf 里果断加上 proxy_buffering off;,并且强制使用 HTTP/1.1 传输。同时,在 Django 的 StreamingHttpResponse 响应头里加上 X-Accel-Buffering: no。再次测试,完美的流式输出回来了。
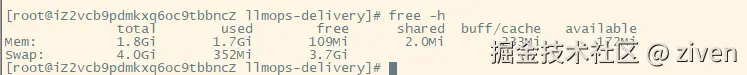
💥 坑四:1.8G 内存引发的 OOM 血案(最惨的一步)
前面的坑全填平了,满心欢喜地发出第一次请求,结果终端直接甩脸:
data: {"error": "{"error":"llama-server process has terminated: signal: killed"}"}
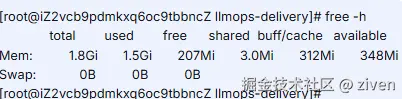
排查与解决 :signal: killed 只有一种可能------被 Linux 系统的 OOM Killer 杀掉了。
顺手敲了一下 free -h,好家伙,这台跑着测试环境的服务器,可用物理内存只剩 348M 了。模型一加载,内存瞬间撑爆。
立刻安排急救:用 fallocate 划了 4G 的 Swap 虚拟内存保底;然后去 docker-compose.yml 里限制 Ollama 的资源占用(设置 OLLAMA_NUM_PARALLEL=1 限制并发,把上下文长度砍到 1024)。
重启,再次 curl,终于稳稳地活下来了。
🎯 最终验收:这就是交付的底气
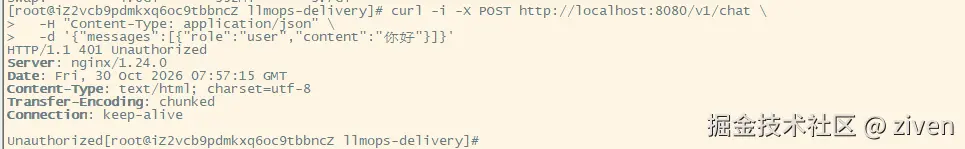
1. 鉴权防线拦截
不带 Token 直接裸奔请求?抱歉,网关直接打回原形,返回 401 Unauthorized。这道门禁,替企业挡掉了所有非法的算力白嫖。
2. 标准流式透传
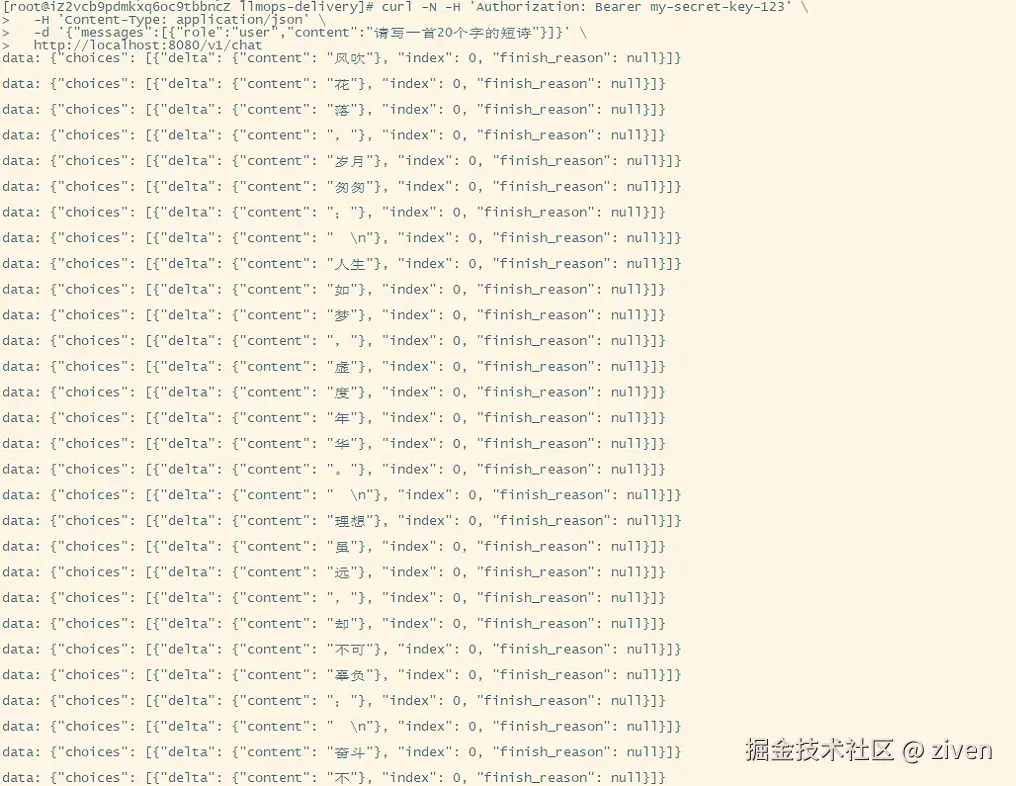
带上 Token,再次请求。看着终端里一行行规整地吐出 data: {"choices":[{"delta":{"content":"春"}}]},一块块流式数据完美穿过 Nginx,穿过 Django 网关,呈现在眼前。这一刻,这套网关算是彻底立住了。
💡 总结一下
弄完这一套,体会是:无论 AI 多么"高大上",当它被放进生产环境时,它就是一个吃显存、吃内存、需要安全隔离和限流的"服务端进程"。
高可用架构、容器隔离、网络穿透、甚至 Swap 虚拟内存,这些老掉牙的工程基座,在 AI 时代依然是一切的基石。
下一篇,我准备在这个网关后面接入 Qdrant 向量数据库,给它加上"外挂记忆"(RAG)。这堵墙既然砌好了,接下来就该上点真家伙了。
(本项目已开源在 Gitee,包含 deploy.sh 一键部署脚本,感兴趣的朋友可以拿去跑跑看。)