最难找的文件,往往恰好是当初命名最随意的那一个。
截图叫 Screenshot 2026-09-28...,照片还是 IMG_2107.jpg,一份有用的笔记混在几十个 Markdown 文件里。过了几周,我还记得里面写了什么、画面是什么样,却想不起文件叫什么。
这也是我开发 AnySearch 这个 macOS 原生搜索工具时,一直在解决的问题。最初的目标是更快地按文件名查找;后来更有意思的问题变成了:当文件名不再是线索时,搜索应该依赖什么?
这篇文章梳理一下这条演进路线:基础文件搜索、3.0 的文件全景与自然语言条件解析、为 3.2.0 实现的本地 AI 内容检索,以及为 3.2.1 准备的应用搜索。
先说明版本边界:应用搜索属于后续开发工作,本文不会把所有能力都当作已经在公开商店版本中上线。具体可用功能以当前版本更新说明为准。
一、先把精确搜索做好,不是所有问题都需要 AI
如果我知道目标是一张最近修改过的 PDF 发票,就不需要模型猜测,只需要这些条件能够准确地组合起来。
AnySearch 使用自己的本地 SQLite 索引,不依赖 Spotlight 的索引。文件系统变化通过 FSEvents 更新到索引里,因此搜索是在已有数据库上查询,而不是每次重新遍历目录。
普通搜索支持包含、前缀、后缀、精确匹配,也可以组合大小写、扩展名、大小、日期、目录和文件类别等条件。例如:
text
invoice ext:pdf modified:7d
report ext:pdf NOT draft size:>1mb
kind:image in:~/Downloads/
三行分别表达:
- 最近 7 天修改过、名称包含
invoice的 PDF; - 名称包含
report、排除draft、大于 1 MB 的 PDF; - 下载目录中的图片。
还可以使用 OR、引号短语、通配符和创建日期筛选,逐步缩小结果范围。
这里,可视化筛选和查询语法同样重要。日期、目录、扩展名应该是用户能看见、能修改的条件,而不是藏在某个排序算法里的假设。
二、"自然语言搜索"其实可能是两件不同的事
有个区别很容易被一张 AI 功能清单掩盖:把一句话转换成条件,不等于按内容含义检索。
3.0 中的自然语言查询,例如"查找上周大于 1 MB 的发票",由 Mac 上的确定性规则处理。程序识别支持的时间、大小、类别和目录表达,把它们转换成结构化过滤条件。
这让已有的搜索引擎更容易使用,但不意味着引擎已经能理解照片里的画面。
解析后的条件会显示为标签。如果严格条件没有结果,程序尝试放宽日期、目录或类别时,也会展示采用的策略,而不是偷偷换一个问题。
我希望保留这个区别:已知条件足够明确,就用可解释的精确筛选;真正缺少的是文件名线索时,再使用语义检索。
三、只记得内容,也应该能找到原文件
AI 演示里,一个直观的例子是 IMG_2107.jpg。
输入"戴墨镜的猫",描述的是照片内容,而不是文件名。在实际录制的演示中,程序找到了这张照片,并在右侧预览。
动图 1:用画面描述找照片,不依赖文件名。
演示中还有"支付失败的截图""吃火锅的发票""去杭州旅游的笔记"等查询。这些例子的共同点是:人对内容的记忆,通常比系统自动生成的文件名更有辨识度。
当然,这些是小规模准备素材上的功能演示,不是对任意个人文件库的检索准确率保证。
下面几段录屏分别展示不同类型的内容线索。
按场景找截图
动图 2:不需要记住截图的日期和自动生成的名称。
按用途找发票
动图 3:线索是发票对应的事情,而不是一长串文件编号。
不只找视频,还能定位到匹配画面
动图 4:查看匹配的视频时刻,也能对比同一主题下的图片。
按笔记内容找文档
动图 5:找到原文档后,直接在预览中确认是不是要找的那一份。
为 3.2.0 实现的本地 AI 搜索,将这个思路扩展到照片、截图、PDF 页面、文档段落、EPUB 书籍,以及音视频片段。可选的代码搜索使用 code: 前缀。对支持的结果,程序会展示匹配的页码、段落或时刻,而不是只扔给用户一个大文件。
底层做的是检索,不是让聊天机器人生成回答:
- 本地 embedding 模型把内容和查询编码成向量;
- 搜索引擎结合语义信号,以及文件名、提取文本、OCR 文字上的全文匹配;
- 返回原始文件,并尽量定位到命中的内容位置。
这两类信号需要互补。精确的标识符、少见的词,不应该因为另一份文件"语义上有点像"就被淹没;一张照片也不应该先手写好说明文字,才具备被搜索的资格。
四、"本地运行"需要讲清楚具体含义
AI 搜索在 Apple silicon Mac 上,通过 llama.cpp 运行 EmbeddingGemma 2。第一次使用需要下载约 865 MB 的模型文件,不是说一个体积很小的安装包里已经悄悄包含了所有模型。
模型安装完成后,AI 索引和搜索可以离线运行:
- 查询在 Mac 上编码;
- 提取的内容和向量保存在本地索引中;
- 只索引用户选择的目录;
- 不需要注册 AI 账户,也不需要配置 API Key。
模型下载站点会收到提供文件下载所必需的普通连接信息,但不会收到正在索引的文件内容或之后输入的搜索查询。
本地运行也不是没有成本:初次建索引需要时间,模型冷启动比热搜索慢,模型和索引占用磁盘,计算也会消耗内存和算力。
普通文件名搜索继续支持 Intel Mac;本地 AI 搜索要求 Apple silicon。音频检索也还有局限,当前实现中,中文口语音频的语义检索效果仍弱于文档和照片。
这些边界,比一句"什么都能搜到"更有参考价值。
五、索引还在更新时,搜索也应该能正常用
一个搜索框在静态演示中很快,并不代表它在真实建索引过程中也好用。
最近的一部分引擎工作,就在处理这些不显眼但影响体验的问题:
- 用户继续输入后,取消已经过时的查询;
- 新结果返回前保留现有列表,避免反复清空;
- 用户切换选中项后,不让旧预览覆盖新预览;
- 后台刷新向量时,不让交互查询排在刷新任务后面等待。
向量刷新现在会在后台构建独立的只读数据库快照。交互搜索继续使用当前快照,新快照构建完成后再切换。
一次本地回归测试使用了 18,668 个向量 ,8 个查询各重复 10 次。在后台刷新期间,检索延迟中位数从约 128 ms 降到约 10 ms。80 次前后对比中,返回文件与匹配片段的排序保持一致。
这里必须说明测量边界:查询向量已经提前生成,测的是检索和排队延迟,不包含模型编码、冷启动、输入防抖和界面渲染。不能据此宣称"任何 Mac 上的完整 AI 搜索都只需 10 ms"。
真正想达到的效果很朴素:修改查询、切换结果时,不要像是在和索引器抢使用权。
六、有时先看清文件分布,比直接搜索更有用
搜索默认我知道自己要问什么。File Landscape(文件全景)解决的是还不知道该从哪里找的问题。
3.0 引入的文件全景,会按类别、扩展名、大小、目录和最近活动汇总已索引文件,也提供大文件和可能重复项入口。点击统计项,可以回到主搜索并带上对应条件。
动图 6:从文件类型、空间占用切换到活动趋势,画面已裁掉个人目录区域。
它不是一个看完就结束的独立仪表盘,而是开始搜索的另一种方式。
这里也有两个限制:
- 统计对象是已授权、已索引的集合,不是对整个系统盘的完整扫描;
- "可能重复"基于文件名和大小提供候选,不代表已经验证文件内容完全一致。
对实际清理任务来说,这往往足够作为起点:先看空间主要被哪类文件占用,再检查大文件,最后决定如何处理原文件。
七、应用也有自己的"名字记不全"问题
后续为 3.2.1 准备的能力,是应用搜索。
人们记住一个应用的方式,可能是完整名称、简称、旧名称,也可能只是几个字母。匹配器因此支持名称、前缀、子串、有序缩写、有限的拼写容错,以及中文名称、拼音和拼音首字母。
应用已安装的前提下,例如:
| 输入 | 对应应用 |
|---|---|
gc |
Google Chrome |
msg |
Messages / 信息 |
vsc |
Visual Studio Code |
wx / weixin |
WeChat / 微信 |
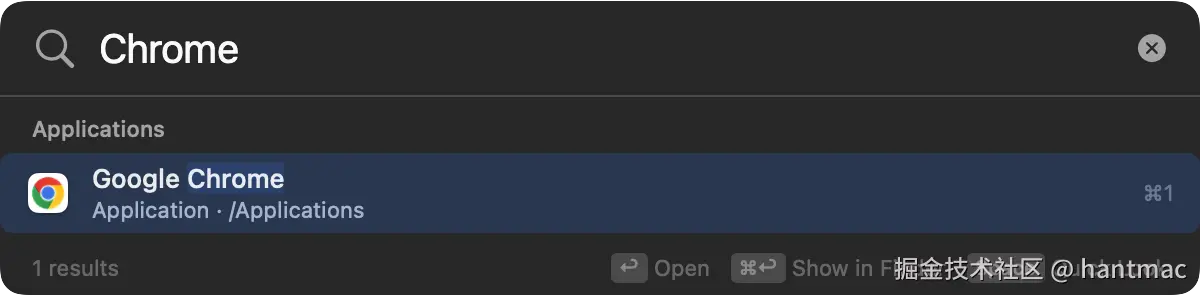
应用会出现在普通搜索和快捷面板中,与文件一起呈现。但输入 ext:pdf 这样的明确文件查询时,不应该混入无关应用。
这项工作的范围,比做一个命令启动器或插件平台小得多。它读取应用包元数据和本地化名称,不需要读取应用内部的用户业务数据。非标准安装目录需要单独授权,而不是绕过 macOS 权限。
八、找到结果,还不代表搜索任务完成了
无论是哪种搜索模式,我最终想保留的流程都是:
输入 → 辨认结果 → 确认内容 → 继续工作。
因此,文件名旁边要能看见所在目录,键盘选择要稳定,Quick Look 要方便调用,打开文件、在 Finder 中显示、复制路径和拖入其他应用这些动作,都应该容易触达。
如果正确结果已经出现,却还需要花一分钟确认它到底是什么,那么搜索问题并没有真正结束。
AnySearch 的方向,不是在每次查询前面都加一个 AI,而是根据用户还记得什么,使用合适的检索方式:
- 记得明确条件,就用文件过滤;
- 只记得内容,就按内容检索;
- 不清楚文件分布,就先看全景;
- 只记得应用缩写,也能找到对应应用。
如果想体验,应用在 Mac App Store 中的名称是 AnySearch Pro。后续 AI 和应用搜索能力的可用情况,请查看当前版本更新说明。
本文由 AnySearch 开发者撰写。截图和动图来自实际演示及开发版本,用于说明功能行为,不代表通用检索准确率评测。动图为录屏节选与压缩版本,不用于衡量端到端搜索耗时。