线程调度的职责,究竟应该由谁承担?
在 Android 开发中,我们经常会遇到一个问题:一个操作应该在哪个线程执行?
读取文件应该放到 IO 线程,复杂计算应该放到后台线程,更新 UI 则必须回到主线程。这些规则并不复杂。真正值得思考的是:线程切换的责任,究竟应该由谁承担?
在我看来,线程调度不应该成为上层业务代码的负担,而应该成为底层 API 设计的一部分。
Java 时代,我们通常通过 @WorkerThread 注解或者异步回调来表达线程执行要求。前者把线程调度的责任交给调用方,后者则通过回调组织异步流程。
Kotlin 协程则提供了一种不同的思路:通过 suspend 函数和上下文机制,让执行环境可以成为 API 的内部实现细节。
这就是我所说的:
Java 线程自上而下,Kotlin 协程自下而上。
这里的"上下",不是指线程的执行方向,而是指线程调度职责的组织方式。这是一种架构设计上的概括,并不是 Java 与 Kotlin 的绝对区别。
一、Java:调用方经常需要关心线程
在传统 Android Java 开发中,处理耗时操作通常有两种思路。
1. 阻塞方法:通过注解告诉调用方
先看一个常见的例子:
typescript
@WorkerThread
public User getUser() {
    return database.userDao().getUser();
}
这里的 @WorkerThread 是一种线程约束声明。
它告诉调用方:这个方法可能执行耗时操作,不应该在主线程调用。
但需要注意,注解本身不会切换线程,也不会自动创建后台任务。
调用方仍然需要自己安排执行环境:
ini
executor.execute(() -> {
    User user = repository.getUser();
    mainHandler.post(() -> {
        updateUI(user);
    });
});
整个过程需要调用方负责:
- 选择合适的线程池
- 提交后台任务
- 获取执行结果
- 切换回主线程
- 更新 UI
也就是说,底层 API 只是声明了执行要求,真正的线程调度责任仍然在调用方。
2. 异步回调:底层处理异步,调用方接收结果
另一种常见方式是异步回调:
scss
public void getUser(Callback<User> callback) {
    executor.execute(() -> {
        User user = database.userDao().getUser();
        mainHandler.post(() -> {
            callback.onSuccess(user);
        });
    });
}
调用方:
sql
repository.getUser(new Callback<User>() {
    @Override
    public void onSuccess(User user) {
        updateUI(user);
    }
});
这种方式将线程调度封装在了 API 内部。
调用方不需要自己创建线程,也不必手动切换主线程,只需要实现回调。
但随之而来的问题也很明显:
- 异步流程被拆分成多个回调
- 多个异步操作组合起来容易形成回调嵌套
- 异常处理需要额外设计
- 取消任务和管理生命周期需要额外机制
当然,Java 也有 Executor、Future、CompletableFuture 等更高级的抽象,可以改善这些问题。
问题不在于 Java 没有抽象能力,而在于传统异步编程方式容易让调用方参与异步任务的编排。
阻塞方法 + 线程注解,调用方负责安排线程;异步回调,调用方负责组织回调流程。
这两种方式都存在各自的设计成本。
二、Kotlin 协程:让底层封装线程切换
再看 Kotlin 协程:
kotlin
suspend fun readData(): String =
    withContext(Dispatchers.IO) {
        readFile()
    }
这里有一个关键变化。
readData() 的调用方不必知道文件读取需要切换到 IO 调度器。它只需要调用:
ini
val data = readData()底层负责执行环境的切换。
当 withContext 中的操作完成后,协程会恢复到调用它时所对应的上下文继续执行。
调用方不需要自己编写回调,也不必手动切回原来的线程。
需要注意,suspend 本身并不意味着切换线程。真正负责线程调度的是 withContext(Dispatchers.IO)。
再看一个没有进行线程切换的挂起函数:
kotlin
suspend fun readData(): String {
    return readFile()
}
它虽然是挂起函数,但并没有指定新的执行上下文。如果调用它的协程运行在 Main,那么其中的普通代码默认也会在 Main 执行。
因此,不能简单地认为所有 suspend 函数都是后台执行的。
这里还有一个值得强调的设计原则:
挂起函数应该尽可能保证 Main-safe。
也就是说,调用方即使在主线程调用这个 API,底层也应该通过合适的执行机制,避免阻塞主线程。
例如:
kotlin
suspend fun readData(): String =
    withContext(Dispatchers.IO) {
        readFile()
    }
调用方不需要关心内部使用什么调度器,只需要关心业务流程。
协程没有消除线程调度,而是让线程调度可以被封装在 API 内部。
这才是值得关注的变化。
三、两种模式的对比
把两种思路放在一起看,差异会更清楚。
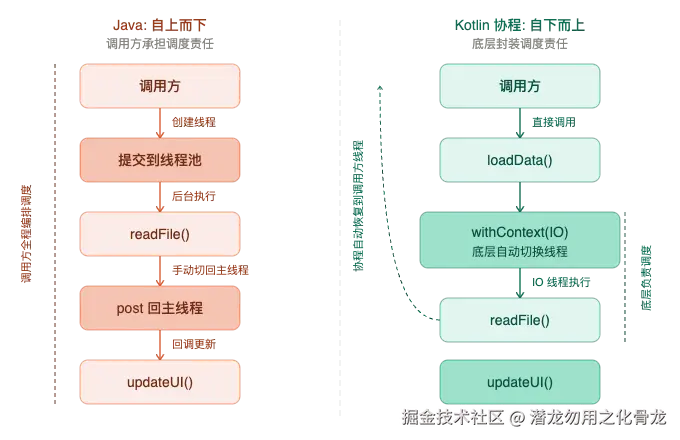
Java:调用方编排调度
ini
executor.execute(() -> {
    String data = readFile();
    mainHandler.post(() -> {
        updateUI(data);
    });
});
调用方需要:
提交任务到线程池 → 获取执行结果 → 手动切回主线程 → 更新 UI。
每一步调度都写在调用处。
Kotlin 协程:底层封装调度
kotlin
suspend fun loadData(): String =
    withContext(Dispatchers.IO) {
        readFile()
    }

viewModelScope.launch {
    val data = loadData()
    updateUI(data)
}
loadData() 内部负责 IO 调度,调用方只需要关注什么时候加载数据,以及拿到数据之后做什么。
如果 viewModelScope 在主线程启动,且后续没有其他上下文切换,那么 loadData() 返回后,协程会恢复到主线程继续执行。
两者的区别不是 Java 不能封装线程,也不是 Kotlin 协程一定会自动切换线程。真正的区别是:我们可以利用协程,把调度责任放到更合适的抽象层中。
▼ 流程图:Java vs Kotlin 线程调度职责对比
四、为什么这件事对 Android 架构很重要?
假设一个项目有以下调用关系:
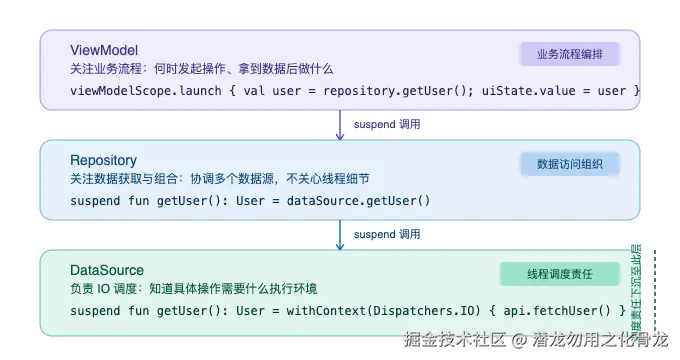
ViewModel → Repository → DataSource
如果每一层都需要关心具体线程,业务逻辑就很容易被调度细节污染。
例如,ViewModel 知道数据库操作需要 IO,Repository 知道网络请求需要 IO,DataSource 也在进行线程切换------线程职责分散,维护困难。
换一种方式。
ViewModel------关注业务流程:
ini
viewModelScope.launch {
    val user = repository.getUser()
    uiState.value = user
}
Repository------关注数据获取与组合:
kotlin
suspend fun getUser(): User {
    return dataSource.getUser()
}
DataSource------负责执行环境要求:
kotlin
suspend fun getUser(): User =
    withContext(Dispatchers.IO) {
        database.userDao().getUser()
    }
这样,每一层的职责就更加清晰:
- ViewModel 决定何时发起操作
- Repository 负责数据访问的组织
- DataSource 了解具体操作的执行要求,并在必要时负责调度
例如,Retrofit 的挂起 API 本身就有异步执行机制,Room 也有自己的线程管理策略,并不需要开发者无条件再套一层 withContext(Dispatchers.IO)。
具体放在哪一层,应当由操作性质和架构职责决定。
但有一条原则值得坚持:
谁最了解操作的执行要求,谁就应该负责保证它满足相应的执行要求。
▼ 流程图:三层架构中的调度职责分布
五、协程带来的不只是代码简洁
如果我们只把协程理解成一种更好用的异步写法,就低估了它的价值。
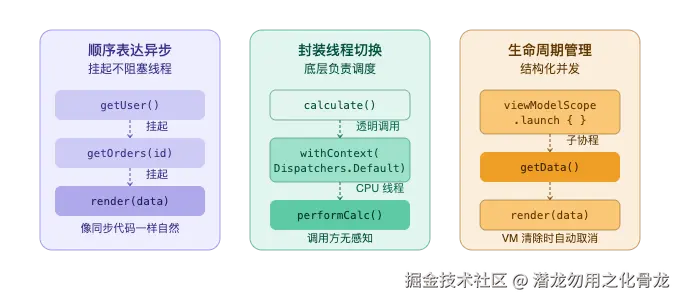
协程至少带来了三个重要的设计能力。
1. 顺序表达异步流程
ini
val user = repository.getUser()
val orders = repository.getOrders(user.id)
代码看起来像同步调用,但挂起函数可以在等待结果时挂起协程,而不是阻塞当前线程。
开发者可以用更自然的顺序组织异步业务。
2. 封装线程切换
kotlin
suspend fun calculate(): Result =
    withContext(Dispatchers.Default) {
        performCalculation()
    }
计算逻辑知道自己需要适合 CPU 密集型任务的执行环境,调用方不必重复编排线程切换。
3. 管理异步任务的生命周期
kotlin
viewModelScope.launch {
    val data = repository.getData()
    render(data)
}
当 ViewModel 清除时,其作用域中的协程会被取消。
这让异步任务的生命周期能够与业务组件建立联系,而不是依赖开发者手动管理每一个线程。
当然,结构化并发也不是无条件生效的:底层 API 需要正确传播取消信号,不能随意吞掉 CancellationException,也不应该把工作偷偷启动到脱离调用方生命周期的作用域中。
▼ 流程图:协程带来的三个设计能力
总结
从 Java 到 Kotlin 协程,我越来越关注的不是少写了多少行代码,而是代码应该由谁负责。
Java 时代,阻塞方法通过 @WorkerThread 告诉调用方线程要求,异步回调通过 Callback 组织异步流程。调用方往往需要参与线程安排或者异步任务编排。
Kotlin 协程则让我们有了另一种选择:通过 suspend 函数和协程上下文,将执行环境的要求封装在 API 内部。
线程是执行任务的资源,协程是组织挂起、恢复与异步任务的一种编程机制。
当我们开始使用协程时,不应该只想着把 Thread 换成 launch,也不应该把所有业务代码都塞进 withContext。
更重要的是,重新审视每一层的职责。
上层不应该知道的细节,就尽可能封装在底层;底层知道的执行要求,就由底层合理地承担调度责任。