💡 一句话总结:Google 和港大的 VeriCUA 把「判定计算机操作智能体是否真完成任务」从一次模型调用打分,升级成一套会主动取证的验证流程------先勘察环境再定验收标准,GUI 和代码两条通道找证据,按证据可信度规则仲裁。五个基准全部领先,假阳性率最多砍到基线的四分之一。做 agent 评测、RL 奖励、数据筛选的人都该看看。
先问一个可能戳到你的问题:你训 agent 的时候,有没有怀疑过训练集里那些「成功」轨迹?
比如你让智能体「把这段笔记保存到备忘录」,它操作了一通,界面上明明显示着笔记内容,于是它报告:任务完成。轨迹看着没毛病,验证器打了个勾,这条样本就进了你的 RL 奖励池或者 SFT 数据集。
但它保存了吗?
没保存。编辑根本没落盘,界面只是「看起来对」。等你哪天排查为什么模型学会了「假装完成任务」,这条轨迹还在数据集里躺着呢。
这不是玄学,是 Google、香港大学这篇 2026 年 10 月的新论文 VeriCUA 的出发点。论文标题直译过来是「VeriCUA:面向计算机操作智能体的验证即智能体探索」,一句话概括:别再让验证器当看截图的裁判了,让它当会翻文件、查数据库、放大截图的取证员。
想看原文?资源在这:
- 📄 论文:arXiv 2610.40578
这篇论文到底想解决什么问题?
计算机操作智能体(CUA,Computer-Using Agent,就是替你点鼠标、敲键盘操作软件的智能体)这两年火得一塌糊涂,但它的训练和评估全都压在同一个原语上:任务完成判定。
判定不准会坏三件事:
- 评测失真:benchmark 的成功率是假的,你根本不知道模型真实水平;
- 数据被污染:轨迹合成管线靠验证分数筛样本,「假完成」混进训练集,模型直接学坏;
- RL 奖励投毒:强化学习的奖励信号来自完成判定,假阳性等于给错误行为发奖金。
那现在的自动验证都是怎么干的?两条主流路线,各有一个致命盲区。
第一条是 VLM 评委:把轨迹截图和动作日志喂给一个多模态模型,让它一次调用打个分。问题是它只能看「被喂进来的画面」------文件是否真的保存了这种事,截图里根本拍不到。
第二条是自动生成验证脚本:让模型给每个任务写个检查程序去读机器状态。听起来挺好,但脚本写之前没人勘察过这个应用------查错了目录、问错了数据库,得到的答案是错的还浑然不觉。
论文里最扎心的对照发生在 ScienceBoard(一个科学软件桌面环境基准)上:自动生成验证器假阳性率 21.7%,因为它不认识那些冷门软件,查状态全靠猜;而 VeriCUA 先勘察应用再生成检查,假阳性率只有 5.4%------差不多是前者的四分之一。
那怎么办?作者的答案是把「验证」从一次性的裁判行为,变成一个动态的侦查过程。
它的思路是什么?
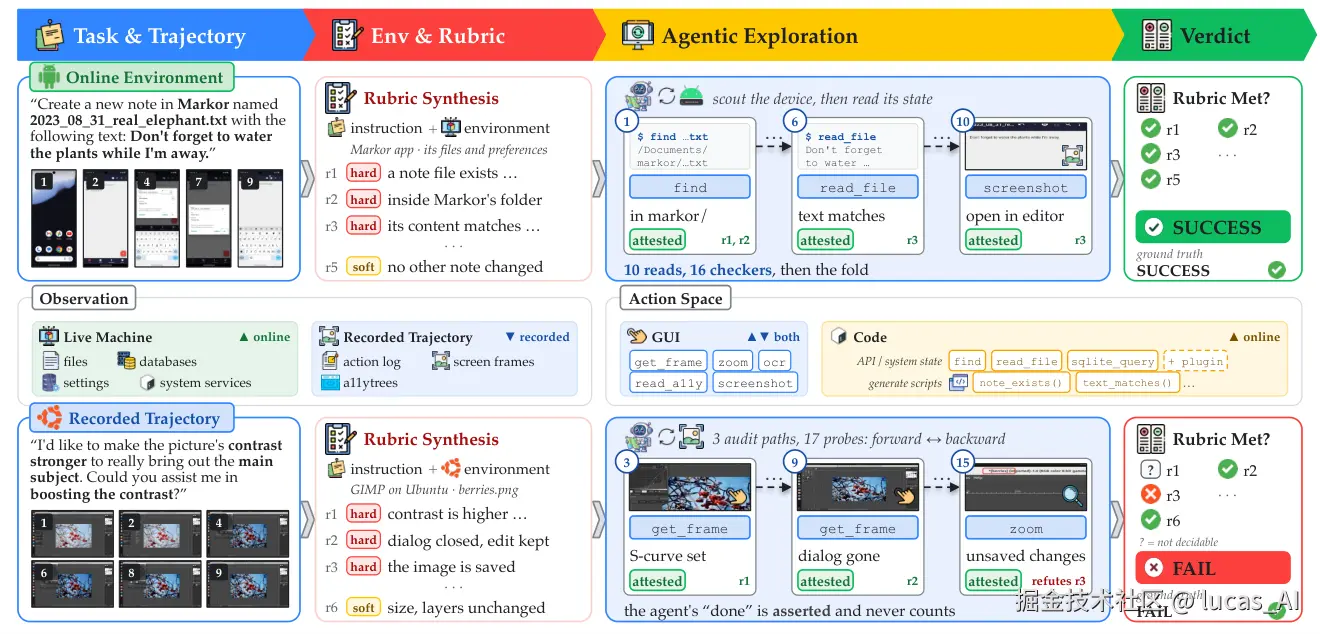
VeriCUA 的核心动作是:在执行智能体跑完之后,启动一个验证智能体,走四步流程。整个设计可以用验收装修来类比:装修工人说「刷完漆了」,你不能光听他说(asserted 证据),得自己看墙(GUI 检查),还得查油漆桶的余量和进货单(代码检查持久化状态),两边的证据都对上了才算验收通过。
第一步:先勘察,再定标准
验证器拿到任务指令后,第一件事不是打分,而是用检查工具勘察现场------线上就摸清这个应用有哪些包、数据存在哪些目录、数据库的 schema 长什么样;线下就通览录制下来的操作步骤和可用画面。
为什么要多这一步?因为指令只说「保存笔记」,不说这个应用的笔记存在哪、在哪个界面能看出来存没存。不勘察就定验收标准,会定出一些应用根本做不到的要求------比如假定它有个「已保存」的徽标。
勘察完,验证器把指令翻译成一份评分细则(rubric) :一组可核查的具体要求,每条标注 hard(必须满足才算成功)或 soft(附加检查)。关键是:找到的证据存放位置只是取证地点,不会被算成额外的成功条件------这个区分让验收标准始终忠实于用户的原始指令。
第二步:GUI 和代码两条腿取证
定了标准就进入取证循环。VeriCUA 的动作空间覆盖三类「案发现场」:
- 轨迹:智能体操作时留下的录屏帧、动作日志、思考记录------它「当时看到了什么、做了什么」;
- 表层:此刻机器界面的新鲜截图、UI 层级结构------现在屏幕上是什么样;
- 持久化状态:文件、应用数据库、系统设置------真正落到磁盘上的效果。
GUI 工具负责视觉检查:选帧、区域放大、OCR。代码工具负责状态检查:读文件、查 SQLite、问系统服务,一共 17 个只读动词。线上模式还能更进一步,把一串只读操作加一个判定谓词打包成「检查器」,一次执行。
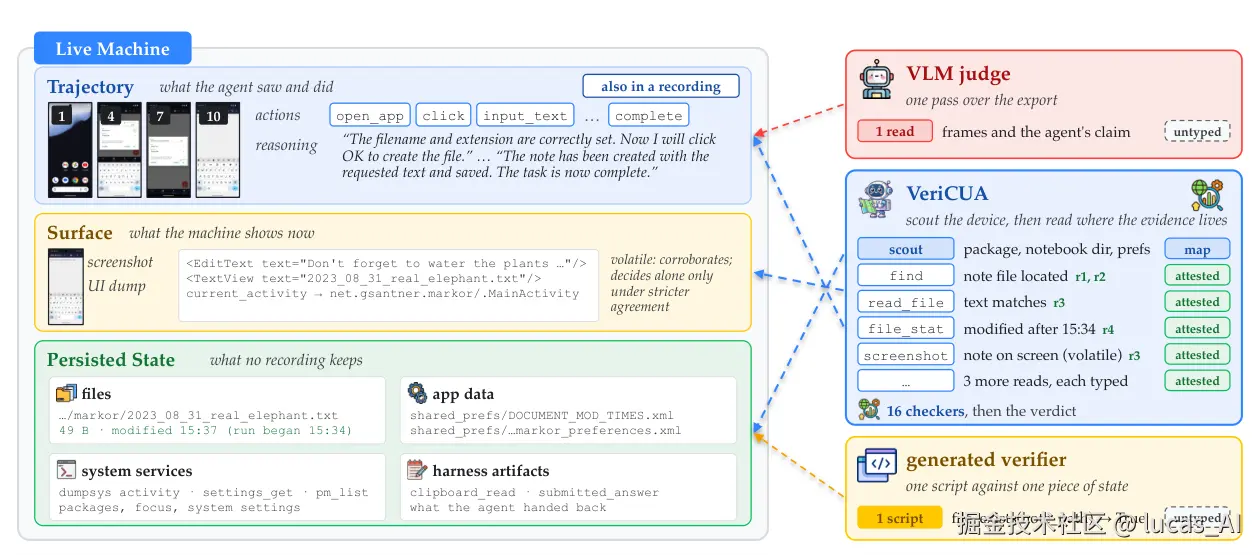
这三类现场回答的是不同的问题:动作日志只能证明「尝试过编辑」,新鲜截图能证明「屏幕上现在是编辑后的内容」,文件读取才能证明「内容真的写进磁盘了」。这就是为什么单通道验证必然有盲区。
第三步:给证据分级,这是全文最值得抄的设计
取证回来的每条发现,都要过三道纪律:
- 有据可查:每条发现必须引用一次真实执行过的检查,引用对不上执行记录的会被执行层直接拒收------不许凭空断言;
- 分清证词与物证 :证据分两等,attested(物证:动作后的截图、文件读取、数据库查询这类对任务状态的直接观测)和 asserted(证词:智能体自己说「我做完了」、动作前的帧证明它「打算做」)。证词可以引导侦查,但永远不能单独把要求标记为完成;
- 记录来源属性:这次读取查的是持久化状态还是易变状态?这帧截图在目标动作之前还是之后?这些属性决定了它能支撑哪种推断。
最后由一个确定性的仲裁器按规则合议:全部 hard 要求有物证支持 → success;任何 hard 要求被多个独立探针证伪 → fail;证据不够 → 弃权(线上)或者用预先封存的「初判」兜底(线下)。注意这个设计:宁可不判,也不乱判。
线上线下,同一套流程
妙的是这套流程线上线下通用:线上验证器能直接访问机器状态,GUI 加代码全开;线下只有录制好的轨迹,就派多条审计路径正着找支持、反着找反驳。接口统一成「只读动词 + 证据类型 + 来源属性」,接一个新数据源只需要声明它的动词和证据类型,下游全部复用。
效果到底怎么样?
验证器全部跑在同一个骨干模型(gemini-3-flash-preview)上,五个基准、线上线下两种设置,结论相当一致:VeriCUA 全部第一,而且优势集中在最值钱的地方------假阳性。
线上三个环境(AndroidWorld、OSWorld、ScienceBoard)的完整对局里,最亮的三组数字:
- AndroidWorld:VeriCUA 准确率 90.5%,假阳性率 7.7%,对比 VLM 评委的 15.4% 和自动生成验证器的 16.9%------错杀率直接砍半再砍半;
- ScienceBoard:假阳性率 5.4%,是自动生成验证器(21.7%)的四分之一,准确率却高出近 10 个点(86.4 vs 76.9);
- 决策准确率:VeriCUA 在敢下判断的任务上准确率 88.7%~95.1%,因为它会弃权------证据不足就交白卷,而不是硬编一个答案。
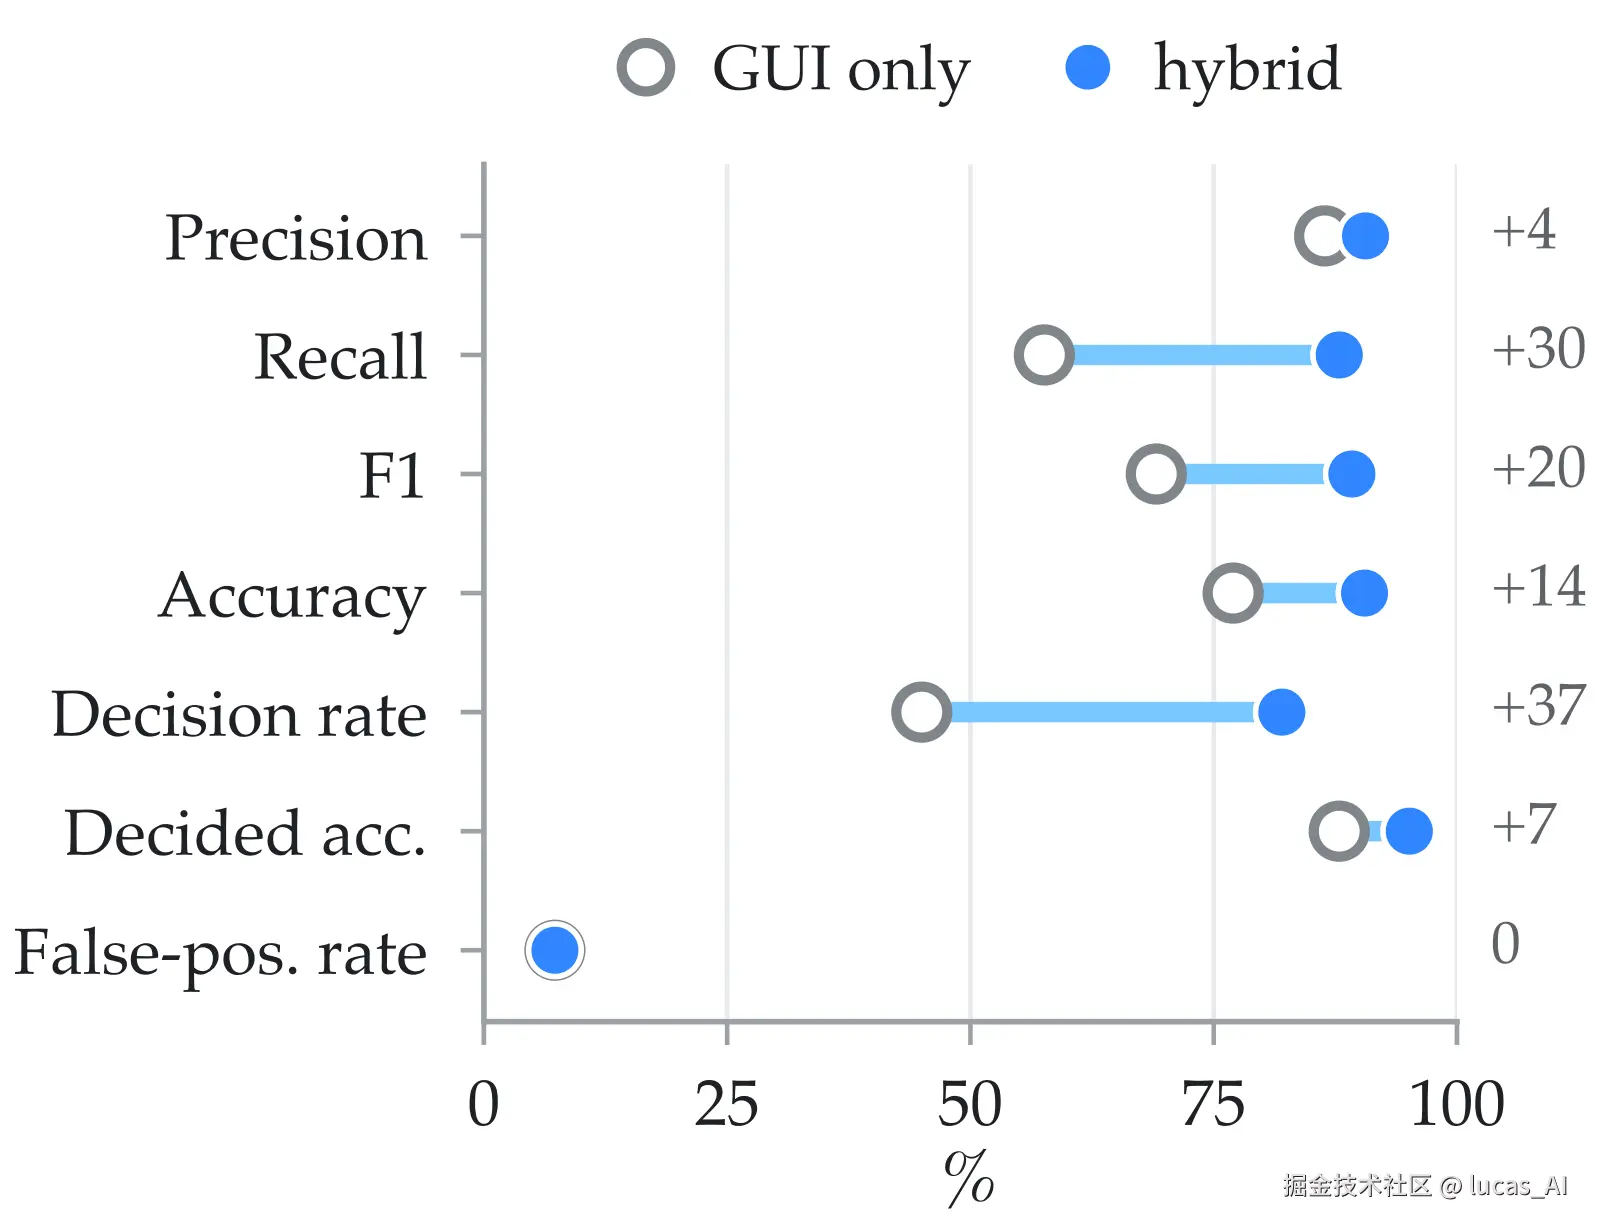
最能说明「收益从哪来」的是上面这张消融图:同样的任务,只给 GUI 工具时决策率 45%,加上代码工具后飙到 82%,而假阳性数量一个没涨(都是 3/41)。配对分析显示,代码通道新增的每一个正确判断,背后都有一次文件或应用存储的读取在支撑。换句话说,代码检查解决的是 GUI 根本无法回答的问题(「存没存」),而不是把同一批问题换个姿势再做一遍。
线下侧的收益集中在难例上:OSReward 困难子集(284 条人工标注轨迹)上,VeriCUA 70.4%,最强基线 OS-Themis 只有 65.7%------固定证据不够判定时,主动取证的兵力优势才显出来。
还有一个特别实用的数字:面对智能体的虚假完成报告,VeriCUA 能拒绝其中约 80%,而基线评委几乎束手无策(ScienceBoard 上的自动生成验证器几乎从不拒绝)。这正是数据筛选和 RL 场景最需要的能力。
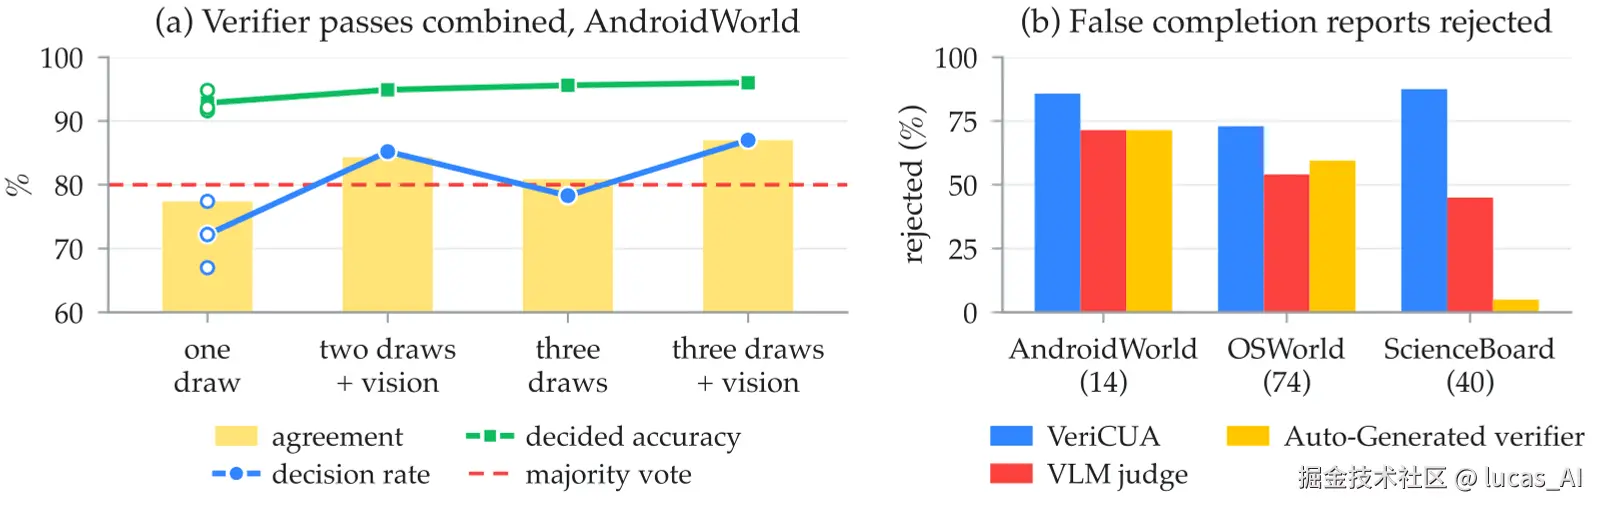
预算敏感的同学关心成本:论文做了等预算对照,把基线评委的调用次数、帧数配到和 VeriCUA 同档,VeriCUA 仍然领先(OSReward 86.4 vs 84.8),只是幅度收窄------多花一些推理预算换可靠性,这笔账在 RL 奖励场景下是划算的。
为什么你要关心?
如果你在做 agent 相关的任何工程,这篇论文有三处可以直接搬走的东西:
- 证据分级(attested/asserted):给任何自动化验收系统加上「物证/证词」标签,并规定证词不能单独通过验收------这一条规则就能干掉一大类「自称完成」的假阳性,成本几乎为零;
- 先勘察再定标准:让验证器生成检查逻辑之前先摸一遍环境 schema,对自动生成测试脚本、生成 verifier 的工作同样适用;
- 弃权机制:验证器输出三态(success/fail/abstain)而不是硬挤一个二元答案,把「不确定」显式暴露给上游,数据筛选场景直接拿决策准确率做阈值。
再往大里看,这个工作的信号是:验证正在成为 agent 系统里独立的一等公民。过去我们习惯把「评判」当作生成的一个附属品(生成完顺手让模型评一下),而 VeriCUA 给出的答案是------验证值得一套自己的动作空间、自己的证据规则、自己的架构。论文里换上更强的骨干模型(gemini-3.1-pro-preview)后,基线评委原地踏步甚至倒退,VeriCUA 却继续涨 2.7 个点------验证流程的复杂度红利,要强模型才兑取得出来,这也暗示这条路线的上限还远没到。
理性看待
几个该打问号的地方:所有对比都在 Gemini 系骨干上跑,跨模型家族的泛化还没验证;线上验证依赖特权访问(root adb / 虚拟机只读权限),真实生产环境里应用数据常有沙箱隔离,这个前提不一定成立;benchmark 官方评测器本身也有噪声,VeriCUA 的「一致性提升」里有多少是「和金标犯同样的错」没法完全剥离。另外论文没有放出代码仓库,想复现 17 个只读动词的细节只能靠附录的文字描述。这些都不动摇主结论,但动手照搬前值得心里有数。