背景
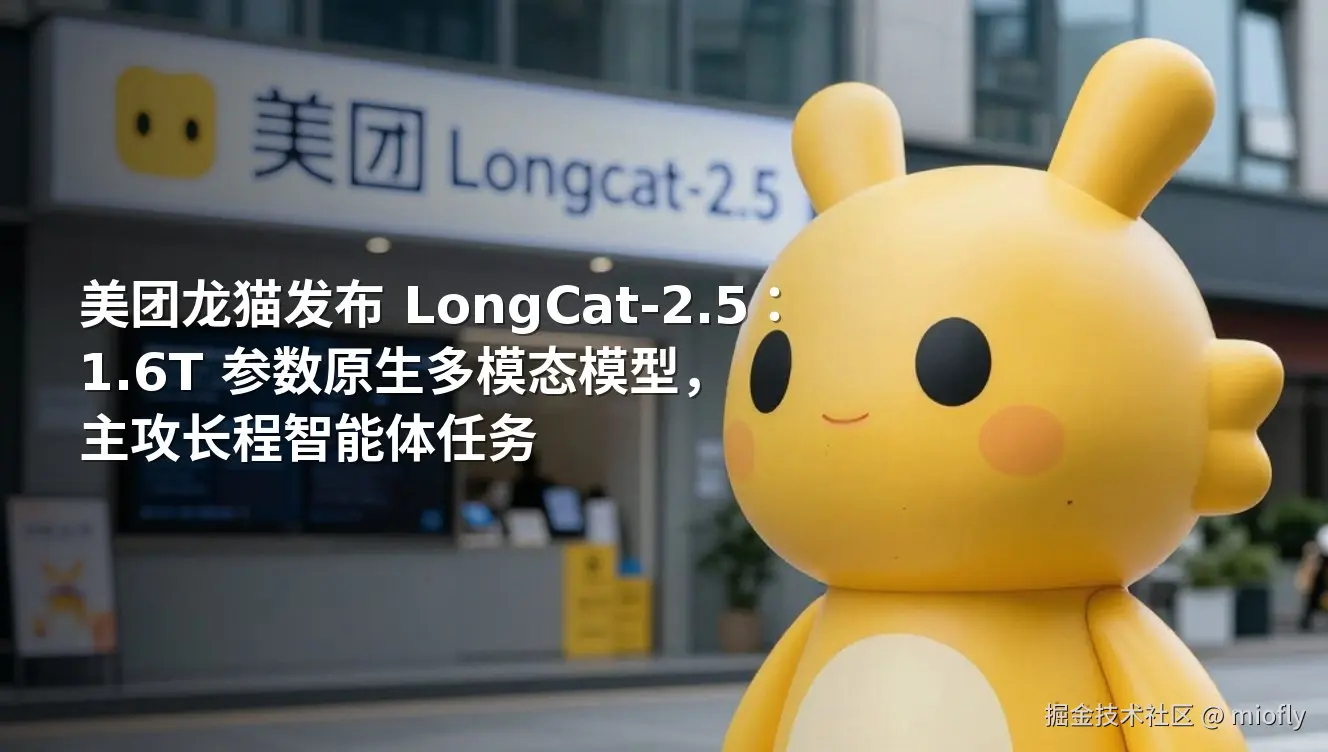
美团龙猫发布了新一代原生多模态模型 LongCat-2.5,面向长程智能体任务。模型总参数量达 1.6 万亿,每个 token 激活约 480 亿参数,属于典型的大规模混合专家结构。这是在 LongCat-2.0 的基础上迭代而来,重点方向是强化原生视觉理解和智能体编程能力。
长程智能体任务指的是需要模型在较长时间跨度、较多步骤中保持连贯决策的工作,比如复杂代码库的开发和完整项目的构建。这类任务对模型的要求和单轮问答完全不同,需要模型能记住之前的操作、判断中间结果是否正确,并根据反馈调整后续步骤。LongCat-2.5 的训练方式就是围绕这个目标设计的。
目前模型已经可以在 longcat.chat 在线体验,API 接入入口也已开放,GitHub 和 HuggingFace 上的开源版本官方表示即将上线。
核心原理
LongCat-2.5 在训练阶段加入了更多长程轨迹数据,并配合大规模长程强化学习,目的是提升模型在复杂代码库开发、完整项目构建等任务中的端到端工程能力。官方还提到,围绕数据合成、环境构建和跨 Harness 混合训练,这条训练链路在持续扩展。
一个值得关注的做法是,龙猫团队把真实 Agent 运行时产生的失败轨迹转化成可复现、可验证的训练任务,再针对模型暴露出的能力短板补充训练数据。这种从失败中反向构造训练样本的方式,比单纯依赖人工标注数据更贴近真实使用场景中会遇到的问题。
在多模态处理上,LongCat-2.5 把视觉信号表示为多层级离散 token,让主干模型用统一的 token 形式同时处理视觉和文本输入。这种设计使得原生视觉理解和智能体编程能力可以结合起来,模型在 Visual Coding(结合视觉信息进行代码生成或调整)上表现突出,并支持创意设计、3D 相关任务。
支撑这些能力的是持续演进的基础设施:官方提到在国产算力上优化了长上下文训练和 W4A4 推理,还通过训练与推理之间的数值一致性优化,以及长上下文 rollout 优化,来保证大规模长程强化学习能够高效运行。
局限
素材中没有给出 LongCat-2.5 在具体基准测试上的分数,也没有披露训练数据规模、训练时长或硬件集群规模等细节,这些信息目前无法确认。
模型的开源版本尚未上线,GitHub 和 HuggingFace 页面官方标注为"即将上线",具体开放时间和开源协议都还不明确。API 接入页面目前能查到入口,但计费方式、调用限制、支持的上下文长度等参数素材中没有提及。
"W4A4 推理"说明模型支持 4-bit 权重和 4-bit 激活的量化推理,这能降低显存占用和推理成本,但量化之后的精度损失、实际推理速度提升幅度,素材中也没有给出数字,这里不做推测。
对开发者的意义
对于需要处理长流程智能体任务的开发者,LongCat-2.5 提供了一个新的候选模型,尤其是涉及代码库级别的开发、多步骤项目构建的场景。原生多模态的设计意味着视觉输入和文本输入可以在同一套 token 体系下处理,如果产品里有结合图片或设计稿生成代码的需求,这个方向值得关注。
在正式接入前,建议先通过在线体验入口测试模型在自己业务场景下的实际表现,再决定是否通过 API 接入。开源版本上线后,本地部署和微调的可行性会更清晰,目前只能等待官方后续动作。
量化推理支持对于成本敏感的部署场景是个积极信号,但具体收益需要等实测数据或官方公布的性能报告。
原文地址:tools.wflynn.cn/aitools/tre...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: