💡 一句话总结:当检索被 Agent 循环接管,「找得到」不再是瓶颈(BM25+grep 已达 91%),瓶颈变成「供给什么上下文」。RAGFlow 论文把摄入期的语义加工命名为知识编译,其中唯一可测的机制------断言-证据对------在证据够用时把查询总 token 砍 91%,不够时只多 1.9%,但省 token 是用轮数换的,延迟约 3 倍,得再配个决策门拉回来。
导语:chunk 大小你调到第几版了?
做 RAG 的朋友,下面这个场景你大概不陌生:深夜的终端里,你第 17 次改着 chunk_size 和 overlap,向量库换到第 3 个,rerank 模型换了 4 版,GraphRAG 的 community report 建了 6 个小时------然后测试集上的分数纹丝不动,甚至倒退 0.3 个点。
你开始怀疑人生:到底是我的 embedding 不行,还是我的语料根本不适合分块?
RAGFlow 团队(就是那个 GitHub 上 70k+ star 的开源 RAG 引擎背后的 InfiniFlow)联合华东师范大学,10 月底在 arXiv 上放了一篇论文,标题很工业派------《Context as Infrastructure: Knowledge Compilation for Retrieval in Agentic Systems with Harnesses》。它给出的答案有点残忍:在 Agent 化的检索里,你调的那些东西,大半已经不是决定性变量了。
📄 论文:Context as Infrastructure (arXiv 2610.41172)
🔧 系统:RAGFlow(GitHub 开源)
先看一个扎心的实验:BM25 + grep,91%
论文的出发点是一条正在被多家独立验证的结论:检索正在被「搜索 harness」吸收。所谓 harness(挽具/执行框架),就是那个拥有完整搜索循环的组件------Agent 自己写查询、读结果、改写关键词、决定什么时候证据够了可以收工。ReAct、DeepResearch 这类系统里,检索早就不止是一次「query → embedding → 相似度」的调用。
一旦 Agent 会自己 grep、自己读,那经典检索层的三大目标------更好的分块、更好的 embedding、更高的 Recall@k------就不再是瓶颈。作者们干脆把话说绝:整篇论文没有向量索引、没有 dense 检索腿,理由是实验性的而非审美的------「在我们的运行里,加 dense 腿降低了准确率」,因为语义这一步 Agent 在循环里已经做了(改写查询、读内容、说清还缺什么),你再给它第二个排序,它还得花力气调和两套排序的矛盾。
裸 harness 的成绩单:
- 📊 BrowseComp-Plus 85%(BM25 + grep + MiniMax M3,每题约 300 万 token)
- 📊 FRAMES 91%(多跳问答,每题约 32.5 万 token)
注意这两个数字不可互相比较------一个是单题深挖、一个是多跳问答,各自是 harness 在自己赛道上的饱和检查。重点是它们都没用到任何编译索引。
这就推出论文的第一个论断:检索先是 harness 问题,才是索引问题。索引决定「能不能找到」,harness 决定「找到之后能不能变成答案」。一个从不丢弃坏查询、读东西没预算、舍不得扔贵价 passage 的循环,换任何索引都救不回来。
那索引层就失业了?也不是。论文说:它的价值换了赛道------从「帮你找」变成「喂得好」。
知识编译:把语料当代码,先编译再查询
作者给这套东西起了个编译原理味道的名字:知识编译(knowledge compilation)------在摄入期(ingestion time)用一个可配置的管线,把源文档加工成查询无关的、带类型的「工件(artifact)」,查询时消费的是工件而不是原始文本。类比很直接:语料是源代码,工件是编译产物,Agent 是运行时。
管线六段,每段可替换:
- Parse:PDF/Office/HTML/表格转成保结构的规范表示;
- Chunk:自然边界分块------注意,chunk 只是召回单位,不是语义单位,「每个语料都得有自己的魔法 chunk size」这个调参地狱,在 harness 时代根本不用熬;
- Enrich:小模型(实验里用的是 glm-4-flash,便宜货)按模板产出工件------断言、实体、事件、本体标签、综述文章;
- Validate :证据 span 必须逐字命中源文,对不上就丢弃------「模型提议,源文裁决」,这是小模型敢上岗的原因;
- Assemble:断言聚簇成树、实体解歧成图、事件排成时间线;
- Register:带源版本、偏移、抽取器版本、访问标签入库,可回退、可审计、可增量更新。
工件是个大家族:断言-证据树、导航树壳、实体关系图、本体、LLM wiki、时间线、脑图、会话记忆。每类工件各有自己的「账本」------比如本体(ontology,给实体和关系定类型与约束的 schema)的价值主要在企业治理:统一术语、跨源打通、按类型控权限,这类收益 benchmark 根本看不见。
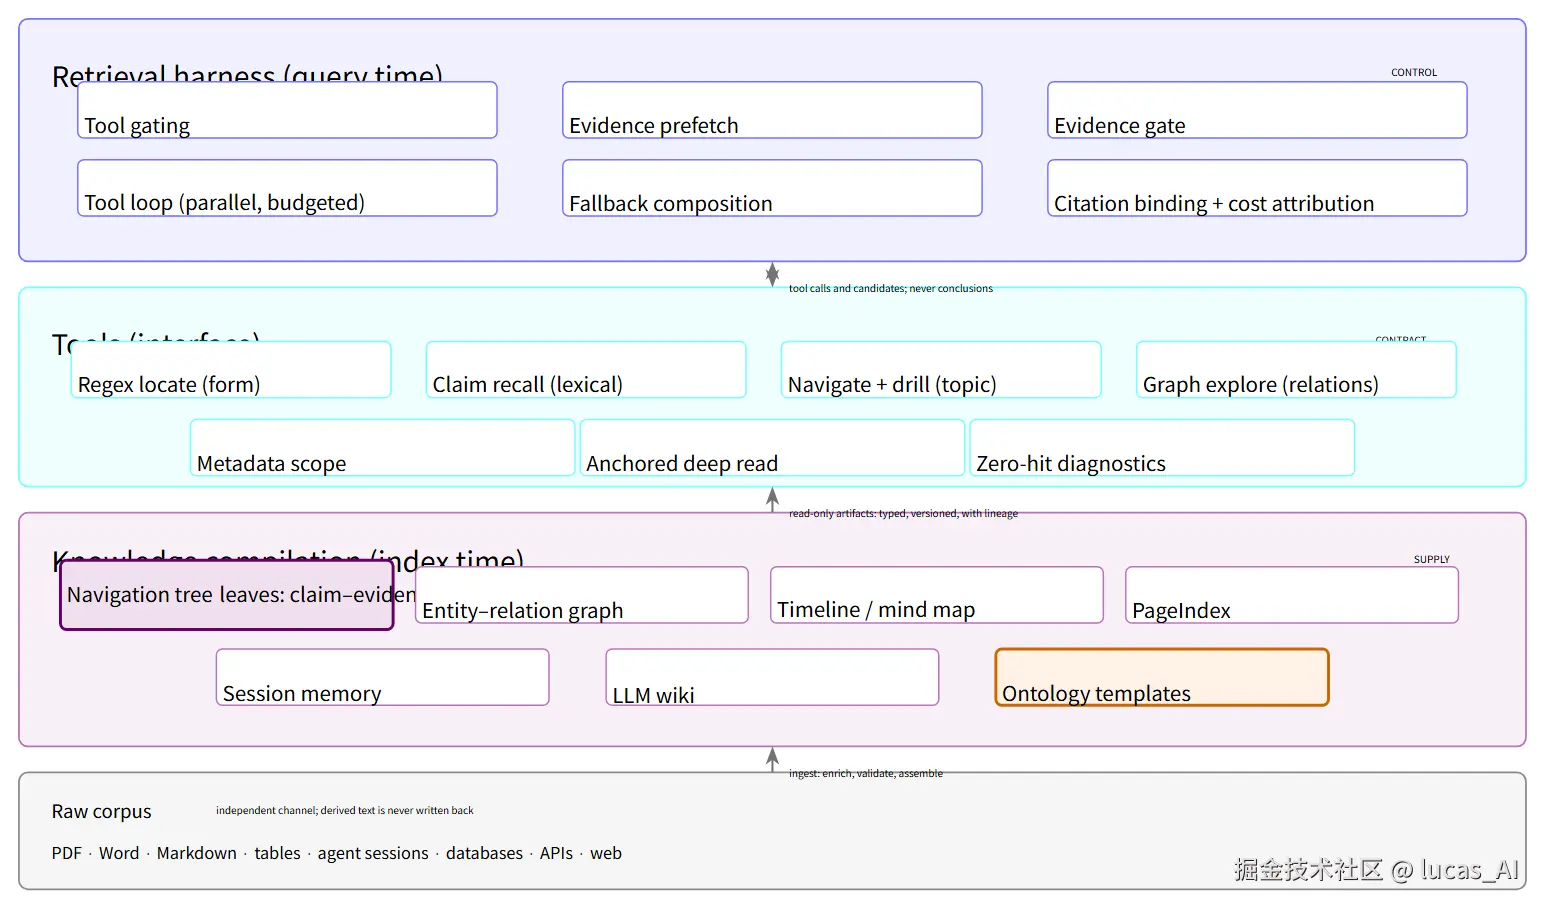 图说:整个体系分四层------顶层 harness 负责控制,工具是它和供给层之间的契约,知识编译在摄入期把原始语料加工成各种只读工件(高亮的断言叶树是本文唯一实测的机制,本体模板则是商业价值为主的那类)。
这里有一条值得抄进自己项目的铁律:通道分离。派生工件只读、带血缘指针、绝不写回源文档------否则就会出现「LLM 生成的摘要变成下一代模型的源」这种 LLM 自维护语料的头号翻车现场。想在生产里玩 AI 自维护知识库,这条是底线。
唯一被实测的机制:断言-证据对,以及它的账本
编译工件一大堆,论文只把一个机制拿到实验台上测了:断言-证据对(claim--evidence pair)。
单元很朴素:一条归一化断言 c + 一段逐字复制的证据原文 e + 源文偏移 s + 有效期元数据 τ。找不到对应原文的断言直接不存。几百 token 的 chunk,压缩成几句话的断言集合------散文有损,出处无损。
服务方式三种:
- E1 证据优先检索:直接对断言文本做 BM25,实测优于「先定位文档再顺树而下」------树内歧义多,还多烧一轮;
- E2 证据替换(默认):搜索行为完全不变,定位到 chunk 后,在进上下文窗口之前把它替换成该 chunk 的断言-证据对,再由门判断够不够,不够再开原文;
- E3 决策门控阅读 :一个轻量决策模型判断「这块值不值得深读」------省的是读的次数 ,不是读的量。
然后是全文最值钱的一张图(Figure 2),账本如下:
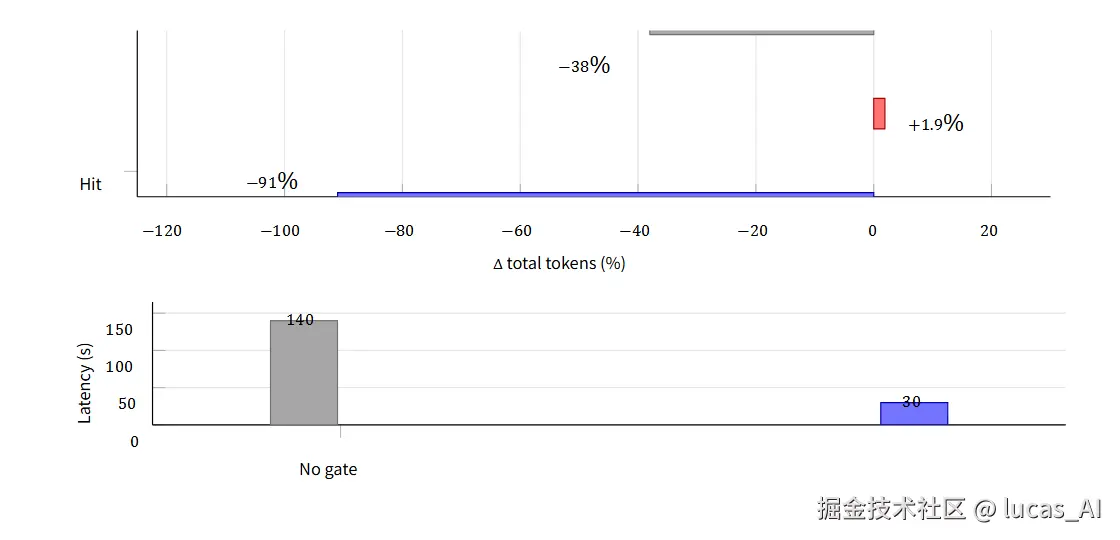 图说:上图------证据够用时(hit)查询总 token 暴降 91%,不够时(miss)只多付 1.9%,FRAMES 平均 −38%;下图------决策门把端到端延迟从 140 秒拉到 30 秒。
为什么 miss 只罚 1.9%?因为替换是个查找动作,不是生成动作------失败了顶多对已定位的 chunk 多看一眼原文。为什么 hit 省 91%?因为基线读的是整块 chunk,替换后读的是几句带出处的断言。代入期望公式一算:只要「证据够用」的充分率超过 2%,编译就开始赚。FRAMES 上实测平均 −38%,反推充分率约 43%。
但作者立刻补了两刀,防止你无脑上系统:
第一刀,有限视野。 2% 是无限回合的渐近值。真实试点有查询量 Q 和编译成本 c,净收益公式变成「2% + c/(0.929Q)」------1000 次查询、编译成本 10 个查询等价物的小试点,实际需要充分率 >3.12%;要是实测只有 2.5%,渐近规则说「编译」,有限规则说「别」,会净亏 5.8 个查询等价物。正在评估要不要编译语料的朋友,用这个公式,别用营销数字。
第二刀,天下没有免费的 token。 在配对子集上,替换把查询 token 砍半的同时,端到端延迟涨了约 3 倍 ------证据页小了,轮数就得变多。省 token 和省时间是两种货币。于是轮到 E3 登场:决策门把「要不要深读」交给小模型,140 秒的延迟直接拉回 30 秒,无证据场景还能再省 30% token。记住这个分工:证据减少读的量,门减少读的次数------又贵又慢的 agent RAG,先分清自己是哪种病。
顺带一个诚实的补丁:门报告的其实是「接受率」,不是「真充分率」------门可能把流利但不相关的块放进来。论文给了假接受率的一阶估计公式,并规定两个数必须成对报告;校准审计(100~400 条标注)已预注册但还没跑。所以 43% 这个数,看的时候打个折扣。
负结果也值钱:结构不是证据
比正结果更难得的是论文把负结果也做成了机制分析。同一个 harness 下,四件结构工件全部表现平平:RAPTOR 式摘要树中性、PageIndex 式大纲目录小规模中性、LLM wiki 中性还贵、实体图中性(FRAMES 本来就带实体链接证据,大多数问题用不上 join)。
PageIndex 大纲甚至从中性滑向负资产:路由单步 95% 正确看着挺好,但分支因子 8、文档量 10⁵ 时,端到端路由成功率只剩约 75%------一次自信的错分支,比开放搜索还糟。
四个失效机制,每条都能对号入座到某个 RAG 产品宣传:
- harness 已经是自适应索引:grep + 读,就是按需现建的索引,静态分区想赢,得比 Agent 的下一发查询更聪明------通常做不到;
- 结构不是证据:摘要和大纲是「重新描述」,不增加任何事实;
- 抽取误差会复利:每层 95%,乘到第五层就不是 95% 了;
- 结构增加选择负担:Agent 得决定什么时候走树,这本身耗轮数耗上下文。
结论不是删掉树,而是别再拿「召回」卖树:树是放证据的好地方(叶子装断言-证据对、内部节点做导航标签)、支持增量维护和按子树控权限------是组织载体,不是检索器。
Harness:纪律比聪明重要
供给侧讲完,控制侧的方法论同样可抄。RAGFlow 的 harness 把一次查询切成五个站点:能力检查(没编译过的语料,连导航/图工具的描述都不暴露)→ 证据预取(全语料扁平召回,绝不走小树------小树会把所有问题引向同两篇文档)→ 证据门(数量、来源多样性、覆盖度不够就整块丢弃,绝不塞进 prompt)→ 工具环(单轮并行多动作,步数与墙钟双预算,让循环「按构造收敛」)→ 确定性收尾(异常终止也得产出答案)。
支撑它的是六条朴素不变量:证据先于思考、不足即丢弃、工具按语料门控、调用带预算、引用编号由框架交付时绑定(不信任模型自己编号)、保证收尾。作者说得直白:这些不变量毫无魅力,但它们就是「时而能跑的 demo」和「可运营的系统」之间的差别。
还有个细节我特别喜欢------零命中协议:返回 0 结果是工具的属性,不是语料的事实。harness 先向模型解释这次零命中是怎么回事,然后沿回退梯子重试(放宽过滤 → 切回原始词法搜索 → 放宽时间窗),全部失败后模型才被允许得出「语料里没有」的结论。这个三行协议,防的是 agentic 检索里最常见的假阴性:agent 因为工具配置不对而放弃了本可以找到的答案。你的 DeepResearch 常常「查了但没查到」,多半缺的就是这个。
工具列表的组织方式也反直觉:不按实现(search/browse/read/grep)分,按移除的失败原因分------每个工具对应一个具名失败、一个可观测症状、一个指标;如果两个工具移除同一个失败,一个就是另一个的配置项;如果一个工具移除不了任何具名失败,它是 demo。「让模型在十几个工具里自由选择」被明确反对------工具集越大、语料越陌生,模型的选择越自信越无效。
把话说明白
读完全文,哪些站得住、哪些要留个心眼,给你分开摆:
站得住的:「检索是 harness 问题」有本文和多项独立报告同向支撑;断言-证据对的成本不对称(hit −91% / miss +1.9%)逻辑干净、机制清楚;零命中协议、通道分离、双账本评估这些工程纪律,与具体数字无关,直接可用。
要打折的:91%/1.9% 是 N=200、单次运行、无置信区间下的「工作点」;「延迟 3 倍」只来自 7 个配对问题;43% 的充分率依赖门本身的校准,而校准审计还没跑;「结构无用」是「harness 够强 × 基准难度」的联合命题,换更强的模型或更难的基准,结论可能松动。另外别忘了立场:这是 RAGFlow 团队为自己的架构写的论文,Wikipedia 型语料上的结论,搬到表格、扫描件、黑话密集的企业语料时,作者自己都承认可能反转。
对你的项目意味什么:如果你在维护一个 agent 化的检索系统,这篇论文给你的行动清单大概是------先别急着买新索引,量一下自己循环的纪律(有没有预算、会不会丢弃、零命中怎么处理);评估编译工件时用有限边界公式算盈亏,拿「投影失败频率」当头号监测指标;又贵又慢的,先分清是 token 病(上证据替换)还是轮数病(上决策门)。至于文档树和知识图谱,它们没死,只是换了个岗位:别再让它们去考召回的试了。
那天深夜第 18 次调 chunk size 之前,或许可以先问一句:我的 harness 有纪律吗?------这可能才是这篇论文想留给每个 RAG 工程师的那根刺。
参考来源
- 论文原文(arXiv 2610.41172,一手)--- arxiv.org/abs/2610.41...
- RAGFlow 开源项目(实现载体,一手)--- github.com/infiniflow/...
- ReAct: Synergizing Reasoning and Acting in Language Models(harness 思想源头之一)--- arxiv.org/abs/2210.03...
- RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval(被测的摘要树基线)--- arxiv.org/abs/2401.18...
- Lost in the Middle(长上下文中部丢失,替换机制动机之一)--- arxiv.org/abs/2307.03...
- FRAMES benchmark(评测基准)--- arxiv.org/abs/2409.12...