Before you disturb the system in any way, watch how it behaves.
观其行,究其理,而后改之。
------多内拉·梅多斯,《Dancing With Systems(与系统共舞)》1
楔子
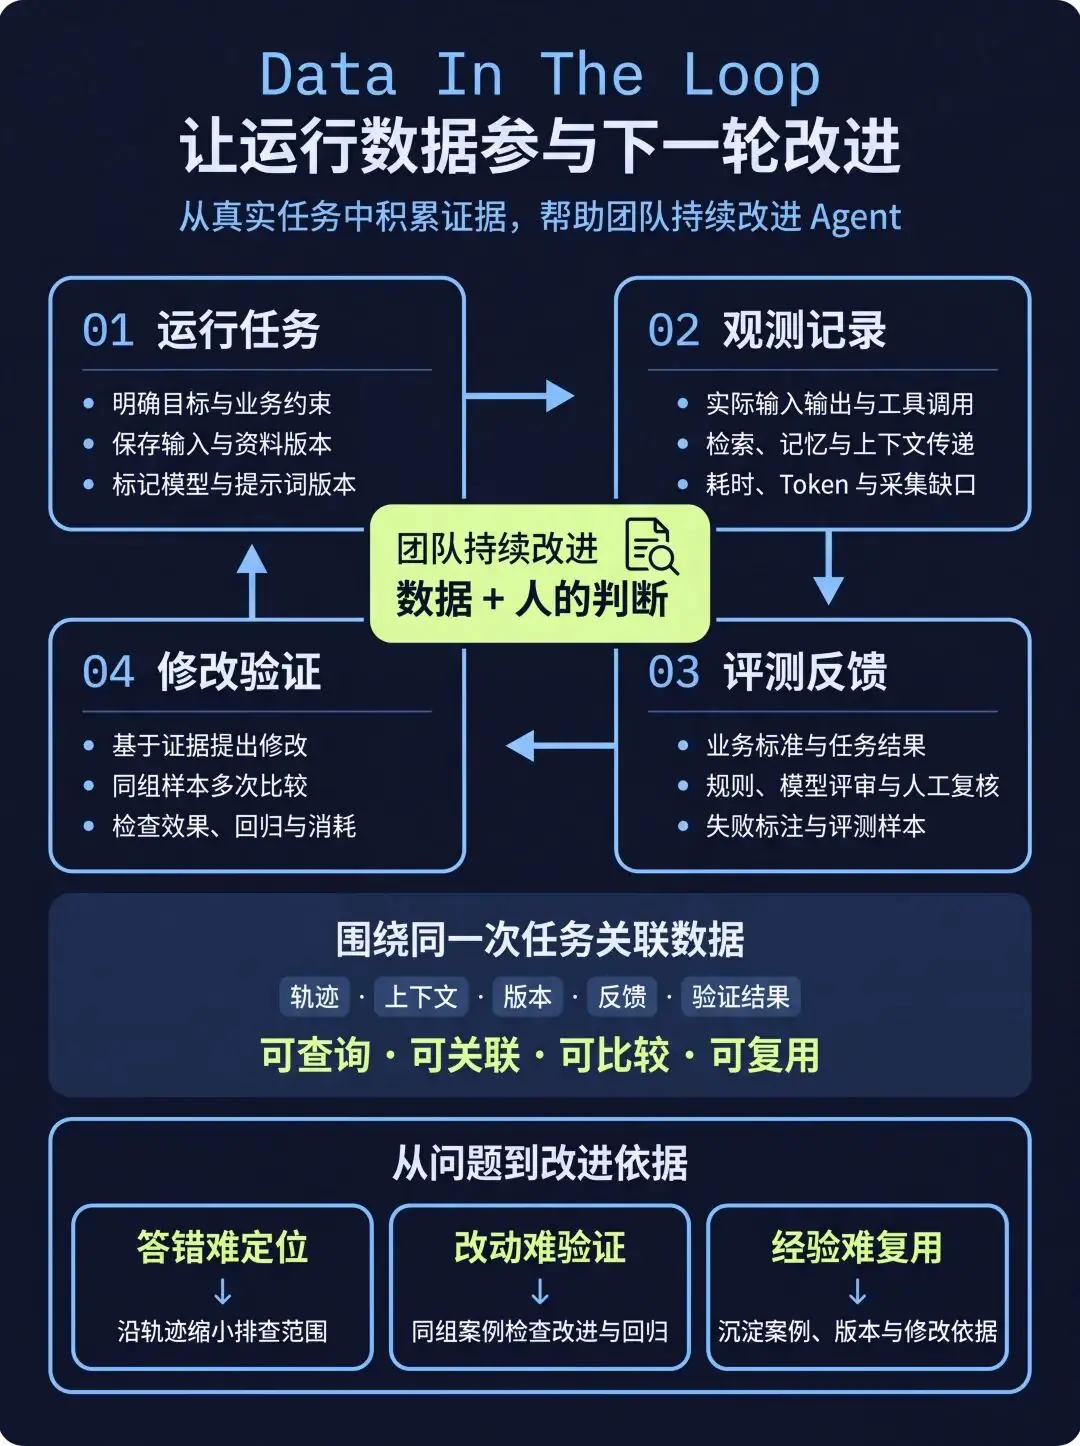
今天,我们会在"老纪的技术唠嗑局"里,开设一个新的系列专题,名字叫做 Data In The Loop。
这个系列专题,来自一个很实际的愿望:当你花时间调试一个 Agent,应该能够看清楚自己究竟改好了什么,也能够把这一次的经验带到下一次开发和优化里。
看到 Agent 自己查资料、调用工具、完成任务,很容易让人兴奋。但等它开始处理真实工作,我们又会多一份顾虑:这次的答案可靠吗?换个问法能让它做得更好吗?出了问题,有没有办法查清楚?
调试要花时间,运行要消耗资源,我们做这个系列,是想和大家把这些问题聊清楚:哪些记录值得看,怎样判断一次修改有没有帮助。希望你读完后能带走一种分析方法,然后回到手头的任务里去试上一试。
这个系列,会从观测和评测谈起,沿着开发、测试、部署和实际使用,讨论运行数据怎样帮助团队判断下一步应该进行哪些优化。同时,我们也在把这些想法做成工具,希望能够和大家一起使用。
欢迎大家关注 OceanBase 社区公众号"老纪的技术唠嗑局"。在这里,我们会持续为大家更新与 #AI 和 #Data 相关的技术内容~
先从 Agent 的一个错误的回答聊起
假设你在老板的指示下,折腾了几天,终于开发出了一个企业知识助手 Agent。
用户问它:"最新版本的产品里,某个功能应该怎么配置?"
Agent 很快给出了步骤,还附上了资料链接。然后用户照着操作时,却发现配置不生效:因为引用的文档对应的是旧版本的产品。
你可以再加一句提示词,提醒它注意版本。可在动手提醒之前,你大概也想知道:Agent 究竟是压根没拿到新资料,还是拿到了却没选对?以及用户指定的版本,有没有真的保留在上下文里?
因为,不同的情况,会引导你对 Agent 做出不同的修改和优化。
观测的价值,在这个时刻就变得具体了。
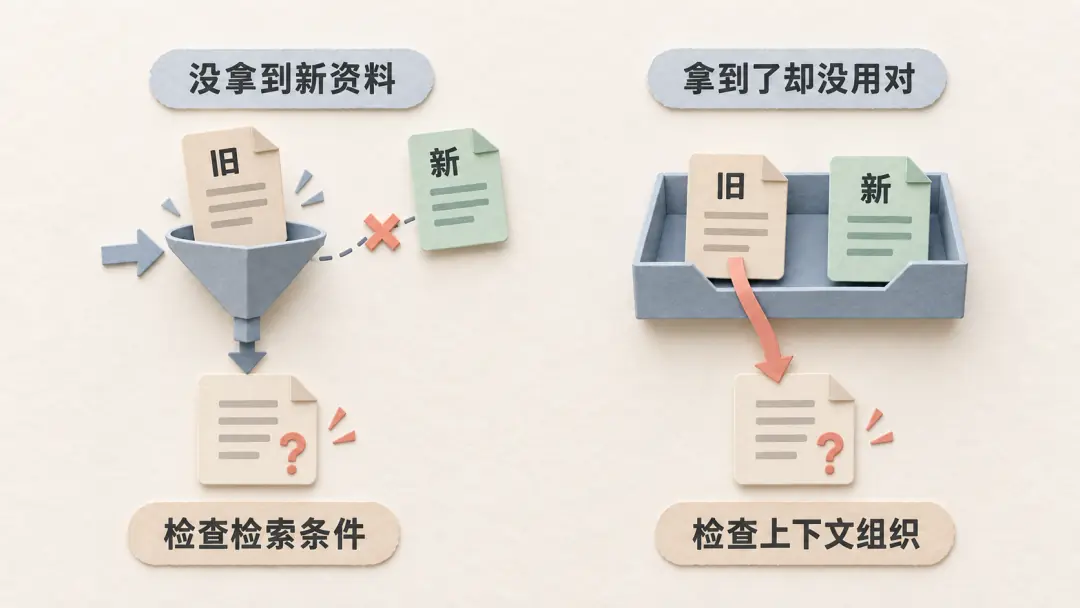
你能沿着一次任务,查看工具原始返回了什么、模型实际收到了什么、哪些要求在传递过程中丢失了。 如果检索只返回旧资料,就应该先检查检索条件;如果新旧资料都在,就应该继续看上下文怎么组织。
开发者由此就会有一个可以验证的修改方向。业务同事也能参与:指出资料适用哪个版本,说明什么样的回答才可以交给用户。
开发者特别在意这种变化。面对 Agent 的一次失败,大家应该坐下来读同一份记录,先把问题说清楚,然后再决定下一步该怎么改。
在思考怎样理解和改进 Agent 时,我们参考了很多 LangChain2 团队的讨论。
LangChain 提供 Agent 开发框架与观测评测工具,它的联合创始人 Harrison Chase 也写过一个名为 In the Loop 的专栏。在其中一篇讨论代码与运行轨迹关系的文章3中,他提出了:代码帮助我们理解应用如何设计,轨迹则记录 Agent 在具体条件下做了什么。
这和刚才的排查思路是相通的:读过上下文的处理逻辑之后,我们还要沿着运行记录,检查资料是如何一步一步地被检索出和传到模型面前的。
为何把 "Data" 放在专题的名字里?
下次改提示词、换模型时,能不能直接复用这次排查留下的线索?
你刚刚排查完那个错误,知道了正确配置,也终于知道了问题可能出在哪一步。
如果这些信息只留在聊天记录和几张截图里,下次遇到相近的问题,仍然可能需要再次从头开始排查。
要留住这份经验,可以把问题对应的运行、当时使用的资料、业务同事的判断、具体改动和验证结果,放在同一个任务下面。
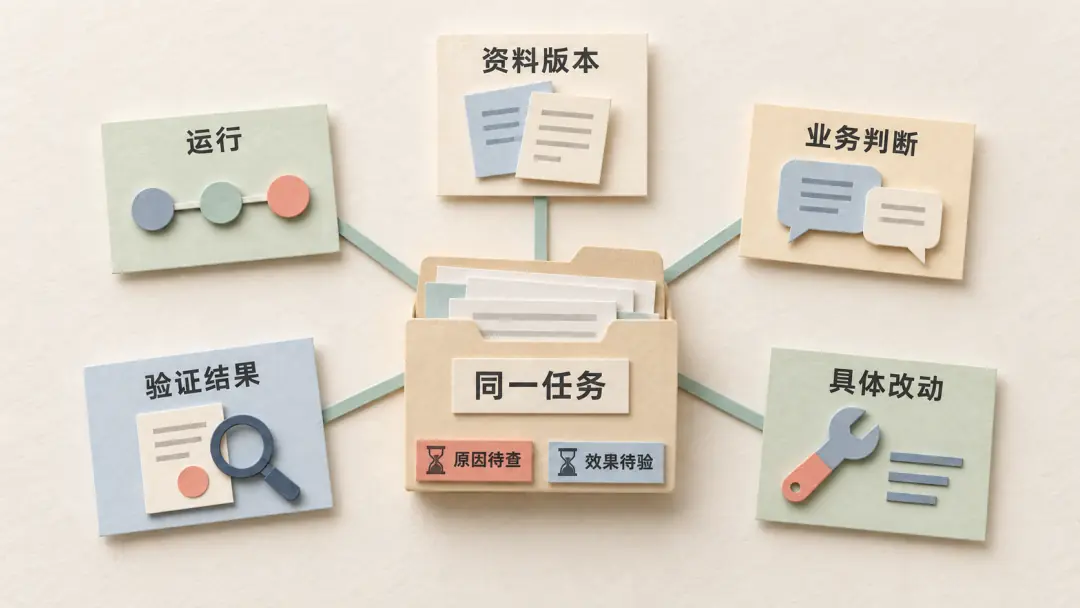
下一次改提示词时,你就有一个案例可以用于测试;换模型时,可以来测试旧问题有没有重现;新同事接手时,也能读到当初为什么需要这么改。
这就是我们想讨论的 Data In The Loop:让运行记录、评测结果和人的反馈,继续参与下一轮开发。
Agent 执行任务时,可能多次调用模型和工具。我们这里说的 Loop,关注的是团队怎样在一轮轮工作中改进它:从运行中找出问题,提出修改,用样本验证,再从真实使用中接收反馈。
这就需要把记录存下来、查得到,再把它与资料版本、反馈和验证结果关联起来。数据库的存储、查询和关联能力,可以帮助我们把调试经验带到后面的测试和协作里,让曾经花在排查上的时间,在以后继续派上用场。
让这一轮的经验,融入下一轮开发
要让运行中的经验持续帮助开发,我们还需要看清这些工作在整个流程中的位置。
LangChain 在讨论 Agent 的工程实践时,用 ADLC(Agent Development Lifecycle,智能体开发生命周期)来组织这个流程。在相关介绍4中,它将流程概括为 Build、Test、Deploy、Monitor:构建、测试、部署和持续监测。测试从发布前就开始,实际使用带来的反馈再进入后续开发。
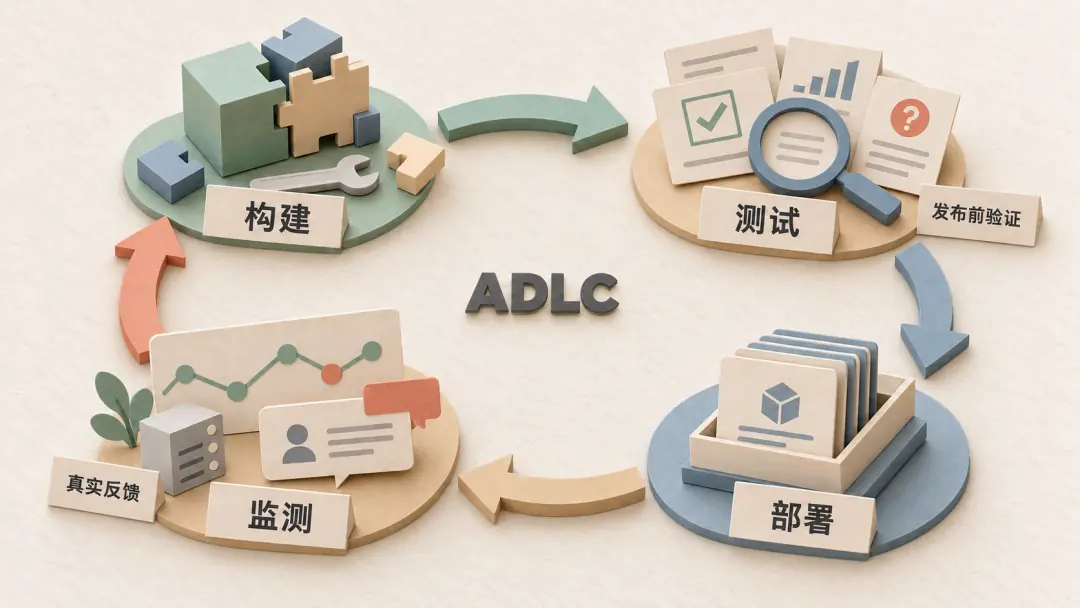
沿着这几个阶段,观测和评测就可以成为日常工作的一部分。
开发知识助手时,你可以先写清楚它要完成什么。例如,依据用户指定版本提供配置方法,资料不足时说明缺失条件。再沿着运行记录检查,这些要求有没有进入实际执行,用测试案例判断结果是否满足要求。
修复旧资料问题之后,可以把这次失败留下来,再补上旧版本提问、版本不明确等相近场景。下次修改时一起检查,这次排查就能继续帮助后面的验证。
部署之后,用户可能还会带来各种没有提前预料到的问法。这些反馈可以关联回具体运行,挑出值得复查的案例,再补充到测试中。业务同事也能参与:一起说清楚,在这个任务里,什么样的结果才能算是"答对了"。
当你准备把更多任务交给 Agent,或者让更多同事开始使用它,这些记录也能帮助团队作出判断。哪些任务测过,哪些问题还没解决,耗时和消耗有没有变化,都可以拿出来一起讨论,再决定下一步投入。
一次修改改善了什么、还有哪些限制,也能解释得更清楚。
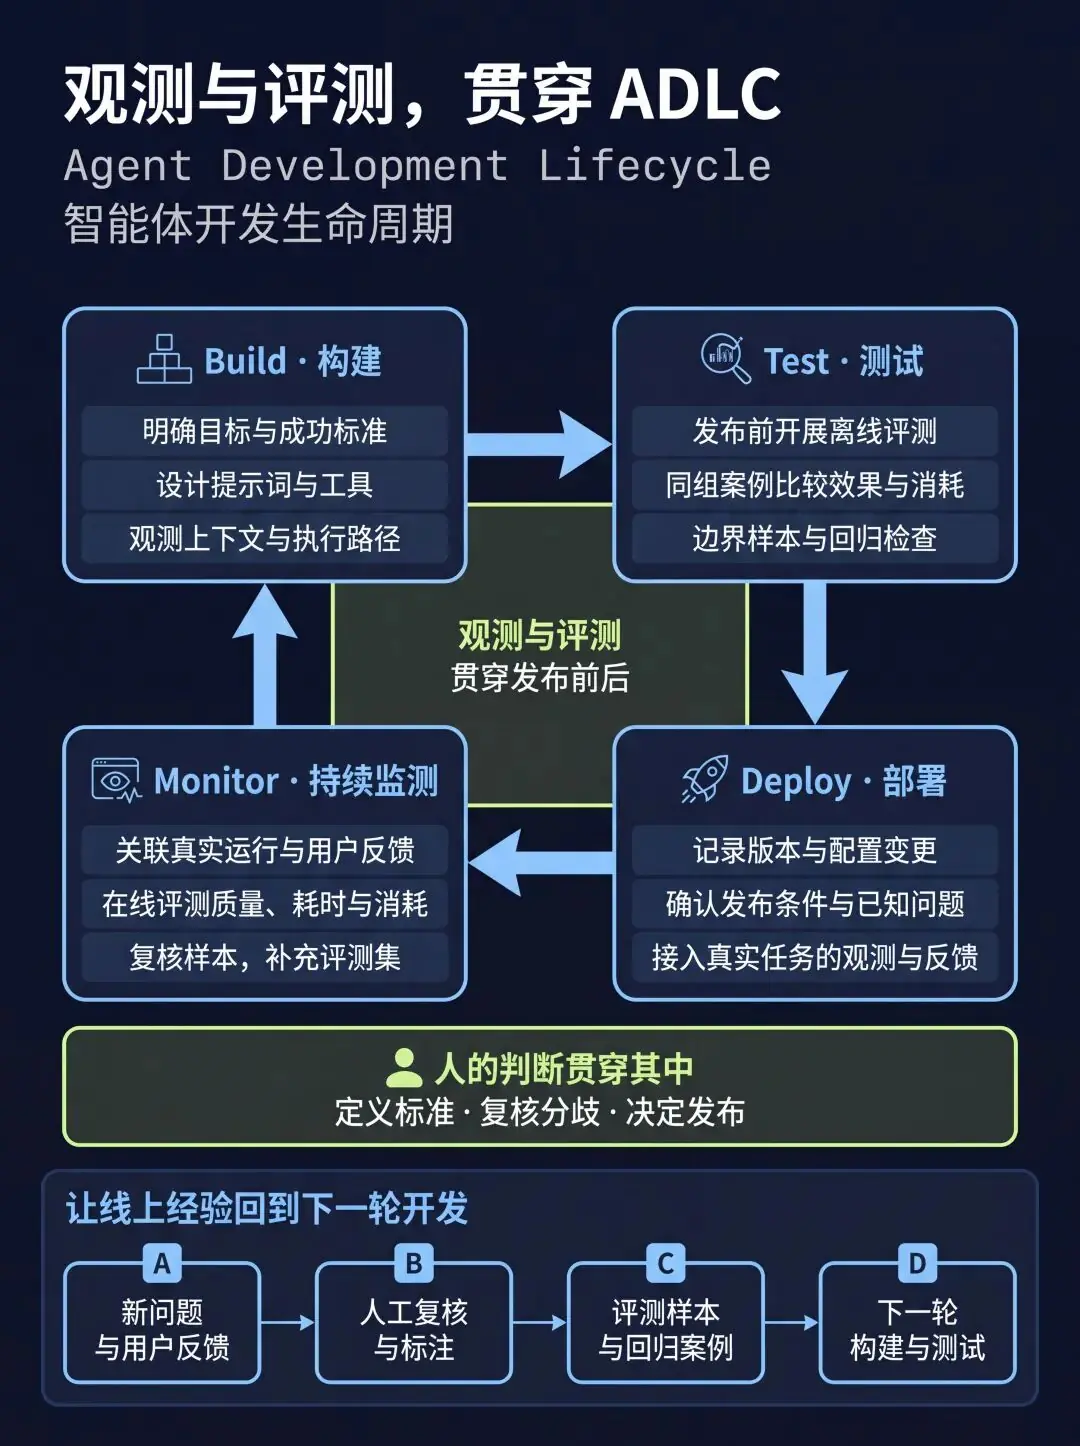
ADLC 四阶段的工程解读
尾声:我们想把这些问题拿出来,和大家一起做
写这个系列,我们希望与大家讨论能落到工作中的方法。
怎样读一次运行,怎样从失败里挑出测试样本,怎样检查上下文和记忆,怎样判断多花的时间与模型调用有没有带来帮助,这些都会成为后续的话题。
工具也要接受同样的检验。一个页面能不能让使用者读懂任务,一次诊断能不能给出有依据的建议,一个评测结果能不能帮助团队决定是否发布,我们都希望能够和大家一起,把这些事情做扎实。
如果你愿意参与,可以从一个具体问题开始:哪次 Agent 失败让你查了很久,最后仍解释不清?或者,你做过哪次有效的修改,却还没有找到合适的方法证明它?
欢迎把这些问题,以及你已经摸索出来的办法,带进这个系列。愿意动手的朋友,也欢迎一起参与后续的实验,以及工具的使用和改进。
我们希望下一篇文章、下一轮实践,就能回应你手上正在做的工作。
参考资料
1
《Dancing With Systems(与系统共舞)》: donellameadows.org/archives/da...
2
LangChain: www.langchain.com/about
3
讨论代码与运行轨迹关系的文章: www.langchain.com/blog/in-sof...
4
相关介绍: www.langchain.com/blog/the-ag...

往期内容推荐
了解更多
添加社区小助手,加入微信交流群~