"为什么下雨以后,天空会出现彩虹?"
"给我讲一个关于勇气和友谊的小故事吧。"
"我们一起练习用英语打招呼,好不好?"
小朋友的脑袋里,总有许多有趣的问题。
最近,我把这些日常场景做进了一个 Windows 桌面软件,给它起名叫 "小芽 · 儿童语音伙伴" 。打开语音模式,喊一声"小芽小芽",听到"我在,请说",就可以直接提问。
它能显示回答,也能把回答读出来。家长可以和孩子一起听故事、聊科普、练英语,开发者也可以打开完整源码,研究一个语音助手从收音到开口的实现过程。
这次更新到了 r4,增加了 GPU 语音合成、自部署大模型接口,也继续打磨了整个对话流程。
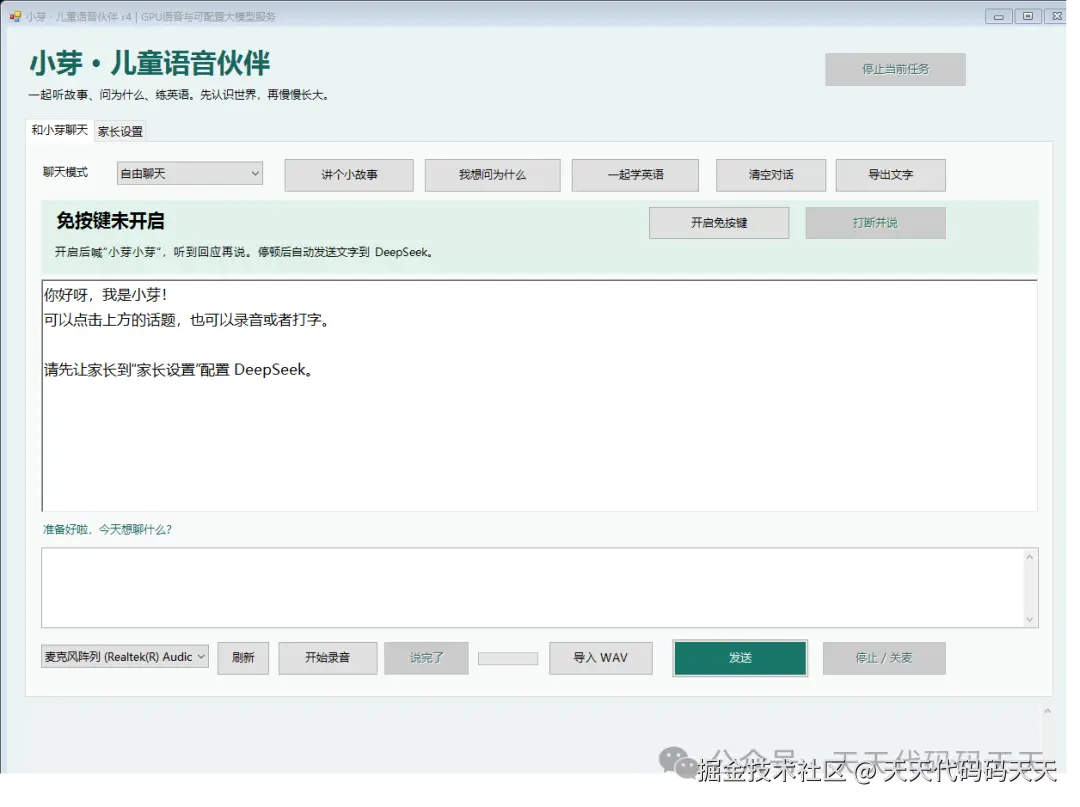
小芽儿童语音伙伴聊天界面
从听故事、问为什么开始
目前软件提供四种聊天模式:
| 模式 | 可以怎样使用 |
|---|---|
| 自由聊天 | 聊今天遇到的事情,提出自己感兴趣的问题 |
| 晚安故事 | 提供主题,让小芽生成一个简短故事并朗读 |
| 十万个为什么 | 围绕彩虹、植物、动物等话题继续追问 |
| 英语小课堂 | 练习简单问候和日常表达,一次学习一句 |
这些内容由配置的大模型生成。家长可以设置年龄,帮助软件组织更适合孩子理解的回答;故事和解释仍需要家长一起判断,AI也会说错。
我喜欢的一个使用场景是:孩子提出一个问题,家长和他一起听回答,再讨论"它说得对不对""我们能不能做个小实验"。这样,软件也能成为亲子交流的话题来源。
喊一声就能开始,回答后还能继续追问
软件保留了手动录音、打字和导入 WAV 的方式,也加入了更接近智能音箱的免按键交互。
使用时先点击"开启免按键",然后:
- 喊"小芽小芽",也可以在设置中选择"你好小芽"。
- 听到"我在,请说"后,再说出问题。
- 说完稍作停顿,软件自动截取语音、识别文字并提交问题。
- 回答结束后,可以直接继续追问;等待一段时间没有说话,会回到待机。
"现在几点了""今天星期几"等问题会由本机时钟回答。"再见"可以让它回到待机,"关闭麦克风"可以结束语音模式。界面也保留了"停止 / 关麦"和"打断并说"按钮。
当前默认使用外放半双工:小芽回答时丢弃麦克风输入,减少扬声器声音被再次识别的问题。耳机用户可以尝试实验性的唤醒打断,但本版还没有外放全双工回声消除,远场和嘈杂环境的体验需要结合设备实际测试。
这次重点:让显卡承担耗时的语音合成
做语音助手,能回答问题只是第一步,等待多久才开口,也很影响体验。
我们把链路拆开测了一遍:本地短问题识别已经比较快,Kokoro 的 CPU 语音合成则需要数秒。因此,这版采用 CPU 识别、唤醒和截句,GPU 加速语音合成 的组合。
在 RTX 4060 Laptop、约 8GB 显存、2个CPU线程的电脑上,用同一句约 3.88秒的中文语音,对比 r4 内部的两条执行路径:
| 测试项目 | CPU 合成 | DirectML GPU 合成 |
|---|---|---|
| 第一次合成,包含首次执行开销 | 约5.05秒 | 约3.07秒 |
| 后续连续3次合成平均 | 约5.16秒 | 约0.32秒 |
这段预热后样本的合成速度约提升16倍。 这个数字对应语音合成环节;完整对话还包括截句、识别、网络请求和播报,不同句长、音色和首次执行也会影响耗时。
在模型已加载、完成确认语预热后,一次使用合成问题音频、真实请求 DeepSeek 的"识别→回答→GPU合成"测试中,本地识别约 280毫秒 。从提交文字问题起,模型首字约 0.83秒 ,首段音频约 2.16秒生成。其中播放端按音频时长模拟消费,未测量实体麦克风和扬声器的实际出声延迟;这也是一次样本结果,并非固定响应承诺。
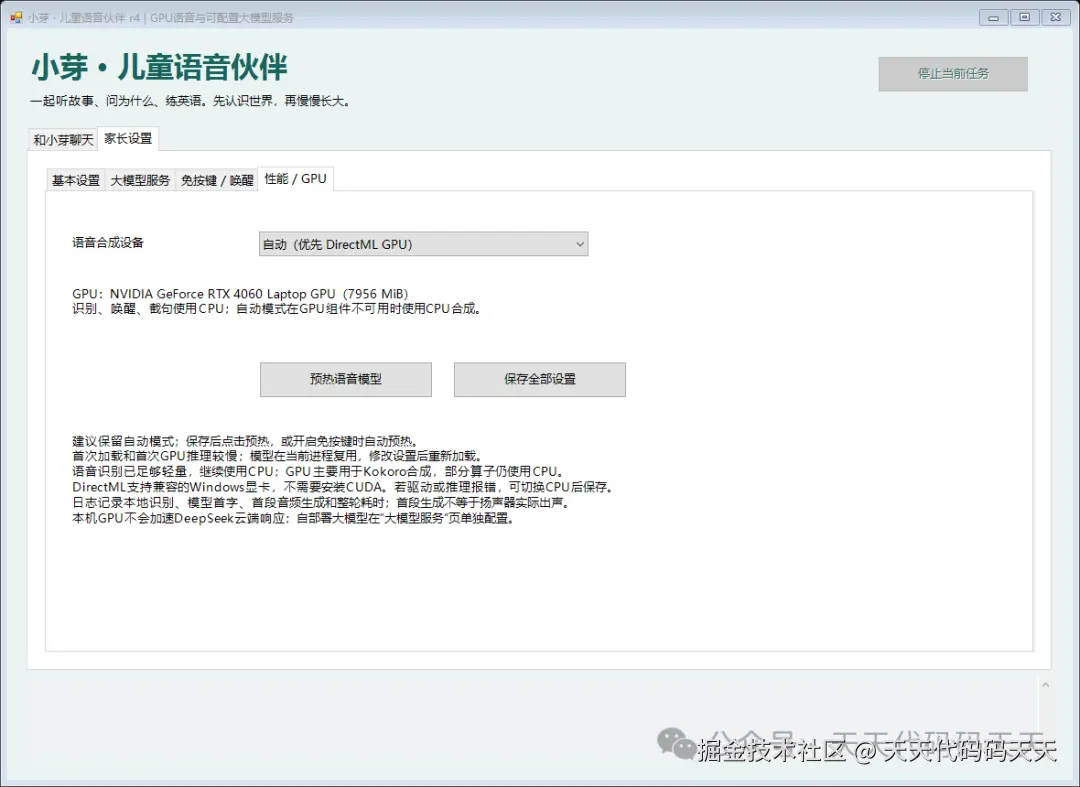
GPU设置与模型预热
GPU 后端采用 DirectML,运行包已经包含配套组件,无需额外安装 CUDA。默认自动选择兼容显卡,笔记本上会优先选择专用显存较大的设备;没有可用 GPU 时可以用 CPU。具体兼容性和加速幅度仍取决于显卡与驱动,当前硬件实测覆盖的是上述 RTX 4060 Laptop。
除了 GPU,这次还增加了模型预热、确认语缓存、首段短分句合成,以及同一轮回答复用播放设备等优化。目标很直接:减少重复加载,尽早生成第一段声音,让后续回答接得更顺。
它是怎样"听懂,再开口"的?
整个流程可以分成几步:
本地检测唤醒词
      ↓
检测说话与停顿,截取问题音频
      ↓
SenseVoice 在本机识别成文字
      ↓
DeepSeek / 自部署大模型生成流式回答
      ↓
按分句交给 Kokoro 合成语音
      ↓
连续播放,并在界面显示文字
大模型还在继续生成后面的文字时,前面的分句就可以进入语音合成。文字、合成和播放之间使用有容量限制的队列;点击停止后,会取消本轮并清理待处理内容,防止下一次提问还混入上一轮的声音。
GPU 部署也做了专门适配。原始 Kokoro 模型的一维转置卷积在 DirectML 上遇到了兼容性问题,我们将相关算子改写为等价的"插零+普通卷积",保留原始 CPU 模型,并对7个转换算子、3种输入长度做了数值对比验证。部分算子仍由 CPU 执行,这个版本结合了两种设备各自适合的工作。
默认用 DeepSeek,也为自己部署的大模型留好接口
在"家长设置 → 大模型服务"中,可以选择 DeepSeek 官方服务,也可以填写自部署服务的地址、模型名和可选密钥。
只要后台提供软件所支持的流式 OpenAI 兼容 Chat Completions 接口,就可以接入。这给后续使用本机或内网的大模型留下了空间;后台服务需要自行启动,软件本身不负责下载和托管大模型。
DeepSeek 和自部署服务的密钥分别加密保存。填写后可以先测试连接,再保存用于对话。
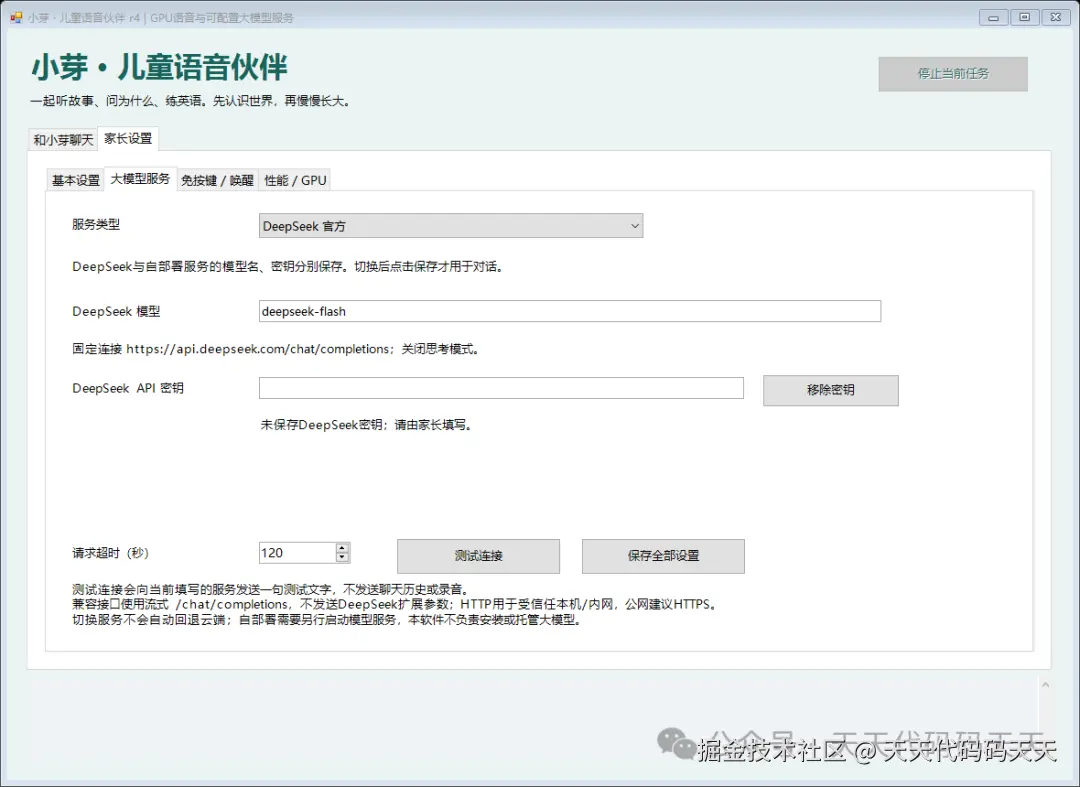
DeepSeek及自部署服务设置入口
这里也说明一下数据流:语音识别与合成都在本地,提问文字和最近最多6轮对话会发送给当前选择的大模型服务。 录音默认只在内存中处理,不自动保存或上传音频;免按键模式唤醒后,识别出的提问文字会自动提交。
使用 DeepSeek 需要联网,并按账户产生相应调用费用。接入本机模型时,是否能够全程离线,取决于后台服务的实际部署方式。
拿到软件后,怎样开始使用?
先把完整运行包解压到有写入权限的目录,再打开 KidsVoice.Workshop.exe。需要 Windows 10/11 x64 和 .NET Framework 4.8,日常运行不需要安装 Python。
接着完成下面几步:
- 配置大模型。 在家长设置中填写 DeepSeek 密钥,或配置自己的兼容服务,测试后保存。
- 选择使用习惯。 设置年龄、中文或英文音色、语速,以及每时段的分钟数和提问次数。
- 预热语音。 在"性能 / GPU"中保留自动模式,保存后点击"预热语音模型";首次加载需要多等一会儿。
- 先试一轮手动对话。 选好麦克风,录音后检查识别文字,再发送问题。
- 再开启免按键。 喊"小芽小芽",听到回应后开始提问。
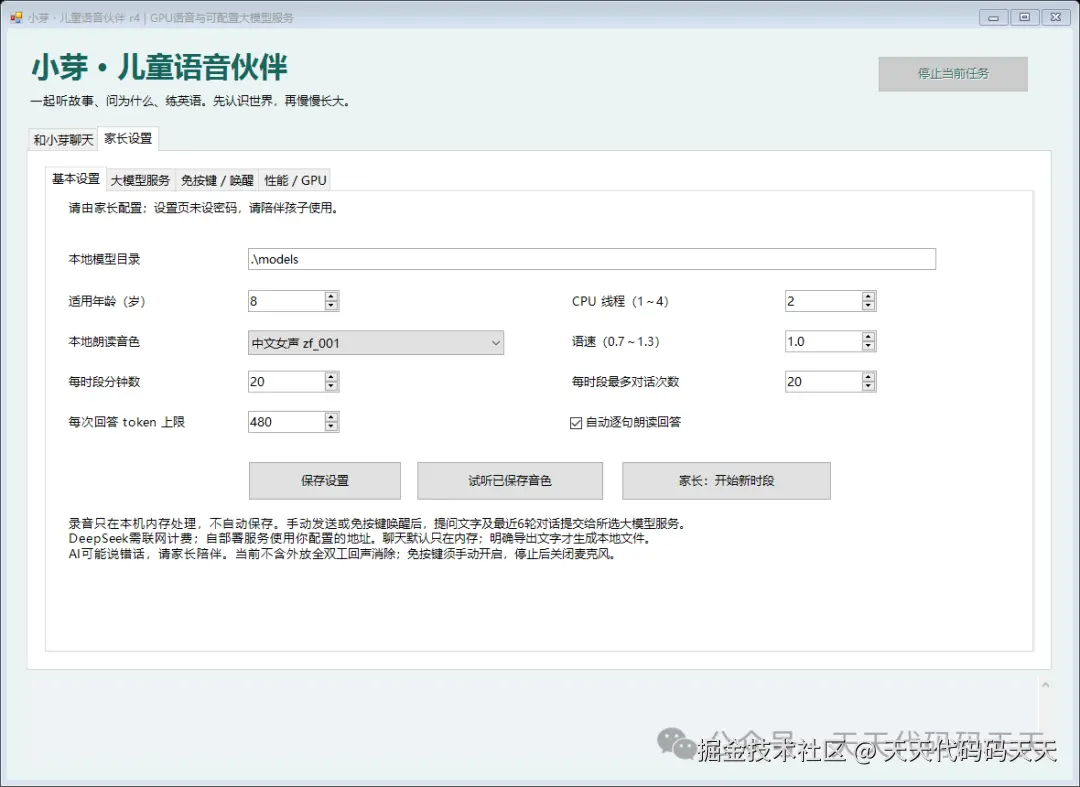
年龄、音色和使用时段设置
模型和工作区默认使用相对 EXE 的路径。请保留完整目录,不要只复制一个 EXE,也不要直接在压缩包里运行。
也把完整 C# 项目留给喜欢动手的朋友
这个版本提供完整 Windows 运行包和 VS2022 源码包,各约 388MiB,包含所需模型和配套运行库。
界面使用 C# WinForms、.NET Framework 4.8、.Designer.cs 和 .resx ,可以继续用设计器调整。安装 VS2022 的 .NET 桌面开发工具与 Framework 4.8 目标包后,打开解决方案,选择 Release | x64 即可编译应用,无需另外下载模型或进行 NuGet 还原。
如果你也在研究桌面语音软件,这个项目里可以看到录音、自动截句、识别、流式接口、语音合成、播放缓冲、取消操作,以及 GPU 模型适配怎样串成一个完整流程。源码包中也保留了使用说明、测速记录和第三方组件许可。
目前已经完成独立解压、源码重新编译、GPU多音色合成、识别回环和界面检查。孩子口音、实体麦克风、房间混响与外放听感,还需要在实际使用的电脑上继续打磨。
小芽有年龄提示和使用时段限制,但设置页没有密码锁,这些功能不能替代家长陪伴,也不能保证模型回答始终正确。和孩子一起使用、一起核对有趣的答案,是我更期待的打开方式。
如果你也喜欢这类能拿来使用、也能打开源码研究的小工具,欢迎一起交流。
交流QQ群:天天代码码天天
群号:264292622
希望有一天,小朋友喊一声"小芽小芽",开启的是一次愉快的提问,也是一段和家人共同探索世界的时间。