背景:记录分享页 需要把「摘要」导出为文档供用户下载。摘要内容为 Markdown 渲染的 HTML,包含标题、时间、表格、列表和图片(OSS 跨域图片)。 结论先行:只有「真 OOXML docx + 图片二进制内嵌」能在手机端 Word / WPS / 文件预览里完整显示,其余方案在手机端都有硬伤。
一、为什么手机打不开图?三种方案的对比
| 方案 | 文件实质 | 桌面 Word | 手机 Word | WPS / 手机预览 | 结论 |
|---|---|---|---|---|---|
HTML 伪装 .doc(application/msword + HTML) |
HTML 文本 | ✅ 图片正常 | ❌ 图片不显示 | ❌ 图片不显示 | PC 可用,手机无图 |
altChunk docx(html-docx-js) |
HTML 原样塞进 docx 包 | ✅ 打开时合并渲染 | ❌ 打开空白 | ❌ 打开空白 | 手机端不支持 altChunk |
真 OOXML docx(docx 库) |
图片为二进制打包进 word/media/ |
✅ | ✅ | ✅ | 最终方案 |
1. HTML 伪装 .doc:桌面能看,手机无图
.doc 文件本质是 HTML。桌面 Word 内置 HTML 渲染引擎,能解析 <img src="data:image/jpeg;base64,...">;但手机 Word / WPS / 系统文件预览对 HTML 版 .doc 支持很差,普遍不解析 data URI 图片------图片区域直接空白。这是格式层面的限制,代码侧无解。
2. html-docx-js:altChunk 机制的陷阱
html-docx-js 生成的 docx 使用 altChunk 机制:HTML 原样嵌入包内,靠桌面版 Word 打开时现场合并渲染 。手机 Word、WPS、微信/QQ 文件预览都不支持 altChunk,读到包里没有任何可渲染内容,打开即空白。
3. docx 库:把 HTML 结构转成真正的 Word 元素
用 docx 库解析 HTML DOM,把每个元素映射为 OOXML 元素(段落 / 表格 / ImageRun),图片解码后以二进制写入 word/media/。产物是标准 OOXML,全端兼容。
二、最终方案设计
2.1 按端分流
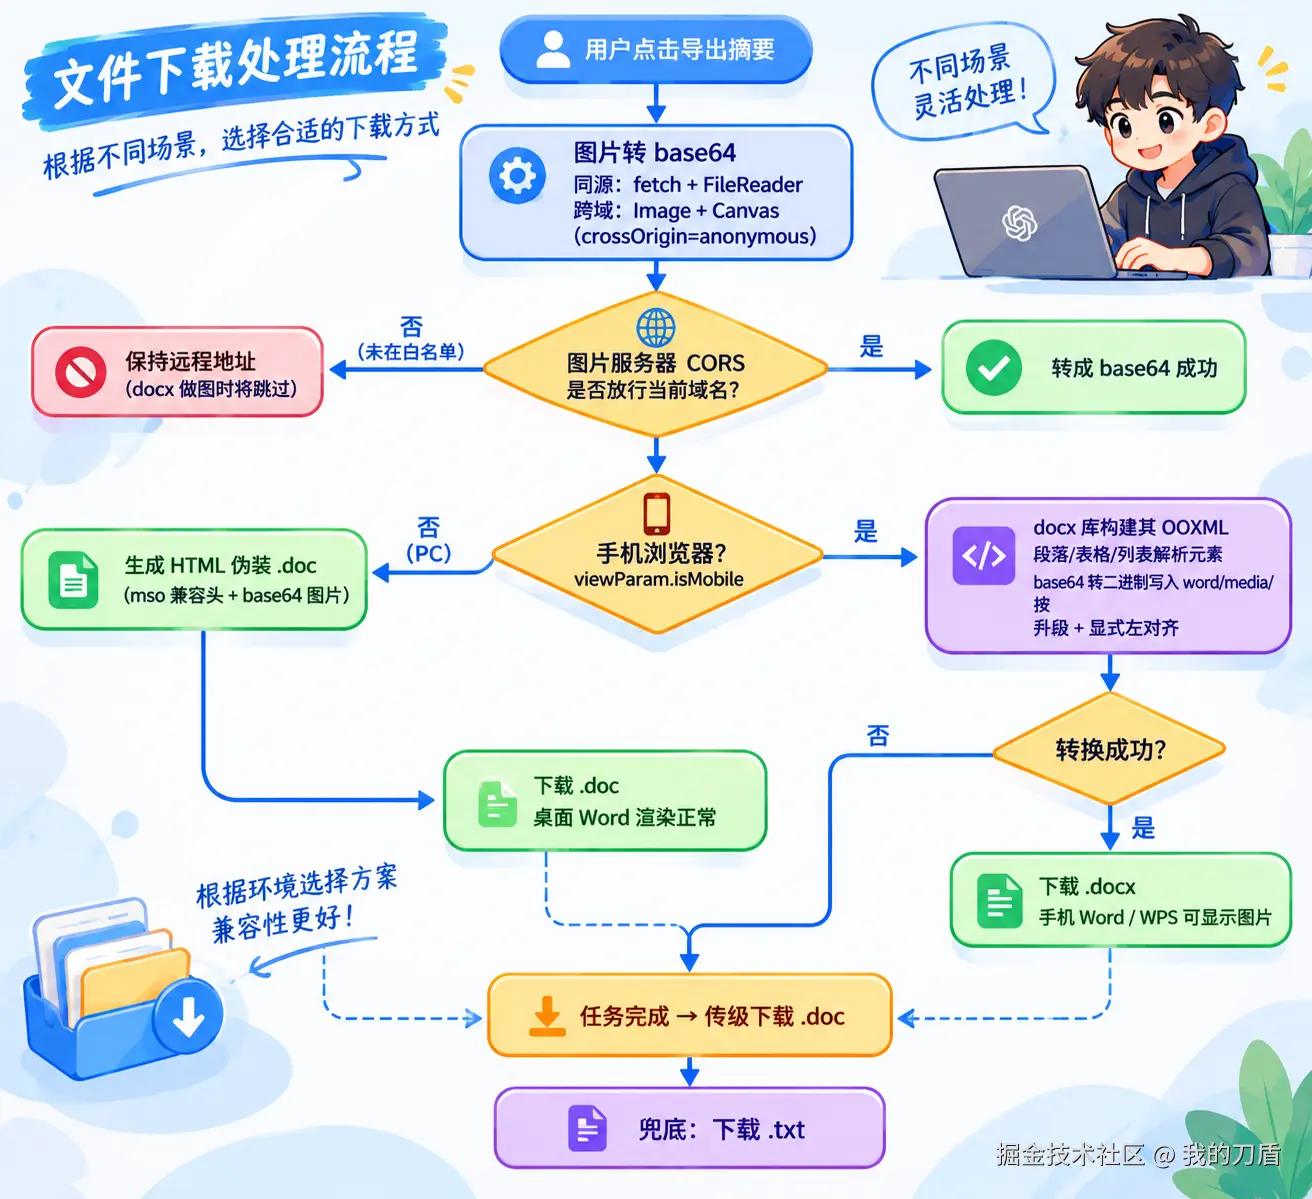
- 手机浏览器 (UA 检测
viewParam.isMobile):docx库生成真.docx,图片二进制内嵌 - PC 浏览器 :维持原 HTML 伪装
.doc(桌面 Word 渲染正常,改动最小) - 纯文本 tab :两端都用
.doc(无图片,手机端显示文字没有问题) - 降级链路 :docx 转换失败 → 降级
.doc→ 再失败 → 降级.txt
2.2 前置条件:图片必须是 base64
docx 无法引用远程 URL,导出前先把所有图片转 base64:
- 同源图片:直接
fetch→ blob → FileReader - 跨域图片:
Image + Canvas(img.crossOrigin = 'anonymous')→canvas.toDataURL
依赖:图片服务器的 CORS 配置 。浏览器以 CORS 模式请求图片,若服务器不返回 Access-Control-Allow-Origin,Image 加载直接失败。OSS 白名单需覆盖实际部署域名,否则转换失败 → 图片保持远程地址 → docx 嵌图时被跳过。
2.3 HTML → OOXML 元素映射
| HTML | OOXML(docx 库) |
|---|---|
h1--h4 |
加粗标题,分级字号(32/28/24 半磅) |
p、行内 strong/em/del/code/a |
对应样式的 TextRun |
table |
带边框 Table,表头灰底(E8E8E8)加粗 |
ul / ol |
项目符号列表 / 手动编号列表 |
img(base64) |
居中 ImageRun,按 width/height 属性(上限 500×800px) |
blockquote |
左缩进 480 + 灰底 |
pre |
Courier New 代码块 |
hr |
thematicBreak 分隔线 |
全局默认样式:微软雅黑(含 eastAsia 声明,避免中文回退宋体)、10.5pt、显式左对齐。
三、手机端特有的坑
3.1 手动换行导致整行拉伸
现象:标题、引用块里每个字被拉开、平均分布到整行;正文正常。
原因 :手机 Word/WPS 会把含 <w:br/> 手动换行的段落整行拉伸铺满 。marked 配置了 breaks: true,标题(「标题\n时间」)和引用块内的换行都生成了 <br>。
修复 :转换时按 <br> 把段落拆成独立段落 ,产物中不存在任何手动换行;同时 docDefaults 显式声明 alignment: LEFT。
3.2 标题字号
标题段落加 docx-title 标记类,转换时首段用 16pt 加粗,<br> 之后的时间行自动恢复默认 10.5pt(拆段逻辑中遇到 BR 丢弃首段附加样式)。
3.3 诊断日志
[docx导出] X/Y 张图片未转成 base64,将不会出现在 docx 中------导出前统计[docx导出] 图片非 base64,已跳过(前缀): ...------逐张跳过原因
四、关键代码示例
4.1 按端分流与降级链路
js
/** 下载为 .doc(isDocHtml=true 时 content 为完整 HTML)或降级为 .txt
 *  手机浏览器走真 docx:手机 Word/WPS 不解析 HTML .doc 里的 base64 图片,只有 OOXML 内嵌图片才能显示;PC 维持 .doc */
downloadDocOrTxt(content, beforeDot, isDocHtml) {
  const downloadBlob = (blob, filename) => {
    const url = URL.createObjectURL(blob)
    const a = document.createElement('a')
    a.href = url
    a.download = filename
    a.style.display = 'none'
    document.body.appendChild(a)
    a.click()
    document.body.removeChild(a)
    URL.revokeObjectURL(url)
  }
  const downloadDoc = () => {
    const html = isDocHtml
      ? content
      : `<!DOCTYPE html><html><head><meta charset="UTF-8"></head><body><pre>${this.escapeHtml(content)}</pre></body></html>`
    downloadBlob(new Blob(['\uFEFF' + html], { type: 'application/msword' }), beforeDot + '.doc')
  }
  try {
    if (isDocHtml && this.viewParam.isMobile) {
      // 手机端:生成真 docx(图片为二进制内嵌),失败时降级回 .doc
      this.htmlToDocxBlob(content)
        .then(blob => downloadBlob(blob, beforeDot + '.docx'))
        .catch(e => {
          console.warn('docx 转换失败,降级为 .doc:', e)
          try {
            downloadDoc()
          } catch (e2) {
            downloadTxt() // 最终兜底
          }
        })
    } else {
      downloadDoc()
    }
  } catch (e) {
    downloadTxt()
  }
}
4.2 跨域图片转 base64(Image + Canvas)
js
/** 使用 Image + Canvas 将跨域图片 URL 转为 base64(需服务器支持 CORS) */
imageUrlToBase64(src) {
  return new Promise((resolve) => {
    const img = new Image()
    img.crossOrigin = 'anonymous' // 服务器无 CORS 头时这里会直接 onerror
    img.onload = () => {
      try {
        const canvas = document.createElement('canvas')
        canvas.width = img.naturalWidth
        canvas.height = img.naturalHeight
        canvas.getContext('2d').drawImage(img, 0, 0)
        // JPEG 兼容性更好;手机 Word 对 PNG base64 支持不佳
        const dataUrl = canvas.toDataURL('image/jpeg', 0.92)
        resolve(dataUrl)
      } catch (_) {
        resolve(src) // 画布被跨域污染时兜底:保留原 URL
      }
    }
    img.onerror = () => resolve(src)
    img.src = src
  })
}
4.3 HTML → docx:入口与全局样式
js
import { Document, Packer, Paragraph, TextRun, ImageRun, Table, TableRow, TableCell,
  AlignmentType, BorderStyle, WidthType, ShadingType } from 'docx'

async htmlToDocxBlob(html) {
  const dom = new DOMParser().parseFromString(html, 'text/html')
  // 诊断:统计未转 base64 的图片
  const imgs = dom.body.querySelectorAll('img[src]')
  const remoteImgs = Array.from(imgs).filter(i => !i.getAttribute('src').startsWith('data:')).length
  if (remoteImgs > 0) console.warn(`[docx导出] ${remoteImgs}/${imgs.length} 张图片未转成 base64,将不会出现在 docx 中`)

  const children = []
  Array.from(dom.body.childNodes).forEach(node => this.appendDocxBlock(node, children))

  const doc = new Document({
    styles: {
      default: {
        document: {
          run: { font: { ascii: 'Microsoft YaHei', eastAsia: 'Microsoft YaHei', hAnsi: 'Microsoft YaHei' }, size: 21 },
          // 显式声明左对齐:手机 Word/WPS 对未声明对齐的中文段落会按两端对齐渲染
          paragraph: { alignment: AlignmentType.LEFT, spacing: { after: 100, line: 300 } }
        }
      }
    },
    sections: [{ children }]
  })
  return Packer.toBlob(doc)
}
4.4 段落转换:按 <br> 拆段(修复手机端拉伸)
js
case 'P': {
  // 按 <br> 拆分为独立段落:手机 Word/WPS 对含手动换行的段落会把整行拉伸铺满
  // docx-title 标记的段落首行(标题)使用大字号,后续行(时间)保持默认字号
  const isTitle = node.classList.contains('docx-title')
  const segments = this.inlineRunsSplitByBr(node, isTitle ? { size: 32, bold: true } : undefined)
  segments.forEach(runs => {
    if (runs.length) out.push(new Paragraph({ children: runs }))
  })
  return
}

/** 行内内容按 <br> 拆分为多段 TextRun/ImageRun 数组 */
inlineRunsSplitByBr(node, firstSegmentStyle) {
  const segments = [[]]
  const walk = (el, style) => {
    if (el.nodeType === Node.TEXT_NODE) {
      const text = el.textContent.replace(/\s+/g, ' ')
      if (text.trim() || text === ' ') segments[segments.length - 1].push(new TextRun({ text, ...style }))
      return
    }
    if (el.nodeType !== Node.ELEMENT_NODE) return
    const tag = el.tagName
    if (tag === 'BR') {
      segments.push([])
      delete style.size // 换行后的行(如时间行)不再使用首段的大字号
      return
    }
    if (tag === 'IMG') {
      const run = this.imgToDocxRun(el)
      if (run) segments[segments.length - 1].push(run)
      return
    }
    const nextStyle = { ...style }
    if (tag === 'STRONG' || tag === 'B') nextStyle.bold = true
    if (tag === 'EM' || tag === 'I') nextStyle.italics = true
    // ... del/strike、code/等宽字体、a/下划线
    el.childNodes.forEach(child => walk(child, nextStyle))
  }
  node.childNodes.forEach(child => walk(child, firstSegmentStyle ? { ...firstSegmentStyle } : {}))
  return segments
}
4.5 base64 图片 → ImageRun(二进制内嵌)
js
imgToDocxRun(img) {
  const src = img.getAttribute('src') || ''
  const match = src.match(/^data:(image\/[\w+.-]+);base64,(.+)$/)
  if (!match) {
    console.warn('[docx导出] 图片非 base64,已跳过(前缀):', src.slice(0, 100))
    return null // 远程图片无法嵌入,跳过
  }
  const bytes = Uint8Array.from(atob(match[2]), c => c.charCodeAt(0))
  const w = Math.min(parseInt(img.getAttribute('width'), 10) || 300, 500)
  const h = Math.min(parseInt(img.getAttribute('height'), 10) || Math.round(w * 0.75), 800)
  return new ImageRun({ data: bytes, transformation: { width: w, height: h } })
}
4.6 表格转换(表头灰底加粗)
js
tableToDocx(tableEl) {
  const border = { style: BorderStyle.SINGLE, size: 4, color: '666666' }
  const rows = Array.from(tableEl.rows).map(tr => {
    const cells = Array.from(tr.cells)
    const isHead = tr.parentElement.tagName === 'THEAD' || cells.every(cell => cell.tagName === 'TH')
    return new TableRow({
      tableHeader: isHead,
      children: cells.map(cell => new TableCell({
        shading: isHead ? { type: ShadingType.CLEAR, fill: 'E8E8E8', color: 'auto' } : undefined,
        margins: { top: 80, bottom: 80, left: 120, right: 120 },
        children: [new Paragraph({ children: this.inlineToDocxRuns(cell) })]
      }))
    })
  })
  return new Table({
    width: { size: 100, type: WidthType.PERCENTAGE },
    borders: { top: border, bottom: border, left: border, right: border, insideHorizontal: border, insideVertical: border },
    rows
  })
}
五、流程图
六、注意事项与运维依赖
- OSS CORS 白名单必须覆盖部署域名 (含协议,如
https://*.example.com),否则跨域图片转 base64 失败,docx 里没有图片。这是运维配置,代码侧无兜底。 docx@7.8.2使用固定版本(ES5 产物,webpack 4 / babel 兼容);v9 起ImageRun需要type参数,升级时需改造。- 导出依赖控制台日志排查问题,关注
[docx导出]前缀的警告。 - 纯文本导出走
.doc路径,两端一致,不涉及图片问题。