一张道路图片,如何变成可分析的场景信息?海量图片,又如何转化为可检索、可筛选的数据资产?
在汽车行业,图片中包含的道路和交通信息,需要经过提取、整理,才能用于后续分析和样本筛选。多模态模型提供了新的处理方式,而批量调用、异常处理和结果写入,则需要与现有数据处理作业一起完成。
某汽车头部客户基于阿里云 EMR Serverless Spark AI Function,在分合流、红绿灯等场景中开展多模态数据处理,并将向量化结果衔接至下游数据库,为后续场景检索、样本筛选及训练数据集构建提供支撑。
大规模模型调用的工程挑战
当处理对象从少量图片扩展到持续积累的业务数据时,模型调用就需要与数据读取、并行执行、结果解析和数据写入共同协作。
如果自行封装模型调用,开发者往往还需要处理连接复用、服务限流、失败重试等通用问题。数据处理逻辑与模型请求逻辑交织,增加了开发和维护的工作量。不同业务场景重复建设类似的调用代码,也会影响能力复用。
规模化处理还需要协调两种不同的执行节奏:Spark 可以并行处理数据,模型服务则有自己的吞吐和配额约束。仅增加数据任务的并行度,并不一定能带来相应的处理提速。
因此,企业需要把模型调用与数据作业的执行、管理和维护结合起来,让 AI 能力顺畅进入现有数据生产流程。
EMR Serverless Spark AI Function 正是面向这一需求,将模型能力封装为内置函数,让数据工程师能够通过 SQL 、 PySpark 或Ray 调用模型,并与过滤、关联、解析、写表等步骤衔接。
客户实践:从场景理解到批量向量化
一张道路图片里,可能有车道分岔、车辆汇入,也可能有路口信号灯。当图片规模达到亿级,如何批量提取这些信息,并将其整理为可分析、可筛选的数据,就成为数据处理中的重要任务。
截至目前,该客户已在阿里云 EMR Serverless Spark 平台完成数亿张图片的处理。 图片理解、信息提取与向量生成通过 AI Function 接入 Spark 作业,处理结果用于后续数据检索和样本筛选。
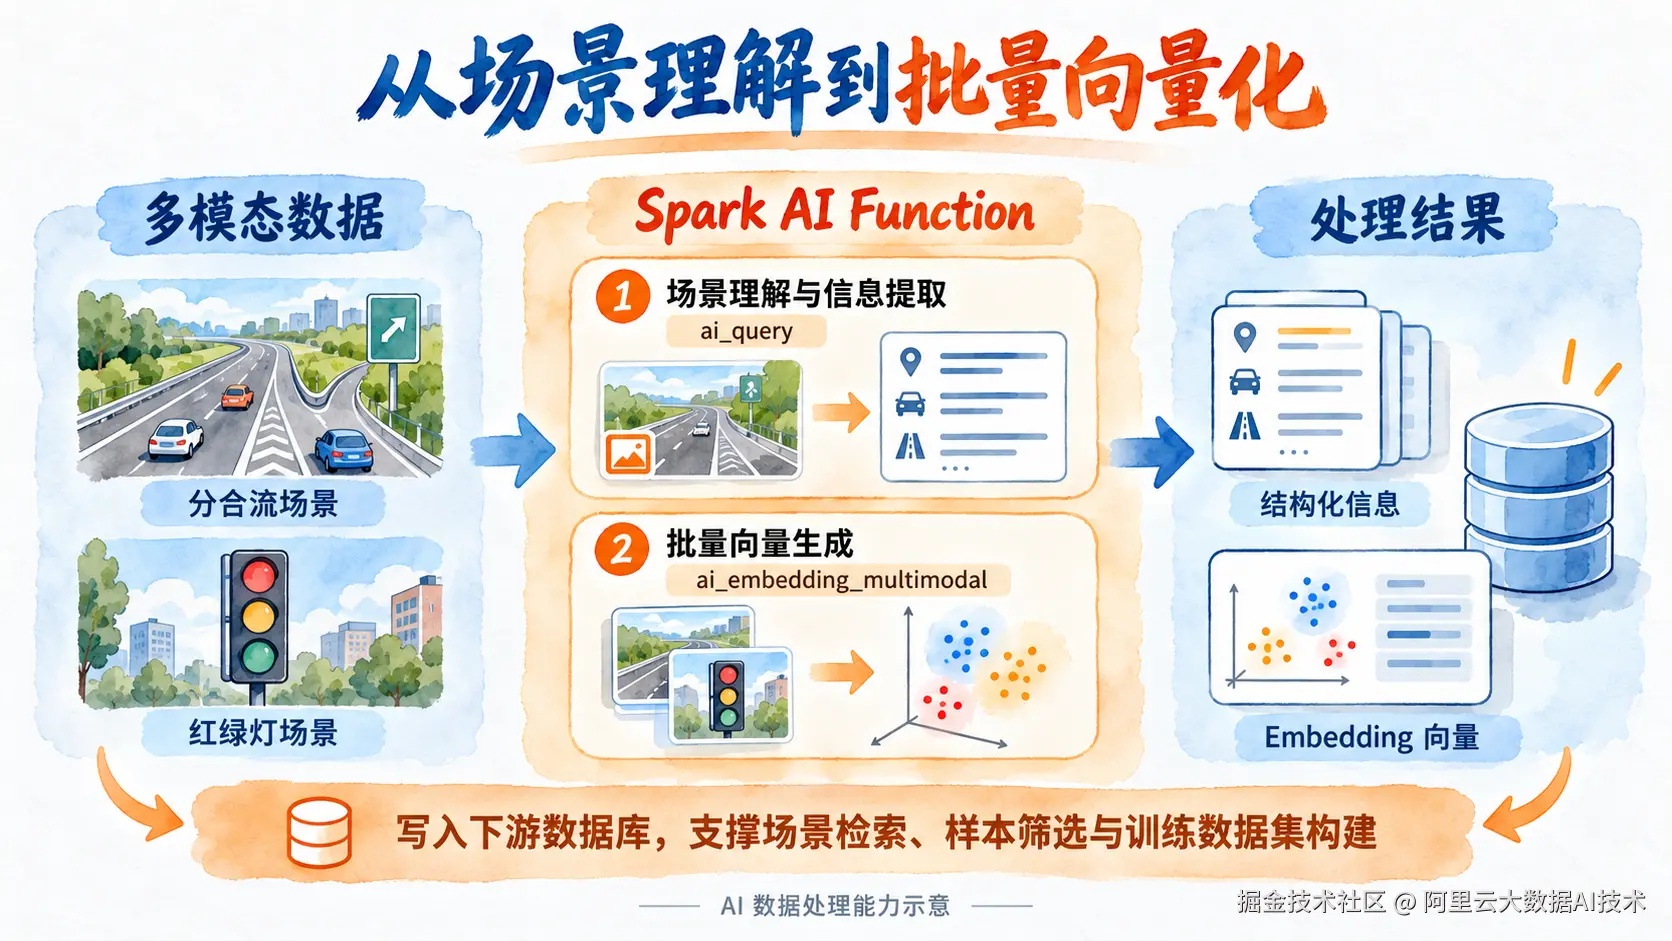
分合流与红绿灯:从道路画面中提取场景信息
在分合流场景中,模型识别道路的分岔与汇入情况;在红绿灯场景中,模型提取画面中的信号灯信息。提取结果经整理后写入数据表,供后续按场景检索和筛选样本。
在这一过程中,图片读取、模型调用、结果整理和写入可以在 Spark 作业中连续完成。数据工程师可以沿用熟悉的 SQL 、 PySpark 或Ray 开发方式,将图片理解加入已有的数据加工步骤,减少单独封装模型请求、维护调用脚本的工作。
分合流与红绿灯场景需要提取的信息有所不同,但可以使用同一套模型调用方式。对于批量任务中常见的限流、重试等问题,平台提供通用处理机制,帮助开发者将精力集中在提取内容和结果质量上。
批量向量化:为寻找相似道路画面建立基础
除了提取场景信息,图片还可以通过向量化,为后续查找相似样本做好准备。
Embedding 将图片内容转换为一组数字特征,使图片之间的相似程度可以通过计算进行比较,为后续检索提供基础。
客户通过 Spark AI Function 批量生成图片向量,并将这一环节纳入数据加工流程。在实际链路中,数据落入 DLF Paimon 表,由 Spark 作业完成相关加工,生成的 Embedding 写入下游数据库,为场景检索、样本筛选及训练数据集构建提供支撑。
场景信息便于按条件整理数据,向量则为查找相似图片提供依据。通过 Spark AI Function,客户将这两类加工任务接入现有 Spark 流程,让道路图片更便于后续检索和使用。
内置 AI Function,带来四方面价值
EMR Serverless Spark 将常用模型能力封装为 AI Function。开发者可以使用 ai_query 完成图片理解与信息提取,使用 ai_embedding_multimodal 生成图片向量,再通过 SQL 、 PySpark 或Ray 对输出结果进行解析、过滤、关联和写入。AI 调用因此可以作为已有数据作业中的一个处理步骤。
Spark 负责组织批量数据的读取、分布式加工和结果写入,AI Function 负责接入模型能力;两者结合,让图片理解和向量生成能够与现有数据作业一起执行。
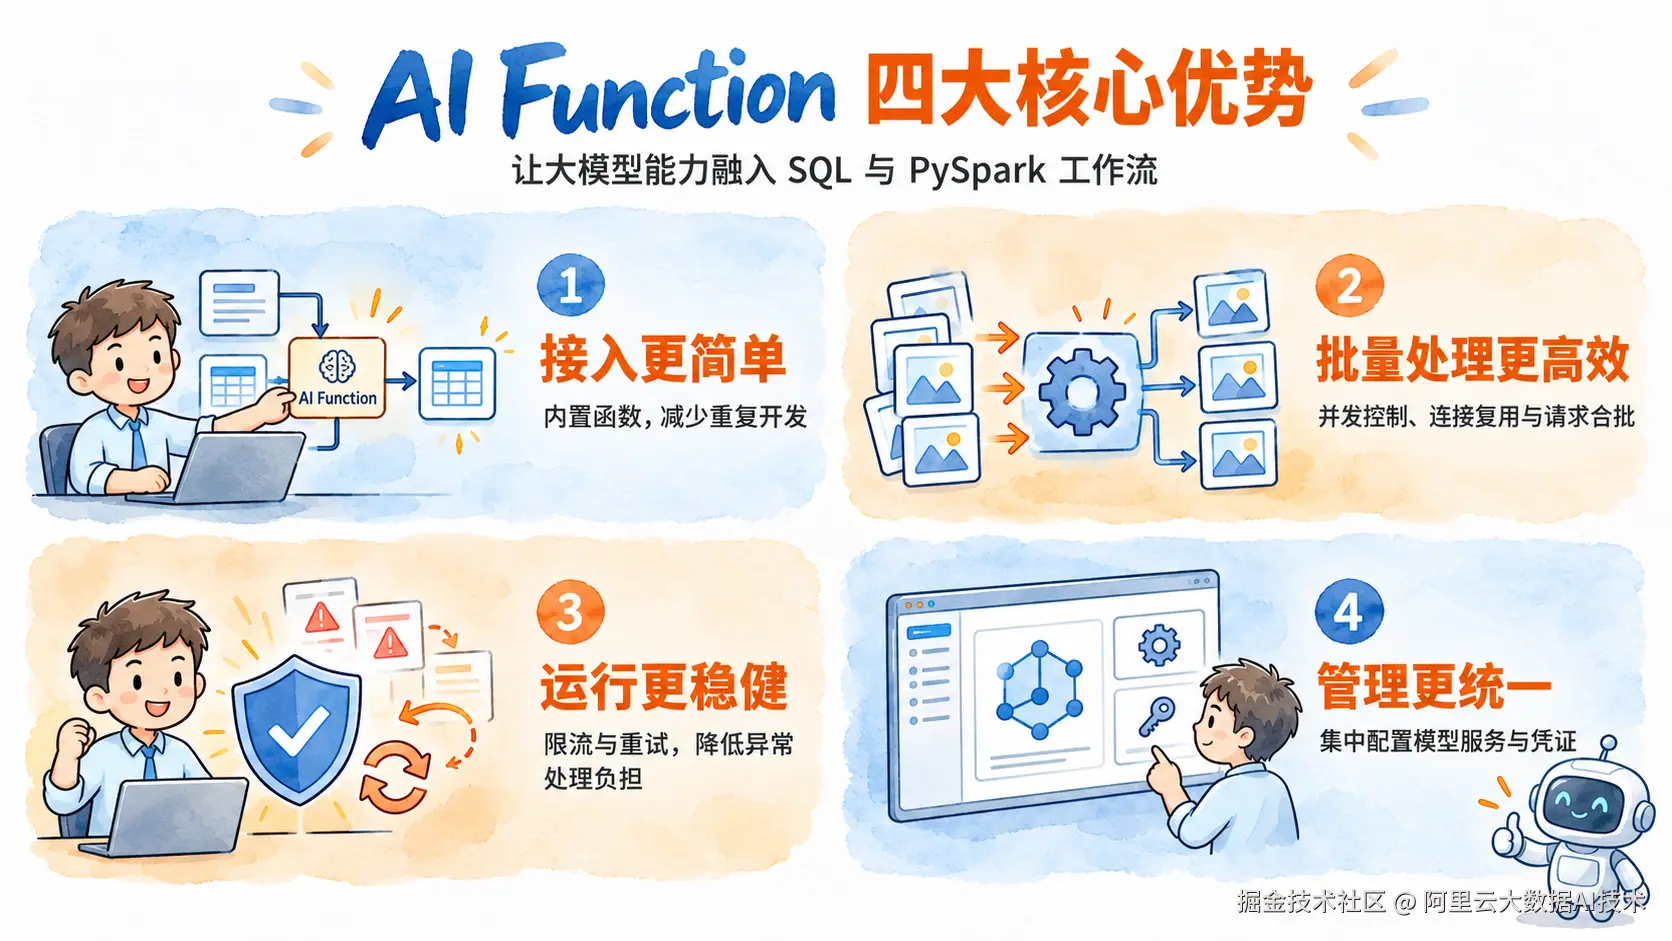
接入更简单:减少重复开发
Spark AI Function 提供 SQL 与 PySpark 调用方式,覆盖内容理解、信息提取、分类、翻译、Embedding 等常见任务。EMR Serverless Ray 也支持 AI Function,可通过 ray.ai 包调用模型。数据工程师可以沿用熟悉的数据开发方式,将 AI 处理与已有作业结合。
对不同数据任务而言,模型请求封装等通用工作可以交由平台承接,减少重复编写调用代码的投入。
批量处理更高效:协调数据并行与模型请求
大规模 AI 数据处理既需要分布式计算,也需要合理组织模型请求。
AI Function 结合并发控制、连接复用及适用场景下的请求合批等机制,减少重复的请求开销,协调 Spark 作业与模型服务的处理节奏。实际吞吐取决于模型服务配额、输入数据及作业配置,用户可以据此规划批量处理任务。
运行更稳健:降低异常处理负担
面对限流、超时或模型服务异常,生产任务需要具备相应的恢复机制。
AI Function 提供限流与重试等能力,减少用户自行维护通用异常处理代码的工作。开发者还可以结合任务要求组织失败数据处理和结果检查,使 AI 调用更好地融入持续运行的数据流程。
管理更统一:便于维护模型服务
通过平台统一配置模型服务地址与凭证,可以减少配置散落在不同脚本中的情况,便于集中维护。 数据任务可以复用已配置的模型服务,并按需求选择相应模型,减少在多个作业脚本中重复配置的工作。
从一个数据任务开始,体验 AI Function
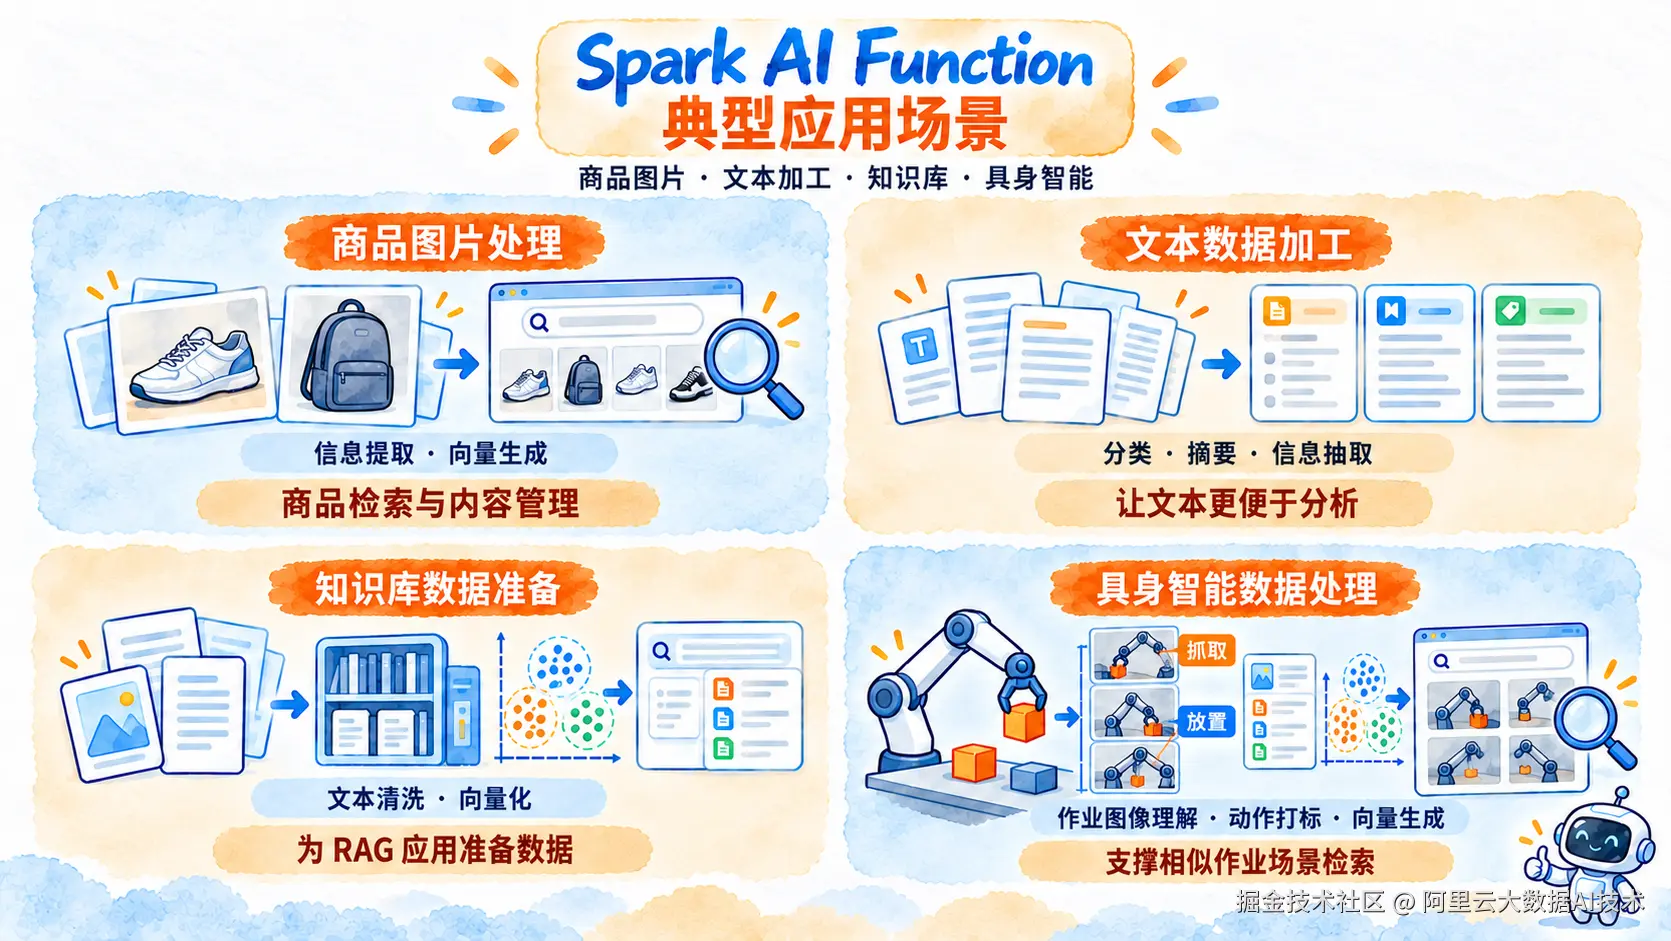
除了汽车场景,AI Function 也可用于以下数据处理任务:
-
商品图片处理: 提取商品图片信息、生成向量,为商品检索与内容管理提供基础。
-
文本数据加工: 完成分类、摘要与信息抽取,使非结构化文本更便于分析。
-
知识库数据准备: 对文本进行清洗与向量化,为检索增强生成(RAG)应用准备数据。
-
具身智能数据处理: 理解机器人作业图像,对抓取、放置等动作进行打标,并生成向量,为相似作业场景检索和样本筛选提供基础。
如果你也有图片理解、信息提取或批量向量化需求,可以从一批样本数据开始验证。开通 AI 中心、确认引擎版本并启用 AI Function 后,即可参考下方示例,在 Spark SQL 或 PySpark 作业中调用相关函数。
欢迎体验阿里云 EMR Serverless Spark AI Function,从一个具体的数据处理任务开始。
了解能力与开通步骤:AI Function 介绍
查看图片理解与向量生成示例:多模态函数使用最佳实践
使用熟悉的 DataFrame API:PySpark 调用 AI Function