前言 :封闭告一段落,开始系统复盘:一个生产 Agent 到底怎么跑起来 。踩坑、经验和落地,最主要的是用户认可,尽量用几篇文章讲清。
这篇文章是系列第7篇:上下文窗口有上限,别当无限仓库乱塞。分清工作记忆、会话状态、长期记忆和 RAG,该写入的写入,不该混放的别混。
希望这篇文章,能给正在搭建 Agent 的朋友一些参考。
线上Agent产品,经常会出现几类问题:
- 用户隔了一周回来,说「还是上次那个支付服务」,系统却不知道「上次那个」指什么。
- 把整本产品手册塞进「用户记忆」,检索时返回一堆无关段落,Token 费用不断上涨,真正的个人偏好反而被淹没。
- 上下文窗口一直往里追加,从不摘要,最终导致输入被截断、推理成本上升。
- 模型只是猜测「可能是 payment-api 服务」,但系统却把它写进会话状态,当成已确认事实。下一轮用户说「查它的日志」,Agent 就可能继续查错服务。
- 用户明确说过「不要重启生产实例」,但旧消息被摘要压缩掉了,Agent 后续又提出甚至尝试执行重启操作。
这些问题看起来是 Agent 的「记忆力」不够好,实际上涉及四个不同层面:上下文组织、会话状态管理、跨会话记忆和企业知识检索。
这篇文章重点讲清楚:
- 四个盒子分开:工作记忆、会话状态、长期记忆、RAG,各管各的;
- 该写才写:区分用户明确表达、工具验证和模型推断,避免把猜测写成事实。
- 窗口有预算:先保留系统规则和当前任务状态,再分配最近对话、记忆和检索结果。
- 按场景选方案: 普通问答、个性化助手、企业运维和长任务 Agent,不能用同一套记忆策略硬套。
- 关注工程成本: 对比数据库、向量检索、摘要压缩和 GraphRAG 的使用场景。
继续用案例 OpsPilot(企业运维助手,虚构案例)。文中示例用 TypeScript,团队线上服务是 Go;换成 Java / Node 也一样,关键是适用场景清楚。
先把四个盒子分开:Agent 的记忆为什么不能混在一起?
很多人会把「记忆」和「检索」混为一谈。先明确一点:模型不会自动访问你的数据库。
每次调用模型时,Runtime 都需要根据当前任务,从会话状态、长期记忆、知识库和最近对话中选择相关信息,再组装成模型可以使用的上下文Prompt。它们不直接喂模型:
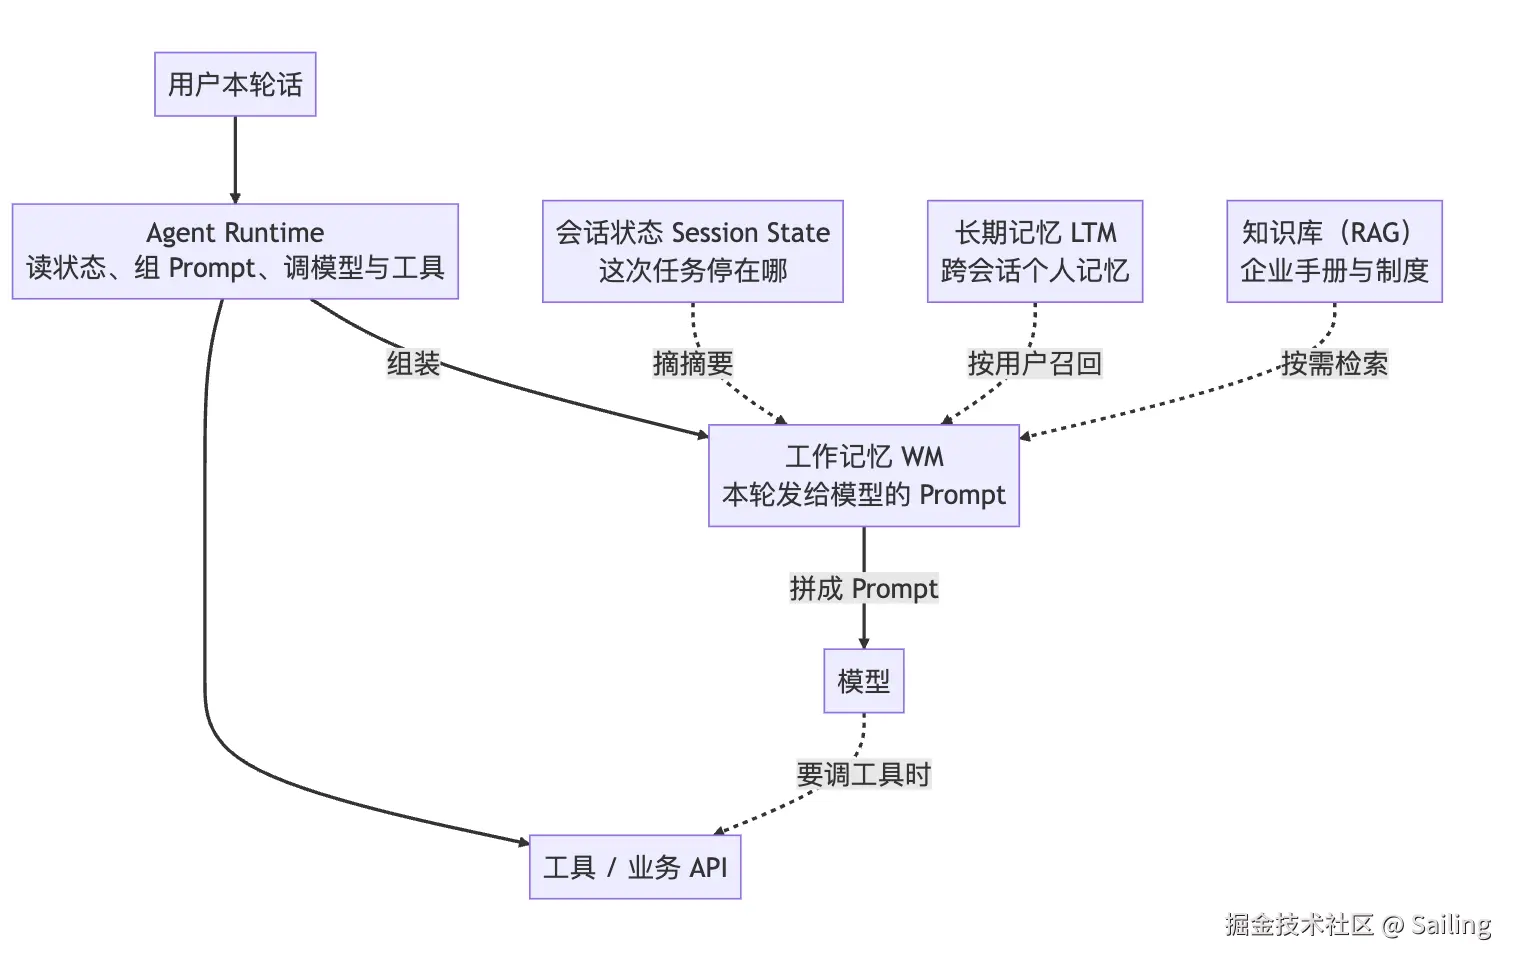
图上四块与文章目录对应,按照目录来理解效果更好:
- 工作记忆(Working Memory,WM):本轮发给模型的那份 Prompt。这一轮调用结束就没了,下一轮要重新拼接,不单独另存到库表等。
- 会话状态(Session State) :这次任务停在哪(当前服务、环境等);落地挂在会话上,代码里写成
SessionState。有人也叫任务状态,指的是同一类东西,本文统一用会话状态。 - 长期记忆(Long-term Memory,LTM):跨会话的个人记忆,多个会话都可以使用(单说 Memory 时常指整套记忆系统,不只这一个)。
- 知识库(RAG):企业文档检索,和 LTM 分开处理。
读图时记住:模型只看工作记忆(WM)拼出来的那份 Prompt;会话状态、长期记忆(LTM)、知识库(RAG)都在 Runtime 外侧,本轮用得到才读进来。若用 LangGraph 时,MessagesState / checkpointer 更靠近「这次 Run 的断点 / 消息」,但代替不了长期记忆(LTM)和知识库(RAG);跨会话的个人偏好,要你自己做一层记忆表 + 读写接口。不使用 LangGraph 也一样,消息列表不等于完整的记忆系统 Memory。
再补一句别混用:
- 用户偏好、说过的话:写入长期记忆(LTM)表,记得按用户隔离。同一偏好,说过两次只留一条。比如他说「改成默认测试」时,要能替换或删掉旧记录。
- 文档、制度:放进共用知识库,用 RAG 检索。大家共用一份,不要按照某个用户单独去改。
- 别反着放:个人说过的话不要进企业知识库;公司规范也不要写进某个用户的记忆表。
工作记忆与会话状态
工作记忆:这一轮发给模型的六块内容
还用 OpsPilot 示例来看。用户上一句已确认查生产环境的 payment-api,现在说:「它的错误日志呢」。
这一轮需要拼接的上下文,通常包括下面六块:
text
系统 Prompt          → 你是运维助手,只能查日志,写操作要等人确认...
工具 Schema          → query_logs 需要 serviceId、env、timeRange...
最近对话             → 用户刚才说了什么、助手回了什么(留最近几轮原文)
会话状态摘要         → 当前服务=payment-api,环境=production(从 SessionState 摘过来)
本轮检索/记忆召回    → 按需从库里取片段放进 Prompt。来源可以是长期记忆(如「该用户默认看生产」),也可以是知识库片段(如查日志规范);本轮如果用不上,可以为空。
最新工具结果         → 若刚调过工具,放刚返回的内容;还没调过工具时,可以为空。
这六块是上下文组装时的逻辑分组,不代表每轮都必须填满这些,也不代表它们合起来就是工作记忆的唯一标准。实际发送给模型前,还要经过相关性筛选、权限检查和 Token 预算控制。
拼接好之后,应用层的工作对象可以长这样(字段和上面六块内容对应,注释即字段含义):
ts
const workingMemory: { // 本轮送进模型的工作记忆
  systemPrompt: string
  toolSchemas: unknown[]
  recentMessages: Array<{ role: 'user' | 'assistant' | 'tool'; content: string }>
  sessionStateSummary: Record<string, unknown>
  recalled: Array<{ source: 'ltm' | 'rag' | 'graph'; id: string; text: string; score?: number }>
  latestToolResult?: { toolName: string; content: string }
  runNotes?: string
  tokenBudget: { maxInput: number; reservedForOutput: number }
} = {
  systemPrompt: '你是 OpsPilot...写操作必须等人确认。', // 系统 Prompt:身份、权限、安全规则
  toolSchemas: [{ name: 'query_logs', parameters: { /* serviceId, env... */ } }], // 工具 Schema:本轮可调哪些工具、参数长什么样
  recentMessages: [ // 最近对话原文
    { role: 'user', content: '查一下生产环境 payment-api' },
    { role: 'assistant', content: '已定位到 payment-api(production)。' },
    { role: 'user', content: '它的错误日志呢' }
  ],
  // 会话状态摘要:从 SessionState 摘来;不是再搜一遍聊天记录
  sessionStateSummary: {
    currentService: { id: 'svc_pay', name: 'payment-api' },
    env: 'production'
  },
  recalled: [ // 本轮召回片段:长期记忆或知识库手册等;source 标明来源
    { source: 'ltm', id: 'mem_1', text: '该用户默认看生产环境监控', score: 0.82 }
  ],
  latestToolResult: undefined, // 最新一次工具返回;本轮未调工具可空,调过则放裁剪后的内容
  runNotes: undefined,         // 本轮笔记(可选):多步时有长度上限的短摘要,见下一段
  tokenBudget: {               // 组装预算:控制裁剪,一般不整段写入 Prompt 正文
    maxInput: 24_000,          // 输入 Token 上限
    reservedForOutput: 1_500   // 预留给模型输出
  }
}
多步执行时还有一个常见问题。假设第一步已经调用 search_resource,返回了一大段 JSON。若下一步把"第一步整段 JSON + 第二步新结果"原样追加进历史,输入会随着执行轮次不断膨胀。
更省 Token 的做法是:
- 把已确认的结论写成短字符串,放进上面的
runNotes,例如已确认 payment-api 在 production,资源 id=svc_pay,并设长度上限; - 每步只带上当前决策需要的最新工具结果;
- 更早几步的大段原文可以存到外部,再通过结果 ID 按需取回,不必每轮原样重放。
这时 runNotes 有值,latestToolResult 只放当前这一步的返回。
组装时注意:
- 最近 2 到 6 轮可以作为起点,尽量保留与当前指代和任务有关的原文。具体轮数需要按任务复杂度和 Token 预算调整。
- 更早的对话压成摘要;摘要里要留下环境、服务名、已确认结论和重要限制,不要只剩无信息量的概述。
- 工具结果不要整段丢进 Prompt。例如
query_logs返回 2000 行日志,Prompt 里只放摘要或关键几行(错误码、时间、条数);完整原文存到别处,需要时再用结果 ID 取回。 - 系统 Prompt 和工具定义尽量少改,并尽量保持稳定的输入前缀。如果所使用的模型和 API 支持 Prompt Caching,稳定前缀可能有助于提高缓存命中率,但并非所有模型和 API 都保证支持或命中缓存。
会话状态:任务停在哪
上面例子里,模型能把"它"解析为 payment-api,通常是因为最近对话中提到过这个服务;结构化状态也可以提供辅助。实际系统往往会结合两者,而不是只靠全文搜索历史消息。
本文把挂在会话上的结构化状态称为 SessionState。它可以存放在会话表、关联表或状态存储中;组装 Prompt 时,再按需摘取成 sessionStateSummary。
还是用户说"它的错误日志呢"这一轮,可以长这样:
ts
const sessionState: SessionState = { // 挂在会话上的已确认事实,不是消息原文。
  conversationId: 'conv_123', // 属于哪个会话
  currentService: { id: 'svc_pay', name: 'payment-api' }, // 用户或工具已确认,不是模型瞎猜
  env: 'production', // 已确认环境
  updatedAt: '2026-10-28T10:00:00Z'
}

type SessionState = { // 会话结构化状态:这次任务停在哪
  conversationId: string
  currentService?: { id: string; name: string }
  env?: 'development' | 'testing' | 'production'
  updatedAt: string
}
和消息、Run 不要混存。系列里的会话服务常见的是:消息表、会话(可挂结构化状态)、Run 表。和"解析它 / 续跑"相关的三类东西:
| 存什么 | 存的是什么 | 干什么用 |
|---|---|---|
Message(消息表) |
聊天原文:谁说了哪一句 | 页面历史、审计、事后摘要。Agent 不靠翻整张消息表来解析「它」 |
SessionState(会话结构化状态) |
已确认的服务、环境等 | 下一轮决策;组装时摘成 sessionStateSummary |
Run(这一次执行) |
用户点一次发送按钮对应的后台任务;interrupted 时等人确认 |
确认后接着这次 Run 续跑。断点最小状态可放在 Run 的 checkpoint 字段;更细的中断记录见前几篇文章中的《Agent 中的 SSE 流式推送与 HITL 暂停恢复》 |
消息与 Run 示意(字段与多轮文对齐):
ts
const message: Message = { // 消息表:一行一句聊天原文
  id: 'msg_101', // 消息 id
  conversationId: 'conv_123', // 属于哪个会话
  role: 'user', // 'user' | 'assistant' | 'tool'
  content: '它的错误日志呢', // 展示 / 落库的正文
  createdAt: '2026-10-28T10:00:01Z'
}

const run: Run = { // Run 表:用户点一次发送对应的一次后台任务
  id: 'run_9', // Run id
  conversationId: 'conv_123', // 落在哪个会话
  userMessageId: 'msg_101', // 由哪条用户消息触发
  status: 'interrupted', // running | interrupted | completed | failed | cancelled;等人确认时用 interrupted
  checkpoint: { /* 续跑所需最小状态;形状见 HITL 专文 */ },
  createdAt: '2026-10-28T10:05:00Z',
  updatedAt: '2026-10-28T10:05:00Z' // 状态最后变更时间
}
对照一下:
- 刷新页面,聊过的句子还在 →
Message。 - 用户只说「再查一下它」,系统仍知道是 payment-api →
SessionState(会话上的已确认事实)。 - 点了「重启实例」,弹窗等确认;稍后点确认还能续跑 →
Run(status: interrupted+checkpoint)。不管「用户默认看生产」这类跨会话长期记忆。
只有工具成功或用户明确确认的信息,才写进 SessionState。模型猜测的服务名、失败查询的参数,不要当成已确认事实。
长期记忆与知识库文档
长期记忆不等于 RAG,也不要写进 RAG。 有人觉得"反正都是向量检索,用户说过的话一并丢进知识库就行",但这会把个人偏好和公司手册混成同一池,权限、过期和删除都不好处理。
先分清两件事:
- 长期记忆 :关于「这个用户 / 这个 Agent」的东西,跨会话还在,按
userId隔离。例如「他默认看生产」。 - 知识库(RAG):关于「公司手册怎么写」的东西,多人共享、有版本。例如「运维手册:查日志须同时指定环境和时间范围」。
检索手段可以都类似(都可能用向量),但库、权限、写入通道、失败策略是两套 。长期记忆走自己的存储与 search;公司手册变更走知识库索引。
存哪:起步很常见是 MySQL / PostgreSQL 一张记忆表 (按 userId / tenantId 过滤,能改能删);条数多、要语义相近召回时,再给 content 加向量索引,或旁路一个向量库。这和「企业 RAG 知识库」仍是两套,不要共用一个索引池。
还是 OpsPilot。用户说过「以后默认看生产环境」。这不该写入企业知识库(RAG),应写成一条只属于该用户的长期记忆。
长期记忆:抽、筛、存、用
不要在对话一结束后,就把整段聊天原文原样塞进长期记忆表。更稳妥的方式是先抽出候选结论,再决定是否入库:
- 抽 :本轮聊完后,从对话中提取可能有长期价值的内容。例如用户说"以后默认看生产",得到候选:
默认看生产环境监控。 - 筛:与该用户已有记忆进行去重、合并和冲突检查。若用户明确把"默认测试"改成"默认生产",就更新旧记录;模型自己都没把握的内容,不应直接成为生效记忆。
- 存 :将通过筛选的内容写入长期记忆表,并记录对应的
userId、tenantId和来源。低置信度内容可以丢弃,不要写进企业 RAG 知识库。 - 用:下次用户再说"查一下错误日志"时,使用用户和租户范围进行检索,再把相关记忆按需加入工作集和上下文。
筛过之后,库表里的一行可以长这样:
ts
const memoryItem: { // MySQL / PostgreSQL 长期记忆表的一行,不是 RAG 文档
  id: string
  userId: string
  tenantId: string
  type: string
  content: string
  sourceMessageIds: string[]
  confidence: number
  expiresAt?: string
  createdAt: string
  updatedAt: string
} = {
  id: 'mem_1',                              // 主键
  userId: 'u_42',                           // 用户隔离;查询必须带上
  tenantId: 't_acme',                       // 租户隔离;查询必须带上
  type: 'semantic',                         // 可选分类;起步可先固定写 semantic / preference
  content: '默认看生产环境监控',             // 只记结论;不记访问凭证、不记整段日志
  sourceMessageIds: ['msg_100'],            // 追溯到哪句原话,方便改错、删除
  confidence: 0.91,                         // 抽取把握;过低则本行不写入
  expiresAt: undefined,                     // 可选过期时间
  createdAt: '2026-10-10T08:00:00Z',
  updatedAt: '2026-10-10T08:00:00Z'
}
下一轮用户说"查一下错误日志",召回可能命中 mem_1,于是工作集里的 recalled 就可以包含这条信息。模型在本轮上下文中看到它后,才知道用户通常默认查看生产环境;但如果当前指令与该偏好冲突,应优先遵循当前明确指令和业务权限规则。
写入时注意:
- 查库时带上租户和用户 :
WHERE tenant_id = ? AND user_id = ?。不要指望在 Prompt 里写「别看别人的记忆」。实际中模型靠不住,SQL / 接口过滤才靠得住。 - 用户能改、能删:他说「我改主意了,默认看测试」,旧的「默认看生产」要能更新或标记作废,不能改不了。
- 敏感原文默认不记:访问凭证、整段日志正文不要进记忆表。只记「默认看生产」这类结论。
- 别什么话都记:「嗯」「好的」没信息量,跳过。同一偏好出现两次,合并成一条,别堆重复行。
怎么落地?先有一张记忆表和两个接口就够:add(写入或更新一行)、search(按用户和权限检索相关行)。需要语义相近召回时,再给 content 增加向量检索。不必一上来就建设完整的"记忆运行时"产品。
知识库文档:和长期记忆怎么区分
| 内容 | 放哪 | 为什么 |
|---|---|---|
| "我默认看生产" | 长期记忆(带 userId) |
只对这个用户成立 |
| "运维手册:查日志须同时指定环境和时间范围" | 知识库(RAG) | 公司文档,按权限供相关人员使用 |
| "架构说明:payment-api 依赖 redis-cluster" | 知识库(RAG);如果经常需要多跳查询,再评估 GraphRAG | 公司里的客观关系,不是某个人的偏好 |
本篇只约定:用户偏好走长期记忆,公司文档走 RAG。 一般问答先用基础 RAG;真要回答"谁依赖谁、故障会波及谁"这类需要连查多层关系的问题,再评估 GraphRAG。
GraphRAG 并不是越复杂越好。它的优势是可以帮助处理多跳实体关系问题;代价是图谱构建、关系更新、索引维护和检索延迟都会增加。是否值得上,应该看业务问题是否真的需要关系推理,以及准确率收益能不能覆盖维护成本。
记忆表的 type 字段可选。多数业务起步时先存一行结论就够;以后若要区分信息类型、寿命或召回策略,再使用不同类型,例如:
| type(示意) | 记什么 | 例子 |
|---|---|---|
| preference / 偏好 | 相对稳定的个人偏好 | "该用户默认看生产" |
| episode / 经历 | 某次排查经历 | "2026-10-10 排查过 payment-api 超时" |
| habit / 习惯 | 对该用户怎么回复更合适(不是公司手册) | "给该用户回故障时先结论后证据" |
公司规范放知识库,不要写进某个用户的记忆表。起步一张记忆表、一套读写接口就够,不必按 preference / episode / habit 拆成三套 API。
上下文工程:组装、预算与写入
前面四个盒子回答"东西分别存哪"。上下文工程回答的是:
- 每一轮往模型窗口里装什么;
- Token 不够时裁谁;
- 确认事实怎么写回会话状态(SessionState);
- 本轮答完后怎么抽取长期记忆(LTM)。
下面用同一条 OpsPilot 链路把这些跑通。一轮从读到写,顺序可以看成:
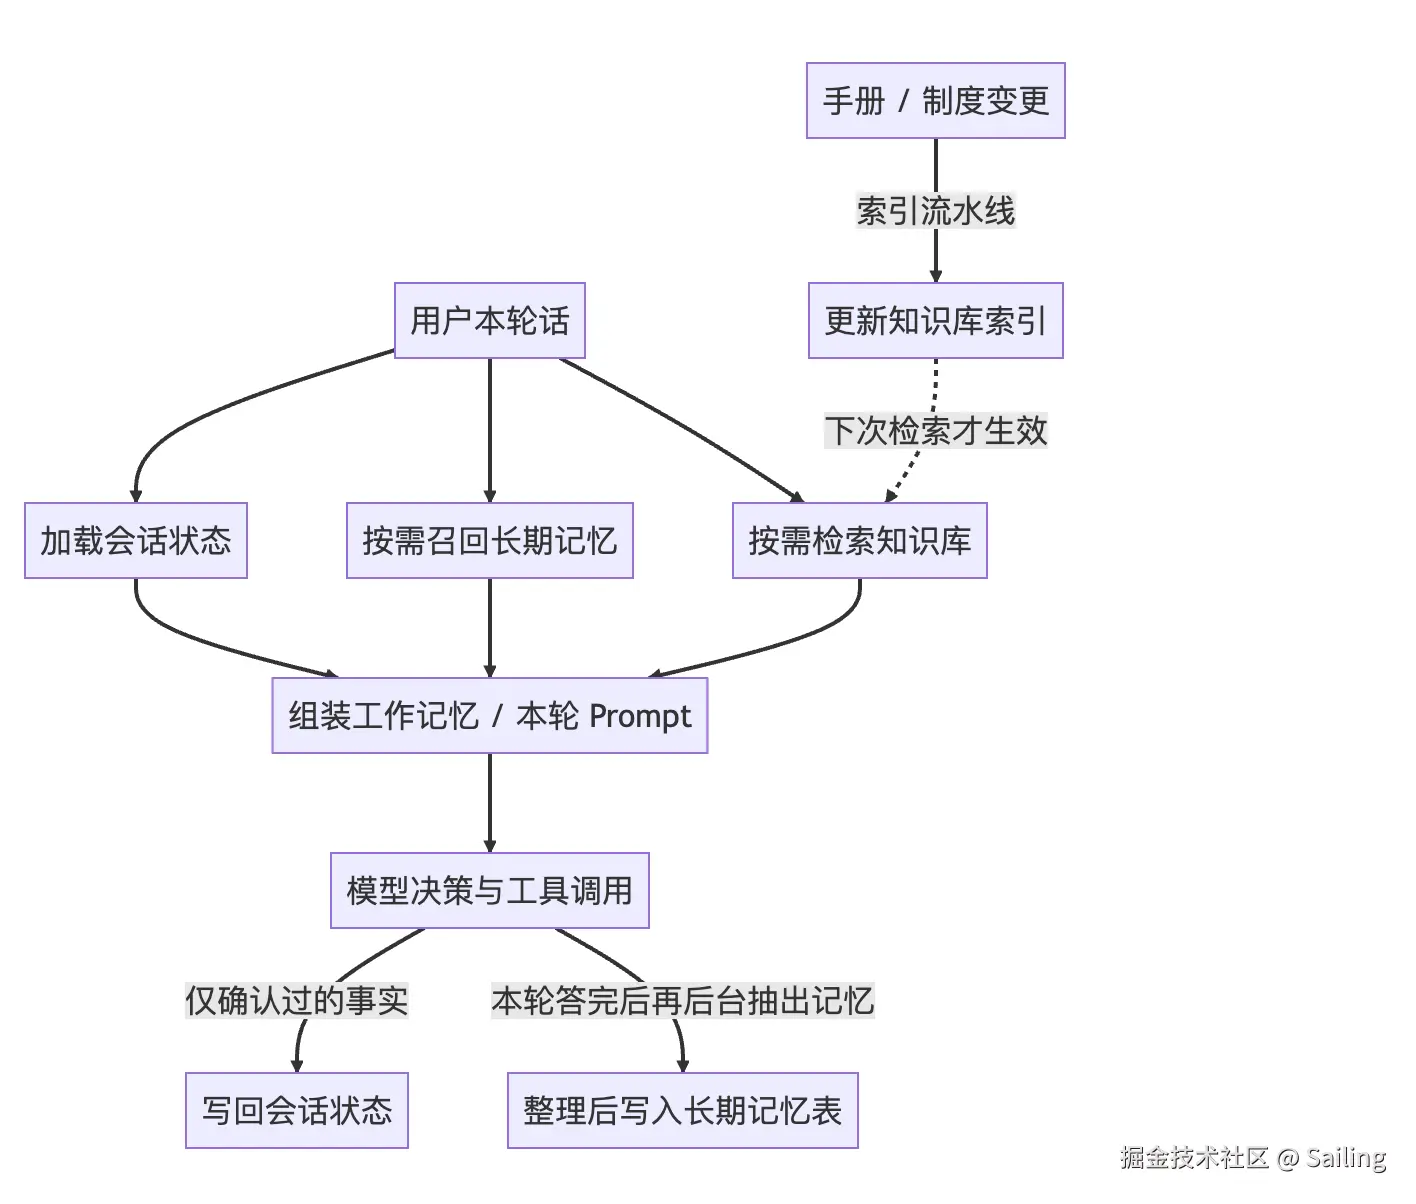
下面几段代码是同一条链路上的函数,不是几套新概念:buildAgentContext 负责读并组装,assemblePrompt 按预算拼 Prompt,writeSessionState / afterTurn 负责写回。
text
加载会话状态(SessionState)+ 按需召回长期记忆(LTM)/ 知识库(RAG)
  → 组装工作记忆(WM)(硬区几乎不裁,软区占剩余预算)
  → 模型决策与工具调用
  → 仅确认事实写回会话状态(SessionState)
  → 异步抽取长期记忆(LTM)(不要为了抽记忆让用户干等回复)
知识库文档变更走索引流水线,不走长期记忆(LTM)
按预算拼 Prompt
拼接工作记忆对应的上下文时,可以先把内容分成两拨:
- 硬区:Token 再紧也尽量留着------系统规则、工具定义、会话状态。系统规则和工具定义尽量别每轮大改,拼 Prompt 时放在最前面(开头稳定时模型侧常能走 Prompt Caching,省token)。如果硬区本身超过模型输入预算,就必须检查、精简或调整配置。
- 软区:用剩下的 Token 配额按相关程度往里塞------最近消息、长期记忆(LTM)、知识库(RAG);不够时,先裁剪低价值内容。
字段对应:
| 工作记忆(WM)字段 | 进哪一拨 |
|---|---|
systemPrompt、toolSchemas(可并进系统侧) |
硬区 |
sessionStateSummary |
硬区 |
recentMessages、recalled、RAG 片段 |
软区 |
tokenBudget |
只管裁剪上限,一般不整段写进 Prompt 正文 |
ts
type ContextAssemblyPlan = { // 组装计划:硬区几乎不裁,软区按分数占剩余预算
  hard: {
    systemRules: string // 系统 Prompt / 工具定义等;尽量稳定,拼在 Prompt 最前
    sessionState: SessionState // 当前会话已确认状态
  }
  soft: {
    recentMessages: Message[] // 最近几轮原文,用来解析「它」
    longTermMemories: Array<{ id: string; content: string }> // 记忆表召回的行
    ragChunks: Array<{ id: string; text: string }> // 知识库片段
    graphFacts: Array<{ id: string; text: string }> // 可选;未上 GraphRAG 可空
  }
  budget: {
    maxTokens: number // 输入 Token 上限
    reserveOutput: number // 预留给模型输出
  }
}

function assemblePrompt(plan: ContextAssemblyPlan): string {
  // 先装硬区,计入已用 Token
  let used = countTokens(plan.hard.systemRules) + countTokens(JSON.stringify(plan.hard.sessionState))
  const parts: string[] = [plan.hard.systemRules, renderState(plan.hard.sessionState)]

  // 最近消息优先塞进剩余预算;否则模型无法解析「它」指什么
  for (const msg of plan.soft.recentMessages.slice().reverse()) {
    const t = countTokens(msg.content)
    if (used + t > plan.budget.maxTokens - plan.budget.reserveOutput) break // 超预算就停
    parts.unshift(renderMessage(msg))
    used += t
  }

  // 记忆与 RAG 按相关分排序、同源去重,再占剩余预算
  const candidates = rankAndDedupe([
    ...plan.soft.longTermMemories.map(asCandidate),
    ...plan.soft.ragChunks.map(asCandidate),
    ...plan.soft.graphFacts.map(asCandidate)
  ])

  for (const item of candidates) {
    if (used + item.tokens > plan.budget.maxTokens - plan.budget.reserveOutput) break
    parts.push(item.text)
    used += item.tokens
  }

  return parts.join('\n\n') // 拼成最终 Prompt 文本
}
经验顺序可以概括为:安全与身份规则 → 当前会话状态 → 相关近期原文 → 重要工具结果和运行笔记 → 相关长期记忆 → RAG / 图谱片段。
这不是对所有任务都适用的绝对排序。例如,某个问题必须依据官方规范回答时,相关规范可能比一般历史摘要更重要。关键是有明确的优先级,并确保重要约束不会被低价值内容挤掉。
下面数字表示:拼进上下文时,每一类内容大约最多占多少 Token。具体数值需要按模型窗口和业务负载调整。
ts
// 使用规则:`maxInput` 是整次输入总上限,下面几项加起来应落在总上限内,并给输出留出 `reserveOutput`。
const budget = {
  maxInput: 24_000,         // 整次输入总上限
  systemAndTools: 4_000,    // 硬区:系统 Prompt + 工具 Schema
  sessionState: 1_000,      // 硬区:会话状态;几乎不裁
  recentMessages: 6_000,    // 软区:最近原文;用来解析「它 / 上次那个」
  memories: 2_000,          // 软区:长期记忆(LTM)召回
  ragOrGraph: 6_000,        // 软区:知识库(RAG)/ 图谱片段
  toolObservations: 4_000,  // 软区:已裁剪的工具结果
  reserveOutput: 1_000      // 预留给模型输出,不算进上面的输入分项
}不够用时分层压缩,不要整段一刀切成摘要:
- 工具结果只留与当前决策相关的行;
- 旧消息保留近期原文和滚动摘要,摘要里要有环境、服务名和关键结论;(可以省很多)
- 检索结果先去重、过滤低相关内容,再按预算加入;
- 重要的权限、环境和用户明确否定过的操作,需要显式保留,不能在摘要中丢失。
压缩并不一定能提高准确率。如果摘要删掉了"用户明确拒绝重启"这类关键信息,模型即使拿到更短的上下文,也可能做出更危险的决策。因此,评估上下文工程时,不能只看 Token 数量,还要看任务成功率、工具调用正确率、延迟和成本。
另外,隔离做错比没有记忆更危险:
tenantId/userId必须在存储层过滤;- 长期记忆(LTM)与知识库(RAG)应有清晰的数据管理边界;
- 召回时标明来源,方便排查"为什么用错偏好"。
完整读写代码
还是用户说"它的错误日志呢"这一轮,读和写可以长这样。以下仍然是接近真实工程的示例代码。
sessionStore、ltm、rag、auth 和 memoryExtractor 都是应用层依赖,需要在具体项目中实现。
ts
// 读:加载状态 → 召回记忆/文档 → 按预算拼 Prompt(接上 assemblePrompt)
async function buildAgentContext(input: {
  userId: string
  tenantId: string
  conversationId: string
  message: string // 用户本轮话,用作召回 query
  recentMessages: Message[] // 最近对话原文
}) {
  const state = await sessionStore.load(input.conversationId) // 读 SessionState

  const memories = await ltm.search({ // LTM:查询必须带 userId / tenantId
    userId: input.userId,
    tenantId: input.tenantId,
    query: input.message,
    limit: 5
  })

  const docs = await rag.retrieve({ // 知识库(RAG):按租户 + 角色过滤,不走长期记忆表
    tenantId: input.tenantId,
    roles: await auth.roles(input.userId),
    query: input.message,
    limit: 4
  })

  return assemblePrompt({
    hard: {
      systemRules: SYSTEM_PROMPT, // 硬区:系统规则
      sessionState: state // 硬区:当前会话状态
    },
    soft: {
      recentMessages: input.recentMessages.slice(-6), // 软区:最近 6 条
      longTermMemories: memories,
      ragChunks: docs,
      graphFacts: [] // 未上 GraphRAG 时留空
    },
    budget: {
      maxTokens: 24_000,
      reserveOutput: 1_500
    }
  })
}

// 写 SessionState:工具成功或用户确认后立刻写;只写已确认字段
async function writeSessionState(conversationId: string, patch: Partial<SessionState>) {
  await sessionStore.patch(conversationId, patch) // 例如 currentService、env
}

// 写长期记忆:回合结束后异步抽取,不挡用户看到回复
async function afterTurn(input: {
  userId: string
  tenantId: string
  messageIds: string[] // 追溯到哪几句原话
  transcriptSlice: string // 本轮对话片段,供抽取用
}) {
  const extracted = await memoryExtractor.extract(input.transcriptSlice) // 抽出候选结论
  await ltm.upsertMany(
    extracted
      .filter(item => item.confidence >= 0.7) // 把握太低的不写
      .map(item => ({
        ...item,
        userId: input.userId, // 写入时带上隔离字段
        tenantId: input.tenantId,
        sourceMessageIds: input.messageIds
      }))
  )
}
上面读完、模型跑完之后,还要把结果存回去,但两类东西的写入时机不同:
- 会话状态(SessionState):当可信事件发生时及时更新。例如用户确认当前服务,或者工具成功返回了服务 ID。对于模型推断的内容,需要保留候选状态或等待确认。
- 长期记忆(LTM):等本轮回答已经开始推给用户之后,再在后台从对话里抽结论写入记忆表,不要为了抽记忆让用户干等回复。
召回时也别搞混:长期记忆 LTM 没命中,可以继续聊;知识库 RAG 没命中,该拒答时就拒答。
开发分几个阶段
第一阶段(多数业务够用):最近 N 轮 + 滚动摘要、结构化会话状态(SessionState)、工具结果裁剪、企业知识走知识库(RAG)。复杂长期记忆(LTM)可以后上。
第二阶段(跨会话个性化):上用户级长期记忆(LTM)的抽取与检索;能更新、能删;Prompt 里分清「用户偏好」和「官方文档」。
第三阶段(复杂关系 / 长任务):真有连查多层关系的时候,再上 GraphRAG;子 Agent 上下文隔离;窗口快满时分层压缩、按预算裁剪;记忆和文档冲突时,官方文档优先于过期偏好。
上线前避开这些坑
- 知识库(RAG)和长期记忆(LTM)不分开管理: 企业文档更新了,用户还抱着旧偏好;或把个人闲聊写进全员知识库。
- 把上下文窗口当仓库: 每轮只往里追加,从不摘要,后面出现截断,费用不断上涨。
- 只靠消息原文维持会话状态: 用户确认了当前是
payment-api服务,却没有更新结构化状态数据;下一轮说"查它的日志",系统仍可能无法可靠解析。 - 长期记忆什么都写: 模型猜错的、访问凭证、整段日志,一起塞进记忆表,这是不对的。
- 把模型输出直接当成已确认事实: 没有来源、确认状态和权限校验,错误信息就可能在后续轮次被不断放大。
- 上来就上 GraphRAG: 业务还没有"谁依赖谁、故障会波及谁"这类问题,先把基础 RAG 跑稳,别为了架构图好看就上图谱。可能根本用不到。
小结
记忆系统要落地,关键就三块:四个盒子别混、只有确认过的才写入、窗口按预算分配。
- 工作记忆(WM)、会话状态(SessionState)、长期记忆(LTM)、知识库(RAG)各管各的。 用户偏好和「上次那个」进 LTM 或会话状态;公司手册、制度走 RAG。
- 只有工具成功或用户明确确认的事实,才写进会话状态(SessionState)/ 长期记忆(LTM)。 LTM 按租户 / 用户隔离,能删、能更正,敏感原文默认不进。
- 上下文窗口有预算,不是无限仓库。 先留系统规则和当前会话状态,再留最近原文,再给 LTM 和 RAG。工具结果先裁剪再送进 Prompt。
希望这篇文章能给正在搭建 Agent 的朋友一些参考。
也想听听大家的实践:你们现在的 Agent 是先做会话状态、长期记忆,还是先把 RAG 跑稳?我在生产环境中遇到过最棘手的是记忆冲突,你们是这个吗?还是上下文超预算,或者任务中断后无法恢复?
欢迎在评论区分享自己的实现方案或踩坑经历,也欢迎直接提问。