100 件库存,1000 个请求同时下单,最后卖出去 1000 单,库存变成 -900。
这不是段子,是我在浏览器里跑出来的真数字。
同一个页面、同一组参数,五种扣减方案各跑一遍:无锁版 8 毫秒就把库存卖成负数,悲观锁版一个不超卖但花了 5368 毫秒。
我把这套对比做成了一个能点开的网页,参数随你改,结果当场出。
一、为什么值得看:超卖不是手速问题,是读和写中间那一小段空隙
先看一段几乎所有人第一次都会写出来的库存扣减。
js
const stock = await db.query("SELECT stock FROM item WHERE id = 1");
if (stock >= qty) {
  await db.query("UPDATE item SET stock = stock - ? WHERE id = 1", [qty]);
  return "下单成功";
}
return "库存不足";
单线程逻辑上它没有毛病:先判断,再扣减。
问题出在两句 SQL 中间的 await 上。
1000 个请求同时进来,第一个请求还没写回去,后面 999 个读到的都是同一个旧值 100。
于是 1000 个请求全部判定「库存够」,全部执行扣减,库存变成 100 - 1000 = -900。
这就是超卖,它跟服务器多快没关系,只跟「读」和「写」之间有没有被别人插队有关系。
二、准备环境:打开码道 Web 就能用
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...
登录之后直接在对话窗口里说需求,不需要装任何软件。
三、任务描述:把这段需求原文丢给码道
下面是我实际发给码道的那段话,一字未改,直接复制就能复现同一个应用。
text
用 HTML 做一个单文件网页应用 index.html,名字叫「秒杀库存超卖实验室」,用来演示高并发下库存扣减为什么会超卖、以及各种加锁方案的效果差异。要求:
1. 顶部配置区:初始库存(默认 100)、并发请求数(默认 1000)、每单扣减数量(默认 1)、模拟数据库延迟毫秒(默认 5,可调)、随机抖动开关。
2. 五种模式并排对比,同一组参数每种各跑一遍,逐个执行:A 无锁直接扣减(读-改-写,中间 await 模拟数据库耗时);B 悲观锁 select for update(请求串行排队持有行锁);C 乐观锁 version 版本号 CAS(冲突后重试);D 带重试上限的乐观锁(重试超过 3 次即失败,观察失败率);E 原子预扣减(单线程内存原子操作,类似 Redis DECR)。
3. 每种模式跑完显示:最终库存、下单成功数、超卖条数(库存为负时超出 0 的数量)、冲突/重试次数、失败次数、总耗时毫秒。
4. 竞态过程区:用列表展示前 20 个请求的序号、读到的库存值、写回的库存值、版本号变化,颜色区分成功、冲突、失败。
5. 对照表:列 模式 / 最终库存 / 成功订单 / 超卖条数 / 重试次数 / 失败次数 / 耗时,超卖那一行高亮标红。
6. 慢放模式:并发数降到 20 时逐条播放,能看清两个请求读到同一个库存值的竞态瞬间。
7. 内置自检:跑完在页面上列出断言结果,至少包含「无锁模式一定出现超卖」「乐观锁与悲观锁最终库存不小于 0」「成功订单数等于初始库存减去最终库存」。
8. 参数校验:库存、并发数、每单数量非法(空、非数字、负数、超过上限)时给中文错误提示并且不启动模拟。
9. 全部逻辑在浏览器里跑,不依赖后端和任何外部库,单文件离线可开(本地打开 file:// 也要能跑),界面中文、深色主题、自适应窗口。
完成后打开预览,让我直接看到运行效果。
四、码道做了什么:五种扣减方案同屏跑
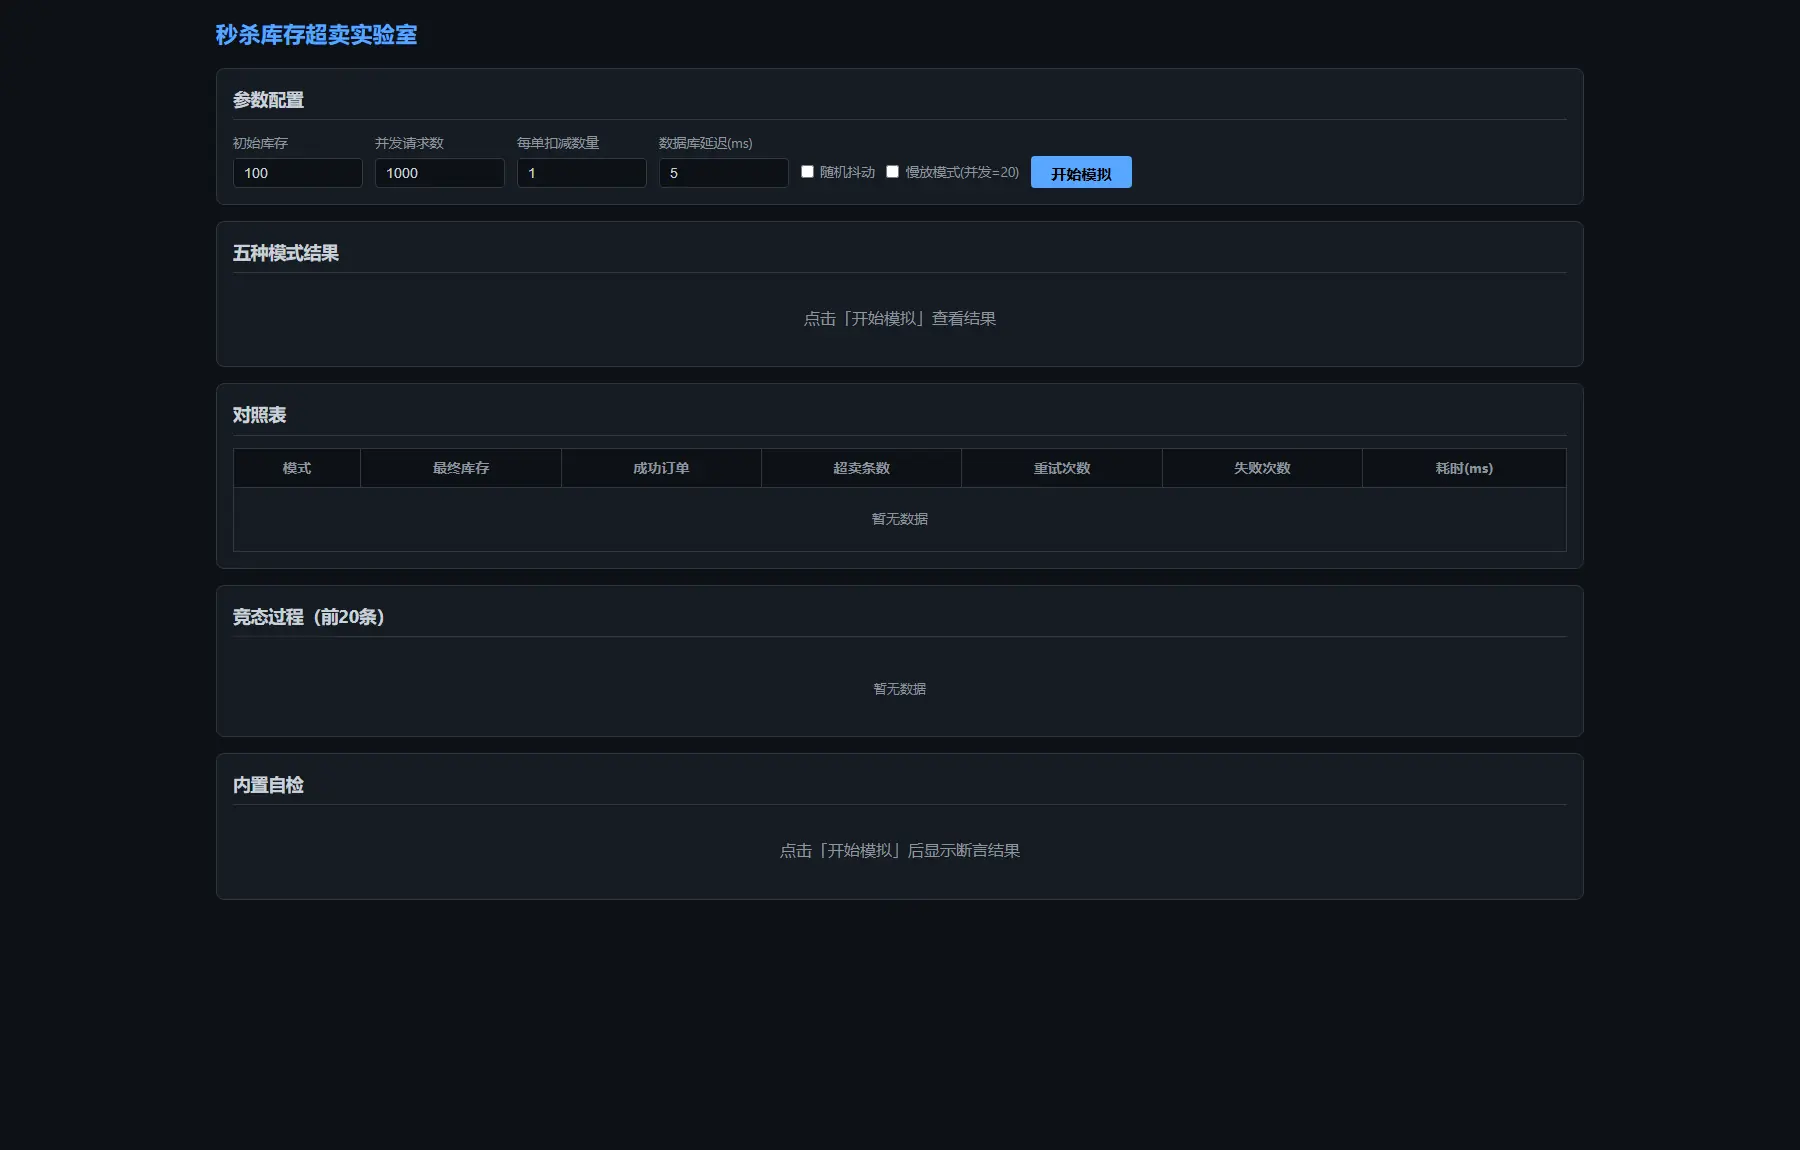
它产出了一个 23 KB 的单文件 index.html,零依赖、零网络请求,离线双击就能跑。
页面顶部是配置区:初始库存、并发请求数、每单扣减数量、数据库延迟、随机抖动开关。
往下是五种方案,同一组参数一种一种跑。
- A 无锁直接扣减:读 → 等一个数据库延迟 → 判断库存 → 写回,中间让出执行权。
- B 悲观锁 :请求串行排队,独占行锁,等价于
select ... for update。 - C 乐观锁 CAS :读的时候带版本号
version,写回前校验版本,冲突就重试。 - D 乐观锁(最多 3 次):同 C,但重试超过 3 次判失败,用来看失败率。
- E 原子预扣减 :判断和扣减之间不留 await,等价于 Redis 的
DECR。
每种跑完都给六个数字:最终库存、下单成功数、超卖条数、冲突/重试次数、失败次数、总耗时。
再往下的竞态过程区,列前 20 条请求的读到值、写回值、版本号和状态。
最后是内置自检,把「无锁一定超卖」「加锁后库存不为负」这类断言逐条打在页面上。
五、实测数据:同样 100 件库存,五种方案差多少
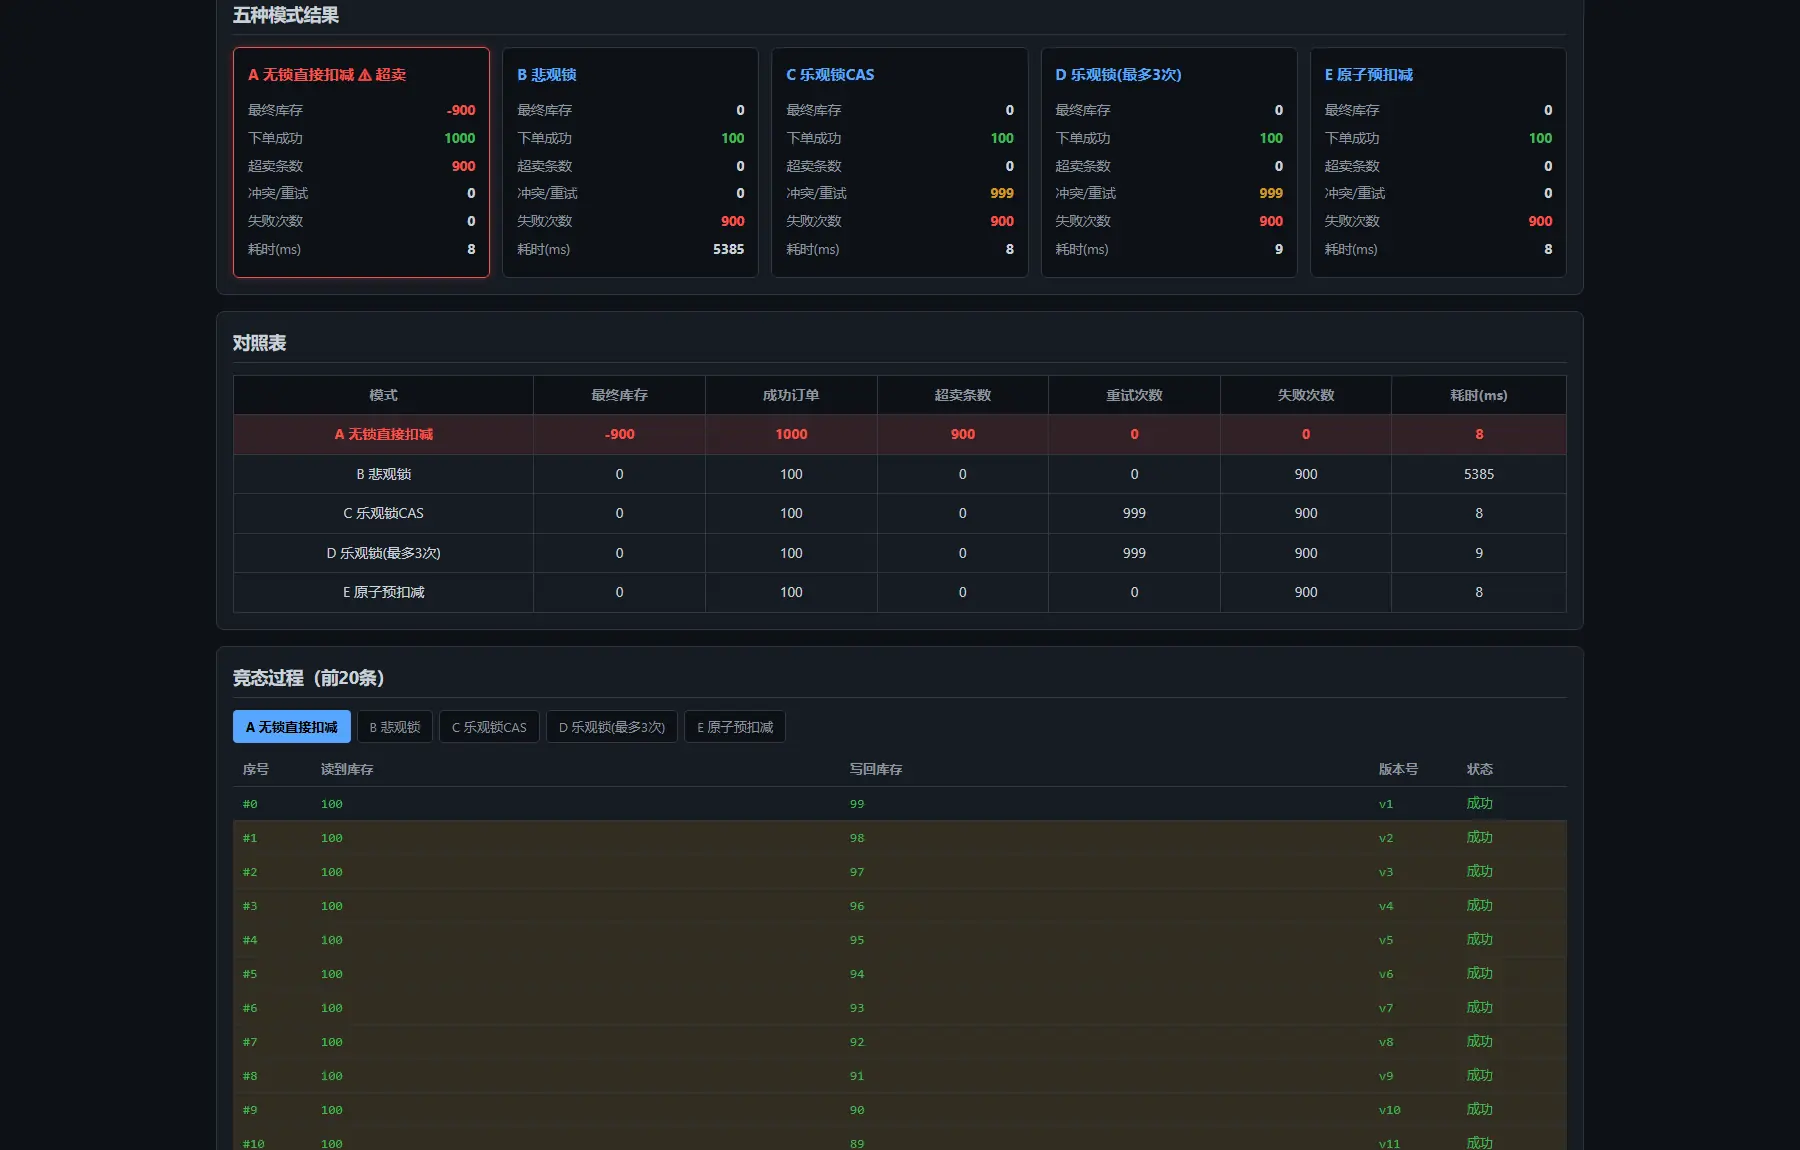
我把默认参数(库存 100、并发 1000、每单 1 件、延迟 5ms)跑了一遍,结果如下。
| 模式 | 最终库存 | 成功订单 | 超卖条数 | 重试次数 | 失败次数 | 耗时(ms) |
|---|---|---|---|---|---|---|
| A 无锁直接扣减 | -900 | 1000 | 900 | 0 | 0 | 8 |
| B 悲观锁 | 0 | 100 | 0 | 0 | 900 | 5368 |
| C 乐观锁 CAS | 0 | 100 | 0 | 999 | 900 | 9 |
| D 乐观锁(最多 3 次) | 0 | 100 | 0 | 999 | 900 | 9 |
| E 原子预扣减 | 0 | 100 | 0 | 0 | 900 | 8 |
几个数字值得盯一下。
A 卖掉 1000 件,库存 -900:超卖条数 900,正好是「请求数减去真实库存」。
B 一个没超卖,但用了 5368 毫秒:串行排队的代价比无锁高 670 倍。
C 重试 999 次,还是把 100 件卖得干干净净:CAS 失败就重试,代价从「超卖」变成了「重试」。
E 重试 0 次,耗时 8 毫秒:把判断和扣减压进同一个同步块,冲突根本不会发生。
顺带说一个容易被忽略的前提:把初始库存改成 1000、并发还是 1000,无锁版也不超卖,最终库存正好 0。
超卖的前提是「库存不够所有人分」,库存管够的时候,无锁代码看起来是正常的。
六、竞态到底发生在哪一行:trace 里「读到库存」全是同一个值
五种方案里,只有 A 的轨迹能一眼看出问题。
前 20 条 trace 的「读到库存」全是 100,而「写回库存」一路往下掉:99、98、97......
我把 trace 切到 C 乐观锁,画面立刻变了:读到值 100、99、98 依次递减,状态列里出现「成功(重试 1)」。
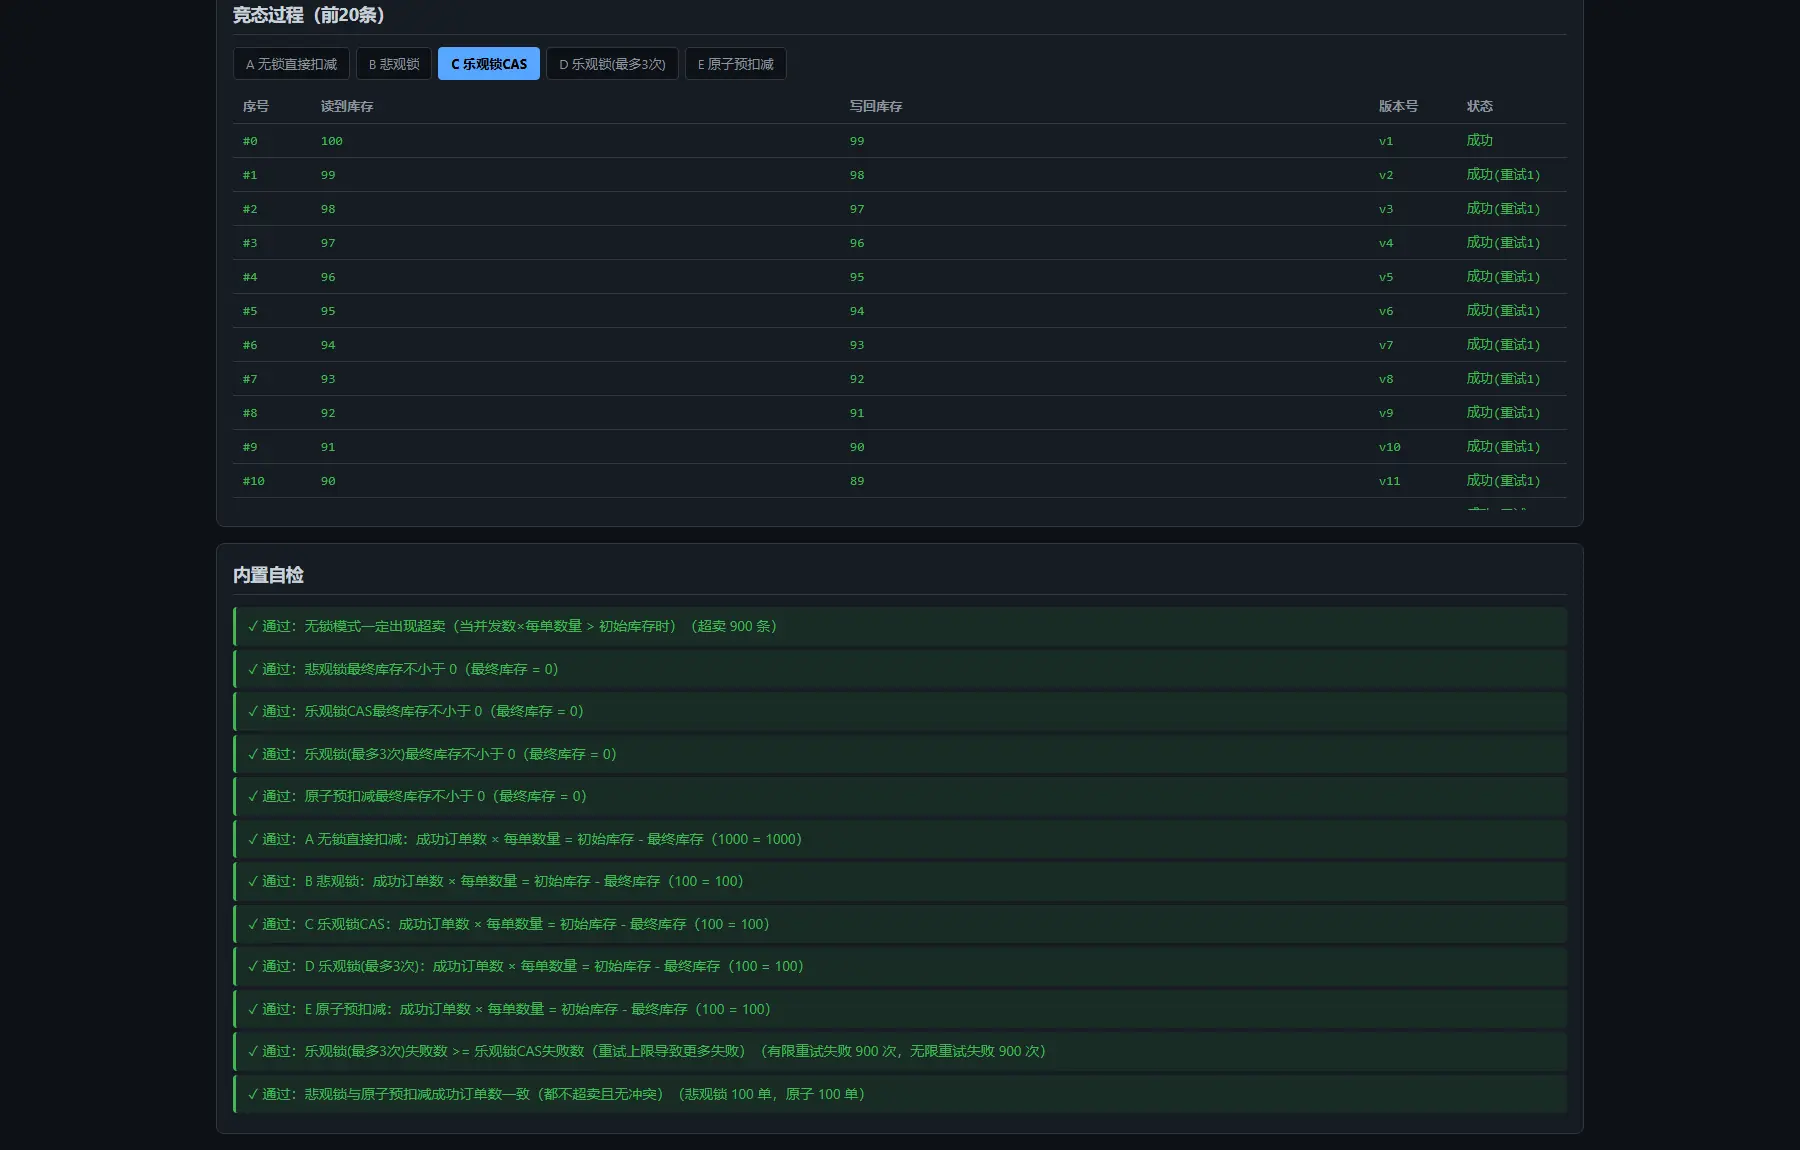
同一个页面、同一份数据,两种轨迹的差别就是「读和写之间有没有被插队」。
慢放模式把并发锁到 20,一条一条播(每条 400ms),能亲眼看到两个请求读到同一个 100。
七、验证与踩坑:12 项断言全绿,还有两条真实边界
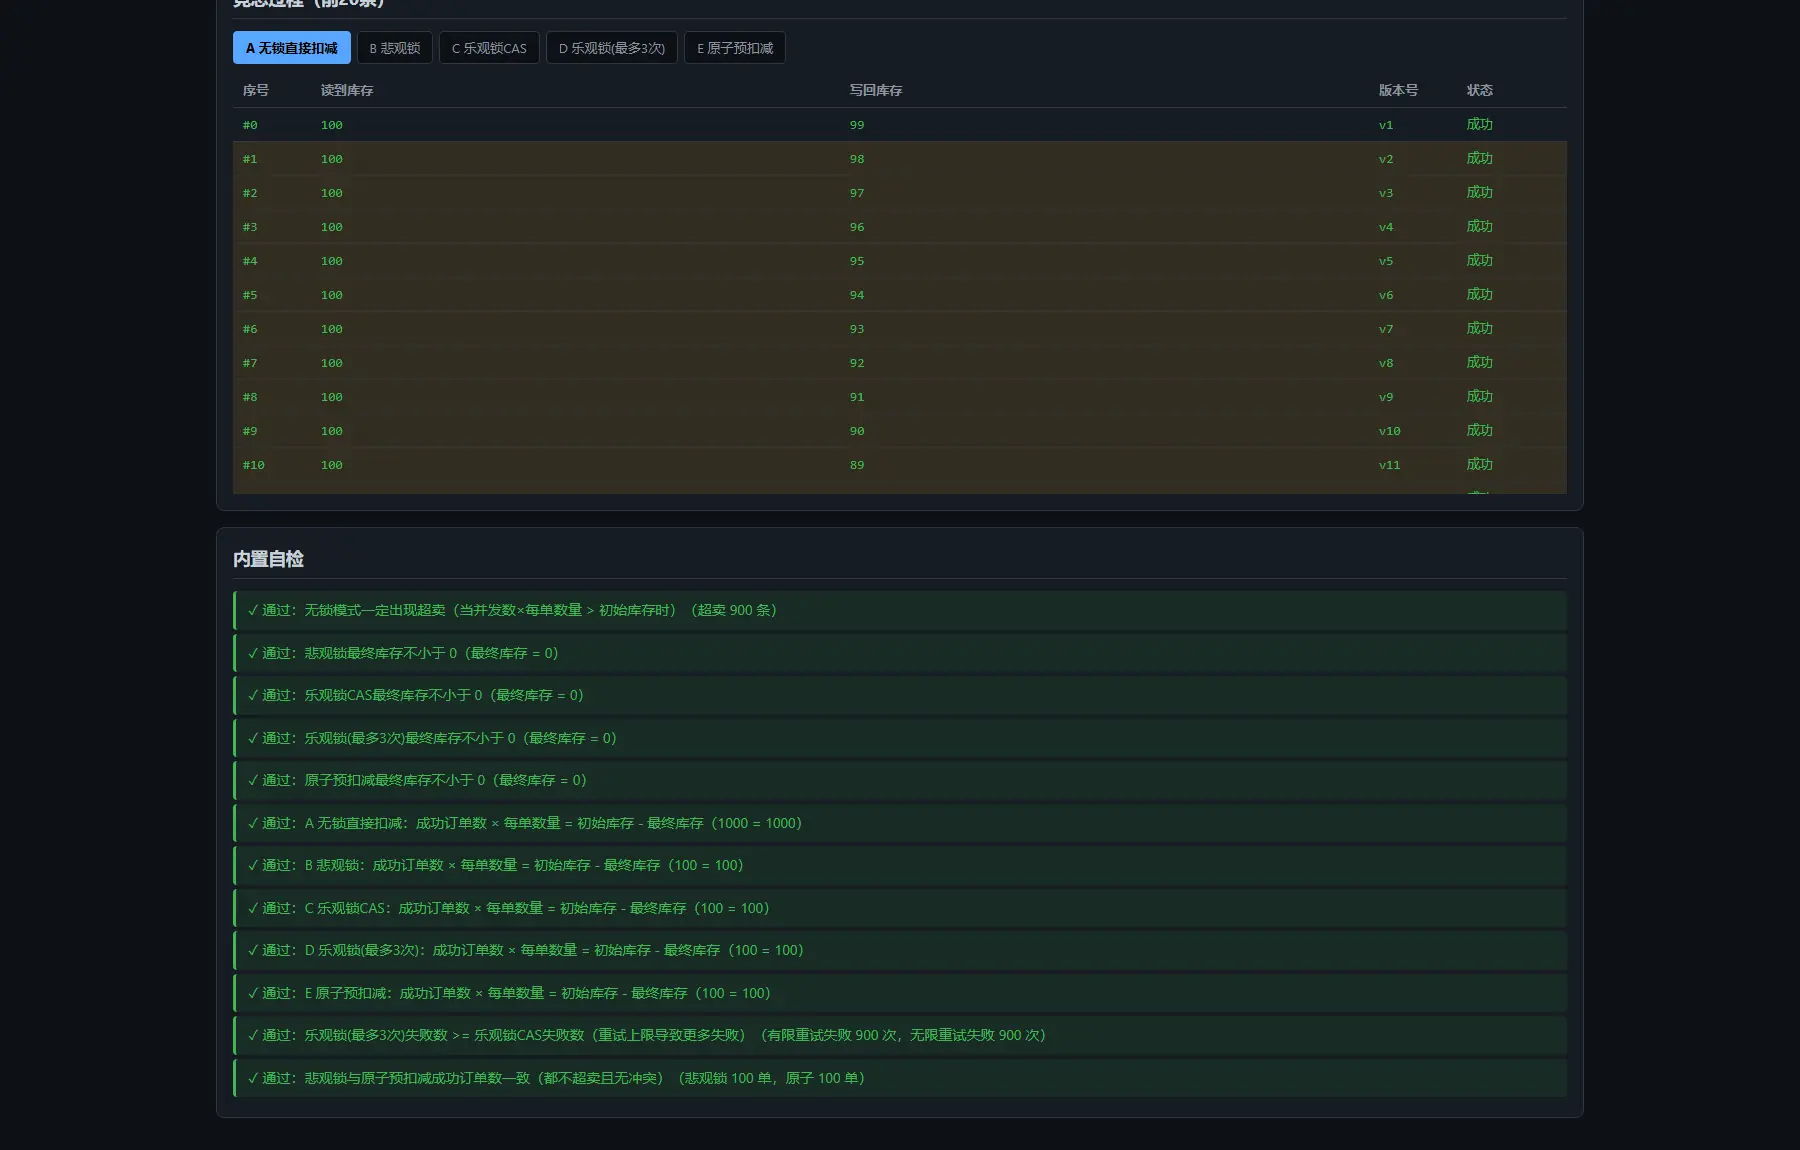
跑完五种方案,页面底部的自检区给出 12 项断言,全部通过。
断言不只有「加锁后库存不为负」这种直白结论,还有两类交叉校验。
一类是守恒:每种方案都验证「成功订单数 × 每单数量 = 初始库存 - 最终库存」,五条全过。
另一类是横向对比:悲观锁与原子预扣减的成功订单数必须一致(都是 100 单),有限重试的失败数必须不少于无限重试。
失败路径我也点了一遍。
把初始库存填成 -1,页面立刻跳出红色提示「初始库存必须大于 0」,模拟不会启动,上一次的结果原样留着。
空着不填会提示「初始库存不能为空且必须为数字」,并发数填 0 会提示「并发请求数必须大于 0」,每单数量填 0 会提示「每单扣减数量必须大于 0」,延迟填 -5 会提示「数据库延迟不能为负数」。
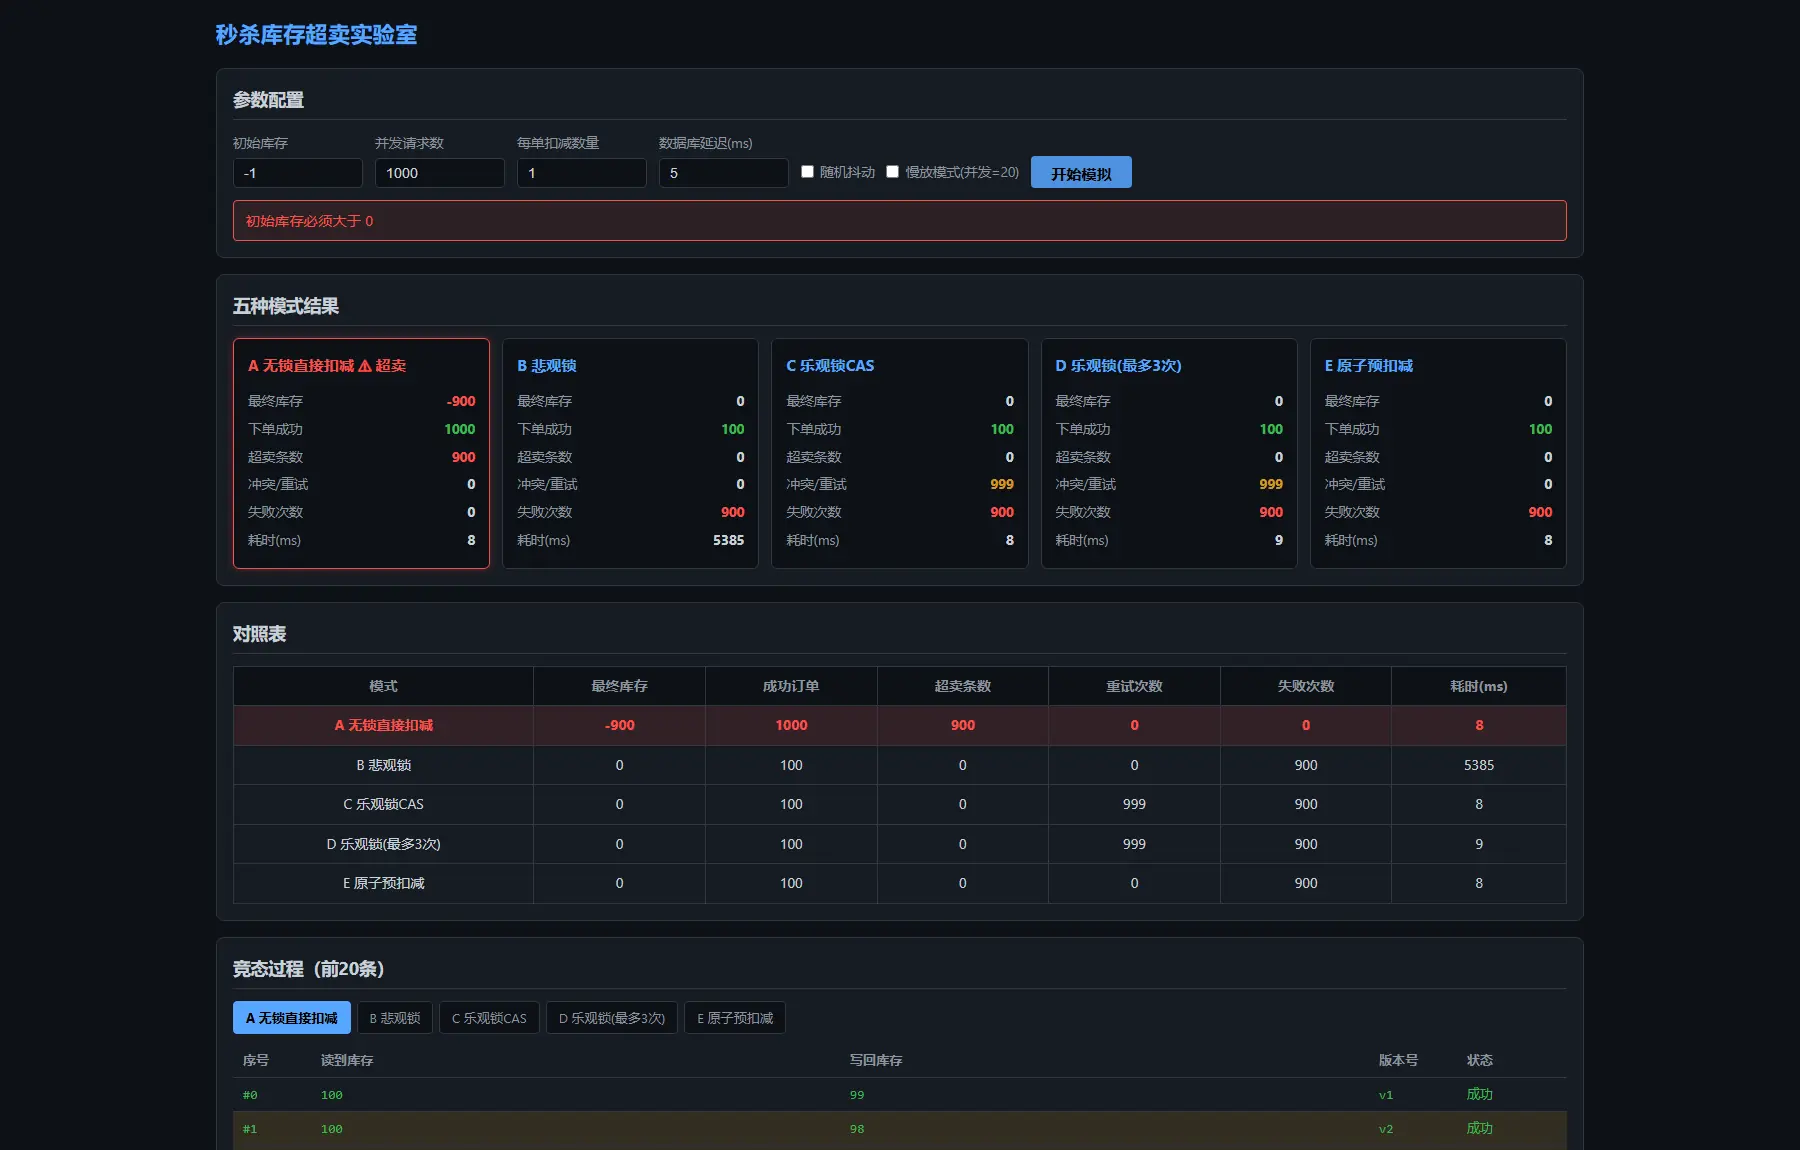
有两条边界我不想藏着。
第一条:D 和 C 的读数完全一样。 两种模式都是重试 999 次、失败 900 次。原因是这次失败全是「库存已经被扣光」,不是「CAS 冲突超过 3 次」。重试上限在这个场景里根本没被触发,自检里那条「有限重试失败数 >= 无限重试失败数」也因此是恒真的。想看 D 和 C 分道扬镳,得把库存调到管够、让冲突成为主要矛盾。
第二条:这是时序模拟,不是性能基准。 页面里没有真数据库、没有真 Redis,并发是用 await 让出执行权模拟出来的。它演示的是「谁先读到值」的顺序问题,耗时数字只能横向比较,不能当成 MySQL 或 Redis 的真实性能。
八、本地复现
index.html 是单文件,下载下来双击就能跑;想让它在局域网里被别人打开,起一个静态服务器就行。
bash
python -m http.server 8080
# 然后浏览器打开 http://localhost:8080/index.html
文件是 file:// 直接打开也能跑的那种,不依赖任何后端。
我自己的验收动作是三条:点「开始模拟」读对照表、把 trace 切到 C 看重试、故意填一个负数看提示原文。
九、使用码道体会
- 需求里的验收方式要写死在提示词里。我加了「完成后打开预览,让我直接看到运行效果」,省掉了来回问「做好了没」。
- 把要对比的方案列成编号清单,比一句「做个超卖演示」效果好得多,五张结果卡片就是按编号长出来的。
- 让自检页面自己说话。我要求「内置自检」,跑完 12 项断言直接打在页面上,比我在评论区里解释可信。
- 边界条件要提前点名 。我在需求里写了「空、非数字、负数、超过上限」,页面就给出了五条中文提示;不写,多半只会给你一条
alert。 - 单文件交付最省事 。零依赖、零构建,
file://能跑,分享给别人也不用配环境。 - 别把模拟当结论。页面能告诉你无锁会超卖,但真实系统的耗时、锁粒度、死锁风险,还得在真数据库上压一遍。
直接下载试玩
这个 Demo 已经完整开源(源代码、本文档、全部截图),托管在公开仓库,可直接下载来玩:
- Demo Park 仓库:atomgit.com/deli007/dem...
- 本案例目录:atomgit.com/deli007/dem...
打开上面的链接,进入 codearts-flash-sale-oversell-lab 文件夹,把 index.html 下载到本地,用浏览器打开即可运行,无需安装任何依赖。
十、总结
超卖这件事,代码写得再短也躲不开:只要「读库存」和「写库存」之间隔着一次 IO,就一定有人插队。
五种方案里,无锁版把 100 件卖成 -900(8 毫秒),悲观锁一件不超卖但慢到 5368 毫秒,乐观锁用 999 次重试换来干净结果,原子预扣减两条都不占。
把这五种摆在同一个页面上跑一遍,比看十篇「分布式锁原理」记得牢。
参数在页面上,陷阱也在页面上:你可以把库存调到管够,看无锁版怎么「假装正常」。