法克,有时候我在编程的时候会迷糊这几个概念,那就一文梳理清楚。
先建立认识:worker 是处理工作的角色;协程描述一次可以暂停、恢复的执行流程;Task 把这次执行纳入 asyncio 的调度和管理。
在常见的队列处理模式中,用协程实现 worker,再创建 Task 来运行它。一个 worker Task 可以在循环中依次处理很多个业务工作项。
下面用一个场景贯穿全文:
先分清"要做的工作"和"处理工作的人"
假设有 A、B、C、D、E 五份报告需要下载,我们安排两个 worker。每个 worker 下载完一份报告,再去领取下一份。暂时没有报告时,处理者留下来等待新工作。
在这个场景中,有两类东西:
- 报告 A、报告 B 等 :等待处理的业务数据,我们称为"工作项",代码中可以命名为
job或report。 - 两个持续下载报告的处理者 :我们称为
worker。
为了避免混淆,后面使用下面这组叫法:
| 名称 | 在本文中的含义 |
|---|---|
工作项 report |
一份等待下载的报告 |
worker |
持续领取并处理报告的角色 |
| 协程函数 | 用 async def 定义的执行流程 |
| 协程对象 | 调用协程函数后得到的对象,代表一次具体执行 |
asyncio.Task |
调度和管理这次协程执行的对象 |
其中,"协程函数""协程对象""Task"是需要区分的 Python 概念。下面一步一步把它们接起来。
协程函数定义流程,协程对象代表一次执行
先只考虑下载一份报告:
python
async def download_report(report):
    print(f"开始下载报告 {report}")

    await asyncio.sleep(0.1)  # 模拟等待网络响应

print(f"完成下载报告 {report}")这里,download_report 是一个协程函数。
函数体规定了下载的步骤:
- 打印开始信息。
- 等待一次模拟的网络操作。
- 打印完成信息。
定义这个函数时,下载流程还没有执行。
现在调用它:
python
coro = download_report("A")这次调用得到的是一个协程对象 ,赋给了变量 coro。
仅仅执行这句,还不会打印"开始下载报告 A"。 调用协程函数会创建协程对象,之后需要等待或调度这个对象,才能推进它的执行。
如果在一个正在运行的 async 函数里写:
python
await coro执行流程就会进入这个协程,并等待它完成。因此,下面两件事要分开理解:
python
coro = download_report("A")  # 创建一次执行对应的协程对象
await coro                  # 进入这次执行,并等待完成
协程对象保存着这次执行的状态。执行到需要等待的地方时,它可以暂停;等待条件满足后,再从暂停的位置继续。
后面的零散代码片段,默认写在正在运行的 async 函数中。完整的可运行程序放在后文。
Task 让协程拥有独立的调度和管理入口
如果希望某段协程与其他工作并发推进,可以为它创建一个 Task:
python
coro = download_report("A")
task = asyncio.create_task(coro)
这两行分别做了不同的事情:
- 第一行创建协程对象。
- 第二行创建一个 Task,安排这个协程执行,并返回 Task 对象。
coro 和 task 仍然是两个不同的对象:
| 对象 | 主要作用 |
|---|---|
coro |
承载这次下载的执行流程和执行状态 |
task |
把这次执行纳入 asyncio 的调度,并提供状态、结果、异常和取消等管理能力 |
create_task() 的正式语义就是:包装协程、安排执行,并返回 Task 对象。
例如:
python
task = asyncio.create_task(download_report("A"))
finished = task.done()  # 查询此刻是否已经结束,不会等待
await task             # 等待执行结束;失败时会传播异常
这里还要分清两个动作: create_task() 负责安排执行;await task 负责等待结果。
Task 不需要等你写到 await task,才有资格开始运行。因此,下面的代码可以让两个下载并发推进:
python
task1 = asyncio.create_task(download_report("A"))
task2 = asyncio.create_task(download_report("B"))

await task1
await task2
虽然最后依次写了两个 await,但前面已经创建了两个 Task,并安排它们执行。等待结果的顺序,并不会把它们变成"先完成 A,才启动 B"。相对地,下面这段代码会先完成 A,再开始 B:
python
await download_report("A")
await download_report("B")
这两段代码的差别,在于是否提前创建了两个能够独立被调度的 Task。
worker 是我们赋予一段代码的工作角色
现在,我们已经有了"下载一份报告"的协程函数。
接下来,希望一个处理者下载完一份报告后,继续领取下一份。于是写出这个循环:
python
async def worker(queue):
    while True:
        report = await queue.get()
        await download_report(report)
        queue.task_done()
这段精简代码表达了一个持续工作的流程:
- 从队列领取一份报告。
- 等待这份报告下载结束。
- 告诉队列:这一工作项已经处理完。
- 回到循环开头,继续领取下一份。
我们把这种持续领取、处理工作的角色叫作 worker。
函数名也可以改成:
python
async def report_consumer(queue):
    ...
改名不会改变 Python 的执行规则。worker 这个名字是在向读代码的人说明:这段代码承担处理工作的角色。
一个 worker 函数,可以启动多个 worker 实例
假设我们需要两个 worker:
python
task1 = asyncio.create_task(
    worker(queue),
    name="worker-1",
)

task2 = asyncio.create_task(
    worker(queue),
    name="worker-2",
)
这段代码调用了两次 worker(queue),因此创建了两个不同的协程对象;随后又为它们分别创建了 Task。
两个 worker 共享同一个队列,但各自保存自己的局部变量和执行位置。
例如,一个正在处理报告 A,另一个正在处理报告 B。
每个 Task 管理的是整个 worker 协程的执行,包括 while True 的多次循环。
所以,下载完报告 A,只表示这个 worker 完成了一轮工作。它的 Task 可以继续存在,再去处理报告 C、报告 E。
worker 调用其他协程时,会不会又产生一个 Task
看 worker 内部这句:
python
await download_report(report)执行它时,确实会调用 download_report(),创建一个新的协程对象。
但是:直接 await 子协程,本身不会为它创建一个新的独立 Task。
执行流程会进入 download_report(),等它结束后,再回到 worker 的下一行。这个过程仍然属于当前 worker Task 的执行。
例如,worker-1 可以经历下面这些阶段:
| 执行阶段 | 当前执行的协程逻辑 | 所属 Task |
|---|---|---|
| 领取报告 A | worker() |
worker-1 |
| 下载报告 A | download_report("A") |
worker-1 |
| 登记完成并领取下一份 | 回到 worker() |
worker-1 |
| 下载报告 C | download_report("C") |
worker-1 |
子协程对象可以不断产生和结束,管理这个 worker 的 Task 仍然是原来的那个。关系如下图所示:
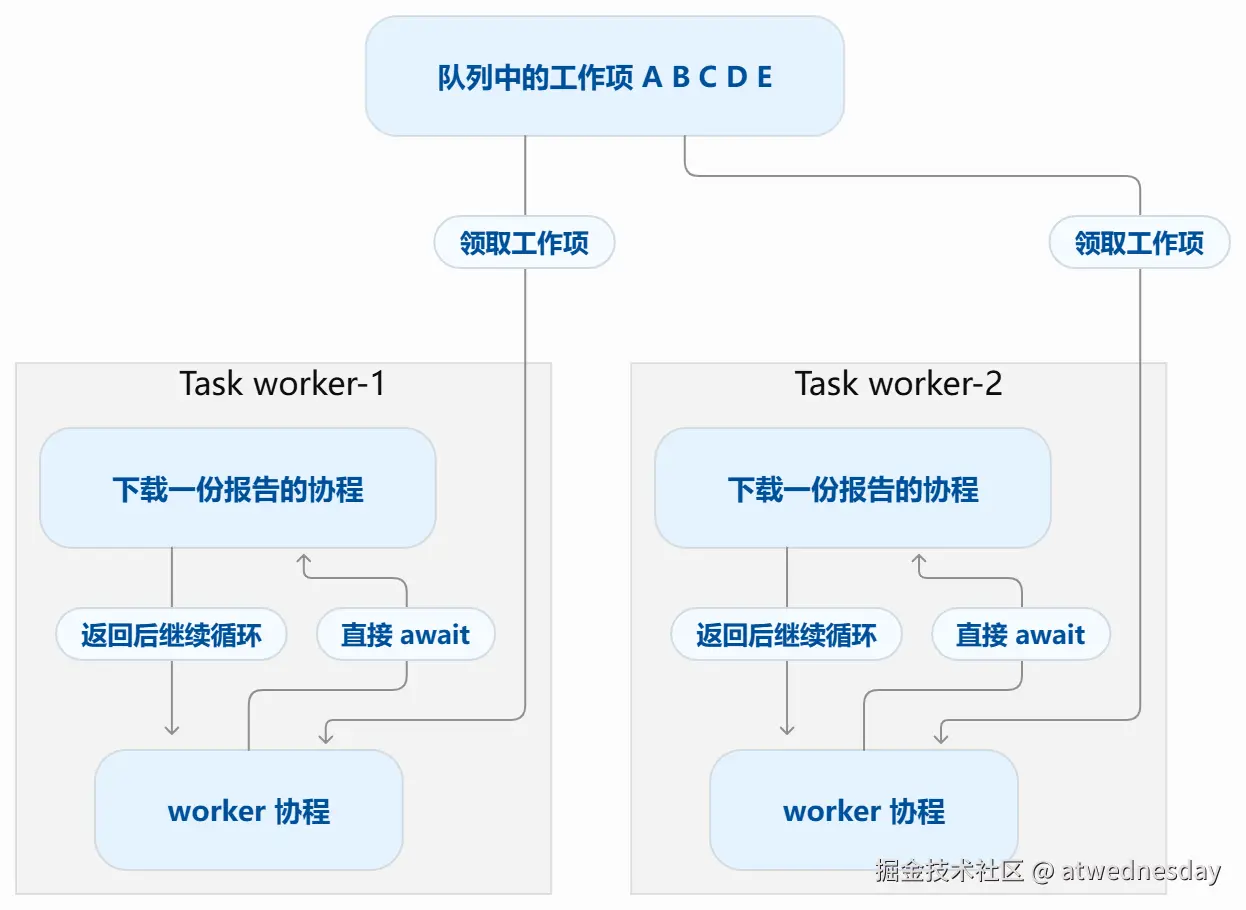
两个框分别代表两个 Task。每个框内,可以沿着 await 调用链进入不同的协程。
如果你写成:
python
task = asyncio.create_task(download_report(report))才会显式创建一个新的 Task。
因此,阅读代码时,需要分别看清:
- 是否调用了协程函数。
- 是否直接
await这个协程。 - 是否通过
create_task()等接口为它创建了独立 Task。
这三个动作不能混为一谈。
把两个 worker 和五份报告放进完整程序
python
import asyncio


async def download_report(report):
    name = asyncio.current_task().get_name()

    print(f"{name} 开始下载报告 {report}")
    await asyncio.sleep(0.1)  # 模拟等待网络响应
    print(f"{name} 完成下载报告 {report}")


async def worker(queue):
    while True:
        report = await queue.get()

        try:
            await download_report(report)
        except Exception as exc:
            print(f"下载报告 {report} 失败:{exc}")
        finally:
            queue.task_done()


async def main():
    queue = asyncio.Queue()

    for report in "ABCDE":
        queue.put_nowait(report)

    worker_tasks = [
        asyncio.create_task(worker(queue), name=f"worker-{i}")
        for i in (1, 2)
    ]

    try:
        await queue.join()

        print("队列剩余工作项:", queue.qsize())
        print("worker 是否结束:", [
            task.done() for task in worker_tasks
        ])
    finally:
        for task in worker_tasks:
            task.cancel()

        await asyncio.gather(
            *worker_tasks,
            return_exceptions=True,
        )

    print("worker 是否已取消:", [
        task.cancelled() for task in worker_tasks
    ])


if __name__ == "__main__":
asyncio.run(main())这里选择的失败策略是:一份报告发生普通异常时,打印错误,然后继续处理其他报告。 示例没有实现重试。
队列里放的是五个工作项
python
for report in "ABCDE":
    queue.put_nowait(report)
这段代码放入了五个字符串。
这些字符串代表五份报告,属于业务数据。入队操作没有为每份报告创建一个 Task。
创建了两个负责消费队列的 Task
python
worker_tasks = [
    asyncio.create_task(worker(queue), name=f"worker-{i}")
    for i in (1, 2)
]
这里创建了:
- 两个 worker 协程对象。
- 两个负责运行它们的 Task。
worker_tasks保存这两个 Task,方便后面查询状态和关闭。
两个 worker 分别领取报告
某个 worker 运行到:report = await queue.get() 就会从队列领取一份报告。然后执行:await download_report(report)。等到这一份报告处理结束,再领取下一份。
这次实际运行中,工作分配如下:
| 领取阶段 | worker-1 | worker-2 |
|---|---|---|
| 首先领取 | A | B |
| 完成后继续领取 | C | D |
| 下一次领取 | E | 等待新工作 |
具体分配和日志交错次序可能随耗时、调度方式而变化,不应当作业务保证。但有一点很清楚:两个 worker Task 就处理完了五份报告。
子协程中的当前 Task 仍然是 worker Task
下载函数中有这行:name = asyncio.current_task().get_name()。它读取当前正在执行这段代码的 Task 名称。因此,会看到:
css
worker-1 开始下载报告 A
worker-1 开始下载报告 C
worker-1 开始下载报告 E
这些日志来自不同次 download_report() 调用,却仍然由同一个 worker-1 Task 执行。
工作项处理完后,worker 还没有退出
程序会打印:
python
队列剩余工作项: 0
worker 是否结束: [False, False]这组输出非常重要。证明:报告已经处理完了,两个 worker Task 却还活着。
原因是它们使用了 while True。处理完现有报告后,又回到:report = await queue.get()。队列暂时没有新报告,于是 worker 在这里等待。
队列为空、工作项处理完、worker 退出,是三个状态
这三个状态经常被混在一起,但它们回答的问题不同。
| 判断或等待方式 | 它关心的事情 |
|---|---|
queue.empty() |
队列里是否还有尚未领取的工作项 |
await queue.join() |
入队工作项的未完成计数是否已经归零 |
worker_task.done() |
整个 worker Task 是否已经结束 |
Queue 的记账方式是:入队时增加未完成计数,调用 task_done() 时减少计数;join() 等待这个计数归零。get() 领取数据,并不会自动把它登记为处理完成。
只跟踪一份报告,就容易看清楚:
| 操作 | 尚未领取的数量 | 尚未登记完成的数量 |
|---|---|---|
| 把报告 A 放入空队列 | 1 | 1 |
| worker 领取报告 A | 0 | 1 |
worker 调用 task_done() |
0 | 0 |
所以,"队列空了"只说明报告都被领取了。报告可能仍然在 worker 手里下载,因此 join() 还需要等待。
task_done() 的名字,也容易让人误会
queue.task_done() 这句话的含义是:向队列登记:刚才领取的这个工作项,本轮处理已经结束。 它不会让当前 worker Task 退出。
而且,队列并不知道文件到底有没有下载成功。示例把它写在 finally 中,所以成功处理和已记录的失败,都会结清这一项的队列计数。
因此,join() 返回不能单独证明"所有下载都成功"。成功、失败和重试,需要业务代码另外记录。
为什么最后还要取消 worker
现有报告全部处理完以后,主流程不再需要等待新报告,于是执行:
python
for task in worker_tasks:
    task.cancel()
然后:
python
await asyncio.gather(
    *worker_tasks,
    return_exceptions=True,
)前一步请求取消;后一步等待它们真正结束。cancel() 是取消请求,协程会在合适的位置收到取消异常,并有机会执行清理逻辑。
这段程序最后会打印:
python
worker 是否已取消: [True, True]整个结束过程也就分清楚了:
- 等待这批工作项处理结束。
- 通知仍然等待新工作的 worker 停止。
- 等待 worker 完成退出。
一个线程为什么能推进多个 worker
在这个例子中,两个 worker 运行在同一个事件循环线程中。
当 worker-1 需要等待网络响应时,它可以暂停,让事件循环推进 worker-2。等到等待条件满足后,再继续执行原来的 worker。
因此,两个下载的等待时间可以重叠。单个事件循环线程仍然一次执行一个 Task 的代码。
这里还要修正一个常见的简化说法:
看到 await,不代表一定立即切换到其他 Task。
例如:report = await queue.get() 如果队列里已经有报告,就可能立即取到。又比如,一个子协程内部没有真正需要等待的操作:
csharp
async def get_number():
return 42直接等待它:number = await get_number()
可能直接完成,不需要把执行权交回事件循环。
更准确的理解是:
await允许当前执行流程等待结果。当等待过程确实需要挂起时,事件循环才有机会推进其他工作。
总结
worker(queue):调用协程函数,得到一个 worker 协程对象。asyncio.create_task(...):创建 Task,安排并管理这个协程的执行。task:保存返回的 Task 对象,以便等待、查看状态或请求取消。
至于这个 worker 实际处理什么,要继续看它的循环:
python
report = await queue.get()
await download_report(report)
queue.task_done()