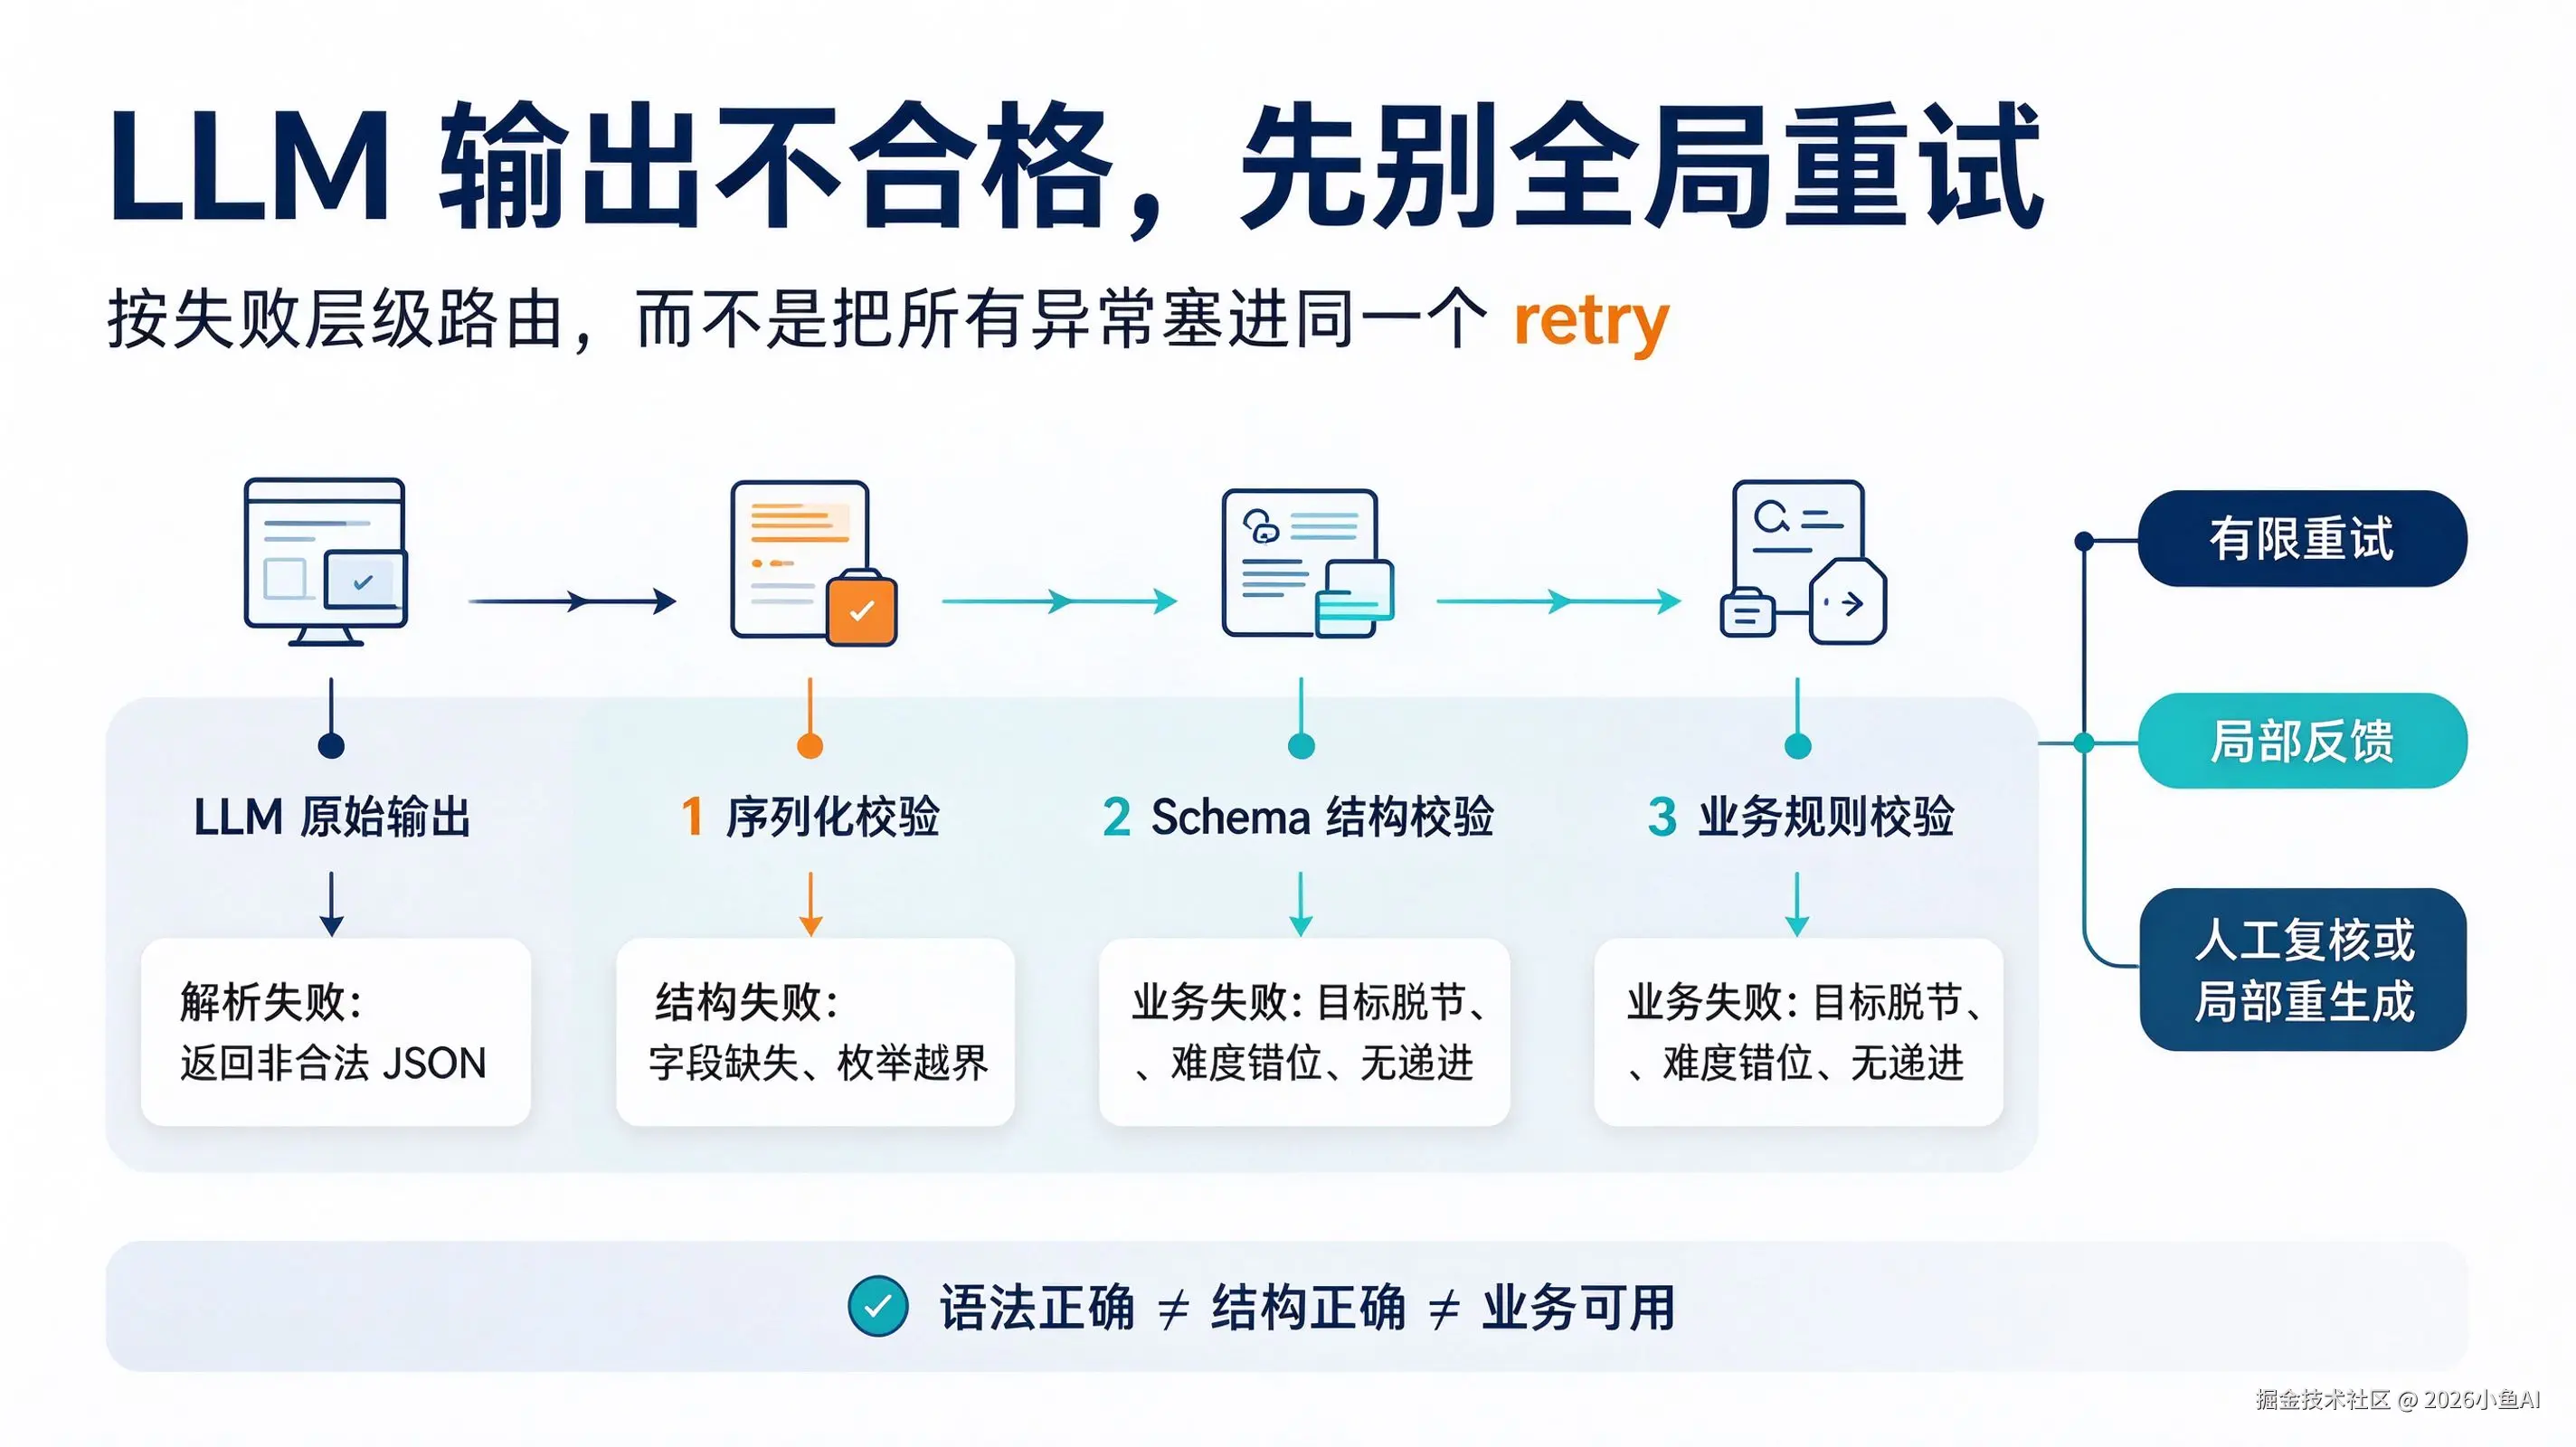
 你有没有遇到过这种诡异问题: 大模型返回的内容通顺流畅,JSON 结构完全合法,没有报错、没有截断,但是放到业务里根本没法用。
在我们 AI 备课的场景里,它可能是:教学目标写了,但后面所有课堂环节都和目标无关;题型、学段匹配错了;课堂活动堆砌在一起,没有循序渐进的逻辑。 提示词反复打磨、增加各种约束,下次依然可能踩同样的坑。
站在教研视角,这是教案不好用的体验问题;但落到工程链路,本质是:LLM 的输出,是一份不可靠的外部数据返回,而不是天然可信的业务结果。
这篇不聊提示词技巧、不教你怎么写更好的 prompt。 我们聚焦生产落地的硬核边界:模型输出格式没问题,但业务不合格时,系统该怎么自动识别?重试的安全边界在哪里?小参数模型并发拉高后,为什么会出现质量漂移?以及哪些业务偏差,再怎么写代码也无法自动化判定,只能交给人工复核。
一、先建立共识:LLM 成功返回 ≠ 业务可用
传统后端接口逻辑很清晰:成功就是 200,失败就是 4xx/5xx。 LLM 完全是另一套逻辑:哪怕调用链路一切正常,它也会产出"格式合规、语义通顺,但业务无效"的内容。
这里要把失败分成三层,这个分类是整套纠偏方案的根基:
| 失败类型 | 典型表现 | 能否自动检测 | 能否自动修复 |
|---|---|---|---|
| 序列化失败 | 返回乱文本、无法解析成合法 JSON | ✅ | 有限次数定向重试 |
| 结构失败 | 字段缺失、枚举值越界、必填内容为空 | ✅ | 有限次数定向重试 |
| 业务失败 | 目标环节脱节、难度不匹配、逻辑缺少递进 | 部分可检测 | 大多只能局部重生成,或转入人工审核 |
很多新手踩坑的根源,就是把这三类错误混在一起,写一个全局异常捕获,失败就无脑重试。 不仅会拉高 Token 成本、放大链路延迟,甚至会重复生成有问题的内容,把脏数据流入下游。
核心原则:不同层级的失败,走完全不一样的恢复路径。
二、分层校验与降级:用 Pydantic 契约守住结构底线
我们搭建四层防护链路:请求前置约束 → JSON 语法解析 → Schema 结构校验 → 业务规则判定。 语法、结构层面的错误,可以定向反馈给模型修复;校验通过之后,再进入业务规则判断。
下面这份最小可运行代码,会显式返回失败层级,而不是简单抛出异常吞掉错误:
python
from pydantic import BaseModel, Field, ValidationError
from typing import Literal
import json

class TeachingSegment(BaseModel):
    phase: Literal["导入", "新授", "练习", "小结"]
    teacher_action: str = Field(min_length=1, max_length=500)
    student_activity: str = Field(min_length=1, max_length=500)
    # 标记依赖的前置环节,用来做业务层的逻辑依赖校验
    depends_on: list[str] = Field(default_factory=list)

class LessonPlan(BaseModel):
    grade: str
    subject: str
    objectives: list[str] = Field(min_length=1)
    segments: list[TeachingSegment] = Field(min_length=1)

def validate_llm_output(raw: str) -> tuple[str, LessonPlan | None, str | None]:
    """
    返回失败层级:parse / schema / ok
    """
    try:
        data = json.loads(raw)
    except json.JSONDecodeError as e:
        return "parse", None, f"JSON解析失败: {e}"

    try:
        plan = LessonPlan.model_validate(data)
    except ValidationError as e:
        return "schema", None, str(e)

    return "ok", plan, None
落地要点
parse解析失败:把报错信息原样回传给模型,让它针对性修复格式;schema结构失败:把校验失败的字段路径、约束信息一并回传,定点修复;- 两层校验全部通过,但业务规则不达标(比如教学目标没有任何环节承接):禁止重跑完整教案,只触发局部段落重生成。
一个非常容易忽略的坑:就算调用模型时传入了 response_format 结构化参数,中转代理、第三方模型网关都有可能静默忽略这个参数。 本地校验是最后的底线,绝对不能依赖模型侧的承诺。
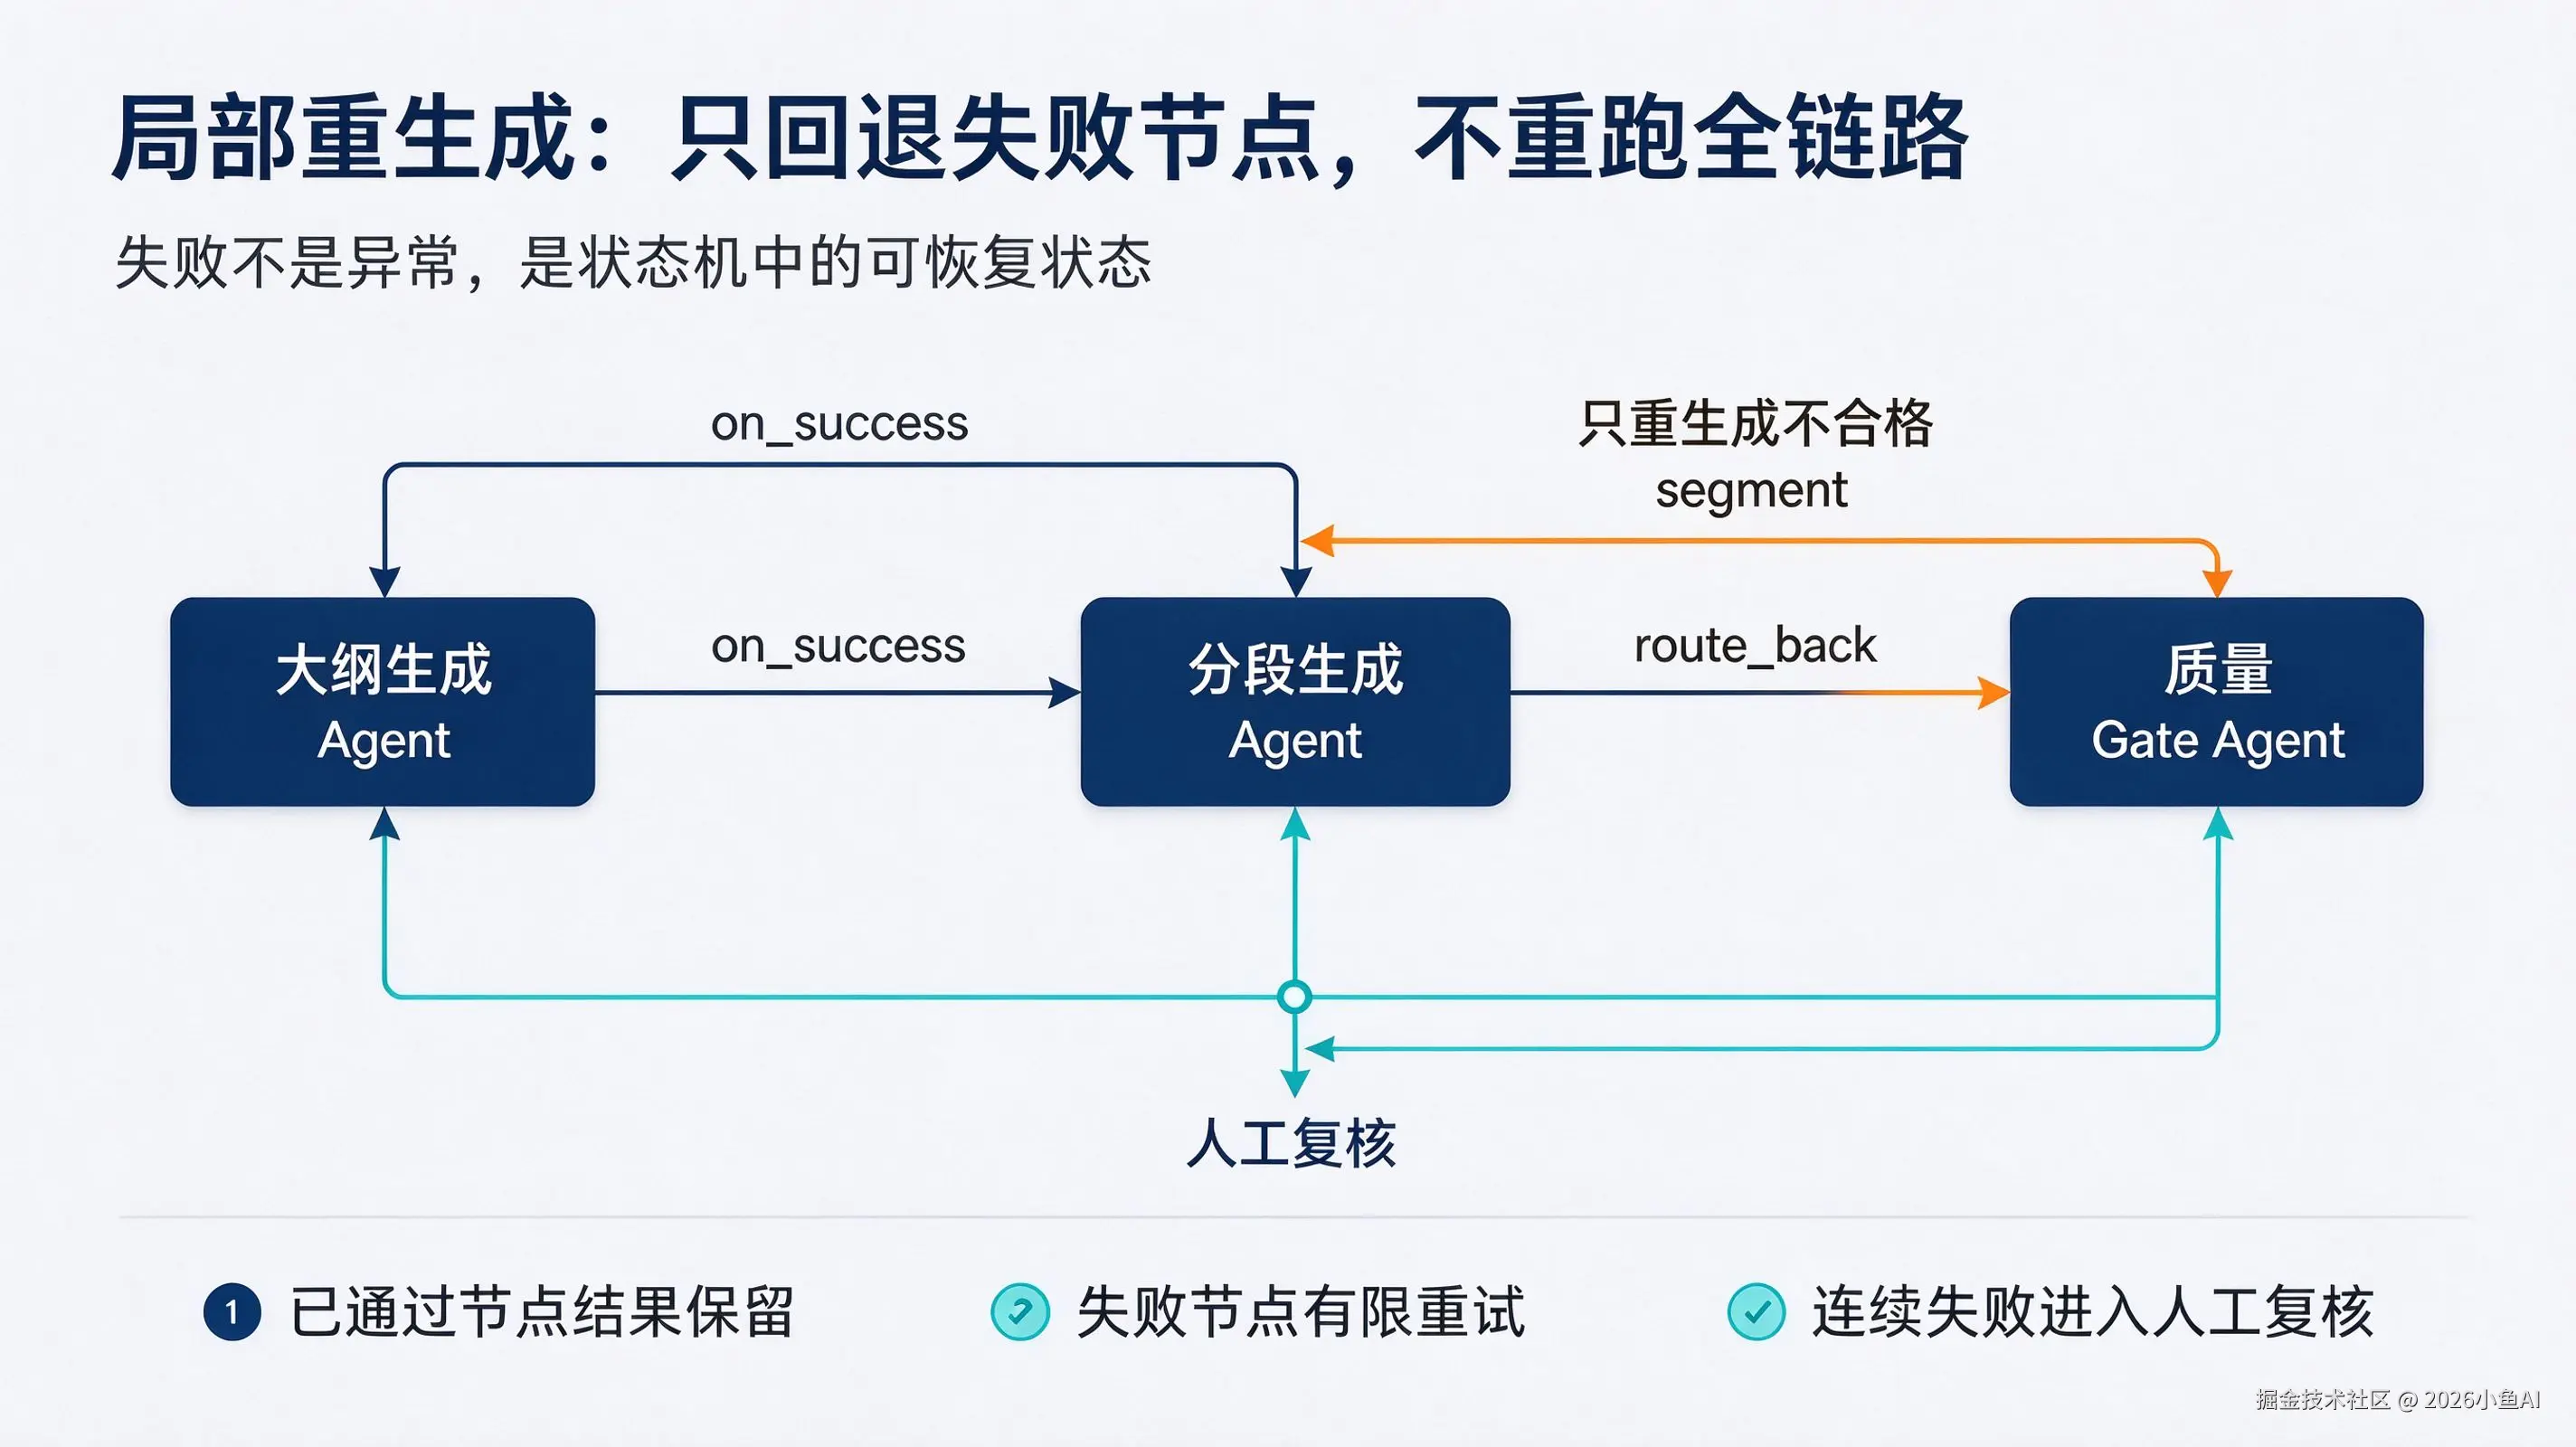
三、局部重生成:多智能体状态机,只回退出错节点,不重跑全链路
教研同学说的"只修改不合格的段落",翻译成工程实现,就是多智能体编排里的状态机能力: DAG 里已经校验通过的节点结果保留,仅对失败的节点做局部回退重试。
我们在备课链路里验证了两种稳定的局部恢复模式:
assess-fail-retry:评审 Agent 判断当前教学方案不合适,路由切换别的教学策略,不重跑整个单元;curriculum-revise-on-repeated-failure:同一个节点连续多次校验失败,仅从当前单元重新规划,而不是从头跑完整流程。
下面是精简可落地的状态机配置:
yaml
# teaching_plan_orchestrator.yaml
states:
  outline:
    agent: CurriculumAgent
    on_success: segment_generation
    on_failure:
      retry: 2
      fallback: human_outline_review

  segment_generation:
    agent: SegmentAgent
    fan_out: true
    validate: lesson_schema
    on_node_failure:
      retry: 1
      retry_with: "schema_error_or_missing_dependency"
    on_repeated_failure:
      after: 3
      action: flag_for_human

  quality_gate:
    agent: RubricReviewer
    on_success: finalize
    on_failure:
      route_back: segment_generation
      max_revisions: 3
两个关键评审点:
route_back的粒度是核心:能不能精准定位到单个出错的环节?如果只能整体重跑,那"局部纠偏"只是一句话术;- 自检不等于独立验收:如果评审 Agent 和生成 Agent 使用同一个模型、同一套提示词,它们会共享相同的认知偏差。 确定性的规则交给代码校验;语义、教学适配度这类主观评审,只用来触发人工复核,不能直接自动放行。
四、小模型并发陷阱:并发上来,先出现质量漂移,再拉高延迟
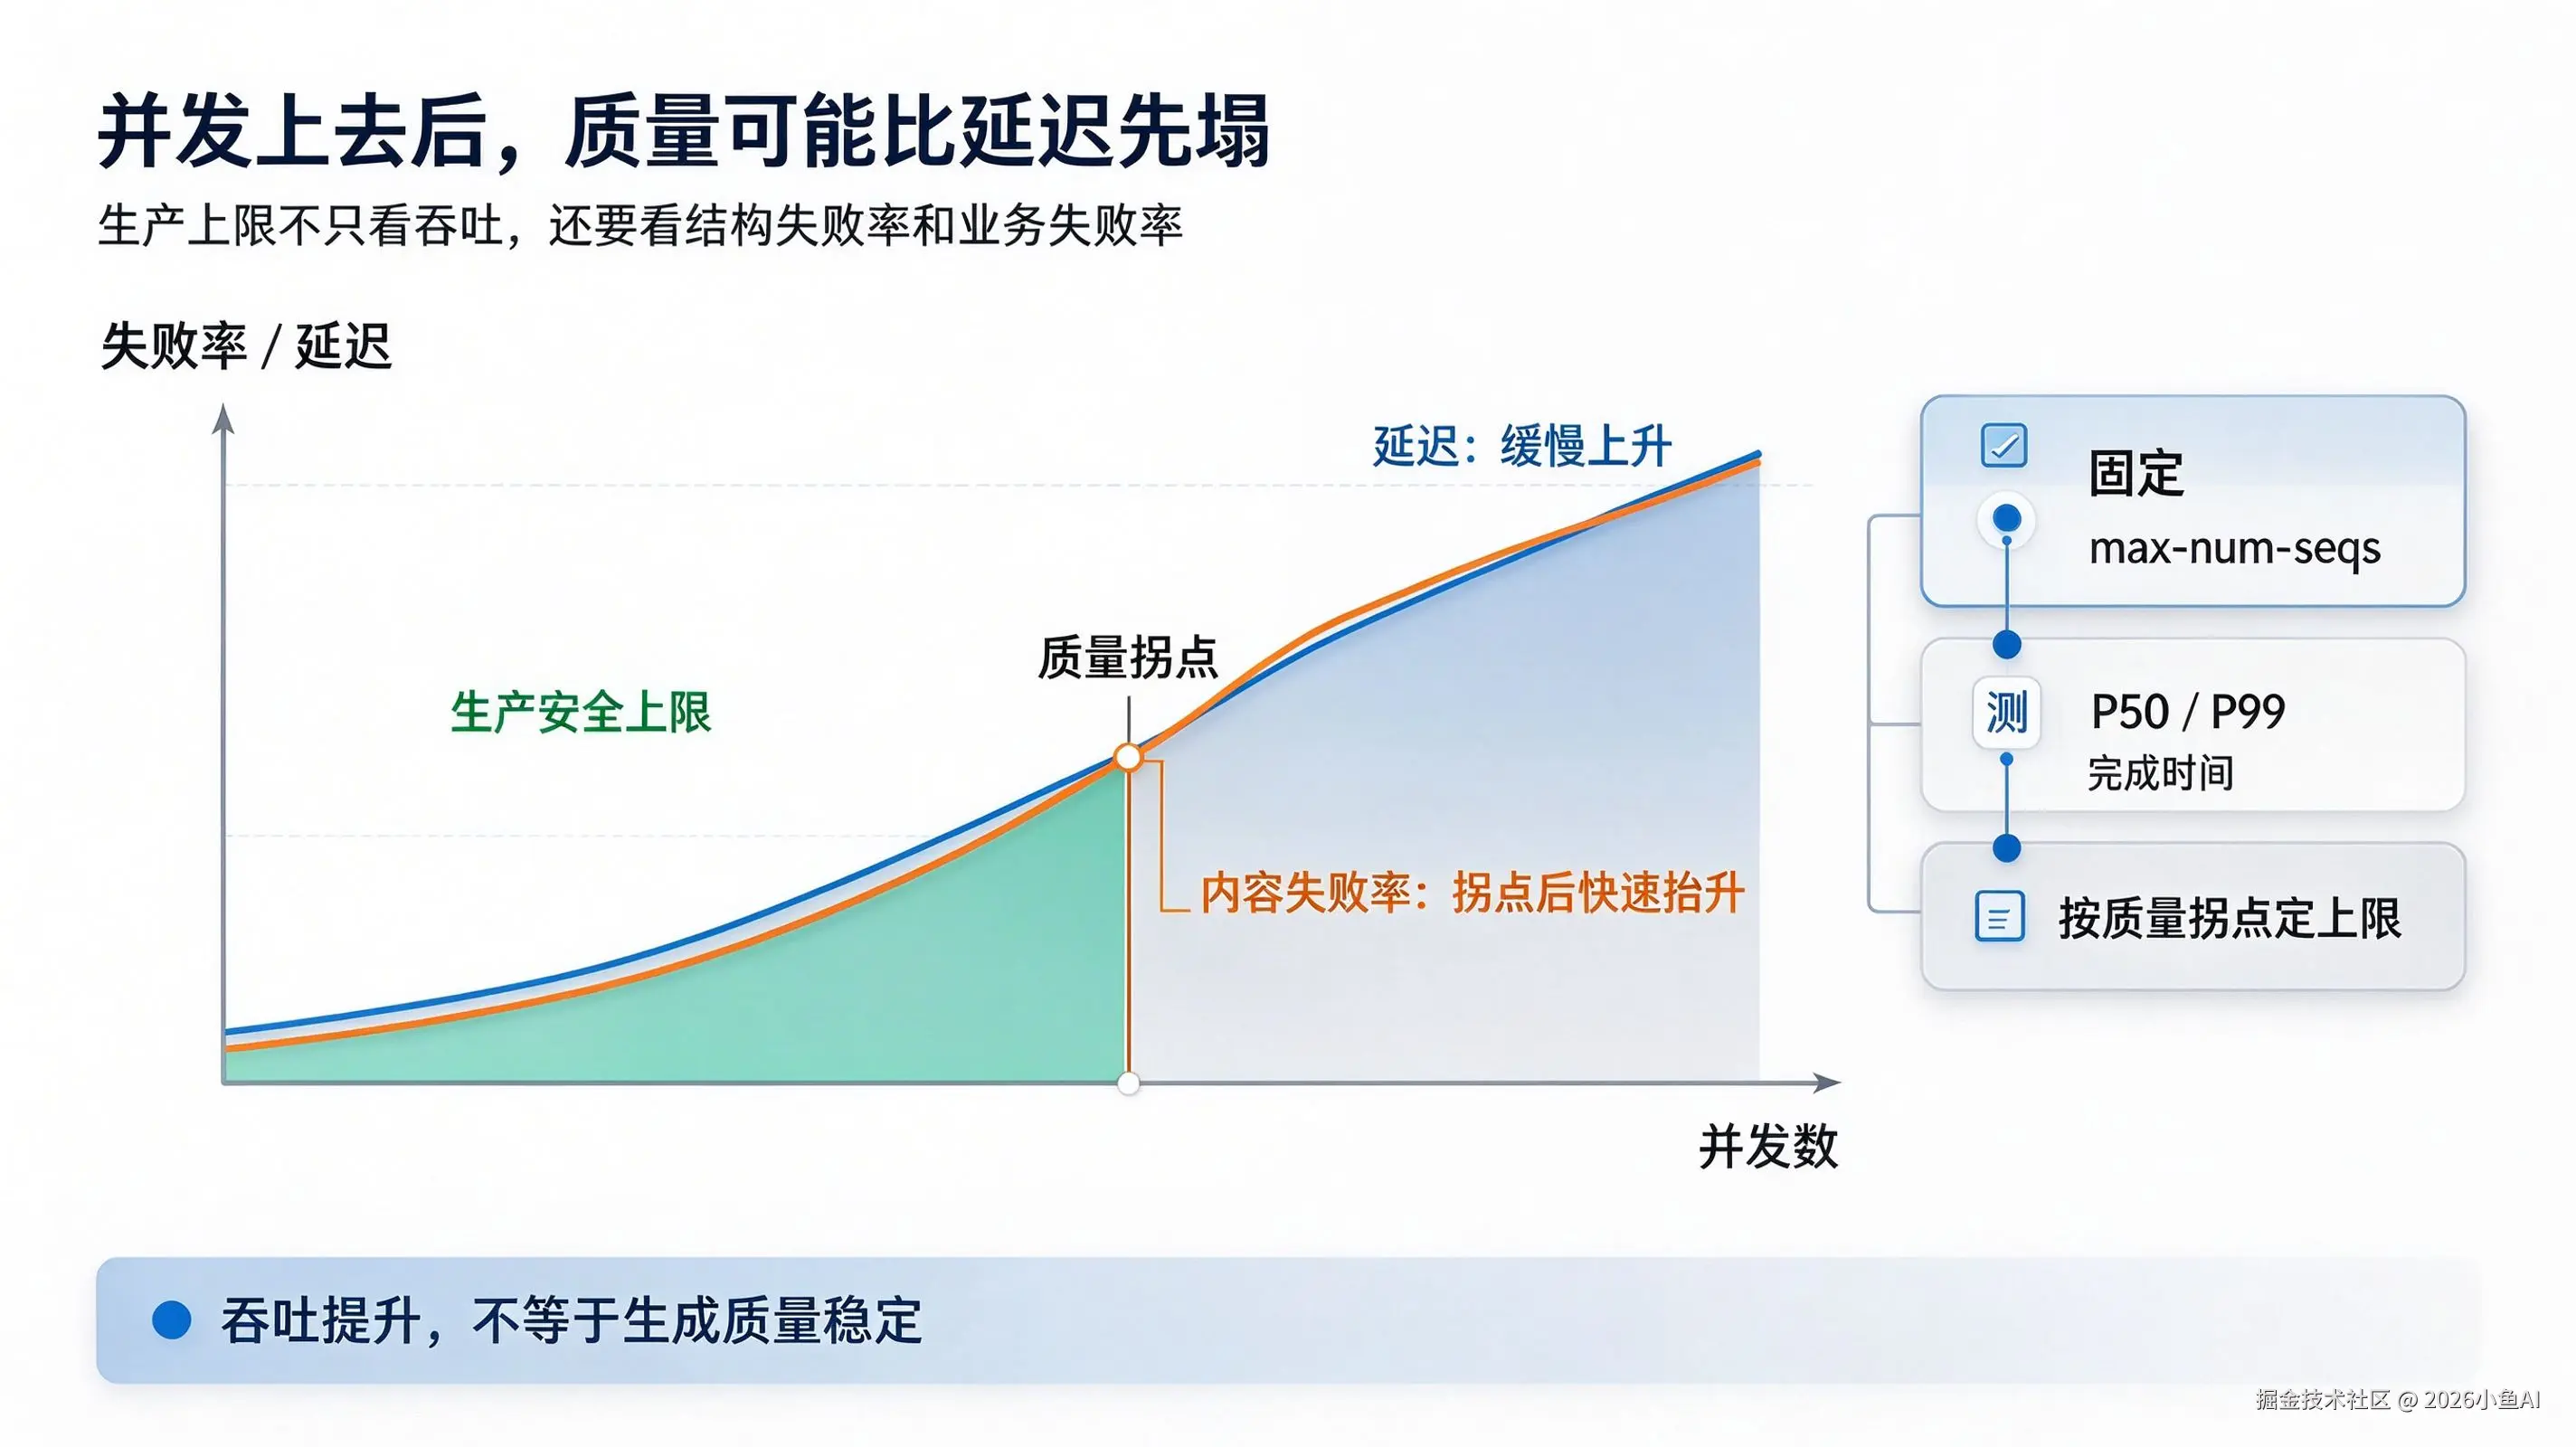
很多团队用 4B~8B 小模型做结构化生成,压测的时候很容易只盯着吞吐、延迟指标,忽略一个更致命的问题:并发上涨到某个阈值之后,输出质量会拐点式下滑。
参考 vLLM 社区公开压测数据:Qwen3-4B-Instruct,L4 24G 单卡,短输出场景(max_tokens=256),20 并发下,流式平均延迟约 15.7s,p50≈16.5s,TTFT 1.1~1.3s,聚合吞吐 300--380 token/s。
备课属于长输出异步任务,这个延迟意味着:前端同步等待体验极差,必须走异步队列,而且并发参数不能直接抄实时对话场景的配置。
社区给出的调优思路:低延迟场景会调低 max-num-batched-tokens、限制 max-num-seqs(4--8)优先保障首token速度。但备课链路优先保障结构化质量,而不是极致吞吐。
推荐一套排查顺序:
- 固定
max-num-seqs,采集 P50/P99 完成时间随并发变化趋势; - 找到结构错误、业务校验失败率明显抬升的拐点,以此作为生产环境并发上限;
- 流量上涨、吞吐不够时,优先横向扩容实例,不要持续拉高单实例并发。
量化可以提升 Token 吞吐,但不代表生成质量稳定。吞吐指标和业务内容合格率,是两套完全独立的观测指标,一定要单独绘制「并发-失败率」曲线。
五、合规不是写在文档里,而是在数据入口硬拦截
教育场景比较特殊,未满14周岁学生信息属于敏感个人信息,按照《个人信息保护法》,只能在最小必要范围内处理,并且需要取得对应的单独同意。
合规不能依靠开发自觉、不能寄希望于提示词,要在组装请求的入口代码直接剥离敏感字段:
python
FORBIDDEN_KEYS = {"student_name", "student_id", "guardian_phone", "home_address"}

def strip_pii(payload: dict) -> dict:
    return {k: v for k, v in payload.items() if k not in FORBIDDEN_KEYS}
如果确实需要传递学情摘要,采用本地映射方案:本地维护 student_key <-> 真实ID,LLM 链路只传递可轮换的匿名标识;日志序列化时自动掩码敏感字段,从底层规避泄露风险。
注:本文仅客观说明法规对应的工程落地手段,不构成法律意见,不代表方案天然合规。
六、上线前先问自己这5个问题
落地这套方案之前,先用下面 5 个问题自查,全部有可复现答案,才算是一套可控的工程方案,而不是调提示词的经验:
- 输出契约是强类型 Schema,还是无约束自由文本?Schema 是否统一由代码维护?
- 校验失败时,系统返回的是明确的层级、错误位置,还是只简单返回一句"校验失败"?
- 重试能力是否支持节点级局部回退,还是只能全链路重新执行?
- 有没有实测并发和内容失败率的曲线?并发上限是按照质量拐点设置,还是单纯看吞吐?
- 学生敏感信息剥离逻辑写在哪一行?是代码强制拦截,还是依靠口头规范?
文末
本文聊的全是落地约束和风险边界。 像 5并发 / 20并发下结构化失败率差异、复杂DAG里 route_back 会不会连带正常节点重跑、队列堆积后 P99 耗时变化,这些没有通用标准答案,只能靠压测、埋 Trace 拿到真实数据。
后续专栏会放出两组带完整压测配置、原始 trace 片段的踩坑记录:一篇拆解小模型长文本生成场景的并发质量拐点,一篇分析多智能体状态机回退粒度对算力成本的影响。 很多官方教程偏向原理科普,这里记录线上生产最容易卡住工程师的真实坑。
欢迎在评论区交流:你在 LLM 内容生产链路,遇到过哪些「格式完全没问题,但业务完全不能用」的诡异场景?