在数据驱动业务的今天,虽然大模型已经能够"生成 SQL 代码",但企业在实际落地中依然面临新的困境:
-
"能写代码"不等于"能交付结果":通用 Agent 缺乏对企业特定业务口径、复杂表关系的深度理解,生成的代码常伴随"幻觉"或逻辑偏差,仍需人工反复校验修改。
-
操作流程严重割裂:即使 AI 生成了代码,用户仍需手动切换到大数据产品控制台、配置权限、粘贴运行、排查报错。多控制台频繁跳转,让"智能化"变成了"半自动化"。
-
企业级安全与感知缺失:通用外挂式 Agent 无法深度感知底层引擎的运行状态(如资源瓶颈、数据倾斜),且难以无缝继承企业现有的 RAM 权限体系与多租户隔离机制,存在合规隐患。
真正的 AI 原生,不应止步于"代码生成",而应实现"端到端的业务结果交付"。
阿里云正式推出 AI 原生大数据服务 ADA。
ADA:以智能体为核心的新一代数据生产力平台
ADA 定位于将智能体(Agent)技术与大数据、AI 引擎深度融合,为企业提供新一代数据生产力平台。帮助企业以自然语言完成大数据任务,加速数据决策。在 ADA 中,MaxCompute、Hologres、Flink、EMR、DataWorks 等各产品引擎的 Agent 能力可以实现多智能体协同。支持对话式数据分析、智能体管理、知识管理、自动化任务等核心功能,致力于让企业以自然语言完成复杂的大数据任务,加速数据决策。
核心架构与三大特性
-
多智能体协同编排:由 AdaWork 作为主 Agent(Master Agent)进行意图理解、任务路由与自动协同,无缝调度底层各引擎的专业 Agent,完成跨引擎的复杂数据交付任务。
-
企业级知识引擎:内置与 DataWorks 同款的语义图谱能力,将企业的数据资产、业务语义与分析经验沉淀为统一的认知中枢。
-
高自由度自定义 Agent:支持低代码与高代码双模式,企业可灵活接入主流 Agent 引擎,构建契合自身业务场景的专属智能体。
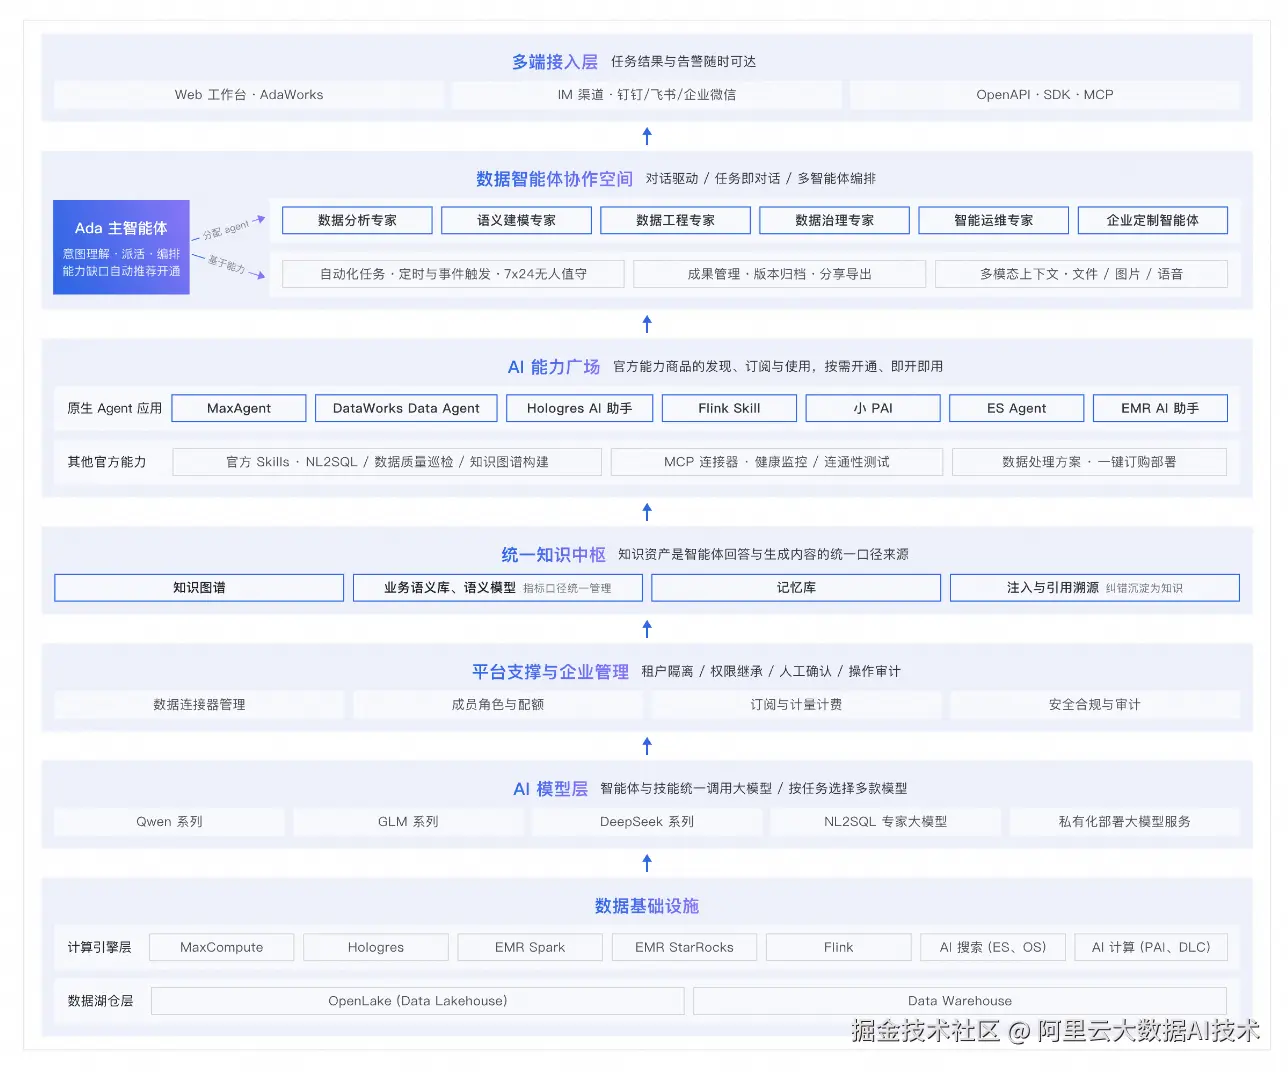 ADA 产品架构图
四大核心优势,重塑数据工作流
1. 极简交互:零门槛,提问即分析,对话即交付
内置开箱即用的数据 Agent 解决方案。业务人员无需编写 SQL 或掌握复杂的引擎操作,只需通过自然语言对话,即可直接发起数据分析、开发与治理任务。从需求理解、任务拆解、跨引擎调用到最终结果交付,全流程由 Agent 自主闭环完成。
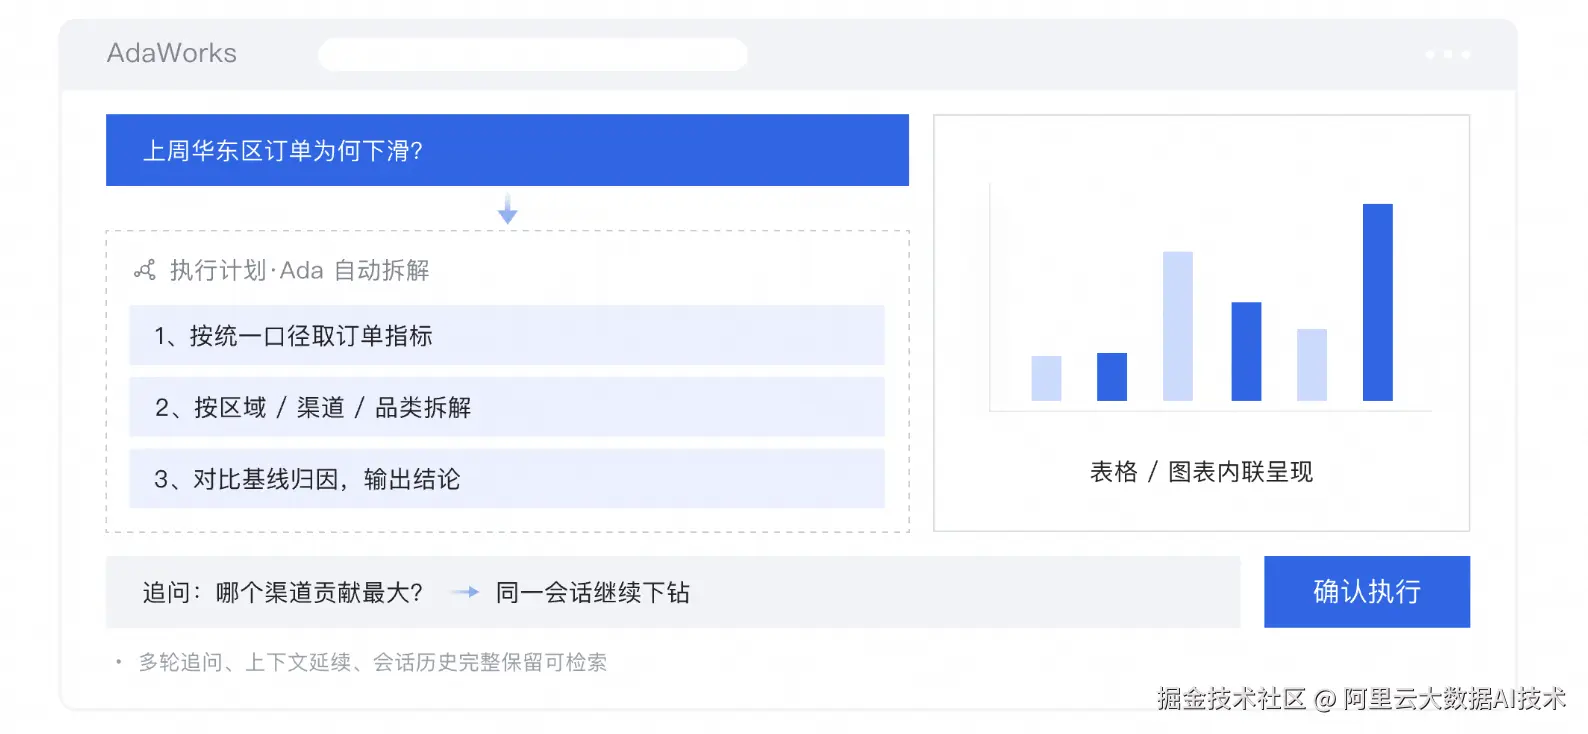
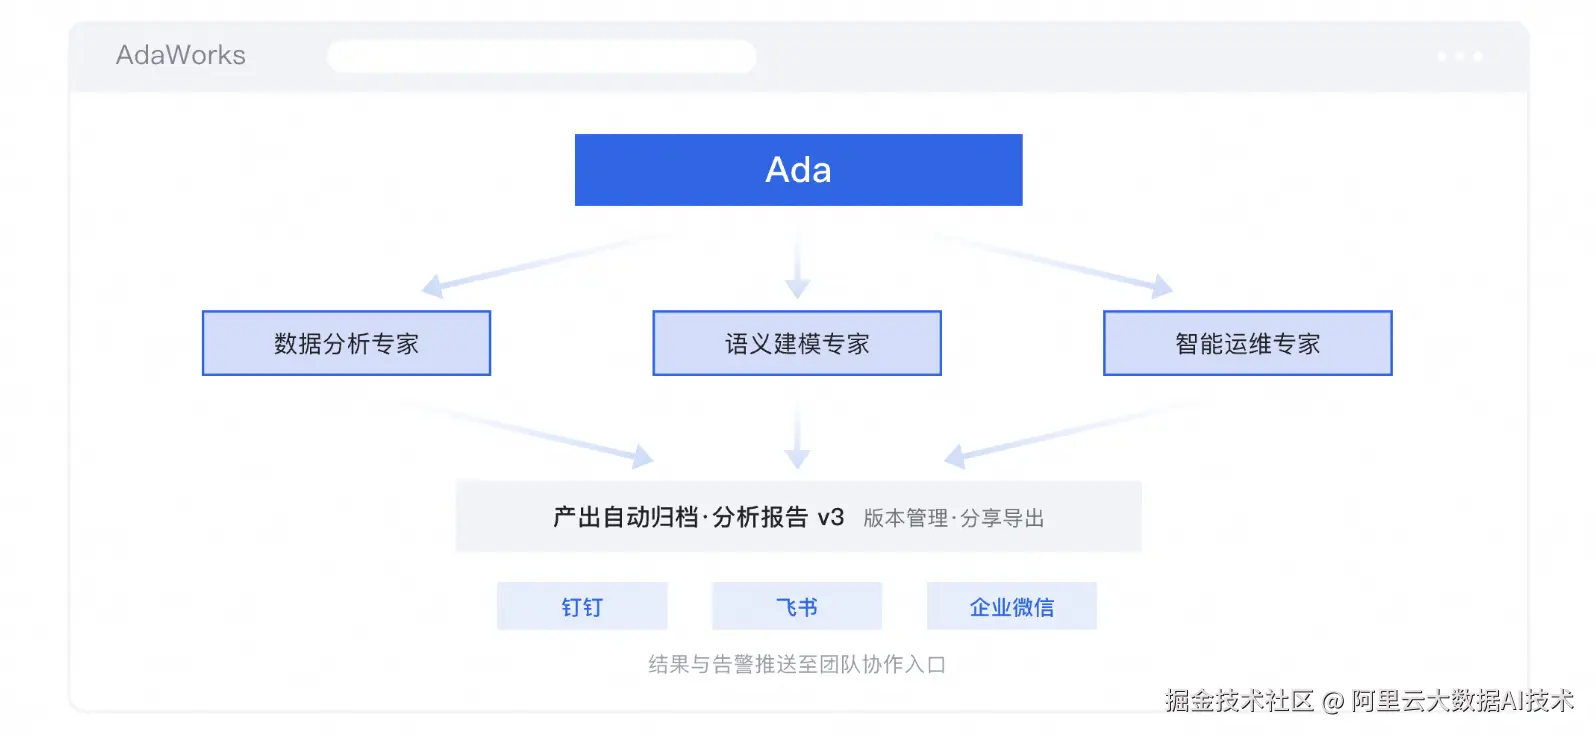
2. 多智协同:多角色编排,端到端交付业务结果
Ada 主智能体作为"超级大脑"统一理解意图并拆解任务,在统一工作空间内,无缝调度底层各大引擎的 Agent。内置数据分析师、语义建模专家、数据工程专家、智能运维专家等多个专业角色协同编排,覆盖从分析洞察到数据治理的完整业务闭环,彻底告别多控制台频繁切换的割裂感。
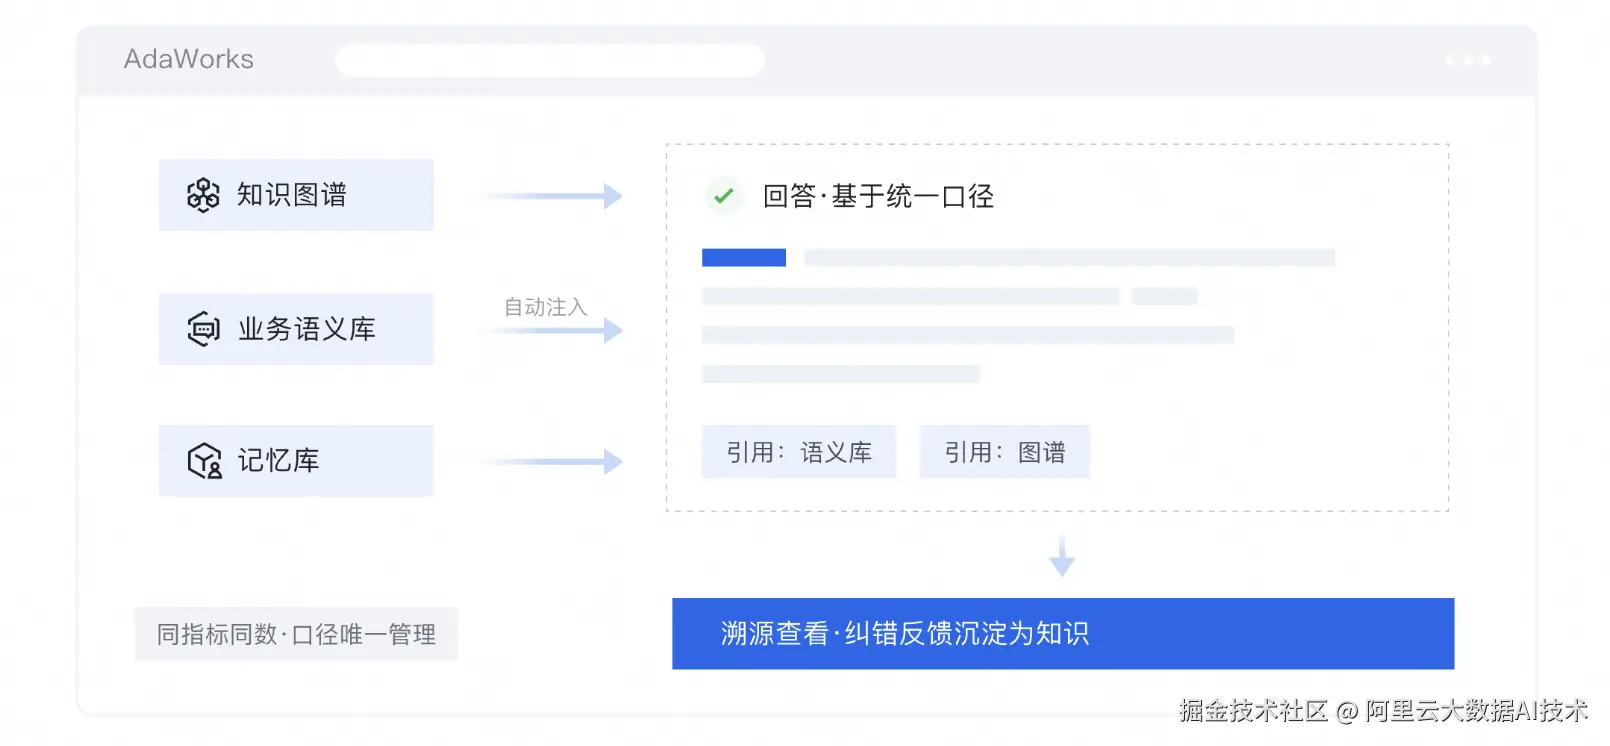
3. 可信可溯:统一语义知识中枢,让每一个结论都经得起推敲
将语义模型、指标计算逻辑、表关系与分析经验,沉淀为平台级知识资产(知识图谱、业务语义库、记忆库)。确保不同 Agent、不同团队基于同一套数据口径开展工作,消除口径冲突。所有分析结论均附带引用溯源,有效避免指标歧义,让数据决策可验证、可信赖。
4. 原生感知:引擎内置 Agent,深度洞察系统状态
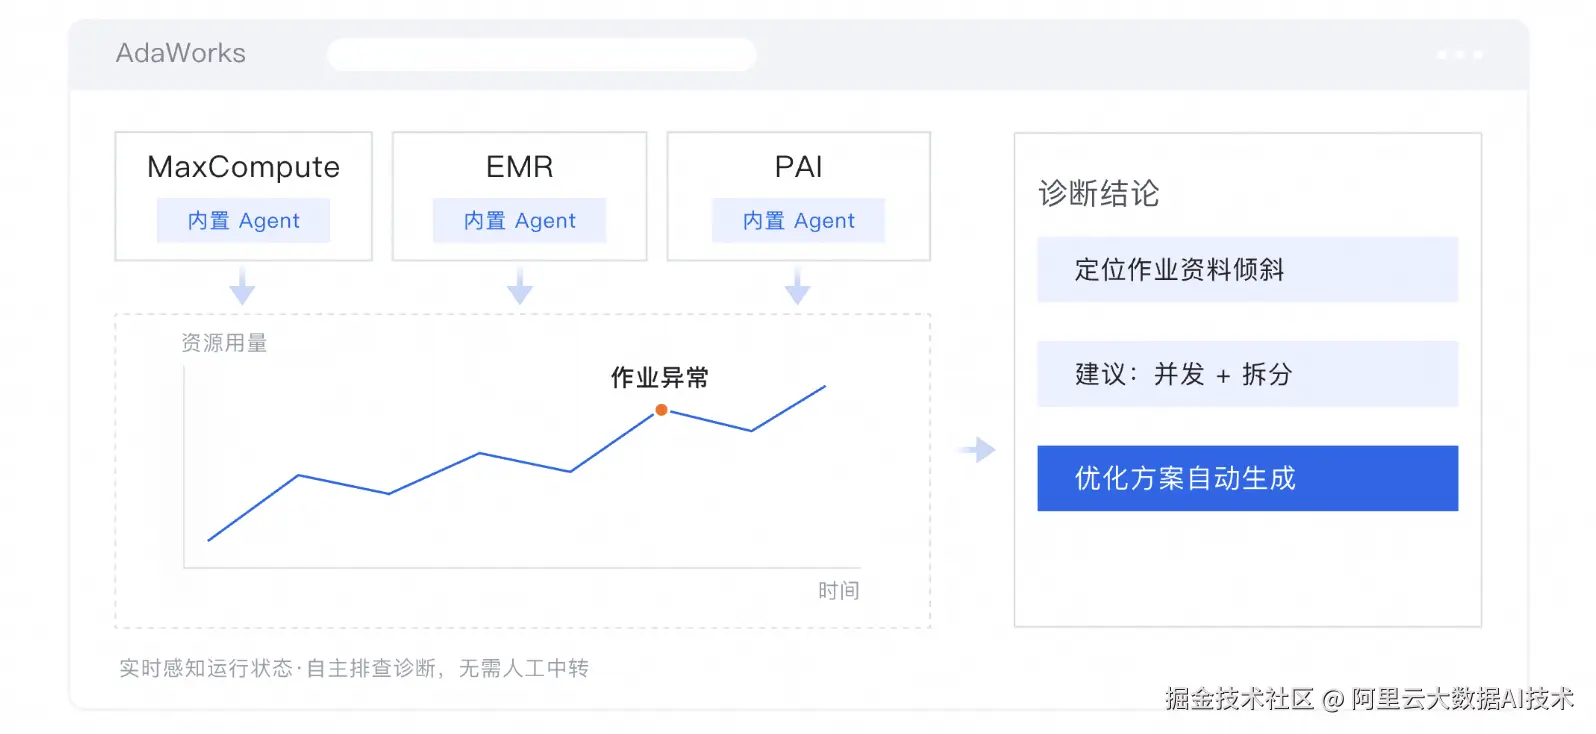
与通过接口获取数据的传统通用 Agent 不同,ADA 的 Agent 直接内置在数据系统内部。它们可实时感知系统运行状态,自主排查性能与健康问题并给出优化方案,全程无需人工中转。这种原生架构,赋予了智能体难以比拟的深度感知、精准诊断与实时响应能力。
ADA:让每个人都能成为数据专家
-
对业务人员:打破技术壁垒,实现"所想即所得"。将数据价值获取周期从"天级"压缩至"分钟级",随时随地用数据驱动业务增长。
-
对数据工程师/分析师:从繁琐的重复劳动中解放出来,将精力聚焦于高价值的语义建模、复杂工作流编排与深度业务洞察。
-
对企业管理者:构建企业专属的"数据认知资产"。通过统一的知识中枢和严格的权限/审计机制(继承 RAM 权限、操作全程可追溯),在保障企业级数据安全合规的前提下,最大化释放数据资产价值。