29 · CUDA Graph 接到 hybrid 路径
一句话 :把 26 篇只停留在「乐观(上限)外插」的 CUDA Graph 候选真正落地------先用 nsys 直接量出发射空档 2.761 ms/token(16.87%),得到天花板;再把 CUDA Graph 接到 64 层异构前向路径上,难点不在 graph API 本身,而在「把随 token 变化的位置量从内核参数搬到设备」;同会话交错 A/B 六轮 1.1335× (省 1.878 ms/token,是下界),两档数值经元素级
memcmp确认逐字节相同。 前置 :建议先读 第 26 篇(发射空档的两个机制)与 第 28 篇(hybrid 接进引擎)。 环境 :x86-64 + NVIDIA RTX 5090;模型 Qwen3.5-27B q4;工具 nsys / ncu;出厂档build-x64\vllm_cuda.dll。 三个数 :① nsys 逐核起止区间合并取补集,发射空档 2.761 ms/token(16.87%) 、1090 次发射/token ⇒ 2.53 µs/次(第 2.2 节,是 graph 的上界);② 同会话交错 A/B 六轮 1.1335× 、省 1.878 ms/token (15.944 → 14.066 ms/token,第 6 节实测,是下界);③ graph 档与流式档的h64/hfinal/logits元素级 memcmp 逐字节相同 (第 10.1 节)。 怎么读 :结论看 一、问题与结论 与 十二、小结 (必读);机制看 三、接线:把位置量从内核参数搬进设备 、四、设计依据与两个坑 、五、数值零回归与口径边界 、七、与天花板对账:归因分级 (想深挖再看);二、侦察:先把空档量出来 、六、同会话交错 A/B 、八、零回归全项与产物 、十、收口 (10.4--10.10)与文末附录属过程与原始数据(可跳)。
第 26 篇那三步曲(事件计时 → nsys → 判别实验)留下的一号候选 CUDA Graph , 在账上一直是一个没实测过的外插:当时只能说「≈1.8 ms(9.3%)=乐观(上限)外插, 禁止当收益引用」。
本篇把这条线走完:先用 nsys 直接量出 发射空档 2.761 ms/token(16.87%) , 由此得到 CUDA Graph 的天花板 ≤ 2.761 ms/token ;再把这个数落地------ 把 CUDA Graph 接到 64 层异构(48 GDN + 16 full attention)前向路径上。
难点不在 graph 本身,而在**「把随 token 变化的位置量从内核参数搬到设备」**: RoPE 位置、KV 追加行号、attention 可见长度,这三者原来都是内核参数, 捕获后会被钉成常量。
结果:同会话交错 A/B 1.1335× 、省 1.878 ms/token (实测, 因口径保守而是一个下界 );两档的 h/final/logits 经元素级 memcmp 确认 逐字节相同 。过程中踩了两个坑,其中一个是接口契约误判。
状态:✅ 已落地(默认关,opt-in)。
一、问题与结论
- 空档被直接量出来了 :用 nsys 逐核起止、区间合并后取补集, 得到发射空档 2.761 ms/token(16.87%) 、1090 次发射/token ⇒ 2.53 µs/次 。 这是 CUDA Graph 的上界。
- 两项天花板,都只是上界 :CUDA Graph(消空档)≤ 2.761 ms/token(16.87%) ; 融小核(192 次发射)≤ 0.49 ms/token(2.9%) 。 CUDA Graph 的天花板是融小核的 ~5.6 倍,但两者都不是 可拿回量: 第 26 篇已判定每次发射的空档是「主机侧 CPU ≈5 µs/次」与「设备地板 ≈1.1 µs/次」取大者 , graph 消不掉设备地板那部分;且 graph 每节点成本随 grid 上升(612 → 2440 ns)。
- 接线只改一个文件 :
src/npu/cuda/vllm_cuda_kernels.cu(宿源码.c未动),7 处改动。 核心是第 2 条:k_attn_rope_tab/k_attn_decode改吃设备指针 , 不再把pos/npos当内核参数------内核参数会被捕获成常量,replay 后恒定。 - 踩了两个坑,教训比收益更值钱 :
- 契约误判 :把位置量设备化的第一版只留一个 标量,理由是「既有守卫
attn_len[ai] == pos已强制两者相等」。这个理由是错的 ------那条守卫只在 graph 准入分支里,不是 公开入口vcuda_dev_attn_step的历史契约。 当场翻车:q35_attn_check退化成[attn] step 0 failed。订正后工具未改一个字节 , worst max_rel 回到归档的 4.697e-07。 - 捕获点放错地方 :捕获必须「空跑 + 真捕」两遍,放
step里实测前向 18.39 ms/token (默认档 16.32)。搬到vcuda_dev_model_reset后解决。
- 契约误判 :把位置量设备化的第一版只留一个 标量,理由是「既有守卫
- 数值零回归 :默认流式档与 graph 档与归档逐项相同 (h/hfinal/logits maxrel、argmax、贪心序列)。 ★ 而「两档之间」又强了一层 :补测的元素级 memcmp 显示
h64.bin/hfinal.bin/logits.bin逐字节相同 (见第十节-1)。 在此之前,「逐项相同」(打印值 + argmax + 序列)不足以支撑「位级一致」------ 本轮的审计 MUST-2 就是冲这句话来的。 - 收益(实测) :同会话交错 A/B 六轮 1.1335× 、省 1.878 ms/token 。 这个数是下界(两档都算了 lm_head)。
- 归因必须分级 :「1.1335×」是实测 ;「拿回空档的 68.0%」是对账 (跨会话/跨仪器比值); 「剩下 ~32% 是设备地板」是推断。三者的证据成色不同,不许混写。
- 审计抓的是口径不是代码 :两条 MUST 里,MUST-1 是真边界守卫缺失(已修,且已补测 ); MUST-2 纯粹是「我的说法比证据所能支撑的更强」(先降级口径,再用 memcmp 升回逐位)。
- 两条欠账用「改工具」补掉,引擎一行未改 :给
q35_gpu_model加--dump(让档间 memcmp 可做)与--maxseq(让越界边界可达)。验证手段不该改动被验证的对象。
二、侦察:先把空档量出来
第 26 篇走到判否实验这一步,只给出了一个外插 :按 1168 × (2.05 − 0.53) µs ≈ 1.8 ms。 要真把 CUDA Graph 落地,第一步是换一种口径再量一次 ------不是在微基准上外插,而是在真实模型路径上量。
方法 = 第 26 篇的原样复跑:subst X: 绕开 protobuf 的非 UTF-8 cwd,nsys profile
cuda_gpu_kern_sum+cuda_gpu_trace;对象 = 出厂档build-x64\vllm_cuda.dll、q35_gpu_model --layers 64 --iters 1(无--ref⇒ 3 个 token 步 ,表内一律除以 3 )。 跑完删除.nsys-rep16.4 MB +.sqlite250.1 MB + csv(共 266 MB,仓库已清)。
powershell
subst X: <repo_root>
nsys profile --stats=true --force-overwrite=true -o X:\nsys_q35_64 `
     X:\GitHupSRC\tools\build\out\q35_gpu_model.exe X:\Modl\Qwen3.5-27B-q8local `
     --vqf X:\Modl\Qwen3.5-27B-q8local\model_q4.vqf --layers 64 `
     --lib X:\GitHupSRC\build-x64\vllm_cuda.dll --iters 1
nsys stats --report cuda_gpu_kern_sum --format table X:\nsys_q35_64.nsys-rep   # 逐核汇总
nsys stats --report cuda_gpu_trace   --format csv   X:\nsys_q35_64.nsys-rep   # 逐核起止(算空档)
2.1 逐核对照(ms/token,÷3)
逐核原始读数见文末 [附录 · 表 A1](#附录 · 表 A1 "#%E9%99%84%E5%BD%95%E5%8E%9F%E5%A7%8B%E6%95%B0%E6%8D%AE%E8%A1%A8")。
★ k_attn_decode 的 max = 203.7 µs(均值 11.27)⇒ 有一次性尖峰,不是 16 次都慢 ; 这 0.18 与 0.113 的差更可能是 3 步样本太少(n=16×3)。不作结论。
两个落地项的 nsys 独立验证:
- 融合:
k_f32_gemv96 次 0.899 →k_f32_gemv248 次 0.416 ,次数与核时都减半 ✓ - 寄存器:
k_gdn_delta2.646 →k_gdn_delta_reg0.240 ✓(与归档的 0.239 一致)
也就是说,这两次改动被 nsys 独立复验(不是「实测 − 预测」的自证)。
2.2 ★ 发射空档(cuda_gpu_trace 逐核起止,区间合并后取补集)
| 量 | 全轨迹(3 步) | 每 token |
|---|---|---|
| GPU 时间线跨度 span | 49.095 ms | 16.365 ms |
| 核时 busy | 40.812 ms | 13.604 ms |
| 空档 idle | 8.284 ms | 2.761 ms(16.87%) |
| 发射次数 | 3270 | 1090 |
| 空档 / 次 | 2.53 µs |
⚠ 口径 :这是核时 vs 时间线 的差,不是第 26 篇的「按步切片」;两者定义不同 (本节是整段合并区间,第 26 篇是逐步),故 2.761 与 2.40 不可直接相减。 但 span/token = 16.365 与无探针 wall 15.875 的 ~3% 差与第 26 篇记的「nsys 口径高 ~1.8%」同向。
测量口径值得写清楚,因为它是后面所有归因的立足点:
- 取
cuda_gpu_trace的逐核起止时间戳; - 把同一条时间线上所有「核在跑」的区间合并,得到 busy 集合;
- 在时间线跨度内对 busy 集合取补集,就是 idle(空档)。
这与第 26 篇那次「12.3%」的差别不是仪器换了 ,而是覆盖窗口变了 :本节量的是 整段合并区间(含相内、相间的全部缝),第 26 篇的窗口是从「该步第一个 rq gemv」 到「最后一次 lm_head 结束」。两个数回答的是不同问题。
2.3 与端到端的独立对账(融合项的收益拆解)
空档既然能逐核量出来,就能拿它去拆一个已经有端到端实测的收益------β/a 融合。
| 项 | 值 |
|---|---|
| 核时减少(0.899 → 0.416) | −0.483 ms/token |
| 发射减少(48 次 × 2.53 µs) | −0.121 ms/token |
| 合计预测 | −0.604 ms/token |
| 端到端交错 A/B 实测 | −0.653 ms/token |
| 差 | 8%(3 步样本 + 探针口径,属噪声量级) |
⇒「核时减半 + 少 48 次发射」这个拆解自洽 。意义在于:这条链的一端是 本轮的 nsys 逐核量 ,另一端是上一轮的端到端 A/B ,中间靠「2.53 µs/次空档」这一条 把两者连起来,得到的差只有 8%。空档这个量因此被端到端独立对账过。
2.4 ★ 由此得到的两项天花板(这才是本轮的目的)
| 候选 | 可拿回(本测量直接给出的上界) | 依据 |
|---|---|---|
| CUDA Graph(消空档) | ≤ 2.761 ms/token(16.87%) | 空档全额 |
| 融小核(GDN 4 小核 + attn 4 小核 = 192 次) | ≤ 0.49 ms/token(2.9%) | 192 × 2.53 µs |
⇒ CUDA Graph 的天花板是融小核的 ~5.6 倍 。但两条都只是上界 : 第 26 篇已判定每次发射的空档是「主机侧 CPU ≈5 µs/次 」与「设备地板 ≈1.1 µs/次 」取大者, graph 消不掉设备地板那部分;且第 26 篇测到 graph 每节点成本随 grid 上升(612 → 2440 ns)。
这句话必须钉死:2.761 是上界,不是承诺。后面拿它做分母对账时, 也只能称"对账",不能称"拿回了 76%"。
2.5 可行性侦察(为接线做的定位,尚未动代码)
vcuda_dev_model_step 目前不可捕获,缺三件:
- 跑在 legacy default stream (
const cudaStream_t st = 0;)------ 捕获不能 用 legacy 流。 稠密路径vcuda_dev_decode_run已经处理过(自建s->stream)。 - 捕获区内有同步 H2D/D2H :
cudaMemcpy(s->d_mdl_h, h, ...)与末尾 logits D2H。 稠密路径的解法:两者都改cudaMemcpyAsync(..., s->stream),输入缓冲稳(d_mdl_h已是设备缓冲)。 pos被当内核参数烧进图 :vc_attn_step_dev里const int len = s->attn_len[layer](宿主)→k_attn_rope_tab<<<...>>>(..., pos, ...)以及s->attn_len[layer] = npos。⇒ 每层一个pos+ 一个 KV 游标都得搬到设备。 引擎已有 这套基建:s->d_dyn[2] = {pos, seq_len},且k_attn_decode存在读dyn[1]的变体与显式吃seq_len的变体。 ⇒ 接线 = 把 hybrid 的 attn 步切到dyn变体 + 把attn_len游标设备化。
风险等级 :中高 。它动的是注意力索引路径 (RoPE 位置 / KV 追加下标)------正是 那三条守卫保护的那一类「静默错」。任何 pos/游标错位都会静默出错误结果, 必须先设计「游标与 pos 的一致性守卫」再动手。
2.6 未做
- 本节只做测量与定位,未改引擎一个字节;三个产物(exe / DLL / 探针)与本轮完全相同。
- 未做 graph A/B 打在 hybrid 模型路径上(那就是落地本身)。
- 3 个 token 步的样本量偏小(
k_attn_decode的尖峰即例子);若要更稳需--iters N多步, 但 nsys 产物会线性变大(须同样跑完即删)。
三、接线:把位置量从内核参数搬进设备
上一节把天花板和「三件缺失」都点清了。这一节把它们逐条补上。 只改了一个文件 :src/npu/cuda/vllm_cuda_kernels.cu(宿源码 .c 未动)。
| # | 改动 | 为什么必须 |
|---|---|---|
| 1 | vc_dev_t 新增 mdl_stream / mdl_graph / mdl_gexec / mdl_graph_mode / mdl_graph_ready;复用既有 d_dyn[2] |
捕获不能用 legacy default stream(第 2.5 节第 1 条) |
| 2 | k_attn_rope_tab / k_attn_decode 改吃设备指针 (不再把 pos / npos 当内核参数) |
内核参数会被捕获成常量,replay 后恒定 |
| 3 | 新增 k_attn_kv_append(kc, vc, kt, vt, dyn, kv_width),取代原先两条 cudaMemcpyAsync(..., DeviceToDevice) |
D2D 的目的地址依赖宿主游标,捕获后钉死。纯拷贝 ⇒ 逐位相同 |
| 4 | vc_attn_step_dev 去掉 int pos 参数;不改任何宿主状态 ;attn_len 推进上移给调用方 |
「不改宿主状态」是能被整体捕获的前提 |
| 5 | vcuda_dev_model_step 抽出可捕获的 vc_model_step_body(s, pos, st, want_logits) |
同上;body 内无同步 H2D/D2H、无 cudaMalloc、无 cudaFuncSetAttribute |
| 6 | 捕获点放在 vcuda_dev_model_reset (decode 计时之外),不在 step 里 |
见第 4.3 节的坑 ② |
| 7 | 开关 VLLM_CUDA_Q35_GRAPH(只读一次、默认关) |
不开 = 引入前的行为 |
3.1 核心那一条:位置量设备化
第 2 条是整件事的支点。把引入前后并排看:
c
/* 引入前:pos 是内核参数 ⇒ 捕获后恒为常量 */
const int len = s->attn_len[layer];          /* 宿主游标 */
k_attn_rope_tab<<<...>>>(..., pos, ...);     /* pos 被烧进图,replay 后不变 */
s->attn_len[layer] = npos;                    /* 宿主状态在发射序列里推进 */
c
/* 引入后:位置量走设备标量,图里只留一个指针 */
/* 约定(与稠密路径同一份):d_dyn[0] = RoPE 位置;d_dyn[1] = KV 追加行号 */
k_attn_rope_tab<<<...>>>(..., s->d_dyn, ...);
k_attn_kv_append<<<...>>>(kc, vc, kt, vt, s->d_dyn, kv_width);
/* 宿主状态不再在发射序列里被改 ------ attn_len 的推进上移给调用方 */
原来的 cudaMemcpyAsync(..., DeviceToDevice)(写 KV 行)也被换掉:D2D 的目的地址 来自宿主游标,捕获后即被钉成固定地址;换成 k_attn_kv_append 后,行号从 dyn[1] 里读, 且它是纯拷贝 ⇒ 逐位相同,不引入新的数值风险:
c
/* 文件名:src/npu/cuda/attn_core_twin.inc ------ KV 追加:行号从设备标量 dyn[1] 读
 * 纯拷贝、无算术 ⇒ 与原来的 cudaMemcpyAsync(D2D) 逐位相同;
 * 目的地址改成设备读,是为了让这一段的地址在 CUDA Graph 捕获里保持「可变」。 */
__global__ void k_attn_kv_append(float *__restrict kc, float *__restrict vc,
                                 const float *__restrict kt, const float *__restrict vt,
                                 const int *__restrict dyn, int kv_width) {
    const int bpr = (kv_width + blockDim.x - 1) / blockDim.x;   /* 每行块数 */
    const int blk = blockIdx.x % bpr;
    const int row = dyn[1];                      /* ★ 行号来自设备标量,不是宿主游标 */
    const size_t off = (size_t)row * (size_t)kv_width;
    for (int d = blk * blockDim.x + threadIdx.x; d < kv_width; d += bpr * blockDim.x) {
        kc[off + d] = kt[d];
        vc[off + d] = vt[d];
    }
}
3.2 发射序列的两个变体
同一段前向,两个档在「怎么把位置量送进去」上不同:
| 档 | d_dyn 写入 |
KV 行号 / 可见长度 | 动态 smem 定尺 |
|---|---|---|---|
| 流式(默认) | {pos, pos} 同步 H2D |
dyn[1] / dyn[1]+1 |
按当前 npos(cudaFuncSetAttribute 在此处调) |
graph(=1) |
{pos, pos} async H2D(在 mdl_stream 上) |
同上 | 按 max_seq 固定(捕获前设好属性) |
两档在 KV 行号 / 可见长度 上其实用的是同一份 dyn 读法 ------差别只在 d_dyn 的写入方式(同步 vs async)和动态 smem 的定尺。
3.3 ★ 为什么动态 shared 内存必须定尺
这是最容易忽略、也最危险的一处。GPU 上 attention 的 KV 长度是随 pos 增长的, 内核用的动态 smem 尺寸要随可见长度变化------流式档可以直接在发射前调 cudaFuncSetAttribute 改属性。
graph 档不行,两个原因:
cudaFuncSetAttribute在捕获区内非法 (捕获区里不许有这类「配置调用」), 所以属性只能在捕获前设一次;- 捕获到的 launch 会把当时的 smem 尺寸 记进图节点里。replay 时不会重算, 而是直接复用捕获那一刻的尺寸。
⇒ 如果按捕获时的 npos 定尺,replay 到更长序列时会复用更小的 smem , 越界 。所以 graph 档按 max_seq 定尺:一次取到上限,保证任何 pos 下都够用、 且不需要在 replay 路径上改属性。代价是每步多占一点 smem,但换来了「图是自洽的」。
四、设计依据与两个坑
4.1 ★ 为什么是「两个设备标量」而不是一个
这是本篇最值得写下来的一段。
把位置量设备化的第一版,把 d_dyn 砍成只用一个标量,理由是:
既有守卫
attn_len[ai] == pos已强制两者(RoPE 位置与 KV 行号)相等。
这个理由是错的。 那条守卫只在 vcuda_dev_model_step 的 graph 准入分支 里, 不是 vcuda_dev_attn_step(公开入口)的历史契约。该入口历来允许 「重复喂同一 token (pos 回退、游标不回退)」------tools/q35_attn_check.c 的计时段正是靠这个自由度重复喂同一批 token。
当场翻车 :改严后 q35_attn_check 退化成 [attn] step 0 failed(rc=1)。
订正 :恢复引入前语义------d_dyn[0] = RoPE 位置、d_dyn[1] = KV 追加行号 (与稠密路径 k_rope 读 [0] / k_attn_decode_f32q 读 [1] 同一约定 )。 工具未改一个字节 ,worst max_rel 回到归档的 4.697e-07。
教训:不要把「某处守卫成立」当成「接口契约」 。契约要看全部 调用方。 「某处」可以是某个新分支、某次重构后的局部约束;契约是所有调用方加起来的行为。
这一条之所以比收益更值钱:它不是「写错了代码」,而是推理方式错了 ------ 从「我加的那条守卫成立」推出「接口就该这样」。而接口的历史行为是别人(和从前的自己) 依赖过的事实,不看调用方就改,等于偷偷动了契约。
4.2 ★ 坑 ①:d_dyn 为 NULL,错误被吞
d_dyn 原先只由 vcuda_dev_decode_init / vcuda_dev_model_init 分配; vc_attn_step_dev 改成读设备标量后,只走 attn_init 的 q35_attn_check 就成了 cudaMemcpy(NULL, ...),错误被 cudaGetLastError() 吞掉 , 外面只看到光秃秃的 [attn] step 0 failed。
修 :vcuda_dev_attn_init 也按「NULL 守卫 + memset 0」分配 d_dyn, vc_attn_free 对称释放(三处 free 都带 NULL 守卫,destroy 顺序 decode → attn → mdl)。
坑 ① 的教训是错误可见性 :cudaGetLastError() 这种「取完即清」的写法和 「NULL 指针」叠在一起,会把「内存没分配」伪装成「算错了」。
4.3 ★ 坑 ②:捕获点在 step 里
捕获必须「空跑 + 真捕 」两遍(惰性分配与 cudaFuncSetAttribute 在捕获区内非法), 而 hybrid 的 GDN 是递推的------这两遍会真实推进 S/conv 历史。
放 step 里实测前向 18.39 ms/token (默认档 16.32)------多出来的正是两遍捕获的成本, 被摊进了前两个 token。
为什么「GDN 是递推的」让这件事特别危险 :稠密模型的两次空跑最多是浪费算力, 但 GDN 的 S_t 依赖 S_{t-1}、conv 有历史窗口------空跑会在状态里留下真实痕迹 。 如果捕获点在序列中间,那么捕获这一动作本身就会污染递推状态 , 后续 token 全都建立在一个被空跑推进过的 S/conv 上(而且是静默 的)。 这正是必须把捕获点放到序列起点的原因。
修 :搬到 vcuda_dev_model_reset(序列起点、decode 计时之外),捕完再复位 GDN/attn。 这样两遍捕获只影响序列开始前、且随后被显式复位 ⇒ 不进任何 token 的计时、也不留痕迹。
捕获函数就是「空跑一遍物化惰性缓冲 + 真捕一遍」,且属性必须在捕获区外设:
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu ------ 捕获一个 decode 步(节选)
 * 捕获必须「空跑 + 真捕」两遍(惰性分配与 cudaFuncSetAttribute 在捕获区内非法),
 * 而 GDN 是递推的 ------ 这两遍会真实推进 S/conv 历史,故调用方捕完必须复位状态。 */
static int vc_mdl_graph_capture(vc_dev_t *s, int pos) {
    if (!s->mdl_stream &&
        cudaStreamCreate(&s->mdl_stream) != cudaSuccess) { cudaGetLastError(); return -1; }
    if (cudaDeviceSynchronize() != cudaSuccess) { cudaGetLastError(); return -1; }
    {   /* ★ 大 smem 的属性必须在捕获**外**设(主体里 graph 档不再设) */
        const int hd = s->attn_hd;
        const size_t shbytes = ((size_t)s->attn_maxseq + 2 * hd) * 4;   /* 按 max_seq 定尺 */
        if (hd > 0 && shbytes > 48 * 1024)
            cudaFuncSetAttribute(k_attn_decode, cudaFuncAttributeMaxDynamicSharedMemorySize,
                                 (int)shbytes);
    }
    if (vc_model_step_body(s, pos, s->mdl_stream, 1) != 0) return -1;   /* 空跑:物化惰性缓冲 */
    if (cudaDeviceSynchronize() != cudaSuccess) { cudaGetLastError(); return -1; }
    if (cudaStreamBeginCapture(s->mdl_stream, cudaStreamCaptureModeThreadLocal) != cudaSuccess)
        return -1;
    if (vc_model_step_body(s, pos, s->mdl_stream, 1) != 0) {            /* 真捕 */
        cudaStreamEndCapture(s->mdl_stream, &s->mdl_graph);
        return -1;
    }
    cudaStreamEndCapture(s->mdl_stream, &s->mdl_graph);
    cudaGraphInstantiate(&s->mdl_gexec, s->mdl_graph, 0);
    s->mdl_graph_ready = 1;
    return 0;
}
五、数值零回归与口径边界
--test-q35-cuda --model <md> --q35-vqf <md>\model_q4.vqf --q35-ref <md>\_q4ref64:
| 档 | h(layers) maxrel | hfinal maxrel | logits maxrel | argmax | 贪心序列 |
|---|---|---|---|---|---|
| 流式(默认) | 2.2536e-06 | 2.0334e-06 | 3.3887e-06 | 5/5 | 148398 8442 198 198 198 |
graph(=1) |
2.2536e-06 | 2.0334e-06 | 3.3887e-06 | 5/5 | 148398 8442 198 198 198 |
| 归档 | 2.2536e-06 | 2.0334e-06 | 3.3887e-06 | 5/5 | 同上 |
tools\build\out\q35_gpu_model.exe <md> --vqf ... --ref ...\_q4ref64 --layers 64 --lib <dll>: 两档同样三项全等。
★ 口径(审计 MUST-2:先降级,后补测升回) :上表本身 只是「三项 maxrel 的打印值 + argmax + 贪心序列逐项相同 」,不是逐位(byte-level)证明 (TOKIDS 相同 不作为位级证明)。所以它不能单独支撑「graph 档位级一致」这句话。 补测已做完(见第十节):给工具加了
--dump,两档各写一份h64/hfinal/logits后逐字节比对, 三个文件 SHA256 完全相同 ⇒ 「graph 档 ↔ 流式档」现在是真·逐位。
这一节值得停一下。上表里 2.2536e-06 是打印精度 下的输出,两档在这一精度上同值, 不等于 底层 buffer 的字节相同。把「逐项相同」写成「位级一致」,就是「把推断写成实测」的 同类错误------只不过这次错在证据强度上。
当时的正确处理是先把口径降级、同时把补测排上 ,而不是就地宣称位级。补测用的是 --dump(纯工具侧 改动,引擎一行未改)------这一点也有讲究:验证手段不该改动被验证的对象。
六、同会话交错 A/B
收益的唯一有效口径 :同一 build、同一 DLL、交替 执行, q35_gpu_model --layers 64 的「计时:20 步」口径。
| 轮 | 流式 ms/token | graph ms/token |
|---|---|---|
| 1 | 15.996 | 14.050 |
| 2 | 15.975 | 14.030 |
| 3 | 16.485 | 14.823 |
| 4 | 15.810 | 13.817 |
| 5 | 15.656 | 13.799 |
| 6 | 15.741 | 13.876 |
| 均值(6 轮) | 15.944 | 14.066 |
⇒ 1.1335× ,省 1.878 ms/token。
组内离散:流式 15.656--16.485(5.3%)、graph 13.799--14.823(7.4%)。第 3 轮是唯一离群轮 (两个档同时偏高 ,符合环境扰动而不是档位差异)。上表是补测后的最终产物 (工具因 --dump / --maxseq 重建)上的 6 轮;补测前的 3 轮给的是 1.1384× / 1.940 ms, 工具侧的改动只加了两个新选项、计时循环与发射序列一字未动 ,两组相差 0.4%, 在该离散下不可区分。以最终产物这一组为准。
「交替执行 + 同 build + 同 DLL」这三条缺一不可:跨会话比会混进时钟/驱动状态, 不同 build 会混进编译器差异,而这正是第 26 篇反复强调的口径问题------ 1.44× 那次之所以要先做自证,就是因为它跨了会话。
辅证(n 太小,不作收益证据):
| 口径 | 流式 | graph |
|---|---|---|
--test-q35-cuda 5 token 前向 |
16.41 ms/token | 14.10 ms/token |
--stream-test(12 token) |
62.57 tok/s | 70.16 tok/s |
这两行方向一致但样本量太小 ,只能当「同向」的辅证, 不能当收益证据引用。
七、与天花板对账:归因分级
| 结论 | 等级 | 依据 |
|---|---|---|
| graph 档比流式档快 1.1335×(省 1.878 ms/token) | 实测 | 第 6 节同会话交错 A/B(6 轮) |
| 「拿回了第 2.2 节测得空档 2.761 ms 的 1.878/2.761 = 68.0%」 | 对账(跨会话/跨仪器比值) | 分子是本轮 A/B 实测,分母是第 2.2 节的 nsys span 口径,不是同一台仪器同一次测量 |
| 「剩下 ~32% 是 graph 消不掉的设备地板(第 2.4 节末段:2.53 µs/发射里的设备那部分 + 图节点开销)」 | 推断 | 无「device-only 空核」对照 ⇒ 分不开 |
★ 这一条是照「把推断写成实测」的前车之鉴 写死的: 1.878 是实测,2.761 是另一次测量,比值只能叫对账。
三行表里的等级是刻意分开的:
- 第一行是实测------两次运行同一会话、同一 build、交替执行,直接读出 1.1335×;
- 第二行是对账 ------分子(1.878)与分母(2.761)来自两次不同的测量 , 甚至是两种不同的仪器口径 (交错 A/B 的 wall vs nsys 的 span)。 这个比值有信息量(它说明 graph 消掉的量与空档量同量级),但它不是「拿回 68.0%」的实测;
- 第三行是推断 ------「剩下的是设备地板」这句话没有对照实验 (需要造一个「device-only 空核」 才能把主机侧与设备侧分开),所以它只是推断。
保守性说明(方向正确) :q35_gpu_model 的 lg 缓冲非空 ⇒ want_logits=1, 两档都 算了 lm_head;而 graph 档每步多了一次 cudaGraphLaunch 的固定开销。 若计时循环传 logits=NULL,graph 的收益只会更大 ⇒ 1.1335× 是下界。
这条保守性说明很重要:它意味着真实生产路径(不算 logits)下 graph 的收益只会更高 , 所以对外引用 1.1335× 是安全方向(宁小不大)。
八、零回归全项与产物
8.1 零回归(全项,均在最终 build 上重跑)
| 检查 | 结果 | 与归档 |
|---|---|---|
q35_attn_check(attn_l3) |
PASS,worst max_rel 4.697e-07 ;reset 后首 token 位级复现 0/5120 |
相同 |
q35_gdn_check(f32) |
PASS,worst max_rel 3.800e-07 ;0/5120、0/25600×2 逐位相同 |
相同 |
q35_rq_check(_gpu) |
maxae 1.431e-05 / maxrel 2.372e-06 / RMSrel 1.203e-06 ;0/17408 逐位相同 / PASS |
相同 |
三自检 --test-sparse / --test-l3 / --test-moe-ep |
rc 0 / 0 / 1 | 相同 |
Qwen3.5-27B --stream-test(VLLM_CUDA_Q35=1) |
词表 248077 / im_start=248045;两档输出文本逐字相同 ;流式 62.57 / graph 70.16 tok/s |
词表相同 |
Qwen3-VL-2B --stream-test(非 hybrid) |
Loaded 151669 / im_start=151644 / 34.54 tok/s;文本 逐层加载推理是一种在深度学习中,通过分 |
词表相同 |
注意到:q35_attn_check / q35_gdn_check / q35_rq_check 的 0/xxxx 是逐位 (element-level)相同的------这三个工具本来就有逐位口径。而第五节的端到端三项 没有 逐位口径,所以那边只能写「逐项相同」。两种口径的差别在本篇里同时存在, 不能混读。
另外,非 hybrid 的 Qwen3-VL-2B 也一起跑了:graph 接线不应该 影响稠密路径 (稠密路径是另一条 s->stream),这一条确认了「另一条路径没被牵连」。
8.2 产物(锚在被改的那个产物:内核 ⇒ DLL)
| 文件 | 大小 | 时间 | SHA256 |
|---|---|---|---|
build-x64\vllm_cuda.dll |
1,766,400 B | 14:24:36 | 51B743C301CA563AE4C913A10C8A44175B8DB4E03E4006BF30870E3EB60AB99C |
build-x64\vllm_kestrel_x64.exe |
1,570,047 B | 14:25:01 | 4EB2C69CB84486017BB21F33CC2A9475133B0F2DA79F41D70C8616AC38149353 |
DLL 由 1,761,280 → 1,766,400 B (+5,120 B,graph 捕获/重放代码 + k_attn_kv_append)。 exe 源码未动、尺寸仍 1,570,047 B;其 SHA 因整体重建而变 ≠ 「内容变了」。
⇒ 「SHA 变了」这个现象本身不是证据 :整体重建会让时间戳等元数据变, SHA 随之变,但源码未动这一条要靠尺寸与源码 diff 来确认,不能靠 SHA。
九、审计结论与落实
两条 MUST、四条 SHOULD 落实,另有归档项。
MUST(2 条,均已落实):
| # | 问题 | 落实 |
|---|---|---|
| MUST-1 | graph 重放绕过 attn_maxseq 边界守卫 ⇒ pos 越界时越界写/读 KV。vc_attn_step_dev 里的 len >= attn_maxseq 是 C 代码 ,只在捕获那一次执行;准入处只判了 attn_len == pos |
准入处补 pos >= s->attn_maxseq → 本步退回流式。退回流式后仍走那条既有判据 ,行为与引入之前完全一致 |
| MUST-2 | 「graph 档与流式档逐位相同」证据不足(只有 maxrel 打印值 + argmax + 序列;TOKIDS 不作位级证明) | 两步走:① 先把口径降级 为「三项 maxrel / argmax / 贪心序列逐项相同(非逐位) 」;② 再补元素级 memcmp 把它升回逐位(第十节-1) |
MUST-1 是真问题 :len >= attn_maxseq 那条边界检查是普通 C 代码 , 它只在捕获那一次 执行(捕获时真的跑了一遍 body),一旦捕成了图, replay 就不再执行 这段 C 代码。于是「越界保护」在 graph 档里凭空消失 。 修法是把保护复制到准入处 (pos >= s->attn_maxseq ⇒ 该步干脆退回流式), 退回流式后走的还是原来那条判据 ⇒ 与引入前逐行为一致。
这条「准入处补守卫」在源码里就是 graph 分支入口那一小段:
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu ------ graph 准入判定(节选)
 * ★ 审计 MUST-1:`vc_attn_step_dev` 里的 `len >= attn_maxseq` 是**C 代码**,
 *   只在捕获那一次执行 ⇒ 图重放**不会**再判它。所以必须在**准入处**先堵住。 */
s->mdl_graph_mode = vc_mdl_graph_env();
int graph = s->mdl_graph_mode;
if (graph && s->mdl_skip) { ...; graph = 0; }            /* 诊断档与 graph 不兼容 */
if (graph && s->attn_len) {                              /* 冗余复核:游标 == pos */
    for (int L = 0; L < nl; L++)
        if (s->mdl_type[L] && s->mdl_aidx[L] >= 0 && s->attn_len[s->mdl_aidx[L]] != pos)
            return -1;
}
if (graph && s->attn_len && pos >= s->attn_maxseq) {     /* ★ MUST-1:越界则退回流式 */
    vc_vlog(s, "[CUDA] model: graph 档 pos(%d) 已达 attn_maxseq(%d),本步退回流式\n",
            pos, s->attn_maxseq);
    graph = 0;
}
if (graph && !s->mdl_graph_ready) { ...; graph = 0; }    /* 没就绪就不猜、不静默 */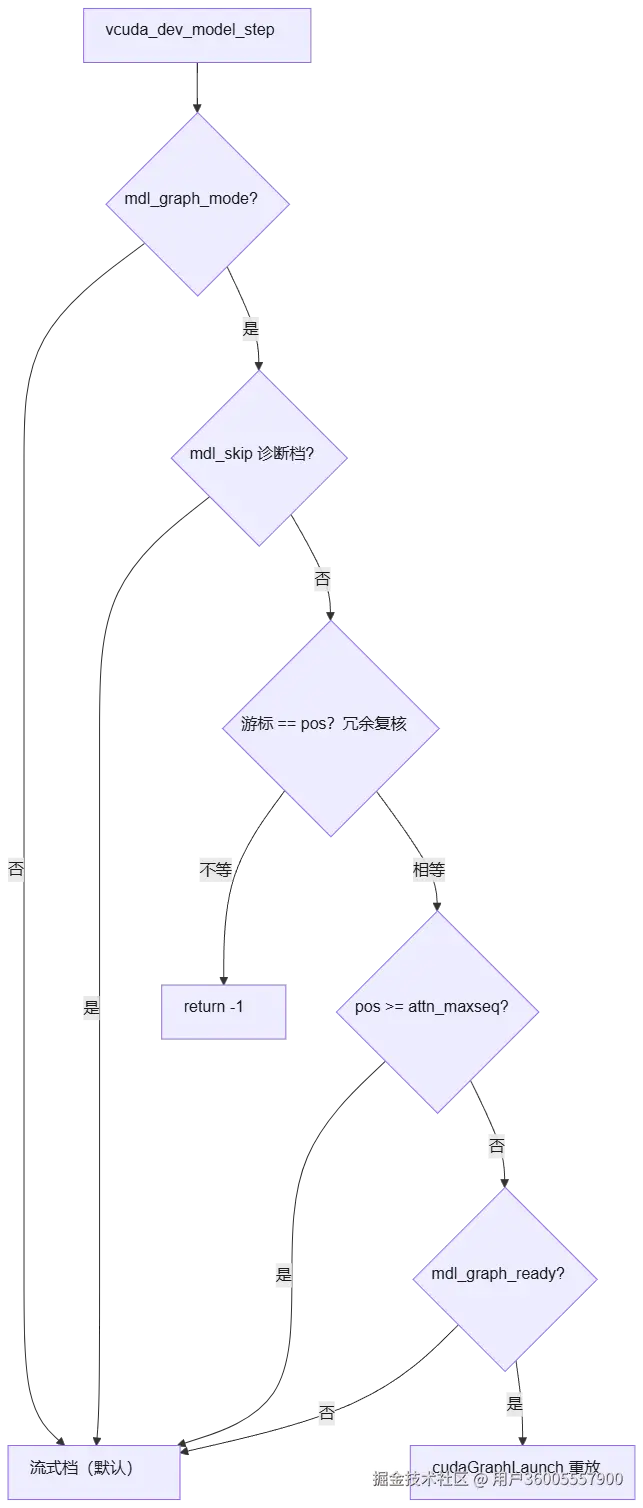
图 1 :CUDA Graph 的 capture/replay 准入判定(审计 MUST-1)。graph 档下
vc_attn_step_dev里的len >= attn_maxseq是普通 C 代码、只在捕获那一次 执行 ⇒ 重放不再判它,所以必须在准入处先堵:pos >= attn_maxseq时本步退回流式 (走的仍是引入前那条判据,逐行为一致)。读法:四条前置检查(诊断档不兼容 / 游标==pos 冗余复核 / 越界 / 图就绪)任一不满足即退回流式;这是 M=1 的 decode 路径 (默认化见第 40 篇)。背景数字:nsys 量出发射空档 2.761 ms/token(16.87%) 、1090 次发射/token ⇒ 2.53 µs/次,是本候选的天花板;落地后同会话交错 A/B 1.1335× 、省 1.878 ms/token ,两档h64/hfinal/logits经元素级 memcmp 逐字节相同。
MUST-2 是口径问题,不是代码问题 ------它抓的不是代码错,而是「我的说法比证据所能支撑的更强」。 处理方式也因此分两步:先降级说法 (不能一边说位级、一边只有打印值), 再补证据(做 memcmp 把它升回去)。见第十节-1。
SHOULD(已落实 4 条):
| # | 问题 | 落实 |
|---|---|---|
| SHOULD-1 | 交接稿误称「流式档无游标守卫」------实为公共预检(在 graph 分支之前)对两档都强制 | 代码注释订正:graph 分支里的同名检查是冗余复核 |
| SHOULD-2 | vcuda_dev_decode_init 的 d_dyn 是无 NULL 守卫 的 cudaMalloc;vc_attn_free 会释放共享标量 ⇒ 将来「同实例混用/重入」会释放在用缓冲 |
给 decode_init 补 if (!s->d_dyn) 守卫,三个 owner 同法 |
| SHOULD-3 | 捕获失败重试时 vc_mdl_graph_capture 每次 cudaStreamCreate,而 vc_mdl_graph_release 不管流 ⇒ 句柄泄漏 |
改为 if (!s->mdl_stream) 守卫 |
| SHOULD-5 | 安全关键下标注释与实现相悖(3 处仍写 d_dyn[0],实现读 dyn[1]) |
3 处注释全部订正 |
SHOULD-5 是第 4.1 节那个坑留在注释里的残影:语义改成「[0]=RoPE、[1]=KV 行号」后, 有 3 处注释还写着 d_dyn[0]。这类注释本身不产生 bug ,但它会误导下一个读代码的人, 而这里读错的代价是「静默错」------所以订正它不是洁癖。
SHOULD(记入本节即视为归档,未改代码) :SHOULD-4(归因分级,见第七节)、 SHOULD-6(「默认关 = 引入前逐位同路径」依赖那条公共预检守卫 ,非无条件)、 SHOULD-7(未单独出 PRE_REG 预告;本轮判据源 = 第 2.4 节先于本轮给出的 2.761 ms / 16.87%)。 未留痕 :OMP_NUM_THREADS / VLLM_THREADS / banner compute_threads(GPU 侧 A/B 对此不敏感)。
SHOULD-6 值得单独说一句:「默认关 ⇒ 默认档与引入前逐位同路径」不是无条件的------ 它依赖那条公共预检守卫。把「默认关」说成「零影响」时,要带上这个前提。
审计 OK 项 (已独立复核):调用点闭合(vcuda_dev_attn_step 全仓只有 tools/q35_attn_check.c 在用;src/ 下无 L3/prefill/预热/serve 调用); 三个 attn 内核唯一发射点;产物哈希复算逐字相同;A/B 口径合规;与第 2 节数值对账一致。
十、收口:两处「欠账」的补测 + 下一项的 M7 门禁
写到这里,还剩两条自己给自己开的欠账 。它们都不是新的优化,而是 「已修 ≠ 已验证」那类缺口------所以优先补掉。
两条都在工具侧 解决:tools/q35_gpu_model.c 加了三个新东西,引擎一行未改 。 这不只是图省事:验证手段不该改动被验证的对象,否则「测出来的」和「修完的」就不是同一个东西了。
| 新选项 | 作用 | 为什么需要 |
|---|---|---|
--dump <dir> |
把对拍那一段前向的 hout/hfinal/logits 按与参考目录同名同格式写出 |
让「两个档之间」的逐字节比对可做 |
--maxseq N |
覆盖传给 vllm_cuda_attn_init 的 max_seq(默认 1024) |
让「pos 越过 attn_maxseq」这条边界可达 |
(配套)iters 上限解耦 |
由 if (iters > maxseq) 改为固定 1024 |
否则 t 永远到不了 maxseq,边界又不可达;默认档行为不变 |
10.1 欠账 ①:graph 档 vs 流式档的元素级 memcmp(MUST-2 升回逐位)
css
q35_gpu_model <md> --vqf <md>\model_q4.vqf --ref <md>\_q4ref64 --layers 64 \
                 --lib build-x64\vllm_cuda.dll --dump <A>     # 流式
(同一条命令 + VLLM_CUDA_Q35_GRAPH=1 写 <B>) # graph| 文件 | 字节 | 元素数 | SHA256(前缀) | 结论 |
|---|---|---|---|---|
h64.bin |
102,400 | 25,600 | 66494E87ED85BCE9... |
两档逐字节相同 |
hfinal.bin |
102,400 | 25,600 | 0D0399A237AB138D... |
两档逐字节相同 |
logits.bin |
4,966,400 | 1,241,600 | 650F29AF2DD13685... |
两档逐字节相同 |
⇒ 「graph 档 ↔ 流式档」现在是真·逐位 :64 层逐层 hidden(25600 个 f32)、 final norm 之后的 hidden、以及 5×248320 的完整 logits,一个字节都不差。
这正是第五节那段口径该有的收尾:先承认证据不够,再去把证据做够 。 (也印证了当时的判断:graph 档不引入新的浮点运算,理论上应当逐位相同------但「理论上」不算证据。)
边界 :这只覆盖同一台设备上的两条发射路径 ,不等于 「与 CPU 位级一致」。 后者需要 L2EXACT 那种 opt-in 位级档,而 hybrid 的算子族(递推 + conv + 双 RMSNorm) 要逐字复刻 CPU 的归约序,成本远高于收益------这是一条有意不做的边界。
10.2 欠账 ②:attn_maxseq 边界(MUST-1 从「静态可审」升到「实测」)
引擎里 attn_maxseq 由 cfg.max_seq_len(模型 262144)夹到 4096 ,而所有既有 vehicle 都够不到这个边界------这正是 MUST-1 只剩静态审阅的原因。解法是把边界搬近 : --maxseq 8 让 attn_maxseq 变成 8,再让 --iters 越过去。
--maxseq |
--iters |
流式 | graph | 流式总耗时 | graph 总耗时 |
|---|---|---|---|---|---|
| 8 | 8(对照,pos ≤ 7) | 跑完 rc=0 |
跑完 rc=0 |
126.55 ms(8 步) | 111.70 ms(8 步) |
| 8 | 20 | 停在 t=8,rc=1 |
停在 t=8,rc=1 |
127.13 ms(8 步) | 112.05 ms(8 步) |
| 9 | 20 | 停在 t=9,rc=1 |
停在 t=9,rc=1 |
143.31 ms(9 步) | 126.91 ms(9 步) |
三条证据:
- 停止点由
maxseq决定 :maxseq=8停在第 8 步、maxseq=9停在第 9 步 (总耗时 ÷ 单步耗时正好给出 8 / 9 步)。这是判别性的------排除了「因为别的什么恰好挂了」。 - graph 档的守卫确实触发 :stderr 打出
[CUDA] model: graph 档 pos(8) 已达 attn_maxseq(8),本步退回流式⇒ MUST-1 新加的那一行退化代码真的在跑。 - 两档行为一致 :同一
maxseq下停止步、rc、耗时形态都对得上 ⇒ 补的守卫只是把 「越界」换回既有的拒绝路径,没有引入新行为(这正是修它的初衷)。
仍然没有覆盖的 :「真实 4096 边界」的完整生成(需要 4096 步端到端,现有 vehicle 做不到------ --stream-test --stream-n 4200 实测在 64 token 就停)。本测的意义是 边界逻辑本身被驱动过了,而不是只被读过。
10.3 仍未做
- graph 未接 prefill /
VLLM_Q35_FWD_TEST路径(vc_model_step_body是 step 专用)。 ★ 订正(后续):该项作废 ------ CUDA 路径的「prefill」就是逐 token 循环同一个model_step, 早已被 graph 覆盖;且VLLM_CUDA_Q35_GRAPH自后续起默认开 (见 第 40 篇)。 mdl_stream与s->stream(稠密路径)是两条独立的非默认流;两套不会同时用 , 但d_dyn是共享的 ------ 这个耦合在 SHOULD-2 的守卫下是安全的,长期应收敛到单一 owner。- 与 CPU 的位级一致(见第 10.1 节末尾的边界说明,有意不做)。
第 10.3-2 是一条架构隐患 (不是 bug):d_dyn 是多 owner 的 (decode / attn / mdl 三处都可能分配),当前靠 NULL 守卫 + 顺序释放保证安全, 但这是耦合 不是设计,长期应收敛到单一 owner。
10.4 顺着往下走:融小核的 M7 门禁 ------ 判否
落地后,「下一个候选」是排在第二的 融小核 : 把每层的 4 个小核并成 1 个(小核共 256 次/token ,融合后 64 次,省 192 次 )。 它的旧天花板写的是 ≤ 0.49 ms/token(2.9%)。
但这个数字的前提已经被本篇改掉了。 0.49 ms 的算法是「192 × 2.53 µs 」, 而那个 2.53 µs 是 stream 档 每次发射的空档(第 2.2 节:idle 2.761 ms / 1090 次)。 graph 档下这 192 次发射变成了 192 个图节点 ,要付的是节点成本 ,不是「主机侧发射 + 设备地板」。 ⇒ 旧天花板作废,必须在 graph 档下重量(这也正是 M7 纪律:动手前先量形状级收益)。
新探针 tools/q35_smallk_shape.cu(引擎一行未改 ),8 个形状逐行抄自 vc_gdn_step_dev / vc_attn_step_dev 的真实 grid/block。三个臂只改节点数:
| 臂 | 含义 | 节点数 | stream µs/token | graph µs/token |
|---|---|---|---|---|
| A sep | 引擎真实序列(48×4 + 16×4) | 256 | 1344.8 / 1358.2 / 1373.5 | 199.2 / 200.7 / 207.2 |
| B fuse | 每层 1 个 | 64 | 335.2 / 340.7 / 351.3 | 52.4 / 52.6 / 53.0 |
| C one | 全 token 1 个(不可实现的下限) | 1 | 6.3 / 6.4 / 6.5 | 6.4 / 6.9 / 7.2 |
(三次独立运行。另有一条纯节点成本轴:N ≥ 16 后收敛到 ≈775--800 ns/节点。)
| 结论 | 值 |
|---|---|
| graph 档 A−B(省 192 节点) | ≈ 149.7 µs/token(三次:146.1 / 148.2 / 154.8) |
| ⇒ 端到端 | 14.066 → ~13.916 ms/token = 1.011× |
| M7 形状级门禁 | A/B ≈ 3.95×、A/C ≈ 31× ⇒ 通过(门槛 1.20×) |
| 性价比判据 | 端到端 1.011% ,要重写 8 个内核 ⇒ 不划算,暂缓 |
| 旧天花板 | 实测只有它的 0.31× ⇒ 作废 |
★ 口径订正 :本节初稿把「端到端 1.011× < 1.20×」写成 M7 门禁不通过 ------这是错的 。 M7 是形状级 判据(
基线/纯读地板 ≥ 1.20×),不是端到端 ; 按形状级算它通过 。真正的否决理由是性价比 :为 1.1% 改写 8 个内核。 M7 只回答「形状级有没有空间」,不回答「这一刀值不值得动 8 个内核」。 这个区分在下一节里立刻用上了------两者的 M7 都通过,但价值差 10 倍。
即使按最乐观的假设计算也不达标 :把 256 个小核连算术一起 免掉, 上限 = A−C(0.20 ms,实测)+ 小核算术(第 2.1 节合计 ≈0.38 ms) = 0.58 ms ⇒ 1.043× ,仍远低于 1.20×。⇒ 判否是稳健的。
这一节最值得记的不是结论,是口径 :同一个问题「省 192 次发射值多少」, stream 档下 ≈1.03 ms、graph 档下 ≈0.150 ms,差 3.3 倍。 旧口径 0.49 ms 既不是前者的实测、 也不是后者的实测,而是「全轨迹平均空档 × 192」凑出来的中间值。 一个数字从哪一种测量里来,决定了它能用在哪种决策上------这与第 26 篇三版量空档 是同一条教训的第二次出现。
顺带说明:这一轮没有重建引擎 (vllm_cuda.dll / vllm_kestrel_x64.exe 哈希不变), 所以门禁无需重跑------因为没有说话对象被改。
10.5 再往下:小投影 fusion ------ 过门禁,列为落地候选(≈1.10×)
因为融小核的账被证明只有 1.1%,目光转向真正的那个大头 : 微基准早已量出投影的 cold(逐份发射)比 bulk(同字节合成一次)低 24% ,第 2.1 节的实测是投影 401 次 / 11.851 ms = 84% 的核时 。缺口折算 ≈2.9 ms。
但机制一直没定 :这 24% 是主机侧发射成本 (那 graph 应该已经吃掉大半), 还是设备侧每发一次都要付的爬坡/收尾 (graph 吃不掉)?------这个判别必须先做, 否则就会像融小核那样照着错误的档位算账。
给 q35_q4_gpu 加一个 --gran :总字节固定,只改「拆成几次发射」 , 而且每个配置同时测 stream 与 graph 两档。三个可合并组,逐组量(RTX 5090,iters=10):
| 组 | 每次 MiB | 发射次数 | stream GB/s | graph GB/s |
|---|---|---|---|---|
| mlp gate+up(5.98 GiB) | 47.81 → 95.62 | 128 → 64 | 1198.8 → 1378.6 | 1251.1 → 1417.7 |
| gdn in_qkv+in_z(2.11 GiB) | 22.50 → 45.00 | 96 → 48 | 929.4 → 1190.1 | 994.8 → 1239.6 |
| attn q+k+v(0.62 GiB) | 13.14 → 39.38 | 48 → 16 | 896.0 → 1264.6 | 1091.1 → 1415.2 |
结论一(判别) :graph 只把这部分抬 4.4%(1198.8 → 1251.1), 而「两份合成一次」能抬 15.0%(→ 1378.6)。 ⇒ 这 24% 缺口主要是设备侧的发射粒度 ,CUDA Graph 吃不掉它 。 ⇒ CUDA Graph 与小投影 fusion 不是同一笔账的两种算法,而是两个正交的机制 : graph 消主机侧 发射成本,合并消设备侧每发一次的爬坡/收尾。
结论二(账) :三组合计字节 9.36 GB(占投影 68%),发射 401 → 257:
| 档 | 省 | 落地后 | 倍率 |
|---|---|---|---|
| 默认(stream) | ≈1.45 ms/token | 15.944 → ≈14.49 ms | ≈1.100× |
| graph | ≈1.19 ms/token | 14.066 → ≈12.87 ms | ≈1.093× |
结论三(判定) :形状级 M7 = 1.34× / 1.72× / ~1.76× ,全部通过 ; 端到端 ≈1.10× ,是融小核的 10 倍 ⇒ 列为落地候选。
口径 :表里的 GB/s 与「graph 只高 4.4%」是实测 ; 「省 1.45 ms」是实测带宽 × 合并形态的模型 (真实融合是「2--3 个不同权重、同一个 x 的一发」, 设备侧工作量等价);「端到端 1.100×」是外推 ,未落地、未过零回归/位级门禁。
10.6 小投影融合落地:1.1062×(stream)/ 1.0892×(graph),且逐字节相同
门禁过了就落地。改动只有一处、一个文件:新增融合内核 k_rq_q4_gemv3 (把「同一个 x」的 2--3 个投影并成一次发射),接到三个点:
| 组 | 之前 | 之后 |
|---|---|---|
MLP gate + up (同吃 d_mdl_nrm) |
128 次 | 64 次 |
GDN in_qkv + in_z (同吃 d_h) |
96 次 | 48 次 |
attn q + k + v (同吃 d_h) |
48 次 | 16 次 |
| 合计 | 401 次 | 257 次 |
融合的维度只有「输出行 / 权重指针选择」 :warp 号落在哪一段就用哪对 (W,y), 并把 warp 号折成段内行号。行内算式一字未改 ------ 所以理论上是位级安全的:
c
/* 文件名:src/npu/cuda/q4_gemv_twin.inc ------ 把同一个 x 的 2--3 个投影并成一次发射。
 * 合并的只有「输出行」这一维:全局 warp 号落在 [0,r0)/[r0,r0+r1)/[r0+r1,...) 哪一段,
 * 就取哪一对 (W,y),并把 warp 折成段内行号;★ 下面从 `const int lane` 起与单输出版逐字相同。 */
__global__ void k_rq_q4_gemv3(const uint8_t *__restrict W0,
                              const uint8_t *__restrict W1,
                              const uint8_t *__restrict W2,
                              const float   *__restrict x,
                              float *__restrict y0, float *__restrict y1, float *__restrict y2,
                              int r0, int r1, int r2, int cols) {
    int warp = (int)((blockIdx.x * blockDim.x + threadIdx.x) >> 5);
    const int r01 = r0 + r1;
    if (warp >= r01 + r2) return;
    const uint8_t *W; float *y;
    if (warp < r0)        { W = W0; y = y0; }
    else if (warp < r01)  { W = W1; y = y1; warp -= r0; }   /* 折成段内行号 */
    else                  { W = W2; y = y2; warp -= r01; }
    /* ---- 以下与 k_rq_q4_gemv_f32act 的 `lane` 起逐字相同 ---- */
    const int lane = (int)(threadIdx.x & 31u);
    const int m   = warp & 3;                     /* row inside the 4-row tile */
    const int grp = warp >> 2;
    ...
    if (lane == 0) y[warp] = acc;
}
它确实是位级安全的 (memcmp,不是 TOKIDS):两个 DLL 各 --dump 一次, h64.bin / hfinal.bin / logits.bin SHA256 完全相同 (66494E87... / 0D0399A2... / 650F29AF...,与本篇归档一致)。
同源 A/B (同一份源码,只差一个 -D,同会话交错 3 轮):
| 档 | base(逐发射) | fuse(融合) | 倍率 | 省 |
|---|---|---|---|---|
| 默认 stream | 15.928 ms/token | 14.400 | 1.1062× | 1.529 ms |
| graph | 14.033 ms/token | 12.884 | 1.0892× | 1.149 ms |
与第 10.5 节门禁的预测对账 :预测 stream ≈1.100×(省 1.45 ms)、graph ≈1.093×(省 1.19 ms); 实测 1.1062×(1.529 ms)/ 1.0892×(1.149 ms)⇒ 省下量差 +5% / −3% 。 一条 --gran 命令把端到端收益预测到了 ±5% 以内 ------ 这就是先做 M7 门禁的价值。
零回归全项通过:--test-q35-cuda 两档三项 maxrel/argmax/序列与归档逐项相同、 q35_{attn,gdn,rq}_check 全 PASS、三自检 0/0/1、--stream-test 68.20 tok/s(改前 62.57)。
归因仍标「推断」 :「省下的量主要来自设备侧发射粒度」是第 10.5 节探针(graph 只抬 4.4%) 加上 引擎 graph 档仍提速 8.9% 推出来的;引擎侧最强的直接证据是 「graph 档下融合仍省 1.149 ms」,不是「实测就是设备侧」。
顺带记一个新坑 :文本编辑工具会给已有 BOM 的文件再叠一个 BOM 。 q35_q4_gpu.cu 被叠成 x2(nvcc 报 line 1: expected a declaration), 更早的 vllm_cuda_kernels.cu 被叠成 x3 却一路编过了 ⇒ 这个坑是静默的 。 已经把它写成构建前断言 :build_x64.ps1 在调 nvcc 前扫 src/npu/cuda/*.cu|inc, 发现连续两个 EF BB BF 就 exit 1(并做了负向测试:故意叠一个 BOM,构建立即被拦)。
10.7 把「整合级证据」补到「内核级」:抽出唯一一份源
第 10.6 节的位级结论有个说不出口的地方:它是整合级 的 ------ 两个 DLL 各跑完 64 层、 三个文件逐字节相同。这当然强,但它证明的是「整条链路没变」, 证不到 「那个融合内核在边界形状 上没变」。而边界恰恰是融合最可能写错的地方: r1/r2 == 0(某一段不存在)、cols % 256 != 0(尾块分支)------ 这两条在真实模型里 全是死代码 ,永远跑不到 ⇒ 整模型对拍也永远测不到它们。
① 内核抽成「唯一一份源」 。新增 src/npu/cuda/q4_gemv_twin.inc, 把 d_f16_to_f32 / rq_coef / k_rq_q4_gemv_f32act / k_rq_q4_gemv3 四样逐字 搬进去, 引擎和工具两边 #include 同一个文件。这不只是为了整洁 ------ 它消掉的是一个具体的 失败模式:「改了引擎忘了改工具 ⇒ 直测对着旧内核出结论」。 顺带把记了很久的「两份独立拷贝」那笔债还了, VC_RQ_TILE_BYTES 也从两份变一份。
② 直测用「三种证据」,各自标清强度:
| 证据 | 对手 | 判据 | 强度 |
|---|---|---|---|
| ① | 单输出现役内核(逐段发射) | memcmp 逐字节 |
位级 |
| ② | 宿主 CPU 标量参考 | maxrel |
容差 |
| ③ | 权重 / 激活 | 合成 LCG,x 逐元素不同 | ------ |
两个容易写错的点:
- ② 不可能是位级 。GPU 是 warp 树归约、CPU 是顺序累加,求和序不同 。 同理,工具里那份旧实现(v4,
(a0+a1)+(a2+a3))也不同序 ------ 拿它当位级对手是错的,它只能给容差。 - x 不能用常数 。常数 x 会把「两列写反」这类映射错掩盖掉: 两个 lane 交换了列,只要 x 处处相同,结果一模一样。必须逐元素不同。
③ 9 个形状,其中 4 个是合成的死代码:
| # | (r0,r1,r2) / cols | 覆盖 |
|---|---|---|
| 1--3 | 三输出 / 两输出 ×2 | 真实模型的两种形态 |
| 4 | (17408, 0, 17408) | 中段为空 r1==0(r01 分支) |
| 5 | (0, 1024, 1024) | 首段为空 r0==0(引擎不可达,合成) |
| 6 | (5120, 1024, 1024) / 5184 | 尾块 cols%256!=0(nb=162 ⇒ 余 2) |
| 7 | (64, 32, 32) / 32 | 纯尾块(主循环一次都不跑) |
| 8 | (1020, 4, 0) | 单输出核早退 rows%8!=0 |
| 9 | (1020, 4, 4) | 融合核早退 tot%8!=0(tot=1028) |
⇒ 9/9 memcmp 逐字节相同 ,容差 1.3e-07 -- 3.0e-06。
④ 但「跑了」不等于「覆盖到了」------ 这是本轮审计抓到的 。 第一版形状表里我写了一项 rows%8=4 early-exit (1020, 4, 0),注释写的是「warp >= tot 早退」。 审计指出:tot = 1020+4+0 = 1024,而 1024 % 8 == 0 ⇒ grid 正好 128 块 × 8 warp = 1024 个 warp,融合核的早退一次都没跑 ; 它只触发了单输出核 那一发。可 tot 是融合核才有的量 ------ 标签指的是融合核,实际覆盖的是另一个核 。补一个 (1020, 4, 4)(tot=1028)才算真覆盖。
这条比它看起来重要:形状表本身就是一种「结论」 , 而它和别的结论一样会名实不符 。写形状表时要问的不是「我跑了个边角形状吗」, 而是「这个形状具体让哪一行代码执行、哪一行不执行」。
⑤ 顺手收了一条纪律:BOM 断言补「缺失」方向 。 改 vllm_cuda_kernels.cu 时编辑工具把文件首部的 BOM 吃掉了,报错却是 6000 行以外 的一句 error: missing closing quote(cl.exe 改按 cp936 解码, 中文串的尾字节跟引号配对)。原先的构建前断言只挡「叠加」这一半。 现在两半都挡(「恰好一个 BOM」),并给 build_cuda_tool.ps1 也装了一个 ------ 因为 tools/*.cu 里有非 ASCII 字面量,而 build_x64.ps1 的循环只扫 src/npu/cuda。
真正值得注意的是:它不是每次都吃 。同一轮里 3 个被编辑的文件,2 个被吃、1 个没事 ⇒ 这种事没法靠「多注意」避开,只能靠断言。
10.8 下一站 MTP 投机:先撞上一堵墙,再量出一个数
阶段五支线清空后只剩 MTP ------ 把模型自带的 MTP 头接进投机解码。开工前先做了一次只读侦察, 结论有点出人意料:
① 这不是「接线」活,是「先造底座」活。 MTP 那一侧其实已经齐了 :q35_mtp_step 前向完整、模块级对拍 PASS(本轮重跑:11 级 × 5 token 全 OK)、权重已经在 .vqf 里 并被引擎挂载。真正缺的是主模型侧:
hybrid 设备路径是纯 M=1(单 token)的,没有任何 M>1 的批量前向。 GDN 递推是严格逐 token 的顺序式(没有 chunk / parallel scan),full-attn 只支持 单行 KV append,GDN 状态只有
reset没有分支克隆。引擎里已有的批量能力 全属于稠密/MoE 路径 ------vcuda_dev_spec_verify甚至硬拒非 MoE。
② 为什么「批量」是生死线 (算术,不是实测): 投机一轮产出 1/(1-α) 个 token。
- 批量 verify :成本 ≈
c_m + k·c_d⇒ α=0.6、k=3 时约 2.0×; - 顺序 verify :成本 ≈
(k+1)·c_m + k·c_d⇒ 24.4 ms/token,比基线 14.4 还慢 1.7×。
⇒ 顺序 verify 不是收益小,是净亏。收益的门槛不在「α 够不够高」,而在 「批量前向存不存在」。
③ 顺带一个容易漏的大头 :草稿成本 c_d 里,lm_head(682 MB/次草稿)比整个 MTP 层(229 MB)还大 3 倍 。漏了它会把 c_d 低估 4 倍。
④ 那就先把唯一能一票否决的量掉:接受率(G1)。 新增 tools/q35_mtp_accept.c ------ MTP 权重 / embed 表 / lm_head 全部从 .vqf 读 (与引擎同一份量化 权重,不用 f32 原件那种乐观口径),主模型 hidden 用引擎 --dump 的 hfinal.bin,判据链一断就停 (部署口径)。引擎一个字节未改。
实测(一段真实中文文本,169 个位置,k=4):
| 深度 j | 活到本层 | α_j(条件) |
|---|---|---|
| 1 | 169/169 = 100.0% | 0.657 |
| 2 | 111/169 = 65.7% | 0.450 |
| 3 | 49/169 = 29.0% | 0.388 |
| 4 | 19/169 = 11.2% | 0.368 |
⇒ E接受长度 = 2.107 token/轮 (每轮实际只发 2.06 个草稿)。 按前述 c_d 折算 ⇒ 1.7--1.9× 的量级 ------ 比阶段五支线任何单刀 (最大 1.148×)都大一个档。
★ 这里有个自查纠正值得记:第一版我把无条件 接受率直接相加(
1 + Σα_j= 2.31), 那是上界 ------ 它忽略了合取(d1 错的时候,d2 在部署里根本不会发出)。 改成「链一断就停」后条件 α_j 在 0.37--0.45 走平 ,E[len]落到 2.107。 同一批数据,两个口径给出 2.31 vs 2.11,而只有后者能拿去算收益。
⑤ 所以现在的状态是 :G1 ✅ 通过;G2(批量前向做不做得到)未做 ------ 它是 MTP 批量化开工条件,也是这条路上真正的工程量所在(GDN 要改成 chunked scan, 动的是位级)。
10.9 G2:一条 20 分钟的探针,砍掉了一个 0.6× 的乐观估计
G1 过了(α₁ = 65.7%),但第 10.8 节里那张收益表(1.8× 量级)藏着一个没量过的假设 : 把「一次前向验 k+1 个位置」的成本,当成了「一次单 token 前向」。 按老规矩 ------ 动手之前先把这条假设量掉。
新增 tools/q35_batch_shape.cu:M=1 直接用引擎那一份源(q4_gemv_twin.inc), M=4 是「同样 1 warp 一行、内层多一层 m 循环」,再加一条地板 (同样 M× 的 MAC,但 x 只读一遍,输出故意错)。冷档工作集 ≫ L2。
| 口径 | t(M=4)/t(M=1)(3 次) |
投影侧每 token |
|---|---|---|
| 朴素批量 | 1.761 / 1.776 / 1.755 | 2.27× |
| 地板(x 载入不随 M 放大) | 1.144 / 1.146 / 1.155 | 3.50× |
且 M=4 的批量版与引擎 M=1 版逐字节相同(8/8 形状 bit-exact)。
两个发现:
- 「M=4 ≈ 单 token 成本」不成立。 M=1 时只跑到 1146 GB/s (峰值 1792 的 64%) ⇒ 这个内核族本来就不是访存受限,所以 M× 的 MAC 立刻吃掉余量 ------ 即使到地板也要 1.16×。
- 缺口几乎全在「M 倍的 x 载入」 :x 在「1 warp 一行」的映射下被每个 warp 各读一遍, M=4 又把这份冗余乘了 4。把它按住(地板),比值从 1.78 掉到 1.16 。 ⇒ 要接近地板,必须让 x 复用(smem 暂存 / 跨行共享寄存器)------这是内核工程,不是换算法。
于是收益订正:
| 批量投影的实现水平 | verify | 每轮成本 | ms/token | 提速 |
|---|---|---|---|---|
| 第 10.8 节的隐含假设(比值 1.0) | 15.68 ms | 17.95 ms | 8.52 | |
| 地板(x 载入不随 M 放大) | 17.78 ms | 20.05 ms | 9.52 | 1.51× |
| 朴素批量(本轮实测) | 26.30 ms | 28.57 ms | 13.56 | 1.06× |
⇒ MTP 的预期从「1.7--1.9×」订正为 「1.06× ~ 1.51×」,而那个 1.51× 还得靠内核工程去挣。
这条比数字本身重要:便宜的门禁拦住了一个贵的方向 。MTP 批量化要动 GDN 的位级 (M 维批量化 / 分支克隆);若按 1.8× 的预期开工、最后只拿到 1.06×,那才是浪费。 现在开工前就知道:「能不能拿到 1.5×」取决于 x 复用那一刀能不能成。
审计又在这条探针上抓到两处,都已订正:
① GDN 那一项不能按带宽折 。递推是时间轴上强串行的 (早说过:395 GB/s、 128 深串行加链),引擎用的是 k_gdn_delta_reg,实测 8.839 µs/层 ⇒ M=4 是 4 步串行 (+1.27 ms),而不是按流量折的 0.60 ms。上限因此 1.55× → 1.51×。
② 「让 x 复用」这一刀,撞上了一条已退役负结果的动机 。q4_gemv_twin.inc 里记着: 「一个 warp 处理 4 行」动机正是「让 x 只加载一次」 ,试过、回退了 (更慢)。 ⇒ 但两件事的分界很清楚:那条负结果削了并行度 (4 行/1 warp ⇒ warp 数 1/4); 这次的方向是保持 1 warp/行不变 、只在同一个 block 的 8 个 warp 之间共享 x(smem)。 不是同一刀,但必须先单独量过才能立项 ------ 这正是「不要重做已退役的一刀」这条纪律的用法: 不是禁止,而是要求你说清这次为什么不一样。
10.10 那把「已退役的刀」,换个参数就是正收益
第 10.9 节最后留了个尾巴:缺口在「M 倍的 x 载入」,而「让 x 复用」这件事撞上了一条退役记录 ------ q4_gemv_twin.inc 里写着「一个 warp 处理 4 行」动机正是让 x 只加载一次 , 试过、回退了。审计要求:要么说清这次为什么不一样,要么别提。
先说为什么不是 smem :缺口是指令发射数 ,不是 DRAM 字节 (x 每 token 只 80 KB,是权重的 0.17%)。把 x 搬进 smem 只是把「gmem 载入」换成 「smem 载入 + 分级载入」⇒ 指令数不降反升 。杠杆不在「少读几遍」,在 让同一份 x 服务更多行:
| 每 lane 每 8 列块迭代的指令 | MAC | 指令/MAC | |
|---|---|---|---|
| R=1, M=1(引擎现役) | 2(W) + 2(x) = 4 | 8 | 0.50 |
| R=1, M=4(朴素批量) | 2 + 8 = 10 | 32 | 0.31 |
| R=4, M=4 | 8 + 8 = 16 | 128 | 0.125 |
新增 k_rq_q4_gemv_mr<R,M>(R 行共用同一份 x)与工具的 --mr 档。位级 : 每个 (r,m) 的列步进/k 序/尾块/归约树与单行版逐字相同 ⇒ 8 形状 × 3 变体全部 ndiff = 0:
c
/* 文件名:src/npu/cuda/q4_gemv_twin.inc ------ 批量形态:R 行/warp × M 个激活。
 * 与单行版的唯一差别是「一个 warp 算 R 行、内层再套 M 个激活」;
 * 每个 (r,m) 的列步进、内层 k 序、尾块分支、__shfl_down_sync 归约树**逐字相同** ⇒ 位级相同。
 * ★ 与那条「一个 warp 处理 4 行」的**退役负结果**的分界:那条是 R=4、M=1(warp 数 ÷4 ⇒ 并行度不足);
 *   本内核把 M 一起抬起来,M 提供额外的独立工作补偿了并行度 ⇒ 同一把刀换了符号。**不要用于 M=1。** */
template <int R, int M>
__global__ void k_rq_q4_gemv_mr(const uint8_t *__restrict W,
                                const float   *__restrict x,   /* [M][cols] 行主序 */
                                float         *__restrict y,   /* [M][rows] 行主序 */
                                int rows, int cols) {
    const int warp = (int)((blockIdx.x * blockDim.x + threadIdx.x) >> 5);
    const int lane = (int)(threadIdx.x & 31u);
    const int base = warp * R;
    if (base >= rows) return;
    const int row_grp = base >> 2;              /* R 行同属一个 4 行组 */
    const int row_in  = base & 3;
    const int nb = cols >> 5;
    const uint8_t *gb = W + (size_t)row_grp * (size_t)nb * VC_RQ_TILE_BYTES;
    const int bi = lane >> 2, g = lane & 3;
    float acc[R][M];
    #pragma unroll
    for (int r = 0; r < R; r++)
        #pragma unroll
        for (int m = 0; m < M; m++) acc[r][m] = 0.0f;
    int b = 0;
    for (; b + 8 <= nb; b += 8) {
        const uint8_t *p = gb + (size_t)(b + bi) * VC_RQ_TILE_BYTES;
        uint32_t u[R]; float s[R];
        #pragma unroll
        for (int r = 0; r < R; r++) {           /* R 行的权重/标度各取一次 */
            memcpy(&u[r], p + 8 + g * 16 + (row_in + r) * 4, 4);
            __half h; memcpy(&h, p + (row_in + r) * 2, 2);
            s[r] = __half2float(h);
        }
        #pragma unroll
        for (int m = 0; m < M; m++) {           /* ★ 同一份 x 被 R 行共用 */
            const float *xp = x + (size_t)m * (size_t)cols
                                + (size_t)(b + bi) * 32u + 4u * (size_t)g;
            const float4 x0 = *reinterpret_cast<const float4 *>(xp);
            const float4 x1 = *reinterpret_cast<const float4 *>(xp + 16);
            const float xs[8] = { x0.x, x0.y, x0.z, x0.w, x1.x, x1.y, x1.z, x1.w };
            #pragma unroll
            for (int r = 0; r < R; r++) { ...; acc[r][m] += t0 + t1; }
        }
    }
    ...
}
实测(每 token 提速,理想 4.0;两次运行稳):
逐形状原始读数见文末 [附录 · 表 A2](#附录 · 表 A2 "#%E9%99%84%E5%BD%95%E5%8E%9F%E5%A7%8B%E6%95%B0%E6%8D%AE%E8%A1%A8")。
两件事同时被量出来了:
M=1R4那一列多数 < 1(0.79--1.24)------ 当年那条负结果被复现了符号。 所以它不是错的,只是当时没有 M。M=4R4是明确正收益 (2.30 → 2.93):M 提供了额外的独立工作来隐藏延迟, 把「warp 数 ÷R」的代价补了回来。
⇒ 同一把刀,换了参数就换了符号。 「不要重做已退役的一刀」这条纪律的正确用法不是禁止, 而是要求你量 :先量它的失效原因(并行度),再看新参数有没有把那个原因消掉。
收益再订正 (verify = (14.4 − 0.424) × 比值 + 1.696,每轮 + 2.06 × 1.1,/ 2.107):
| 实现水平 | 投影比值 | verify | ms/token | 提速 |
|---|---|---|---|---|
| 地板(x 载入不随 M 放大) | 1.15 | 17.78 | 9.52 | 1.51× |
| ★ R=4,M=4(本轮实测) | 1.37 | 20.78 | 10.94 | 1.32× |
| R=1,M=4(朴素) | 1.74 | 26.30 | 13.56 | 1.06× |
⇒ MTP 的预期收窄为 「1.32×~1.51×」 ,下界已经是实测过的。
一个诚实的尾巴:R=4 不是对所有形状都更好 (
attn k/v2.83→2.30、in_proj_z2.28→2.46)。 小形状上抬 R 会亏 ------ warp 数本来就少。所以落地时要按形状选 R; 而 R=2 与 R=4 的加权几乎一样(2.91 vs 2.93),取 R=2 更稳。
十一、意义
- 「把常量从内核参数里赶出去」才是 graph 化的真正工作 ,graph API 本身是薄的。 这次真正花力气的地方,全在「识别哪些值会随 token 变、并把它们从内核参数搬到设备内存」: RoPE 位置、KV 追加行号、可见长度、动态 smem 定尺------没有一个是 graph API 本身的问题 。
cudaStreamBeginCapture/cudaGraphLaunch加起来不过几十行; 而把它们正确地接上一条 64 层递推 hybrid 路径,才是全部难点。 - 同一个开关,在两个负载下符号相反 。 第 15 篇里 CUDA Graph 是零数值风险的纯加速 (launch-bound 的 fast 档,52.7 → 118.8 tok/s, 2.25×);第 22 篇末段里它是负收益 (位级档 9.90 → 8.45 tok/s,0.85× , 101 ms/tok 已计算受限,图捕获反摊上 ~870 节点重放开销);本篇把它接回 launch-bound 的 hybrid 路径,又是正收益 (1.1335×)。 ⇒ graph 的符号不取决于开关本身,而取决于负载是 launch-bound 还是计算受限。 同一个开关,三种结论,只有看过负载才说得清。
- 审计的价值在于抓「证据口径」,而不是抓代码 。 本轮两条 MUST 里,只有 MUST-1 是代码里的真缺口(边界守卫被捕获绕过); MUST-2 纯粹是「我的说法比证据所能支撑的更强」 ------把「逐项相同」说成了「逐位一致」。 这类问题不在代码里 ,任何静态扫描、任何编译告警都不会报它; 只有一条一条去问「这个结论的证据 是什么等级」才会浮现。 而它恰恰是最容易流出去的------因为代码是对的,说法是错的,后者更难被后来人发现。
- 「已修」不等于「已验证」 ,而补验证的正确姿势是改工具、不改被测对象 。 本轮两条欠账(档间 memcmp、边界可达性)最后都是靠给
q35_gpu_model加选项解决的:--dump让比对可做,--maxseq让边界可达,引擎一行未改。 如果反过来去改引擎让它「好测」,那测出来的东西和要交付的东西就不是同一个了。 - 一个优化做完,会作废排在它后面的另一个优化的账 。 融小核的 ≤0.49 ms 是在「发射要去抢主机 CPU」的假设下算的;graph 一落地, 同样的 192 次发射改从图节点 走,账立刻缩到 0.150 ms(3.3× 之差)。 ⇒ 优化清单上的数字必须标注「它是在哪个档下算的」, 否则上一项的收益会悄悄变成下一项的假机会。
- 但「作废」要看机制是否同轴 ------这一点是第 10.5 节补上的,也是对第 5 条的修正: CUDA Graph 之于融小核 确实作废了(同轴:都针对那 192 次发射的成本); 而 CUDA Graph 之于小投影 fusion 完全没有作废 ------ 因为第 10.5 节量出 graph 只抬 4.4%、合并能抬 15% ,两者是正交 的。 ⇒ 判断「上一项会不会吃掉下一项」之前,先问它们动的是不是同一个环节 : graph 动主机侧 ,合并动设备侧 。没量清机制就合并账,会误杀也可能误投。
- M7 是形状级门禁,不是价值判据 。本节两条候选的形状级 M7 都通过 (3.95× 与 1.34--1.76×),但价值差 10 倍 (1.011% vs ≈10%)。 ⇒ 过门禁只说明「这里还有空间」,不说明「值得动」。 决定要不要动手,还要看实现面(改几个文件、位级风险多大)。 这一条是本轮自己先写错、又自己纠正的(见第 10.4 节的订正注)。
- 门禁的价值在「预测得准」,不在「挡住错的东西」 。 第 10.5 节用一条
--gran探针预测端到端 ≈1.100× / ≈1.093×; 第 10.6 节落地后实测 1.1062× / 1.0892× ,省下量差 +5% / −3% 。 也就是说:在动内核之前,收益已经被量到 ±5% 以内 ------ 这比「先做了再看值不值」便宜得多,也比「凭直觉判断这一刀大不大」可靠得多。 - 位级安全的改动可以「先论证、后验证」 。这次两件事都做了: 论证是「合并的只有输出行、行内算式一字未改」;验证是两个 DLL 各 dump 一次比 SHA256。 结论一致 (三个文件逐字节相同)。但要说清边界:这是整合级 证据 ------ 它后来被第 10.7 节补成内核级 (唯一一份源 + 9 形状直测)。 两者不能互相替代 :整合级证明「整条链路没变」,内核级证明「边角分支没变」; 而死代码分支只有后者能覆盖到。
- 「跑了」不等于「覆盖到了」 ------ 本轮审计最值钱的一条。 我给融合核写了一个叫
rows%8=4 early-exit的形状,注释里说它测的是 融合核 的早退;可算一下tot = 1020+4+0 = 1024,1024 % 8 == 0⇒ 融合核的早退一次都没跑 ,实际被触发的是单输出核 那一发。 形状确实跑了 ,覆盖确实没有 。 ⇒ 写测试形状表时,「我跑了个边角形状」不是判据, 「这个形状具体 让哪一行代码执行/不执行」才是。 而且这类错不会自己暴露 ------ 它会安静地给出一个「bit-exact、PASS」的绿勾。 - 纪律要写成断言,因为「注意」不可靠 。 编辑工具吃掉文件首 BOM 这件事,同一轮里 3 个被编辑的文件 2 个被吃、1 个没事 ------ 它可复现,但不确定。 这种分布下,「以后注意点」是没用的:你无法预知这一次会不会踩。 所以把纪律放进构建脚本:恰好一个 BOM ,少了多了都
exit 1,并配负向测试。 ⇒ 判据从「我记得要检查」变成「机器替我检查」,而后者才在你没盯着的时候也生效。 - 「值不值」要在动手之前问,而且它常常能被一个很便宜的工具答掉 。 MTP 看上去只是「接线」,实际上要造一条 hybrid 批量前向底座(顶层是 GDN 的位级重写)。 如果直接开工,很可能几天后才发现接受率不行 ------ 那才是真正的浪费。 而接受率用169 个位置 就量出来了(α₁ = 65.7%)。 ⇒ 门禁的价值不在「挡住什么」,而在在花大钱之前把问题问清楚 。 配套的一条纪律是:这条测量本身也要引擎一个字节不改 (本轮新增测量器、 只把工具里的
MAXT从 16 放宽到 1024)。 - 门禁要卡的不只是「能不能做」,还有「收益里那些从没量过的默认值」 。 G2 那条探针没有推翻任何实现,它推翻的是一个比值 ------ 「M=k+1 一次前向的成本 ≈ 单 token」这个从没量、只被默认 的假设。 量出来是 1.15--1.76,而不是 1.0,于是收益从 1.8× 掉到 1.06--1.51×。 ⇒ 与第 10 条(形状表名实不符)是一对:一个是「覆盖声明」过头, 一个是「成本假设」过头。两者都不会自己暴露 ------ 它们会安静地给出一个好看的数。
- 「已退役的负结果」不是结论,是带条件的观察 。 「一个 warp 处理 4 行」被记为负结果,它写的原因 是「warp 数降到 1/4、 并行度不足以隐藏访存延迟」------ 这句话里藏着条件 。 把 M=4 加进来后,每个 warp 的独立工作多了 4 倍 ⇒ 那个条件变了 ⇒ 同一把刀翻成正收益(加权 2.30 → 2.93),而 M=1 的对照仍复现负号 (0.79--1.24)。 ⇒ 记负结果时,要记「它在什么条件下为负」,不是「它不行」。 只记结论,会永远错过它;记条件,才能在参数变了以后把它捡回来。
CPU 对照(迁移前基线)
- CPU 参考 :
src/model/vllm_q35_model.c:q35_model_step/src/model/vllm_q35_gdn.c:q35_gdn_step------ hybrid 前向参考。 - 迁移要点 :把随 token 变化的位置量(RoPE 位置 / KV 行号 / 可见长度)从内核参数搬进设备
d_dyn;动态 smem 按max_seq定尺;捕获点放model_reset(避污染 GDN 递推状态);小投影融合k_rq_q4_gemv3。 - 真机验证 :命中 E3(
--test-q35-cuda前向 14.28 ms/token,graph 默认化后);CUDA Graph 1.1335× 与小投影融合 1.1062× 的同会话交错 A/B 未在提供证据内。
附录:原始数据表
表 A1 · 2.1 逐核对照(ms/token,÷3)
| 内核 | 次/token | 本轮 ms/token | µs/次 | 前一轮(寄存器/融合前) | Δ |
|---|---|---|---|---|---|
k_rq_q4_gemv_f32act(全部 q4 投影) |
401 | 11.851 | 29.55 | 12.256 | −3.3% |
k_f32_gemv2 (β/a,融合后) |
48 | 0.416 | 8.68 | k_f32_gemv 96 次 / 0.899 |
−53.7% |
k_rms_norm_unit |
129 | 0.357 | 2.77 | 0.357 | 0 |
k_gdn_delta_reg<128> (寄存器落地后) |
48 | 0.240 | 5.00 | k_gdn_delta 2.646(55.1 µs/次) |
−90.9% |
k_attn_decode |
16 | 0.180 | 11.27 | 0.113 | +59%★ |
k_add_ip |
128 | 0.118 | 0.92 | 0.117 | 0 |
k_gdn_conv_silu |
48 | 0.087 | 1.80 | 0.087 | 0 |
k_gdn_beta_g |
48 | 0.071 | 1.48 | 0.070 | 0 |
k_gdn_gate_norm |
48 | 0.069 | 1.44 | 0.068 | 0 |
k_gdn_qk_norm |
48 | 0.064 | 1.33 | 0.060 | 0 |
k_swiglu |
64 | 0.062 | 0.97 | 0.061 | 0 |
k_attn_q_prep / k_attn_k_prep |
16 / 16 | 0.028 / 0.026 | 1.76 / 1.61 | 合计 0.088 | --- |
k_attn_rope_tab / k_attn_out_gate |
16 / 16 | 0.019 / 0.016 | 1.18 / 0.98 | 同上 | --- |
| 核时合计 | ~1090 | ≈13.60 | 16.84 | −19.2% |
表 A2 · 10.10 实测(每 token 提速,理想 4.0;两次运行稳)
| 形状 | M4R1 | M4R2 | M4R4 | M1R4(对照) |
|---|---|---|---|---|
| mlp gate/up | 2.32 | 3.10 | 3.10 | 1.16 |
| gdn in_qkv | 2.34 | 3.69 | 3.92 | 1.24 |
| attn q | 2.19 | 2.42 | 3.43 | 1.10 |
| mlp down | 2.32 | 2.44 | 2.33 | 0.81 |
| attn k/v | 2.83 | 2.52 | 2.30 | 0.79 |
| lm_head | 2.01 | 2.97 | 3.38 | 1.02 |
| 加权 | 2.30 | 2.91 | 2.93 | --- |
十二、小结
- graph 化的真正工作是把「随 token 变的量」从内核参数搬到设备:RoPE 位置、KV 追加行号、 可见长度、动态 smem 定尺------没有一个是 graph API 本身的问题。
- 契约看全部调用方,不看某一处守卫:把「某处守卫成立」当成「接口契约」是推理方式错, 而不是代码错;改公开入口前必须看它历史上被谁依赖过(重喂同一 token 的自由度)。
- 捕获点必须在序列起点 :GDN 是递推的,「空跑 + 真捕」两遍会真的推进 S/conv 历史; 放
step里会把两遍捕获成本摊进前两个 token,还会静默污染状态。 - 同一开关在不同负载下符号相反:graph 只在 launch-bound 场景是加速, 计算受限时是负收益;且即便 launch-bound,它也只消掉主机侧那一半。
- 「已修」≠「已验证」,补验证要改工具不改被测对象 :
--dump让比对可做、--maxseq让边界可达,引擎一行未改。 - 优化账要标「在哪个档下算的」:graph 一落地,融小核的账从 0.49 ms 缩到 0.150 ms(3.3×); 但「作废」只看同轴------graph 与合并是正交的(主机侧 vs 设备侧)。
- M7 是形状级门禁、不是价值判据;门禁的价值在「预测得准」 :一条
--gran把端到端 收益预测到 ±5% 以内。 - 「跑了」不等于「覆盖到了」:形状表本身也是结论,会名实不符------ 要问「这个形状具体让哪一行代码执行」。
- 纪律写成断言,因为「注意」不可靠 :BOM 恰好一个,少了多了都
exit 1。 - 已退役的负结果要记「在什么条件下为负」:同一把「warp 处理 4 行」的刀, M=1 复现负号(0.79--1.24),M=4 翻成正收益(2.30→2.93)。
相关篇目:第 28 篇、第 26 篇 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...