我们公司的工单系统跑了六年,去年年底加了一个 AI 助手:客服把用户的话粘进去,自动判断该派给哪个组、紧急程度几级、要不要拉人。
一开始很朴素------所有请求都丢给同一个模型。跑了两周,账单下来了,我盯着那个数字看了很久,然后决定重做。
不是模型不好。是我们把一个需要"想得很深"的活和一个只需要"归个类"的活,交给了同一个脑子。
一、先看一个很土但很有用的分法
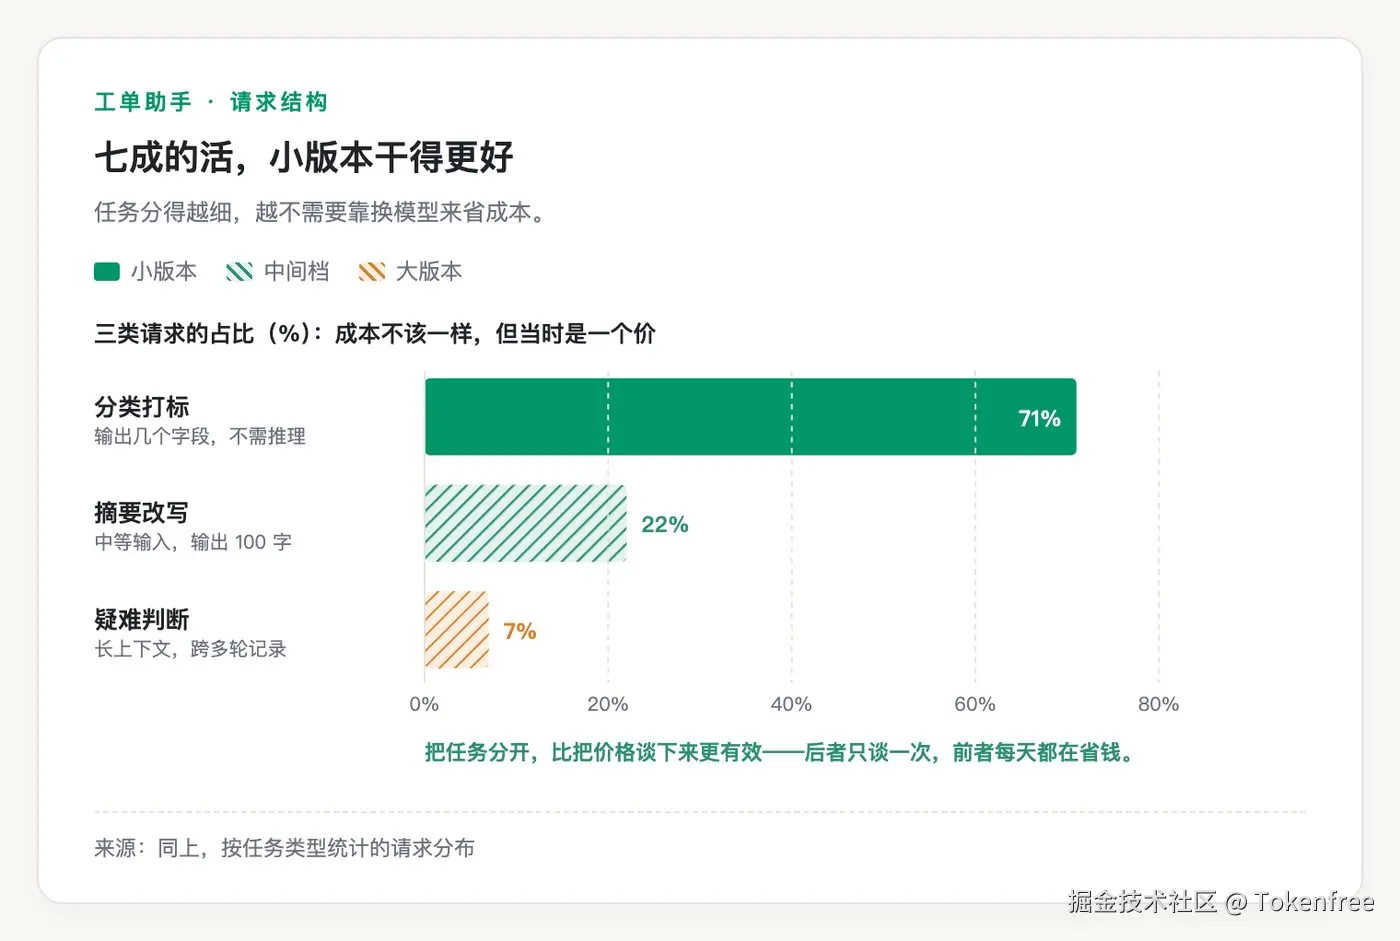 工单系统的 AI 请求,拆开看其实只有三类:
| 类型 | 占请求量 | 特点 |
|---|---|---|
| 分类打标 | 71% | 输出只有几个字段,不需要推理 |
| 摘要改写 | 22% | 中等长度输入,输出 100 字左右 |
| 疑难判断 | 7% | 长上下文,需要跨多轮记录找线索 |
这三类的成本不该一样。但当时我们是一个价。
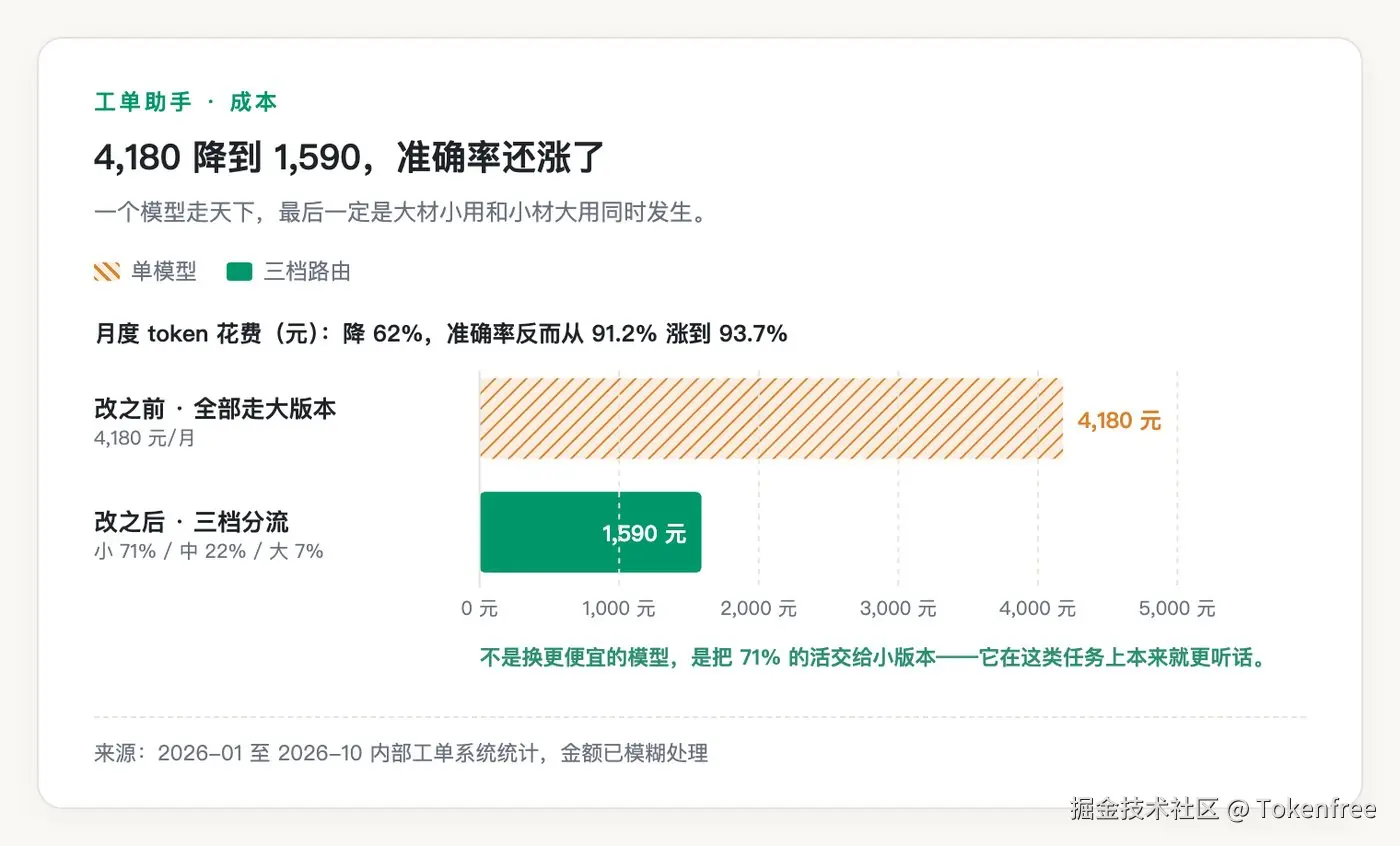 改完之后,71% 的请求走通义千问里最小的那个版本,22% 走中间档,只有 7% 走大版本。月度 token 花费从 4,180 元降到 1,590 元,降了 62%。
而工单分类的准确率------从 91.2% 涨到 93.7%。是的,涨了。因为小模型在"输入很短、任务很明确"的分类上,反而更少自作聪明。
这一点当时挺意外,后来想通了:大模型的问题不是不够聪明,是有时候太聪明,会给你一个"更合理但不是你要的"答案。
二、接法:一份代码,三个模型名
通义千问的接口(Qwen API)是 OpenAI 兼容的,这一点省了非常多事。我们不需要为每个版本写一套客户端,只改 model 这个字符串。
python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.tokenfreeai.com/v1",   # OpenAI 兼容,换服务只改这一行
)

ROUTE = {
    "classify": "qwen-turbo",     # 分类打标,71%
    "summarize": "qwen-plus",     # 摘要改写,22%
    "reason":    "qwen-max",      # 疑难判断,7%
}

def ask(task: str, prompt: str, **kw):
    return client.chat.completions.create(
        model=ROUTE[task],
        messages=[{"role": "user", "content": prompt}],
        **kw,
)调用方传的不是模型名,是任务名。这个抽象很重要------它意味着以后换模型,改的是这张表,不是散落在四十几个文件里的字符串。
上线三个月,这张表改过五次。如果没有这层,那五次就会变成四十个文件的 diff。
三、坑一:长文本不是"上下文更长",是"计价方式不一样"
这个是真正让我吃了一次亏的地方。
工单里有不少"疑难判断"要读历史记录,一条对话可能几万字。我一开始想得很简单------找个支持长上下文的版本,把整段丢进去不就行了。
于是我把 7% 的疑难工单全切到长文本版本,跑了三天,成本没降反升,而且升得很多。
原因在计价结构上:长文本模型的输入单价和你按普通模型算出来的完全不是一回事。 我原来按"普通模型贵一点"估的,实际结算是另一套折算,超出的部分比我想的狠。
后来改成两步:先用普通版本对历史记录做一次压缩,把 3 万字的对话压成 800 字的摘要,再交给长文本版本判断。成本回到预期,判断质量几乎没掉------因为对"该派给谁"这个问题,原始对话里 95% 的内容是噪音。
一个通用结论:上下文长度是能力,不是免费的容量。 能用摘要解决的事,别用长上下文硬扛。
这也是我用 token 计费这件事上最实在的一课:单价表看起来简单,但输入长度、输出长度、缓存命中,每一项都在改最终数字。RFC 里没写的那部分,得自己跑一个月账单才看得见。
四、坑二:结构化输出的 strict 模式,不是所有版本都一致
工单分类的输出必须是机器能吃的。我们用的是结构化输出,JSON Schema 写死字段:group、urgency、need_escalate。
问题出在小版本上。同一份 Schema,大版本老老实实按字段返回,小版本偶尔会:
- 把
urgency从整数变成"3"字符串 - 在 JSON 外面包一层 ```json 代码块
- 字段顺序乱掉(这个其实不影响,但我们的老解析器按位置取的)
第三个是我们的问题,前两个是真实的兼容性差异。
解决方式很土:在代码里做一次归一化,不指望模型。 字符串数字转整数,剥掉代码块包裹,按 key 取值不用位置。二十行代码,比换模型便宜得多。
教训:不要假设"同一个接口"等于"同一个行为"。 版本间的差异往往不在能力上,在边界情况的处理上。
五、限流和并发:这件事比模型选择更影响体验
我们做过一次线上观测:真正让客服抱怨"这个 AI 好慢"的请求里,只有三成是真的模型慢,另外七成是在队列里等。
原因是并发开太大。我们把并发从 32 调到 12,同时加了两个东西:
一是超时降档------超过 2.5 秒没拿到首字,换一个小版本先回一个"正在分析",后台继续跑。用户看到的是有反应,不是转圈。
二是按任务分级排队------分类打标这类短请求走快队列,疑难判断走慢队列,互不占坑。以前一个疑难工单会把后面二十个分类请求全堵住。
改完之后,端到端 P95 从 6.8 秒降到 2.1 秒。这个 2.1 秒里,首字延迟占 1.3 秒左右,剩下的是网络和渲染。
代码里的地址和密钥是一个入口一套,账单按子密钥分了"工单分类"和"疑难判断"两个账本,月底对账不用再拿 Excel 拆。我这边用的是词元云(tokenfreeai.com),几个版本在同一个密钥下面,做这种按任务的成本拆分省了不少事;用各家官方后台也能做,就是得开几个账号对着看。
六、三个版本各自适合干什么(跑了一年之后的结论)
小版本:分类、打标、简短改写、意图识别。输入短、输出结构固定、要求快。这类任务上它和大版本的差距小到可以忽略,价格却差一个数量级。
中间版本:摘要、多轮改写、带一点推理的判断。这是最"万金油"的一档,我个人用得最多。
大版本:跨多份材料的比对、需要按步骤推理的疑难、写出来要直接给人看的长文。真用它的时候,你会发现它值那个价------但如果你发现自己 30% 的请求都在用大版本,先别调价,先看看是不是任务没分好。
技术选型里最贵的一课,从来不是选错了模型,是根本没分。 一个模型走天下,最后一定是大材小用和小材大用同时发生------这也是我们在选大模型 API 时最该先想清楚的一件事。