一台 2025 年底上市的 ARM 小盒子。121GB 统一内存,一块 GB10,官方文档里写着这类模型跑不了它的架构。
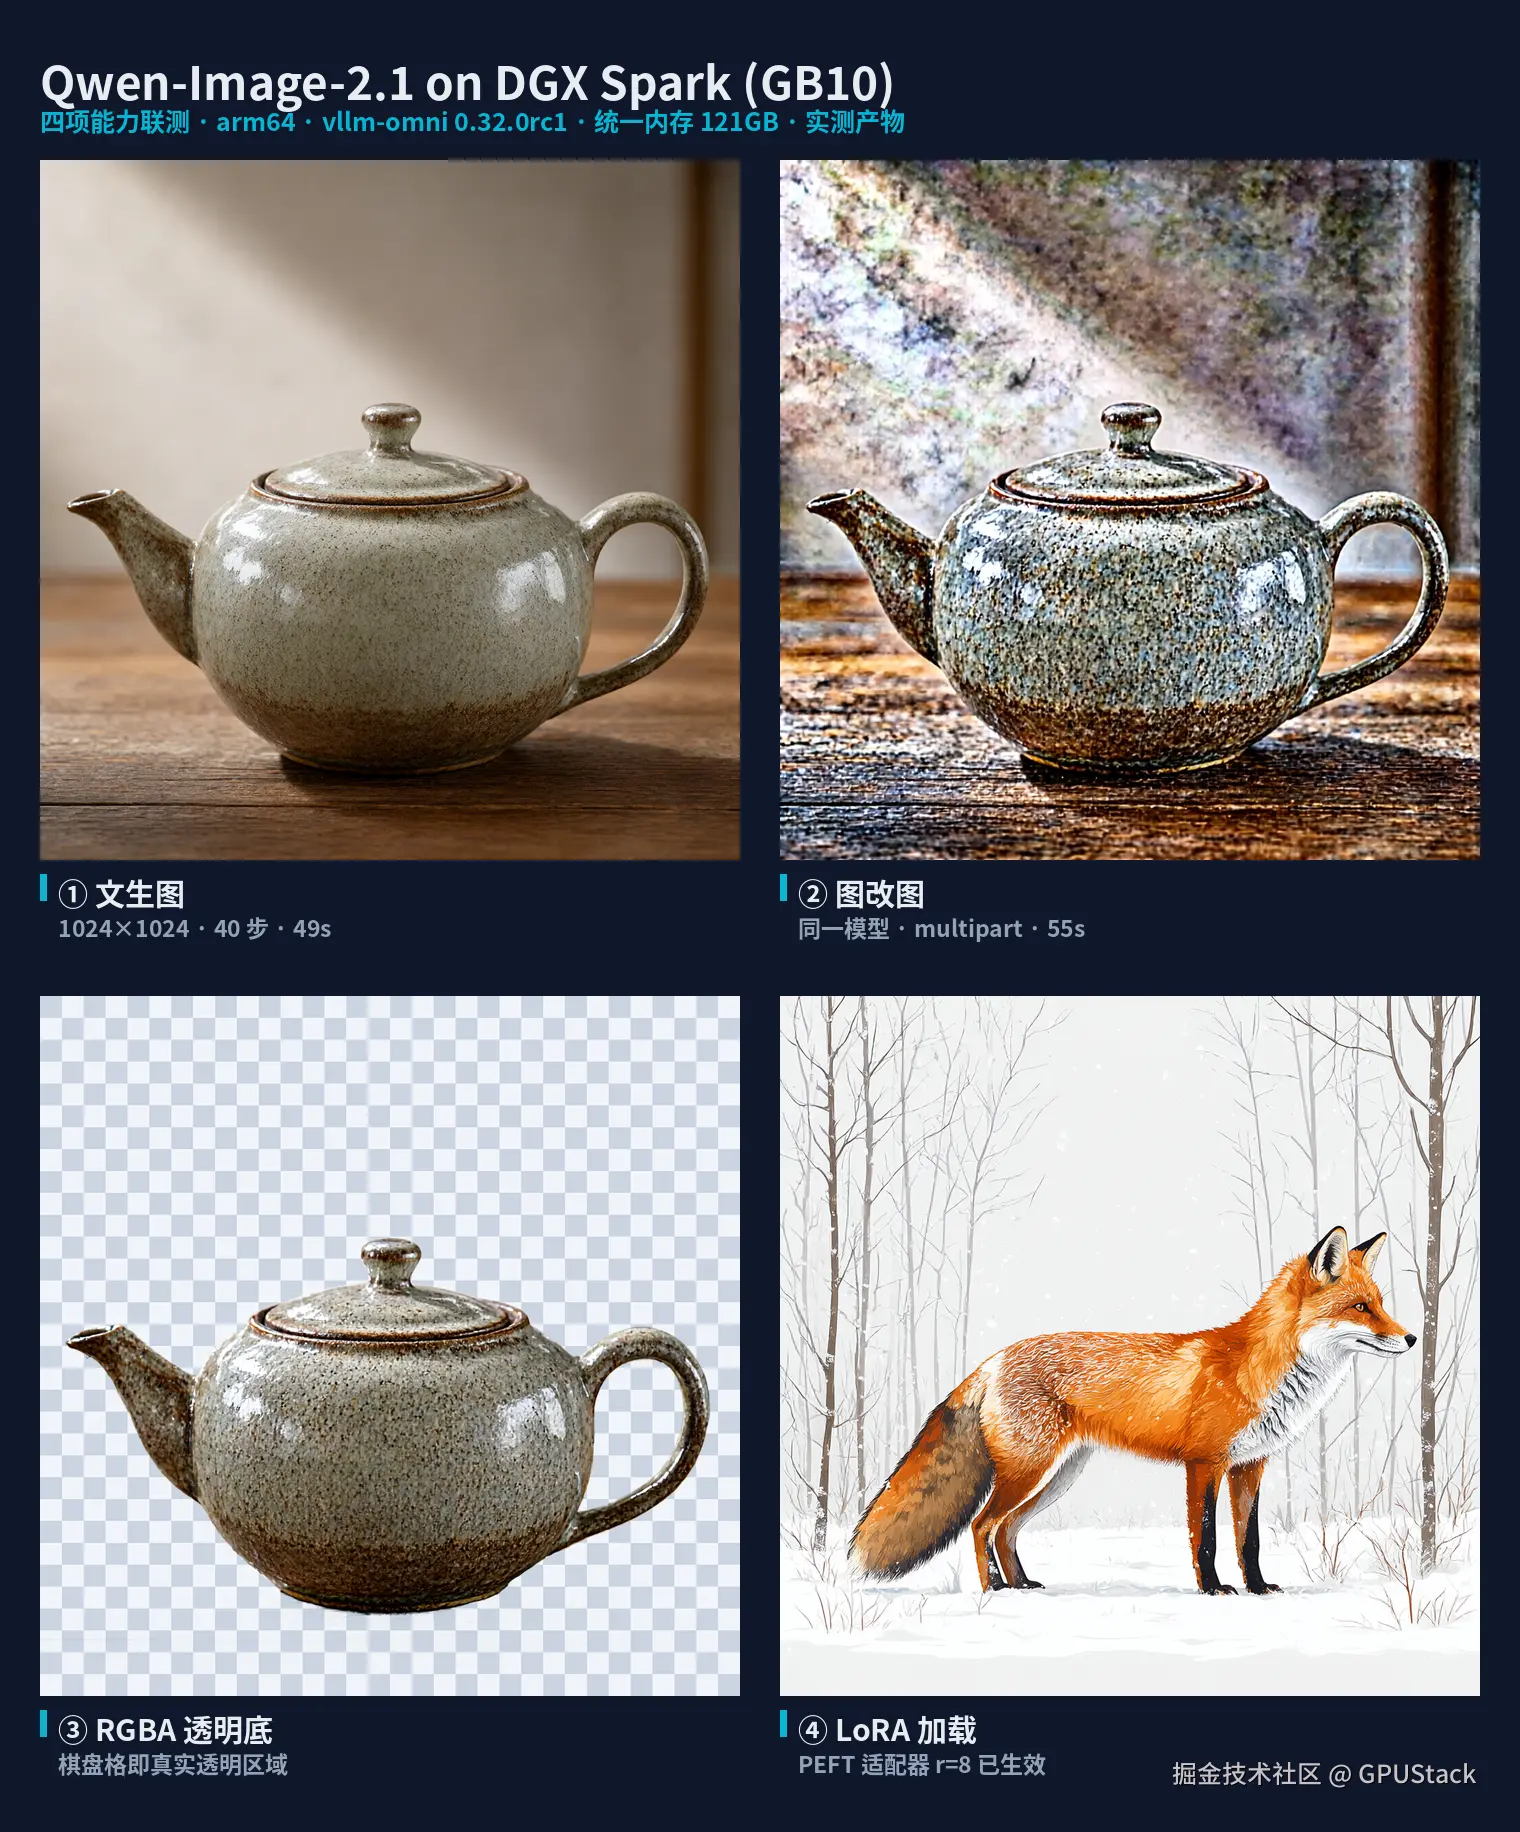
现在它对外提供一个 OpenAI 兼容的图像接口,文生图、改图、原生透明底、LoRA 四项全通。硬件一点没动,驱动没升级,也没有第二台机器。
把镜像变成团队里人人能调的服务,中间那段是 GPUStack 接过去的。下面记录整个过程:先判断 ARM 到底能不能跑,再处理构建、网络、部署和网关问题。
01 · 文档说不支持,我先去验一句
机器是 DGX Spark,GB10,aarch64 架构。驱动 580.173.02,CUDA 13.0,121GB 内存由 CPU 和 GPU 共用。
| 项目 | 实测环境 |
|---|---|
| 设备 | NVIDIA DGX Spark |
| GPU | GB10 |
| 架构 | aarch64 / sm_121 |
| 驱动 | 580.173.02 |
| CUDA | 13.0 |
| 内存 | 121GB CPU/GPU 统一内存 |
要跑的是 9 月 20 号开源的 Qwen-Image-2.1。它不是自回归模型,视觉生成部分是一个 7.1B 的单流 DiT,配 Qwen3-VL-8B 编码文本和参考图,VAE 是 64 通道、16 倍空间压缩,alpha 通道在潜空间里直接生成。
普通 vLLM 跑不了这个结构,必须用 vLLM-Omni 。启动时还要带 --omni。偏偏 NVIDIA Dynamo 的文档里有一行黑体字,我读到时心里凉了一下。
text
[ FAIL ]
ARM64 not supported
vLLM-Omni is currently only installed on amd64 builds.
On arm64, the container build skips the install
and vLLM-Omni features are unavailable.
我没有立刻放弃,先确认这句「不支持」到底指硬件跑不了,还是官方没有提供对应构建。要是后一种,问题可能只在 CI 配置。
先去镜像仓库看它到底发没发 arm64,一条命令。
text
$ docker manifest inspect vllm/vllm-omni:v0.30.0
    "architecture": "amd64",
    "architecture": "arm64",
# 三个 tag 都探了,arm64 变体一直存在
再看包本身,PyPI 上的 vllm_omni 是 py3-none-any,一个纯 Python 的 universal wheel,压根不存在编译平台问题。
构建矩阵没覆盖 arm64,不等于它在 ARM 上跑不了。
但还不能收手。GB10 的计算能力是 12.1,也就是 sm_121,镜像里预编译的 kernel 到底有没有覆盖这一档,仍然要实测。能安装、能 import,最后却因为 kernel 缺失跑崩,这种情况最容易让人白忙。
所以我先不改 Dockerfile,直接进基础镜像跑最小算子,看四个数。
text
torch          2.13.0+cu130
device        NVIDIA GB10
capability     (12, 1)
arch_list     ['sm_80', 'sm_90', 'sm_100', 'sm_110', 'sm_120']
matmul_OK     475798.4  0.277 s
sdpa_OK       (1, 8, 512, 64)
# 矩阵乘与缩放点积注意力在 GB10 上真实执行通过
结果正常。矩阵乘和缩放点积注意力都在 GB10 上实际执行通过。这五分钟把硬件兼容性先排除了,后面可以专心改 Dockerfile。
02 · 版本考古,和一条不能碰的红线
接下来得找出哪个版本的 vLLM-Omni 真正包含这个模型。官方 recipe 页写着,支持代码来自 PR #7759,不在任何 tag 里,而且还没合并。页面更新时间停在 9 月 19 日。我点开 PR,状态是 closed,merged 是 false。
但 recipe 引用的仓库链接里已经有 qwen-image-2.1 分支,vLLM 也发了 Day-0 支持公告。这几处信息对不上,明显是文档落后于代码了。
干脆直接看代码。我用 API 检查模型目录是否存在,一次把几个 ref 都探了一遍。
text
vllm_omni/diffusion/models/qwen_image_21
  ref = v0.30.0       →  404
  ref = v0.31.0rc1   →  404
  ref = v0.32.0rc1    →  200
  ref = main         →  200
# 以仓库里的实际代码为准
v0.32.0rc1 发布于 10 月 19 日,刚好是我动手的前一天。PyPI 上最新的仍是 0.31.0rc1,里面没有这个模型。vLLM-Omni 的版本号又和它依赖的 vLLM 主版本对应,因此基础镜像只能用 vllm/vllm-openai:v0.32.0。这个 tag 确实提供 arm64。
更麻烦的是安装过程会悄悄替换已有依赖。Base 镜像里的 torch、vllm、cuDNN、NCCL 都针对 GB10 和 CUDA 13 预编译过。其中任何一个被 pip 替换,都可能破坏原来的运行环境。镜像甚至仍能正常 build、正常启动,直到加载权重时才报一个看似毫不相关的错。
这事我在构建日志里亲眼看到它正打算动手。
text
Collecting nvidia-nccl-cu13==2.29.7 (from torch>=2.7.1->cache-dit==1.5.0)
  Downloading nvidia_nccl_cu13-2.29.7-...-aarch64.whl (206.0 MB)
# 一个图像缓存加速库,顺着 torch 把 NCCL 也拖进了升级队列
我的处理原则是「只新增,不替换」。先过滤带 extra == 标记的依赖,因为 requires() 会把 dev、docs、fa4 一起列出来,71 个包里有 52 个和图片生成无关。安装时全程使用 --no-deps ,已有包直接视为满足,再用 pip check 一轮轮补真正缺失的项,这个环境跑了 5 轮才收敛。Dockerfile 里还加了版本检查:安装前后分别读取 vllm 和 torch 的版本,只要发生变化,构建立即失败。
text
[omni]  before: vllm=0.32.0  torch=2.13.0+cu130
[omni]  after : vllm=0.32.0  torch=2.13.0+cu130
[omni]  Qwen-Image-2.1 transformer ok
# 构建期就拦住,绝不留到运行期
镜像构建成功还不够,基础环境也不能被安装过程改坏。
03 · 三次「网络不行」,三个不同根因
在国内拉这些镜像和源码,网络问题绕不过去,而且几次故障的原因都不一样。全归成「网不好」,排查方向很容易错。
第一次最阴。机器上配的 registry mirror 查 manifest 又快又全,arm64 变体列得清清楚楚,等真开始 pull,24GB 的层就不动了,日志里刷 Retrying in 3 seconds。我不猜,直接量数据目录有没有在长。
text
docker 数据目录 664G → 664G (40 秒) 零增长# 元数据通畅、数据通道堵塞,这种源只能换掉
换源之后,45 秒下了 238MB,后面一路正常。manifest 能查通 ,只能证明元数据接口可用,不能证明 blob 下载也通。另一个容易忽略的点是,Dockerfile 顶部的 # syntax=docker/dockerfile:1.7 会让 BuildKit 绕过已配置的国内镜像,直接连 docker.io。我在那里卡了 5 分钟,只走了 3MB,而项目其实并不需要 1.7 的语法特性。
第二次,vllm-omni 0.32.0 没上 PyPI,GitHub release 也没有 wheel,只能从源码构建。git clone 报 GnuTLS recv error (-110),TLS 连接被中途掐断;同一个地址改用 curl 下载 tarball,39MB 八秒就完成了。出问题的是 git 这条链路,不是整个站点都不可用。
第三次是 tarball 没有 .git,构建撞上纯工程问题。
text
packaging.version.InvalidVersion: Invalid version: 'dev'
Warning: Failed to get version from git, using fallback
# 没 git 元数据,setuptools-scm 只能推出 'dev' 这个非法版本号
我先试着从外面传版本号,没用。翻开 setup.py 才发现,项目会无条件覆盖外部传入的版本变量 ,然后再调用 setuptools-scm。tarball 没有 git 元数据,它推出来的版本只能是非法的 'dev'。最后的解法是在解包目录里执行 git init,提交一次,再补一个同名 tag,让版本推导有结果可用。
权重下载也卡了一次。33GB 文件用单连接只有 1.2MB/s,照这个速度要八小时。把并发调到 8后,合计速度到了 28MB/s 左右,59 分钟下完。遇到下载慢,可以先确认是不是只有单路连接。
最终镜像 25.3GB,一次构建成功。但这时它还只是本机上的一个容器进程,我要的是团队成员拿 API Key 就能调用的图像服务。鉴权、路由和实例管理这一段,我不打算自己重写。
04 · 平台替我走的那段路
我选 GPUStack,是因为它允许把非官方镜像登记成正式推理后端。这个镜像跨架构,模型支持还停在 rc 阶段,换到限制更严的平台,很可能连第一道校验都过不了。
它的后端版本配置项不多,但已经够用:一个镜像名、一条启动命令模板、一组环境变量。平台会把渲染后的命令作为参数追加给镜像的 ENTRYPOINT,后面的部署流程由它接手。
| 字段 | 我填的东西 |
|---|---|
| image_name | qwen-image-2.1:gpustack-spark |
| run_command | {{model_path}} --omni --host {{worker_ip}} --port {{port}} --served-model-name {{model_name}} |
| env | QWEN_IMAGE_GPU_MEM_UTIL=0.55 QWEN_IMAGE_MAX_NUM_SEQS=2 |
那行占位符是平台负责填的,模型在哪、监听哪个口、对外叫什么名字,我全不用操心。
接入分三步,顺序不能颠倒。
| 步骤 | 配置对象 | 作用 |
|---|---|---|
| 1 | 推理后端 | 定义镜像和启动方式 |
| 2 | 模型 | 定义权重、GPU 和副本数 |
| 3 | 模型路由 | 将模型挂到网关路径 |
这里有个容易选错的地方。平台支持新建自定义后端,看起来更自由,但我翻完 v2.2.2 的实现后没有这么做。LoRA 的参数注入只写在内置 vLLM 后端里;如果另建自定义后端,平台就不知道该怎么挂适配器。因此我是在内置 vLLM 后端下新增版本。
平台能识别 omni 模型
平台本身能识别 vLLM-Omni。只要部署的 categories 带上 image,或者后端参数里显式写了 --omni,它就会按 omni 模型处理。
识别成功后,平台会自动补上 --omni ,并跳过 --max-model-len 的注入。后一点很重要:扩散模型没有 token 序列长度,调度器对 omni 也使用另一套显存估算。如果识别失败,平台会套用 LLM 的 KV cache 逻辑计算 DiT 显存,单卡机器很可能直接被判定为显存不足。
图像接口已经在网关路由里
我原本担心网关只放行 chat/completions,图像端点还得单独加白名单。翻路由表后发现,/images/generations 和 /images/edits 已经和 chat、completions、audio、embeddings 放在同一张 OpenAI 路由表里,而且支持模型名解析。图像接口不需要额外配置代理。
LoRA 交给平台管理
这一段对日常使用最实用。传统做法是运维把 .safetensors 拷到某台机器的某个目录,再让所有人记住路径;一旦拷错,也很难及时发现。
平台会把适配器保存成部署配置,负责下载和状态检查,只有 READY 状态的适配器才会挂进实例 。每个适配器还有一个 基座名:适配器名 的路由名;调用方传这个短名字,网关会找到已经加载对应适配器的实例。
平台还会读取 adapter_config.json 里的 base_model_name_or_path,和部署时选择的基座比对。基座不一致时,ModelFile 会直接进入 ERROR 状态,并写明原因。社区里很多 Qwen-Image LoRA 声明的基座仍是 Qwen-Image,而不是 Qwen-Image-2.1,所以会在这里直接报错。这样至少不会静默加载,等到运行期才出问题。
平台按 LLM 的方式管理这些参数,扩散模型并不认识,所以我只在中间加了一层参数翻译。
text
# 平台按 vLLM 服务 LLM 的规矩下发
--enable-lora --max-loras 2 --max-lora-rank 32
--lora-modules '{"name":"base:styleA","path":"/loras/styleA"}' ...

# 扩散侧真正认的
--lora-backend peft   --lora-path /loras/styleA
# 同名不同义,直接转发就是 argparse 报错;翻译层挂在 ENTRYPOINT 上
适配器是含 adapter_config.json 的目录就走 peft,是单个 .safetensors 就走 distill,这个判断在启动器里自动做。
33GB 权重由 worker 自动从 ModelScope 下载到统一缓存目录,我事先手动下载的那份反而没派上用场。以后换机器部署,也不需要再手工摆文件。
05 · 网关 404,我的锅,平台给的线索
实例起来了,容器 Up,端口本机 curl 返回 200,模型列表里能看到它。然后打网关。
text
{"code":404,"reason":"NotFound",
 "message":"No running model instance found for model name: 1808"}
# 实例明明白白 running,网关却说没有可用实例
我先拿另外几个请求做对照,每次只改一个变量。
| 请求 | 返回 |
|---|---|
| 一个不存在的模型名 | 404 Model not found,说明鉴权和路由本身都通 |
| 一把 KEY 没权限的 LLM | 403 Not allowed to access,说明 KEY 是有效的 |
| qwen-image-2.1 | 404 no running instance |
| 另一个跟本次毫无关系的图像模型 | 同一个 404,指向同一个实例号 |
最后一行把范围缩小了:另一个和本次改动无关的模型也报同样的错。问题不在新镜像,而在平台到 worker 的连接上。
平台的实例接口会直接返回 state、port、worker_ip、worker_advertise_address。逐项对下来才发现,--advertise-address 填成了另一台机器的 IP。网关按上报地址回连,自然连错了地方。改完立刻恢复。问题是我配置错了,好在接口把原始字段都返回了,十分钟就能定位。
这里还有两个容易混淆的点:v2 系列管理 API 的前缀是 /v2 ,不是 /api/v1,后者会直接返回 404。UI 测试代码中 /model/proxy/ 后面的数字是实例 ID,不是模型 ID,两者在数据库里不是同一个编号。
平台侧还有一组参数要留意,这和 DGX Spark 的统一内存有关。
| 扩散侧默认值 | 独显上 | GB10 统一内存上 |
|---|---|---|
| gpu_memory_utilization 0.9 | 顶多一个 CUDA OOM | 0.9 × 121GB = 109GB,挤的是操作系统的地盘 |
| num_inference_steps 50 | 慢一点 | 比这模型要的 40 步多两成时间 |
| true_cfg_scale 4.0 | 风格偏移 | 带上负面提示则 DiT 每步跑两次,耗时翻倍 |
我在两处都留了限制:镜像启动器把 gpu-memory-utilization 设为 0.55、并发压到 2、默认关闭 CUDA Graph;平台的后端版本里再写一遍相同环境变量。统一内存机器把额度吃得太满,宿主系统也可能被拖死。
06 · 账单与边界
四项能力都已在 GPUStack 托管实例上跑通。这四项包括文生图、图改图、RGBA 透明底和 LoRA。调用方只需要一把 API Key:请求先到网关,再按模型名路由到运行这个镜像的实例。
第三格不是抠图插件的产物。alpha 通道由模型的 64 通道 VAE 直接从潜空间解码,透明区域和边缘都来自模型输出,不是后处理加上去的蒙版。
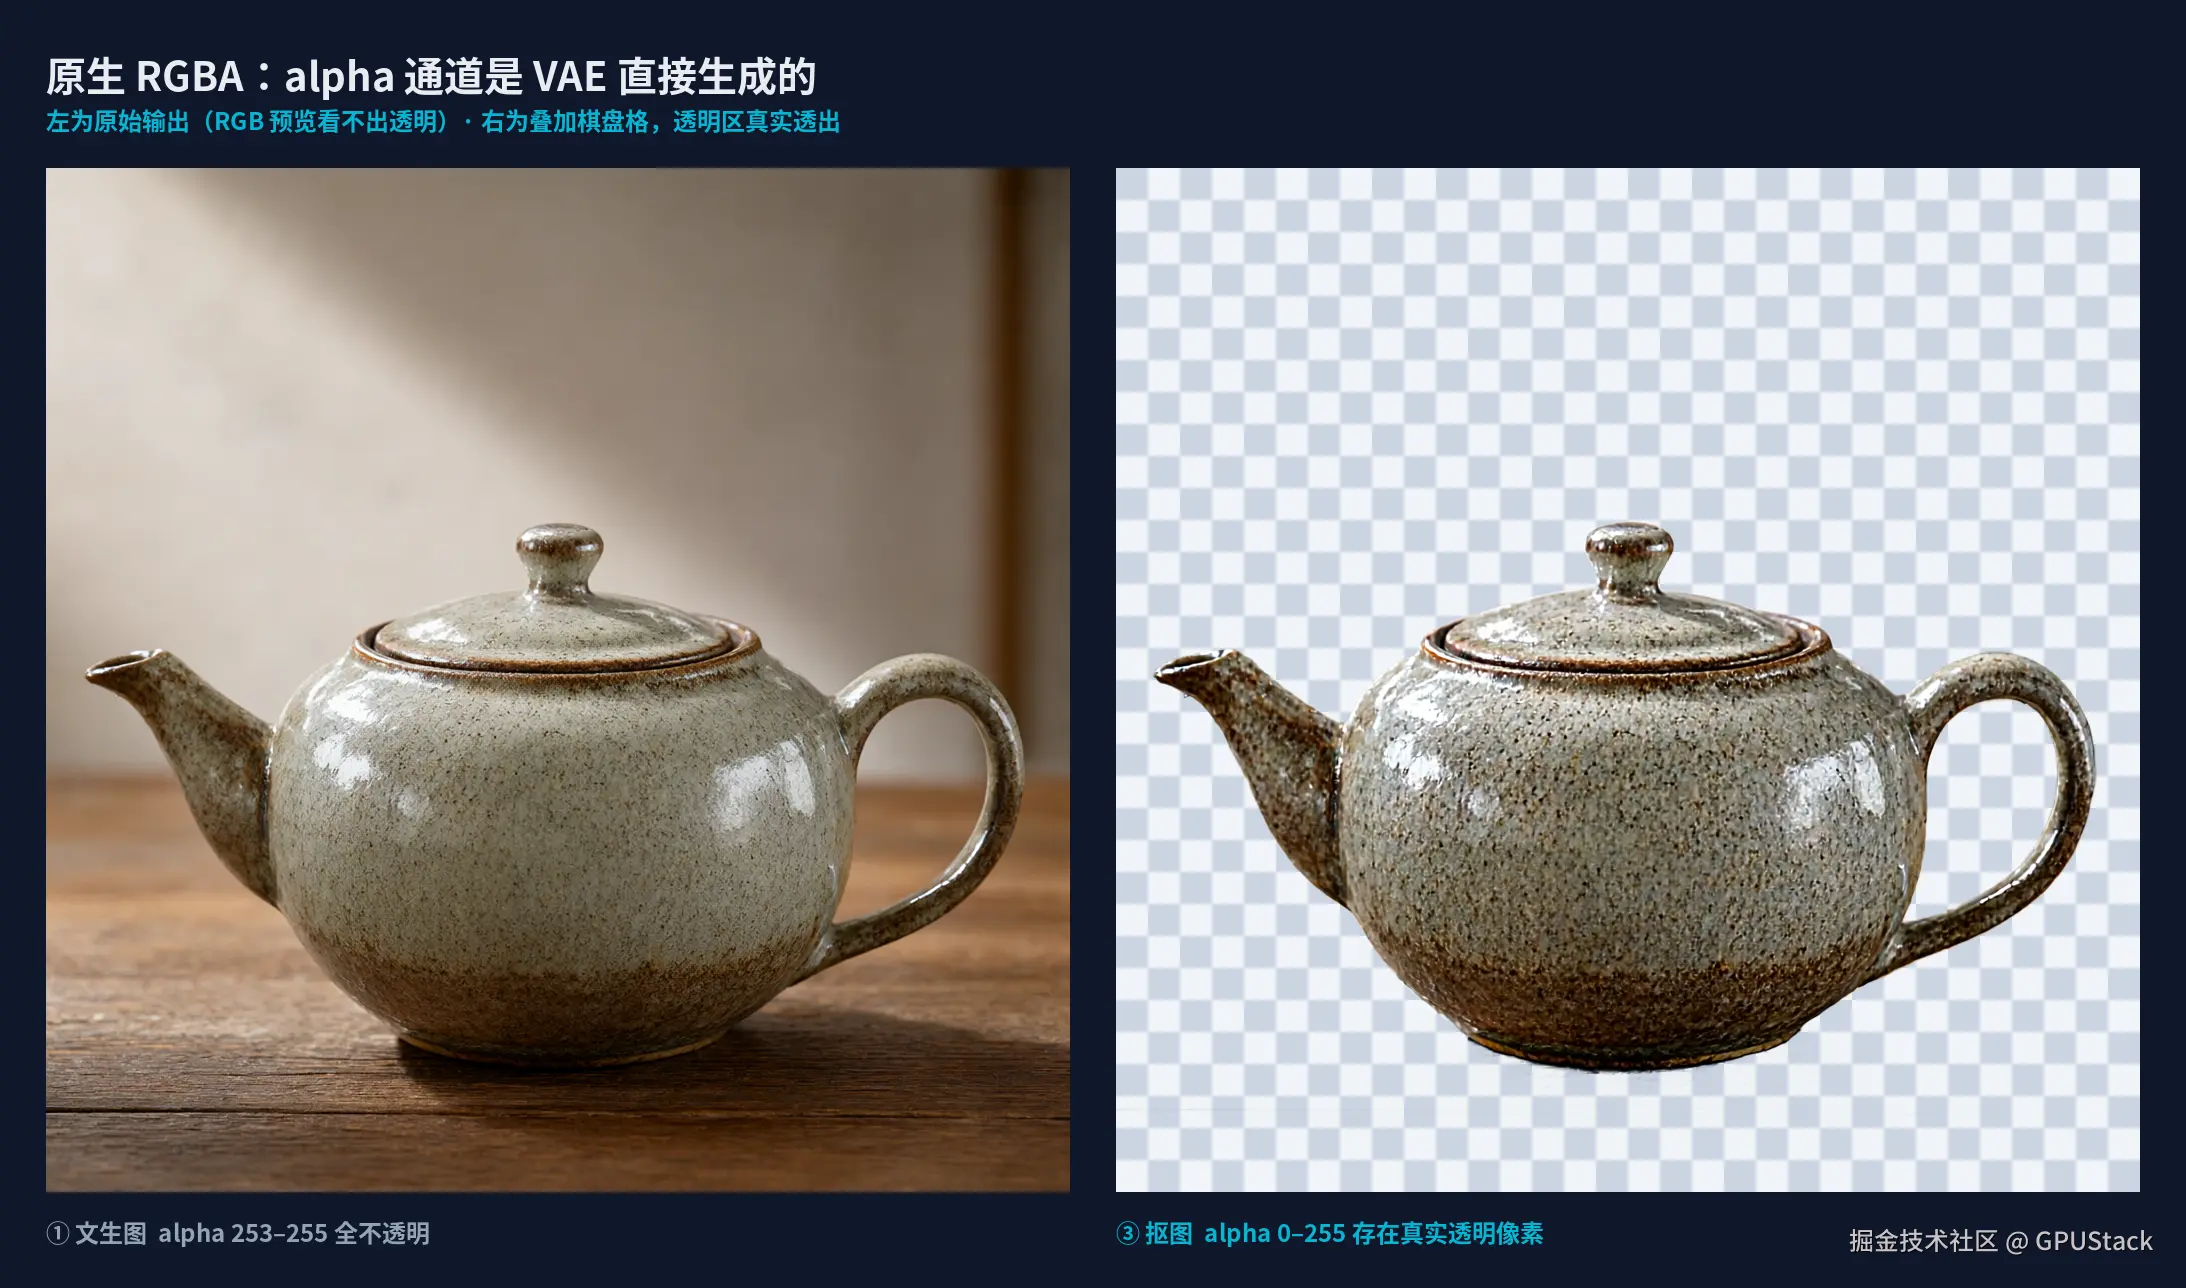
# 左边 RGB 预览看不出透明,右边叠一层棋盘格,透明区是真空的
| 项目 | 实测 |
|---|---|
| 基础镜像 / 最终镜像 | vllm-openai v0.32.0 arm64 24.4GB / 成品 25.3GB |
| 推理引擎 | vllm 0.32.0 + vllm-omni 0.32.0rc1 |
| 权重加载 | 33GB / 29 个文件,105 秒(平台自动拉取) |
| 文生图 1024×1024 · 40 步 | 49 秒 |
| 图改图(单参考图) | 55 秒 |
| RGBA 透明底 | alpha 0--255,真实透明像素 |
| LoRA | 启动预载与按请求加载均通过 |
| 常驻内存 | 38GB / 121GB,宿主仍有 80GB 可用 |
| 硬件改动 | 零。没加卡,没换机,没动驱动 |
测试结果有两个边界。49 秒是在关闭 CUDA Graph 的保守配置下测得;官方在 GB300 上同分辨率约为 4.5 秒,硬件功耗和带宽的差距摆在那里。2048 长边我没有压测。LoRA 使用按真实权重形状构造的 r=8 适配器,B 矩阵全零、delta 为 0,只验证加载链路,不代表具体画风效果。
调用侧还有几条硬约束,最好直接写进接入文档。
| 项目 | 约束 |
|---|---|
| 图像编辑接口 | /v1/images/edits 只接受 multipart;发送 JSON 可能被直接重置连接 |
| 参考图数量 | 最多 4 张 |
| data URL | 单个 part 上限 1024KB,512×512 PNG 已可能触及上限 |
| 推理步数 | 每次请求显式传 num_inference_steps: 40,服务端默认值为 50 |
| CFG | 每次请求显式传 true_cfg_scale: 1.0,服务端默认值为 4.0 |
text
[ OUTPUT ]  经 GPUStack 网关调用
curl http://<gpustack>/v1/images/generations \
  -H "Authorization: Bearer $KEY" -H "Content-Type: application/json" -d '{
   "model": "qwen-image-2.1", "prompt": "...", "size": "1024x1024",
   "num_inference_steps": 40, "true_cfg_scale": 1.0, "seed": 42 }'
# 蓝色两行必须显式带上;换平台这段不用改,改的只是网关地址
写在最后
这次真正耗时间的,是确认「不支持」的具体含义、防止安装过程污染基础依赖,以及找出填错的 IP,模型推理本身反而没花太久。
鉴权、路由、GPU 调度、生命周期、权重分发、适配器管理、健康检查和故障重启,我都直接用了平台现成的能力。自己搭一套的工作量不会比做一个 25GB 镜像小,后面换人或换模型时还得继续维护。
中间那层参数翻译只有几十行,维护成本不高,却能把刚发布的模型接进现有部署体系。对团队来说,区别就是现在能开始试,还是继续等后续排期。
注意授权。Qwen-Image-2.1 用的不是 Apache 2.0,而是 2026-09-20 改版发布的 Qwen Research License Agreement,仅允许非商业性研究与评估。需要商用请走官方授权途径。
如果你也遇到文档写着「不支持」的硬件或镜像,可以先查清楚限制到底出在硬件、构建,还是平台适配上,再决定要不要放弃。