上个月帮朋友评估一个老系统的改造方案。这个系统的情况是这样:一半数据在关系库里,另一半在文档库里。这篇文章记录我调研金仓 KingbaseES MongoDB兼容版的过程,还有我自己在测试环境里把"用SQL管理文档数据"这条路跑通一遍的笔记。
@toc
从一个别扭的架构说起
先说说我朋友那个系统的情况,做过类似业务的同行大概会觉得眼熟。
业务核心是订单和用户,这部分数据放在关系型数据库里,事务也好办,报表也好办。但系统里还有一大块数据,是用户行为记录、商品详情、设备上报的JSON报文。这些数据的字段结构经常变,当初选型的时候,团队一商量:这块放文档数据库吧。于是技术栈就变成了两个数据库并存的状态。
问题是从半年前开始集中出现的。第一件事跟报表有关:业务方想统计"下单用户的会员等级分布"。订单数据在关系库里,用户画像在文档库里。这个统计看起来简单到不能再简单了,但实际要做的话,居然得写一个定时任务,先把文档库的数据导出来,清洗成中间表,然后再和关系库做关联。链路长,延迟高,数据还经常对不上。
第二件事就更现实了:那款文档数据库的服务端软件,商业授权要续费了。费用不低,而且 licensing 条款对集群规模还有新的限制。领导问了一句话,我印象很深:"我们真的需要为这一半数据,单独养一套数据库吗?"
这两个问题其实指向同一个方向:能不能把文档数据收编回关系型数据库,同时又不破坏现有应用的开发方式?那就绕不开一个词了------MongoDB迁移。
我调研了一圈,最后把注意力放在了电科金仓的 KingbaseES V9 MongoDB兼容版上。原因其实很简单:它的思路不是"给你一个类MongoDB的接口",而是让KES直接兼容MongoDB的原生协议和命令。这样一来,现有应用几乎不用动,同时数据库本身还是一个具备完整SQL能力的关系型数据库。下面我把调研结论和动手的过程整理出来。
核心思路:协议层兼容,而不是外挂一层中间件
市面上做"文档数据进关系库"的方案其实不少。但很多方案的本质是什么呢?是在应用和数据库之间架一个解析中间件,把MongoDB的语法翻译成SQL再发过去。这种做法有几个天然的问题:多一跳网络,多一层故障点,遇到复杂命令翻译不过来就直接报错。
KES MongoDB兼容版走的是另一条路。我把官方资料里的分层画了出来: 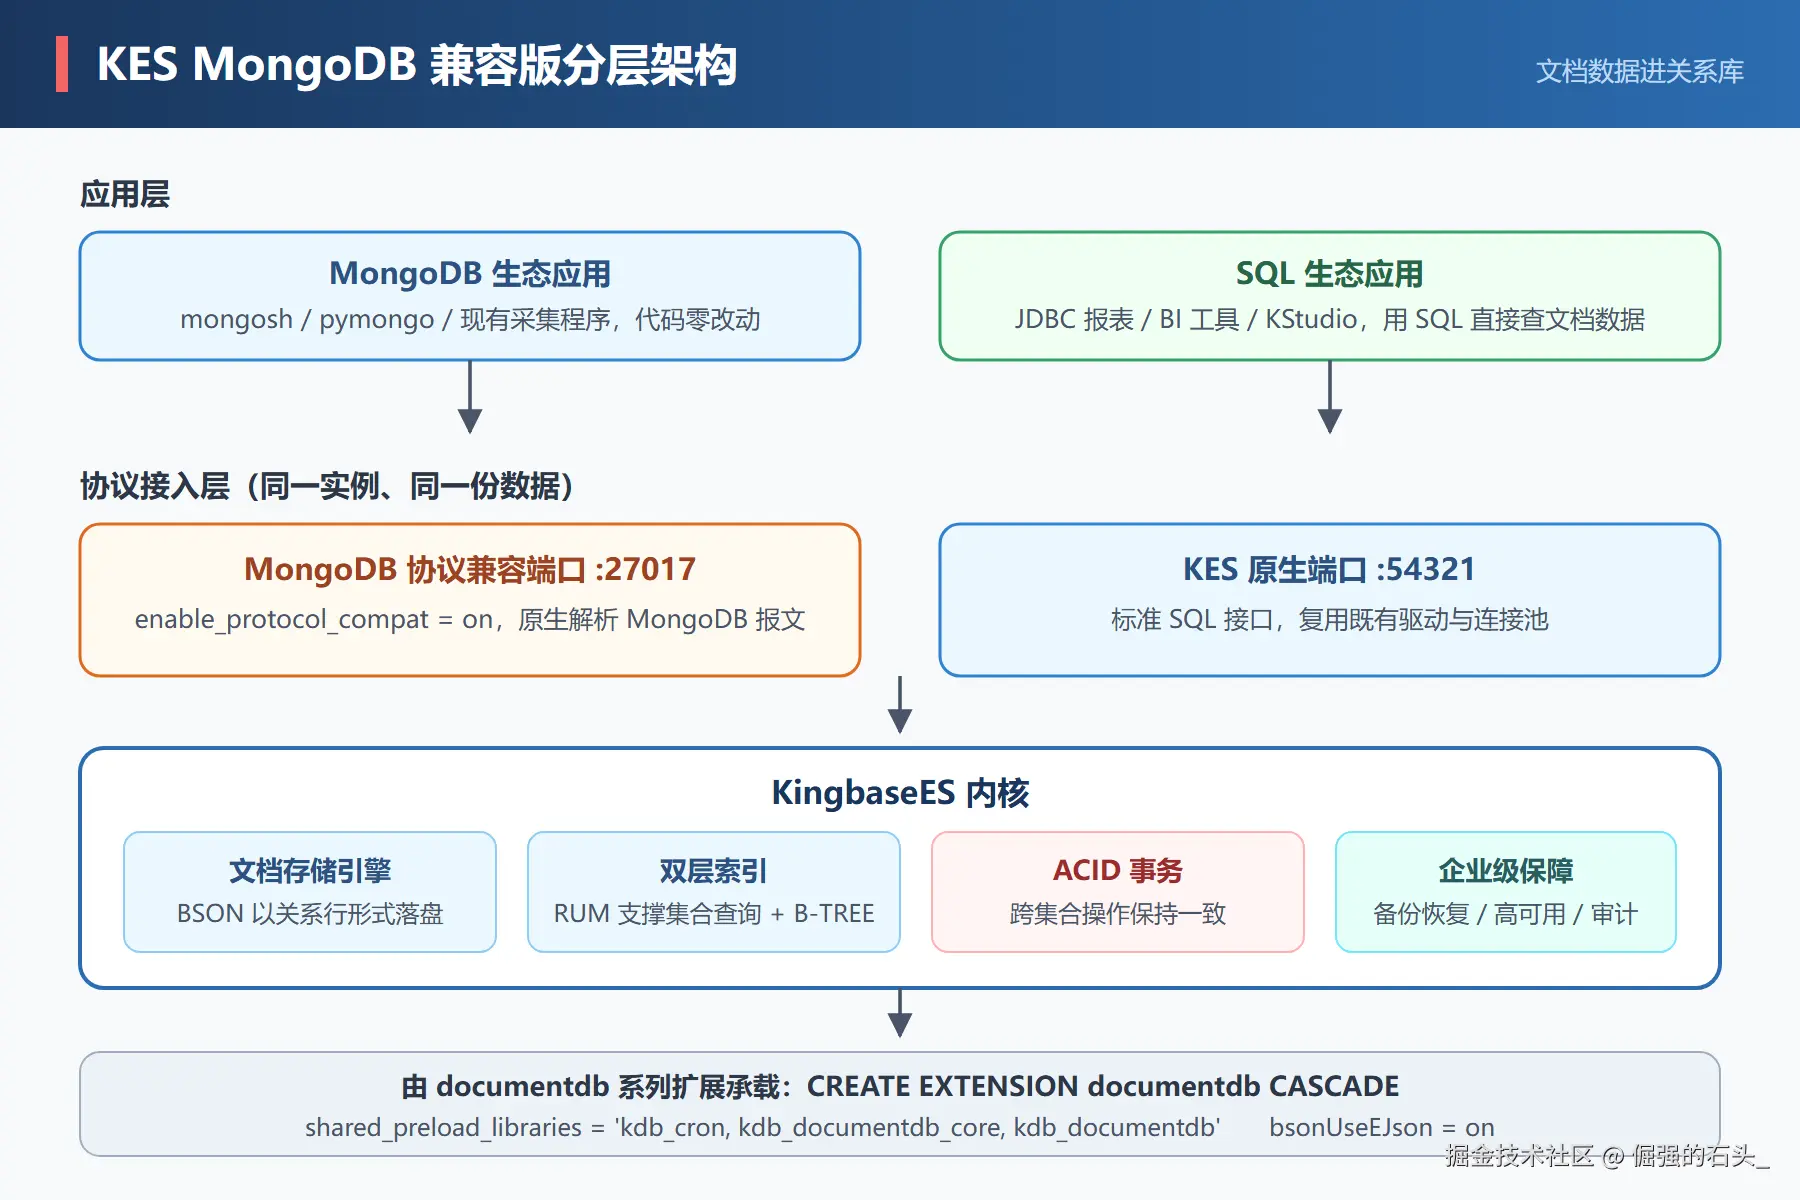
从上往下看:应用层基于MongoDB驱动的程序不用改,只要把连接指向改到KES就行。网络层和协议层,KES内置了MongoDB协议组件,在27017端口直接应答MongoDB原生协议的请求,和KES自己的54321端口并存。语法层由不同的parser负责解析MongoDB命令。存储层是KES的数据模型层------文档数据、关系数据、向量数据、GIS数据,都在同一套存储引擎里。
这个设计里我最认可的一点是:文档数据在底层是以关系表形式存储的BSON类型。也就是说,应用看到的是collection和document,数据库看到的是table和row,两边说的其实是同一份数据。官方对这个能力的概括是"基于SQL的文档数据开发"------开发者可以用自己熟悉的SQL全功能去处理文档数据,而不是被锁死在某一种查询语法里。
官方公布的兼容口径我也核对了一遍:整体兼容度超过60%,常用方法兼容度100%。具体到命令分类,查询和写入命令7个全支持;更新操作符、投影操作符、聚合管道命令都是100%;聚合管道操作符169个支持了167个(98.82%),查询操作符32个支持31个。管理命令的支持率相对低一点(68.75%),不过常用的create、createIndexes、drop、dropDatabase都在支持列表里,缺的主要是fsync、convertToCapped这类低频命令。这种"常用100%、长尾按需补"的节奏,对存量应用迁移来说,其实是够用的。
顺带说一下工具生态:官方能力对比表里明确写了MongoDB Compass、NoSQL Manager、Navicat、mongocli这些开发工具,选择MongoDB数据源就可以直接连KES;Spring Data、Quarkus、Micronaut、Hibernate、pagehelper这些开发框架也在支持列表里。这一点很重要。为什么呢?因为迁移成本的大头往往仅仅只是应用代码和周边生态,从来不是数据库本身。
动手实测:把mongosh连上KES
光看资料不过瘾,我在自己的测试环境里把部署流程走了一遍。整体分三步:初始化配置、创建插件、客户端连接。
**第一步,配置kingbase.conf。**需要在配置文件里打开协议兼容开关,并且指定MongoDB协议的监听端口:
text
# kingbase.conf 中追加
enable_protocol_compat = on
extension_protocol_port = 27017
documentdb_core.bsonUseEJson = on
shared_preload_libraries = 'kdb_cron,kdb_documentdb_core,kdb_documentdb'改完重启数据库实例。这里有几个参数值得展开说一下:enable_protocol_compat是总开关;extension_protocol_port指定的是MongoDB协议的监听端口,默认对齐MongoDB习惯的27017;shared_preload_libraries要把文档库相关的三个插件加载进进程。
**第二步,创建插件。**用ksql连上数据库,一条命令把插件和依赖组件建齐:
sql
CREATE EXTENSION documentdb CASCADE;CASCADE会把依赖的底层组件一并创建,不用手动一个个去装。
**第三步,用mongosh连接。**连接串的写法和连真正的MongoDB几乎一样,只是端口后面接的是KES:
bash
mongosh "mongodb://system:你的密码@127.0.0.1:27017/dbname?authMechanism=SCRAM-SHA-256"连上之后,我按官方示例把基础操作跑了一遍,插入、查询、索引:
javascript
// 插入文档
db.products.insertMany( [
   { item: "card", qty: 15 },
   { item: "envelope", qty: 20 },
   { item: "stamps", qty: 30 }
] );

// 创建索引:item 字段会建立 RUM 索引
db.products.createIndex({"item":1})

// 条件查询
db.products.find({"item":"envelope"})

// 聚合管道
db.products.aggregate([
  { $group: { _id: "$item", total: { $sum: "$qty" } } },
  { $sort: { total: -1 } }
])
有几个实现细节我觉得挺有意思,值得单独说一说。
一个是_id的处理。每个文档插入的时候会自动生成object_id,KES会为它自动创建B-TREE索引,这点和MongoDB的行为是一致的。
另一个是索引类型的对应。createIndex对普通字段建的是RUM索引。同时呢,多维索引、文本索引、通配符索引、hash索引、2dsphere地理索引这些MongoDB的索引类型,在KES里都有对应的实现。对开发者来说,这些差异被藏在了命令层下面,写法完全一样。
还有事务。MongoDB自己的事务支持是什么情况呢?单文档是原生的,多文档需要额外条件。而KES继承的是关系型数据库的完整事务能力,多文档事务是数据库的基座能力,不依赖存储引擎的妥协实现。对于"文档数据也要参与业务事务"的场景来说,这是一个实打实的差异。
把上面这些对应关系整理成一张表,迁移评估的时候可以直接对着填:
| MongoDB 侧的概念 | KES MongoDB 兼容版里的实现 | 迁移时要关注什么 |
|---|---|---|
| database / collection / document | 库 / 表 / 行(BSON 类型存储) | 应用视角不变,DBA 视角换成关系模型 |
_id 字段 |
自动生成 object_id,自动建 B-TREE 索引 | 行为与 MongoDB 一致,无需处理 |
createIndex 普通索引 |
RUM 索引 | 写法不变,索引类型自动映射 |
| 多维/文本/通配符/2dsphere 索引 | 均有对应实现 | 命令层透明,写法完全一样 |
| 多文档事务 | 数据库基座事务能力 | 从"有条件支持"变成"默认可用" |
| mongosh / Compass / Spring Data | 原生协议直接支持 | 工具与框架只改连接指向 |
真正的价值:多模融合,让那两个库合成一个
回到开头我朋友那个报表难题。如果把文档数据收进KES,"下单用户的会员等级分布"就不再是跨库统计了。订单是关系表,用户画像是文档集合,它们在同一个数据库实例里,一条SQL直接关联:
sql
-- 订单表(关系数据)关联用户画像(文档数据)
SELECT o.user_id,
       p.profile->>'member_level' AS member_level,
       count(*) AS order_cnt,
       sum(o.amount) AS total_amount
FROM biz_order o
JOIN user_profile_doc p ON o.user_id = p.user_id::text
WHERE o.created_at >= '2026-10-01'
GROUP BY o.user_id, member_level
ORDER BY total_amount DESC
LIMIT 20;
这就是官方说的"多模态数据融合":文档模型和关系模型不是两个割裂的系统,而是同一个数据底座里的两种视图。原来需要"导出---清洗---关联"三步的统计,现在一步就到位了。中间表、定时同步任务、对账脚本,全部都可以不要了。
合并前后的链路变化,我画了一张对比图。我朋友看完这张图,就把POC排上了: 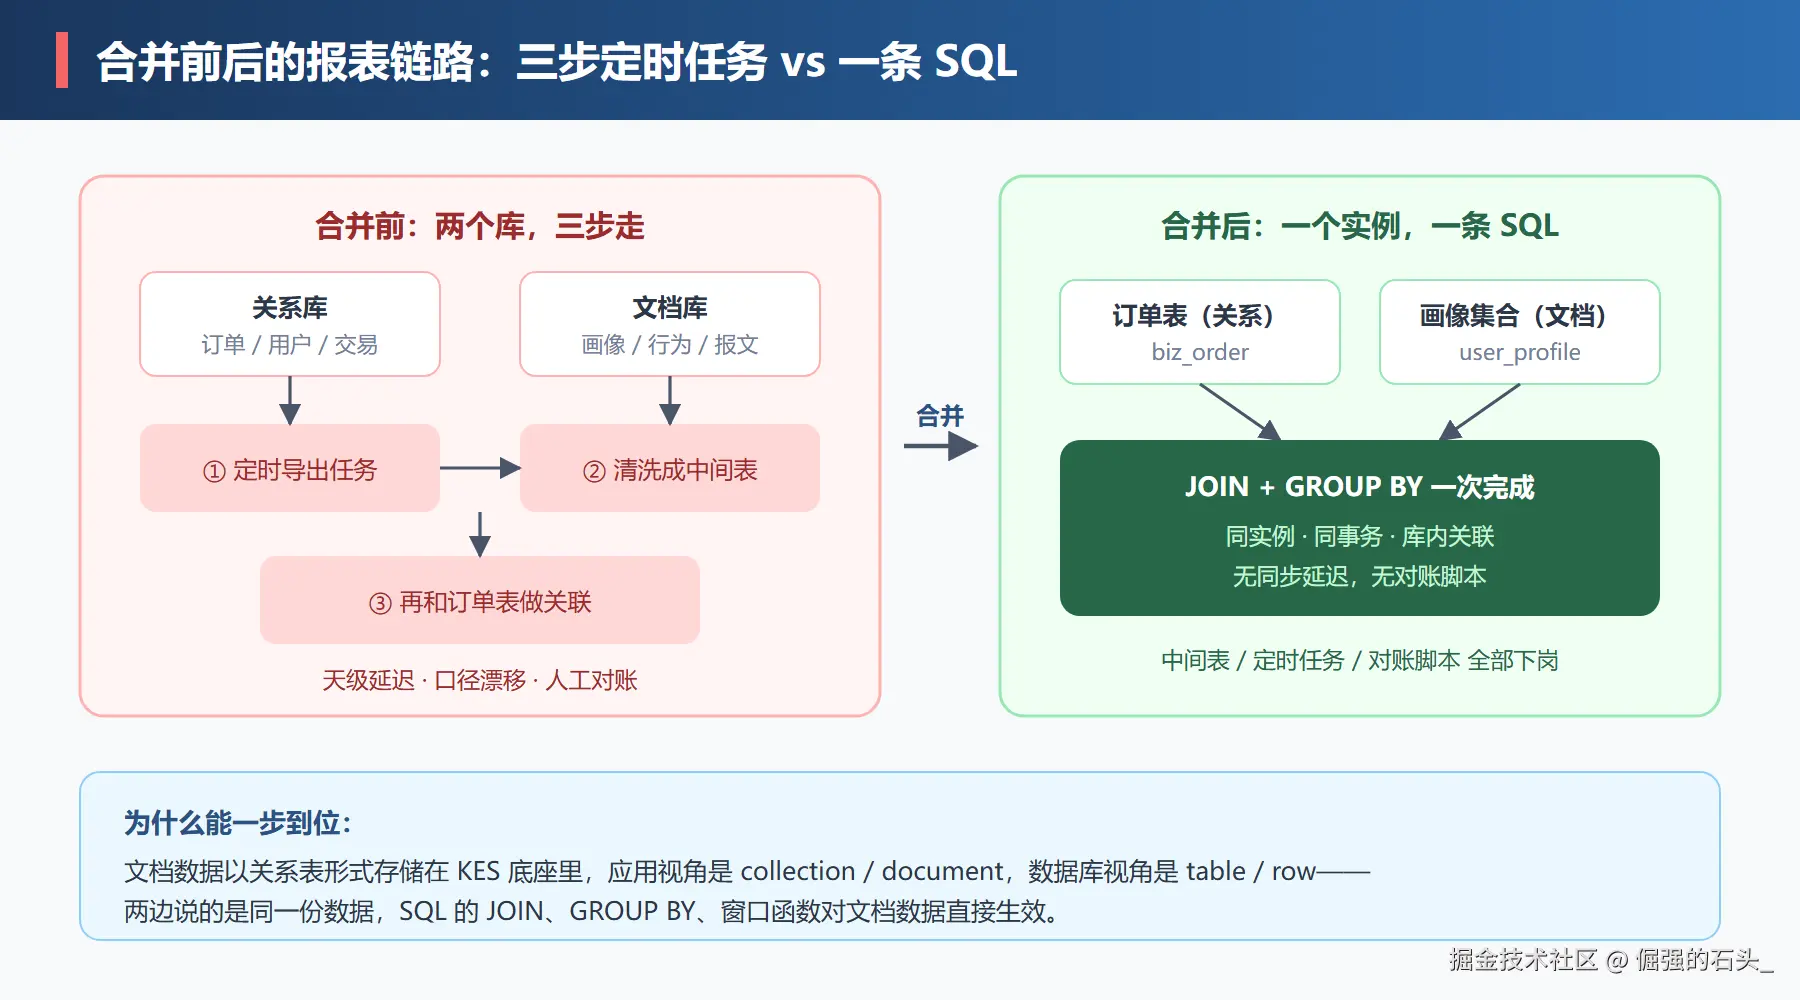
再往远看一点,KES的融合架构里还有向量模型、GIS模型、时序模型。也就是说,将来这个系统如果要加"商品图片以图搜图",或者加"门店位置分析",数据还是在这一个实例里,不需要再引入新的数据库品类。技术栈收敛带来的不只是运维上省事,还有数据一致性的确定性------所有跨模型的关联查询都是库内操作,不存在同步延迟这回事。
性能怎么看:一组需要客观呈现的数字
写性能对比这类内容,最容易犯的错误是只挑对自己有利的数字。这里我把官方资料里的性能对比完整放出来。同样的测试条件下,1万条数据量的时候,MongoDB与KES MongoDB兼容版的INSERT耗时分别是100ms和144ms,UPDATE是35ms和52ms,全表SELECT是24ms和38ms;10万条的时候INSERT是395ms对473ms,UPDATE是328ms对543ms;到了100万条,UPDATE的差距进一步拉大,是3083ms对6413ms。 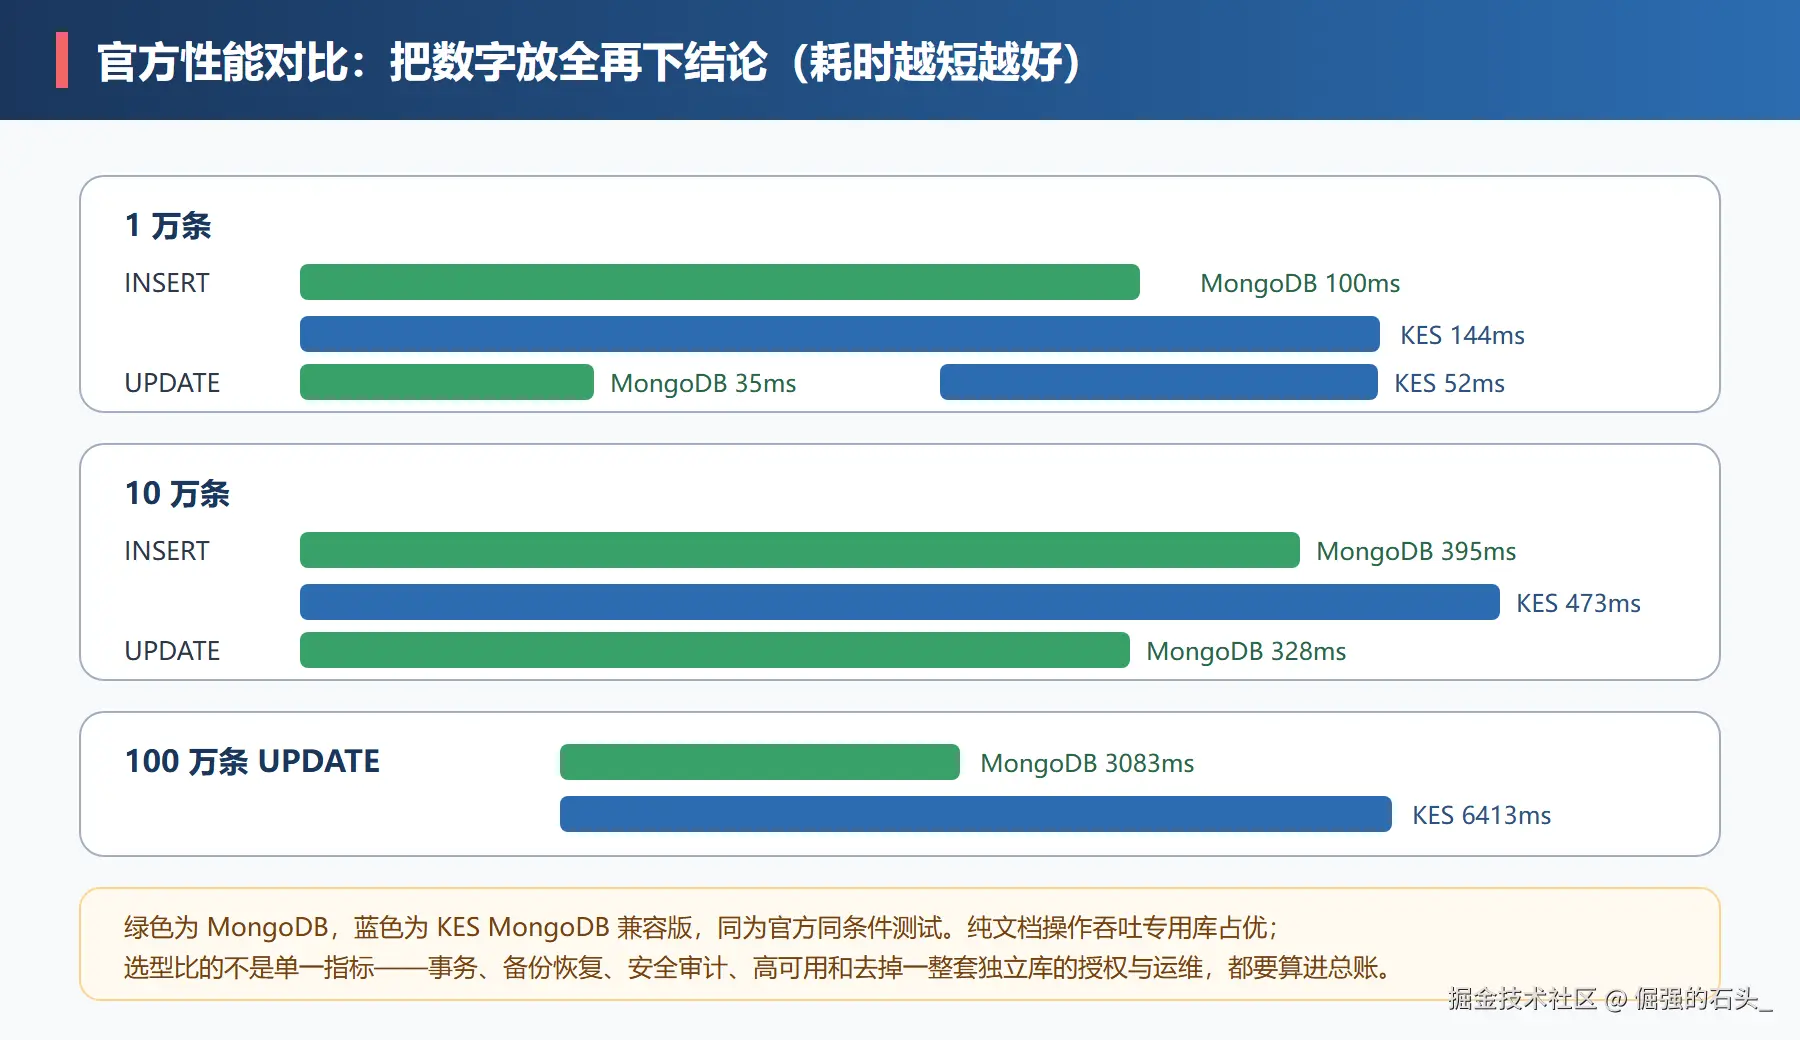
数字要说实话:纯文档操作的吞吐,专用文档库目前是有优势的。这也符合"专用引擎在单一负载上做到极致"的普遍规律。但是选型从来不是单一指标的比拼。KES MongoDB兼容版换来的,是文档数据获得了完整的事务、备份恢复、安全审计、高可用能力------这些都是关系型数据库打磨了几十年的基座能力。同时呢,整套独立文档库的授权费用、运维人力和跨库同步链路也消掉了。用单点10%~40%的写性能让步,换掉一整个技术栈,这笔账在很多场景下是划算的。而对性能极度敏感的纯文档负载,官方的兼容度清单也提示了,这些场景可以继续观察后续版本。
还有一个迁移成本数字值得单独说:因为协议层是原生兼容,存量MongoDB应用迁移到KES,通常来说只需要修改驱动层的连接指向,应用代码"零修改"。官方对这件事的表述是"全栈兼容的文档数据库平替,保留所有既有用户生态"。
写在最后
这一轮调研下来,我对"MongoDB迁移"这件事的态度,从一开始的怀疑,变成了有条件的认可。条件是什么呢?你的场景需要的是"文档数据与业务数据融合"、"技术栈收敛"、"企业层级里的能力补齐",那把文档数据放进一个协议兼容、SQL全功能的多模数据库,就是一条值得认真评估的路。KES MongoDB兼容版把这条路做成了工程实现:mongosh直接连,驱动直接换指向,Spring Data这些框架原生支持,迁移的动作被压缩到了配置层面。
我朋友的项目已经决定先拿测试环境做POC了,重点验证他们那批深嵌套文档的查询性能,还有聚合管道的兼容度。等结果出来,我再把后续的踩坑记录补上。