手机里的照片越存越多,整理起来却越来越费时间。
旅行回来拍了几百张,活动现场连拍了一大批,或者准备把扫描件送去识别文字------真正开始整理时,经常要先做一件事:把明显拍糊的图片找出来。
逐张打开看很直观,可数量一多,就变成了重复劳动。
这次,我做了一个 Windows 桌面小工具:模糊照片筛选助手。让模型先给照片分个组,再由我们看图、校对,最后导出整理好的副本。
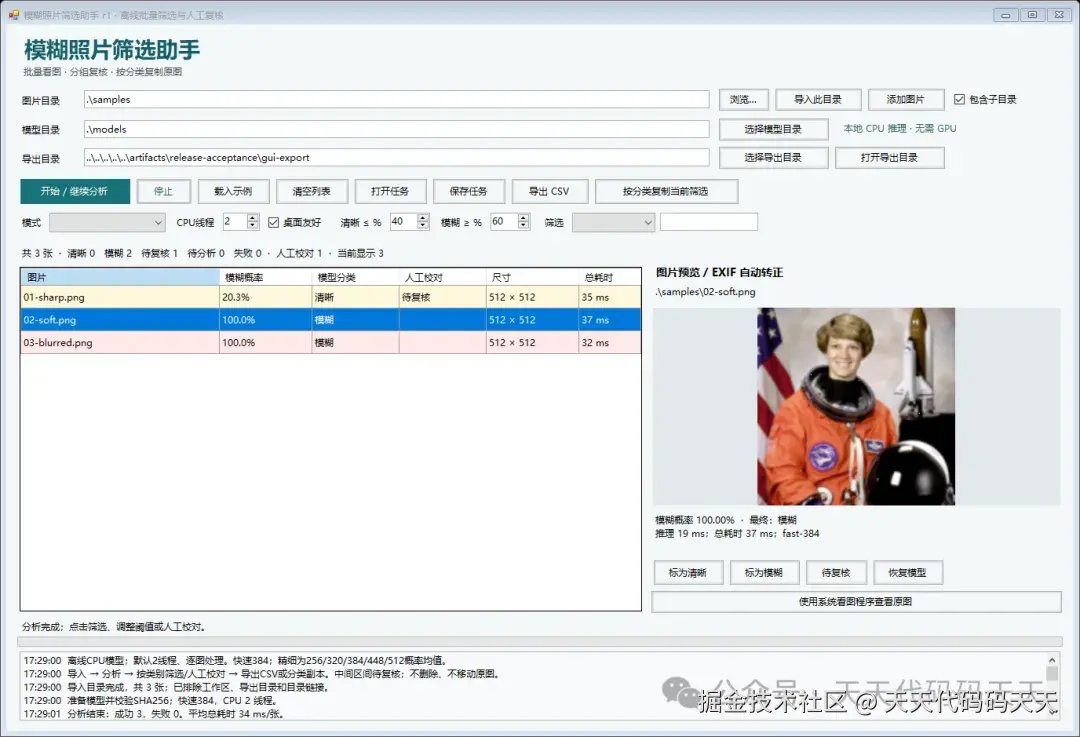
模糊照片筛选助手界面
先分组,再看图
软件的使用流程很简单:
导入图片 → 分析模糊程度 → 筛选与人工校对 → 导出结果。
可以一次添加几张图片,也可以导入整个文件夹、包含子目录;把图片或文件夹直接拖进窗口也可以。
分析后,列表会显示每张图片的模糊分数、模型分类、尺寸和耗时。默认分成三组:
- 清晰:模糊分数不高于 40%。
- 模糊:模糊分数不低于 60%。
- 待复核:处在中间区间,需要自己再看一眼。
这里特意保留了"待复核"。有些照片主体清楚、背景虚化,有些照片使用了柔焦效果,只靠一个分数很难判断它是否值得留下。
点击列表里的图片,右侧就能预览;需要查看细节时,还可以调用系统看图程序打开原图。手机照片会按 EXIF 方向信息自动转正。
判断标准可以自己调
每个人整理照片的目的不一样。
家庭相册更看重回忆,一点轻微模糊未必影响保留;准备做 OCR 的文档照片,则可能需要更清楚的文字边缘。
所以,界面上提供了"清晰上限"和"模糊下限"两个设置。可以先用默认值跑一批,再根据自己的照片调整。
调整阈值会直接更新分类,不需要重新跑模型。
如果某张照片的判断不符合预期,可以手动标为"清晰""模糊"或"待复核";按住 Ctrl、Shift 多选后,也能批量校对。想撤销自己的标记,点击"恢复模型"即可。
软件分别保存模型分数和人工分类,最终整理时采用人工校对后的结果。
整理结果时,保留原图
筛选完成后,有两种导出方式。
第一种是导出 CSV。 文件名、路径、模糊分数、模型分类、人工分类和最终分类等信息都可以放进表格,方便继续统计、检查。
第二种是按分类复制图片。 例如,先筛选"清晰",再点击"按分类复制当前筛选",就能把这一组图片复制到新的导出目录;选择"全部",则会按各自的最终分类整理副本。
软件会保留来源子目录,并给文件名补上用于区分来源的短摘要,减少同名图片发生冲突的情况。
原来的照片仍保留在原位置。你可以检查整理出的副本,再决定后续怎样管理相册。
图片较多时,可以中途停止,也能保存任务以后再打开。模型、分析模式和原图内容都没有变化时,继续分析会复用已算出的结果。
不用显卡,CPU 就能跑
这次选择的是一个比较轻量的分类模型,导出的 ONNX 模型约 17 MB,完整运行压缩包约 22 MB。
软件提供两种分析模式:
- 快速模式:把图片缩放到 384×384,做一次模型推理,适合先筛一遍。
- 精细模式:在五个尺度上分别分析,再综合结果,适合拿来对比一些边界样本。
精细模式需要更多计算,也不保证每张照片的判断都会更好,可以根据自己的素材选择。
默认使用 CPU 2 线程,还提供"桌面友好"选项,在图片之间稍作休息,方便边整理、边做其他事情。
在本机的 512×512 示例测试中,快速模式稳态模型推理约十几毫秒一张,包含读图和预处理的总耗时为几十毫秒。首张加载、原图尺寸、硬盘和电脑配置都会影响实际速度,这组小样本数据仅供参考。
模型是怎样判断的?
这个工具使用了开源项目 MagikaDocumentFromPixel 的公开训练权重,核心是 MobileNetV3-Large + FreqAux。
可以把它理解成:模型同时观察图片内容和边缘变化,学习清晰图像与模糊图像之间的区别。
其中,FreqAux 会从图像中提取拉普拉斯边缘信息,经过标准化后作为辅助通道,与图像内容一起送入网络。网络输出清晰、模糊两类分数,再由软件结合阈值完成分组。
在工程上,我把 PyTorch 权重转换成了 ONNX,通过 ONNX Runtime 在 CPU 上推理 ;外层使用 C# WinForms,负责导入、预览、校对、任务保存和导出。
公开模型提供了起点,桌面软件把这些步骤串成了一个可以直接使用的流程。
看一个随包示例
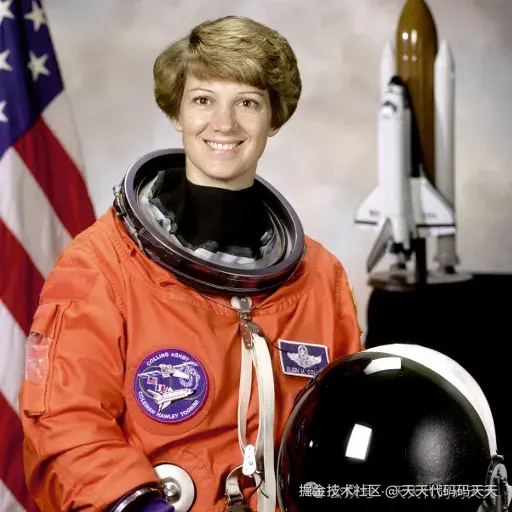
下面的原图来自 NASA 的公开宇航员照片,经由 scikit-image 示例数据获取。软件随包附带了原图,以及人为添加高斯模糊的版本。
示例原图:
NASA公开示例原图
加入高斯模糊后的版本:
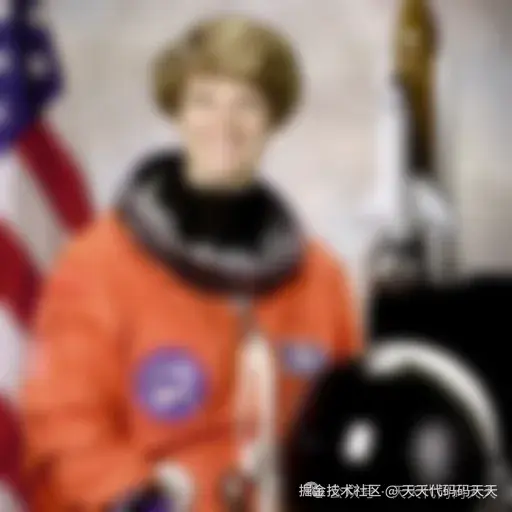
人为加入高斯模糊的示例
在这一组受控示例里,快速模式给原图的模糊分数约为 20%,加入模糊后接近 100%。这可以帮助观察处理流程,但不能用来代表现实照片的识别准确率。
模型主要在运动模糊数据上训练,对失焦、噪声、压缩、插画、背景虚化和艺术柔焦等情况,判断可能出现偏差。界面显示的"模糊概率"应当作为辅助分数使用,结合预览和人工校对更合适。
怎样开始使用?
目前这一版适用于 Windows 10/11 x64,需要 .NET Framework 4.8 。完整解压运行包后,双击 BlurPhoto.Workshop.exe 即可启动。
模型与推理依赖已经放进运行包,日常使用无需安装 Python,也不需要 GPU、API 密钥或联网推理,照片在本机处理。
第一次使用,可以按这个顺序试一下:
- 点击"载入示例",熟悉列表、预览和分类结果。
- 选择"快速"模式、CPU 2 线程,点击"开始 / 继续分析"。
- 导入一小批自己的照片,看看默认阈值是否合适。
- 调整阈值、校对边界样本,再导出 CSV 或分类副本。
程序支持 JPG、JPEG、PNG、BMP,以及 TIFF 的首帧。HEIC、RAW 等格式需要先转换为支持的图片格式。
也给 C# 开发者留了一份完整源码
这一版同时整理了 完整 VS2022 解决方案:
- C# WinForms,目标框架为 .NET Framework 4.8。
- 窗体保留
.Designer.cs,方便继续调整界面。 - 模型、输出和工作目录默认使用相对路径,工作区位于 exe 目录下。
- 随源码提供 ONNX 模型、推理依赖及模型接入记录。
打开解决方案,选择 Release | x64 即可编译;普通使用和编译都不需要安装 PyTorch。
这一版已经做了模型数值对齐、批处理、停止续跑、分类复制、设计宿主检查,以及源码包独立解压后的重新编译验证。喜欢研究本地模型部署的朋友,也可以从图片预处理、模型调用和结果校对这些部分入手。
模型项目地址:
MagikaDocumentFromPixel(github.com/bradduy/Mag...
感谢原作者公开模型与源码,让我们可以在此基础上继续做实用的小工具。
运行包和完整源码包已经整理好。欢迎加入 QQ 群 "天天代码码天天" ,一起交流软件使用和 C# 桌面开发。
群号码:264292622
如果你也有一个一直没空整理的照片文件夹,可以先拿一小批试试,让模型帮忙缩小需要逐张查看的范围。