一句话看懂
项目地址:github.com/NVIDIA/auto...
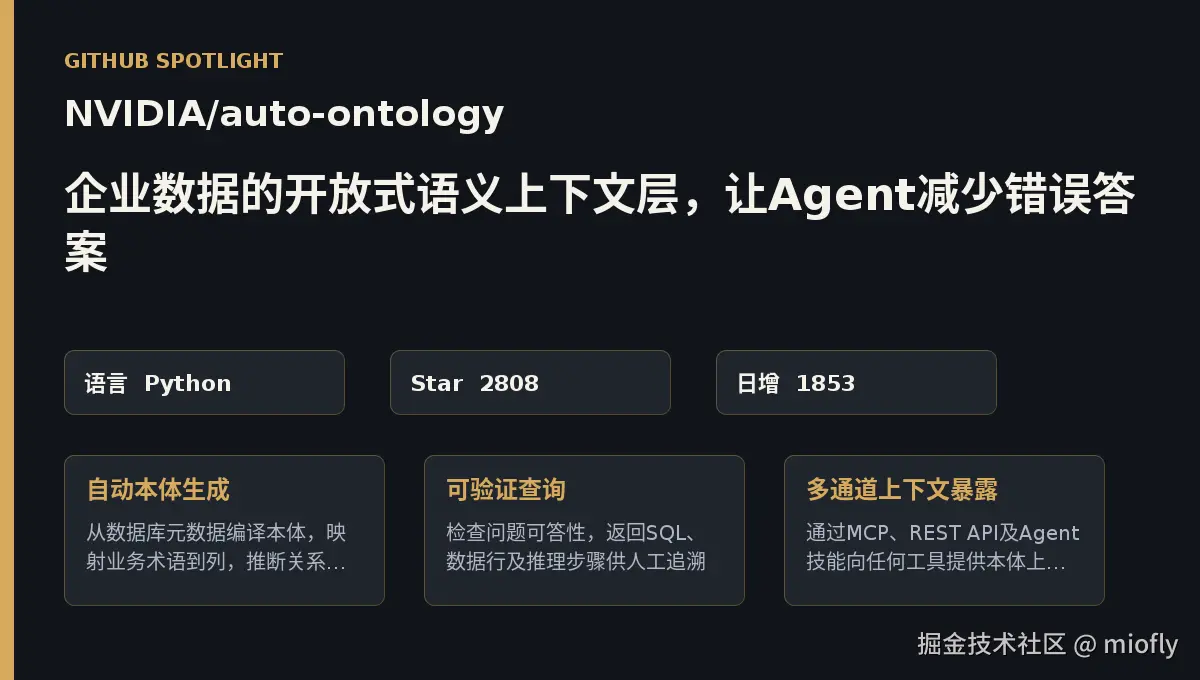
auto-ontology 是为企业数据库生成语义本体的工具,让 AI Agent 用业务术语提问并得到可追溯的 SQL 答案。自动从元数据提取术语、推断关系,回答前检查问题是否能从现有数据得出,把查询步骤和数据来源一并返回。Apache-2.0 许可,但 CONTRIBUTING.md 明确不接受外部贡献,需自行 Fork 使用。
前端端口 3000,后端 3001,摄取服务 3002,MCP 服务 3003。依赖 NVIDIA API 密钥(nvapi-...)用于自然语言转 SQL,兼容 Apache Ossie 标准的语义模型 YAML 导入导出。伴生仓库 auto-ontology-eval 在 BIRD 等基准上对比本体与裸 Schema 的精度。
它解决什么问题
直接把数据库 Schema 塞进 LLM prompt 会遇到三个障碍:业务术语与列名的映射是隐性知识,大表数量会撑爆 token 预算,LLM 即兴生成的 JOIN 无法判断业务逻辑是否正确。当问题涉及的数据根本不存在时,模型仍会编造 SQL 返回空结果,用户无法区分"数据为零"和"无法回答"。
auto-ontology 在数据库前加一层编译好的语义索引。术语表记录"Revenue"映射到 sales.invoicelines.extendedprice,关系表记录 Invoice Line 通过 invoiceid 连接到 Invoice。问答流程先用 pgvector 检索相关术语和列,再让 LLM 只在候选表内生成 SQL。当用户询问 ROAS 时,系统计算 coverage 为 0.5,Agent 提示"无广告支出数据"并拒绝回答,避免幻觉。
执行后返回的不只是数字,还包括完整 SQL、命中的术语列表、JOIN 路径和数据行数,供人工追溯每一步推理。
核心概念速览
Semantic Compilation 从元数据中生成术语、关系和 SQL 属性。compile.py 编译术语、推断外键、建议 SqlAttribute、构建桥接表(Bridge Table,用于连接非直接关联的表)。注释警告外键解析和 SQL 属性阶段可能超过 300 秒。
Text-to-SQL Graph 将自然语言问题转为 SQL 的多 Agent 工作流。text_to_sql_graph.py 用 LangGraph 编排分类、检索候选、生成 SQL、验证修复、执行等节点。状态图从 QuestionIntentAgent 开始,路由至 CandidateRetrievalAgent 检索相关术语,SQLFromCandidatesAgent 在候选表内生成查询,SQLValidationAgent 解析检查,失败则路由回重构,最多七轮后标记为 unconstructable。
Answerability Check 判断问题能否从现有数据回答。coverage 0.5 表示问题涉及的术语只有一半存在于本体中,Agent 据此拒绝回答。这一机制区分"数据为零"和"无法计算"两种情况。
PQL (Prediction Query Language)是 Kumo 预测模型的查询语言。当问题涉及 churn 或 forecast 时,pql_gen.py 生成 PQL 及可选的实体筛选 SQL,调用 KumoRFM predict 接口执行预测。需配置 KUMO_RFM_API_URL 指向 Universal TFM NIM,不支持旧版 kumo-rfm。
架构拆解
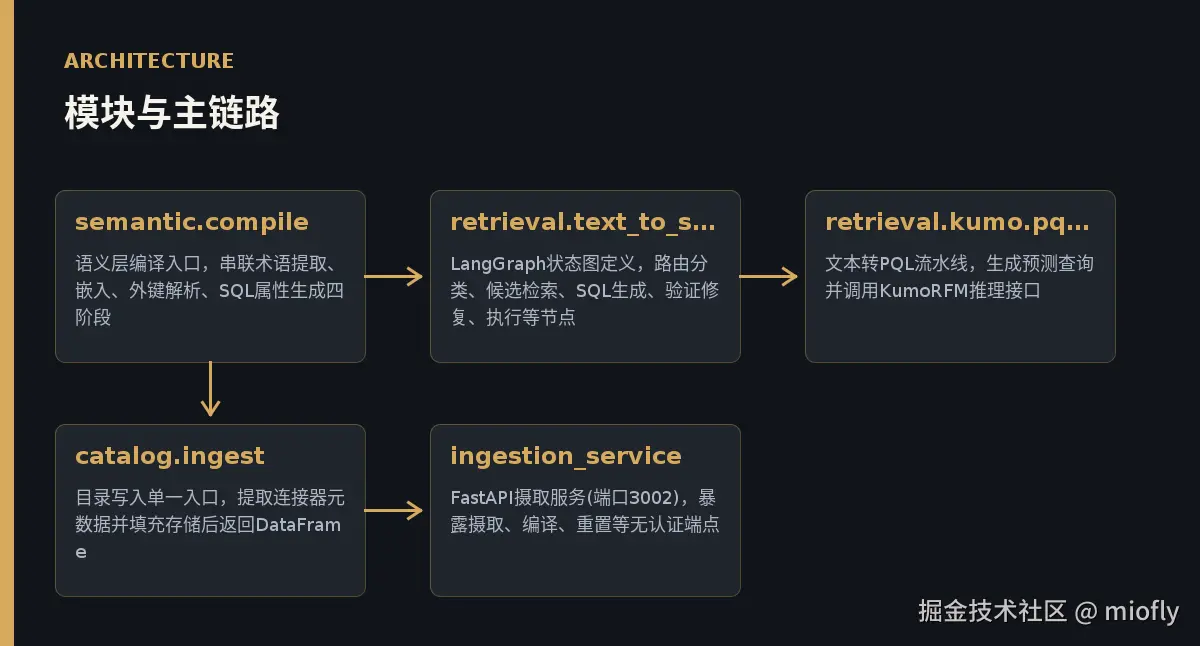
系统分五个模块,按数据流依次协作。
catalog.ingest 是目录写入入口,提取连接器元数据(表、列、类型)并填充存储后返回 DataFrame。摄取完成后触发语义编译。
semantic.compile 串联术语提取、嵌入、外键解析、SQL 属性生成四阶段。并发受 SEMANTIC_LLM_MAX_INFLIGHT 控制,默认 6。编译输出的本体供问答图检索使用,存储在 Postgres + pgvector 中。
retrieval.text_to_sql_graph 定义 LangGraph 状态图,路由分类、候选检索、SQL 生成、验证修复、执行等节点。预测意图问题路由至 PQL 生成,常规问题走 SQL 流水线。
retrieval.kumo.pql_gen 处理文本转 PQL 流水线,生成预测查询并调用 KumoRFM 推理接口。
ingestion_service 是 FastAPI 摄取服务,监听端口 3002,暴露摄取、编译、重置等无认证端点。调度器周期触发摄取任务,适合内网自动化场景。
模块间边界清晰:catalog.ingest → semantic.compile → retrieval.text_to_sql_graph → kumo.pql_gen,ingestion_service 从上游触发 catalog.ingest。状态存储和嵌入检索都依赖 Postgres + pgvector。
关键实现走读
语义编译入口与并发控制
python
def run_semantic_compilation(
    database_name: str,
    *,
    domain_summary: DomainSummary | None = None,
) -> int:
    """Compile semantic taxonomy, embed all nodes into the VDB, then resolve FK edges.

    Returns the number of tables processed.
    """
    with limit_inflight(SEMANTIC_LLM_MAX_INFLIGHT):
return _run_semantic_compilation(database_name, domain_summary=domain_summary)接受数据库名和可选的领域摘要,启动语义编译流程并返回处理的表数量。limit_inflight 上下文管理器限制并发 LLM 调用数,默认 6。语义编译需大量 LLM 调用(提取术语、推断关系、生成 SQL 属性),SEMANTIC_LLM_MAX_INFLIGHT 平衡吞吐与成本。无限制并发会耗尽 API 配额或触发速率限制,触发 NVIDIA API 的 429 错误,导致编译失败或部分术语缺失。
SQL 验证路由与重构上限
python
def route_sql_validation(state: AgentState) -> str:
    if state["decision"] == "unconstructable":
        return "unconstructable"

    path_state = state["path_state"]
    failed_attempt_count = len(path_state.get("failed_attempts") or [])

    if state["decision"] == "invalid_sql":
        logger.info("SQL reconstruction attempts completed: %s", failed_attempt_count)
        if failed_attempt_count >= MAX_RECONSTRUCTION_ATTEMPTS:
            logger.error(
                "SQL construction failed after %s reconstructions",
                failed_attempt_count,
            )
            return "unconstructable"
        return "invalid_sql"

    return "valid_sql"
根据 SQL 验证结果决定下一步。decision 为 valid_sql 时继续执行,invalid_sql 时检查失败次数,超过 MAX_RECONSTRUCTION_ATTEMPTS(7)则标记为 unconstructable,否则返回 invalid_sql 触发重构。LLM 生成的 SQL 可能存在语法错误、表不存在、意图偏离等问题。验证失败后让 LLM 根据错误信息重构比直接放弃成功率更高,但无限重试会陷入循环。七轮是经验阈值,覆盖常见错误但避免无效消耗。
动手上手
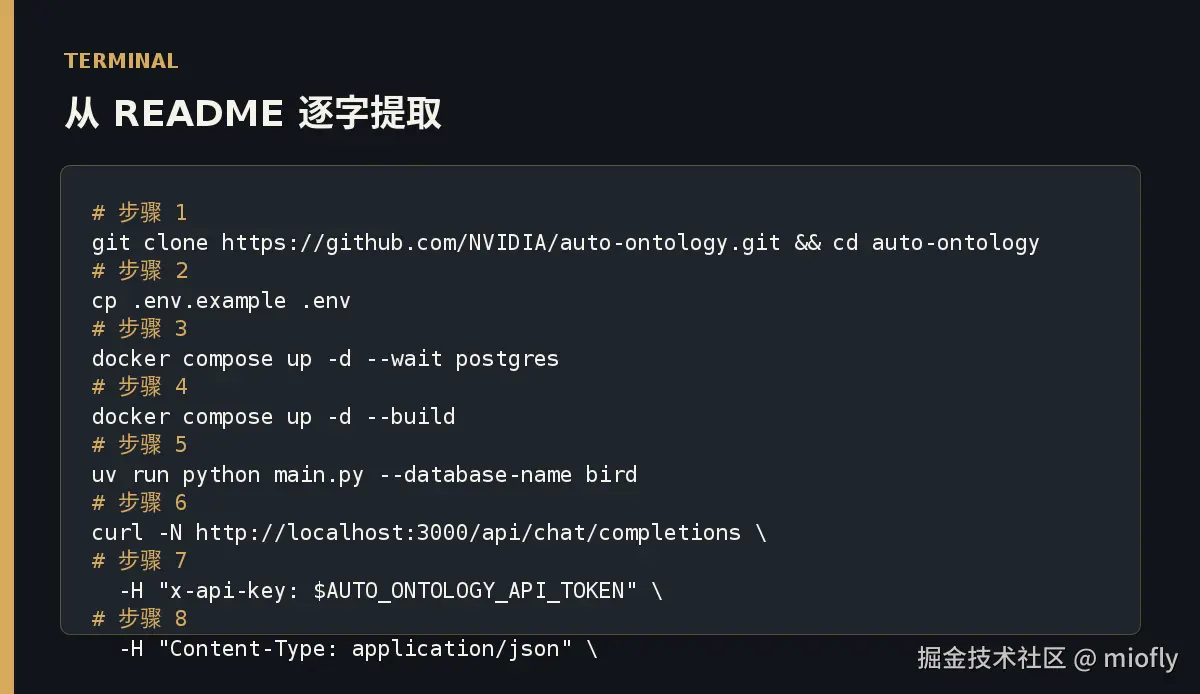
本地部署完整栈
bash
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env
编辑 .env,填入 DEFAULT_MODELS_API_KEY=nvapi-...(NVIDIA API 密钥)。启动 Postgres 并加载样本库:
bash
docker compose up -d --wait postgres运行 seed_wwi.py 将 Wide World Importers 写入 wideworldimporters 库。启动全部服务:
bash
docker compose up -d --build浏览器打开 http://localhost:3000,进入 Settings → Semantic Compilation,点击开始编译。后台调 compile.py 生成术语和关系,耗时视表数量而定(FK 解析可能超 300 秒)。编译完成后 Chat 页面可提问。
验证问答质量
在 Chat 输入:
rust
What was the revenue for USB food flash drive - sushi roll in Pennsylvania in June 2015?预期返回包含答案、完整 SQL 和 Steps。Steps 部分显示 Agent 检索到的术语、构建的 JOIN 路径和验证步骤,供人工审计。若询问本体中不存在的数据,系统会返回 coverage 0.5 并拒绝回答。
通过 API 集成
bash
curl -N http://localhost:3000/api/chat/completions \
  -H "x-api-key: $AUTO_ONTOLOGY_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"question": "How many orders shipped last week?"}'
AUTO_ONTOLOGY_API_TOKEN 在 .env 中设置。返回 JSON 包含 SQL、answer、steps 字段,可直接嵌入业务系统。
配置 MCP 供 Cursor 或 Claude Desktop 调用
编辑 mcp.json:
json
{
  "mcpServers": {
    "auto-ontology": {
      "command": "node",
      "args": ["path/to/auto-ontology/mcp/dist/index.js"],
      "env": {
        "MCP_SERVER_PORT": "3003"
      }
    }
  }
}
Cursor 或 Claude Desktop 重启后可调 check_answerable 和 ask_question 工具。首次调用弹窗登录 Auto-Ontology,token 存本地。端口 3001 和 3002 需保持私有网络。
应用场景
业务指标问答:数据分析师在 Chat 输入"上月 Revenue"或"昨日订单数",Agent 解析术语后生成可追溯 SQL,返回数值、计算逻辑和数据来源。
Agent 集成 MCP:Cursor 或 Claude Desktop 配置 mcp.json 指向端口 3003,调 check_answerable 和 ask_question 工具。开发者在编辑器内直接提问业务数据。
预测型查询:配置 KUMO_RFM_API_URL 后可询问 churn 或 forecast 问题,路由至 pql_gen.py 生成 PQL 调 KumoRFM。需 Universal TFM NIM serving kumo-relational 模型。
语义模型迁移:从其他语义层工具(Cube.js、LookML)导出 Apache Ossie YAML,导入 auto-ontology 复用现有术语定义。
独立分析
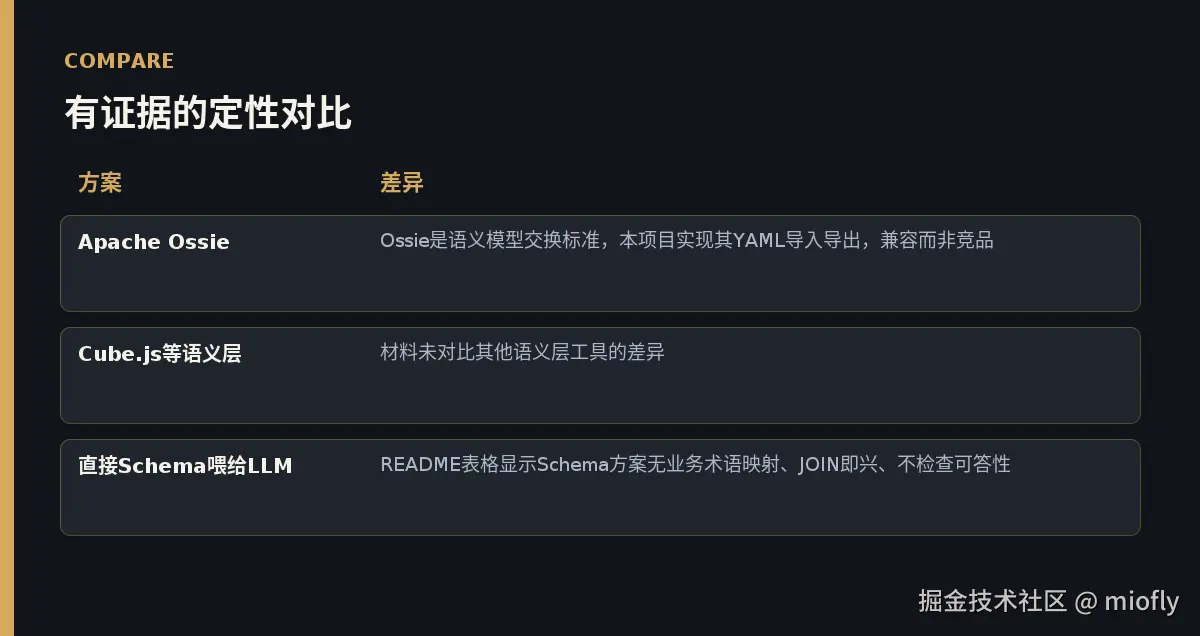
比 Schema-in-prompt 节省 token 且语义更准确。直接 Schema 方案随数据库扩张线性增长 token 消耗,auto-ontology 只检索相关术语对应的表。直接 Schema 方案无业务术语映射、JOIN 即兴、不检查可答性,容易生成语法正确但业务逻辑错误的 SQL。
编译四阶段的 FK 和 SqlAttribute 阶段可能超 300 秒。外键推断需遍历列名、数据类型、值分布进行启发式匹配,大型数据库(数百张表)编译一次可能数小时。
SQL 重构最多七轮后标记为 unconstructable。七轮覆盖常见错误但无法解决根本性缺陷。实测中复杂多表 JOIN 问题可能在第五轮仍失败,而简单问题通常首轮通过。
局限与风险
当前不接受外部贡献,需 Fork 后自行维护。CONTRIBUTING.md 明确说明项目内部开发,外部 PR 会被关闭。企业若依赖此项目需评估长期维护能力。
端口 3001 和 3002 无认证,部署时必须保持私有网络隔离。摄取服务暴露重置端点,恶意请求可删除全部本体。
预测功能依赖 NVIDIA NIM 授权与 Universal TFM kumo-relational 模型。pql_gen.py 的 _prediction_enabled 函数检查 KUMO_RFM_API_URL 是否配置,未配置时预测型问题直接失败。NIM 授权需企业协议。
UI 在重启后可能因旧 cookie 无法加载导航,需手动清除 localhost:3000 site data。前端基于 Better Auth 的 RBAC,session 存储在 Postgres,但浏览器缓存与数据库状态不同步时会出现白屏。
结论卡片
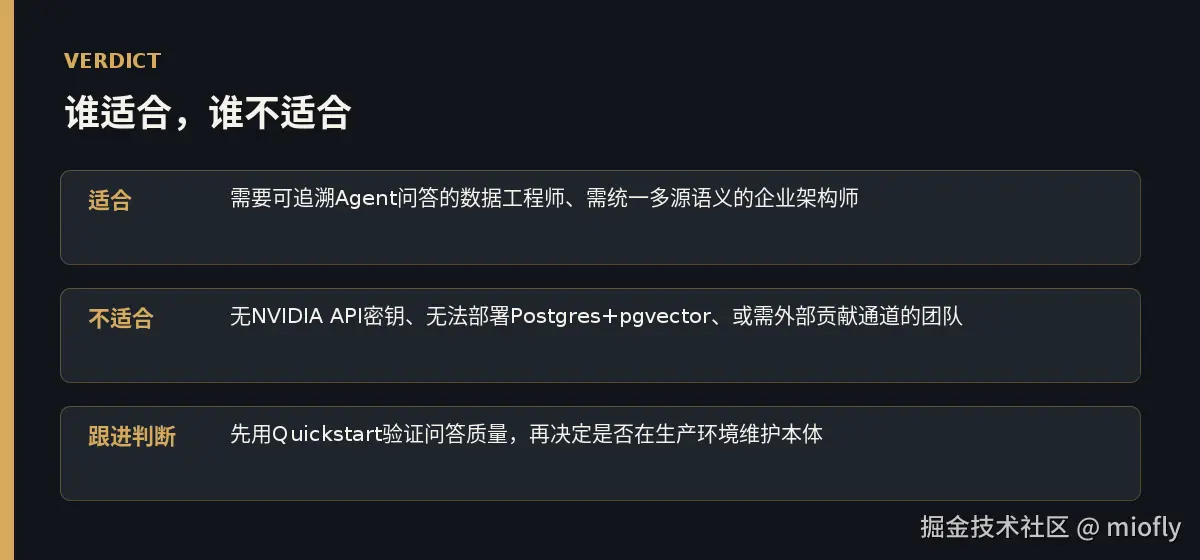
适合需要可追溯 Agent 问答的数据工程师、需统一多源语义的企业架构师。Python 3.12+ 环境,有 NVIDIA API 密钥和 Postgres + pgvector 部署能力。不适合无 NVIDIA API 密钥、无法部署 Postgres + pgvector、或需外部贡献通道的团队。
先用 Quickstart 验证问答质量,观察术语覆盖率和 SQL 准确性,再决定是否在生产环境维护本体。初次编译耗时长(可能数小时),但后续问答受益明显。端口 3001 和 3002 必须私有网络隔离。
项目地址:github.com/NVIDIA/auto...
原文地址:tools.wflynn.cn/aitools/git...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: