在 MongoDB 数据同步中,我们经常会遇到这样的需求:两个数据库实例都需要处理业务写入,同时又希望彼此保持数据同步。比如在跨地域业务部署中,不同地区的应用分别向本地 MongoDB 写入数据,再将变更实时同步到另一端。
乍一看,只需要建立两条方向相反的数据同步任务。但你还需要考虑,当 A 的数据同步到 B 后,B 会不会再次把这条数据同步回 A? 如果没有相应的处理机制,数据就可能在两个实例之间反复回流,影响同步任务的稳定性。
针对这一问题,数据迁移同步工具 CloudCanal 提供了 MongoDB 双向同步方案,通过 MongoDB Change Stream 和事务标识识别同步任务自身产生的写入,避免数据循环。
下面就从实现原理到具体配置,一起来看看如何实现。
MongoDB 双向同步,难点在哪里?
MongoDB 双向同步通常需要建立两条方向相反的数据链路:A → B 和 B → A,让两个实例都能接收业务写入,并将数据变更同步到另一端。
两条链路同时运行时,就需要考虑数据循环的问题。例如,A 的数据同步到 B 后,B 的同步任务可能再次捕获这次写入,并将数据回传到 A,导致同一笔变更反复同步,增加系统负担,甚至影响同步稳定性。
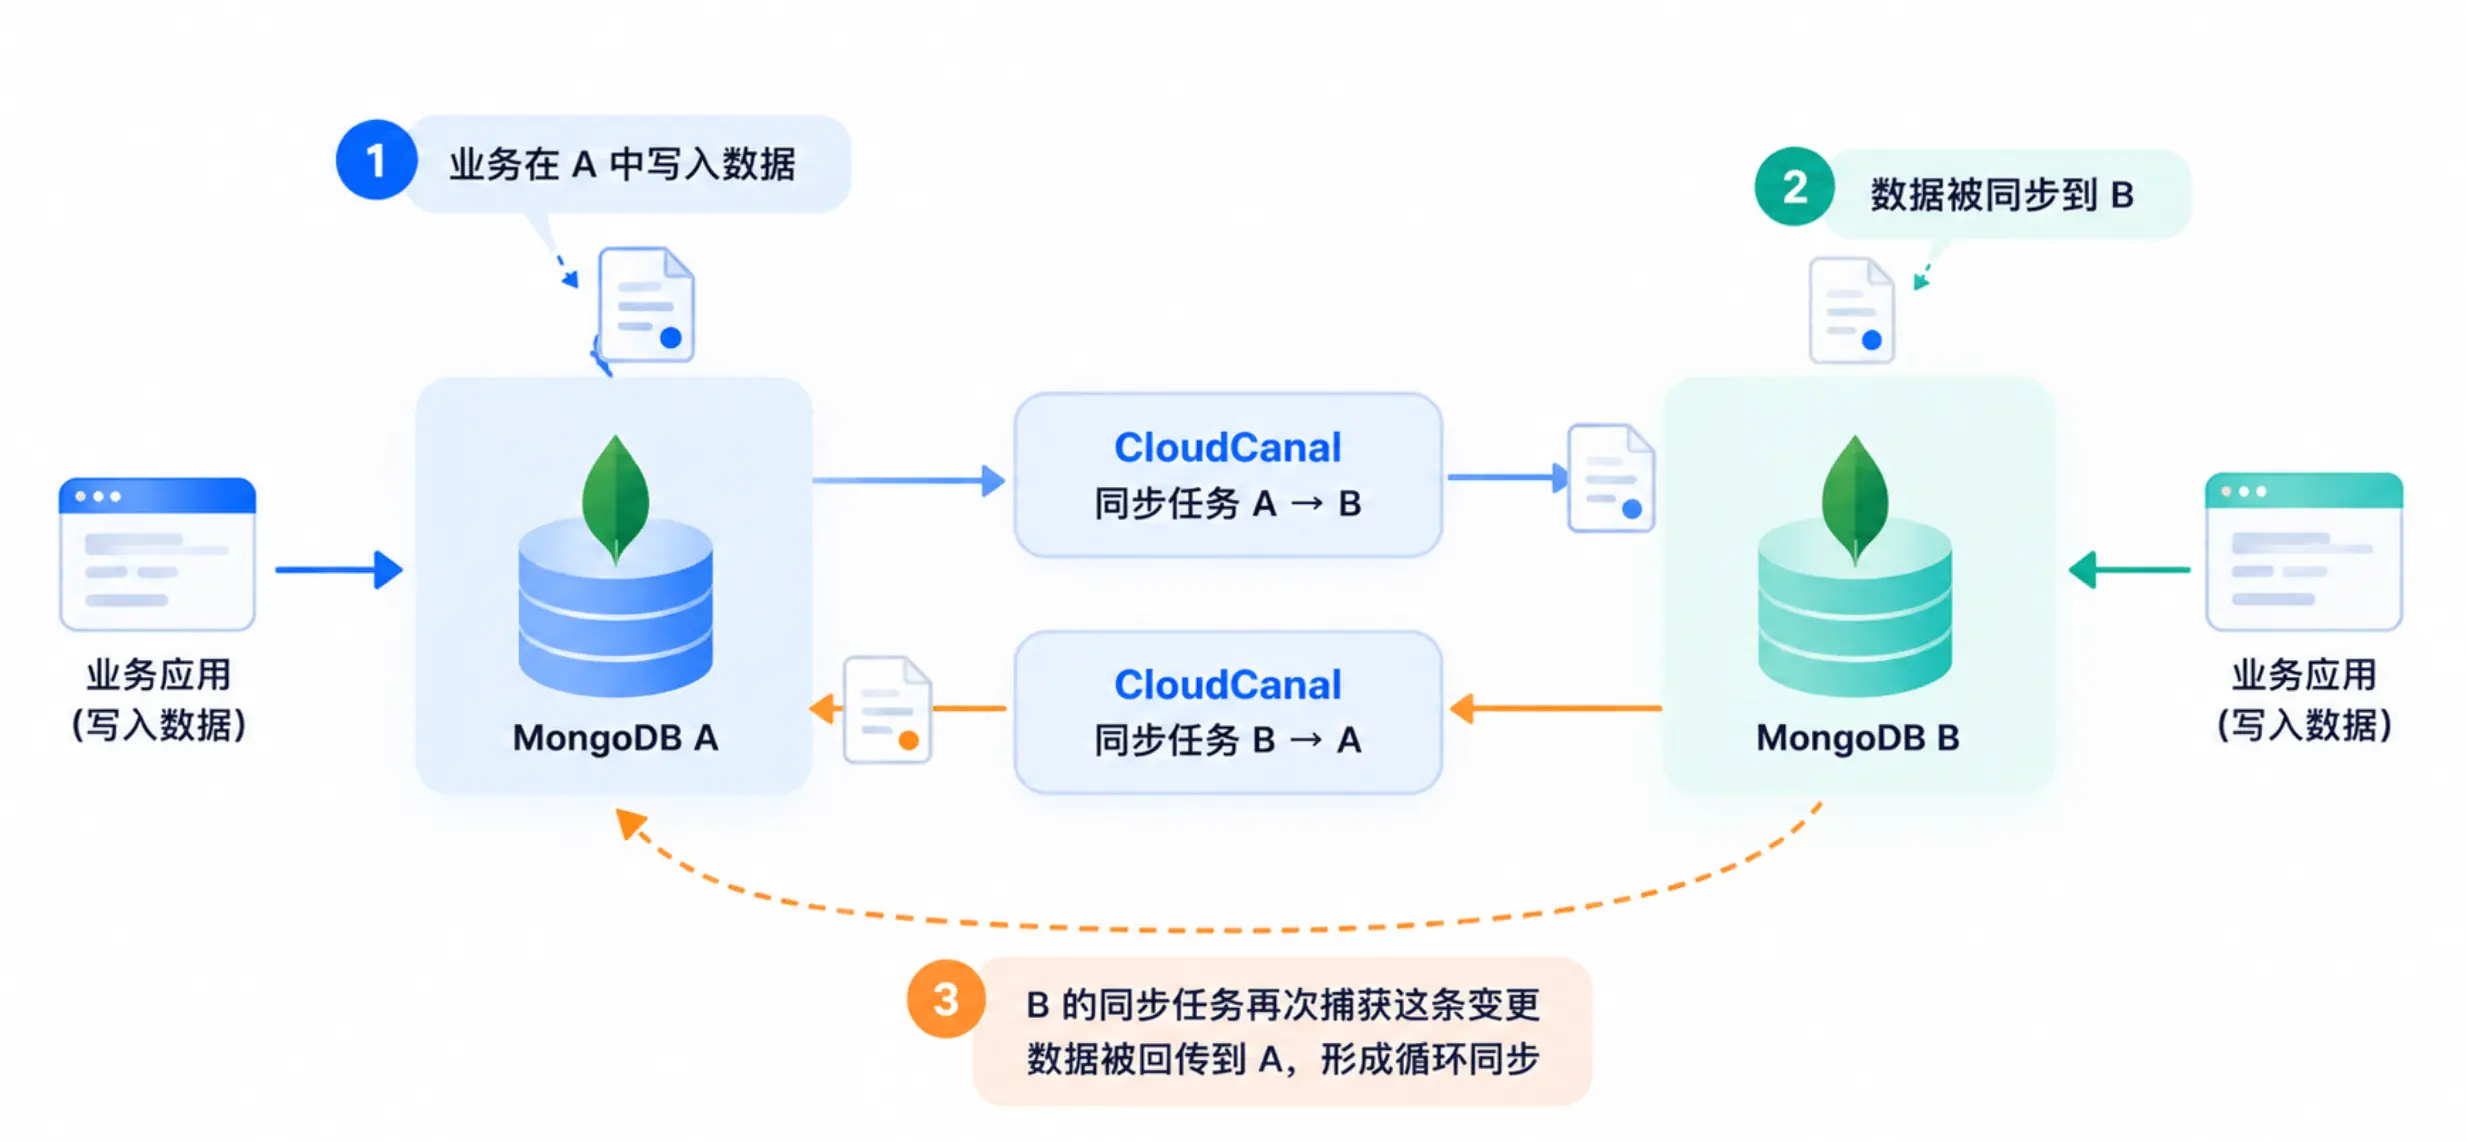
因此,双向同步需要具备防循环机制,能够识别并过滤同步任务自身产生的写入,同时保证正常业务变更可以在两个实例之间传递。
CloudCanal 如何解决数据循环问题?
MongoDB Change Stream 可以持续监听数据库中的数据变化,包括插入、更新和删除等操作。CloudCanal 利用这一机制捕获 MongoDB 的增量变更,并将其同步到另一端。
不过,Change Stream 事件中的 lsid(逻辑会话 ID)和 txnNumber(事务编号)只能用于标识一笔事务,无法直接判断变更来自业务程序还是 CloudCanal。因此,还需要一种机制来识别并过滤同步任务自身产生的写入。
为此,CloudCanal 引入了事务标记(marker)机制,将 marker 与业务数据关联,帮助反向任务识别同步写入。
例如,当 CloudCanal 将 MongoDB A 的数据同步到 B 时,会在 B 的辅助 Collection 中写入一个 marker,并在同一个事务中完成业务数据写入。由于 MongoDB 事务具有原子性,marker 和业务数据会一起提交,确保两者的一致性。
当 B → A 的反向同步任务通过 Change Stream 捕获这些变更时,CloudCanal 会根据 lsid 和 txnNumber 查找对应的 marker,判断该变更是否由同步任务产生。如果匹配到 marker,就将对应的业务变更过滤,避免再次同步回 A;如果是业务程序直接写入 B 的数据,则仍然正常同步到 A。
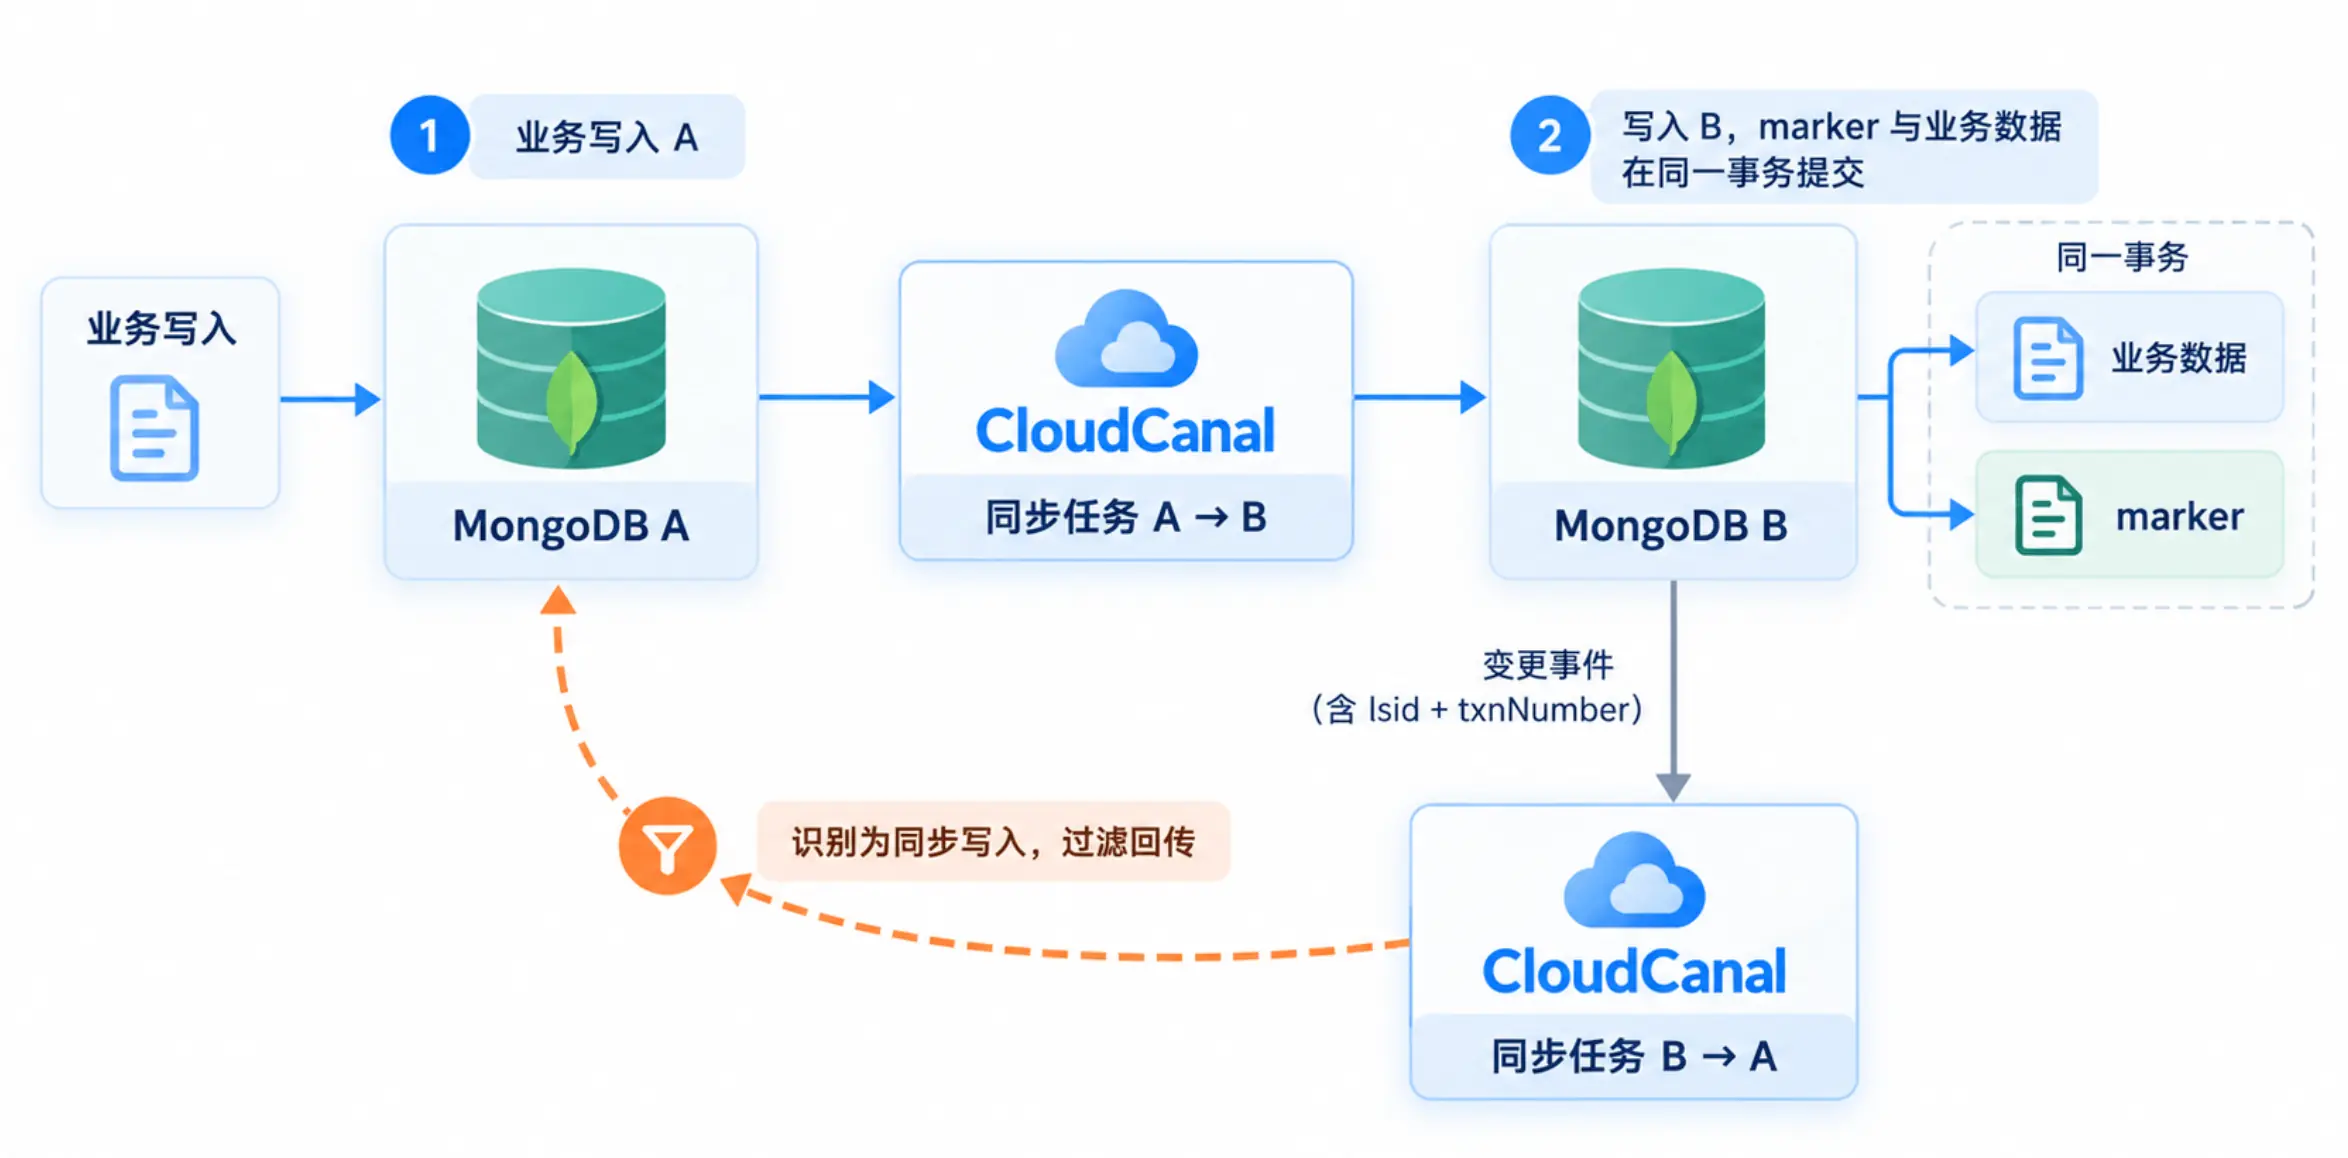
这样,两端的业务变更能够正常流转,CloudCanal 自身产生的同步写入也不会再次进入反向链路,避免数据循环。
注意事项
防循环机制只能识别并过滤同步任务自身产生的写入,无法解决 A、B 两端业务程序同时修改同一个 _id 时的写入冲突。如果同一份业务数据可能在两端同时被修改,仍需在业务层明确数据的写入归属,避免相互覆盖。
实战:通过 CloudCanal 配置 MongoDB 双向同步
接下来手把手教你如何配置 MongoDB 双向任务。
第一步:准备 MongoDB 环境
首先,需要按照 MongoDB 双向同步准备 文档检查两端实例架构、账号权限和任务参数。
当前 MongoDB 双向同步存在以下使用限制:
- 仅支持 MongoDB 到 MongoDB,暂不支持 AWS DocumentDB。
- 增量捕获模式必须使用
CHANGE_STREAM,不支持OP_LOG模式。 - 两端 MongoDB 都必须支持 Change Stream 和多文档事务。
随后,在 A、B 两端分别创建用于保存事务标记的辅助 Collection,默认名称为 cloudcanal.__cc_tx_de_cycle,并为该集合创建 TTL 索引,以便自动清理过期的 marker。
plain
use cloudcanal

db.createCollection("__cc_tx_de_cycle")

db.__cc_tx_de_cycle.createIndex(
  { expireAt: 1 },
  {
    name: "__cc_expire_at",
    expireAfterSeconds: 0
  }
)
该集合用于保存 CloudCanal 自动生成的事务 marker,不需要手动插入数据,也无需将其加入普通业务 Collection 的同步映射。同时,需要为同步账号配置相应的 Change Stream 读取权限、业务数据读写权限,以及辅助集合的访问权限。
第二步:创建 MongoDB A → B 正向同步任务
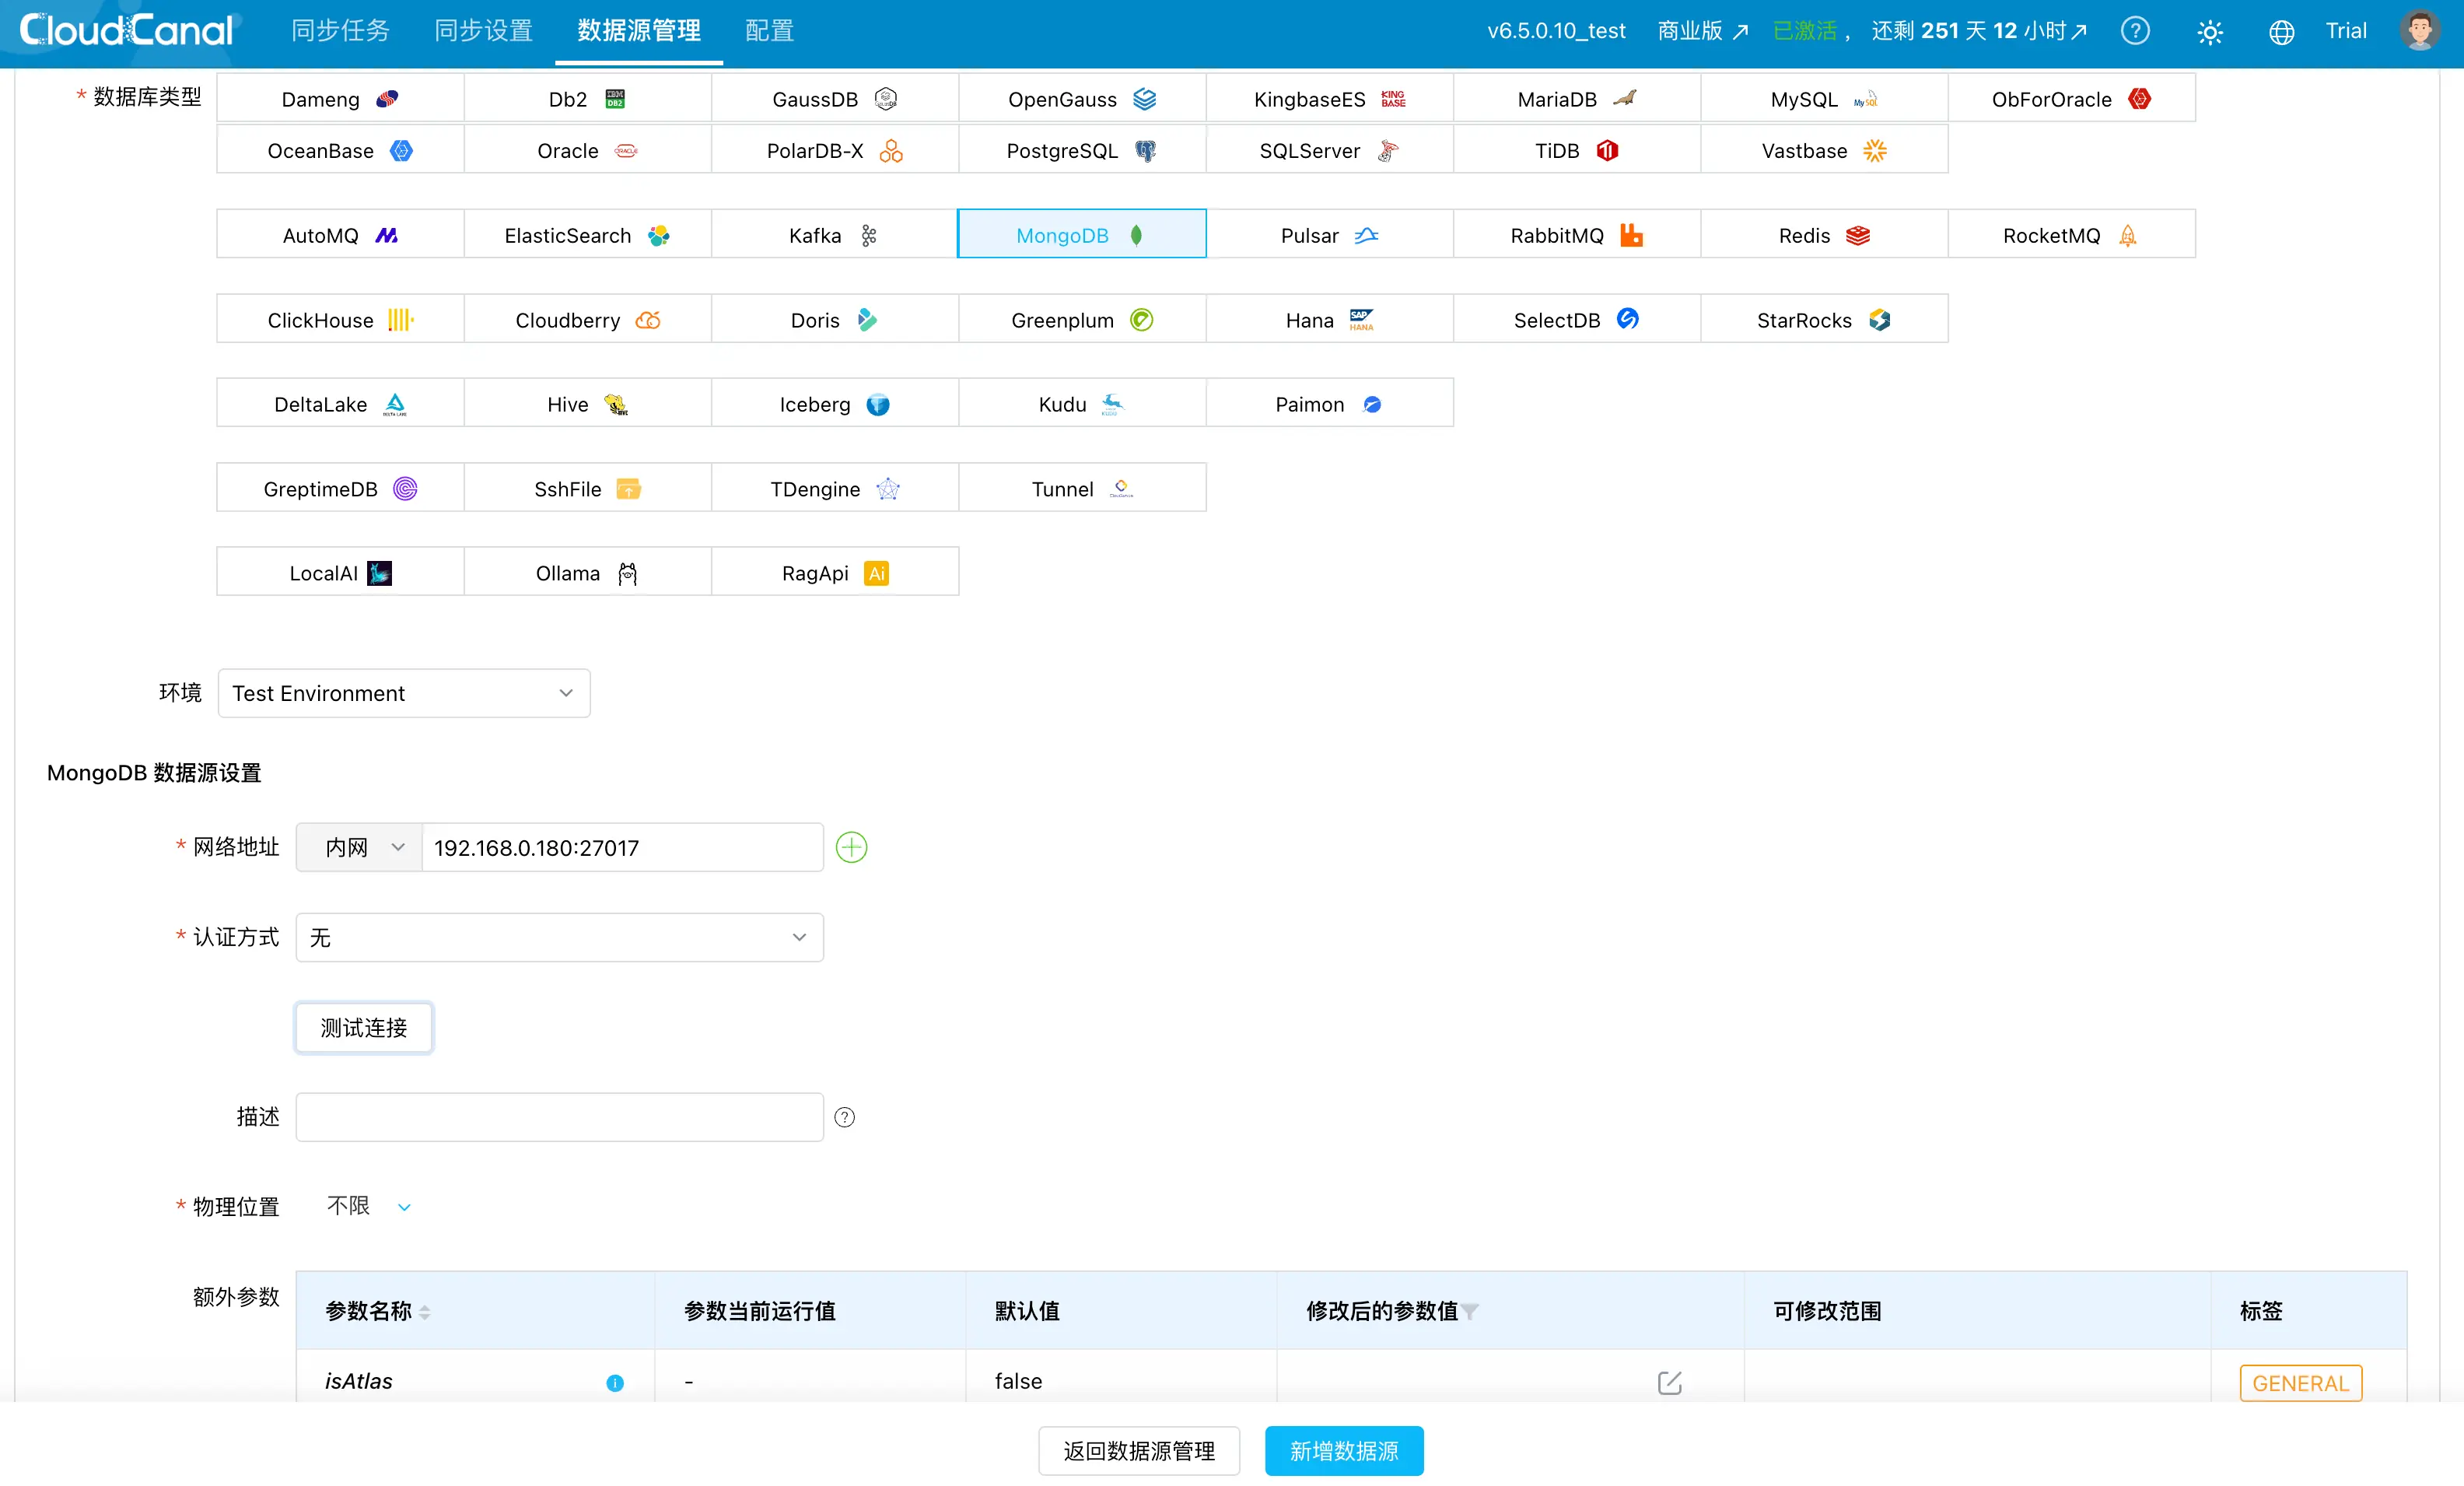
登录 CloudCanal,进入数据源 > 添加数据源,添加两个 MongoDB 实例并测试连接。
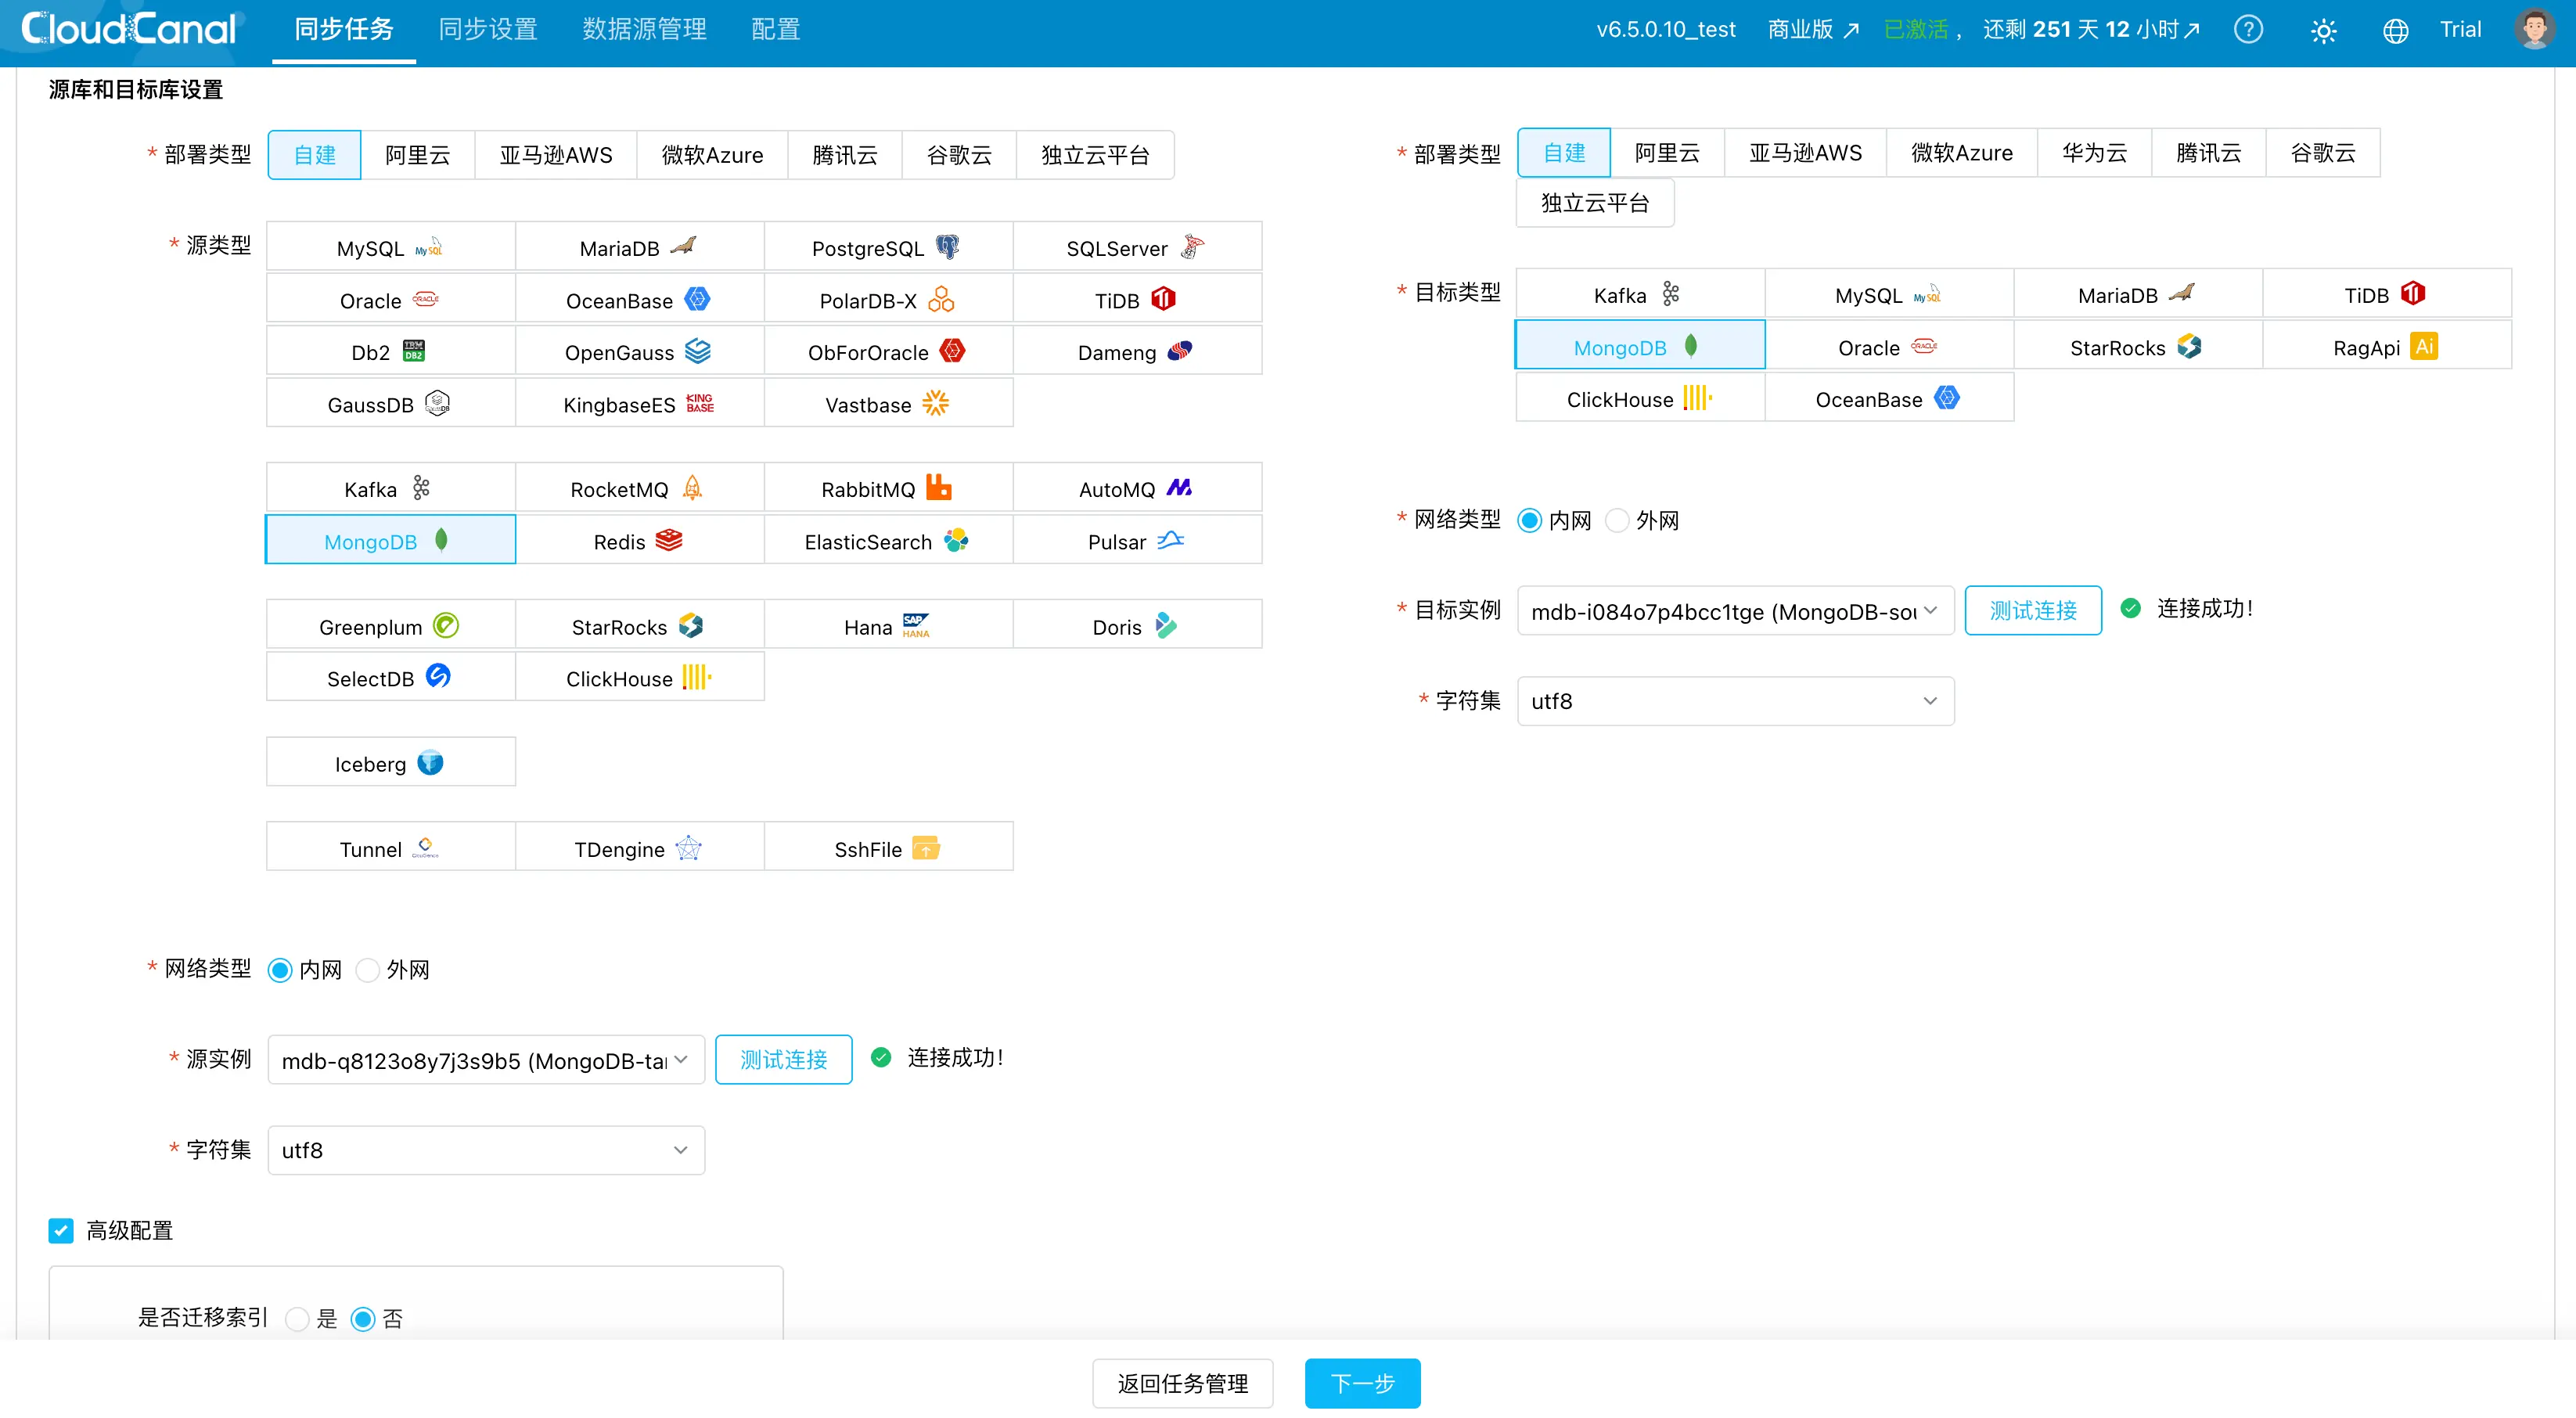
随后,进入同步任务 > 创建任务,选择 MongoDB A 作为源端、MongoDB B 作为目标端。
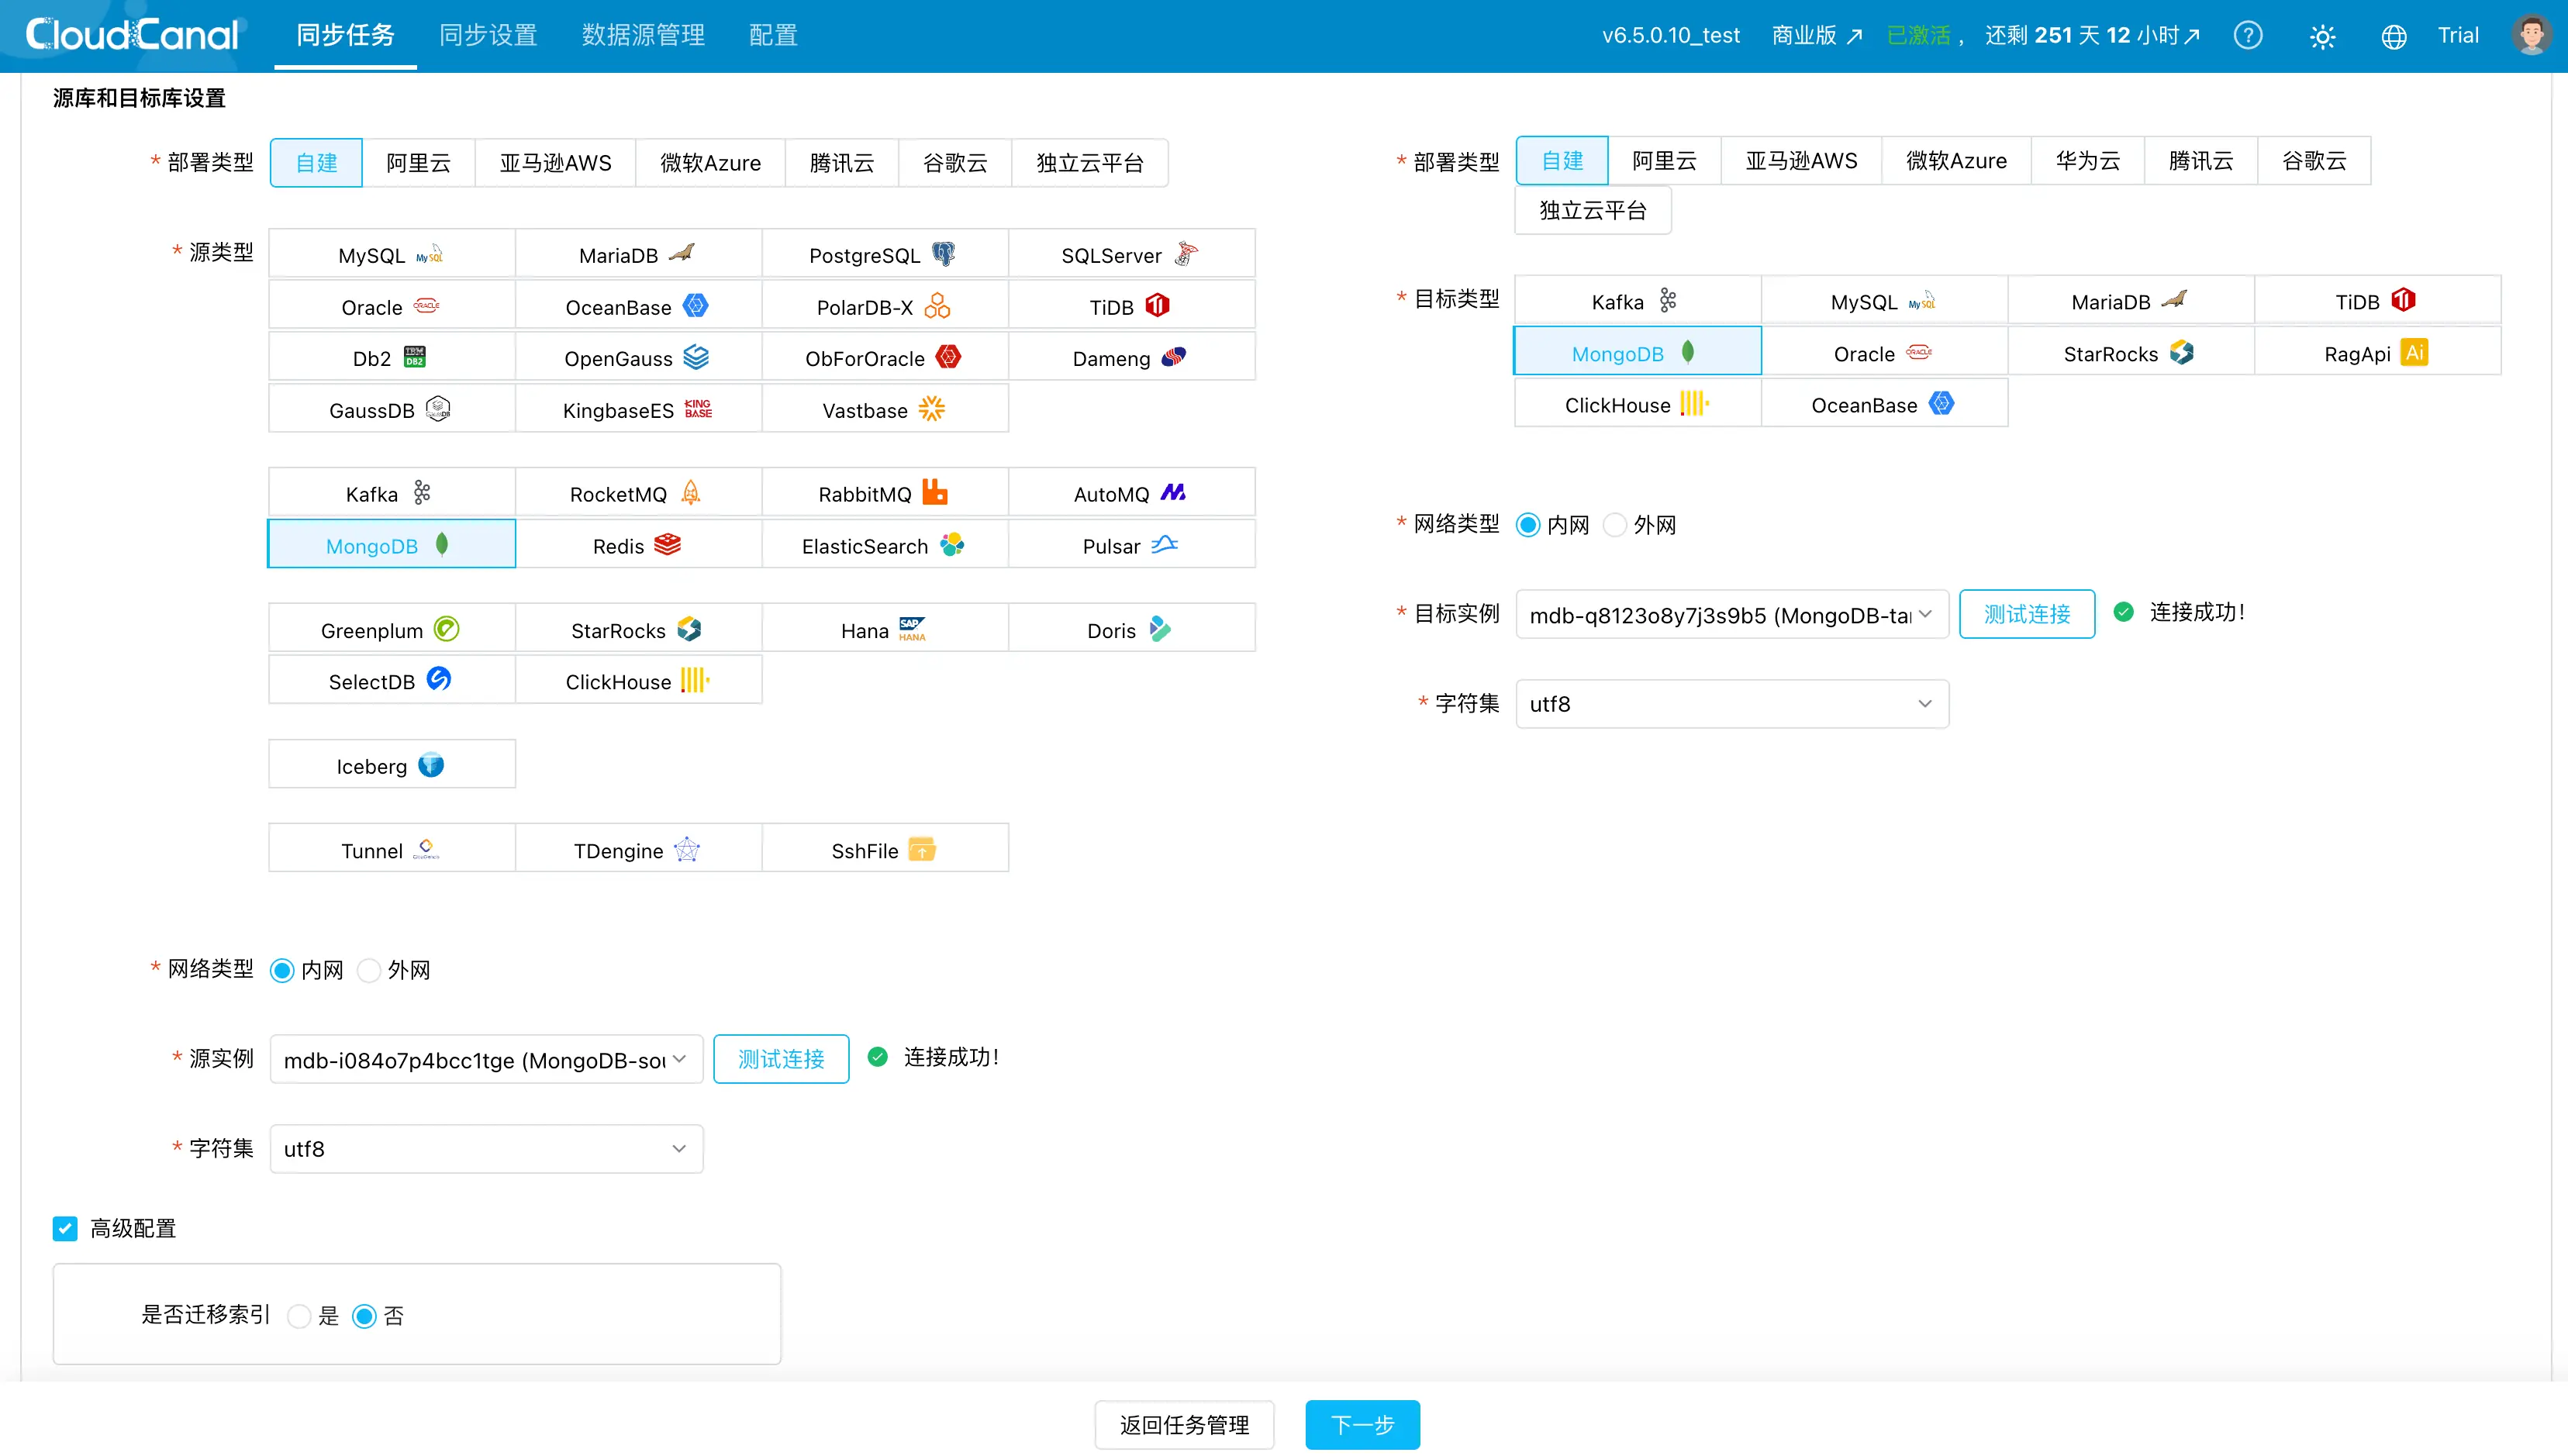
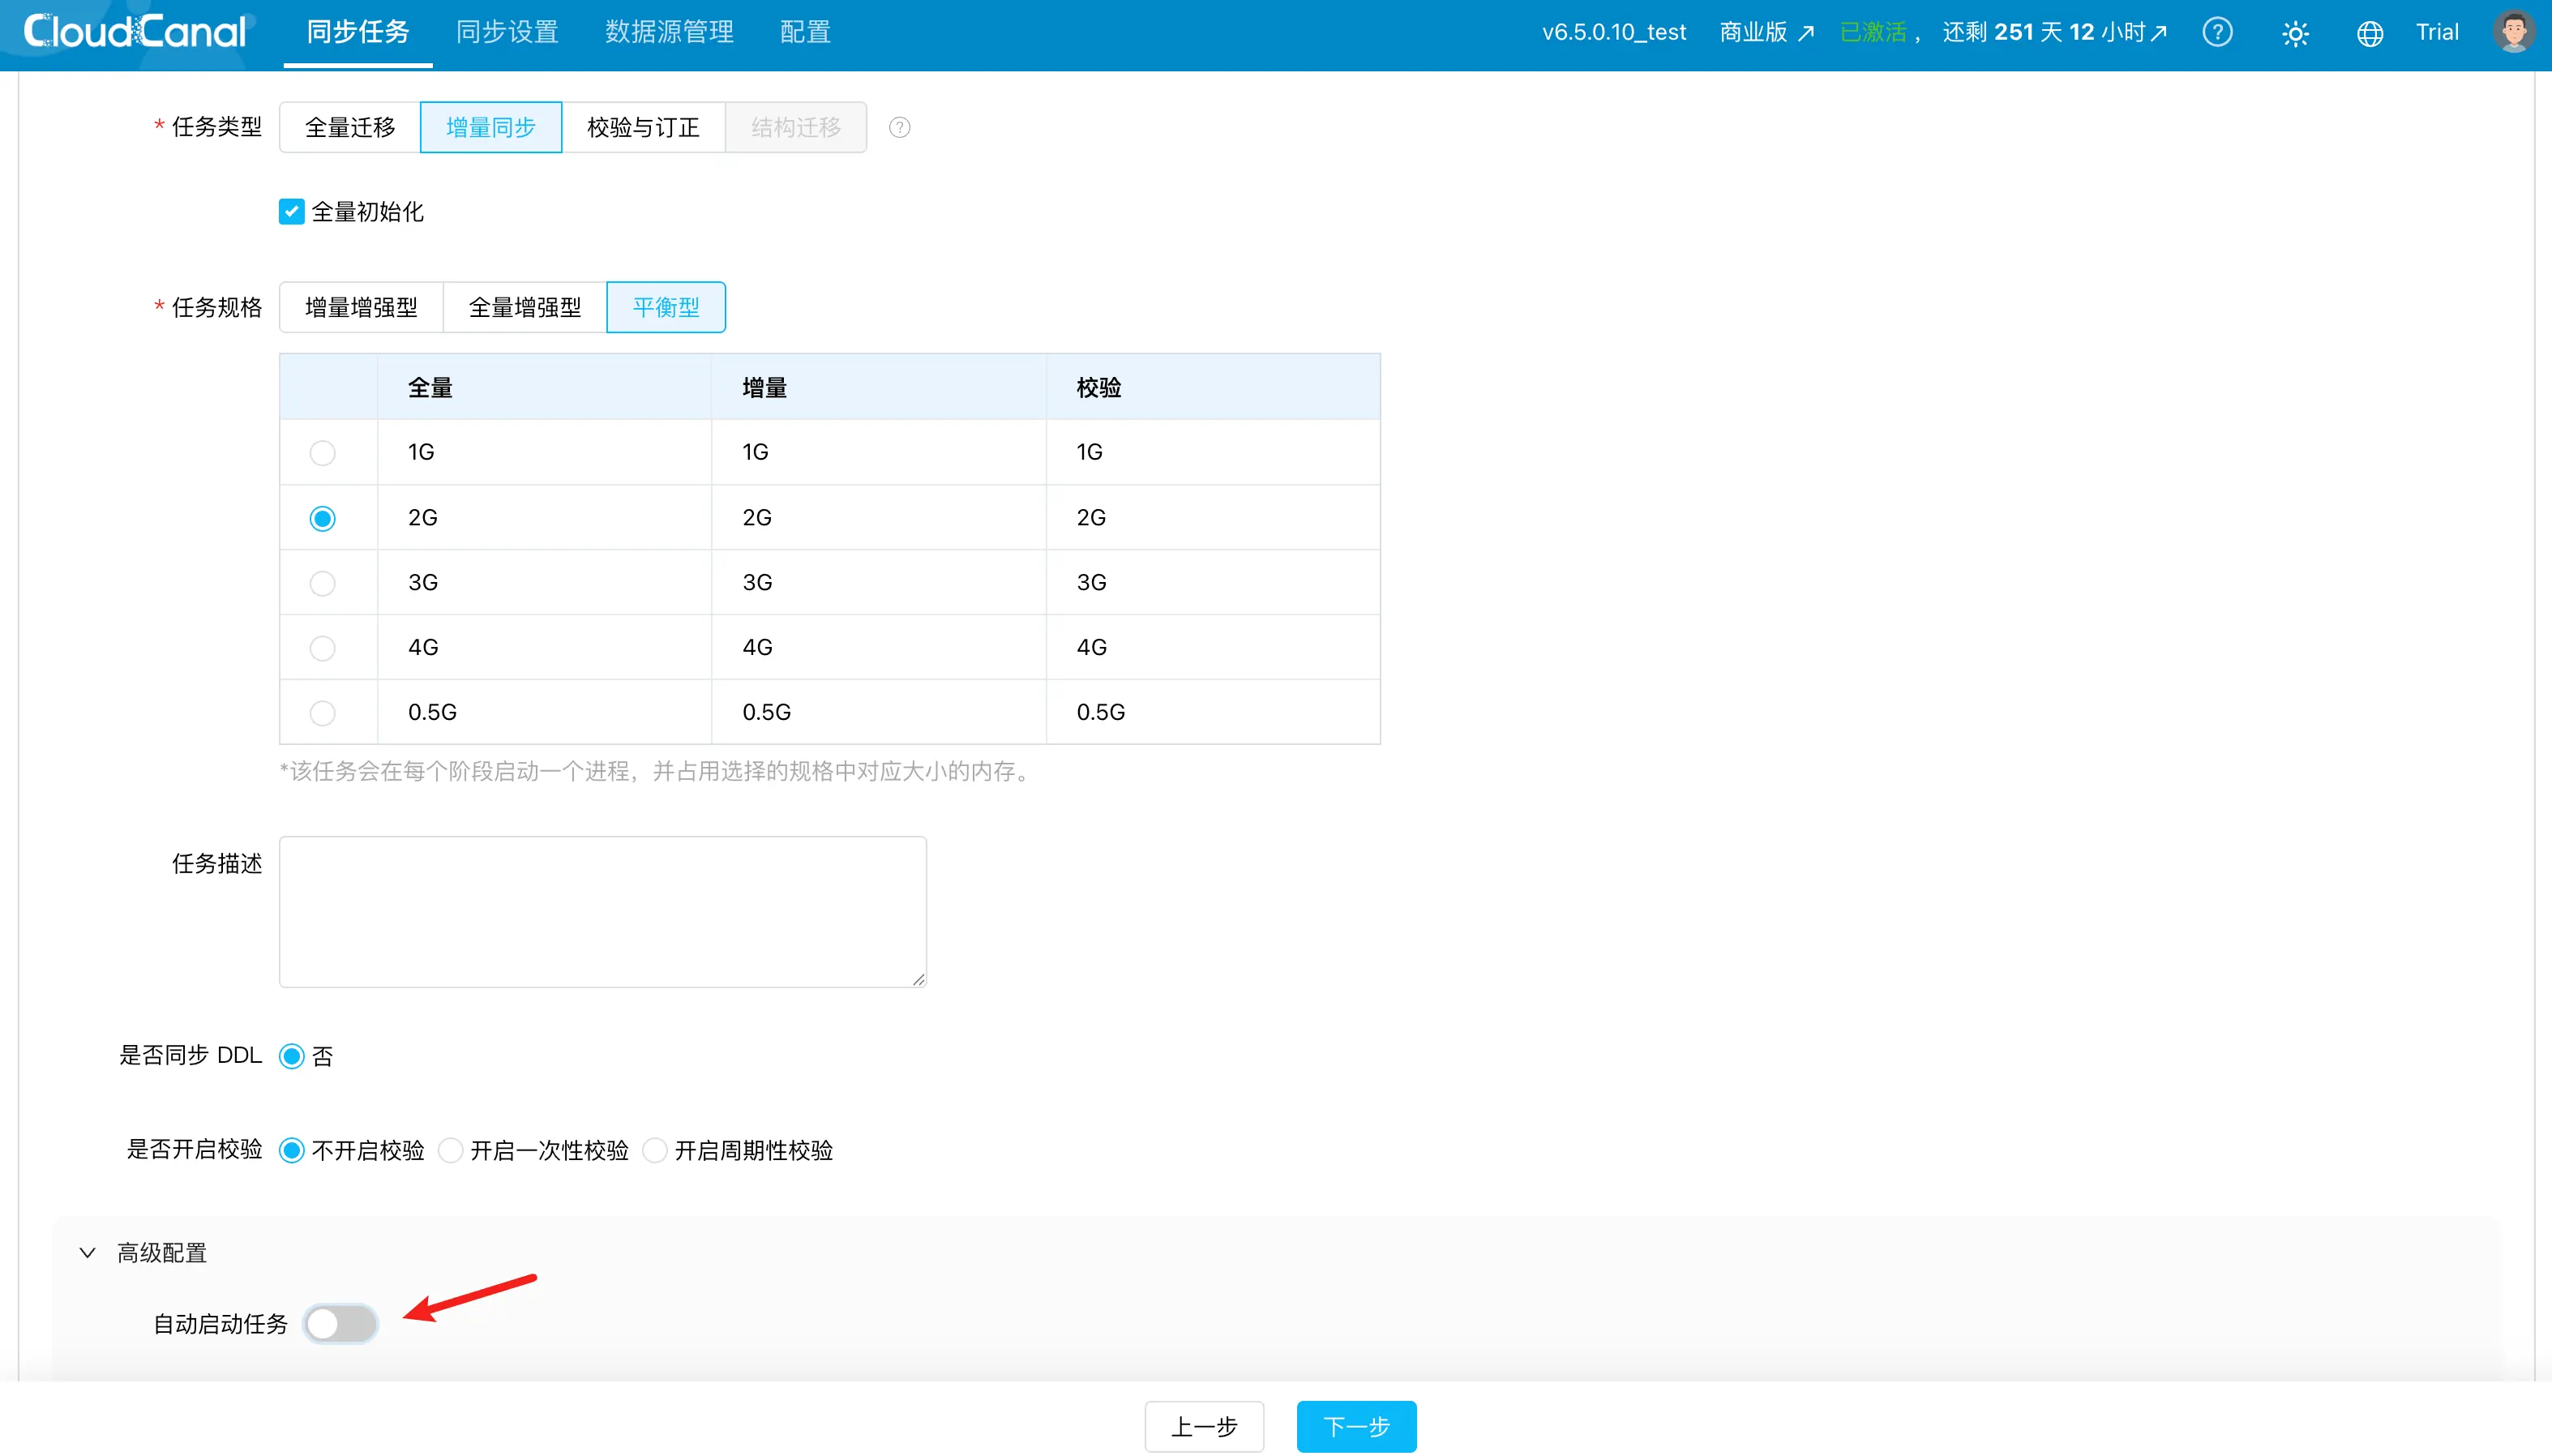
任务类型选择数据同步 ,并勾选全量数据初始化 ,在增量同步开始前完成历史数据的初始同步。同时,关闭任务自动启动。
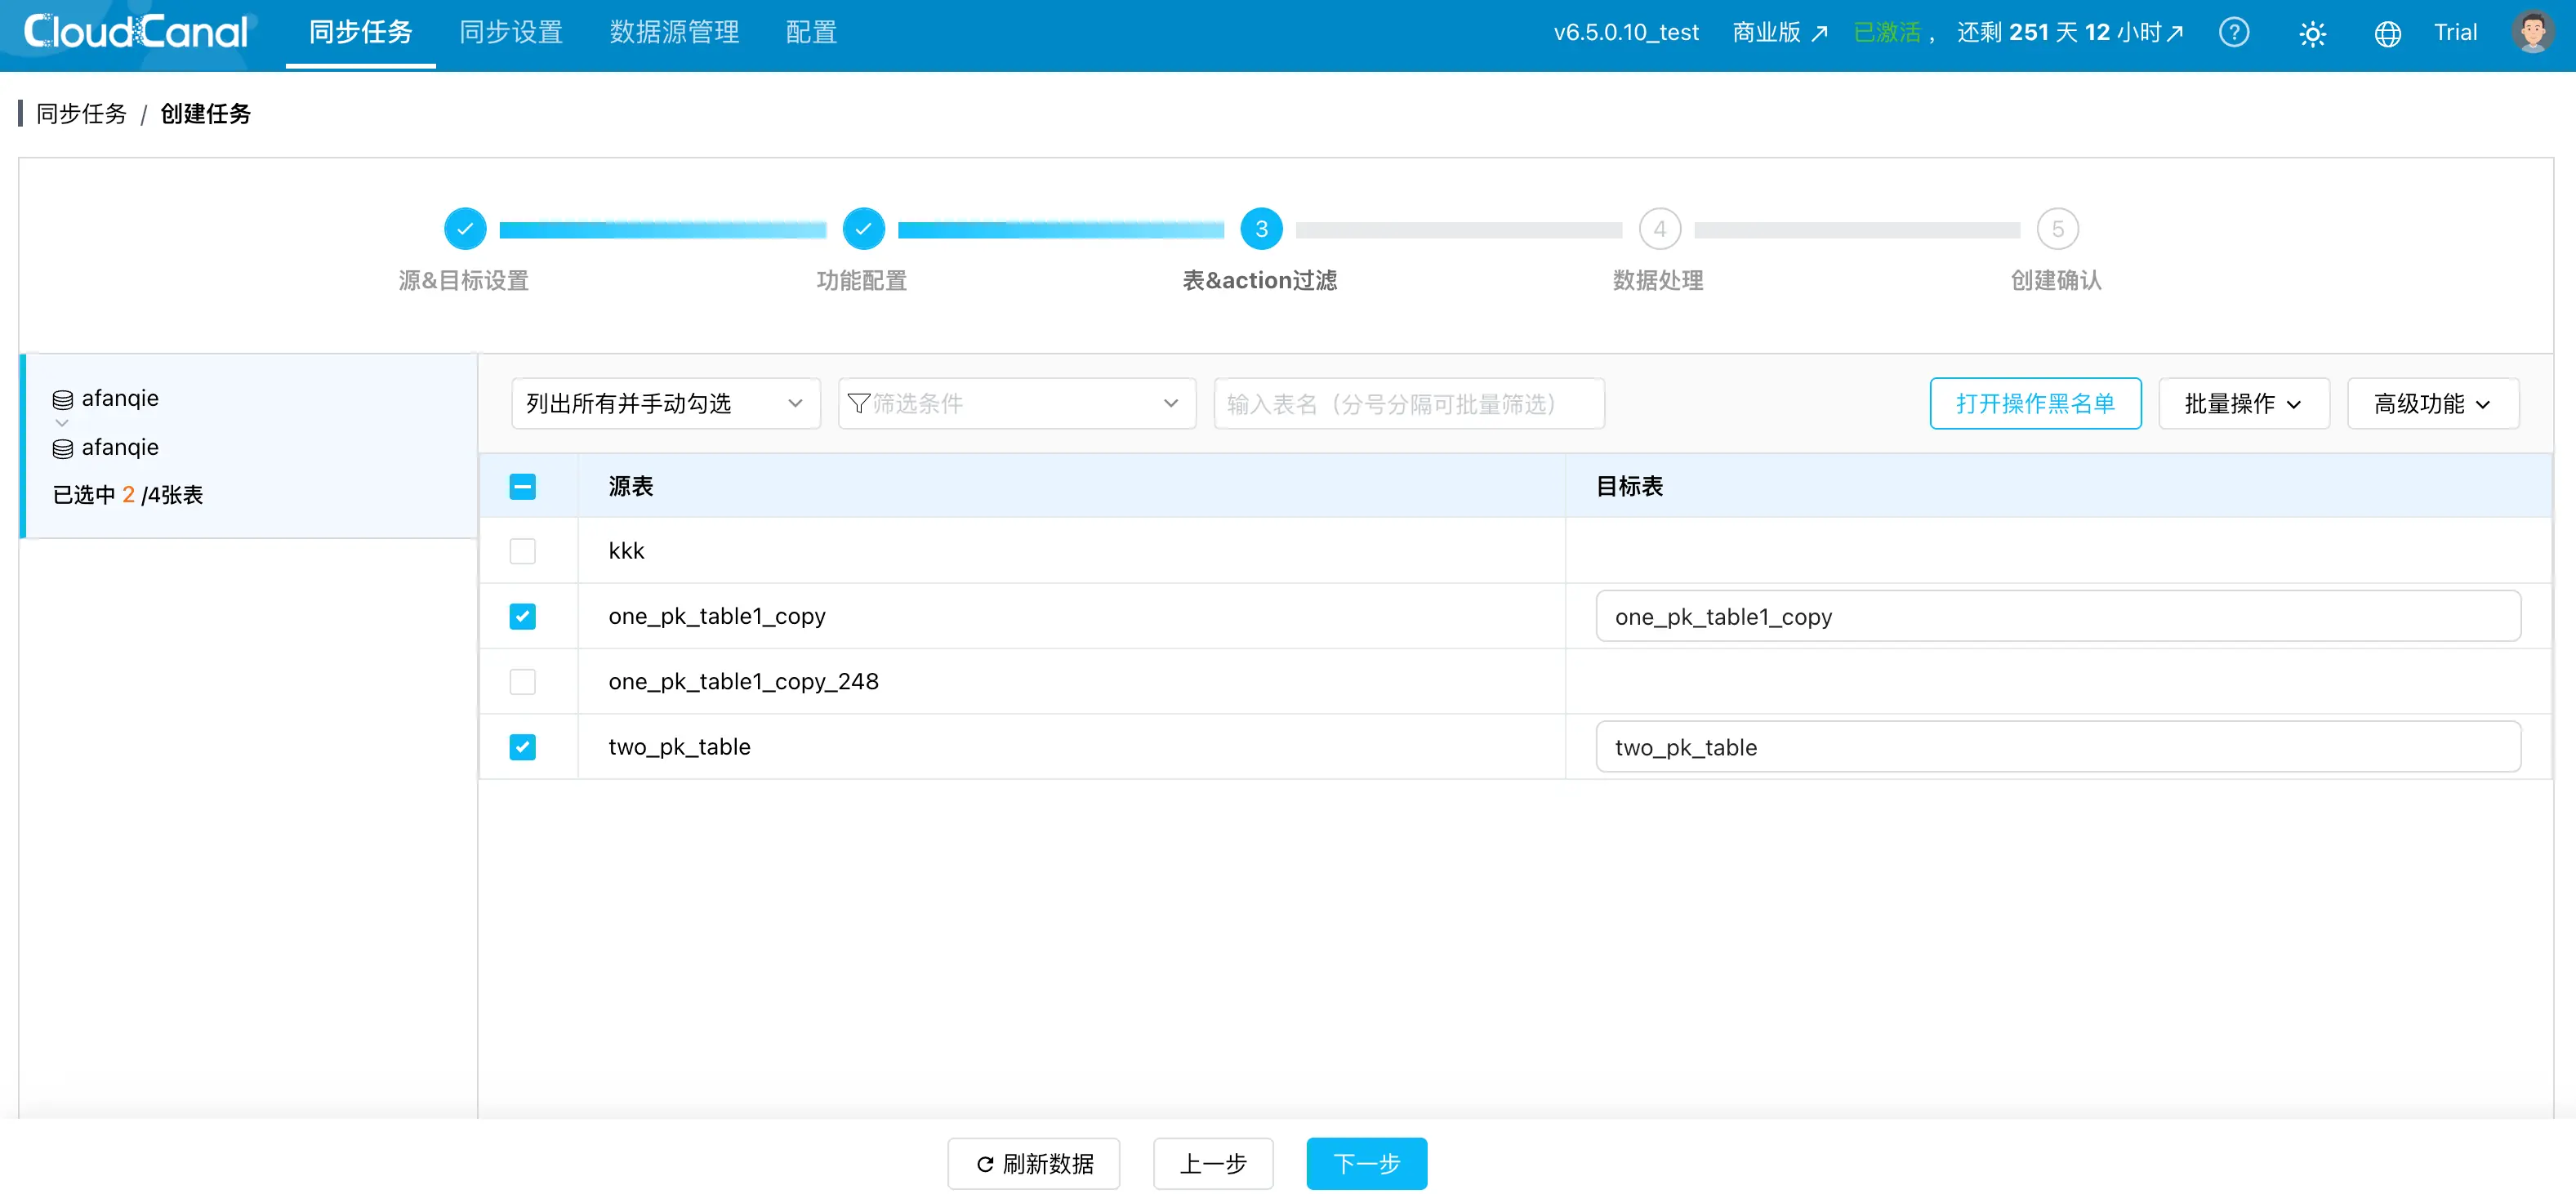
根据实际需求选择需要同步的数据库、Collection 和字段。
创建任务后,进入任务详情页,通过功能列表 > 修改参数设置以下防循环相关参数。
| 配置位置 | 参数 | 配置值 |
|---|---|---|
| 源端 | captureMode |
CHANGE_STREAM |
| 源端 | deCycle |
true |
| 源端 | deCycleCollection |
cloudcanal.__cc_tx_de_cycle |
| 源端 | deCycleTxCacheSize |
10000 |
| 目标端 | deCycle |
true |
| 目标端 | deCycleCollection |
cloudcanal.__cc_tx_de_cycle |
| 目标端 | deCycleMarkerTtlDays |
7 |
| 目标端 | enableBatchApply |
false |
其中:
deCycle=true用于开启防循环机制,源端和目标端必须同时开启。deCycleCollection指定保存事务标记的辅助集合,不需要将该集合加入普通业务 Collection 的同步映射。deCycleTxCacheSize表示进程内缓存的事务判断结果数量。缓存未命中或任务重启后,CloudCanal 会回查持久化 marker;没有明确调优依据时使用默认值10000。deCycleMarkerTtlDays表示 marker 保留天数,默认值为7。该值应大于任务允许的最大停机、积压和位点回溯时间,避免业务事件回放时对应 marker 已被清理。
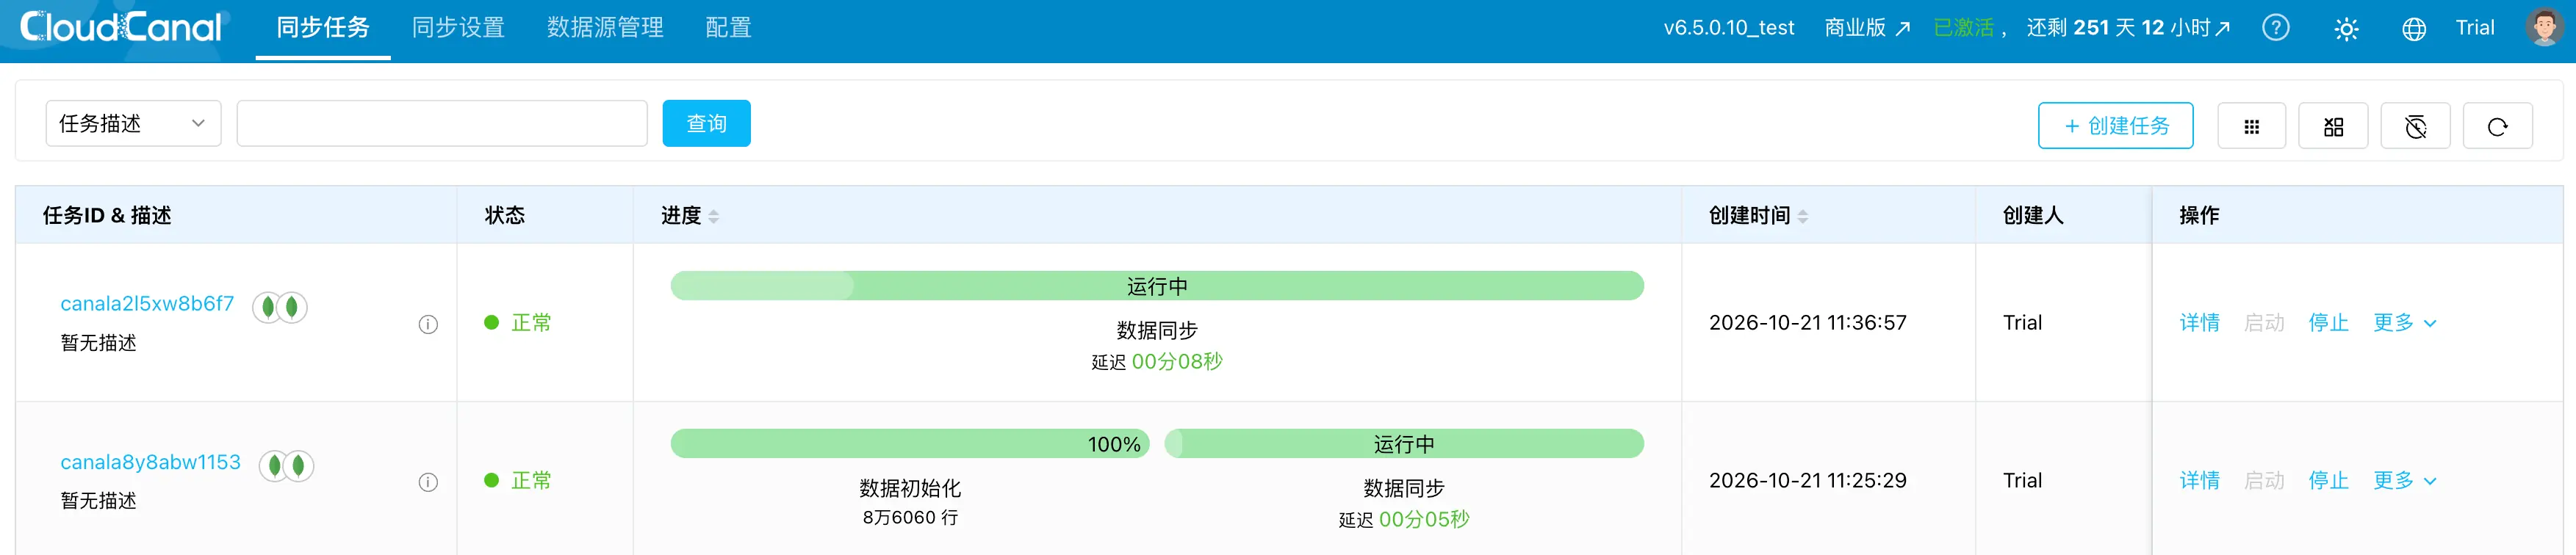
完成参数设置后,启动任务,等待全量数据初始化完成,确认任务进入正常的增量同步状态。

第三步:创建 MongoDB B → A 反向同步任务
接下来创建第二条同步任务,将 MongoDB B 设置为源端、MongoDB A 设置为目标端,选择与正向任务一致的数据库、Collection 和字段映射。
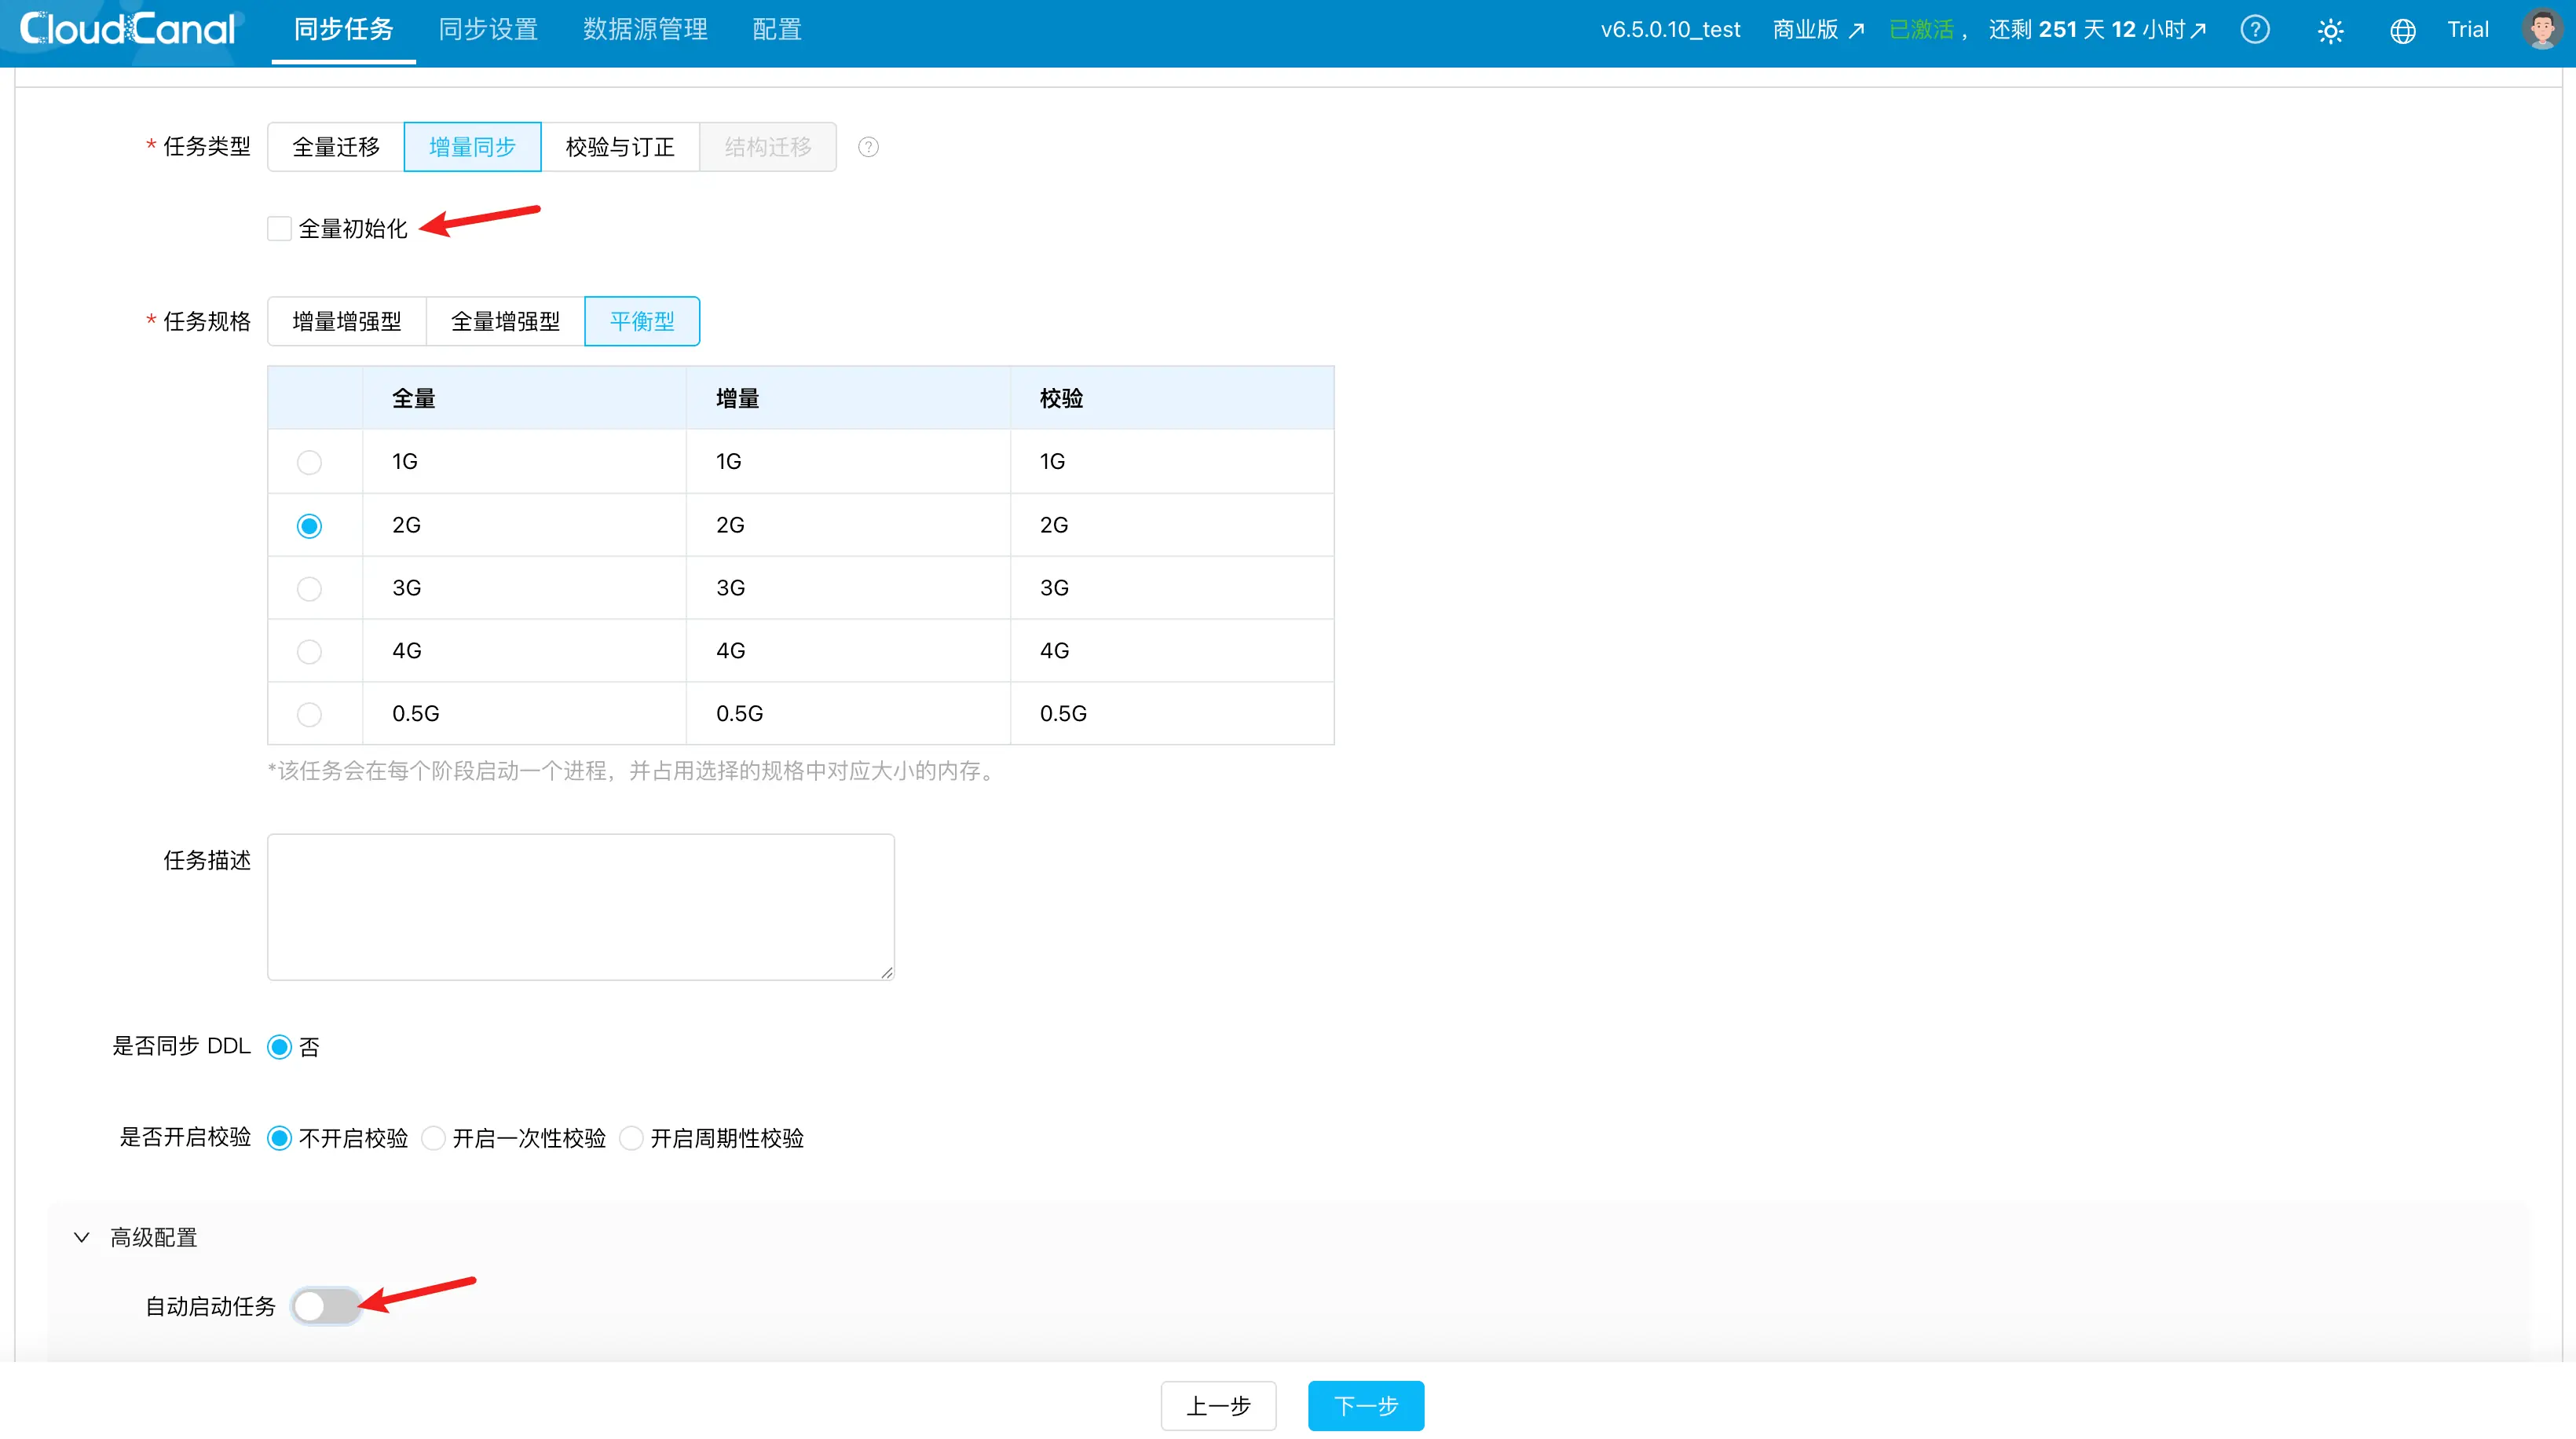
这里需要注意,反向任务无需再次开启全量数据初始化。因为正向任务已经完成了历史数据初始化,如果两条任务都执行全量同步,可能导致重复写入或数据冲突。
反向任务同样需要配置相同的防循环参数。
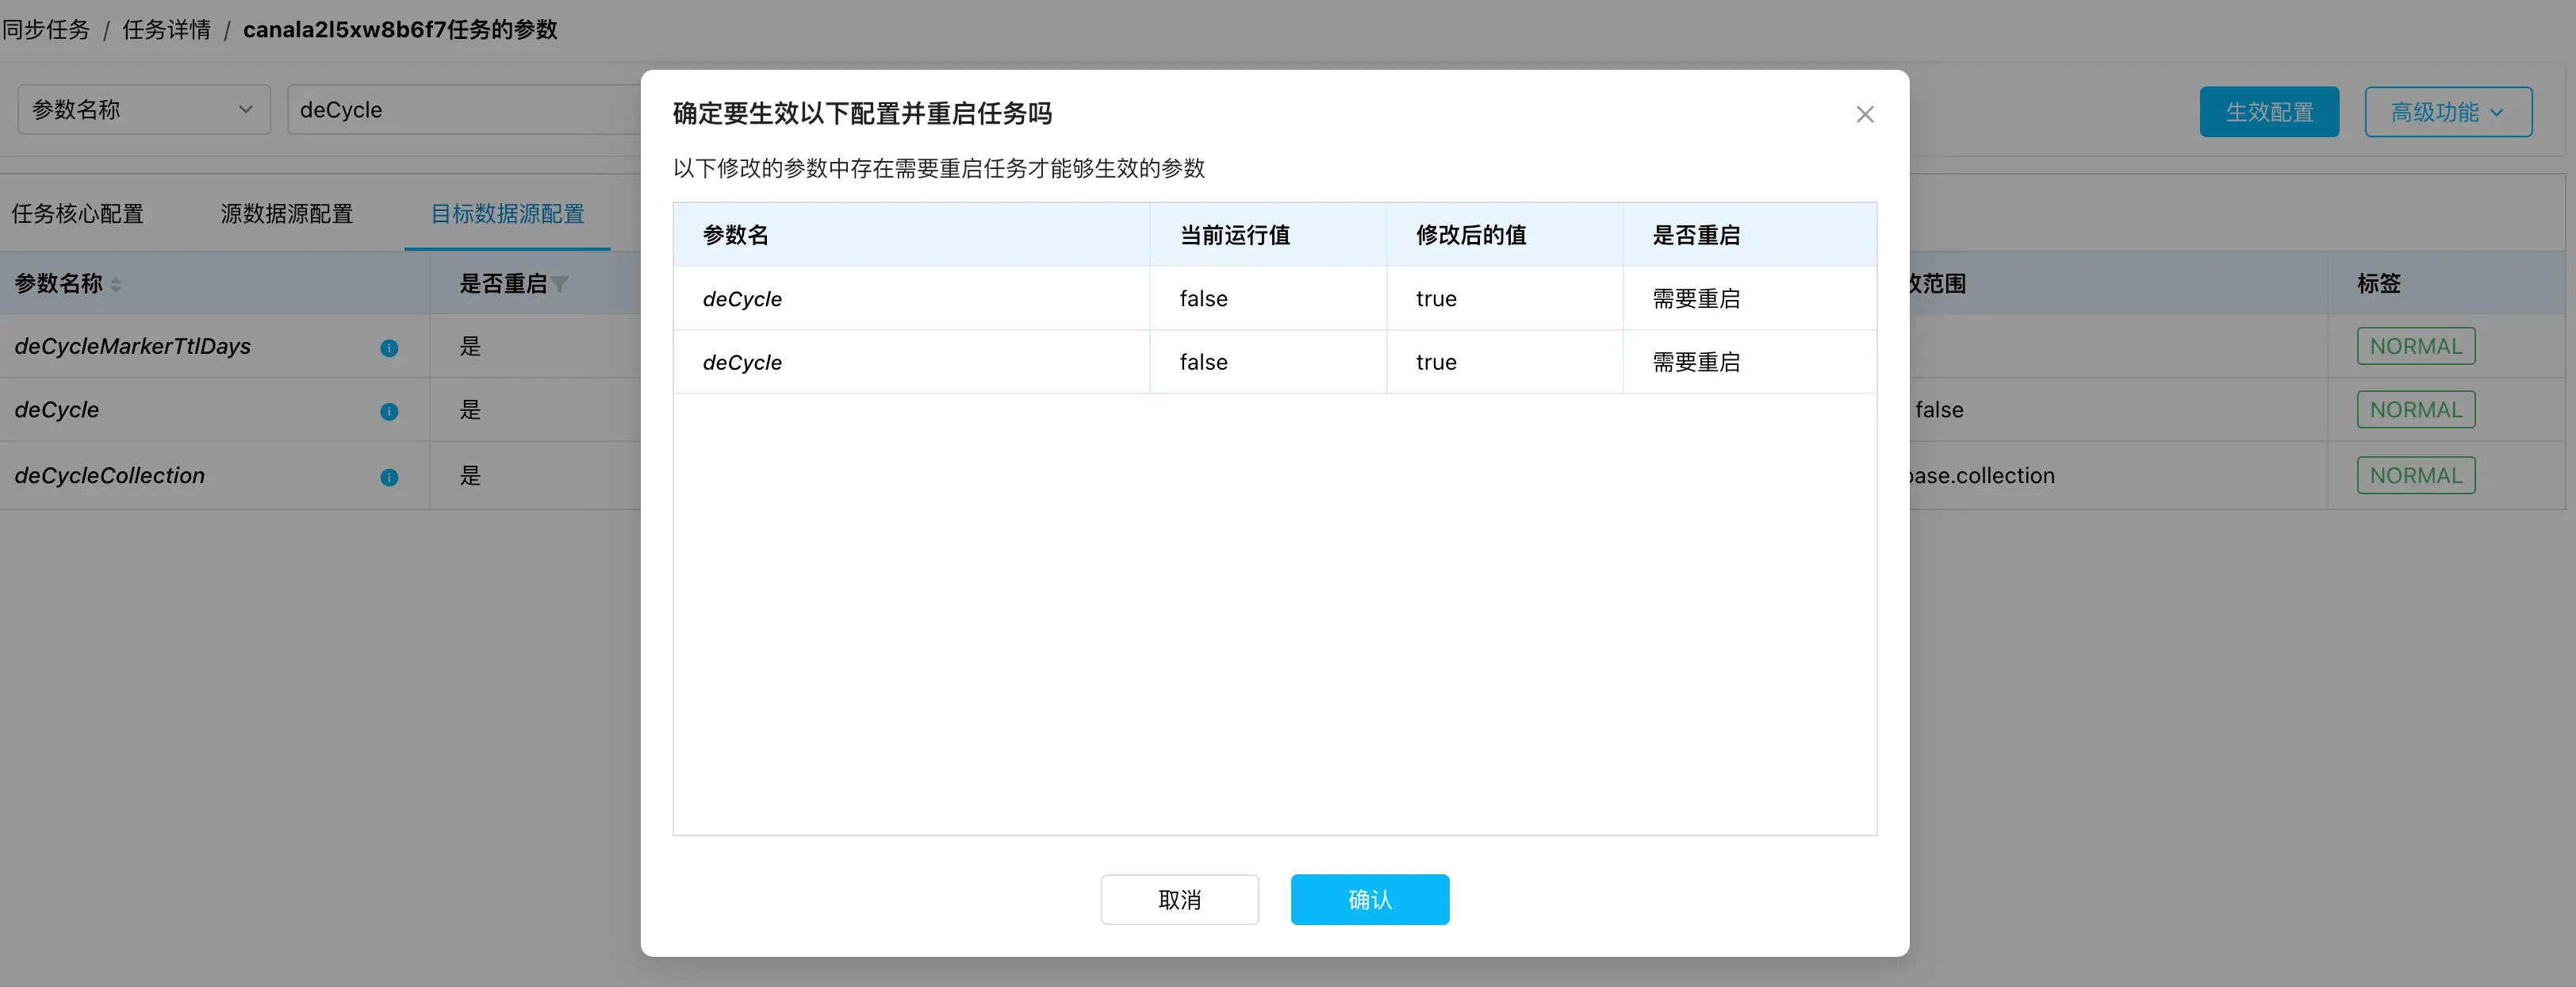
完成配置后,即可启动反向任务。
这样,两条方向相反的 MongoDB 同步链路就建立起来了。
总结
MongoDB 双向同步可以帮助两个实例持续交换业务变更,适用于跨地域业务部署、系统拆分过渡、灾备切换等需要两端承接写入的场景。在这一过程中,避免同步数据反复回流,是保证双向链路稳定运行的重要前提。
CloudCanal 通过 MongoDB Change Stream 捕获数据变化,并利用同一事务中的 marker 和业务写入识别同步来源,使两个方向的同步任务能够相互配合,在保证业务变更正常流转的同时,过滤自身产生的同步写入。
如果你正在考虑搭建 MongoDB 双向同步链路,可以参考上面的操作流程测试一下。