dense_vector 字段 类 型用于存储由数值组成的稠密向量。稠密向量字段主要用于 k 近邻搜索( k-nearest neighbor (kNN) search )。
dense_vector 类型不支持聚合或排序。
你可以使用两种不同的输入格式提供向量:
- 浮点数数组:由数值组成的 JSON 数组,每个数值代表向量的一个维度。
- Base64 编码字符串:向量的 Base64 编码二进制表示。它比浮点数数组更紧凑,可减小请求载荷,并提高处理大型向量和批量索引时的效率。
以下示例创建一个包含 dense_vector 字段的索引(使用默认的 element_type 值 float),并分别使用这两种格式索引文档:
- 浮点数数组
bash
`
1. PUT my-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3,
8. "index_options": {
9. "type": "bbq_disk"
10. }
11. },
12. "my_text": {
13. "type": "keyword"
14. }
15. }
16. }
17. }
18. PUT my-index/_doc/1
19. {
20. "my_text" : "text1",
21. "my_vector" : [0.5, 10, 6]
22. }
23. PUT my-index/_doc/2
24. {
25. "my_text" : "text2",
26. "my_vector" : [-0.5, 10, 10]
27. }
`AI代码解释- Base64 编码字符串
bash
`
1. PUT my-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3
8. },
9. "my_text" : {
10. "type" : "keyword"
11. }
12. }
13. }
14. }
15. PUT my-index/_doc/1
16. {
17. "my_text" : "text1",
18. "my_vector" : "PwAAAEEgAABAwAAA"
19. }
20. PUT my-index/_doc/2
21. {
22. "my_text" : "text2",
23. "my_vector" : "vwAAAEEgAABBIAAA"
24. }
`AI代码解释注意
与大多数其他数据类型不同,稠密向量始终是单值的。无法在一个
dense_vector字段中存储多个值。
为 k 近邻搜索索引向量
_k 近邻_搜索通过相似度度量,查找距离查询向量最近的 k 个向量。
稠密向量字段可用于在 script_score 查询( script_score queries )中对文档进行排名。这样,你就可以扫描所有文档并按相似度排序,执行暴力 k 近邻搜索。
在许多情况下,暴力 k 近邻搜索的效率不够高。因此,dense_vector 类型支持将 向量索引 到专用数据结构中,通过搜索接口中的 knn 选项( knn option )实现快速 k 近邻检索。
尚未映射、包含 128 至 4096 个浮点数元素的 数组 字段,会被动态映射为 dense_vector,默认相似度为 cosine(余弦相似度)。你可以显式将字段映射为 dense_vector,并指定所需的相似度,以覆盖默认设置。
稠密向量字段默认启用索引。索引 float 向量时,Elasticsearch 使用默认索引类型( default index type )。对于 byte 和 bit 等其他元素类型,默认索引类型为不进行 量化 的 hnsw。
注意
在 Elastic 技术栈 9.0 中,float 稠密向量字段始终以
int8_hnsw类型建立索引。
启用索引后,你可以指定 k 近邻搜索使用的向量相似度:
bash
`
1. PUT my-index-2
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3,
8. "similarity": "dot_product"
9. }
10. }
11. }
12. }
`AI代码解释
bash
`GET my-index-2/_mapping`AI代码解释
bash
`
1. {
2. "my-index-2": {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3,
8. "index": true,
9. "similarity": "dot_product",
10. "index_options": {
11. "type": "int8_hnsw",
12. "m": 16,
13. "ef_construction": 100
14. }
15. }
16. }
17. }
18. }
19. }
`AI代码解释注意
为近似 k 近邻搜索建立向量索引是一项开销很大的操作。摄取包含已启用
index的向量字段的文档,可能需要相当长的时间。有关内存要求的更多信息,请参阅 k 近邻搜索( k-nearest neighbor (kNN) search )。
你可以将 index 参数设置为 false 来禁用索引:
markdown
`
1. PUT my-index-2
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3,
8. "index": false
9. }
10. }
11. }
12. }
`AI代码解释Elasticsearch 使用分层可导航小世界算法( HNSW algorithm )支持高效的 k 近邻搜索。与大多数 k 近邻 算法 一样,分层可导航小世界算法是一种近似方法,通过牺牲结果准确性来提高速度。
在搜索响应中访问 dense_vector 字段
默认情况下,_search、_msearch、_get 和 _mget 接口响应中的 _source 不包含稠密向量字段(9.2+)。这有助于减小响应体积并提高性能,尤其适用于向量仅用于相似度评分、无需在输出中返回的场景。
要显式获取向量值,你可以使用:
fields选项,直接请求特定的向量字段:
ini
`GET my-index/_search?filter_path=**.hits`AI代码解释
bash
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_index": "my-index",
6. "_id": "1",
7. "_score": 1,
8. "_source": {
9. "my_text": "text1"
10. }
11. },
12. {
13. "_index": "my-index",
14. "_id": "2",
15. "_score": 1,
16. "_source": {
17. "my_text": "text2"
18. }
19. }
20. ]
21. }
22. }
`AI代码解释如果我们想显示 my_vector 字段,我们可以使用如下的方法:
bash
`

1.  GET my-index/_search?filter_path=**.hits
2.  {
3.      "fields": [
4.        "my_vector"
5.      ]
6.  }

`AI代码解释
markdown
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_index": "my-index",
6. "_id": "1",
7. "_score": 1,
8. "_source": {
9. "my_text": "text1"
10. },
11. "fields": {
12. "my_vector": [
13. 0.5,
14. 10,
15. 5.9999995
16. ]
17. }
18. },
19. {
20. "_index": "my-index",
21. "_id": "2",
22. "_score": 1,
23. "_source": {
24. "my_text": "text2"
25. },
26. "fields": {
27. "my_vector": [
28. -0.5,
29. 10,
30. 10
31. ]
32. }
33. }
34. ]
35. }
36. }
`AI代码解释- 使用
_source.exclude_vectors标志,重新启用在_source响应中包含向量:
bash
`

1.  POST my-index-2/_search
2.  {
3.    "_source": {
4.      "exclude_vectors": false
5.    }
6.  }

`AI代码解释
bash
`

1.  GET my-index/_search?filter_path=**.hits
2.  {
3.    "_source": {
4.      "exclude_vectors": false
5.    }
6.  }

`AI代码解释
markdown
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_index": "my-index",
6. "_id": "1",
7. "_score": 1,
8. "_source": {
9. "my_text": "text1",
10. "my_vector": [
11. 0.5,
12. 10,
13. 5.9999995
14. ]
15. }
16. },
17. {
18. "_index": "my-index",
19. "_id": "2",
20. "_score": 1,
21. "_source": {
22. "my_text": "text2",
23. "my_vector": [
24. -0.5,
25. 10,
26. 10
27. ]
28. }
29. }
30. ]
31. }
32. }
`AI代码解释提示
要进一步了解默认从
_source中排除向量这一决定的背景,请阅读这篇博客文章。
文档值输出格式
你可以使用搜索选项 docvalue_fields 返回稠密向量的文档值。响应格式可以按字段控制:
format: array(默认)以 JSON 数组形式返回解码后的向量值。format: binary返回经过 Base64 编码的原始向量字节。无论向量最初是以数组还是二进制字符串形式索引,此格式都适用。数值元素类型(float、bfloat16)按大端字节序输出;byte和bit向量则按存储原样返回。
示例:以数组或 Base64 编码字节的形式获取稠密向量文档值
bash
`
1. PUT _cluster/settings
2. {
3. "persistent": {
4. "indices.id_field_data.enabled": true
5. }
6. }
8. PUT dv-format
9. {
10. "mappings": {
11. "properties": {
12. "vec_float": {
13. "type": "dense_vector",
14. "element_type": "float",
15. "dims": 3,
16. "index": false
17. }
18. }
19. }
20. }
21. POST dv-format/_bulk?refresh
22. {"index":{"_id":"1"}}
23. {"vec_float":[1.5, 2.0, -3.25]}
24. {"index":{"_id":"2"}}
25. {"vec_float":[1.25, -2.5, 4.0]}
26. POST dv-format/_search
27. {
28. "_source": false,
29. "query": { "match_all": {} },
30. "docvalue_fields": ["vec_float"],
31. "sort": "_id"
32. }
`AI代码解释响应示例(数组格式):
markdown
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_id": "1",
6. "fields": {
7. "vec_float": [
8. [1.5, 2.0, -3.25]
9. ]
10. }
11. },
12. {
13. "_id": "2",
14. "fields": {
15. "vec_float": [
16. [1.25, -2.5, 4.0]
17. ]
18. }
19. }
20. ]
21. }
22. }
`AI代码解释要以 Base64 编码字节的形式获取相同的向量,请仅请求二进制格式:
bash
`

1.  POST dv-format/_search
2.  {
3.    "_source": false,
4.    "query": { "match_all": {} },
5.    "docvalue_fields": [ { "field": "vec_float", "format": "binary" } ],
6.    "sort": "_id"
7.  }

`AI代码解释
响应示例(二进制格式):
markdown
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_id": "1",
6. "fields": {
7. "vec_float": [
8. "P8AAAEAAAADAUAAA"
9. ]
10. }
11. },
12. {
13. "_id": "2",
14. "fields": {
15. "vec_float": [
16. "P+AAAAAAAP+QEA=="
17. ]
18. }
19. }
20. ]
21. }
22. }
`AI代码解释存储 行为与 _source
默认情况下,dense_vector 字段不会存储在磁盘上的 _source 中 。这一行为也由索引设置 index.mapping.exclude_source_vectors 控制。新建索引默认启用此设置,且只能在创建索引时设置。
启用后:
dense_vector字段会从_source中移除,其余_source内容照常存储。- 如果请求包含
_source且需要向量值(例如在恢复或重建索引期间),系统会根据向量的内部格式还原向量。
此设置与合成 _source 兼容,后者会从列式存储中重建整个 _source 文档。在完全合成模式下,磁盘上不存储任何 _source,所有字段 --- 包括向量 --- 都会在需要时重建。
还原与 精度
还原向量值时(例如用于重建索引、恢复或显式请求 _source),系统会根据其内部格式恢复向量。默认情况下,向量以单精度浮点数精度存储,因此,如果最初以更高精度类型(例如 double 或 long)索引,还原后的值精度会降低。这种有损表示旨在节省空间,同时保持搜索质量。此外,将 element_type 设置为 bfloat16 会进一步降低还原向量的精度。
在 _source 中存储原始向量
如果你希望完整保留最初提供的向量值,可以重新启用在 _source 中存储向量:
markdown
`
1. PUT my-index-include-vectors
2. {
3. "settings": {
4. "index.mapping.exclude_source_vectors": false
5. },
6. "mappings": {
7. "properties": {
8. "my_vector": {
9. "type": "dense_vector"
10. }
11. }
12. }
13. }
`AI代码解释禁用此设置后:
dense_vector字段会作为_source的一部分存储,与索引时的值完全一致。- 索引会同时存储原始
_source值和用于向量搜索的内部表示,因此会增加存储用量。 - 所有相关接口都会恢复默认在
_source中返回向量,无需使用exclude_vectors或fields。
此配置适用于需要完整保留源数据的场景,例如审计,或确保输入值经过存储和读取后仍完全一致。
为 k 近邻搜索自动量化向量
dense_vector 字段类型支持量化,以减少搜索( searching ) float 向量时所需的内存。dense_vector 的 k 近邻索引支持以下向量量化策略:
以下是使用 bbq_disk 配置基于磁盘的二进制量化的示例:
bash
`
1. PUT my-bbq-disk-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 384,
8. "index": true,
9. "index_options": {
10. "type": "bbq_disk"
11. }
12. }
13. }
14. }
15. }
`AI代码解释量化向量可以使用过采样和重新评分( oversampling and rescoring )来提高近似 k 近邻搜索结果的准确性。
注意
量化后仍会在磁盘上保留原始浮点向量值,以便在数据的整个生命周期内进行重新排名、重建索引和量化改进。这意味着,由于需要同时存储量化向量和原始向量,int8 的磁盘用量会增加约 25%,int4 增加约 12.5%,bbq 增加约 3.1%。
默认量化类型
|------------------------------------|-------------------------------------|-----------------------------------------------------------------------|
| Stack 9.0+ | Stack 9.1+ | Serverless/Stack 9.4+ |
| 索引 float 向量时,默认索引类型为 int8_hnsw | 索引 float 向量时,默认索引类型为 int8_hnsw。 | 索引 float 或 bfloat16 向量时,如果当前许可证支持 bbq_disk,则默认索引类型为 bbq_disk。 |
对于 byte 和 bit 元素类型,自动量化不适用。在所有版本中,这些元素类型始终默认使用不进行量化的 hnsw。
int8
将向量的每个维度量化为 1 字节整数。这样可将内存占用减少 75%(降至原来的四分之一),代价是损失部分准确性。
以下是创建字节量化索引的示例:
bash
`
1. PUT my-byte-quantized-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 3,
8. "index": true,
9. "index_options": {
10. "type": "int8_hnsw"
11. }
12. }
13. }
14. }
15. }
`AI代码解释int4
将向量的每个维度量化为半字节整数。这样可将内存占用减少 87%(降至原来的八分之一),代价是损失准确性。
以下是创建半字节量化索引的示例:
bash
`
1. PUT my-byte-quantized-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 4,
8. "index": true,
9. "index_options": {
10. "type": "int4_hnsw"
11. }
12. }
13. }
14. }
15. }
`AI代码解释注意
int4量化要求向量维度数为偶数。
更优二进制量化( bbq )
bbq,即更优二进制量化( Better binary quantization ),将每个维度的精度降为单个比特。这样可将内存占用减少 96%(降至原来的三十二分之一),代价是更大的准确性损失。通常,在查询时进行过采样( oversampling )并重新排名,有助于减轻准确性损失。你可以选择以下更优二进制量化索引类型之一:
以下是创建二进制量化索引的示例:
bash
`
1. PUT my-byte-quantized-index
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 64,
8. "index": true,
9. "index_options": {
10. "type": "bbq_hnsw"
11. }
12. }
13. }
14. }
15. }
`AI代码解释注意
bbq量化仅支持维度数大于 64 的向量。
稠密向量字段的参数
支持以下映射参数:
element_type
(可选,字符串)用于编码向量的数据类型。
|-----------------|----------------------------------------------------------------------------------------------------------------------|
| float | 为每个维度索引一个 4 字节浮点值。这是默认值。 |
| bfloat16 (9.3+) | 为每个维度索引一个 2 字节浮点值。它使用 bfloat16 编码,而非 IEEE-754 半精度浮点编码,以保持与 4 字节浮点数相同的取值范围。与 float 相比,使用 bfloat16 可能导致存储值的精度损失。 |
| byte | 为每个维度索引一个 1 字节整数值。 |
| bit | 为每个维度索引一个比特值。适用于超高维向量或专门支持比特向量的模型。注意:使用 bit 时,维度数必须是 8 的倍数,且必须表示比特数。 |
dims
(可选,整数)向量的维度数,不能超过 4096。如果未指定 dims,则会将其设置为添加到该字段的第一个向量的长度。
index
(可选,布尔值)如果为 true,你可以使用 k 近邻查询( knn query )或 _search 中的 k 近邻搜索( knn in _search )来搜索此字段。默认为 true。
similarity
(可选¹,字符串)用于 k 近邻搜索的向量相似度度量。文档按其向量字段与查询向量的相似度排名。每份文档的 _score 都根据相似度计算,确保分数为正,且分数越高,排名越靠前。当 element_type: bit 时,默认为 l2_norm,否则默认为 cosine。
¹ 仅当 index 为 true 时,才能指定此参数。
注意
bit向量仅支持使用l2_norm作为相似度度量。
|-------------------|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| l2_norm | 根据向量之间的 L2 距离(也称为欧几里得距离)计算相似度。文档的 _score 计算公式为 1 / (1 + l2_norm(query, vector)^2)。 对于 bit 向量,使用向量之间的汉明距离 hamming,而非 l2_norm。`_score` 的转换公式为 (numBits - hamming(a, b)) / numBits。 |
| dot_product | 计算两个单位向量的点积。此选项提供了一种计算余弦相似度的优化方式。具体约束和评分计算方式由 element_type 决定。 当 element_type 为 float 时,所有向量的长度都必须为 1,包括文档向量和查询向量。文档的 _score 计算公式为 (1 + dot_product(query, vector)) / 2。 当 element_type 为 byte 时,所有向量都必须具有相同的长度,包括文档向量和查询向量,否则结果将不准确。文档的 _score 计算公式为 0.5 + (dot_product(query, vector) / (32768 * dims)),其中 dims 是每个向量的维度数。 |
| cosine | 计算余弦相似度。在索引期间,Elasticsearch 会自动将使用 cosine 相似度的向量归一化为单位长度,从而在内部使用效率更高的 dot_product 计算相似度。原始的未归一化向量仍可通过脚本访问。文档的 _score 计算公式为 (1 + cosine(query, vector)) / 2。`cosine` 相似度不允许模长为零的向量,因为这种情况下余弦相似度没有定义。 |
| max_inner_product | 计算两个向量的最大内积。这与 dot_product 类似,但不要求对向量进行归一化。这意味着每个向量的模长都可能显著影响评分。文档的 _score 会经过调整,以避免出现负值。当 max_inner_product 的值 < 0 时,`_score` 为 1 / (1 + -1 * max_inner_product(query, vector))。当 max_inner_product 的结果非负时,`_score` 的计算公式为 max_inner_product(query, vector) + 1。 |
注意
尽管概念上相关,
similarity参数与文本( text )字段的相似度( similarity )参数不同,接受的选项也不同。
index_options
(可选²,对象)用于配置 k 近邻索引算法的可选部分。分层可导航小世界算法有两个内部参数,会影响数据结构的构建方式。调整这些参数可以提高结果的准确性,但代价是索引速度变慢。
² 仅当 index 为 true 时,才能指定此参数。
type
(必需,字符串)要使用的 k 近邻算法类型。可以是以下任意一种:
-
hnsw:使用分层可导航小世界算法进行可扩展的近似 k 近邻搜索。支持所有element_type值。这是byte和bit元素类型的默认索引类型。 -
int8_hnsw:某些浮点向量的默认索引类型:- 技术栈 9.1 及更高版本:维度数小于 384 的
float向量的默认类型。 - 技术栈 9.0 及更高版本:所有
float向量的默认类型。
该类型结合分层可导航小世界算法与自动标量量化,为
element_type为float或bfloat16的向量提供可扩展的近似 k 近邻搜索。它可将内存占用降至原来的四分之一,代价是损失部分准确性。请参阅"为 k 近邻搜索自动量化向量"。 - 技术栈 9.1 及更高版本:维度数小于 384 的
-
int4_hnsw:结合分层可导航小世界算法与自动标量量化,为element_type为float或bfloat16的向量提供可扩展的近似 k 近邻搜索。它可将内存占用降至原来的八分之一,代价是损失部分准确性。请参阅"为 k 近邻搜索自动量化向量"。 -
bbq_hnsw:结合分层可导航小世界算法与自动二进制量化,为element_type为float或bfloat16的向量提供可扩展的近似 k 近邻搜索。它可将内存占用降至原来的三十二分之一,代价是损失准确性。请参阅"为 k 近邻搜索自动量化向量"。在技术栈 9.1 及更高版本中,bbq_hnsw是维度数大于或等于 384 的float向量的默认索引类型。 -
flat:使用暴力搜索算法进行精确 k 近邻搜索。支持所有element_type值。 -
int8_flat:结合暴力搜索算法与自动标量量化。仅支持element_type为float或bfloat16。 -
int4_flat:结合暴力搜索算法与自动半字节标量量化。仅支持element_type为float或bfloat16。 -
bbq_flat:结合暴力搜索算法与自动二进制量化。仅支持element_type为float或bfloat16。 -
bbq_disk(技术栈 9.2 及更高版本):结合 k 均值聚类算法的变体与自动二进制量化,对向量进行分区并搜索子空间,相比于分层可导航小世界算法,可能更节省内存。仅支持element_type为float或bfloat16。要了解更多信息,请参阅bbq_disk。此类型需要企业版订阅。
m
(可选,整数)分层可导航小世界图中每个节点连接的邻居数量。默认为 16。仅适用于 hnsw、int8_hnsw、int4_hnsw 和 bbq_hnsw 索引类型。
ef_construction
(可选,整数)为每个新节点构建最近邻列表时,要跟踪的候选数量。默认为 100。仅适用于 hnsw、int8_hnsw、int4_hnsw 和 bbq_hnsw 索引类型。
flat_index_threshold
技术栈 9.4 及更高版本
(可选,整数)段文档数量阈值。低于该阈值时,会跳过图或倒排文件结构的构建,改用暴力平坦搜索。-1(默认值)表示使用各格式的默认设置。0 表示始终构建图或倒排文件结构。正值会覆盖格式的默认阈值。仅适用于 hnsw、int8_hnsw、int4_hnsw、bbq_hnsw 和 bbq_disk 索引类型。
default_visit_percentage
技术栈 9.2 及更高版本
(可选,整数)仅适用于 bbq_disk。必须介于 0 到 100 之间。设为 0 时,默认使用 num_candidates 计算访问百分比。提高 default_visit_percentage 通常可以提升最终结果的准确性。默认情况下,每个分片每有 100 万个向量,访问比例约为 1%。
precondition
技术栈 9.4 及更高版本
(可选,布尔值)仅适用于 bbq_disk。设为 true 时,会使用随机正交投影变换索引向量。当某些向量分量不服从正态分布时,这有助于提高准确性。默认为 false。字段创建后无法更改。
cluster_size
技术栈 9.2 及更高版本
(可选,整数)仅适用于 bbq_disk。每个聚类中的向量数量。较小的聚类规模可以提高准确性,但会降低性能。默认为 384。取值必须介于 64 到 65536 之间。
bits
技术栈 9.4 及更高版本
(可选,整数)仅适用于 bbq_disk。量化编码中每个维度使用的比特数。有效值为 1(默认值)、2、4 或 7。较高的值可以提高保真度,但会略微增加磁盘占用并降低查询速度。未指定 rescore_vector 时,bits 会自动调整默认过采样倍数:1 使用 3.0 倍,2 使用 1.5 倍,4 和 7 则禁用过采样。此设置可以在不重建索引的情况下更改。详情请参阅"量化比特数"。
rescore_vector
技术栈,正式发布,9.1 及更高版本
(可选,对象)用于为指定字段的 knn 查询配置自动向量重新评分的可选部分。仅适用于量化索引类型。
|-------------------------|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| on_disk_rescore (9.3+) | (可选,布尔值)仅适用于量化的分层可导航小世界索引类型和 bbq_disk 索引类型。设为 true 时,向量重新评分会直接从磁盘读取原始向量数据,不会将其复制到内存中。当向量数据量大于可用内存容量时,这可以提高性能。此设置仅适用于新索引的向量;更改此设置后,必须重新索引向量或执行强制合并,才能将新设置应用于整个索引。默认为 false。合并操作有独立的选项 on_disk_merge,详见下文。 |
| on_disk_merge (planned) | (可选,布尔值)设为 true 时,合并该字段的向量数据会尽可能使用直接输入/输出,避免合并操作挤出搜索保留在内存中的数据。可以通过更新映射更改此设置,并应用于后续合并;合并时,会按照每个源段写入时的设置读取该段,因此,更改前写入的段会保留旧行为,直到通过合并被替换。默认为 false。 |
| auto_calibrate (9.5+) | (可选,布尔值或字符串)仅适用于 bbq_disk。启用后,Elasticsearch 会根据合并后语料的实际召回特性,为每个合并后的段自动选择最优的量化编码、过采样倍数和预处理方式。合并后包含少于 10,000 个向量的段不会进行校准;如果映射中未另行指定,则使用默认的 3.0 倍过采样。详情请参阅 bbq_disk 自动校准( Auto-calibration for bbq_disk )。 |
合成 _source( Synthetic _source )
dense_vector 字段支持合成 _source( synthetic _source )。
索引和搜索比特向量
使用 element_type: bit 时,所有向量都会被视为比特向量。比特向量每个维度仅使用一个比特,内部以字节形式编码。这对于超高维向量或模型可能很有用。
使用 bit 时,维度数必须是 8 的倍数,且必须表示比特数。此外,对于 bit 向量,常见的向量相似度度量实际上都会采用相同的评分方式,例如使用汉明距离。
我们来比较两个 byte[] 数组,每个数组都表示 40 个独立的比特。
[-127, 0, 1, 42, 127] 的比特表示为 1000000100000000000000010010101001111111。
[127, -127, 0, 1, 42] 的比特表示为 0111111110000001000000000000000100101010。
比较这两个比特向量时,我们首先计算汉明距离( hamming distance )。
xor(异或)结果:
markdown
`

1.  1000000100000000000000010010101001111111
2.  ^
3.  0111111110000001000000000000000100101010
4.  =
5.  1111111010000001000000010010101101010101

`AI代码解释
然后,统计 xor 结果中值为 1 的比特数,得到 18。为了转换为评分,我们用总比特数减去该数量,再除以总比特数:(40 - 18) / 40 = 0.55。这就是这两个向量之间的 _score。
以下是索引和搜索比特向量的示例:
bash
`
1. PUT my-bit-vectors
2. {
3. "mappings": {
4. "properties": {
5. "my_vector": {
6. "type": "dense_vector",
7. "dims": 40, # 1
8. "element_type": "bit"
9. }
10. }
11. }
12. }
`AI代码解释- 表示比特数的维度数
bash
`

1.  POST /my-bit-vectors/_bulk?refresh
2.  {"index": {"_id" : "1"}}
3.  {"my_vector": [127, -127, 0, 1, 42]} # 1
4.  {"index": {"_id" : "2"}}
5.  {"my_vector": "8100012a7f"} # 2

`AI代码解释- 用于表示 40 维比特向量的 5 个字节
- 用于表示 40 维比特向量的十六进制字符串
搜索时,你可以使用 knn 查询查找相似的比特向量:
markdown
`

1.  POST /my-bit-vectors/_search?filter_path=hits.hits
2.  {
3.    "query": {
4.      "knn": {
5.        "query_vector": [127, -127, 0, 1, 42],
6.        "field": "my_vector"
7.      }
8.    }
9.  }

`AI代码解释
bash
`
1. {
2. "hits": {
3. "hits": [
4. {
5. "_index": "my-bit-vectors",
6. "_id": "1",
7. "_score": 1,
8. "_source": {
9. "my_vector": [
10. 127,
11. -127,
12. 0,
13. 1,
14. 42
15. ]
16. }
17. },
18. {
19. "_index": "my-bit-vectors",
20. "_id": "2",
21. "_score": 0.55,
22. "_source": {
23. "my_vector": "8100012a7f"
24. }
25. }
26. ]
27. }
28. }
`AI代码解释图形处理器向量索引( GPU vector indexing )
技术栈,正式发布,9.4 及更高版本
Elasticsearch 可以利用图形处理器加速( GPU acceleration )来加快稠密向量的索引速度。
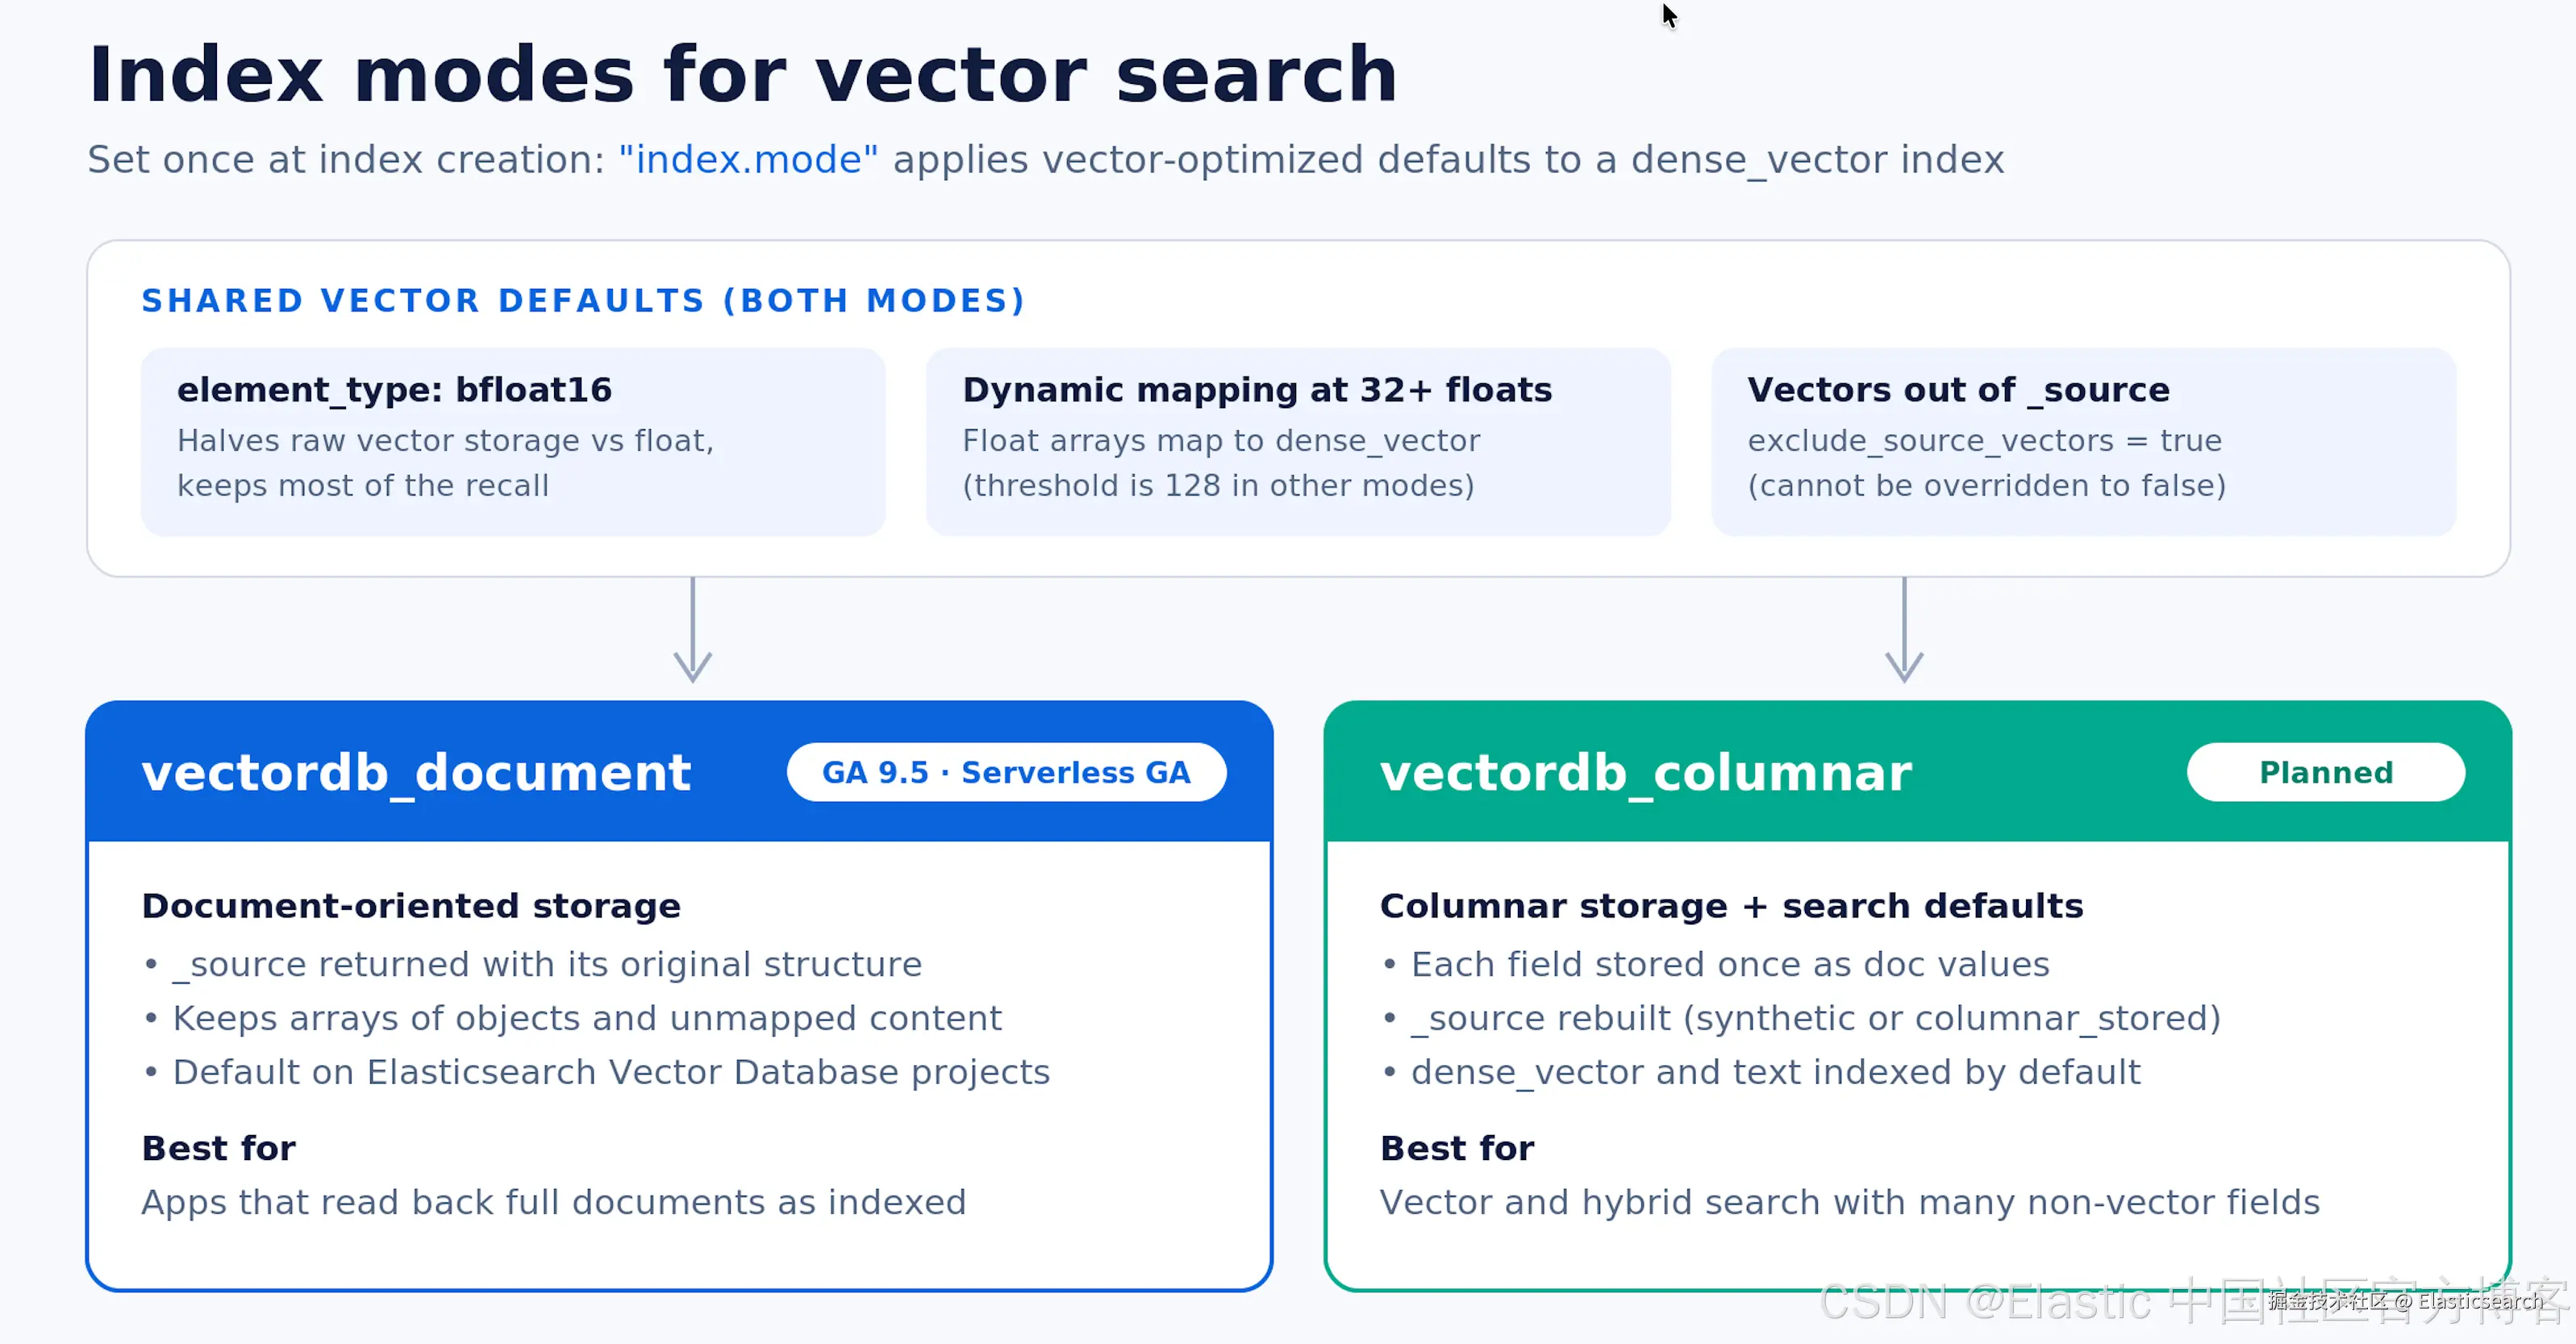
向量搜索的索引模式
vectordb_document
技术栈 9.5 及更高版本
vectordb_document 索引模式( index mode )可针对向量搜索工作负载优化索引。
你必须在创建索引时设置此模式:
arduino
`

1.  PUT my-vector-index
2.  {
3.    "settings": {
4.      "index": {
5.        "mode": "vectordb_document"
6.      }
7.    }
8.  }

`AI代码解释
提示
无服务器向量数据库
在 Elasticsearch 向量数据库( Elasticsearch Vector Database )项目中,新索引会自动使用
vectordb_document。这是唯一受支持的索引模式。详情请参阅何时使用此项目类型( when to use this project type )。
启用 vectordb_document 模式后,除非你显式配置,否则会自动应用以下设置:
element_type(稠密向量)
默认为 bfloat16,而非 float,在保留大部分召回质量的同时,将原始向量的存储成本减半。
- 浮点数数组的动态映射
动态映射时,包含至少 32 个元素的浮点数数组会自动映射为 dense_vector,而其他索引模式使用的阈值为 128 个元素。
index.mapping.exclude_source_vectors
设为 true。向量字段值会从存储的 _source 中排除,以减少存储开销。此设置是必需的,不能覆盖为 false。
index.store.preload
设为 ["vex", "veq", "veb", "cenivf"]。这些向量索引文件扩展名分别对应分层可导航小世界图、标量量化数据、二进制量化数据和倒排文件质心数据,相关文件会预加载到文件系统缓存中。
index.merge.intra_merge_parallelism_enabled
设为 true。启用单次合并操作内部的并行执行,加快段合并速度。
index.merge.scheduler.auto_throttle
设为 false。禁用合并输入/输出的自动限流,让合并全速进行。
vectordb_columnar
vectordb_columnar 索引模式( index mode )将 vectordb_document 的向量搜索默认设置与列式( columnar )存储模型相结合。列式模式将每个字段以文档值的形式仅存储一次,并据此重建 _source,从而减少与向量一同存储的非向量字段的存储占用。与其他列式模式不同,vectordb_columnar 针对搜索而非分析进行优化,因此默认也会为 dense_vector 和 text 字段建立索引。这使其既适用于向量搜索,也适用于结合文本与向量的混合搜索。
vectordb_columnar 很适合向量搜索,尤其是当文档包含大量既非向量也非文本的字段时。如果搜索需要为大量命中结果返回许多字段,可以考虑使用 columnar_stored _source 模式来加快检索。当你需要返回保留原始结构的 _source 时,例如对象数组或未映射的内容,请选择 vectordb_document。
你必须在创建索引时设置此模式:
arduino
`

1.  PUT my-vector-index
2.  {
3.    "settings": {
4.      "index": {
5.        "mode": "vectordb_columnar"
6.      }
7.    }
8.  }

`AI代码解释
vectordb_columnar 应用与 vectordb_document 相同的向量搜索设置和默认值。
它还继承了列式模式的行为和限制( limitations ),例如自动扁平化的映射、合成或 columnar_stored 形式的 _source,以及不允许使用映射级运行时字段。与其他列式模式不同,它默认会为 dense_vector 字段建立索引,保留 text 字段的位置信息和长度归一化因子,将动态字符串映射为 text,并保持查询缓存启用,以支持带筛选条件的向量搜索。完整的设置和默认值列表,请参阅 vectordb_columnar 设置( vectordb_columnar settings )。
可更新的字段类型( Updatable field type )
为了更好地满足扩展和性能需求,可以通过更新映射接口( Update Mapping API ),按照下图更新 index_options 中的 type 设置(允许跳跃式变更):
|------|--------------------------------------------------------------------------------------------------------|
| 9.1+ | flat --> int8_flat --> int4_flat --> bbq_flat --> hnsw --> int8_hnsw --> int4_hnsw --> bbq_hnsw |
| 9.0 | flat --> int8_flat --> int4_flat --> hnsw --> int8_hnsw --> int4_hnsw |
更新所有分层可导航小世界索引类型( hnsw、int8_hnsw、int4_hnsw、bbq_hnsw )时,连接数 m 必须保持不变或增加。
在所有其他情况下,更新 index_options 中的 type 都会失败。
切换类型不会重新索引已经建立索引的向量,它们会继续使用原来的 type;更改后索引的向量则会使用新的 type。
例如,可以定义一个使用 flat 类型(原始 32 位浮点数数组)的稠密向量字段,用于索引第一批数据。
bash
`
1. PUT my-index-000001
2. {
3. "mappings": {
4. "properties": {
5. "text_embedding": {
6. "type": "dense_vector",
7. "dims": 384,
8. "index_options": {
9. "type": "flat"
10. }
11. }
12. }
13. }
14. }
`AI代码解释将 type 更改为 int4_hnsw,可确保更改后索引的向量使用四位整数标量量化表示和分层可导航小世界算法(例如用于 k 近邻查询)。这也包括通过合并( merging )先前创建的段而生成的新段。
bash
`
1. PUT /my-index-000001/_mapping
2. {
3. "properties": {
4. "text_embedding": {
5. "type": "dense_vector",
6. "dims": 384,
7. "index_options": {
8. "type": "int4_hnsw"
9. }
10. }
11. }
12. }
`AI代码解释在此更改之前索引的向量会继续使用 flat 类型(原始 32 位浮点数表示,并通过暴力搜索执行 k 近邻查询)。
要将所有向量更新为新类型,需要重建索引或执行强制合并。
调试时,可以使用索引段接口( Index Segments API )查看每种 type 对应的段数和文档数。