Intro
2012 年,AlexNet 团队训练了一个大型深层卷积神经网络,用于将 ImageNet LSVRC-2010 数据集中的 120 万张高分辨率图像分类为 1,000 个类别。在测试集上,AlexNet 取得了 37.5% 的 Top-1 错误率和 17.0% 的 Top-5 错误率,显著刷新了当时的最佳成绩。
AlexNet 包含约 6,000 万个参数和 65 万个神经元,由五个卷积层和三个全连接层组成,部分卷积层后接最大池化层,最终通过 Softmax 层输出 1,000 个类别的预测结果。为提高训练效率,AlexNet 使用了非饱和激活函数 ReLU,并通过 GPU 高效实现卷积运算。为缓解全连接层的过拟合问题,模型还采用了当时新近提出的正则化方法 Dropout。
在随后举行的 ILSVRC-2012 竞赛中,AlexNet 的一个变体取得了 15.3% 的 Top-5 测试错误率,而排名第二的参赛作品为 26.2%。这一成果推动了深度卷积神经网络在图像识别领域的广泛应用。
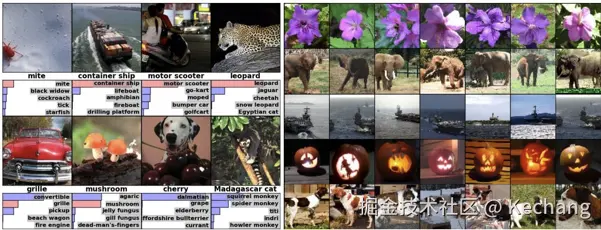
作为神经网络初学者,我计划以学习和理解为主要目的,使用 NumPy 从零设计和实现一个参考 AlexNet 架构的卷积神经网络,并在 MNIST(Modified National Institute of Standards and Technology)数据集上进行验证。
考虑到学习效果、经济成本和训练时间,我将保留 AlexNet 的核心架构思想与网络拓扑,同时根据 MNIST 的数据规模和图像尺寸进行适配,设计一个轻量化的 Tiny-AlexNet。此外,对于已有成熟实践的实现细节,将酌情采用现代常用方案,如在仿射层、卷积层中使用 He 初始化。
开发与训练环境如下:
| 软硬件 | 型号 |
|---|---|
| 设备型号 | MacBook Air (Mac16,12) |
| 处理器(SoC) | Apple M4(10 核:4 个性能核 + 6 个能效核) |
| 系统内存 | 16 GB 统一内存(Unified Memory) |
| 操作系统 | macOS 26.6.2(Darwin 25.6.0,arm64) |
| 运行环境 | Python 3.9.6 venv |
| 核心计算库 | NumPy 2.0.2(底层计算库:Apple Accelerate / vecLib BLAS) |
学习目标: 熟悉 AlexNet 的网络结构与前向传播、反向传播机制,学习 CNN 的核心原理,加深对卷积神经网络的理解。通过设计、验证、训练、评估,了解神经网络开发的基本流程。
训练成本预估: 原版 AlexNet 在 ILSVRC 数据集上训练时,每轮涉及大量浮点运算。2012 年,使用两块 GTX 580 GPU 训练 90 轮耗时近 6 天。若使用纯 Python/NumPy 在 CPU 上实现并训练原版模型,计算成本将显著增加。 相比之下,针对 MNIST 适配的 Tiny-AlexNet 大幅降低了计算量。通过这种方式,可以在较低的计算与时间成本下,实践卷积网络的实现、反向传播与参数优化,并观察模型的训练过程和收敛表现。
Dataset
ILSVRC-2010 是 AlexNet 论文中主要使用的数据集版本之一。由于该版本提供了带标签的测试数据,研究人员可以直接评估模型的分类性能。
因为是以学习和复现为目的,因此选择小得多的 MNIST 数据集进行实验。MNIST 仅包含 28 × 28 的灰度图像,数据规模也远小于 ImageNet,直接照搬 AlexNet 的网络结构会导致模型容量与数据规模不匹配。
MNIST 数据集可从 Kaggle 下载。
MNIST 数据集包含以下文件:
| Filename | 说明 |
|---|---|
t10k-images.idx3-ubyte |
测试集图像 |
t10k-labels.idx1-ubyte |
测试集标签 |
train-images.idx3-ubyte |
训练集图像 |
train-labels.idx1-ubyte |
训练集标签 |
MNIST 使用 IDX 二进制格式存储数据:
ubyte:无符号单字节整数,即uint8,取值范围为 0~255。idx1:存储一维数组,例如标签数据,形状为(N,)。idx3:存储三维数组,例如图像集合,形状为(N, H, W)。
原始数据只有训练集和测试集。为了便于调参,避免使用测试集参与模型选择,需要从训练集中划分出验证集。
我计划从原始训练集中抽取 10,000 张图像作为验证集,剩余 50,000 张作为训练集。考虑到 MNIST 数据规模较小,数据预处理阶段将直接把数据全部读入内存。
idx1
idx1 是 IDX 格式中用于存储一维数组的二进制格式,采用大端序。文件由两部分组成:8 字节的元数据头部(Header)和紧随其后的数据载荷(Payload)。
Header
text
魔数 Magic Number:0x00000801 = 2049

Byte 0: 0x00
Byte 1: 0x00
Byte 2: 0x08  # 数据类型:unsigned byte
Byte 3: 0x01  # 维度:1

元素总数 N:32 位无符号大端整数

Byte 4: 0x00
Byte 5: 0x00
Byte 6: 0xEA
Byte 7: 0x60  # N = 60,000
Payload
从偏移 0x08(第 8 字节)开始,依次存储 N 个标签,每个标签占 1 字节。
text
Byte 8  : 第 0 个样本的标签(如 0x05,代表数字 5)
Byte 9  : 第 1 个样本的标签(如 0x00,代表数字 0)
Byte 10 : 第 2 个样本的标签(如 0x04,代表数字 4)
...
Byte (7 + N) : 第 N-1 个样本的标签因此,idx1 文件的总大小为:
8+N bytes
idx3
idx3 是 IDX 格式中用于存储三维数组的二进制格式,同样采用大端序。文件由两部分组成:16 字节的元数据头部和紧随其后的数据载荷。
Header
text
魔数 Magic Number:0x00000803 = 2051

Byte 0: 0x00
Byte 1: 0x00
Byte 2: 0x08  # 数据类型:unsigned byte
Byte 3: 0x03  # 维度:3

样本总数 N:32 位无符号大端整数

Byte 4: 0x00
Byte 5: 0x00
Byte 6: 0xEA
Byte 7: 0x60  # N = 60,000(训练集)

图像高度 H:32 位无符号大端整数

Byte 8:  0x00
Byte 9:  0x00
Byte 10: 0x00
Byte 11: 0x1C  # H = 28

图像宽度 W:32 位无符号大端整数

Byte 12: 0x00
Byte 13: 0x00
Byte 14: 0x00
Byte 15: 0x1C  # W = 28
其中,测试集的样本数为 10,000,即 N = 0x00002710。
Payload
从偏移 0x10(第 16 字节)开始,连续存储所有图像的像素值。每个像素占 1 字节,类型为 uint8,取值范围为 0~255。像素按行优先排列。
text
Byte 16                  : 第 0 张图像,第 0 行第 0 列像素
Byte 17                  : 第 0 张图像,第 0 行第 1 列像素
...
Byte (16 + 28*28 - 1)    : 第 0 张图像,第 27 行第 27 列像素

Byte (16 + 28*28)        : 第 1 张图像,第 0 行第 0 列像素
...
Byte (15 + N*H*W) : 第 N-1 张图像的最后一个像素因此,idx3 文件的总大小为:
16+N×H×W bytes
数据预处理
读取原始图像后,需要将数据转换为适合后续卷积神经网络计算的形式。不同数据集的图像尺寸、通道数和像素值范围可能不同,因此预处理方式也需要根据数据特点选择。
AlexNet 论文使用的 ImageNet 图像尺寸各不相同。作者首先将图像的短边缩放至 256 像素,再从中心裁剪出 ( 256×256) 的区域,并减去训练集的平均像素值。
训练时,AlexNet 还使用了数据增强:从 ( 256×256) 的图像中随机裁剪 ( 224×224) 的区域,并进行随机水平翻转和 RGB PCA 颜色扰动。通过为同一张图像生成不同的训练样本,这些方法有助于减少过拟合。
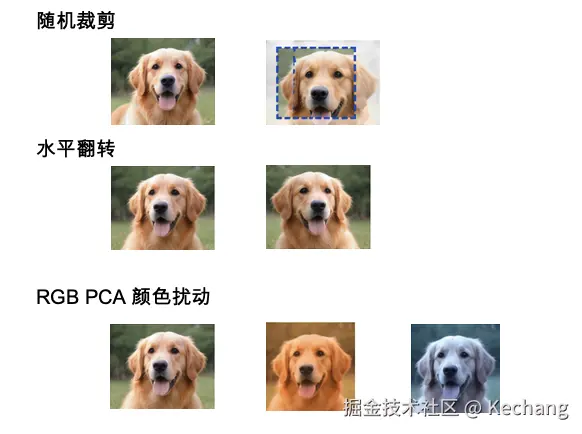
补充:RGB PCA 颜色扰动
PCA,即主成分分析,是一种分析数据变化方向的方法。它通常先对数据进行中心化,再计算协方差矩阵,求出其特征向量和特征值。特征向量给出一组相互正交的方向,特征值表示数据在对应方向上的方差大小。
PCA 常用于降维,即选择方差较大的几个方向,将原始数据投影到这些方向张成的低维空间中(这样原数据的差别在新的投影空间中被放大)。AlexNet 则用 PCA 来生成颜色扰动,并没有降维。
具体来说,作者将 ImageNet 训练集中每个像素的 RGB 值视为一个三维向量,计算这些向量的 ( 3×3) 协方差矩阵,得到三个主成分方向及其对应的特征值。然后,沿三个方向分别生成随机扰动并相加,得到一个 RGB 偏移量:
ΔI=∑i=13αiλipi,αi∼N(0,0.12) 其中,( pi) 是第 ( i) 个主成分方向,( λi) 是对应的特征值,( αi) 是随机采样的系数。同一张训练图像的所有像素加上相同的 RGB 偏移量;当这张图像再次用于训练时,重新采样扰动。
这种方法利用了训练集中 RGB 通道的变化关系,产生类似光照强度和颜色变化的效果。它基于「适度改变光照通常不会改变图像中物体的类别。通过在训练中引入这些变化,模型有机会学到对光照变化更稳健的特征。」
很厉害的技巧!
考虑到 MNIST 的数据特点,本例不采用上述缩放、裁剪、均值中心化和 RGB 颜色扰动,而是保留 MNIST 原始的 28 × 28 图像尺寸,并将像素值归一化到 [0.0, 1.0]。
- 调整张量形状:将原始图像数组从 (N,H,W) 扩展为 (N,Cin,H,W)。对于 MNIST,输入通道数为 1,因此最终形状为 (N,1,28,28)。
- 归一化:将像素值从
uint8转换为float32,并除以 255,使其映射到 0.0,1.0 区间。
数据集划分
总之,我们完成数据读取与预处理后,将原始训练集划分为训练集和验证集,并保留原始测试集用于最终评估。
| Filename | 类型 | 样本数 | 用途 |
|---|---|---|---|
t10k-images.idx3-ubyte |
测试集图像 | 10,000 | 评估 |
t10k-labels.idx1-ubyte |
测试集标签 | 10,000 | 评估 |
t50k-images.idx3-ubyte |
训练集图像 | 50,000 | 训练 |
t50k-labels.idx1-ubyte |
训练集标签 | 50,000 | 训练 |
v10k-images.idx3-ubyte |
验证集图像 | 10,000 | 调参 |
v10k-labels.idx1-ubyte |
验证集标签 | 10,000 | 调参 |
Architecture
原版 AlexNet 的架构图如下。由于 2012 年使用的 NVIDIA GTX 580 单卡显存仅有 3 GB,无法轻松容纳整个模型及训练过程中产生的中间数据,因此论文中采用了双 GPU 并行的设计。
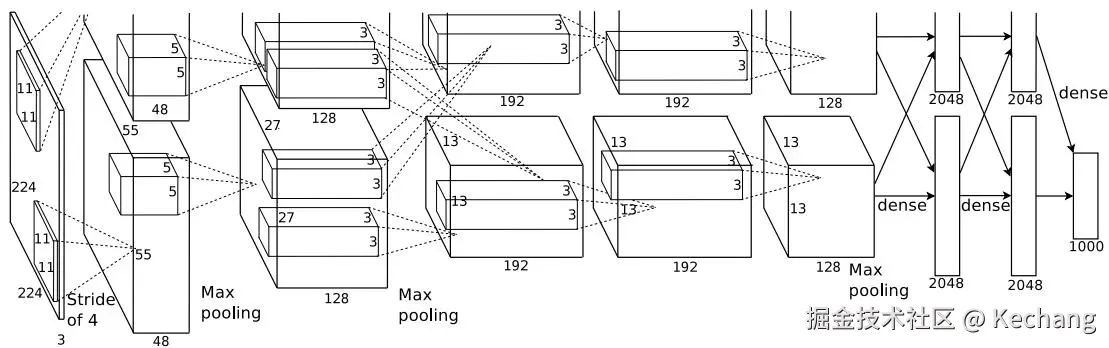
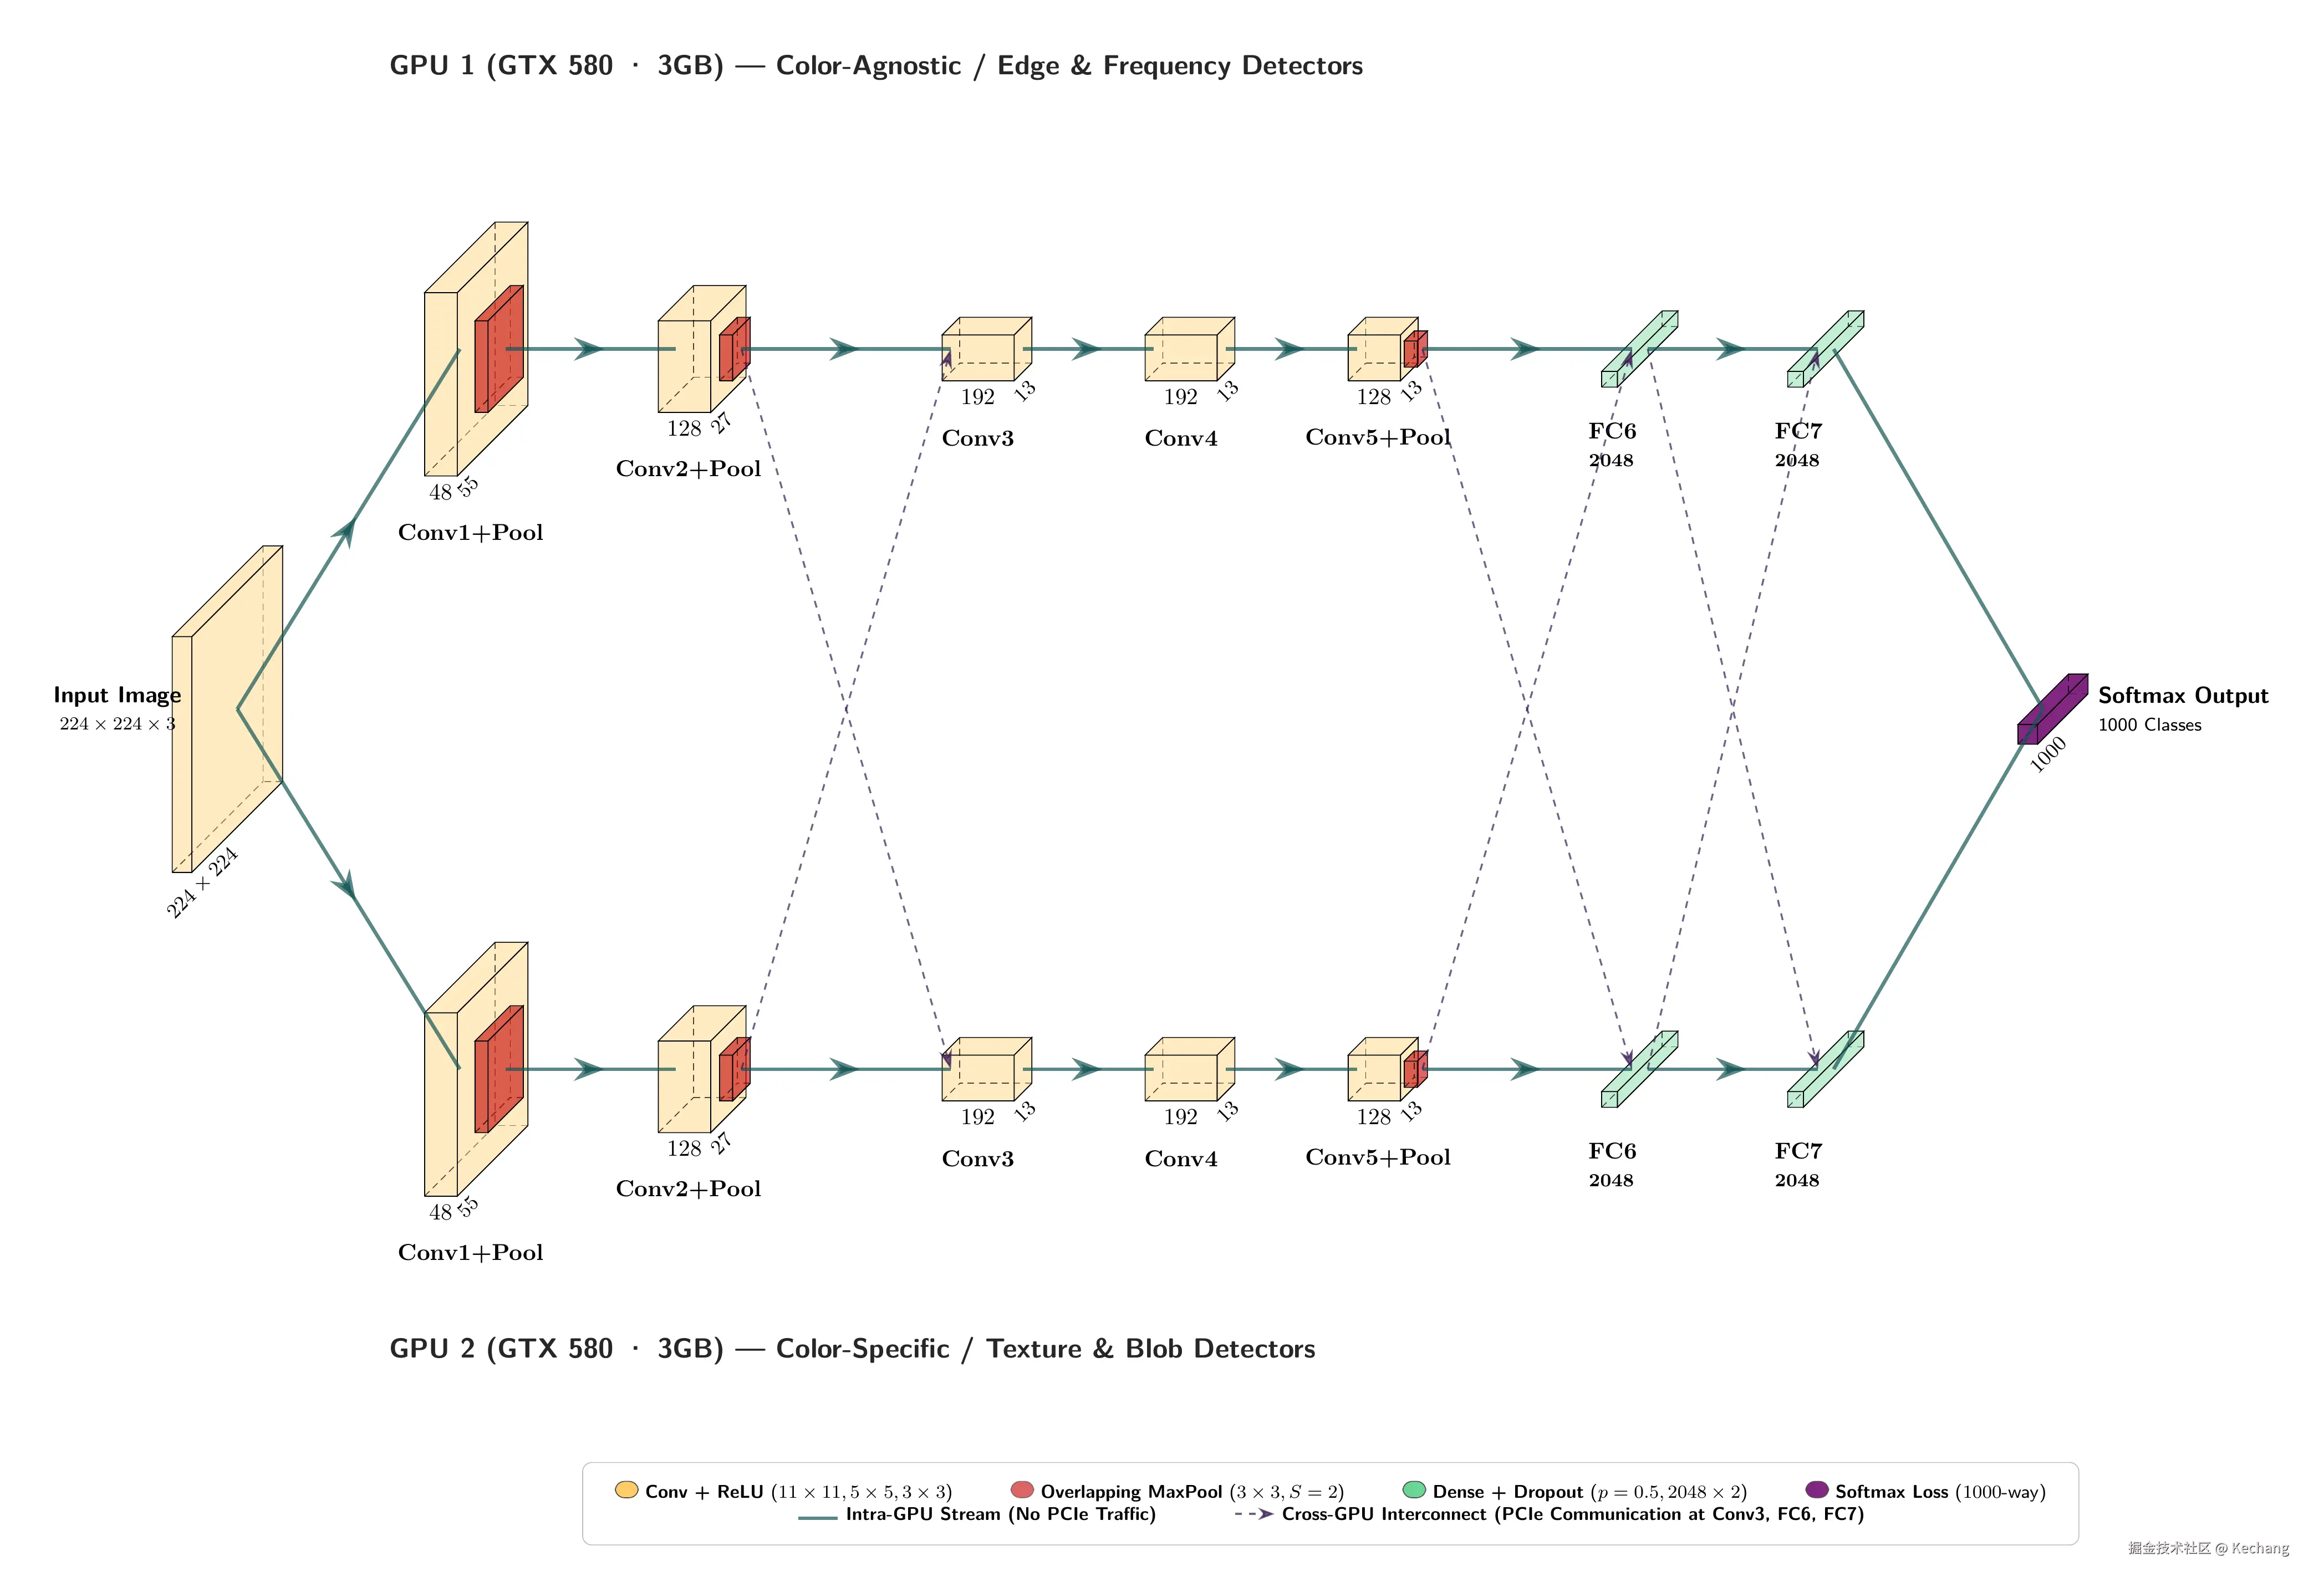
论文中的架构图存在排版截断,我重新绘制了一份结构图:
双 GPU 与单流架构
原版 AlexNet 的双 GPU 设计主要出于当时的硬件限制。
- 显存需求:模型包含约 6,000 万个参数,训练时还需要保存前向传播产生的中间激活值及反向传播所需的数据,显存占用较高。
- 分治策略:将部分网络计算分配到两张 GPU 上,每张 GPU 负责部分卷积核和特征图计算,并在指定层进行跨 GPU 通信。
这体现了根据各层的特性,合理拆分任务并行计算突破硬件资源限制的思路。
对于我们的 Tiny-AlexNet,模型规模较小,没有必要实现双 GPU 并行。因此,为降低实现复杂度,我们会将网络合并为单一计算流。
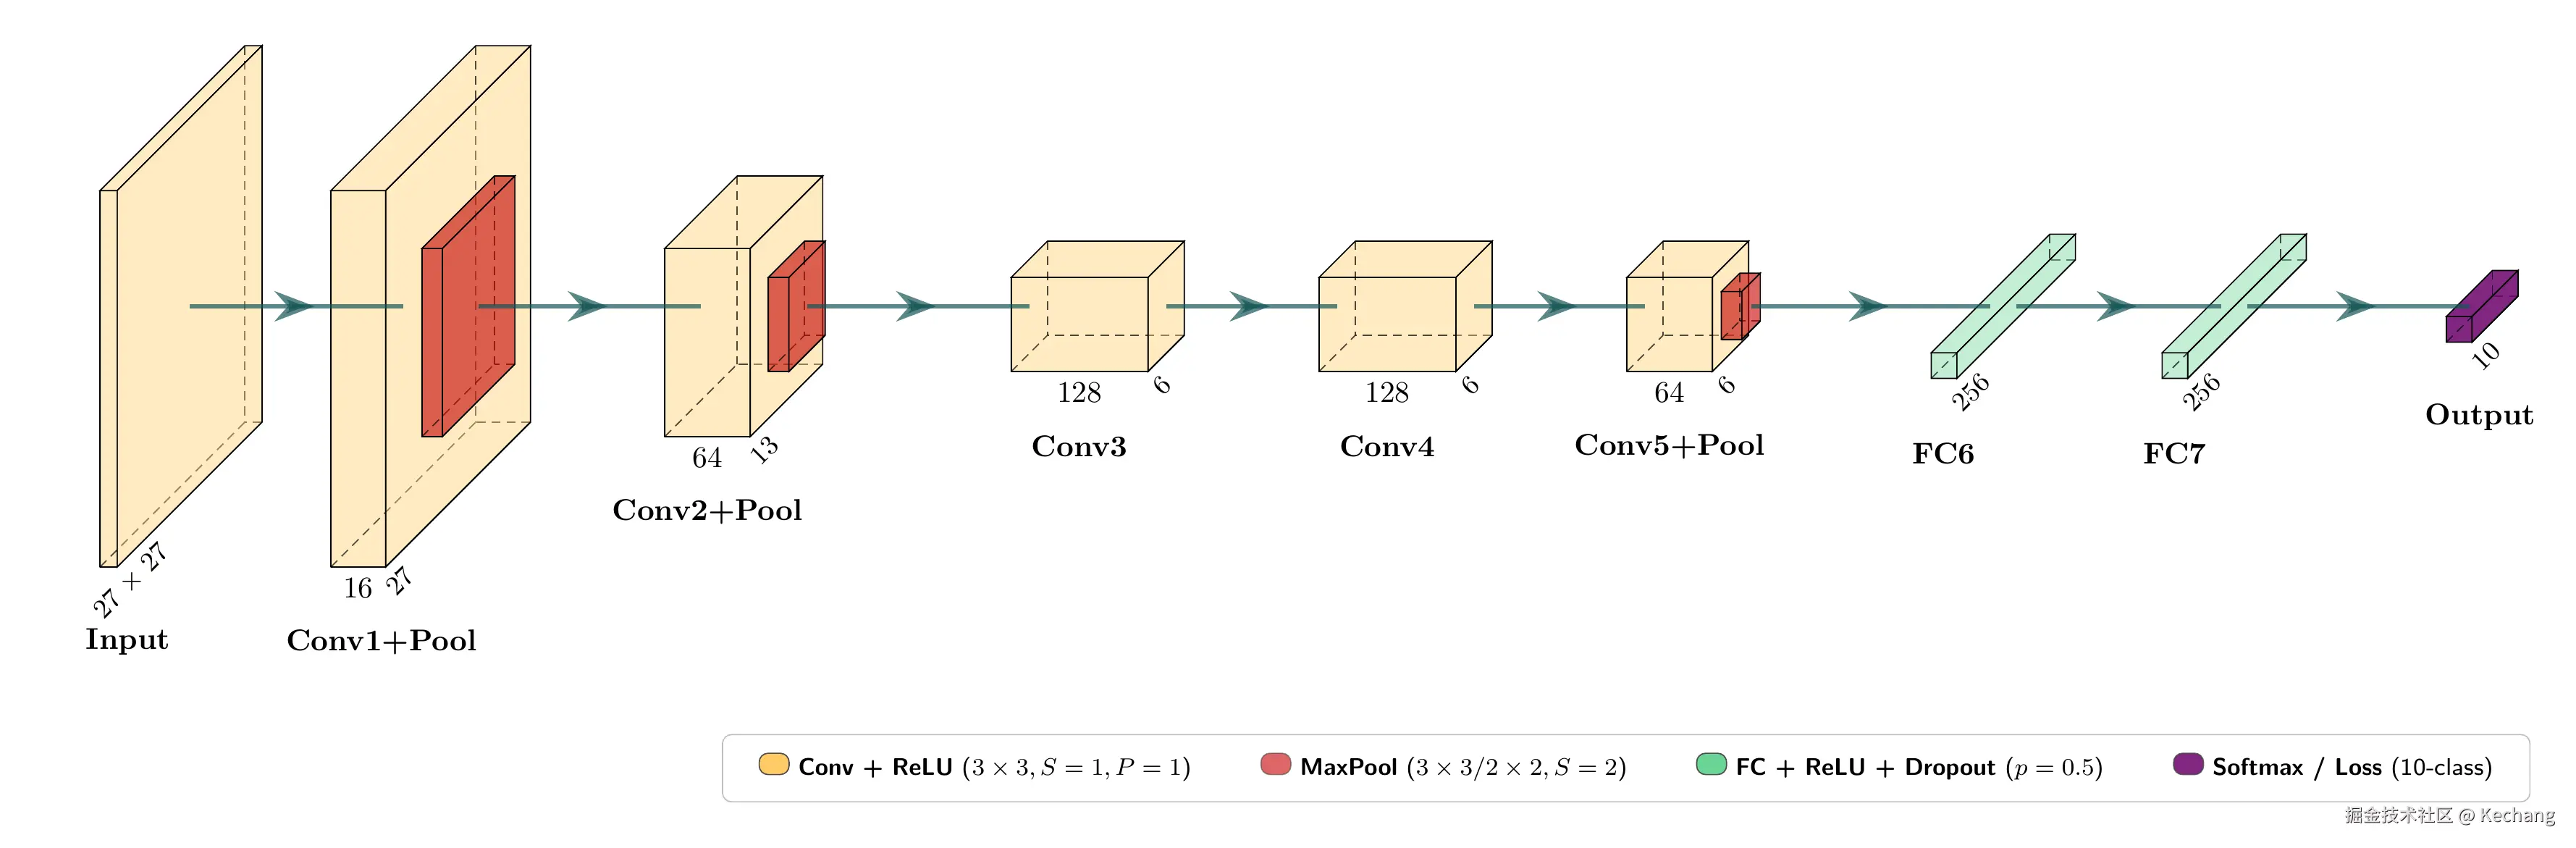
未来面对更大规模的模型时,可进一步学习数据并行、模型并行等分布式训练方法。
激活函数
Alex 团队通过实验确认,使用 ReLU 的网络训练错误率下降得更快。最终,AlexNet 选择 ReLU 作为激活函数。
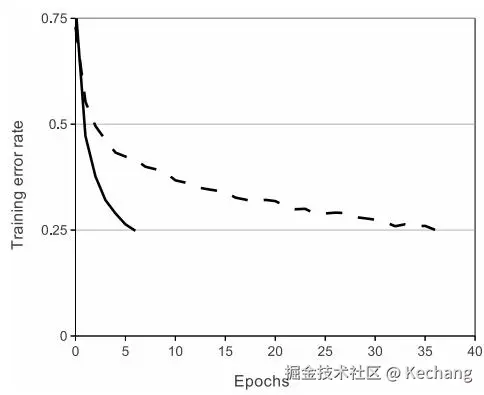
ReLU 定义为:
ReLU(x)=max(0,x)
其导数为:
∂x∂ReLU(x)={1,0,x>0x≤0
相较于 Sigmoid、Tanh 等饱和激活函数,ReLU 在正半轴上的导数恒为 1,有助于缓解梯度消失问题。
我们同样会采用 ReLU。
局部响应归一化(LRN)
AlexNet 使用了局部响应归一化(Local Response Normalization,LRN),其设计灵感来源于生物学中的侧抑制机制。
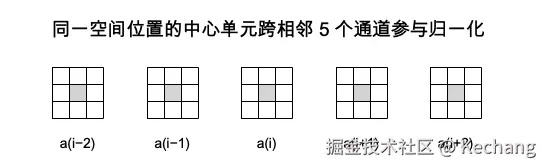
对于输入特征图上位置 (i,j) 的第 c 个通道,LRN 的计算形式为:
yi,jc=(k+α∑l=max(0,c−n/2)min(N−1,c+n/2)(xi,jl)2)βxi,jc
其中:
- xi,jc、 yi,jc:输入与输出特征图的数值。
- N:特征图的总通道数。
- n:参与归一化的邻近通道范围。
- k,α,β:控制归一化行为的超参数。
LRN 在局部通道范围内,根据相邻通道的响应强度调整当前通道的输出。较大的邻近响应会增大归一化分母,从而抑制当前响应。
不过,LRN 并不是现代 CNN 的必需组件。后续网络研究表明,在很多架构中,移除 LRN 并不会降低模型性能。
考虑到 LRN 不是很常用,并且会显著增加前向和反向传播的代码实现、计算复杂度,因此 Tiny-AlexNet 不使用 LRN。
补充:AlexNet 论文中的 LRN 在通道边界处直接截断邻域,没有像循环数组那样首尾回绕。(论文中给出的 LRN 计算公式的分母的求和上下界中的 max 和 min 将索引限制在 0 到 N−1 之间)
池化层
AlexNet 采用了重叠最大池化(Overlapping Max Pooling)。
传统的 2×2 最大池化通常使用步幅 S=2,相邻窗口互不重叠。
AlexNet 则在相关池化层中使用:
FH=FW=3,S=2,P=0
窗口大小为 3×3,每次移动 2 个像素,因此相邻窗口在空间上重叠 1 个像素。
举个例子:
text
窗口 1:[x0, x1, x2]
窗口 2:        [x2, x3, x4]
此时 x2 同时属于两个池化窗口。
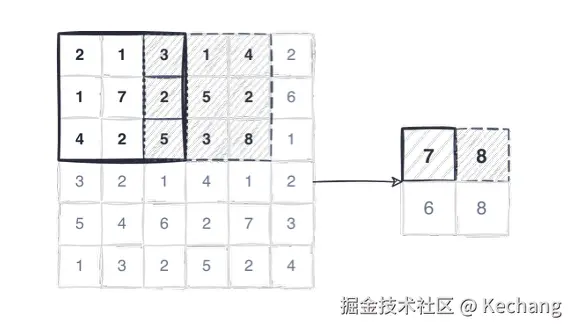
AlexNet 论文指出,重叠池化相较于非重叠池化略微降低了分类错误率,并且在实验中表现出一定的抗过拟合优势。
We generally observe during training that models with overlapping pooling find it slightly more difficult to overfit.
重叠池化的反向传播
最大池化的反向传播会将梯度传递给前向传播时选中的最大值位置。
假设 x2 同时是两个池化窗口的最大值,分别对应输出 out1 和 out2。
根据链式法则:
∂x2∂L=∂out1∂L∂x2∂out1+∂out2∂L∂x2∂out2
由于两个窗口都依赖于 x2,其梯度贡献必须累加。
因此,在实现 MaxPool 的反向传播时,需要使用 dx[idx] += dout,累加来自多个窗口的梯度。
Dropout
Dropout 是 AlexNet 用于缓解全连接层过拟合的重要技术。
Without dropout, our network exhibits substantial overfitting.
其原理是在训练阶段,以一定概率随机将部分神经元的输出置零,使网络不能过度依赖特定神经元,从而学习更具鲁棒性的特征。
AlexNet 在前两个全连接隐藏层中使用了 Dropout,丢弃概率为 p=0.5。
Dropout 的计算
假设下一层神经元的输入为:
z=i=1∑DWiai+b
其中 ai 是上一层的激活值。
在 AlexNet Dropout 方案中,训练阶段为每个神经元独立采样一个二值掩码:
mi∼Bernoulli(1−p)
当 p=0.5 时:
mi={1,0,50% 的概率50% 的概率
因此,训练阶段的输出为:
ztrain=i=1∑DWimiai+b
如果推理阶段关闭 Dropout,直接使用全部神经元,则:
ztest=i=1∑DWiai+b
如何处理训练与推理阶段的差异?
在 AlexNet Dropout 方案中,推理阶段将相关激活值乘以保留概率 1−p,以匹配训练阶段的期望。
当 p=0.5 时:
aitest=0.5ai
一个简单的理解是:训练时候随机丢掉了一半的能量,推理的时候全部的神经元都要激活,所以能量会是训练阶段的两倍,所以推理的时候相关激活值乘以 0.5 以降低到相同能量大小。
实际上这样是不严谨的, ztrain=∑i=1DWimiai+b 。当偏置 b=0 时,不能简单地认为二者始终恰好相差两倍
现代实现中更常见的是 Inverted Dropout:训练阶段对保留的激活值除以保留概率 1−p,推理阶段则不需要额外缩放。
其训练阶段的输出为:
aitrain=1−pmiai
因为考虑到要验证 AlexNet Dropout 是否能显著降低过拟合,所以 Tiny-AlexNet 将同样在 FC6 和 FC7 后使用 AlexNet Dropout,丢弃概率均为 0.5。后续会通过对比有无 Dropout 的实验,观察其对训练误差、验证误差和过拟合的影响。
最优化方法
AlexNet 使用带动量的随机梯度下降法(SGDM),并结合权重衰减。
论文采用的主要参数为:
- Batch Size:128
- Momentum:0.9
- Weight Decay:0.0005
- 初始学习率:0.01
其更新形式可以写为:
vi+1=0.9vi−0.0005ϵwi−ϵ⟨∂w∂L wi⟩Di
wi+1=wi+vi+1
其中:
i:参数更新的迭代索引。 vi:动量变量。 wi:当前参数。 ϵ:学习率。 ⟨∂L/∂w⟩Di:当前 Mini-batch 上的平均梯度。
权重衰减项用于限制权重的增长,动量项则利用历史更新方向改善优化过程。
AlexNet 还采用了人工调整学习率的策略:当验证错误率在当前学习率下不再改善时,将学习率缩小为原来的十分之一。
我们将尝试对比以下三种经典的优化器:
- SGD:随机梯度下降。
- SGDM:带动量的随机梯度下降。
- Adam:结合一阶、二阶梯度矩估计的自适应优化方法。
初始化参数
AlexNet 论文采用均值为 0、标准差为 0.01 的高斯分布初始化权重,并根据网络层的位置设置不同的偏置。
We initialized the weights in each layer from a zero-mean Gaussian distribution with standard deviation 0.01. We initialized the neuron biases in the second, fourth, and fifth convolutional layers, as well as in the fully-connected hidden layers, with the constant 1.
当时,He 初始化尚未提出。现代 CNN 则常采用 He 初始化,以便更好地适配 ReLU 激活函数。
对于 ReLU 网络,He 初始化的典型形式为:
W∼N(0,fan_in2)
其中 fan_in(扇入) 表示每个输出单元对应的输入连接数。
对于卷积层:
fan_in=CinFHFW
对于仿射层:
fan_in=Din
我们将采用 He 初始化,并将偏置初始化为 0。
学习率
AlexNet 使用统一的初始学习率,并根据验证集错误率的变化手动调整。
当验证错误率停止改善时,将学习率缩小为原来的十分之一。AlexNet 论文中初始的学习率为 0.01,训练结束前共缩小了三次。
Tiny-AlexNet 架构
Tiny-AlexNet 保留原版 AlexNet 的 8 层骨架,即 5 个卷积层和 3 个全连接层,同时根据 MNIST 的输入尺寸、类别数量和计算资源缩减网络规模。
整体结构如下:
text
Input
  ↓
Conv1 → ReLU → MaxPool1
  ↓
Conv2 → ReLU → MaxPool2
  ↓
Conv3 → ReLU
  ↓
Conv4 → ReLU
  ↓
Conv5 → ReLU → MaxPool3
  ↓
Flatten
  ↓
FC6 → ReLU → Dropout
  ↓
FC7 → ReLU → Dropout
  ↓
FC8
  ↓
SoftmaxWithLoss
其中,FC8 输出 10 个类别的 Logits,随后由 SoftmaxWithLoss 计算分类损失。
输入尺寸与 Conv1
MNIST 的原始输入形状为:
X.shape=(N,1,28,28)
其中:
- N:Batch Size。
- Cin=1:灰度图像只有一个通道。
- H=W=28:图像的高和宽。
二维卷积的输出尺寸为:
OH=⌊SH+2P−FH⌋+1
OW=⌊SW+2P−FW⌋+1
为了保留浅层特征的空间分辨率,Conv1 采用 3×3 卷积核、步幅 S=1 和填充 P=1。
卷积核尺寸必须为奇数,因为卷积是要在中心点输出一个高精度的加权特征响应,必须有中心像素。
因此:
OH=128+2(1)−3+1=28
同理, OW=28。
如果只看卷积输出,形状将变为:
(N,1,28,28)→(N,Cout,28,28)
接下来应该考虑 MaxPool1,若在池化层降采样为原来的一半,那么 S 可取 2,要重叠池化那么 FH 只能比 S 大,比如 3。但是代入 OH=SH+2P−FH+1 发现 OH 不是整数(即无法顺利池化)。
重新考虑 Conv1,令 OH=29 、 FH 按照惯例取 3 ,尝试代入公式反推 S、 P 。即 29=S28+2P−FH+1,由 S<FH 只能取 1、 2,发现 S、 P 无解。
考虑非对称 Padding,给 MNIST 边缘填充一圈零 (28×28→29×29),即输入 shape=(N,16,29,29) ,若 Conv1 不变,将输出 (N,16,29,29),在 MaxPool1( FH=3, S=2, P=2) 输出 (N,16,14,14) ,尺寸确实对接成功了,但是同样的情景又出现了:Conv1 处理的输入也是偶数尺寸,输出会是偶数尺寸。后续还有卷积池化层,同样的情况只会导致我们又遇到相同的问题,所以不考虑这种方式。
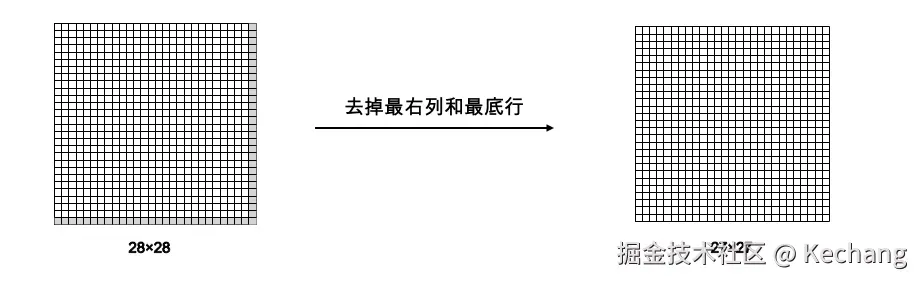
考虑裁剪 MNIST 边缘 (28×28→27×27),Conv1( FH=3, S=1, P=1) 输出 (N,16,27,27), MaxPool1( FH=3, S=2, P=0) 输出 (N,16,13,13) 是奇数了,问题不会再出现了。
即我们选择在进入网络时裁剪图像的最末一行和最末一列:
28×28→27×27
因此,实际输入为:
X.shape=(N,1,27,27)
那么重新推导 Conv1:
Conv1 使用 16 个卷积核:
W1.shape=(16,1,3,3)
b1.shape=(16,)
经过 Conv1 后:
OH=OW=127+2(1)−3+1=27
输出形状为:
(N,16,27,27)
MaxPool1
AlexNet 使用重叠池化,典型配置为 3×3 窗口、步幅 2。
对于当前的 27×27 特征图:
OH=OW=⌊227−3⌋+1=13
因此:
(N,16,27,27)→(N,16,13,13)
Conv2 与 MaxPool2
Conv2 使用 64 个卷积核:
W2.shape=(64,16,3,3)
b2.shape=(64,)
采用 3×3 卷积核、步幅 1、填充 1,保持空间尺寸不变:
(N,16,13,13)→(N,64,13,13)
接着进行 3×3、步幅 2 的最大池化:
OH=OW=⌊213−3⌋+1=6
因此:
(N,64,13,13)→(N,64,6,6)
Conv3 与 Conv4
Conv3 将通道数增加到 128:
W3.shape=(128,64,3,3)
b3.shape=(128,)
采用 3×3、步幅 1、填充 1,输出形状为:
(N,64,6,6)→(N,128,6,6)
Conv4 保持 128 个通道:
W4.shape=(128,128,3,3)
b4.shape=(128,)
同样采用 3×3、步幅 1、填充 1,因此:
(N,128,6,6)→(N,128,6,6)
Conv5 与 MaxPool3
Conv5 将通道数从 128 降至 64:
W5.shape=(64,128,3,3)
b5.shape=(64,)
经过卷积和 ReLU 后,输出为:
(N,128,6,6)→(N,64,6,6)
最后使用 2×2、步幅 2 的最大池化:
OH=OW=⌊26−2⌋+1=3
因此:
(N,64,3,3)
注:为适配较小特征图,MaxPool3 使用非重叠池化
Flatten 与全连接层
经过最后一个池化层后,特征图形状为:
(N,64,3,3)
Flatten 将每个样本的通道与空间维度展平:
Din=64×3×3=576
因此:
(N,64,3,3)→(N,576)
接着依次通过三个全连接层。
FC6:
W6.shape=(576,256)
b6.shape=(256,)
(N,576)→(N,256)
经过 ReLU 和 Dropout 后,形状保持不变。
FC7:
W7.shape=(256,256)
b7.shape=(256,)
(N,256)→(N,256)
同样经过 ReLU 和 Dropout。
FC8:
W8.shape=(256,10)
b8.shape=(10,)
最终输出:
Logits.shape=(N,10)
即每个样本对应 10 个 Logits 得分。
SoftmaxWithLoss 根据 Logits 和真实标签计算交叉熵损失。若采用 Batch 平均损失,最终输出标量 Loss。
完整架构
| 层级 | 算子 / 机制 | 权重形状 W | 偏置形状 b | 超参数 | 输出形状 |
|---|---|---|---|---|---|
| 0 | Input / Crop | --- | --- | 裁剪至 27×27 | (N,1,27,27) |
| 1 | Conv1 | (16,1,3,3) | (16,) | 3×3, S=1, P=1 | (N,16,27,27) |
| --- | ReLU | --- | --- | --- | (N,16,27,27) |
| --- | MaxPool1 | --- | --- | 3×3, S=2, P=0 | (N,16,13,13) |
| 2 | Conv2 | (64,16,3,3) | (64,) | 3×3, S=1, P=1 | (N,64,13,13) |
| --- | ReLU | --- | --- | --- | (N,64,13,13) |
| --- | MaxPool2 | --- | --- | 3×3, S=2, P=0 | (N,64,6,6) |
| 3 | Conv3 | (128,64,3,3) | (128,) | 3×3, S=1, P=1 | (N,128,6,6) |
| --- | ReLU | --- | --- | --- | (N,128,6,6) |
| 4 | Conv4 | (128,128,3,3) | (128,) | 3×3, S=1, P=1 | (N,128,6,6) |
| --- | ReLU | --- | --- | --- | (N,128,6,6) |
| 5 | Conv5 | (64,128,3,3) | (64,) | 3×3, S=1, P=1 | (N,64,6,6) |
| --- | ReLU | --- | --- | --- | (N,64,6,6) |
| --- | MaxPool3 | --- | --- | 2×2, S=2, P=0 | (N,64,3,3) |
| --- | Flatten | --- | --- | 64×3×3=576 | (N,576) |
| 6 | FC6 | (576,256) | (256,) | 仿射变换 | (N,256) |
| --- | ReLU | --- | --- | --- | (N,256) |
| --- | Dropout | --- | --- | p=0.5 | (N,256) |
| 7 | FC7 | (256,256) | (256,) | 仿射变换 | (N,256) |
| --- | ReLU | --- | --- | --- | (N,256) |
| --- | Dropout | --- | --- | p=0.5 | (N,256) |
| 8 | FC8 | (256,10) | (10,) | 仿射变换 | (N,10) |
| --- | SoftmaxWithLoss | --- | --- | 交叉熵损失 | Loss:标量 |
参数量
最后,对 Tiny-AlexNet 所有可学习参数进行核算:
| Layer | 计算 | 参数量 | 占比 |
|---|---|---|---|
| Conv1 | 16×1×3×3+16 | 160 | 0.03% |
| Conv2 | 64×16×3×3+64 | 9,280 | 1.78% |
| Conv3 | 128×64×3×3+128 | 73,856 | 14.18% |
| Conv4 | 128×128×3×3+128 | 147,584 | 28.34% |
| Conv5 | 64×128×3×3+64 | 73,792 | 14.17% |
| FC6 | 576×256+256 | 147,712 | 28.36% |
| FC7 | 256×256+256 | 65,792 | 12.63% |
| FC8 | 256×10+10 | 2,570 | 0.49% |
| 总计 (Total) | --- | 520,746 | 100.00% |
Tiny-AlexNet 共包含约 52.1 万个可学习参数,约为原版 AlexNet 6,000 万个参数的 0.87%。
模型参数规模显著缩小,更适合在 NumPy 和 CPU 环境下进行实现。
Operators
Flatten
out=reshape(x,(N,C×H×W))
x.shape=(N,C,H,W) out.shape=(N,C×H×W)
Flatten 的意义是什么?
将四维张量 (N,C,H,W) 拍扁成二维矩阵 (N,C×H×W),便于输入到 Affine。
前向传播
将输入张量 x 的后三个维度合并为一个维度,保留批量维度 N。
out=reshape(x,(N,C×H×W))
同时,记录输入张量的原始形状,以便反向传播时恢复:
orig_shape=x.shape
反向传播
dx
由于 Flatten 只改变张量的形状,不会改变每个元素对应的梯度数值。
因此,反向传播时,只需要将 ∂out∂L 恢复为输入张量的原始形状:
∂x∂L=reshape(∂out∂L,orig_shape)
其中 ∂x∂L.shape=(N,C,H,W)
实现
python
class Flatten:
    def __init__(self):
        self.orig_shape = None

    def forward(self, x):
        self.orig_shape = x.shape
        out = x.reshape(x.shape[0], -1)
        return out

    def backward(self, dout):
        dx = dout.reshape(*self.orig_shape)
        return dx
Affine
out=x⋅W+b
x.shape=(N,Din) W.shape=(Din,Dout) b.shape=(Dout,) out.shape=(N,Dout)
Affine 的意义是什么?
Y=Wx+b
通过可学习的权重矩阵 W 和偏置 b,对输入特征进行仿射变换,生成新的特征表示。
类比 Logistic 回归,Affine 可以构建超平面,作为线性分类的决策边界。
前向传播
out=x⋅W+b
反向传播
dx
∂x∂L=∂out∂L⋅∂x∂out
其中:
∂x∂out=W
又 W.shape=(Din,Dout) , ∂out∂L.shape=out.shape=(N,Dout), ∂x∂L.shape=x.shape=(N,Din)
∂x∂L=∂out∂L⋅WT
dW
∂W∂L=∂out∂L⋅∂W∂out
其中:
∂W∂out=x
又 W.shape=(Din,Dout), ∂out∂L.shape=(N,Dout), x.shape=(N,Din)
∂W∂L=xT∂out∂L
db
∂b∂L=∂out∂L⋅∂b∂out
其中:
∂b∂out=1
又 b.shape=(Dout,), ∂out∂L.shape=(N,Dout), ∂b∂L.shape=(Dout,) 由于在前向传播中偏置 b 广播到了每一个样本上,根据反向传播规则,对 b 的梯度需要将批量维度( N)上的梯度进行累加求和:
∂b∂L=i=1∑N∂out∂Li,:=∂out∂L.sum(axis=0)
实现
python
class Affine:
    def __init__(self, W, b):
        self.W = W
        self.b = b
        self.x = None
        self.dW = None
        self.db = None

    def forward(self, x):
        self.x = x
        out = x @ self.W + self.b
        return out

    def backward(self, dout):
        dx = dout @ self.W.T
        self.dW = self.x.T @ dout
        self.db = np.sum(dout, axis=0)
        return dx
ReLU
out={x,0,(x>0)(x≤0)
x.shape=(N,Din)
ReLU 函数的意义是什么?
先看一个简单的神经网络:
xAffine hAffine y
假设第一层的计算是:
h=xW1+b1
第二层的计算是:
y=hW2+b2
把第一层的结果代入第二层:
y=(xW1+b1)W2+b2
展开:
y=xW1W2+b1W2+b2
注意,最终仍然可以写成:
y=xW′+b′
其中, W′ 和 b′ 是合并后的权重和偏置。
这意味着:无论堆叠多少层 Affine,只要中间没有非线性运算,整个网络实际还是一个 Affine。(若没有非线性函数,多层线性变换最终会退化为单层线性模型)
ReLU 最重要的作用之一即引入非线性。
前向传播
out={x,0,(x>0)(x≤0)
反向传播
dx
out={x,0,(x>0)(x≤0)
求 ∂x∂L:
∂x∂L=∂out∂L⋅∂x∂out
其中:
∂x∂out=⎩ ⎨ ⎧1,0,0,(x>0)(x=0)(x<0)
约定 ∂x∂out=0,(x=0)
因此:
∂x∂L=⎩ ⎨ ⎧∂out∂L⋅1,∂out∂L⋅0,(x>0)(x≤0)
化简得:
∂x∂L=⎩ ⎨ ⎧∂out∂L,0,(x>0)(x≤0)
实现
python
class ReLU:
    def __init__(self):
        self.mask = None

    def forward(self, x):
        self.mask = (x <= 0)
        out = x.copy()
        out[self.mask] = 0
        return out


    def backward(self, dout):
        dx = dout.copy()
        dx[self.mask] = 0
        return dx
非线性函数补充
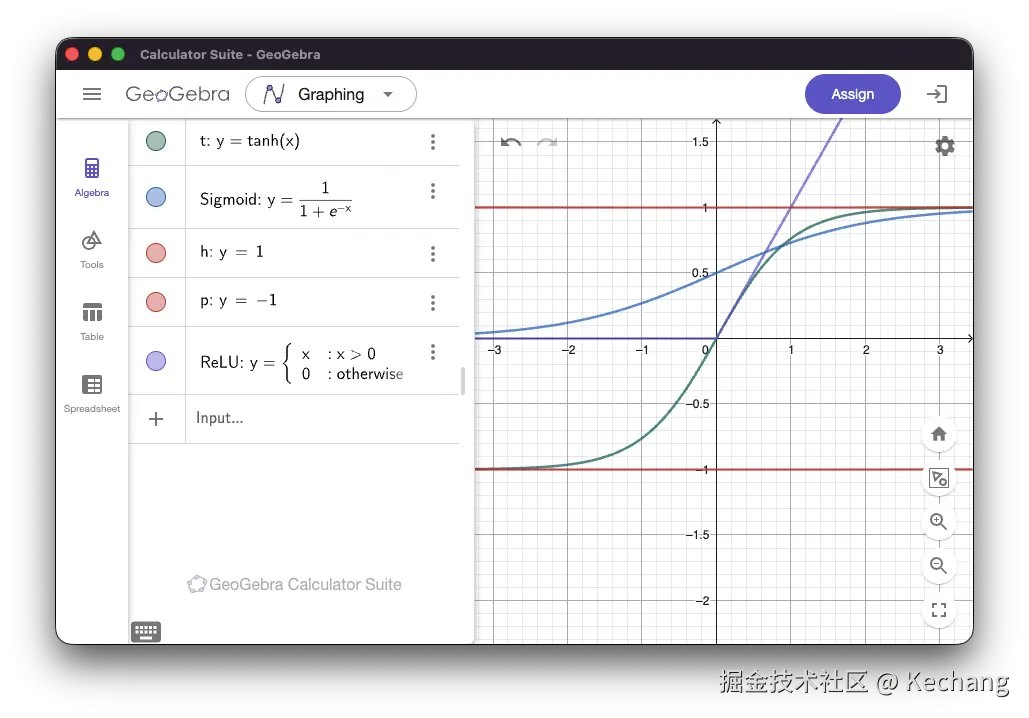
Sigmoid
out=σ(x)=1+e−x1
0<out<1
0<dxdout=out(1−out)≤0.25
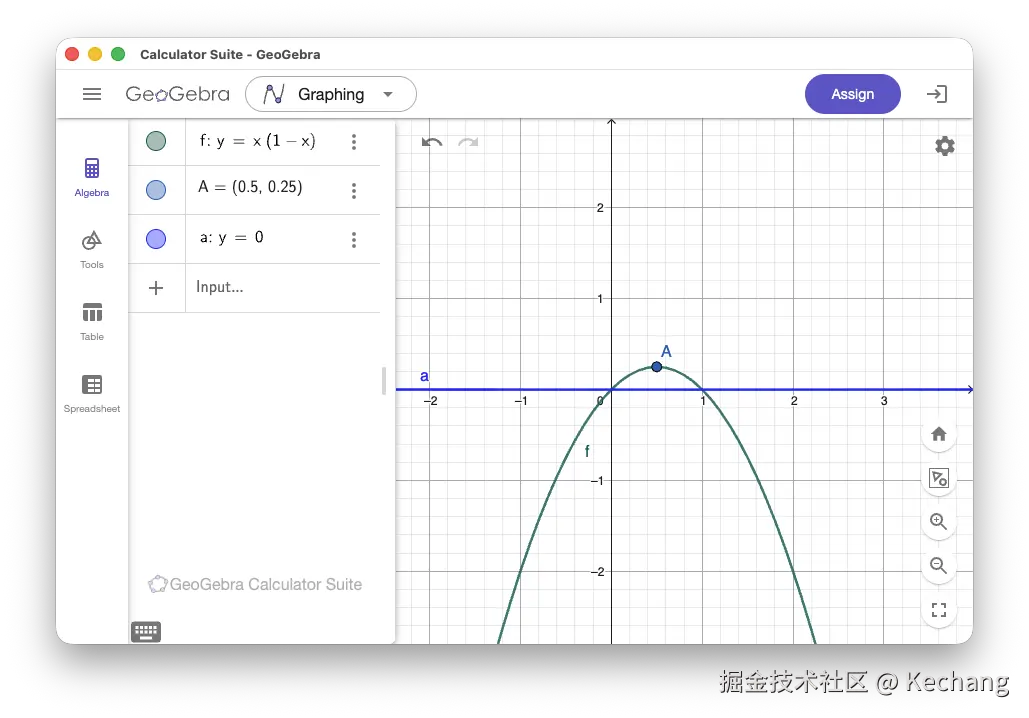
当梯度反向传播穿过一个 Sigmoid 激活函数时,需要乘以该位置的局部导数,其取值范围为 (0,0.25]:
dx1=dout×0.25×0.25×0.25×⋯=dout×(0.25)L
穿透 8 层后,梯度衰减到原来的 0.258≈0.000015;穿透 20 层后,梯度直接衰减到 10−12。
梯度并没有变成 0,但它极其微弱、无限逼近于 0,导致神经网络浅层的权重几乎不动(梯度消失)。
严格来说,梯度穿过一层神经网络时,不仅会乘以激活函数的导数,还会乘以 Affine 层的权重矩阵。因此,梯度是否衰减还与权重矩阵有关。
Tanh
out=tanh(x)=ex+e−xex−e−x
−1<out<1 0<dxdout=1−out2≤1
在反向传播过程中,误差每向前传播一层,梯度就要乘以一个 ≤1 的小数,尽管比 Sigmoid 好一点,但是连续穿透多个 Tanh 层同样存在梯度消失的可能。
ReLU
对比, ReLU 在输入大于 0 时,局部导数恒为 1,不会像 Sigmoid 和 Tanh 那样因为激活函数自身的导数较小而持续衰减梯度:
out={x,0,(x>0)(x≤0)
∂x∂out={1,0,(x>0)(x≤0)
但这不代表 ReLU 可以彻底解决梯度消失问题,因为梯度仍然受到权重矩阵的影响;同时,当输入小于等于 0 时,梯度为 0,还可能出现 Dead ReLU 问题。
Convolution & Pooling
接下来将分析卷积、最大重叠池化的实现。为了便于理解,先假设 im2col、col2im 两函数已经实现,其中:
im2col 函数的输入输出如下:
- 输入:
input_data.shape = (N, C, H, W),卷积核尺寸(FH, FW),步幅S,填充P。 - 输出:
col.shape = (N · OH · OW, C · FH · FW),每行对应一个卷积窗口展开后的向量。
col2im 函数的输入输出如下:
- 输入:
dcol.shape = (N · OH · OW, C · FH · FW),原始输入形状input_shape = (N, C, H, W),卷积核尺寸(FH, FW),步幅S,填充P。 - 输出:
dx.shape = (N, C, H, W),将展开矩阵中的梯度还原至原始输入空间,重叠区域的梯度进行累加。
Convolution
out=Conv(x,W)+b
x.shape=(N,C,H,W) W.shape=(FN,C,FH,FW) b.shape=(FN,) out.shape=(N,FN,OH,OW) 其中 OH=⌊SH+2P−FH⌋+1,OW=⌊SW+2P−FW⌋+1,两值分别代表卷积核在行/列方向的移动次数;等价于卷积层输出特征图的尺寸
Convolution 的意义是什么?
Y=x∗W+b
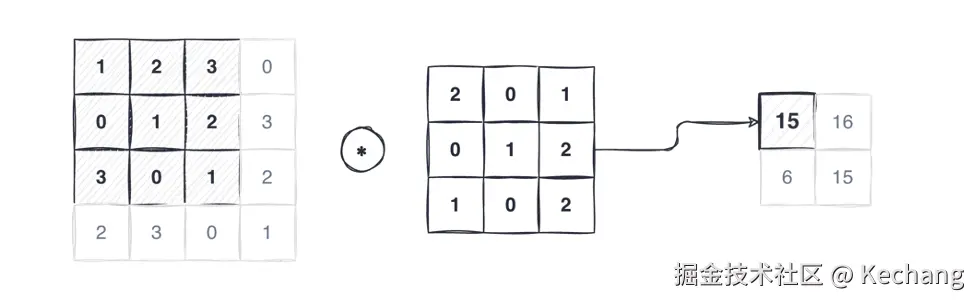
通过在空间维度滑动局部卷积核,提取具有空间局部相关性的特征表达。
卷积层本质上是加强了空间局部稀疏性的 Affine
前向传播
令 L=N⋅OH⋅OW(展开空间窗口总数), D=C⋅FH⋅FW(单感受野像素总数):
输入与权重矩阵化展开: col=im2col(x,FH,FW,S,P)∈RL×D
col_W=reshape(W,(FN,D))T∈RD×FN
二维矩阵乘法(仿射运算):
out_2d=col⋅col_W+b∈RL×FN
四维张量还原:
out=transpose(reshape(out_2d,(N,OH,OW,FN)),(0,3,1,2))
out.shape=(N,FN,OH,OW)
反向传播
下游传入的损失梯度为 dout∈RN×FN×OH×OW。 首先执行前向输出变换的逆操作,将梯度对齐回二维矩阵空间: doutcol=reshape(transpose(dout,(0,2,3,1)),(−1,FN))∈RL×FN
即 (N,FN,OH,OW)→(N,OH,OW,FN)→(L,FN)
接下来应该对照该等式进行偏导计算:
out_2d=col⋅col_W+b∈RL×FN
db
∂bf∂L=l=1∑Ldoutcol,lf
又 b.shape=(FN,), doutcol.shape=(L,FN)。偏置 b 在所有样本及所有滑动窗口位置( L=N⋅OH⋅OW)上广播共享,根据反向传播规则,需沿位置维度( axis=0)求和累加:
∂b∂L=l=1∑Ldoutcoll,:=doutcol.sum(axis=0)
dW
∂col_W∂L=colT⋅doutcol
其中 col.shape=(L,D), doutcol.shape=(L,FN),矩阵相乘后形状为 (D,FN)。 再反向撤销前向对权重的转置与展开:
∂W∂L=reshape((colT⋅doutcol)T,W.shape)
dx
根据矩阵求导链式法则,损失对展开矩阵 col 的梯度为:
dcol=∂col∂L=doutcol⋅col_WT
其中 doutcol.shape=(L,FN), col_WT.shape=(FN,D),得到 dcol.shape=(L,D)。 由于前向通过 im2col 复制了重叠像素,反向需利用伴随算子 col2im 累加重叠区域梯度并剥离 Padding:
∂x∂L=col2im(dcol,x.shape,FH,FW,S,P)
实现
python
class Conv:
    def __init__(self, W, b, stride=1, pad=0):
        self.W = W
        self.b = b
        self.stride = stride
        self.pad = pad

        self.x = None
        self.col = None
        self.col_W = None

        self.dW = None
        self.db = None

    def forward(self, x):
        FN, C, FH, FW = self.W.shape
        N, input_channels, H, input_width = x.shape

        if input_channels != C:
            raise ValueError(
                "input channel count must match the convolution kernel"
            )

        out_h = (H + 2 * self.pad - FH) // self.stride + 1
        out_w = (input_width + 2 * self.pad - FW) // self.stride + 1

        col = im2col(
            x,
            filter_h=FH,
            filter_w=FW,
            stride=self.stride,
            pad=self.pad
        )

        col_W = self.W.reshape(FN, -1).T
        out = col @ col_W + self.b

        out = out.reshape(N, out_h, out_w, FN)
        out = out.transpose(0, 3, 1, 2)

        self.x = x
        self.col = col
        self.col_W = col_W

        return out

    def backward(self, dout):
        FN, C, FH, FW = self.W.shape

        dout_col = dout.transpose(0, 2, 3, 1)
        dout_col = dout_col.reshape(-1, FN)

        dcol_W = self.col.T @ dout_col
        self.dW = dcol_W.T.reshape(self.W.shape)

        self.db = np.sum(dout_col, axis=0)

        dcol = dout_col @ self.col_W.T

        dx = col2im(
            dcol,
            self.x.shape,
            filter_h=FH,
            filter_w=FW,
            stride=self.stride,
            pad=self.pad
        )

        return dx
Pooling (MaxPooling)
out=MaxPool(x)
x.shape=(N,C,H,W) out.shape=(N,C,OH,OW) 其中 OH=⌊SH+2P−PH⌋+1,OW=⌊SW+2P−PW⌋+1
Pooling 的意义是什么?
yn,c,i,j=(p,q)∈windowmaxxn,c,i⋅S+p,j⋅S+q
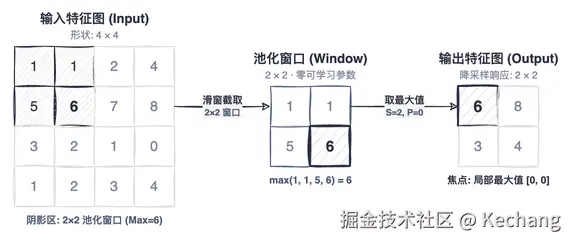
沿空间维度对各个特征图独立进行下采样,在压缩空间分辨率、降低后续计算量的同时,保留局部感受野内最显著的激活响应。
池化层无任何可学习参数(无权重 W 与偏置 b),且通道之间严格独立(通道数保持不变)。
前向传播
输出尺度计算:
OH=⌊SH+2P−PH⌋+1,OW=⌊SW+2P−PW⌋+1
空间窗口展开与通道切分: 利用 im2col 将输入展开为二维矩阵: col=im2col(x,PH,PW,S,P)∈R(N⋅OH⋅OW)×(C⋅PH⋅PW) 卷积核跨越全部通道,而池化层各通道独立处理。因此将行内的通道维度拆开下压至行维度: colpool=reshape(col,(−1,PH⋅PW))∈R(N⋅C⋅OH⋅OW)×(PH⋅PW)
求局部最大值并记录索引(反向传播需要,只有最大值所在的位置能够获得梯度): outflat=maxjcolpool:,j∈RN⋅C⋅OH⋅OW arg_max=argmaxjcolpool:,j∈NN⋅C⋅OH⋅OW
张量形状还原:
out=transpose(reshape(outflat,(N,OH,OW,C)),(0,3,1,2))∈RN×C×OH×OW
反向传播
下游传入的损失梯度为 dout∈RN×C×OH×OW。
dx
根据多元链式法则与局部极值函数的导数性质:
∂xi∂out={1,0,i=arg_maxi=arg_max
前向被选为最大值的元素获得下游传递的全部梯度,未被选中的元素梯度为 0(类似 Dropout):
对齐梯度维度: 将 dout 按前向还原的逆顺序调整轴序并展平,使其与展开行一一对应: doutflat=reshape(transpose(dout,(0,2,3,1)),−1)∈RN⋅C⋅OH⋅OW
梯度路由(Scatter): 初始化与 colpool 相同尺度的全零矩阵 dcolpool,仅在缓存的 arg_max 索引处写入下游梯度:
dcolpooli,arg_max\[i]=doutflati
恢复 col2im 兼容结构并累加还原: 还原回多通道拼接的二维展开矩阵:
dcol=reshape(dcolpool,(−1,C⋅PH⋅PW))
调用伴随算子累加还原至输入图像空间:
∂x∂L=col2im(dcol,x.shape,PH,PW,S,P)
当步幅 S<min(PH,PW)(重叠池化 Overlapping Pooling)时,某个输入像素可能同时成为多个相邻池化窗口的最大值;
col2im底层的+=散射累加机制能够自洽地将所有窗口的梯度贡献合并。
实现
python
class Pooling:
    def __init__(
        self,
        pool_h,
        pool_w,
        stride=1,
        pad=0,
    ):
        self.pool_h = pool_h
        self.pool_w = pool_w
        self.stride = stride
        self.pad = pad

        self.x = None
        self.arg_max = None
        self.col = None

    def forward(self, x):
        N, C, H, W = x.shape

        out_h = (
            H + 2 * self.pad - self.pool_h
        ) // self.stride + 1

        out_w = (
            W + 2 * self.pad - self.pool_w
        ) // self.stride + 1

        col = im2col(
            x,
            self.pool_h,
            self.pool_w,
            self.stride,
            self.pad,
        )

        col = col.reshape(
            -1,
            self.pool_h * self.pool_w,
        )

        self.arg_max = np.argmax(col, axis=1)

        out = np.max(col, axis=1)

        out = out.reshape(
            N, out_h, out_w, C
        ).transpose(0, 3, 1, 2)

        self.x = x
        self.col = col

        return out

    def backward(self, dout):
        N, C, H, W = self.x.shape

        dout = dout.transpose(0, 2, 3, 1)

        dout = dout.reshape(-1)

        dcol = np.zeros_like(self.col)

        dcol[
            np.arange(self.arg_max.size),
            self.arg_max,
        ] = dout

        dcol = dcol.reshape(
            -1,
            C * self.pool_h * self.pool_w,
        )

        dx = col2im(
            dcol,
            self.x.shape,
            self.pool_h,
            self.pool_w,
            self.stride,
            self.pad,
        )

        return dx
im2col
col=im2col(x,FH,FW,S,P)
x.shape=(N,C,H,W) col.shape=(N⋅OH⋅OW,C⋅FH⋅FW) OH=⌊SH+2P−FH⌋+1,OW=⌊SW+2P−FW⌋+1
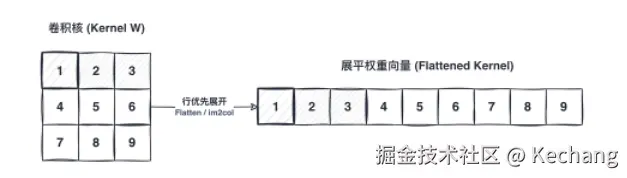
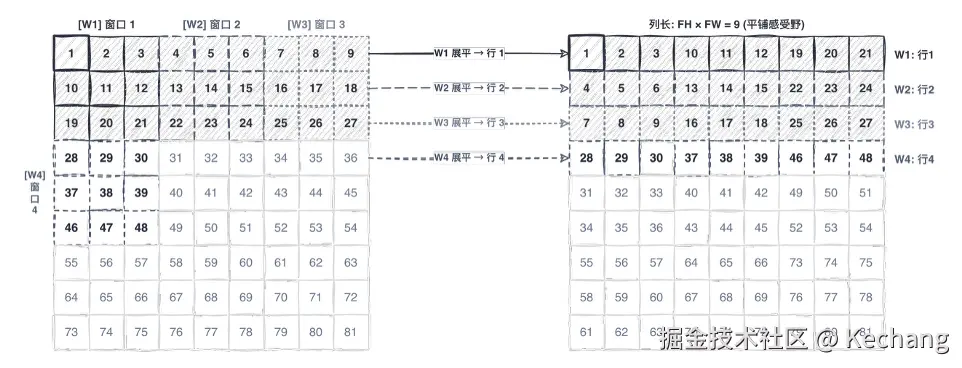
处理流程
确定输出尺度:
OH=⌊SH+2P−FH⌋+1,OW=⌊SW+2P−FW⌋+1
对输入张量 x 的空间维度四周进行常数 0 填充,得到形状为 (N,C,H+2P,W+2P) 的张量 xpad。
构建六维张量、卷积核感受野采样: 初始化临时张量 col6D∈RN×C×FH×FW×OH×OW。遍历卷积核的局部空间坐标 (y,x)∈\[0,FH)×\[0,FW),沿步幅 S 抓取对应的全图切片并广播赋值: col6D:,:,y,x,:,:=xpad:,:,y:y+S⋅OH:S,x:x+S⋅OW:S
轴置换与二维展平: 将窗口空间索引置于前侧,窗口内部通道及局部像素置于后侧:
(N,C,FH,FW,OH,OW)transpose(0,4,5,1,2,3) (N,OH,OW,C,FH,FW)
轴合并展平:
col=reshape(col6D,(N⋅OH⋅OW,C⋅FH⋅FW))
实现
python
def im2col(input_data, filter_h, filter_w, stride=1, pad=0):
    N, C, H, W = input_data.shape

    out_h = (H + 2 * pad - filter_h) // stride + 1
    out_w = (W + 2 * pad - filter_w) // stride + 1

    img = np.pad(
        input_data,
        (
            (0, 0),
            (0, 0),
            (pad, pad),
            (pad, pad)
        ),
        mode="constant"
    )

    col = np.zeros(
        (N, C, filter_h, filter_w, out_h, out_w),
        dtype=input_data.dtype
    )

    for y in range(filter_h):
        y_max = y + stride * out_h

        for x in range(filter_w):
            x_max = x + stride * out_w

            col[:, :, y, x, :, :] = img[
                :,
                :,
                y:y_max:stride,
                x:x_max:stride
            ]

    col = col.transpose(0, 4, 5, 1, 2, 3)

    col = col.reshape(
        N * out_h * out_w,
        -1
    )

    return col
col2im
dx=col2im(dcol,input_shape,FH,FW,S,P)
dcol.shape=(N⋅OH⋅OW,C⋅FH⋅FW) dx.shape=(N,C,H,W)
处理流程
形状恢复、轴重排: 二维梯度矩阵恢复六维排列: (N⋅OH⋅OW,C⋅FH⋅FW)reshape (N,OH,OW,C,FH,FW) 逆置换回采样轴序: (N,OH,OW,C,FH,FW)transpose(0,3,4,5,1,2) (N,C,FH,FW,OH,OW)
空间重叠梯度累加(+=):
初始化带 Padding 尺寸的梯度缓存张量 dxpad∈RN×C×(H+2P+S−1)×(W+2P+S−1)。遍历卷积核局部坐标 (y,x),将各滑动窗口的梯度贡献通过切片索引累加回原像素: dxpad:,:,y:y+S⋅OH:S,x:x+S⋅OW:S+=col6D:,:,y,x,:,:
剥离 Padding 边缘: 裁切掉前向填充的外边距,还原输入原始物理空间尺寸:
dx=dxpad:,:,P:H+P,P:W+P
实现
python
def col2im(col, input_shape, filter_h, filter_w, stride=1, pad=0):
    N, C, H, W = input_shape

    out_h = (H + 2 * pad - filter_h) // stride + 1
    out_w = (W + 2 * pad - filter_w) // stride + 1

    col = col.reshape(
        N,
        out_h,
        out_w,
        C,
        filter_h,
        filter_w
    )

    col = col.transpose(0, 3, 4, 5, 1, 2)

    img = np.zeros(
        (
            N,
            C,
            H + 2 * pad + stride - 1,
            W + 2 * pad + stride - 1
        ),
        dtype=col.dtype
    )

    for y in range(filter_h):
        y_max = y + stride * out_h

        for x in range(filter_w):
            x_max = x + stride * out_w

            img[:, :, y:y_max:stride, x:x_max:stride] += (
                col[:, :, y, x, :, :]
            )

    img = img[
        :,
        :,
        pad:H + pad,
        pad:W + pad
    ]

    return img
Dropout
out={x⊙mask,x⋅(1−p),traintest
x.shape=(N,D) mask.shape=(N,D) out.shape=(N,D) ⊙ 表示哈达玛积(Hadamard product),即逐元素相乘。
Dropout 的意义是什么?
out=x⊙mask
在训练阶段以丢弃概率 p 随机将部分神经元输出置零,迫使其他神经元学习更为鲁棒的冗余特征表示。
| 项目 | 训练阶段 (Train) | 测试阶段 (Test) |
|---|---|---|
| 随机屏蔽 | 是 | 否 |
| 掩码状态 | 采样 mask∈{0,1} | 无掩码 |
| 前向传播 | x⊙mask | x⋅(1−p) |
| 反向传播 | dout⊙mask | 不执行反向传播 |
| 期望保持 | 均值被削减为原本的 (1−p) 倍 | 显式乘以 (1−p),使推理与训练期望对齐 |
前向传播
训练阶段(按保留概率 1−p 采样伯努利掩码):
out=x⊙mask,maskij∼Bernoulli(1−p)
Bernoulli(1−p):对于张量中的每一个位置,独立地进行一次概率为 1 - p 的抽样
测试阶段(保持输出信号的数学期望一致):
out=x⋅(1−p)
反向传播
dx
∂x∂L=∂out∂L⊙∂x∂out
其中:
∂x∂out=mask⟹∂xi∂outi={1,0,maski=Truemaski=False
又 x.shape=(N,D), mask.shape=(N,D), ∂out∂L.shape=(N,D)。根据逐元素求导规则,前向被屏蔽的神经元其梯度被硬截断为 0:
∂x∂L=∂out∂L⊙mask
实现
python
class Dropout:
    def __init__(self, dropout_ratio=0.5):
        self.dropout_ratio = dropout_ratio
        self.mask = None
        self.train_flg = True

    def forward(self, x, train_flg=True):
        self.train_flg = train_flg
        if train_flg:
            self.mask = np.random.rand(*x.shape) > self.dropout_ratio
            return x * self.mask
        else:
            return x * (1.0 - self.dropout_ratio)

    def backward(self, dout):
        if self.train_flg:
            return dout * self.mask
        else:
            return dout * (1.0 - self.dropout_ratio)
SoftmaxWithLoss
对于二分类问题,一般考虑 Sigmoid + CEL(交叉熵损失)。这里我们做 MNIST 手写数字分类是十分类问题,通常使用 SoftmaxWithLoss。
Softmax
outk=∑j=1Kexp(aj)exp(ak)
Softmax 的意义是什么?
建立联系
神经网络的本质是一个高维拟合函数,它的最后一层 Affine 的输出是一无拘束的有正有负的总和不为 1 的 Logits。我们需要一个转换函数,将这些裸数值与 labels 建立联系。
强制非负
无论全连接层吐出多么极端的负数, ex>0
拉大差距
指数函数的爆炸式增长特性,能够极大地放大 Logists 微小的得分优势。得分最高的那个类别会被指数级抬升,占据绝大部分概率质量;同时又为其他类别保留了微小的非零概率。
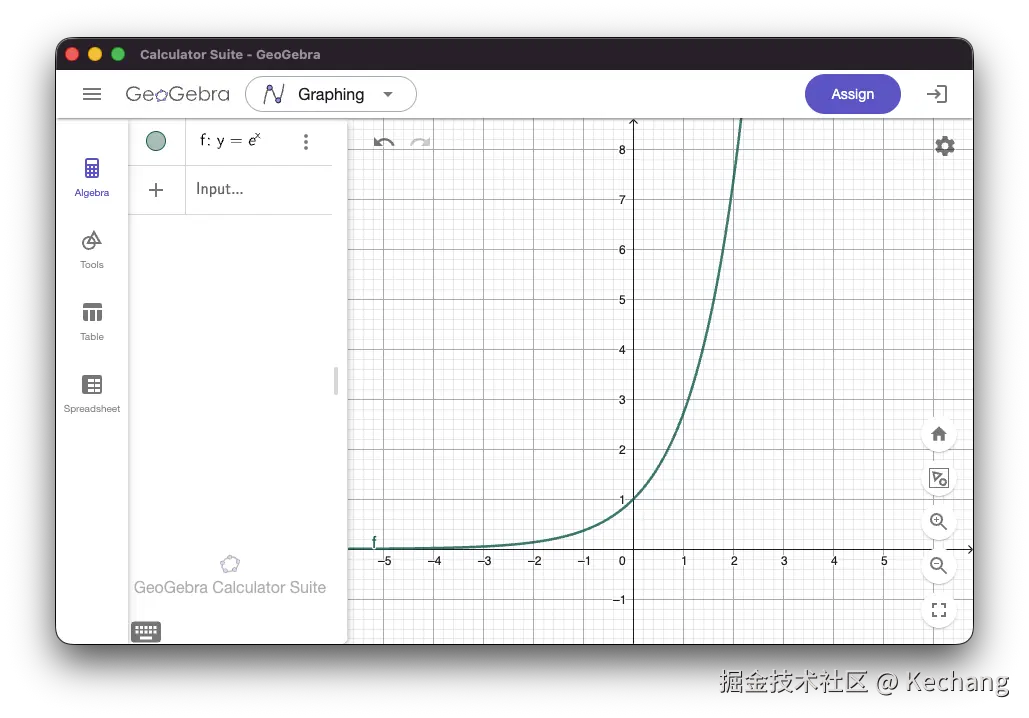
但是,由于指数函数的爆炸式增长特性,可能会数据溢出。
Tricky 平移不变性,Softmax 的分子分母同时乘除一个非零常数,其结果恒等:
yk=∑j=1Kexp(aj)exp(ak)÷1=∑j=1Kexp(aj)exp(ak)÷exp(C)exp(C)=∑j=1Kexp(aj−C)exp(ak−C)
一般令 C=max(a)
现在,Softmax 吐出了一个合法的概率分布 y。
接下来,需要量化 " 这个神经网络的输出距离标签,到底差了多远?" 便于最优化迭代。
Loss
均方误差(MSE、L2 Loss)
以 SigmoidWithMSE 为例:
Sigmoid
y=1+e−a1
MSE
L=21(y−t)2
反向传播
对于 MSE 层:
∂y∂L=y−t
对于 Sigmoid 层:
∂a∂L=∂y∂L⋅∂a∂y
其中:
∂a∂y=y(1−y)
可得到
∂a∂L=∂y∂L⋅∂a∂y=(y−t)⋅y(1−y)
交叉熵损失(Cross-Entropy Loss)
以 SigmoidWithCEL 为例:
Sigmoid
y=1+e−a1
CEL(二元交叉熵)
L=−tlny+(1−t)ln(1−y)
t:真实标签,取值为 0 或 1。 y:Sigmoid 的输出。
反向传播
对于 CEL 层:
对 y 求导:
∂y∂L=−yt+1−y1−t
通分整理:
∂y∂L=−y(1−y)t(1−y)+y(1−y)(1−t)y=y(1−y)−t(1−y)+(1−t)y=y(1−y)−t+ty+y−ty=y(1−y)y−t
因此:
∂y∂L=y(1−y)y−t
对于 Sigmoid 层:
根据链式法则:
∂a∂L=∂y∂L⋅∂a∂y
其中:
∂a∂y=y(1−y)
代入可得:
∂a∂L=∂y∂L⋅∂a∂y=y(1−y)y−t⋅y(1−y)=y−t
最终得到:
∂a∂L=y−t
对比两种损失函数最终传递给 Sigmoid 输入 a 的梯度:
| 损失函数 | 对 a 的梯度 |
|---|---|
| MSE | (y−t)y(1−y) |
| Cross-Entropy | y−t |
使用交叉熵损失的话更不容易出现梯度消失。
Softmax + CEL 组合,对 Logits 的梯度同样可以简化为预测概率减去真实标签。
∂ak∂L=yk−tk
所以 Softmax 会和 CEL 合并为一个算子 SoftmaxWithLoss
SoftmaxWithLoss
L=−N1n=1∑Nk=1∑Ktnklnynk,yk=∑jexp(xj)exp(xk)
x.shape=(N,K) t.shape=(N,K) 或 (N,) y.shape=(N,K) L.shape=()
前向传播
Softmax:
ynk=∑j=1Kexp(xnj−maxjxnj)exp(xnk−maxjxnj)
Cross-Entropy Loss:
L=−N1n=1∑Nk=1∑Ktnkln(ynk+ϵ)
反向传播
dx
单个 Logit xk 会改变所有类别的预测概率 y1,...,yK,需对所有路径求和:
∂xk∂L=i=1∑K∂yi∂L⋅∂xk∂yi
其中:
∂yi∂L=−yiti
Softmax 的偏导(分 i=k 与 i=k 两种情况,引入 Kronecker delta δik 合并):
∂xk∂yi=yi(δik−yk)
代入链式法则并约去 yi:
∂xk∂L=i=1∑K(−yiti)⋅yi(δik−yk)=−i=1∑Ktiδik+yki=1∑Kti
由标签的 One-hot 编码性质 ∑i=1Ktiδik=tk 且 ∑i=1Kti=1:
∂xk∂L=yk−tk
又 x.shape=(N,K), y.shape=(N,K), t.shape=(N,K),由于在前向传播中损失 L 在批量维度( N)进行了均值计算( N1),根据反向传播规则,对输入 x 的梯度需除以批量大小 N,并乘以反向传入的损失梯度 dout:
∂x∂L=Ny−t⋅dout
实现
python
class SoftmaxWithLoss:
    def __init__(self):
        self.y = None
        self.t = None
        self.batch_size = None

    def forward(self, x, t):
        self.t = t
        batch_size = x.shape[0]
        self.batch_size = batch_size

        x = x - np.max(x, axis=1, keepdims=True)
        exp_x = np.exp(x)
        y = exp_x / np.sum(exp_x, axis=1, keepdims=True)

        self.y = y

        if self.t.size == self.y.size:
            loss = -np.sum(self.t * np.log(self.y + 1e-12)) / batch_size
        else:
            loss = -np.sum(
                np.log(self.y[np.arange(batch_size), self.t] + 1e-12)
            ) / batch_size

        return loss

    def backward(self, dout=1):
        dx = self.y.copy()
        if self.t.size == self.y.size:
            dx = (dx - self.t) * dout / self.batch_size
        else:
            dx[np.arange(self.batch_size), self.t] -= 1
            dx = dx * dout / self.batch_size
        return dx
Tiny-AlexNet
| 层级 | 算子 / 机制 | 权重形状 W | 偏置形状 b | 超参数 | 输出形状 |
|---|---|---|---|---|---|
| 0 | Input / Crop | --- | --- | 裁剪至 27×27 | (N,1,27,27) |
| 1 | Conv1 | (16,1,3,3) | (16,) | 3×3, S=1, P=1 | (N,16,27,27) |
| --- | ReLU | --- | --- | --- | (N,16,27,27) |
| --- | MaxPool1 | --- | --- | 3×3, S=2, P=0 | (N,16,13,13) |
| 2 | Conv2 | (64,16,3,3) | (64,) | 3×3, S=1, P=1 | (N,64,13,13) |
| --- | ReLU | --- | --- | --- | (N,64,13,13) |
| --- | MaxPool2 | --- | --- | 3×3, S=2, P=0 | (N,64,6,6) |
| 3 | Conv3 | (128,64,3,3) | (128,) | 3×3, S=1, P=1 | (N,128,6,6) |
| --- | ReLU | --- | --- | --- | (N,128,6,6) |
| 4 | Conv4 | (128,128,3,3) | (128,) | 3×3, S=1, P=1 | (N,128,6,6) |
| --- | ReLU | --- | --- | --- | (N,128,6,6) |
| 5 | Conv5 | (64,128,3,3) | (64,) | 3×3, S=1, P=1 | (N,64,6,6) |
| --- | ReLU | --- | --- | --- | (N,64,6,6) |
| --- | MaxPool3 | --- | --- | 2×2, S=2, P=0 | (N,64,3,3) |
| --- | Flatten | --- | --- | 64×3×3=576 | (N,576) |
| 6 | FC6 | (576,256) | (256,) | 仿射变换 | (N,256) |
| --- | ReLU | --- | --- | --- | (N,256) |
| --- | Dropout | --- | --- | p=0.5 | (N,256) |
| 7 | FC7 | (256,256) | (256,) | 仿射变换 | (N,256) |
| --- | ReLU | --- | --- | --- | (N,256) |
| --- | Dropout | --- | --- | p=0.5 | (N,256) |
| 8 | FC8 | (256,10) | (10,) | 仿射变换 | (N,10) |
| --- | SoftmaxWithLoss | --- | --- | 交叉熵损失 | Loss:标量 |
装配 Tiny-AlexNet 网络骨架
TinyAlexNet 类
下面的实现通过 TinyAlexNet 类组装网络。__init__ 初始化参数字典,为卷积层和全连接层创建权重与偏置,再按前向传播顺序把各层放入 OrderedDict。predict 依次执行这些层并返回分类分数;loss 将分数和标签传给 SoftmaxWithLoss 计算损失;gradient 从损失层开始反向传播,并收集各参数的梯度。
init
权重使用 kaiming_init 初始化,偏置初始化为零。卷积层、激活函数、池化层、展平层、全连接层和 Dropout 按网络结构顺序加入 self.layers;最后的 SoftmaxWithLoss 单独保存在 self.last_layer 中。
python
class TinyAlexNet:
    def __init__(self, dropout_ratio=0.5):
        self.params = {}

        self.params['W1'] = kaiming_init(16, 1, 3, 3)
        self.params['b1'] = np.zeros(16)

        self.params['W2'] = kaiming_init(64, 16, 3, 3)
        self.params['b2'] = np.zeros(64)

        self.params['W3'] = kaiming_init(128, 64, 3, 3)
        self.params['b3'] = np.zeros(128)

        self.params['W4'] = kaiming_init(128, 128, 3, 3)
        self.params['b4'] = np.zeros(128)

        self.params['W5'] = kaiming_init(64, 128, 3, 3)
        self.params['b5'] = np.zeros(64)

        self.params['W6'] = kaiming_init(576, 256)
        self.params['b6'] = np.zeros(256)

        self.params['W7'] = kaiming_init(256, 256)
        self.params['b7'] = np.zeros(256)

        self.params['W8'] = kaiming_init(256, 10)
        self.params['b8'] = np.zeros(10)

        self.layers = OrderedDict()

        self.layers['Conv1'] = Conv(W=self.params['W1'], b=self.params['b1'], stride=1, pad=1)
        self.layers['ReLU1'] = ReLU()
        self.layers['MaxPool1'] = Pooling(pool_h=3, pool_w=3, stride=2, pad=0)

        self.layers['Conv2'] = Conv(W=self.params['W2'], b=self.params['b2'], stride=1, pad=1)
        self.layers['ReLU2'] = ReLU()
        self.layers['MaxPool2'] = Pooling(pool_h=3, pool_w=3, stride=2, pad=0)

        self.layers['Conv3'] = Conv(W=self.params['W3'], b=self.params['b3'], stride=1, pad=1)
        self.layers['ReLU3'] = ReLU()

        self.layers['Conv4'] = Conv(W=self.params['W4'], b=self.params['b4'], stride=1, pad=1)
        self.layers['ReLU4'] = ReLU()

        self.layers['Conv5'] = Conv(W=self.params['W5'], b=self.params['b5'], stride=1, pad=1)
        self.layers['ReLU5'] = ReLU()
        self.layers['MaxPool3'] = Pooling(pool_h=2, pool_w=2, stride=2, pad=0)

        self.layers['Flatten'] = Flatten()

        self.layers['FC6'] = Affine(W=self.params['W6'], b=self.params['b6'])
        self.layers['ReLU6'] = ReLU()
        self.layers['Dropout6'] = Dropout(dropout_ratio=dropout_ratio)

        self.layers['FC7'] = Affine(W=self.params['W7'], b=self.params['b7'])
        self.layers['ReLU7'] = ReLU()
        self.layers['Dropout7'] = Dropout(dropout_ratio=dropout_ratio)

        self.layers['FC8'] = Affine(W=self.params['W8'], b=self.params['b8'])
        self.last_layer = SoftmaxWithLoss()
        self.last_loss = None
predict
predict 对输入执行前向传播。若输入图像空间尺寸为 28×28,则按实现约定裁剪为左上角的 27×27 区域,以匹配网络的输入尺寸。遍历有序层时,将 train_flg 传给 Dropout,以选择训练或评估行为;其他层直接执行前向计算。该实现使用 AlexNet 原版 Dropout:训练时按保留概率生成掩码,评估时关闭随机失活并按保留概率缩放输出。
python
class TinyAlexNet:
    def __init__(self):
        ...
    def predict(self, x, train_flg=False):
        if x.shape[2:] == (28, 28):
            x = x[:, :, :27, :27]

        for layer in self.layers.values():
            if isinstance(layer, Dropout):
                x = layer.forward(x, train_flg=train_flg)
            else:
                x = layer.forward(x)
        return x
loss
loss 先调用 predict 得到网络输出,再由 SoftmaxWithLoss 根据输出和标签计算交叉熵损失。训练时默认启用 Dropout。
python
class TinyAlexNet:
    def __init__(self):
        ...
    def predict(self, x, train_flg=False):
        ...
    def loss(self, x, t, train_flg=True):
        y = self.predict(x, train_flg=train_flg)
        return self.last_layer.forward(y, t)
gradient
gradient 先执行前向计算并得到损失,再从 SoftmaxWithLoss 开始反向传播。随后按前向层序的逆序调用各层的 backward,最后从卷积层和全连接层读取权重、偏置梯度,组成与 self.params 对应的字典并返回。
python
class TinyAlexNet:
    def __init__(self):
        ...
    def predict(self, x, train_flg=False):
        ...
    def loss(self, x, t, train_flg=True):
        ...
    def gradient(self, x, t, train_flg=True):
        self.last_loss = self.loss(x, t, train_flg=train_flg)

        dout = self.last_layer.backward()

        for layer in reversed(list(self.layers.values())):
            dout = layer.backward(dout)

        grads = {}
        grads['W1'] = self.layers['Conv1'].dW
        grads['b1'] = self.layers['Conv1'].db

        grads['W2'] = self.layers['Conv2'].dW
        grads['b2'] = self.layers['Conv2'].db

        grads['W3'] = self.layers['Conv3'].dW
        grads['b3'] = self.layers['Conv3'].db

        grads['W4'] = self.layers['Conv4'].dW
        grads['b4'] = self.layers['Conv4'].db

        grads['W5'] = self.layers['Conv5'].dW
        grads['b5'] = self.layers['Conv5'].db

        grads['W6'] = self.layers['FC6'].dW
        grads['b6'] = self.layers['FC6'].db

        grads['W7'] = self.layers['FC7'].dW
        grads['b7'] = self.layers['FC7'].db

        grads['W8'] = self.layers['FC8'].dW
        grads['b8'] = self.layers['FC8'].db

        return grads
Optimizer 类
训练神经网络的本质是最小化损失函数 L(w)。反向传播只负责算出梯度 ∇wL,告诉我们损失在每个参数方向上 " 往哪走会上升 "。优化器负责决定如何利用这个梯度去更新参数:
wt+1=wt−Δwt
不同优化器的差别,就在于 Δwt 如何计算。它直接影响:
- 收敛速度:能否更快下降到较低的损失;
- 训练稳定性:能否抑制震荡,穿过鞍点和平坦区域;
- 最终效果:能否收敛到泛化更好的解。
SGD
沿负梯度方向,按固定学习率 η 直接更新参数:
w←w−η⋅g
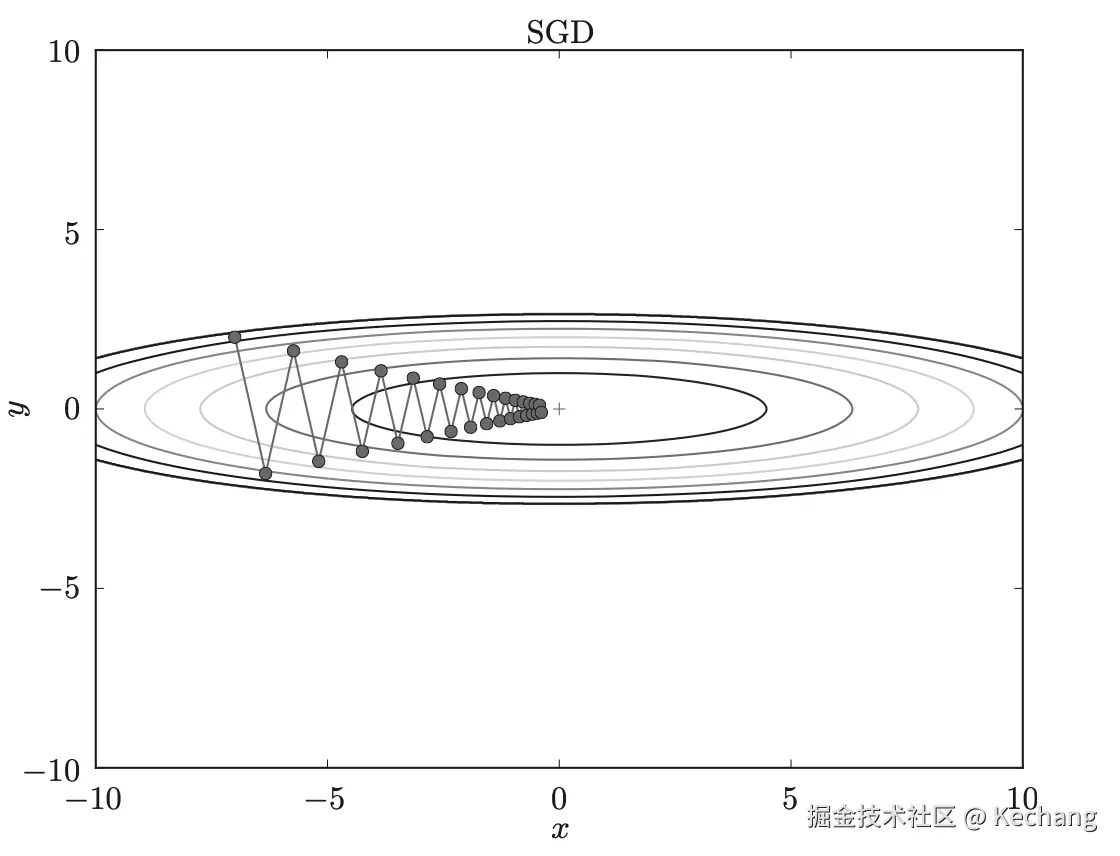
- 优点:实现简单,计算和内存开销最小;
- 缺点:对学习率敏感;在狭长的 " 峡谷 " 形损失面上容易来回震荡;所有参数共用同一学习率,无法区别对待。
python
class SGD:
    def __init__(self, lr=0.01):
        self.lr = lr

    def update(self, params, grads):
        for key in params.keys():
            params[key] -= self.lr * grads[key]
AlexNetSGDM(SGDM)
引入 " 速度 " v 来累积历史梯度,类似物理中的惯性:
v←βv−η(g+λw)
w←w+v
其中 β 为动量系数(常取 0.9), λ 为权重衰减系数(L2 正则)。
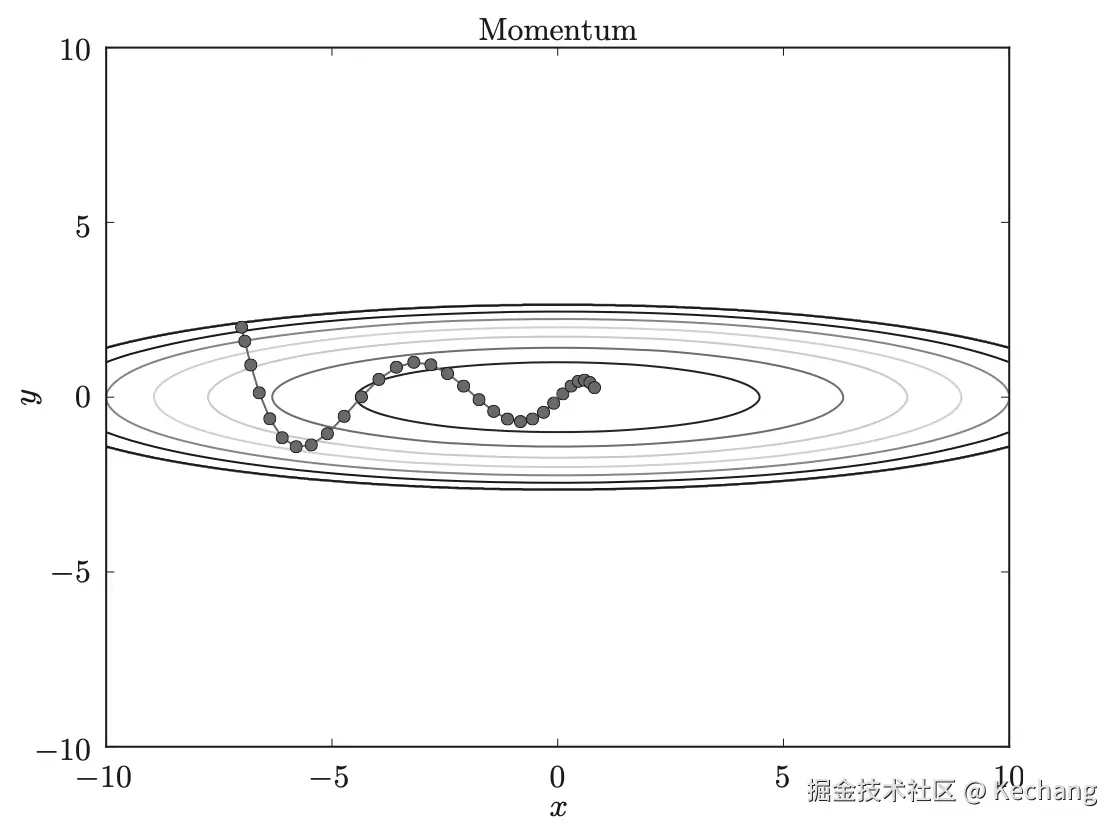
- 惯性效应:方向一致的梯度不断累积,加速下降;方向来回变化的分量相互抵消,抑制震荡;
- 权重衰减:每步额外施加 −ηλw 的收缩力,约束权重大小,缓解过拟合。代码中只对权重矩阵(
W1~W8)施加衰减,偏置b不衰减。
python
class AlexNetSGDM:
    def __init__(self, lr=0.01, momentum=0.9, weight_decay=0.0005):
        self.lr = lr
        self.momentum = momentum
        self.weight_decay = weight_decay
        self.v = None

    def update(self, params, grads):
        if self.v is None:
            self.v = {}
            for key, val in params.items():
                self.v[key] = np.zeros_like(val)

        for key in params.keys():
            if key.startswith("W") and self.weight_decay > 0:
                decay_term = self.weight_decay * self.lr * params[key]
            else:
                decay_term = 0.0

            self.v[key] = (
                self.momentum * self.v[key]
                - decay_term
                - self.lr * grads[key]
            )
            params[key] += self.v[key]
Adam
Adam 结合了动量和自适应学习率,同时维护梯度的一阶矩和二阶矩:
mt=β1mt−1+(1−β1)gt
vt=β2vt−1+(1−β2)gt2
其实同 TCP 中计算 RTT 时候的指数平滑算法,根据权重来结合当前值和以前值
由于 m0=v0=0,训练初期估计会偏向 0,需要做偏差修正:
m^t=1−β1tmt,v^t=1−β2tvt
w←w−η⋅v^t +ϵm^t
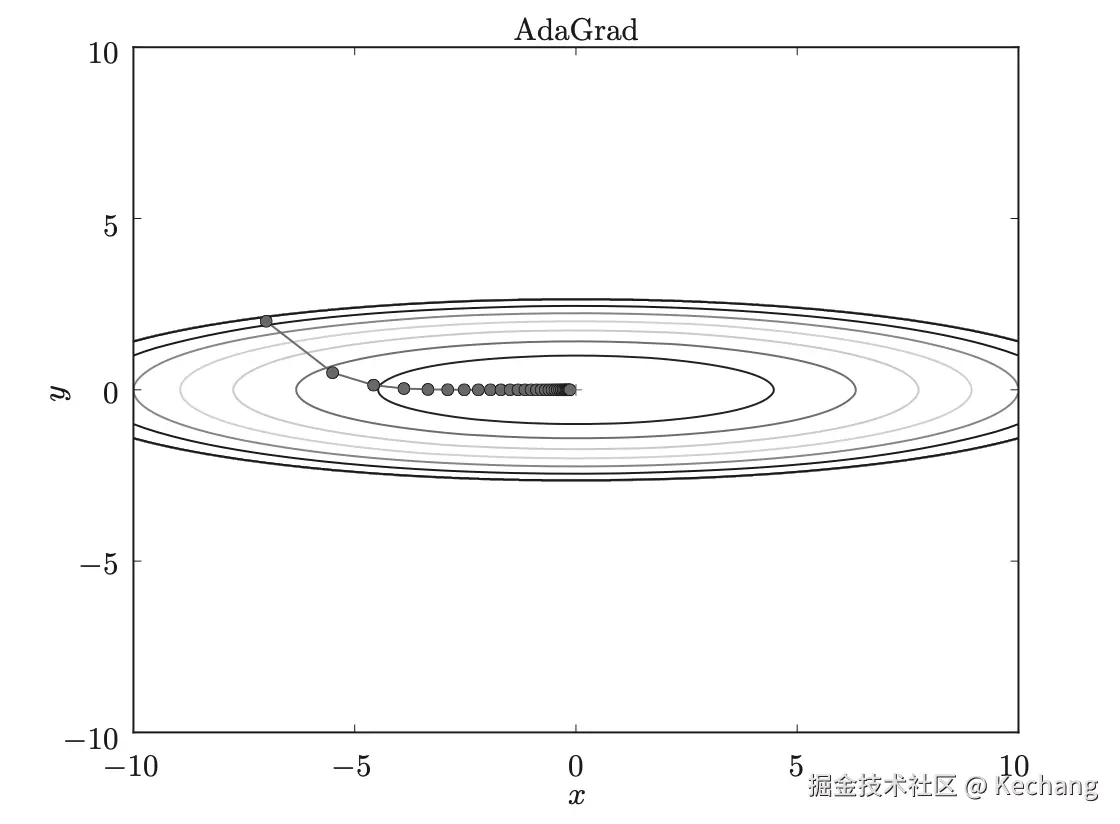
- 自适应步长:梯度长期较大的参数,分母大,步长被压小;梯度较小的参数,步长相对放大,因此每个参数拥有各自的有效学习率;
- 默认超参数: β1=0.9, β2=0.999, ϵ=10−8, η=0.001,通常无需精细调参;
- 实现技巧:代码把偏差修正系数合并进一个标量学习率 ηt=η1−β2t /(1−β1t),避免对每个张量逐元素做除法(与原论文的高效实现形式一致,仅 ϵ 的作用位置略有差异,影响可忽略)。
python
class Adam:
    def __init__(self, lr=0.001, beta1=0.9, beta2=0.999, eps=1e-8):
        self.lr = lr
        self.beta1 = beta1
        self.beta2 = beta2
        self.eps = eps
        self.m = None
        self.v = None
        self.iter = 0

    def update(self, params, grads):
        if self.m is None:
            self.m = {}
            self.v = {}
            for key, val in params.items():
                self.m[key] = np.zeros_like(val)
                self.v[key] = np.zeros_like(val)

        self.iter += 1
        lr_t = (
            self.lr
            * np.sqrt(1.0 - self.beta2**self.iter)
            / (1.0 - self.beta1**self.iter)
        )

        for key in params.keys():
            self.m[key] += (1.0 - self.beta1) * (grads[key] - self.m[key])
            self.v[key] += (1.0 - self.beta2) * (grads[key] ** 2 - self.v[key])
            params[key] -= lr_t * self.m[key] / (np.sqrt(self.v[key]) + self.eps)
Mini-batch Iterator 类
目的
DataLoader 将数据集按批次提供给训练或评估流程。每次迭代返回一批图像及对应标签,便于分批处理。它不会在每个批次中重复抽取样本,也可以保留无法整除批大小的尾批次。
设计
不放回遍历
每个 Epoch 开始时,若启用 shuffle,就对全部样本索引生成一次随机排列,再按顺序切片组成 Mini-batch。这样一个 Epoch 内每个样本恰好出现一次。
python
indices = rng.permutation(num_samples)仅打乱索引
迭代器只打乱一维整数索引数组,不重排整份图像数据。取批次时再按索引提取对应样本,减少数据搬运。
python
X_batch = X[batch_indices]保留尾批次
当样本数不能被 batch_size 整除时,最后一批可能小于批大小。实现保留这部分样本,不丢弃数据。
python
end_idx = min(start_idx + batch_size, num_samples)实现
DataLoader 采用迭代器接口提供批次,并按数据集划分加载训练集、验证集或测试集。类级缓存用于在同一进程内复用已加载并预处理的数据;每次开始迭代时重置游标,并根据 shuffle 重新排列索引或恢复顺序。
python
class DataLoader:
    _DATASET_CACHE = {}

    def __init__(self, split="train", batch_size=64, shuffle=None, seed=None):
        if not isinstance(batch_size, (int, np.integer)) or batch_size < 1:
            raise ValueError(f"batch_size 必须是 >= 1 的整数,当前为: {batch_size}")

        split_normalized = split.lower().strip()
        if split_normalized in ("val", "validation"):
            self.split = "val"
        elif split_normalized in ("train", "test"):
            self.split = split_normalized
        else:
            raise ValueError(
                f"未知的 split 标识: '{split}',仅支持 'train', 'val' / 'validation', 'test'"
            )

        self.batch_size = batch_size
        if shuffle is None:
            self.shuffle = (self.split == "train")
        else:
            self.shuffle = bool(shuffle)

        self._seed = seed
        self._rng = np.random.default_rng(seed)

        self.X, self.y = self._get_cached_dataset(self.split)
        self.num_samples = self.X.shape[0]

        self._cursor = 0
        self._indices = np.arange(self.num_samples)

    @classmethod
    def _get_cached_dataset(cls, split):
        if split not in cls._DATASET_CACHE:
            if split == "train":
                raw_x, raw_y = load_train_mnist()
            elif split == "val":
                raw_x, raw_y = load_validation_mnist()
            elif split == "test":
                raw_x, raw_y = load_test_mnist()
            else:
                raise ValueError(f"Invalid split: {split}")

            x_tensor = raw_x.astype(np.float32, copy=False)
            y_tensor = to_one_hot(raw_y, num_classes=10)

            x_tensor.setflags(write=False)
            y_tensor.setflags(write=False)

            cls._DATASET_CACHE[split] = (x_tensor, y_tensor)

        return cls._DATASET_CACHE[split]

    @classmethod
    def clear_cache(cls):
        cls._DATASET_CACHE.clear()

    def __len__(self):
        return (self.num_samples + self.batch_size - 1) // self.batch_size

    def __iter__(self):
        self._cursor = 0
        if self.shuffle:
            self._indices = self._rng.permutation(self.num_samples)
        else:
            self._indices = np.arange(self.num_samples)
        return self

    def __next__(self):
        if self._cursor >= self.num_samples:
            raise StopIteration

        start_idx = self._cursor
        end_idx = min(start_idx + self.batch_size, self.num_samples)
        self._cursor = end_idx

        batch_idx = self._indices[start_idx:end_idx]
        return self.X[batch_idx], self.y[batch_idx]
骨架测试
前向传播测试
目的
确认网络结构、前向计算及初始输出符合预期。
需要验证的内容
网络结构与形状
- 总参数量是否为 520,746。
- 8 组权重和偏置的形状是否符合架构设计。
- 21 个层的输出形状是否正确。
- 空间尺寸是否按预期变化: 27→13→6→3,展平后为 64×3×3=576,与 FC6 的输入维度一致。 裁剪与 Dropout
- 输入 28×28 图像与手动裁剪为 27×27 后的预测结果是否一致。
- 评估模式下,连续两次预测是否一致。
- 训练模式下,连续预测是否体现 Dropout 的随机失活行为。
初始损失
- 10 类分类在输出接近均匀分布时,交叉熵应接近: L0=−ln(0.1)≈2.3026
- 使用随机输入和标签,检查初始损失是否处于合理范围(当前设为 2.15~2.45)。
- 若损失明显偏高,应检查权重初始化及各层输出的数值尺度。
初始损失接近 2.3026,并不能证明初始化完全正常。即使权重接近零、输出接近均匀分布,也可能得到相同的损失。
准确率计算
- 构造与预测结果完全一致的标签,检查准确率是否为 1.0。
- 检查非整除批次的统计是否正确,包括最后一个不完整批次。
- 检查未训练网络在随机数据上的准确率是否处于合理范围。10 分类的随机猜测基准约为 10%,有限样本下会有波动。
反向传播测试
验证的内容
- 梯度字典的键是否与参数字典一致。
- 每个参数的梯度形状是否与对应参数相同。
形状正确不代表梯度数值正确,因此还需要进行数值梯度检验。
数值梯度检验
目的
通过有限差分独立估算参数梯度,并与反向传播得到的解析梯度进行比较,验证梯度计算是否正确。
∂w∂L≈2ϵL(w+ϵ)−L(w−ϵ)
该检验可以发现转置方向错误、偏置求和漏轴、梯度符号错误等问题。
实现
-
比较两种梯度
-
解析梯度:通过反向传播计算。
-
数值梯度:分别计算参数加上和减去 ϵ=10−5 时的损失,再通过中心差分估算梯度。
-
使用以下容差判断两者是否一致:
∣gana−gnum∣≤10−7+5×10⁻⁵∣gnum∣
-
-
覆盖所有参数组
-
检查 16 组参数,即 W1~W8 和 b1~b8。
-
每组抽取约 5 个元素:解析梯度绝对值最大的 2 个,以及固定随机种子选取的 3 个,去重后进行比较。
-
批大小设为 2,以控制计算量。
虽然只抽查部分参数,但较早层的参数梯度依赖后续各层传回的梯度,因此可以间接检查整条反向传播链路。
-
-
检查不同模式
- 评估模式:关闭 Dropout,前向计算具有确定性,可直接进行数值比较。
- 训练模式:固定 Dropout 掩码,确保计算解析梯度与数值梯度时使用相同的随机失活结果,避免随机性干扰比较。
-
检查前置条件
- 所有参数均使用
float64,降低有限差分中的浮点舍入误差。 - 检查梯度不全为零,避免反向传播断路导致解析梯度与数值梯度同时为零而误通过。
- 所有参数均使用
失败时排查
- 根据失败的参数组定位可能存在问题的网络层。
- 若只有个别元素不通过,检查对应计算是否接近 ReLU 或 MaxPool 的不可导点,再检查反向传播公式。
- 固定输入和随机种子以保证结果可复现,但检验结论仅适用于实际抽查的样本与参数元素。
过拟合测试
目的
检查完整训练链路能否通过反复更新参数,拟合一小批固定样本。
如果模型无法在极小数据集上有效降低损失、提高训练准确率,应进一步排查网络、梯度、优化器及数据对应关系。
即确认反复迭代之后,整条训练链路能不能真的让网络学会东西?
实现
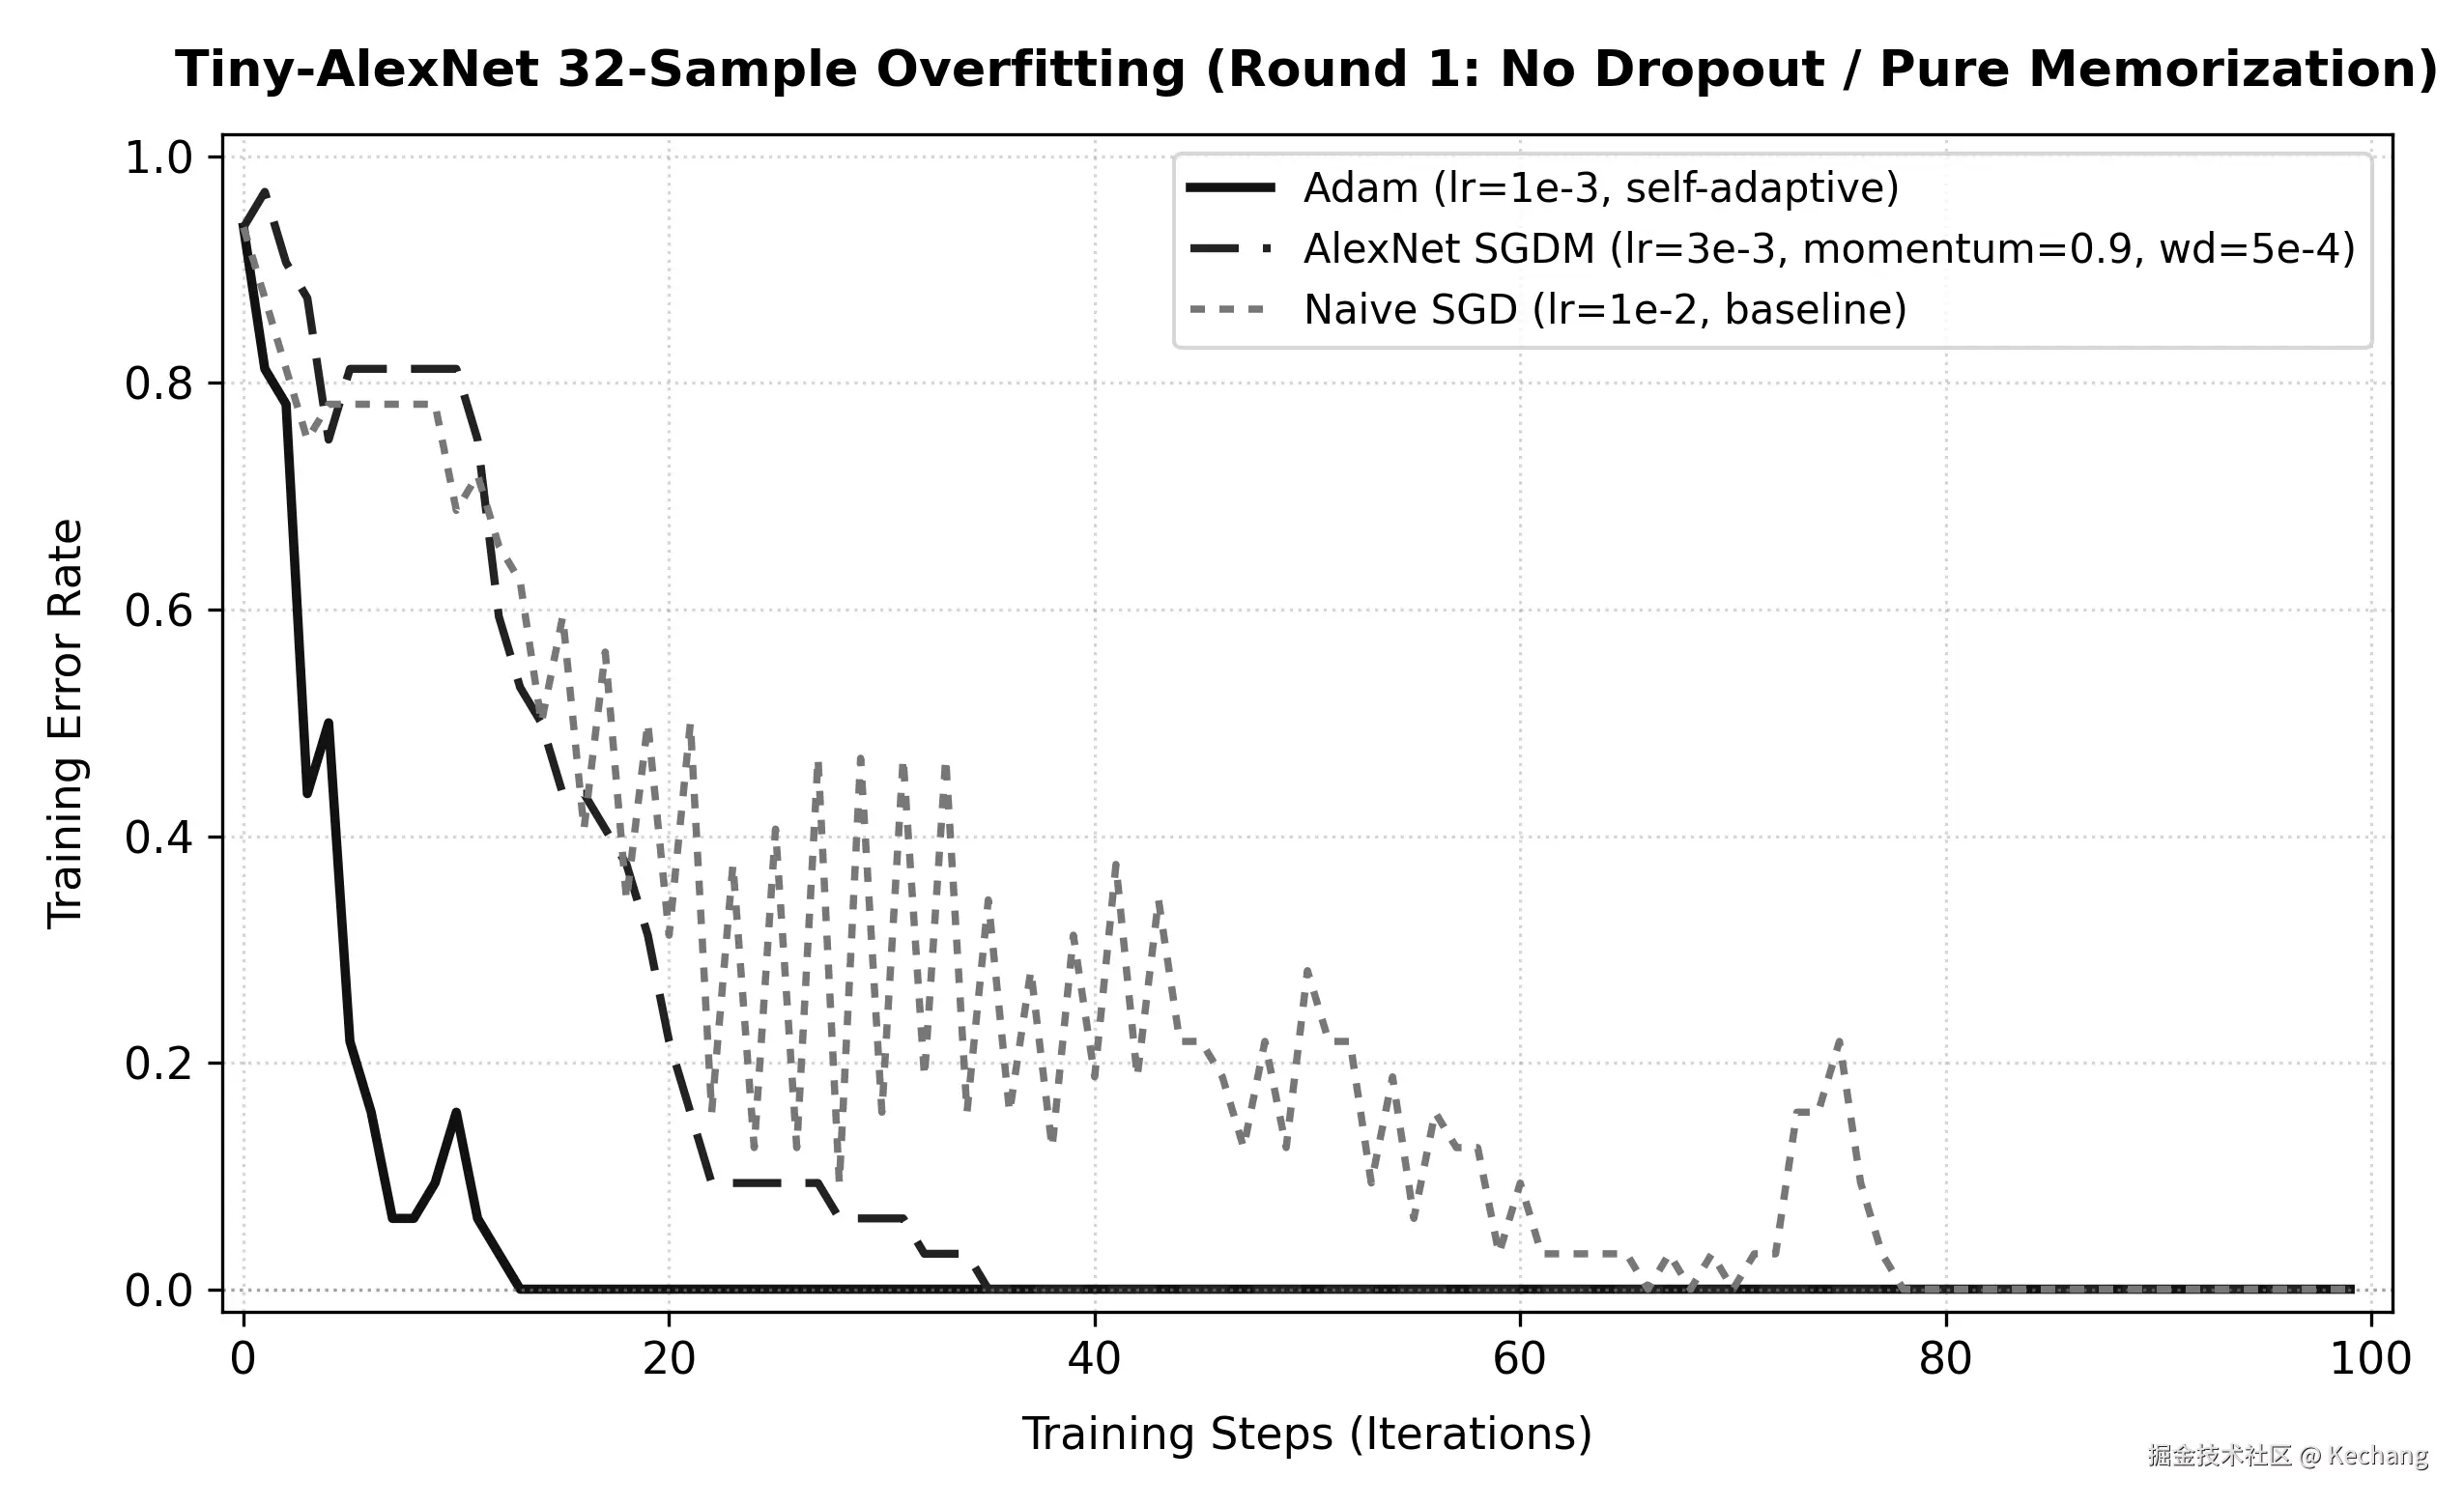
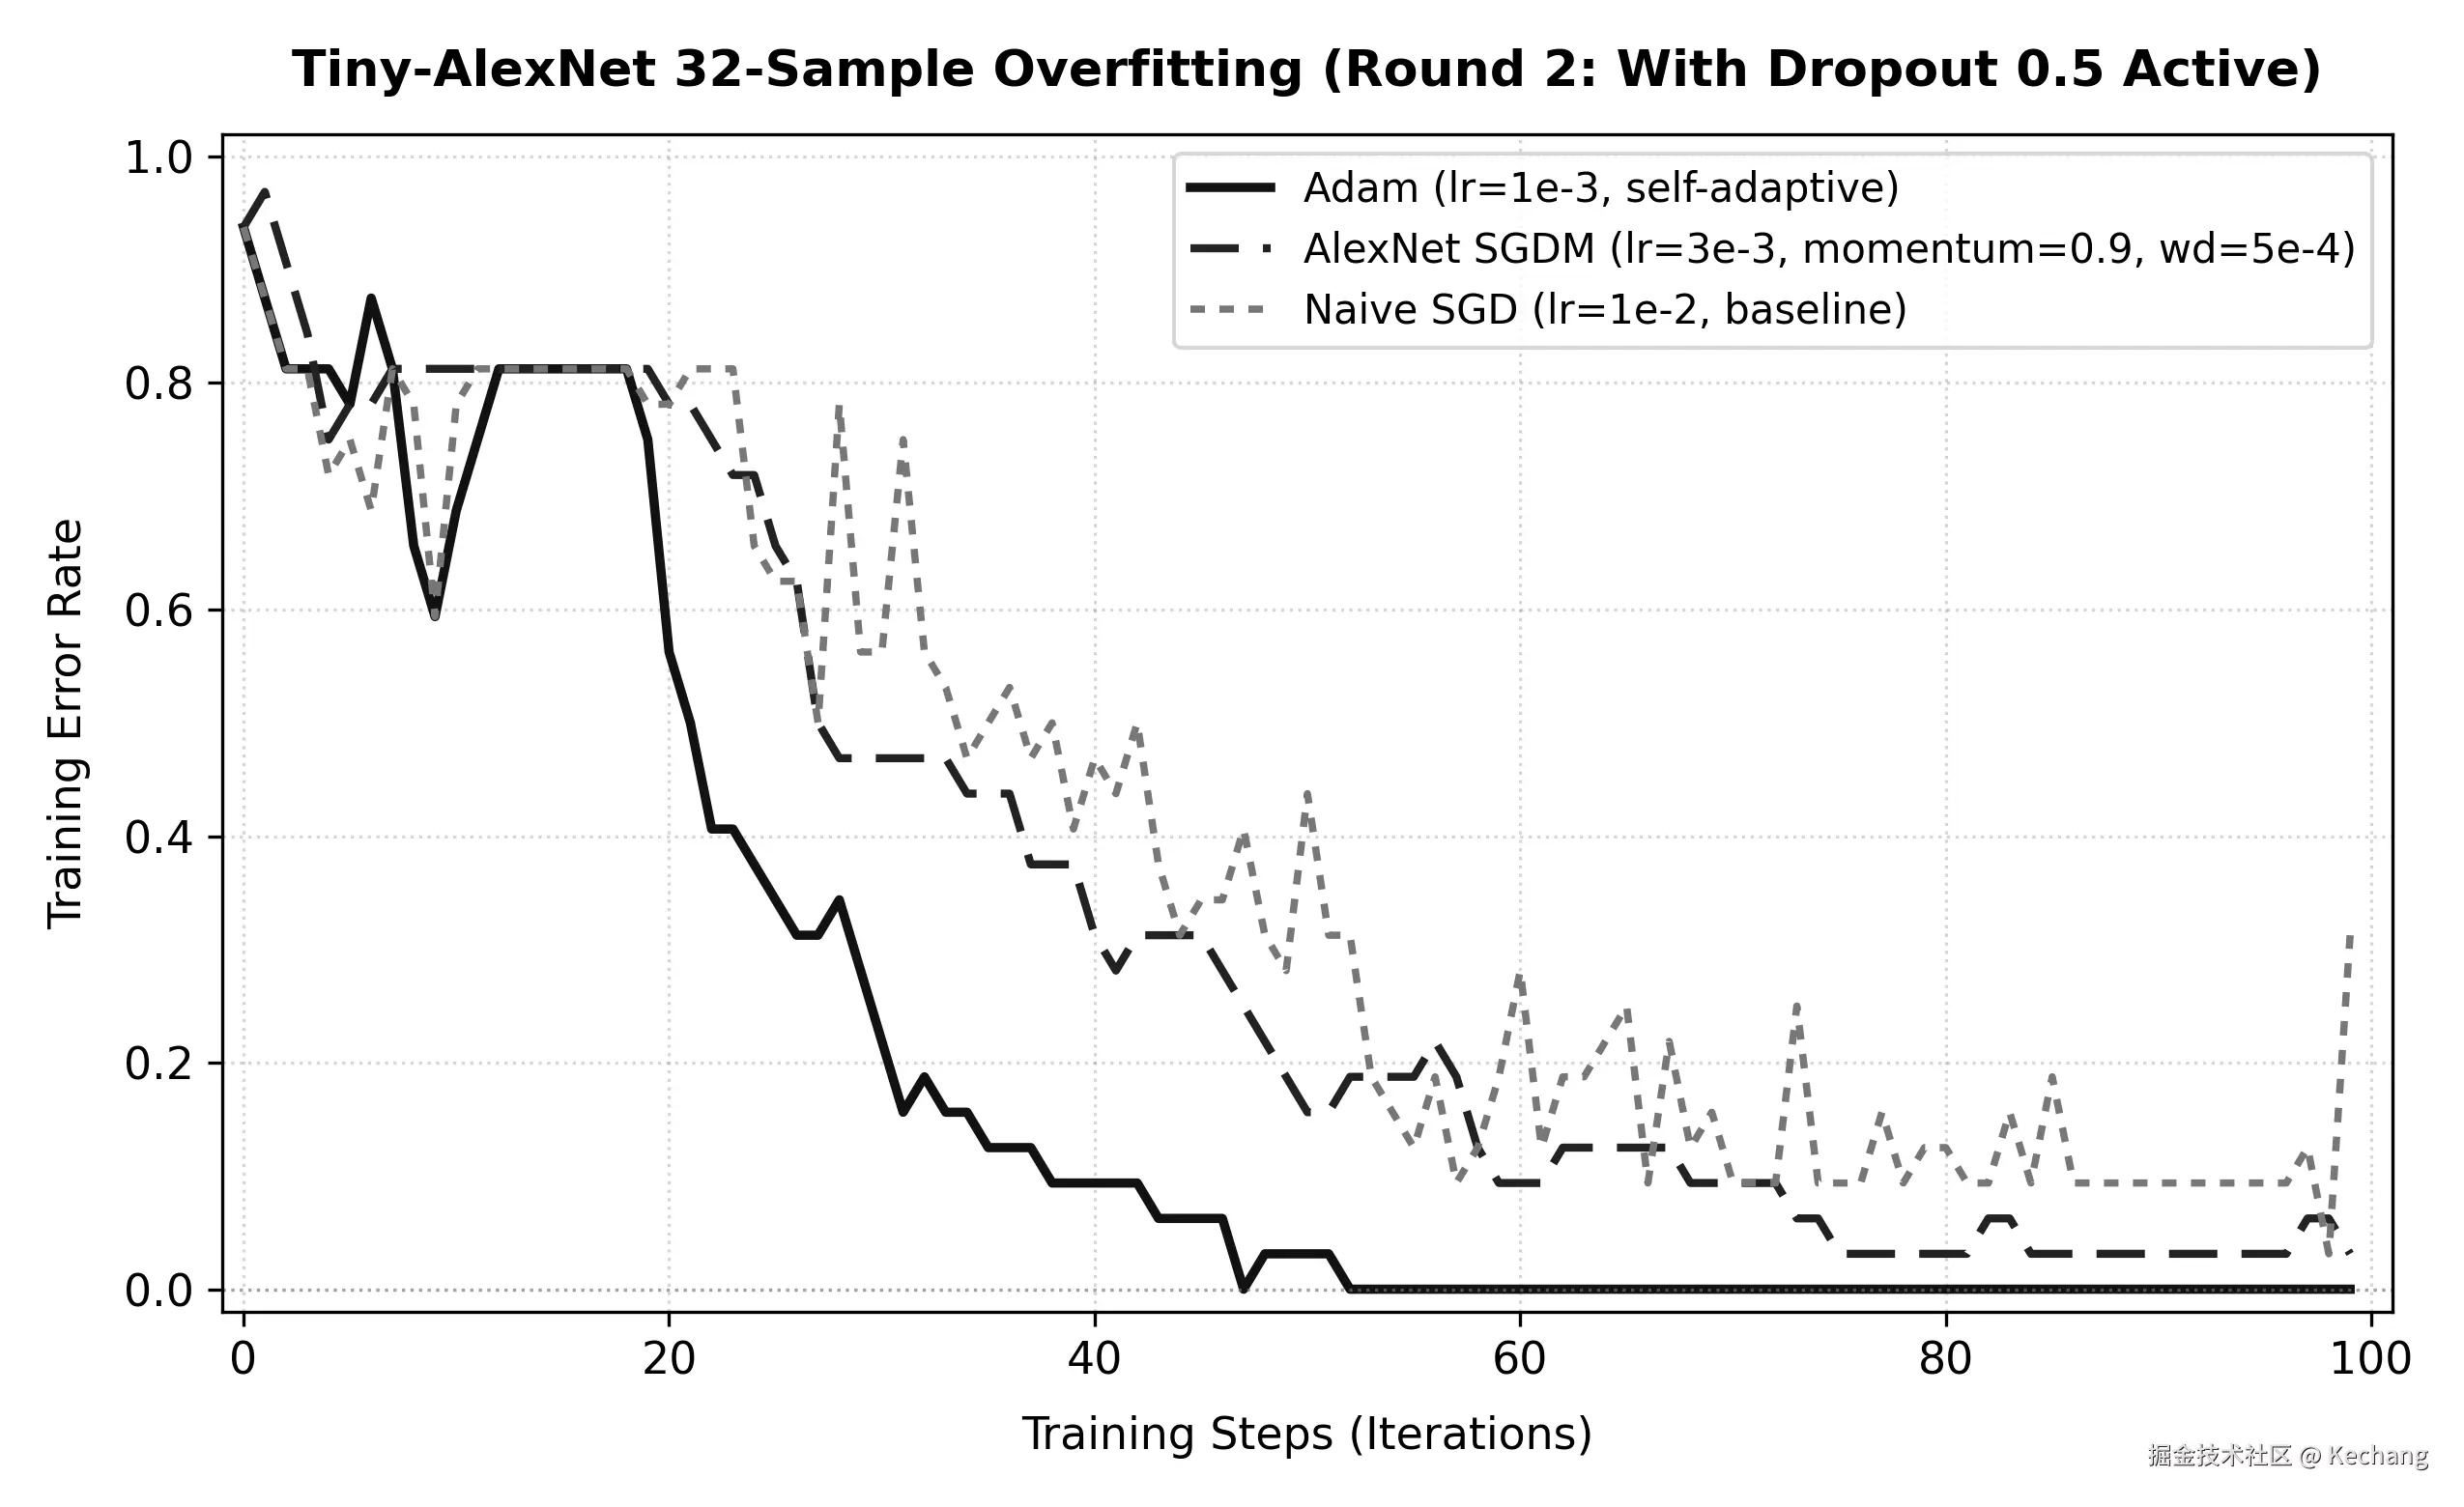
固定使用 32 张真实图像,反复训练约 100 步,观察损失和训练准确率的变化。
关闭 Dropout
- 使用评估模式进行训练诊断,减少随机失活对损失变化的影响。
- 检查模型能否有效拟合固定样本。
启用 Dropout
- 使用训练模式进行训练。
- 检查随机失活开启后,训练流程是否正常。
- 结合损失趋势和训练准确率判断拟合情况,不要求损失曲线单调下降。
失败时排查
- 反向传播:检查梯度计算是否正确。
- 层缓存:检查多步迭代之间的前向缓存是否正确更新。
- 优化器:检查优化器状态、参数更新及学习率。
- 数据对应关系:检查图像与标签是否一一对应,例如 One-hot 标签是否错位。
优化器的选择
根据过拟合测试中的表现可以看到 Adam 效率更优,所以后续模型中会使用 Adam 作为优化器。
验证
使用训练集与验证集评估模型的拟合能力和泛化表现,并据此确定最优模型。
Dropout 调参
目的
通过对比不同失活率的 Dropout 配置,检查全连接层的 Dropout 是否能改善小样本下的泛化表现,并观察失活率过大时的副作用。
实验设计
为观察过拟合现象,使用小样本训练,并控制其他变量一致。
- 训练数据:取前 5,000 张训练图像,参数量与样本量之比约为 104:1。
- 验证数据:完整的 10,000 张验证集。
- 训练轮数:30 个 Epoch,共 2,370 步,Batch Size 为 64。
- 优化器:
Adam(lr=1e-3)。 - 对照组:
Dropout = 0.0 / 0.5 / 0.7 / 0.8,共 4 组。 - 重复实验:每组使用 3 个随机种子(共 12 次运行),报告均值 ± 标准差(
ddof=1, n=3)。 - 评估方式:每轮结束后切换为评估模式(
train_flg=False,即关闭 Dropout),分别计算 5k 训练集与 10k 验证集的损失和准确率。
实验结果
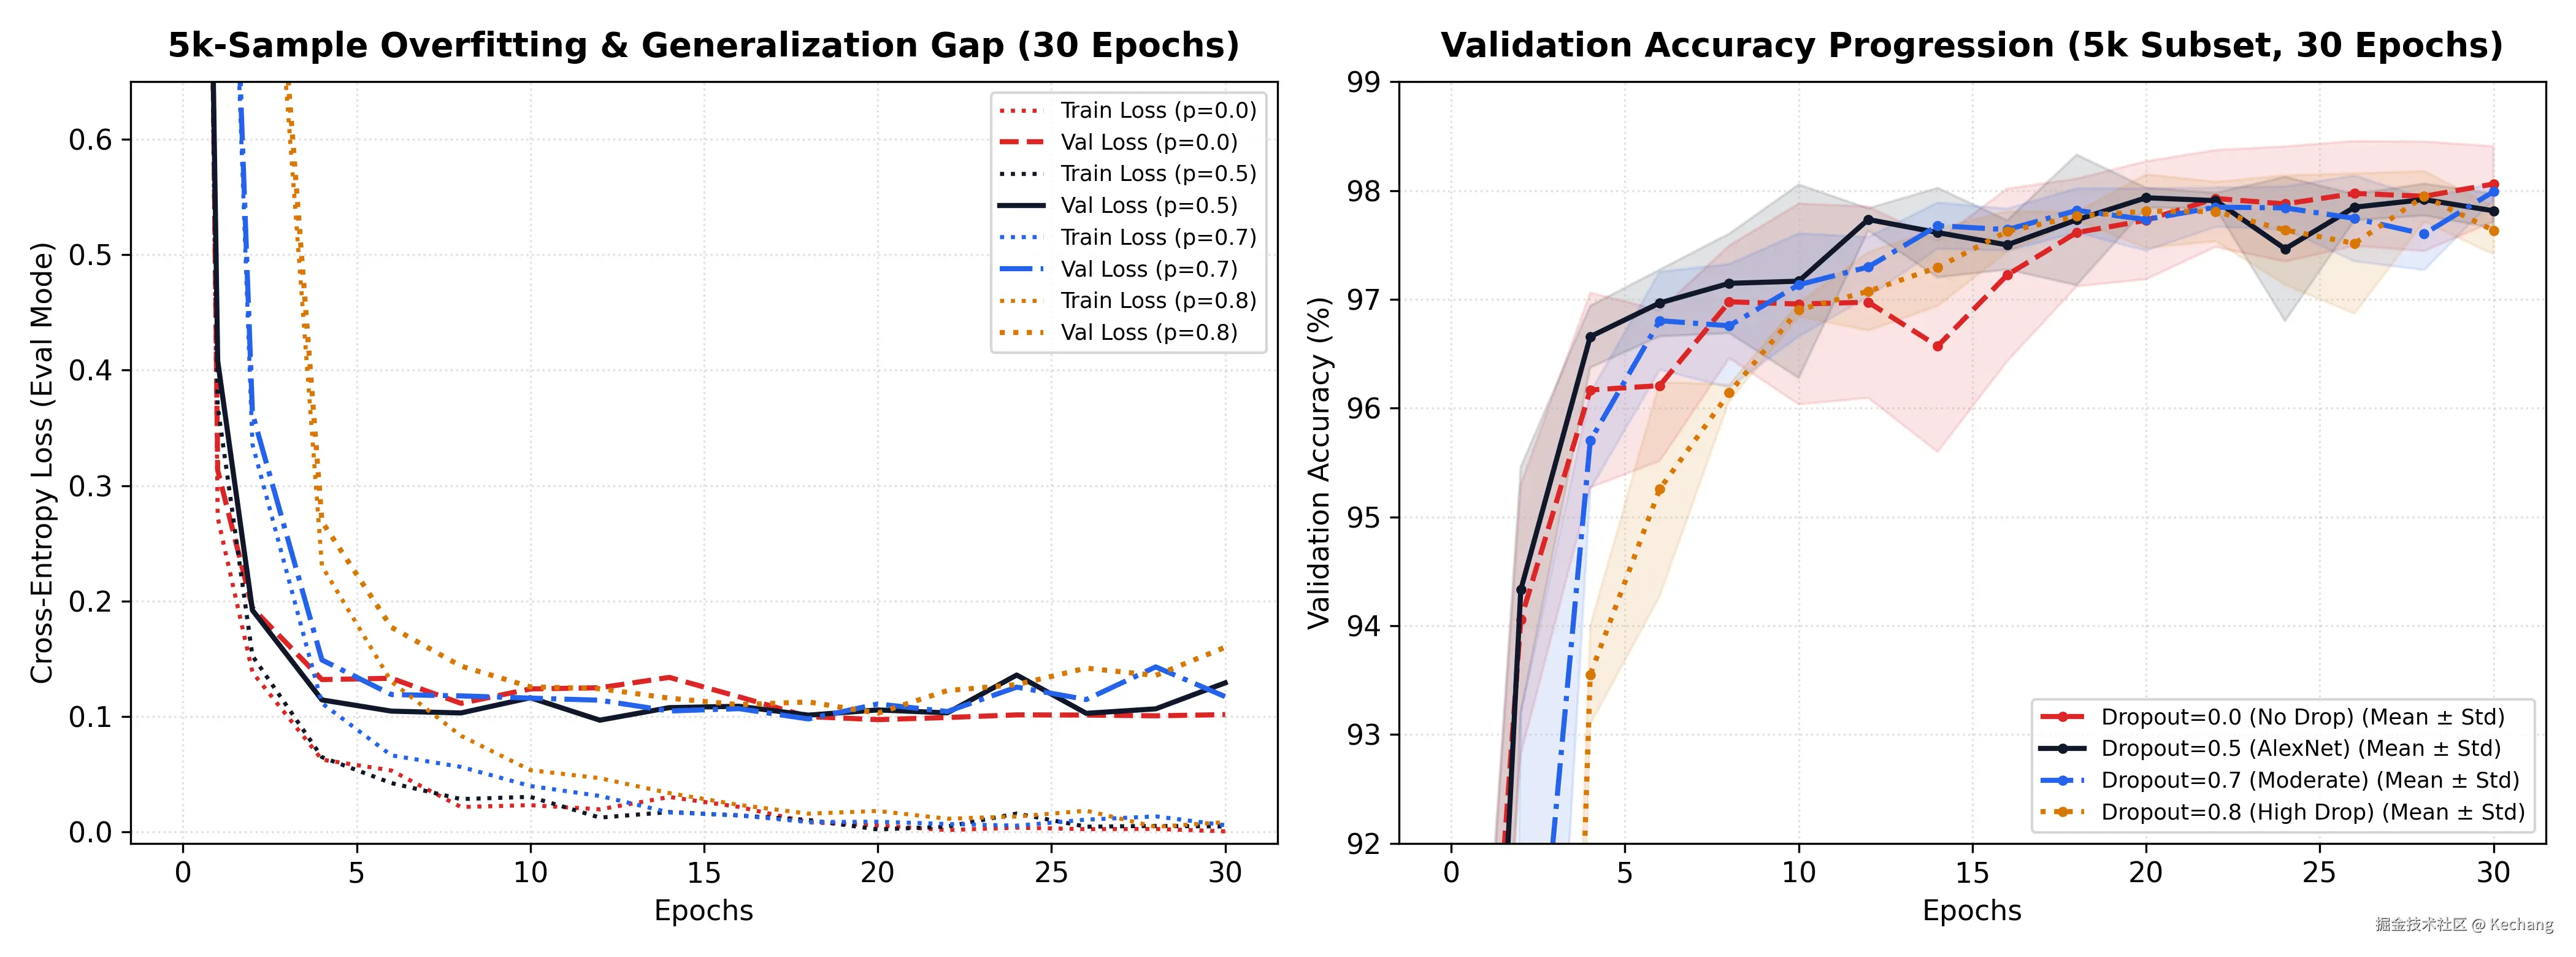
| 配置 | FC 层存活神经元(期望) | 5k 训练 Loss | 10k 验证 Loss | 泛化损失 ΔLoss | 验证准确率 (%) | 分析 |
|---|---|---|---|---|---|---|
| Dropout=0.0 (No Drop) | 256 (100%) | 0.0004 ± 0.0006 | 0.1015 ± 0.0145 | +0.1012 ± 0.0140 | 98.06% ± 0.35% | 近乎完全拟合;验证损失最低、准确率最高,但跨种子波动最大 |
| Dropout=0.5 | 128 (50%) | 0.0046 ± 0.0044 | 0.1290 ± 0.0206 | +0.1244 ± 0.0163 | 97.81% ± 0.16% | 验证损失出现波动(第 24 与 30 轮反弹至 ~0.13) |
| Dropout=0.7 | 77 (30%) | 0.0057 ± 0.0068 | 0.1171 ± 0.0046 | +0.1114 ± 0.0049 | 97.99% ± 0.08% | 准确率与损失的跨种子波动均最小 |
| Dropout=0.8 | 51 (20%) | 0.0084 ± 0.0045 | 0.1599 ± 0.0225 | +0.1515 ± 0.0234 | 97.63% ± 0.22% | 验证损失明显上翘,准确率最低 |
补充: Dropout=0.9 时会出现严重欠拟合,此处超参数可通过二分查找算法思路来快速找到。
实验结论
- 过拟合普遍存在:四组训练准确率均 ≥ 99.7%,训练损失均 < 0.01,训练与验证损失之间有 0.10~0.15 的差距。推测原因是 5k 样本过小,各组都能完全记住训练集,Dropout 的差异难以体现。本实验中,无 Dropout 组的验证损失最低、准确率最高,Dropout 未带来平均泛化改善。
- Dropout 可能提高稳定性: p=0.7 时,准确率标准差从 0.35% 降至 0.08%,验证损失标准差从 0.0145 降至 0.0046。但该趋势并不单调( p=0.8 时波动回升),且 n=3 时标准差估计很不稳定,只能视为现象,需增加种子数验证。
- 失活率过高代价明显: p=0.8 首轮验证准确率仅 32.40%( p=0.0/0.5 约为 88%~90%),收敛明显滞后。虽在 Epoch 10 左右追平,但终值验证损失反弹至 0.1599,准确率最低。
- 开销:开启 Dropout 会增加约 10%~17% 的训练耗时。
注:实验结果仅适用于当前网络、数据规模和训练配置;每组仅 3 个种子,组间微小差异应谨慎解读。这与 AlexNet 中 Dropout 显著缓解过拟合的结论并不矛盾(二者在网络规模与数据规模上差异很大)。
学习率调参
目的
在固定 Dropout = 0.7 的条件下,对比不同 Adam 学习率,检查学习率对收敛速度、泛化表现和稳定性的影响。
实验设计
与 Dropout 消融实验保持同参数,仅改变学习率。
- 训练数据:前 5,000 张训练图像;验证数据:完整的 10,000 张验证集。
- 训练轮数:30 个 Epoch,共 2,370 步,Batch Size 为 64。
- 固定配置:
Dropout = 0.7,优化器为Adam。 - 对照组:
lr = 1e-2 / 1e-3 / 1e-4,共 3 组。其中lr = 1e-3与 Dropout 实验中的 p=0.7 组数值一致。 - 重复实验:每组 3 个随机种子,报告均值 ± 标准差(
ddof=1, n=3)。 - 评估方式:每轮结束后切换为评估模式(
train_flg=False),分别计算 5k 训练集与 10k 验证集的损失和准确率。
实验结果
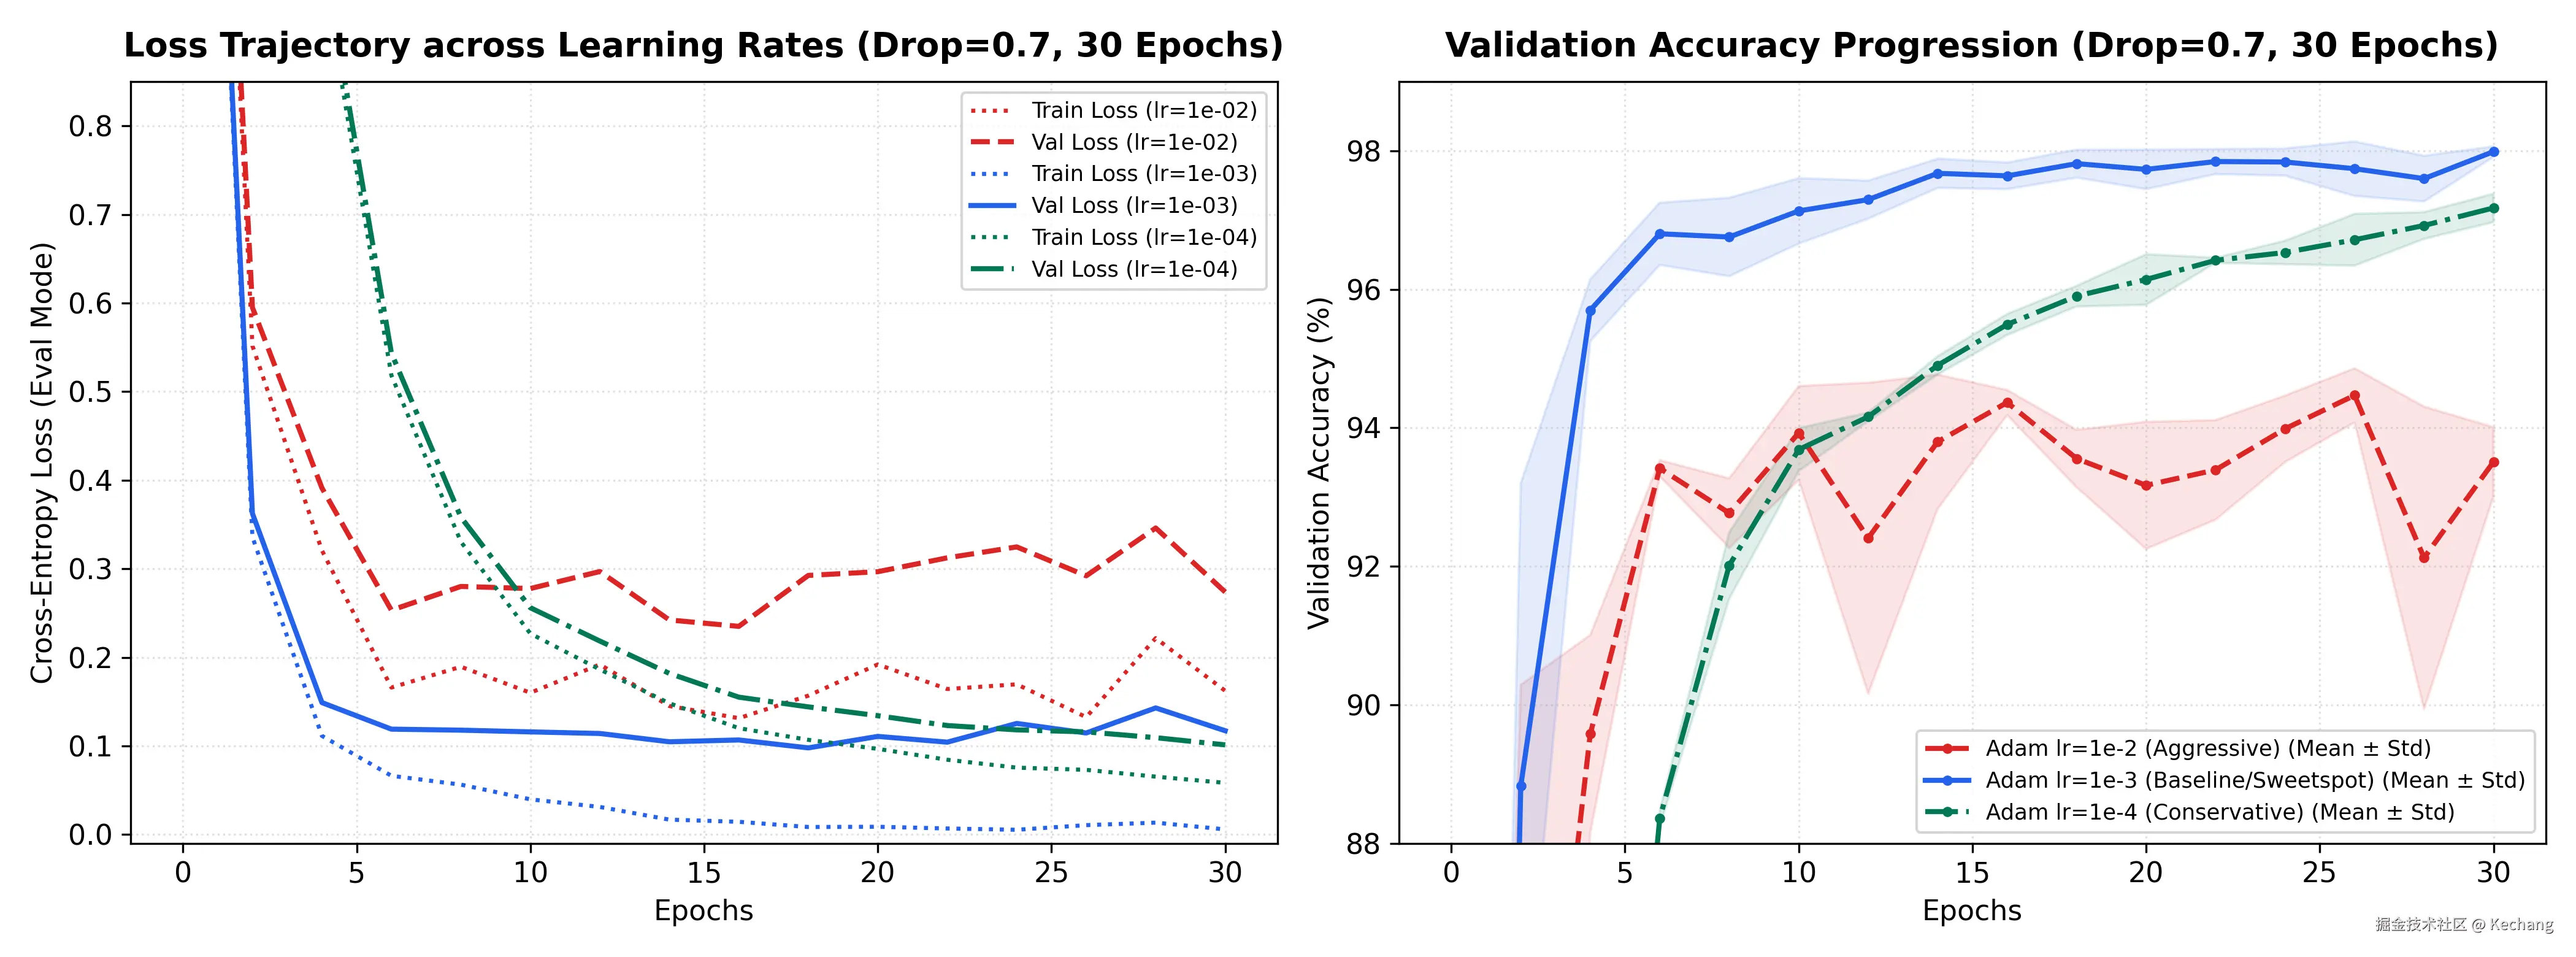
| 配置 | 5k 训练 Loss | 10k 验证 Loss | 泛化损失 ΔLoss | 验证准确率 (%) | 分析 |
|---|---|---|---|---|---|
| lr=1e-2 | 0.1622 ± 0.0329 | 0.2737 ± 0.0197 | +0.1116 ± 0.0323 | 93.51% ± 0.50% | 训练损失居高不下,验证准确率最低,首轮波动极大 |
| lr=1e-3 | 0.0057 ± 0.0068 | 0.1171 ± 0.0046 | +0.1114 ± 0.0049 | 97.99% ± 0.08% | 收敛快且稳定,验证准确率最高、跨种子波动最小 |
| lr=1e-4 | 0.0583 ± 0.0054 | 0.1011 ± 0.0045 | +0.0429 ± 0.0022 | 97.18% ± 0.21% | 收敛慢,泛化差距最小、验证损失最低,但 30 轮内仍在爬升 |
lr=1e−4 值得延长 Epochs 轮数继续测试
延长 Epochs 轮数测试
目的
5k 子集消融中 lr=1e-3 综合最优,但 lr=1e-4 的验证损失最低、泛化差距最小,且 30 轮内验证准确率仍在爬升,说明小学习率在该训练步数下可能尚未收敛。因此在完整 50,000 张训练集上重新对比这两个学习率,判断最终模型应采用哪个学习率、是否需要延长训练轮数。
实验设计
- 训练数据:完整的 50,000 张训练图像;验证数据:完整的 10,000 张验证集。
- 训练轮数:15 个 Epoch,共 11,730 步,Batch Size 为 64。
- 固定配置:
Dropout = 0.7,优化器为Adam。 - 对照组:
lr = 1e-3 / 1e-4,共 2 组。 - 随机种子:仅
seed = 42一次。两组初始验证结果一致(Loss 2.3033,Acc 9.61%),起点相同。 - 评估方式:每轮结束后在评估模式下计算 10k 验证集的损失与准确率。Train Loss 为训练模式(含 Dropout)下的批次加权平均,不能与验证损失直接相减。
与 5k 消融不同,本组只有单个种子,仅用于决定是否延长训练,不用于报告均值 ± 标准差。
实验结果
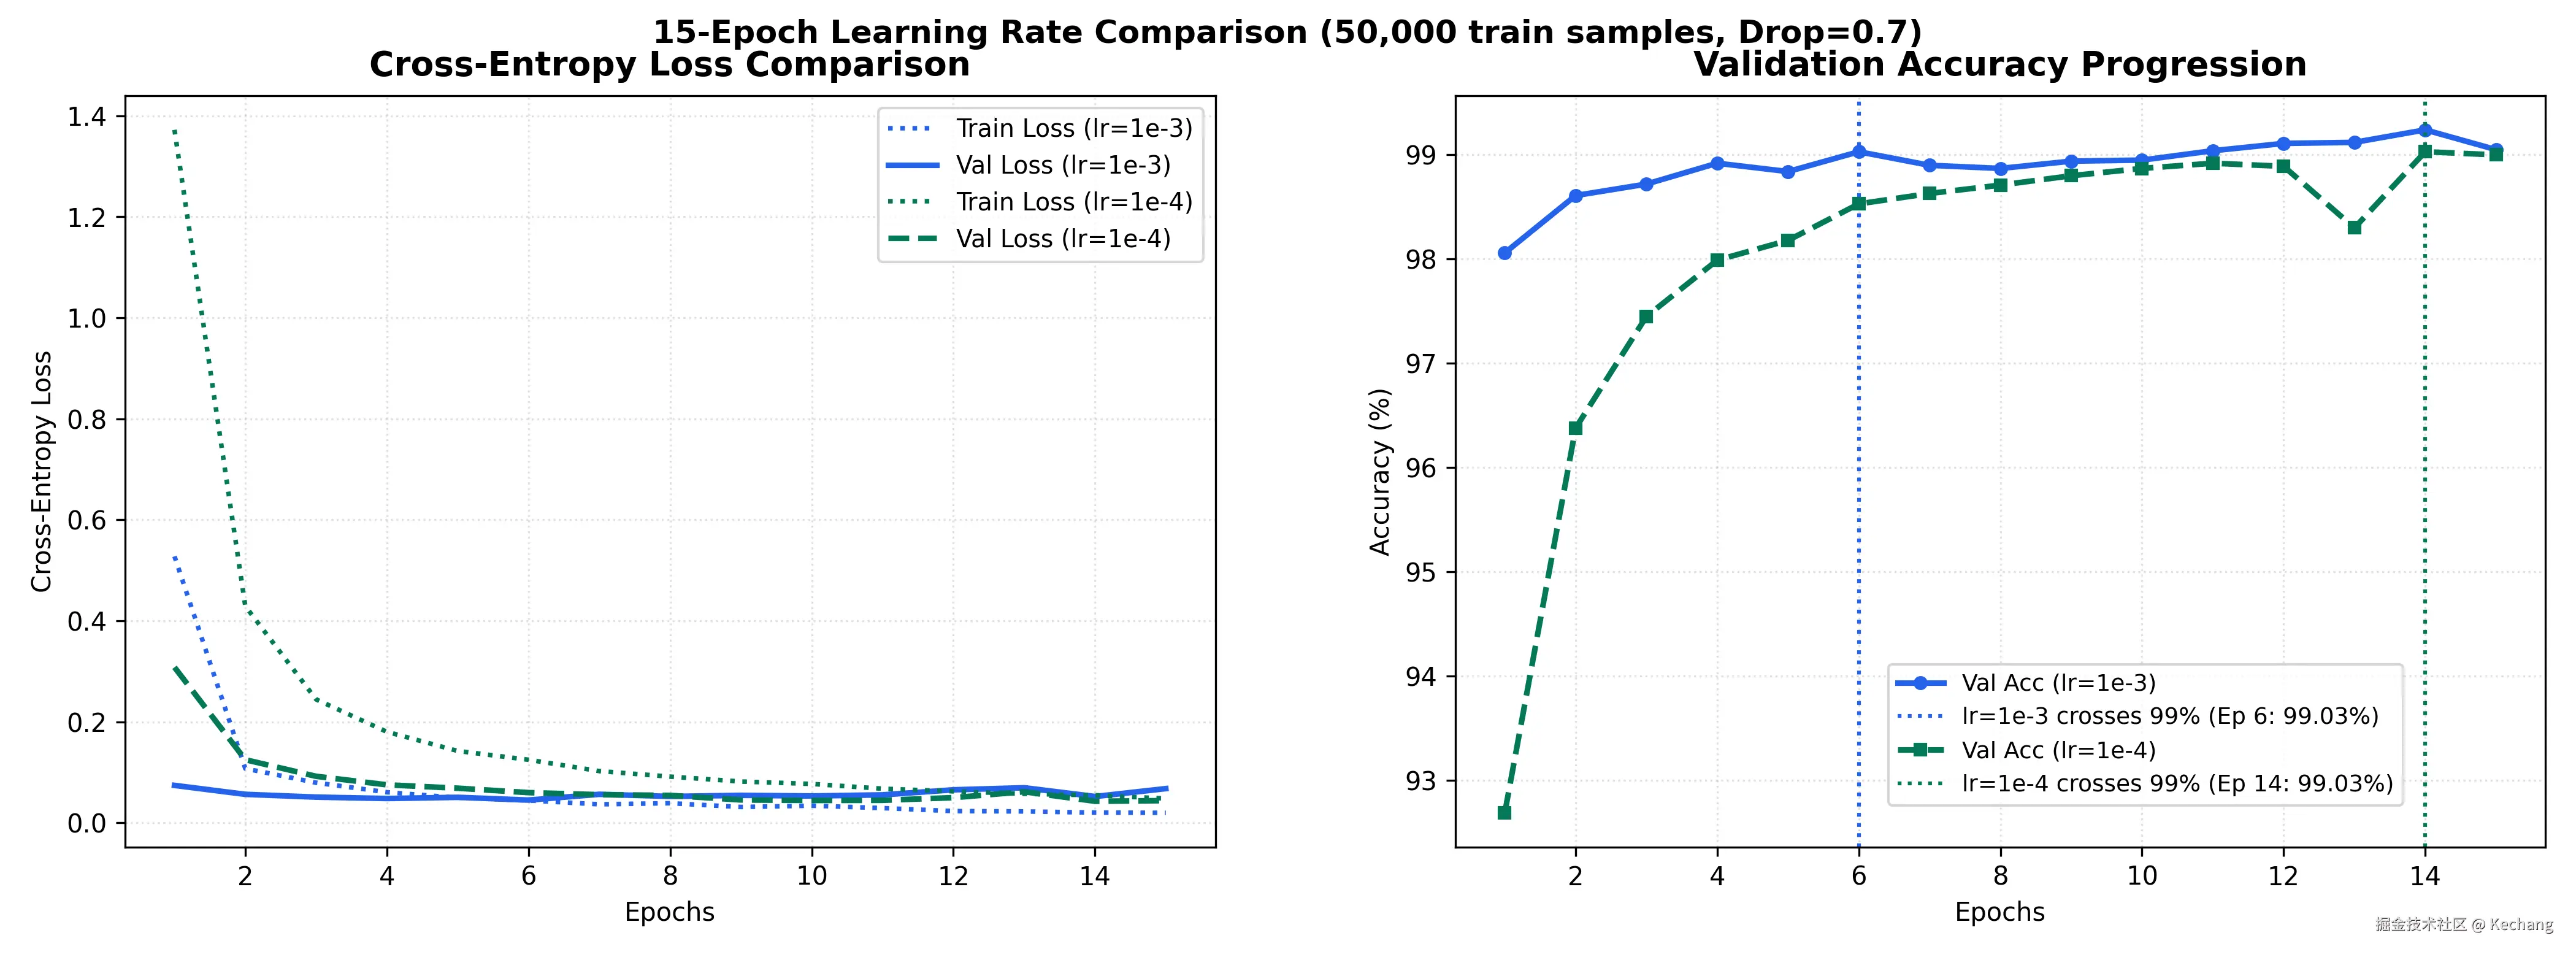
实验结论
lr=1e-4 的优势在于验证损失更低、仍有优化空间。延长到 30 轮后,它有机会保持损失优势,并在准确率上追平或超过 lr=1e-3。
最终模型
根据模型验证结果与实验,确定采用以下训练配置:
- 网络:TinyAlexNet,FC6 和 FC7 使用
Dropout(0.7)。 - 优化器:
Adam(lr=1e-4)。 - 训练数据:完整的 50,000 张训练图像。
- 训练轮数:30 个 Epoch。
- 权重选择:根据验证集表现选择最佳权重。
- 模型评估:权重确定后,在独立测试集上评估一次。
训练
在完整训练集上进行训练,并根据验证集表现选择权重。
全量训练与权重选择
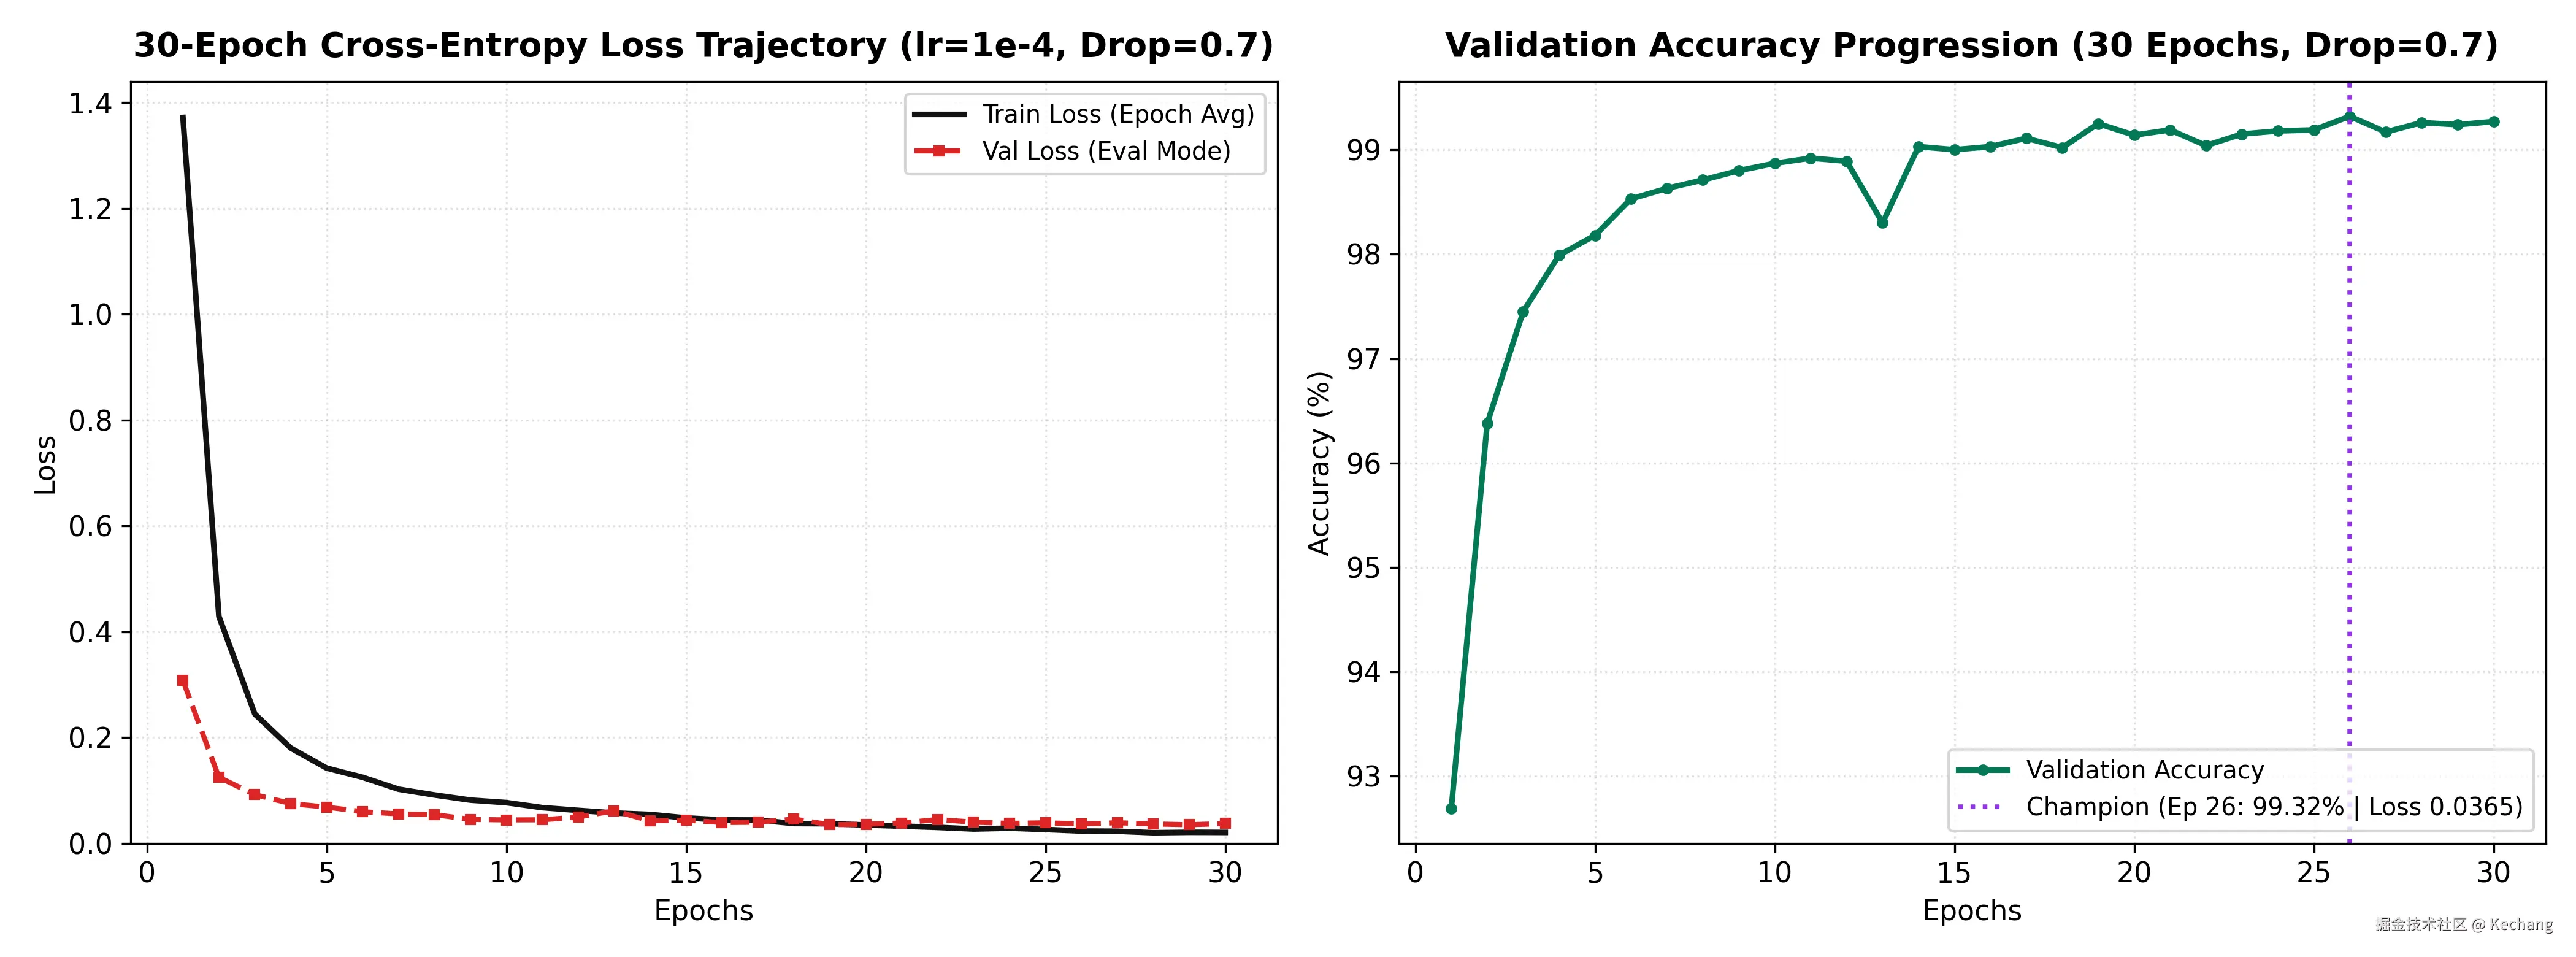
| 训练轮次 (Epoch) | 训练集平均损失 (Train Loss) | 验证集评估损失 (Val Loss) | 验证集准确率 (Val Acc) | 是否最优 |
|---|---|---|---|---|
| Epoch 0 (基线) | - | 2.3033 | 9.61% | |
| Epoch 1 | 1.3721 | 0.3078 | 92.69% | |
| Epoch 2 | 0.4289 | 0.1248 | 96.38% | |
| Epoch 3 | 0.2443 | 0.0920 | 97.45% | |
| Epoch 4 | 0.1800 | 0.0751 | 97.99% | |
| Epoch 5 | 0.1421 | 0.0684 | 98.18% | |
| Epoch 6 | 0.1247 | 0.0597 | 98.53% | |
| Epoch 7 | 0.1023 | 0.0555 | 98.63% | |
| Epoch 8 | 0.0913 | 0.0542 | 98.71% | |
| Epoch 9 | 0.0816 | 0.0452 | 98.80% | |
| Epoch 10 | 0.0769 | 0.0442 | 98.87% | |
| Epoch 11 | 0.0674 | 0.0444 | 98.92% | |
| Epoch 12 | 0.0622 | 0.0497 | 98.89% | |
| Epoch 13 | 0.0572 | 0.0614 | 98.30% | |
| Epoch 14 | 0.0545 | 0.0425 | 99.03% | |
| Epoch 15 | 0.0479 | 0.0437 | 99.00% | |
| Epoch 16 | 0.0442 | 0.0392 | 99.03% | |
| Epoch 17 | 0.0440 | 0.0398 | 99.11% | |
| Epoch 18 | 0.0374 | 0.0457 | 99.02% | |
| Epoch 19 | 0.0370 | 0.0352 | 99.25% | |
| Epoch 20 | 0.0346 | 0.0360 | 99.14% | |
| Epoch 21 | 0.0324 | 0.0383 | 99.19% | |
| Epoch 22 | 0.0301 | 0.0449 | 99.04% | |
| Epoch 23 | 0.0270 | 0.0400 | 99.15% | |
| Epoch 24 | 0.0285 | 0.0376 | 99.18% | |
| Epoch 25 | 0.0261 | 0.0388 | 99.19% | |
| Epoch 26 | 0.0231 | 0.0365 | 99.32% | ★ |
| Epoch 27 | 0.0227 | 0.0388 | 99.17% | |
| Epoch 28 | 0.0199 | 0.0366 | 99.26% | |
| Epoch 29 | 0.0208 | 0.0350 | 99.24% | |
| Epoch 30 | 0.0205 | 0.0374 | 99.27% |
测试集评估
评估方式
模型选择完成后,使用独立的 10,000 张测试图像(t10k)进行最终评估。
- 实例化
TinyAlexNet。 - 加载保存的最佳权重。
- 关闭 Dropout,使用评估模式进行前向传播。
- 计算测试集损失与准确率,并统计识别错误的样本。
评估结果
| 指标 | 实测数值 |
|---|---|
| 终审权重来源 | Adam (lr=1e-4),Epoch 26 |
| 测试集样本规模 | 10,000 张 |
| 最终测试集泛化损失 (Test Loss) | 0.0260 |
| 最终测试集泛化准确率 (Test Acc) | 99.27% |
| 正确识别样本总数 | 9,927 张 |
| 全集识别错误总数 | 73 张 |
结果分析
- 分类表现:测试集准确率达到 99.27%,10,000 张图像中有 9,927 张被正确识别,错误率 0.73%。
- 泛化表现:测试集准确率与验证集最佳准确率(99.32%)仅相差 0.05 个百分点(5 张)。验证集最优值是 30 轮中取最大值得到的,带有轻微的选择偏差,测试集略低与这一方向一致,但差距远小于测试集本身的抽样误差(10,000 张下,99.27% 的 95% 二项近似区间约为 ±0.17 个百分点)。
- 损失表现:测试集 Loss 为 0.0260,低于验证集最佳检查点对应的 0.0365,也低于 30 轮中任意一轮的验证损失(最低 0.0350)。不同数据集上的损失存在波动,不能仅凭这一差异判断模型是否过拟合。
测试集结果反映模型在这批独立数据上的表现,但不能单凭测试集指标证明模型完全不存在过拟合。
错题分析
筛选出模型判定失误的 73 个样本,按置信度分层取 10 个进行人工分析(最高置信度错误 5 张,最低置信度错误 5 张):
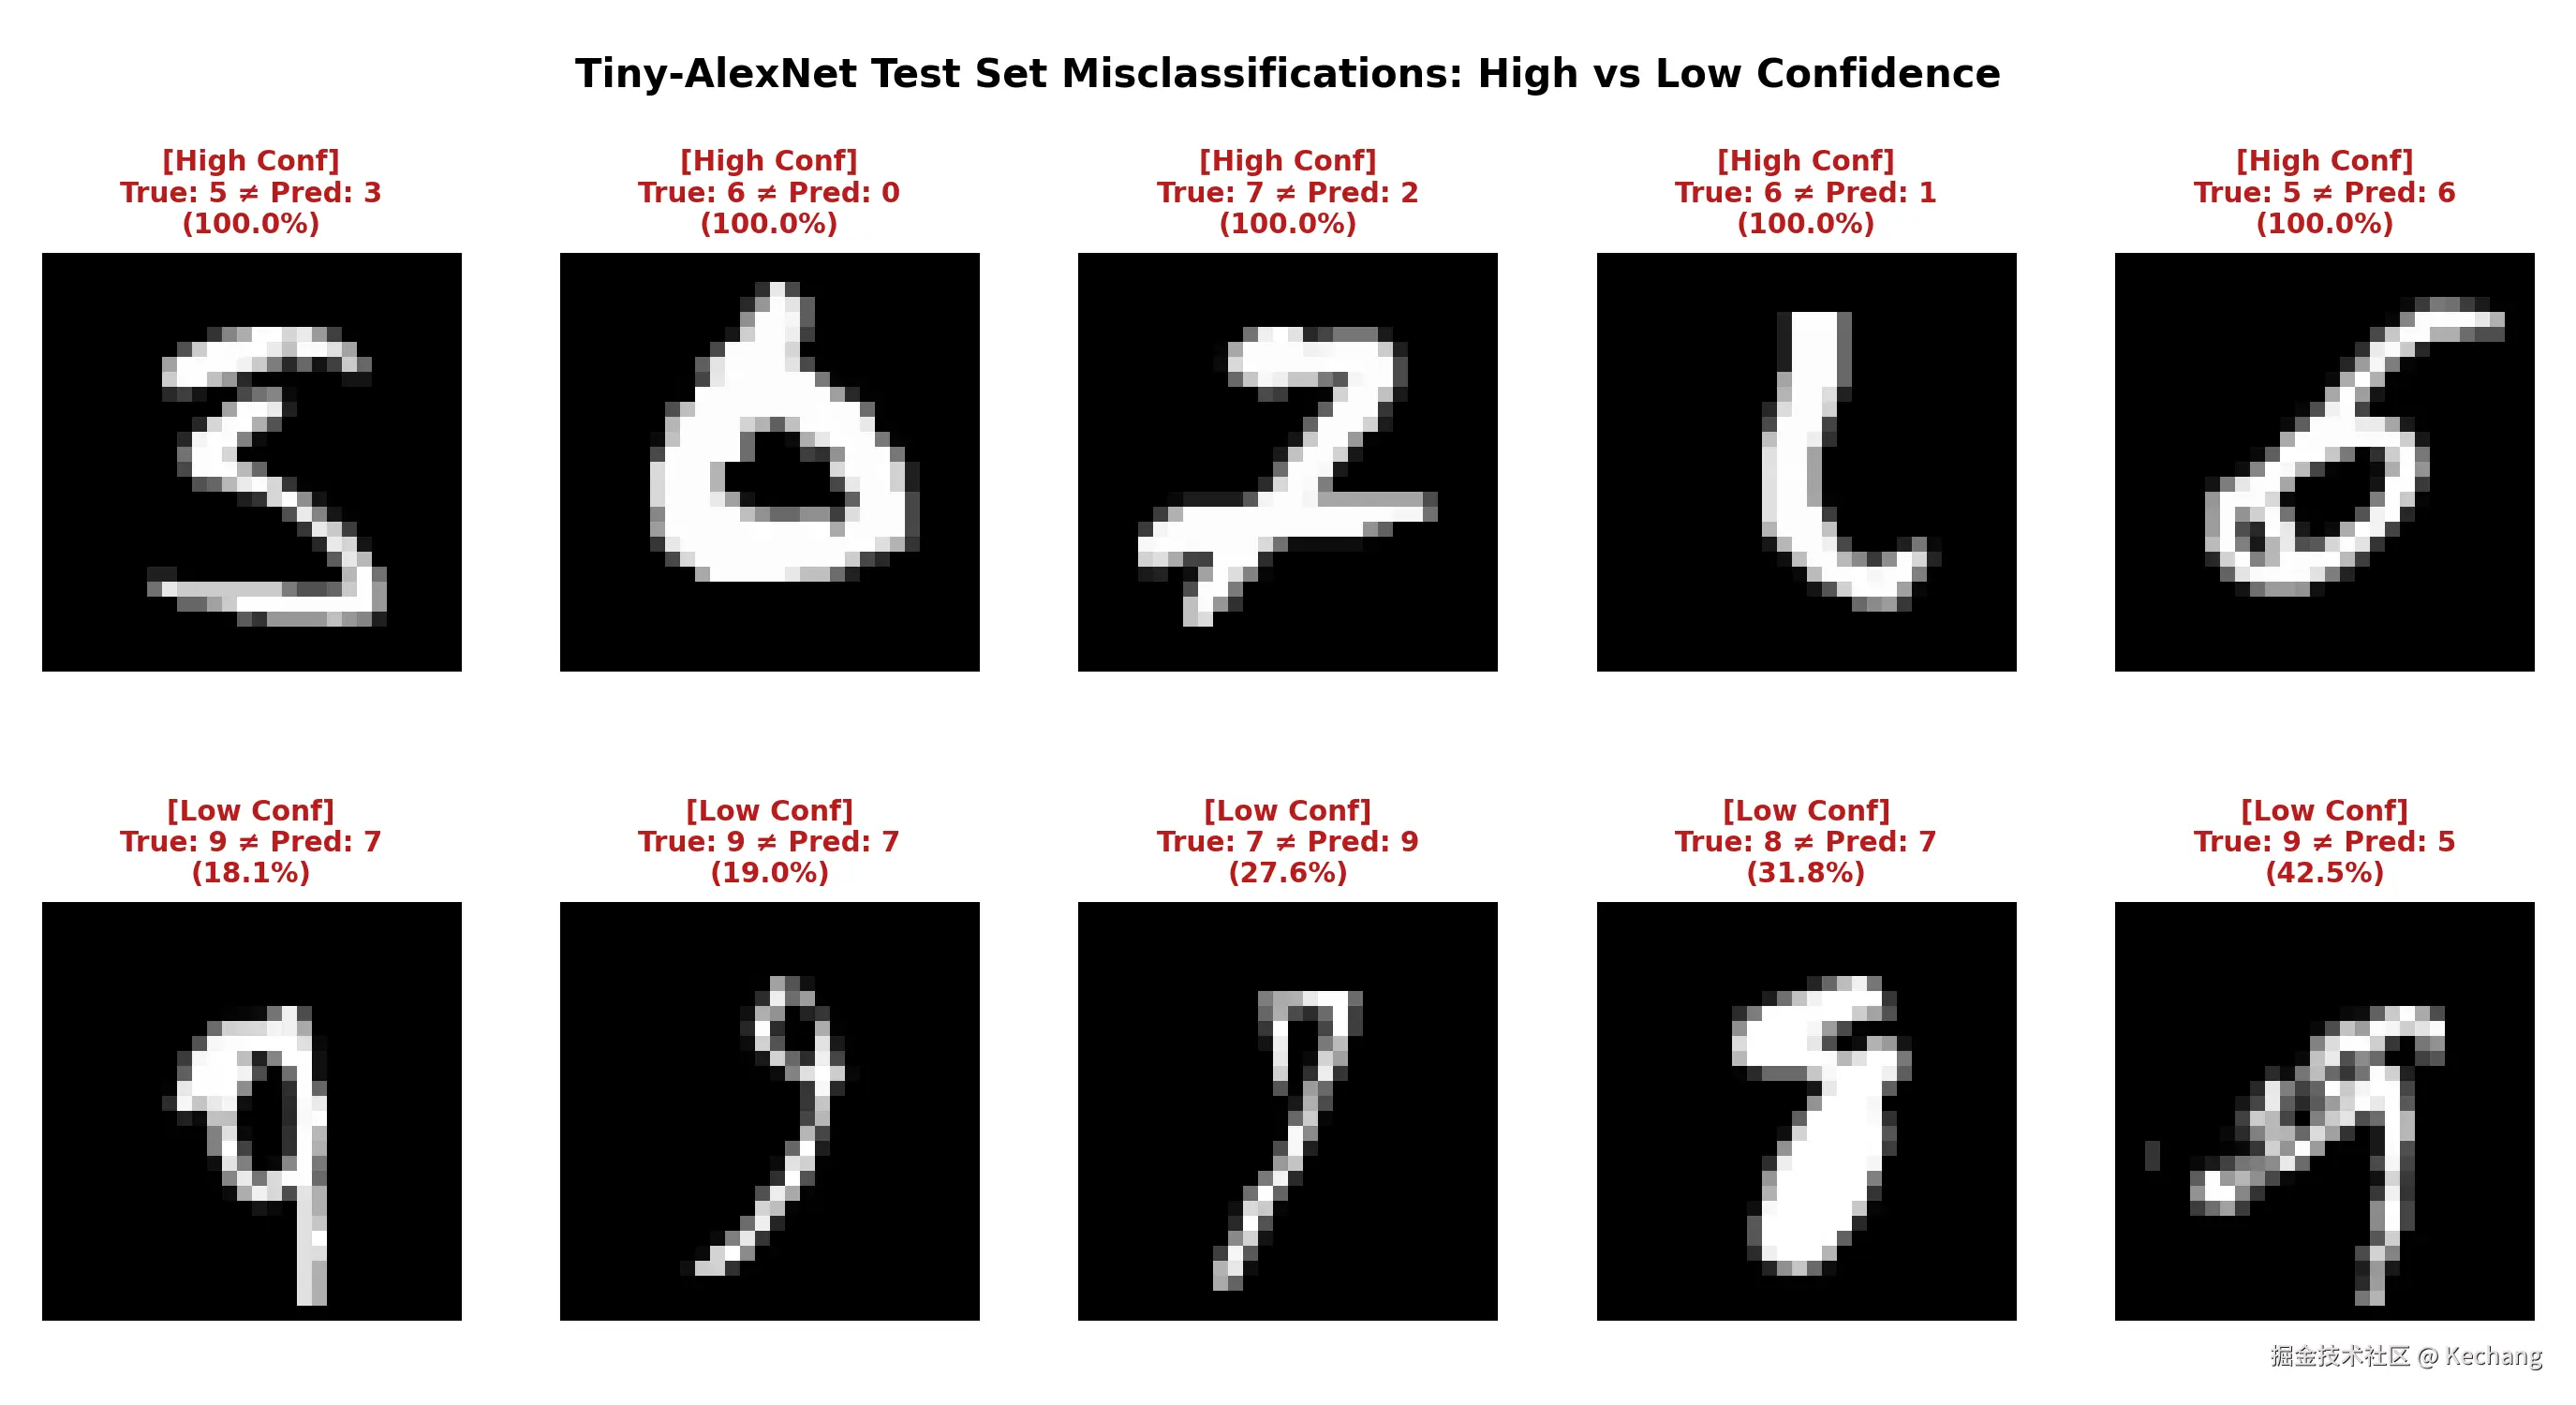
补充
通道数的设置
Tiny-AlexNet 的通道数采用 16、64、128 等数值,这些选择参考了 AlexNet 的架构。
这里想要补充的是,通道数的选择影响着模型的表征能力:
- 浅层特征:主要提取边缘、笔画、方向等局部模式。
- 深层特征:逐步组合低层特征,形成更复杂的结构表示。
对于卷积层:
参数量=CoutCinFHFW+Cout
在卷积核尺寸不变时,同时增加输入和输出通道数会使权重参数量近似按通道数的乘积增长。而下采样可以减少空间维度上的计算量,可以考虑增加通道数(因为计算量下降了,可以增加点通道补上)。不过是否增加通道数,应根据任务、模型容量与计算预算决定。
He 初始化
对于 Affine/Conv 中学习的权重矩阵 W,需要进行初始化。
2015 年,何恺明推导出了一个数学定理:
" 如果我们用 ReLU 激活函数,因为负数会被抹成 0,信号强度在每一层会被削减一半。 为了让信号在穿透任意多层之后,方差既不爆炸、也不消失,始终稳定保持在 1 左右,每一个权重必须进行严格的缩放: 权重的标准差 σ,必须精确等于 Din2!"
- 如果输入维度 Din 很大(比如 1000 个输入相加), 10002 ≈0.045,每个权重就被自动调小,防止相加时爆炸;
- 如果输入维度 Din 很小(比如 10 个输入相加), 102 ≈0.45,每个权重就被自动调大,防止信号太微弱。
python
def kaiming_init(D_in, D_out):
    W = np.random.randn(D_in, D_out) * np.sqrt(2.0 / D_in)
    return W
卷积层的输入感受野神经元数量为:
fan_in=C×FH×FW
其权重标准差必须缩放为 C⋅FH⋅FW2 ,所以使用下面的代码:
python
def kaiming_init(*shape):
    if len(shape) == 1 and isinstance(shape[0], (tuple, list)):
        weight_shape = tuple(shape[0])
    else:
        weight_shape = shape

    if not weight_shape or any(
        not isinstance(dimension, (int, np.integer)) or dimension <= 0
        for dimension in weight_shape
    ):
        raise ValueError("weight shape must contain positive integers")

    if len(weight_shape) == 1:
        fan_in = weight_shape[0]
    elif len(weight_shape) == 2:
        fan_in = weight_shape[0]
    else:
        fan_in = np.prod(weight_shape[1:], dtype=np.int64)

    return np.random.randn(*weight_shape) * np.sqrt(2.0 / fan_in)
小结
通过研读 AlexNet 论文,并尝试使用 NumPy 实现基础算子、搭建网络及完成训练,我对 CNN 的结构设计、核心算子的前向传播与反向传播的推导有了更深入的理解,了解了神经网络开发的基本流程,基本达成了最初的学习目标。
不过,当前基于 MNIST 数据集的 Tiny-AlexNet 仍有进一步优化的空间:
数据集处理:可以参考 AlexNet 做数据增量来缓解过拟合/提高泛化能力。没有判断 MNIST 数据集中各数字个数是否相同并做出对应处理(正负样本偏差)。
网络结构:相对于 MNIST 的任务复杂度,当前网络的参数量仍然较大。可以尝试精简网络层,减少参数量,并进一步观察模型的拟合与泛化表现。
超参数选择:部分超参数尚未经过严谨的对照实验,后续可以进一步验证其对训练效果的影响。
归一化设计:移除了原版 AlexNet 中的 LRN 层,但尚未尝试 Batch Normalization,可以进一步研究不同归一化方法对训练稳定性与收敛效果的影响。
Q&A
Q1:为什么 Alex 要在 Conv3 这个节点做通信? A1:如果全程不通信:两块 GPU 等同于在各自独立训练两个 " 窄版 " 小模型(相当于把通道砍半的两组模型做低级拼凑),无法学习到跨通道的组合特征;
Q2:为什么不在 Conv2 就通信? A2:PCIe 总线带宽瓶颈。2012 年主板的 PCIe 传输速度极慢,而 Conv1 输出的特征图空间尺寸非常大( 55×55)。如果在 Conv2 就跨卡传输,GPU 算力会被漫长的总线 I/O 饿死;到了 Conv2 结束时,特征图经过池化已经被压缩到了较小的空间尺寸( 27×27),此时跨卡通信的传输代价降到了可承受区间。
Q3:ReLU 部分,直接将 x<0 情况的反向传播 dout 置为 0,是否可以说部分神经元出现了梯度消失? A3:不能叫 " 梯度消失 ",ReLU 的局部导数只有两个离散状态:非 0 即 1: 稀疏性(Sparsity):面对一张写着数字 "1" 的图片,大脑里专门识别 " 水平横线 " 和 " 圆圈 " 的神经元根本不需要被激活(前向传播 x < 0);既然这些神经元对 " 识别数字 1" 毫无贡献,那么反向传播时,它们的梯度就理所应当地被置为 0,不参与这次更新 死神经元(Dying ReLU):只有当某个神经元的权重在某次暴躁的梯度冲击下,被打到了极深的负数区;导致它面对训练集里的所有图片(不管给它看数字 0 还是数字 9),前向计算的结果全都是负数,它就再也拿不到任何非零梯度了,永久冻结,再也无法复活。这种极端病态才被叫做 Dying ReLU
Q4: He 初始化部分,为什么不能全初始化为 0? A5: 如果 W 全填 0,所有的神经元前向计算出来的结果全都是 0;反向传播算出的梯度也一模一样。所有神经元做一模一样的事情,本层网络退化成只有一个神经元。