一次交付要走需求、设计、开发、验证、交付五个阶段,跨好几个会话,中间还会遇到上下文压缩和会话中断。阶段和阶段之间靠什么串起来,是设计工作流时第一个要回答的问题。
我们的答案是 Agent 操作 CLI:流程定义、进度和检查放在 CLI 里,Agent 决定每一步怎么做,并通过 CLI 命令查询进度、登记产物、请求推进。
本篇讲五件事:
- 为什么不全交给 Agent,也不全交给脚本;
- 工作流的三个核心概念 Workflow、Phase、State 各是什么,skill 怎样绑定到阶段上;
- 阶段之间怎么交接,State 怎么推进;
- 人在工作流里确认哪几件事;
- 压缩、换会话之后怎么接着走,hook 接在哪几个事件上。
第 01 篇的结尾说过,流程的正确性不能建立在「hook 一定会运行」上。这一篇讲 hook 之外,流程靠什么串起来。
全交给 Agent、全交给 CLI,以及 Agent 操作 CLI
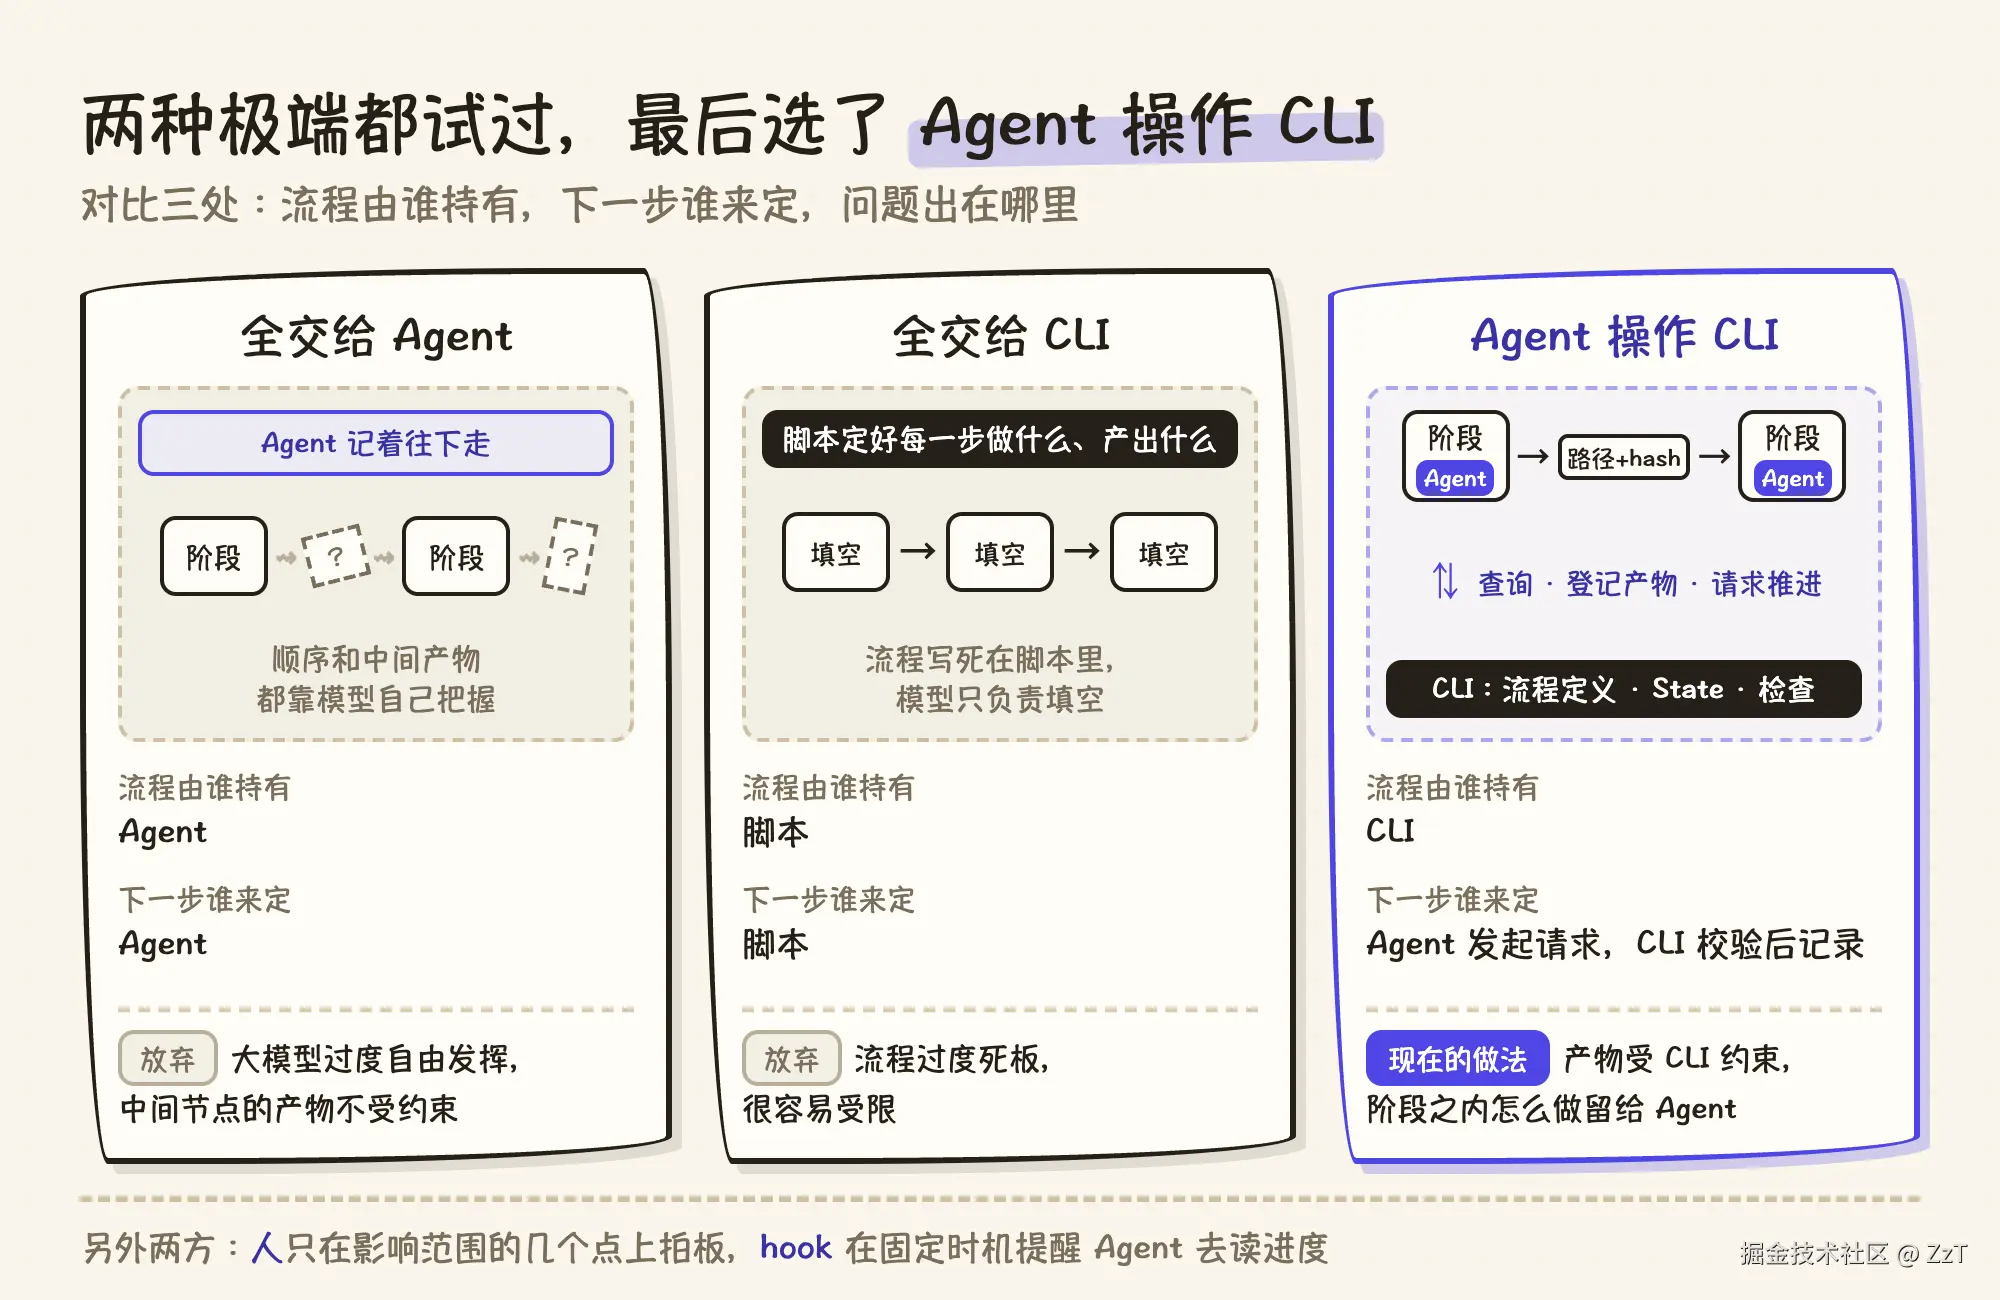
两种极端的做法我们都试过。
全部交给 Agent 串。 阶段顺序、做法、产物要求都写在 skill 和提示里,由模型记着往下走。问题是大模型会过度自由发挥,中间节点的产物不受约束。
全部交给 CLI 串。 每一步做什么、调用什么、产出什么都由脚本决定,模型只负责填空。流程稳定了,但过度死板,很容易受限。
现在的做法是两者结合,由 Agent 操作 CLI:
- CLI 持有流程定义、每次交付的进度和确定性检查,约束产物是什么、放在哪里、怎样算合格、下一步能去哪里;
- Agent 在阶段之内决定怎么做,通过 CLI 命令查询进度、登记产物、请求推进;
- 人只在影响范围的几个点上拍板;
- hook 在固定时机提醒 Agent 去读进度,不替它做决定。
下面先讲 CLI 持有的三个概念,再讲交接、推进、人的角色和恢复,最后讲 hook。
Workflow、Phase、State 三个概念的定义
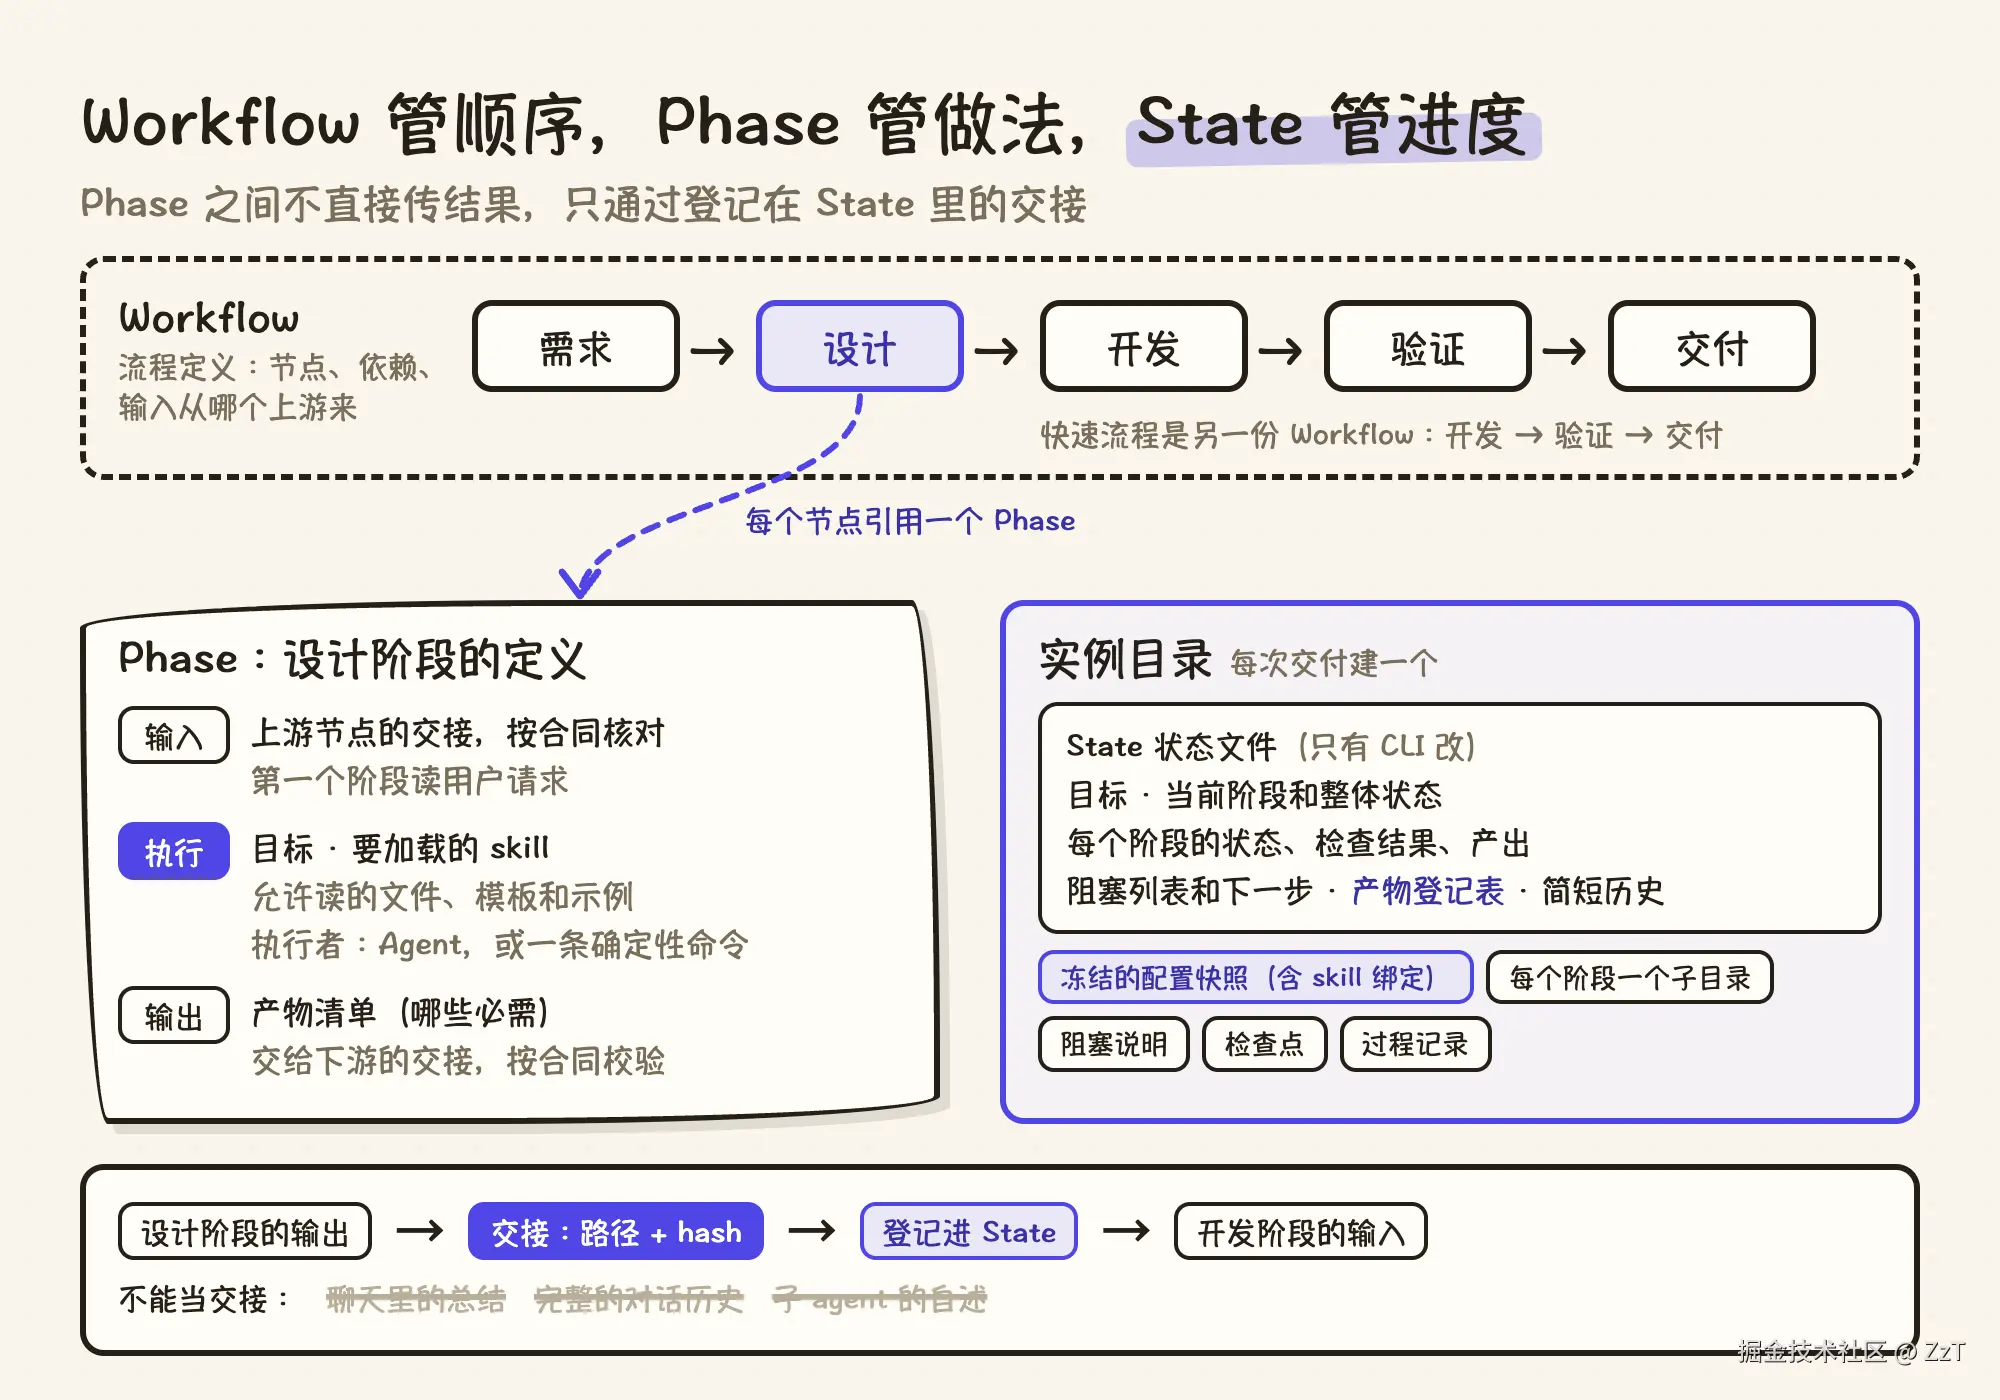
先各用一句话定义:
- Workflow 是流程定义,只描述有哪些阶段节点、谁依赖谁、每个节点的输入从哪个上游来,不包含任何具体做法;
- Phase 是阶段定义,描述一个阶段读什么、由谁来做、产出什么、怎样算合格;
- State 是一次工作流实例的当前事实,记录走到了哪里、卡在哪里、产出了什么。
三者的关系:Workflow 的每个节点引用一个 Phase。每开始一次交付,CLI 按 Workflow 建一个工作流实例(下文简称实例),State 写在实例目录里。Phase 之间不直接传递结果,只通过登记在 State 里的交接文件。
Workflow:节点、依赖和输入来源
Workflow 的每个节点写四项:节点 ID、引用哪个 Phase、直接依赖、输入来自哪个上游节点的哪个产出。整个流程另外声明流程输入(用户请求)和最终输出(最后一个节点的交接)。
下面是裁剪过的快速流程定义,只有开发、验证、交付三个节点:
yaml
kind: workflow
id: quick-delivery
inputs:
  request: { contract: quick-request }
nodes:
  - id: develop
    phase: quick-develop
    needs: []
    inputs: { request: { input: request } }
  - id: verify
    phase: quick-verify
    needs: [develop]
    inputs: { previous: { node: develop, output: implementation } }
  - id: delivery
    phase: quick-delivery
    needs: [verify]
    inputs: { previous: { node: verify, output: verification } }
outputs:
  delivery: { node: delivery, output: delivery }
阶段的先后只由节点之间的依赖决定。完整流程是「需求 → 设计 → 开发 → 验证 → 交付」,快速流程是「开发 → 验证 → 交付」,两者是两份 Workflow 定义。走快速流程时,不为凑齐阶段补造需求和方案文档。
这里的「节点」专指一次阶段调用。开发阶段内部还有一张任务图,那张图的节点是业务工作单元,留到第 04、05 篇讲。
Phase:输入、执行、输出三段
Phase 分三段声明:
- 输入:来源是上游节点的交接,第一个阶段读用户请求;
- 执行:阶段目标、执行者、要加载的 skill,以及允许读的文件、模板和示例;
- 输出:产物清单,标明哪些必需、哪一个是交给下游的交接,交接按合同校验。
执行者有两种。多数阶段由主会话的编排者执行,也就是 Agent 本身;纯检查类的阶段可以只是一条确定性命令,不需要模型参与。
下面是裁剪过的设计阶段定义:
yaml
kind: phase
id: full-design
input:
  ports:
    previous: { contract: full-requirements }
execution:
  goal: 形成可执行、可评审的技术方案,并明确开发范围
  executor: { kind: orchestrator }
  skills:
    - { id: design, path: skills/design/SKILL.md, load: entry, required: true }
    - id: component-reuse
      path: skills/component-reuse/SKILL.md
      load: on-demand
      required: false
      when: { platforms: [android, ios] }
output:
  ports:
    implementation-plan: { contract: full-design }
  artifacts:
    - { id: plan, path: design/plan.md, required: true }
    - { id: task-graph, path: design/tasks.md, required: true }
产物的内容由 Agent 写,产物是否齐全、交接是否符合合同由 CLI 判断。阶段出口的分工就是这一条。
阶段 skill 与原子 skill 的绑定
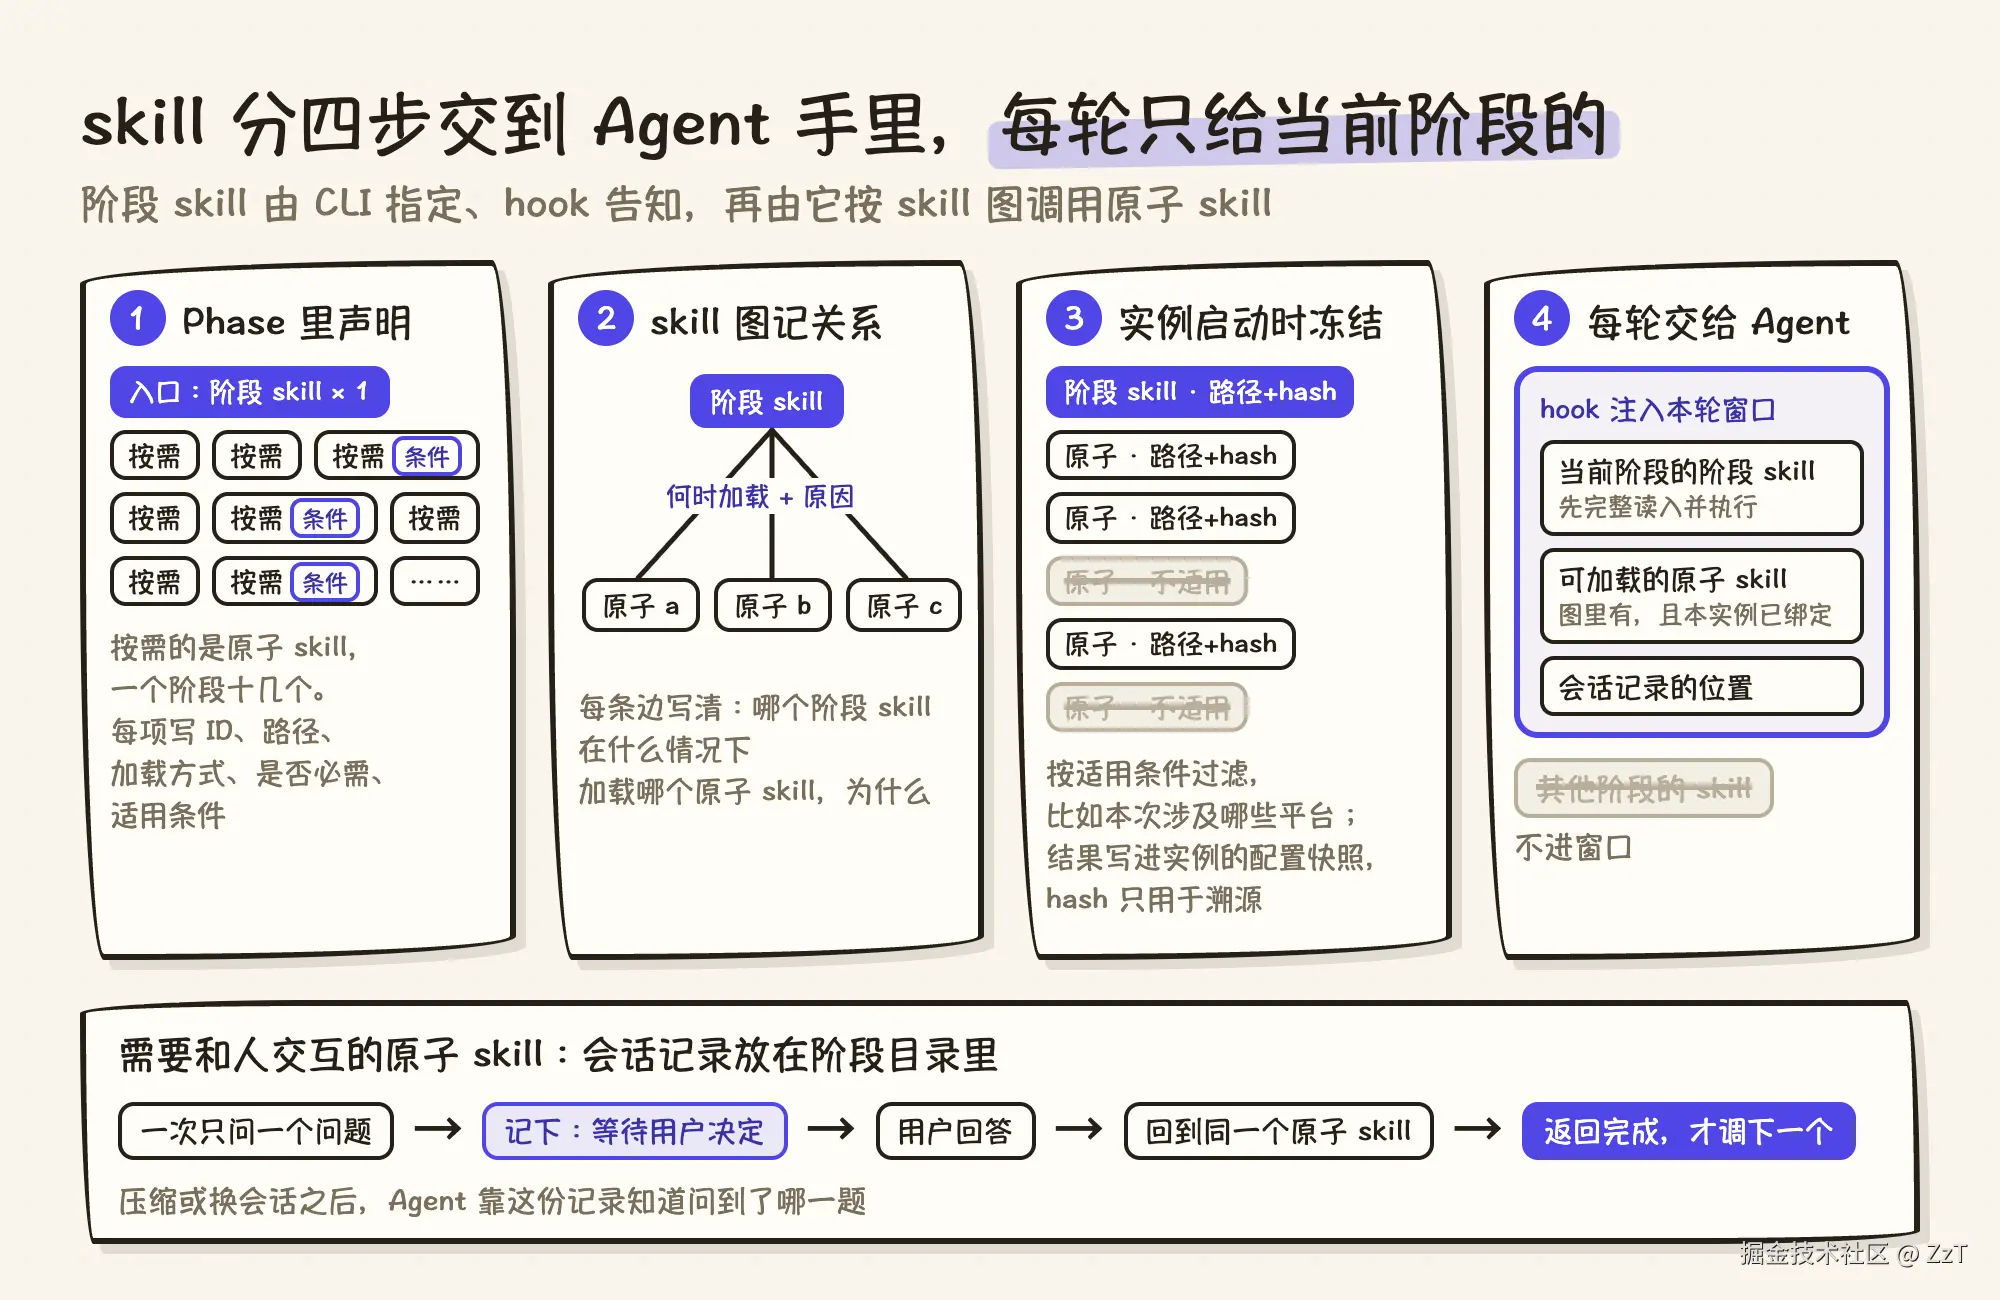
Phase 的执行段列出本阶段可用的 skill,每项写 ID、文件路径、加载方式、是否必需、适用条件。加载方式只有两种:
- 入口:每个阶段恰好一个,必需,是这个阶段的主 skill,下文叫阶段 skill;
- 按需:原子 skill,阶段里遇到具体情况才加载。
我们的每个阶段一般是 1 个入口加十几个按需。
skill 之间的调用关系放在一份单独的 skill 图里。每条边写清哪个阶段 skill 在什么情况下加载哪个原子 skill,以及原因:
yaml
edges:
  - from: design
    to: component-reuse
    type: dynamic_load
    reason: 发现可复用组件缺口时加载,先盘点目标仓已有组件,再决定复用还是新增
实例启动时,CLI 逐个阶段解析 skill 声明,按适用条件过滤(比如本次交付涉及哪些平台),结果写进实例的配置快照:
- 每个阶段对应哪个阶段 skill;
- 每个已绑定 skill 的 ID、路径和 hash,hash 用于溯源。
之后每轮提交时,hook 从快照里取出当前阶段的部分交给 Agent:阶段 skill 的路径、它可以加载的原子 skill、skill 会话记录的位置。可以加载的原子 skill 是 skill 图里有、并且本实例已经绑定的那些。
同时附上一条要求:先完整读入并执行阶段 skill,再由阶段 skill 按 skill 图显式调用原子 skill,不能把阶段 skill 降级成「生成一份产物」的普通任务。
需要和人交互的原子 skill(比如需求澄清)另有一份会话记录,放在阶段目录里,记录当前活跃的原子 skill、状态、待回答的问题和已经做出的决定。规则有三条:
- 一次只问一个问题;
- 用户回答后回到同一个原子 skill 继续,不跳到下游;
- 活跃的原子 skill 返回完成,阶段 skill 才调用下一个。
压缩或换会话之后,Agent 靠这份记录知道问到了哪一题。
回到第 01 篇讲的上下文窗口:skill 文件照常投影到两个宿主,但每轮只把当前阶段的 skill 交给 Agent,窗口里不会出现其他阶段的方法。
State:实例目录里的状态文件
每个实例一个独立目录,里面有一个状态文件,每个阶段一个子目录,另有冻结的配置快照、当前阻塞说明、检查点和过程记录。
状态文件记录这些内容:
- 目标;
- 当前阶段和整体状态;
- 每个阶段的状态、开始和结束时间、检查结果、产出;
- 阻塞列表和下一步;
- 产物登记表;
- 简短历史。
读写分工是 Agent 操作 CLI 的核心:
- 只有 CLI 改 State;
- Agent 通过 CLI 的查询命令读 State,需要推进时显式发请求;
- hook 不改 State,只往实例的事件记录里追加一条观察。
交付从一个工作流入口 skill 开始:它负责选择流程、调用 CLI 建立实例,以及中断后的恢复。各阶段 skill 开头都写明:没有进行中的交付时,先通过入口开始。
阶段之间只传路径和 hash
一个阶段从拿到输入到交出结果,顺序固定:最小的权威输入 → 聚焦执行 → 确定性检查 → 交接 → 下一阶段。
交接只是一个小索引,记交接文件的路径和 hash,不复制正文。下游只读 Phase 里声明过、并且已经在 State 里登记的交接文件。三类内容不能当交接:
- 聊天里的总结;
- 完整的对话历史;
- 子 agent 的自述,比如「已完成,产物在某处」。
分工原则是:依赖图、命令结果、检查结论用确定性逻辑,模型只做语义提取、综合和判断。
这就是 Agent 操作 CLI 在阶段之间的具体含义:交接的格式和去向由 CLI 约束,交接的内容由 Agent 产出。全交给 Agent 时缺的正是这一层约束。
State 推进的三条规则
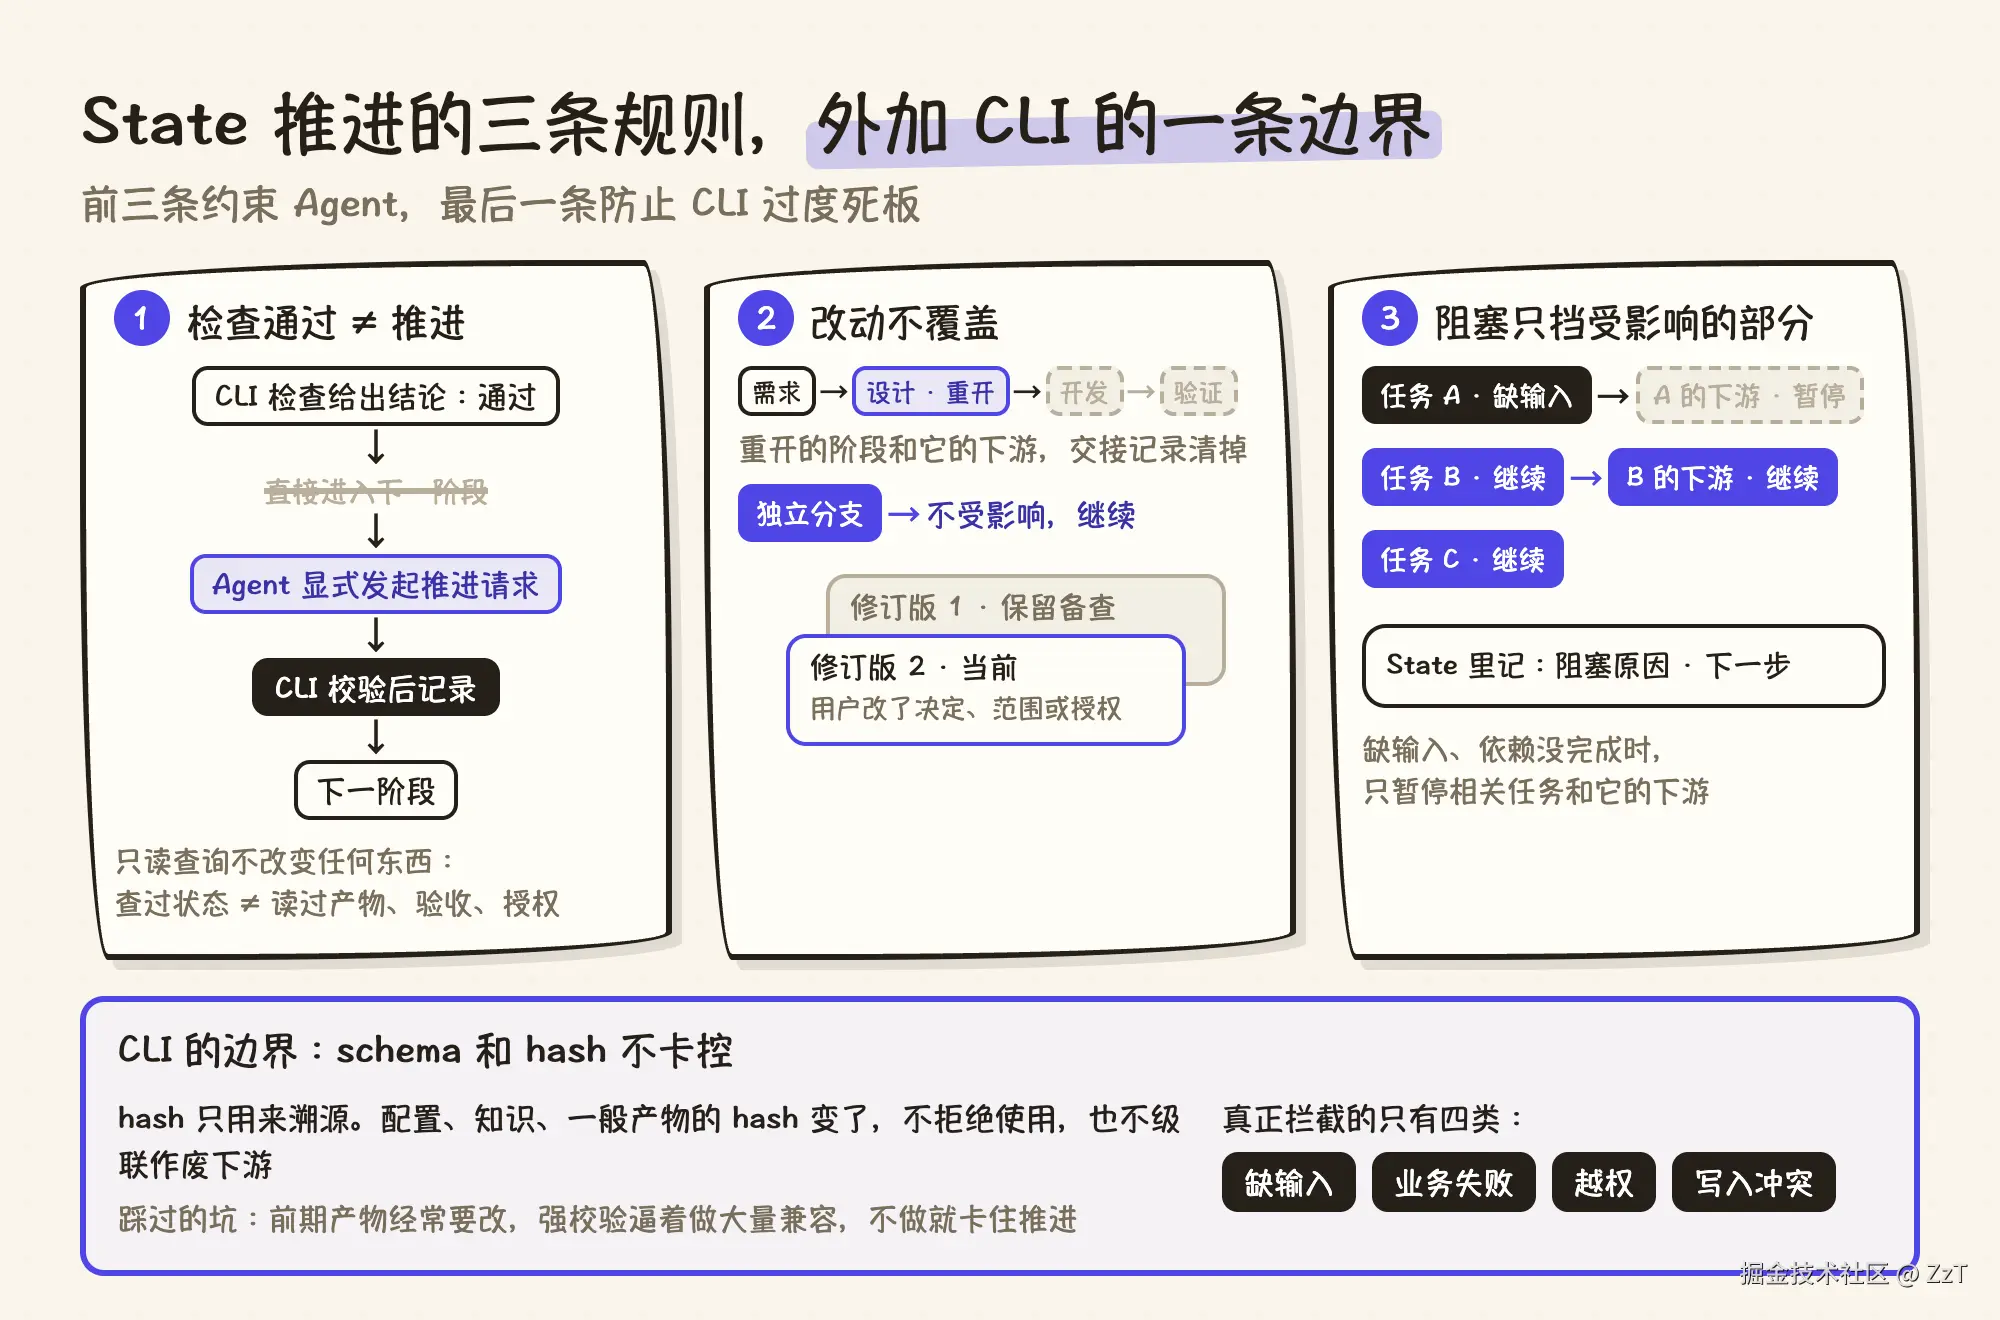
规则一:检查通过不等于状态推进。
CLI 的检查只给出结论。阶段是否往下走,由 Agent 显式发起推进请求,CLI 校验后再记录。
只读查询同样不改变任何东西。查过一次状态,不等于已经读过产物、已经验收,也不等于拿到了授权。
规则二:改动不覆盖。
重开一个阶段时,清掉它自己和依赖它的下游的交接记录,不相关的分支继续。
用户改了决定、范围或授权,开一个新的修订版,旧版本保留备查,不静默改写下游已经用过的事实。
规则三:阻塞只挡受影响的部分。
缺输入、依赖没完成时,暂停相关任务和它的下游,其他独立的工作继续。阻塞写明原因和下一步,记进 State。
这三条约束的是 Agent。CLI 的约束同样要有边界,否则就回到了全交给 CLI 时的死板。
我们在这上面踩过坑:schema 和 hash 做成强校验之后,前期快速迭代时产物不稳定、经常要改,每改一次都要做大量兼容工作,不做就卡住工作流推进。
现在的规则是:
- schema 和 hash 不作为卡控条件,hash 只用来溯源;
- 配置、知识、一般产物的 hash 变了,不拒绝使用,也不级联作废下游结果;
- 真正拦截的只有四类:缺输入、业务失败、越权、写入冲突。
另外,实例启动时会冻结用到的版本和配置,之后恢复按冻结的依据走,不用当前安装的默认值补写。冻结决定按什么做,hash 只回答和当初是不是同一份,两者不冲突。
人在工作流里的六个确认点
人也是串联的一方,但只在影响范围的地方出场。下面六个点,工作流停下来等人确认:
| 确认点 | 发生在 | 人判断什么 |
|---|---|---|
| 流程类型和目标范围 | 开始交付时 | 走完整流程还是快速流程,这次交付做什么、涉及哪些仓库 |
| 需求规格 | 需求阶段结束 | 规格是否准确,确认后才进入设计 |
| 技术方案 | 设计阶段结束 | 方案能否作为开发依据 |
| 写目标仓 | 进入开发前 | 是否授权修改目标仓库 |
| 风险与跳过证据 | 出现时 | 是否接受一个明确的风险,或跳过某项证据 |
| 外部写入 | 交付阶段 | 是否提交、推送、发布,或写入外部系统 |
不问人的事情也写在规则里,由 Agent 自己定:
- 默认走哪条路线;
- 阶段怎么解析;
- 阶段必需的能力;
- 没有歧义的实现细节。
可选的能力先说明价值和影响再问。扩大范围、接受风险、外部写入,每一项单独授权,授权不顺延到下一项。
问的方式沿用上文的会话记录:一次只问一个问题,回答记进实例。之后改主意走修订版,不覆盖已经被下游用过的决定。
压缩和换会话之后的恢复
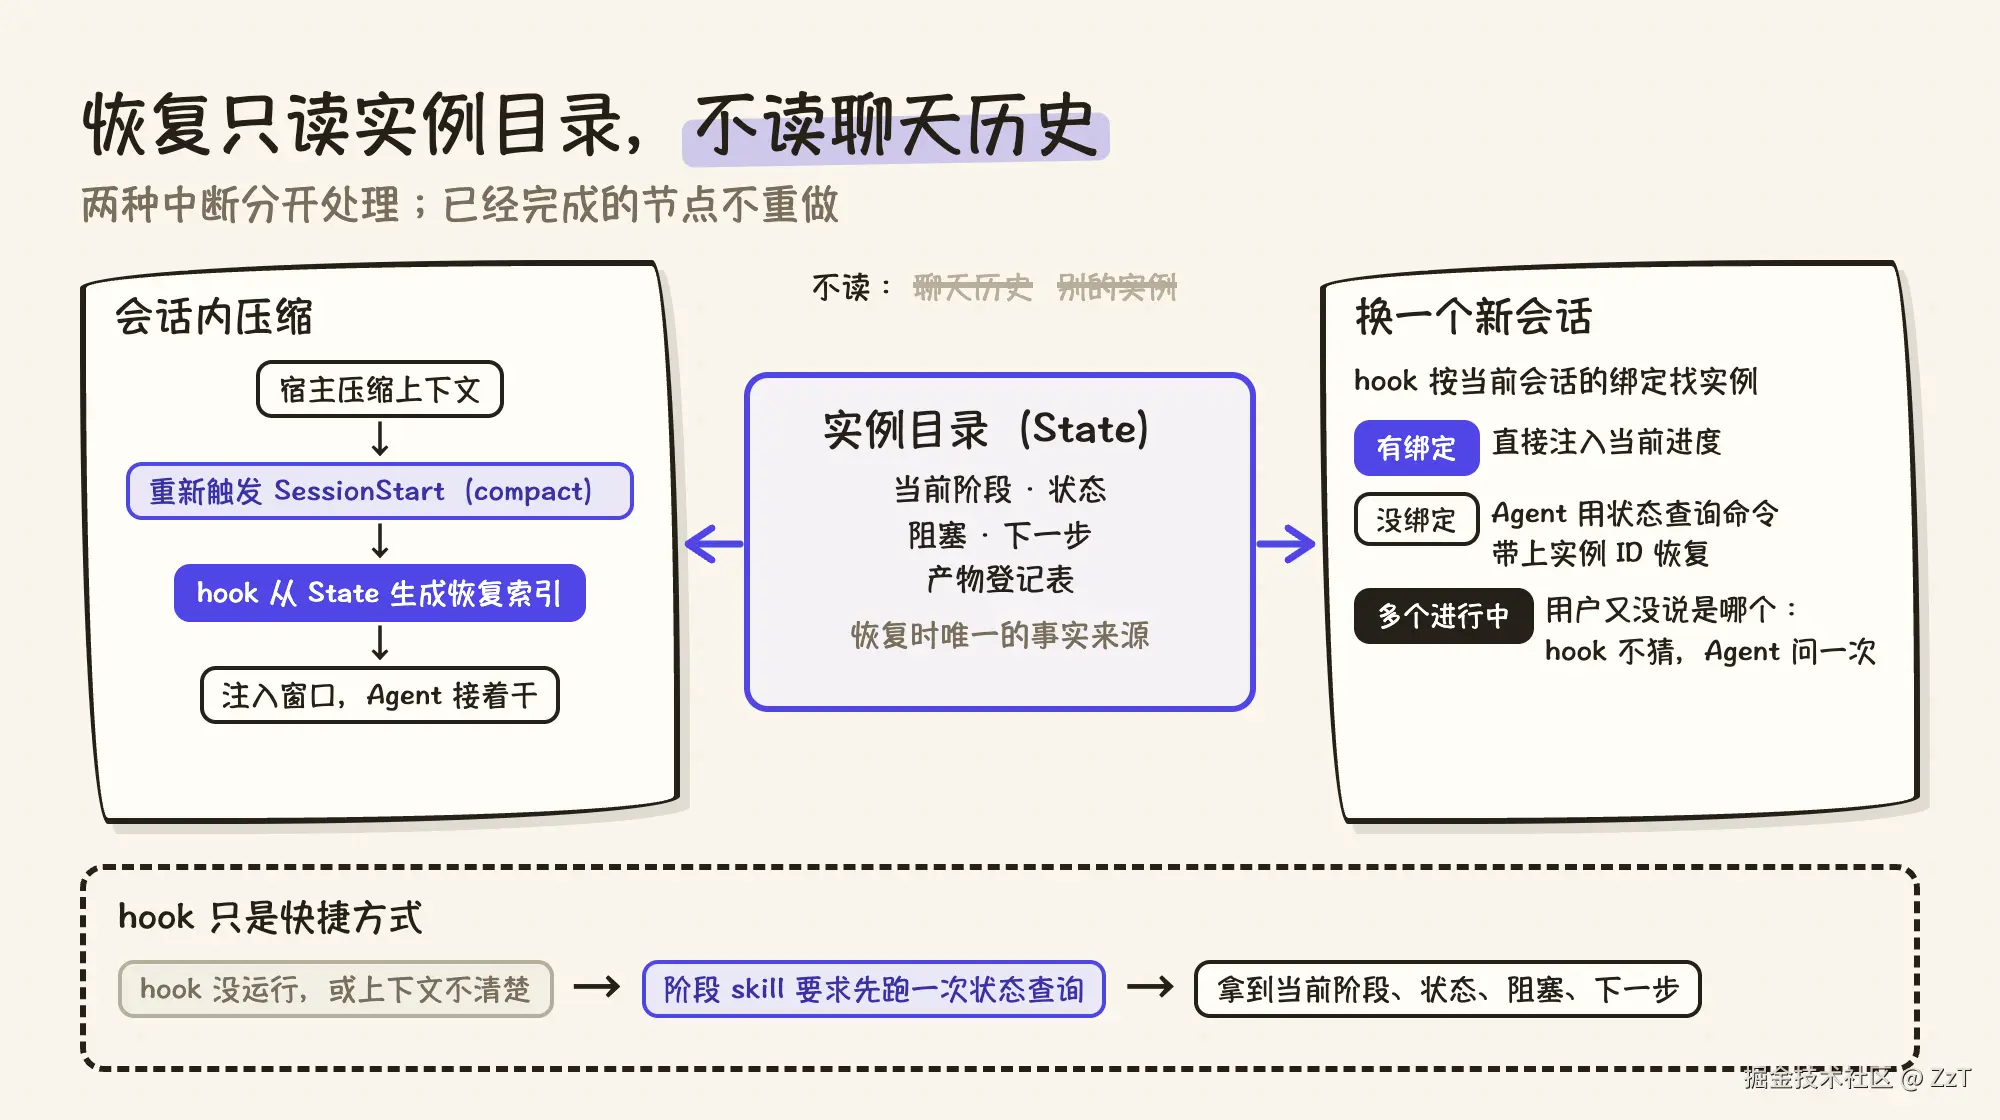
恢复的总原则:只读当前实例目录里的文件,不从聊天历史推断,也不从别的实例借事实;已经完成的节点不重做。
两种中断分开处理。
会话内压缩。 宿主压缩上下文之后,会重新触发会话开始事件,来源标记为 compact。hook 据此从 State 生成一份紧凑的恢复索引注入窗口,内容见下一节。
换一个新会话。 hook 按当前会话的绑定找到对应的实例。新会话还没有绑定时,Agent 用状态查询命令带上实例 ID 恢复。如果有多个进行中的实例,用户又没说是哪一个,hook 不猜,Agent 问用户一次。
不管哪种中断,hook 都只是快捷方式。上下文不清楚时,阶段 skill 要求 Agent 先跑一次状态查询,拿到当前阶段、状态、阻塞和下一步,再决定做什么。hook 没有运行,这条路也走得通。
hook 接在 SessionStart 和 UserPromptSubmit 上
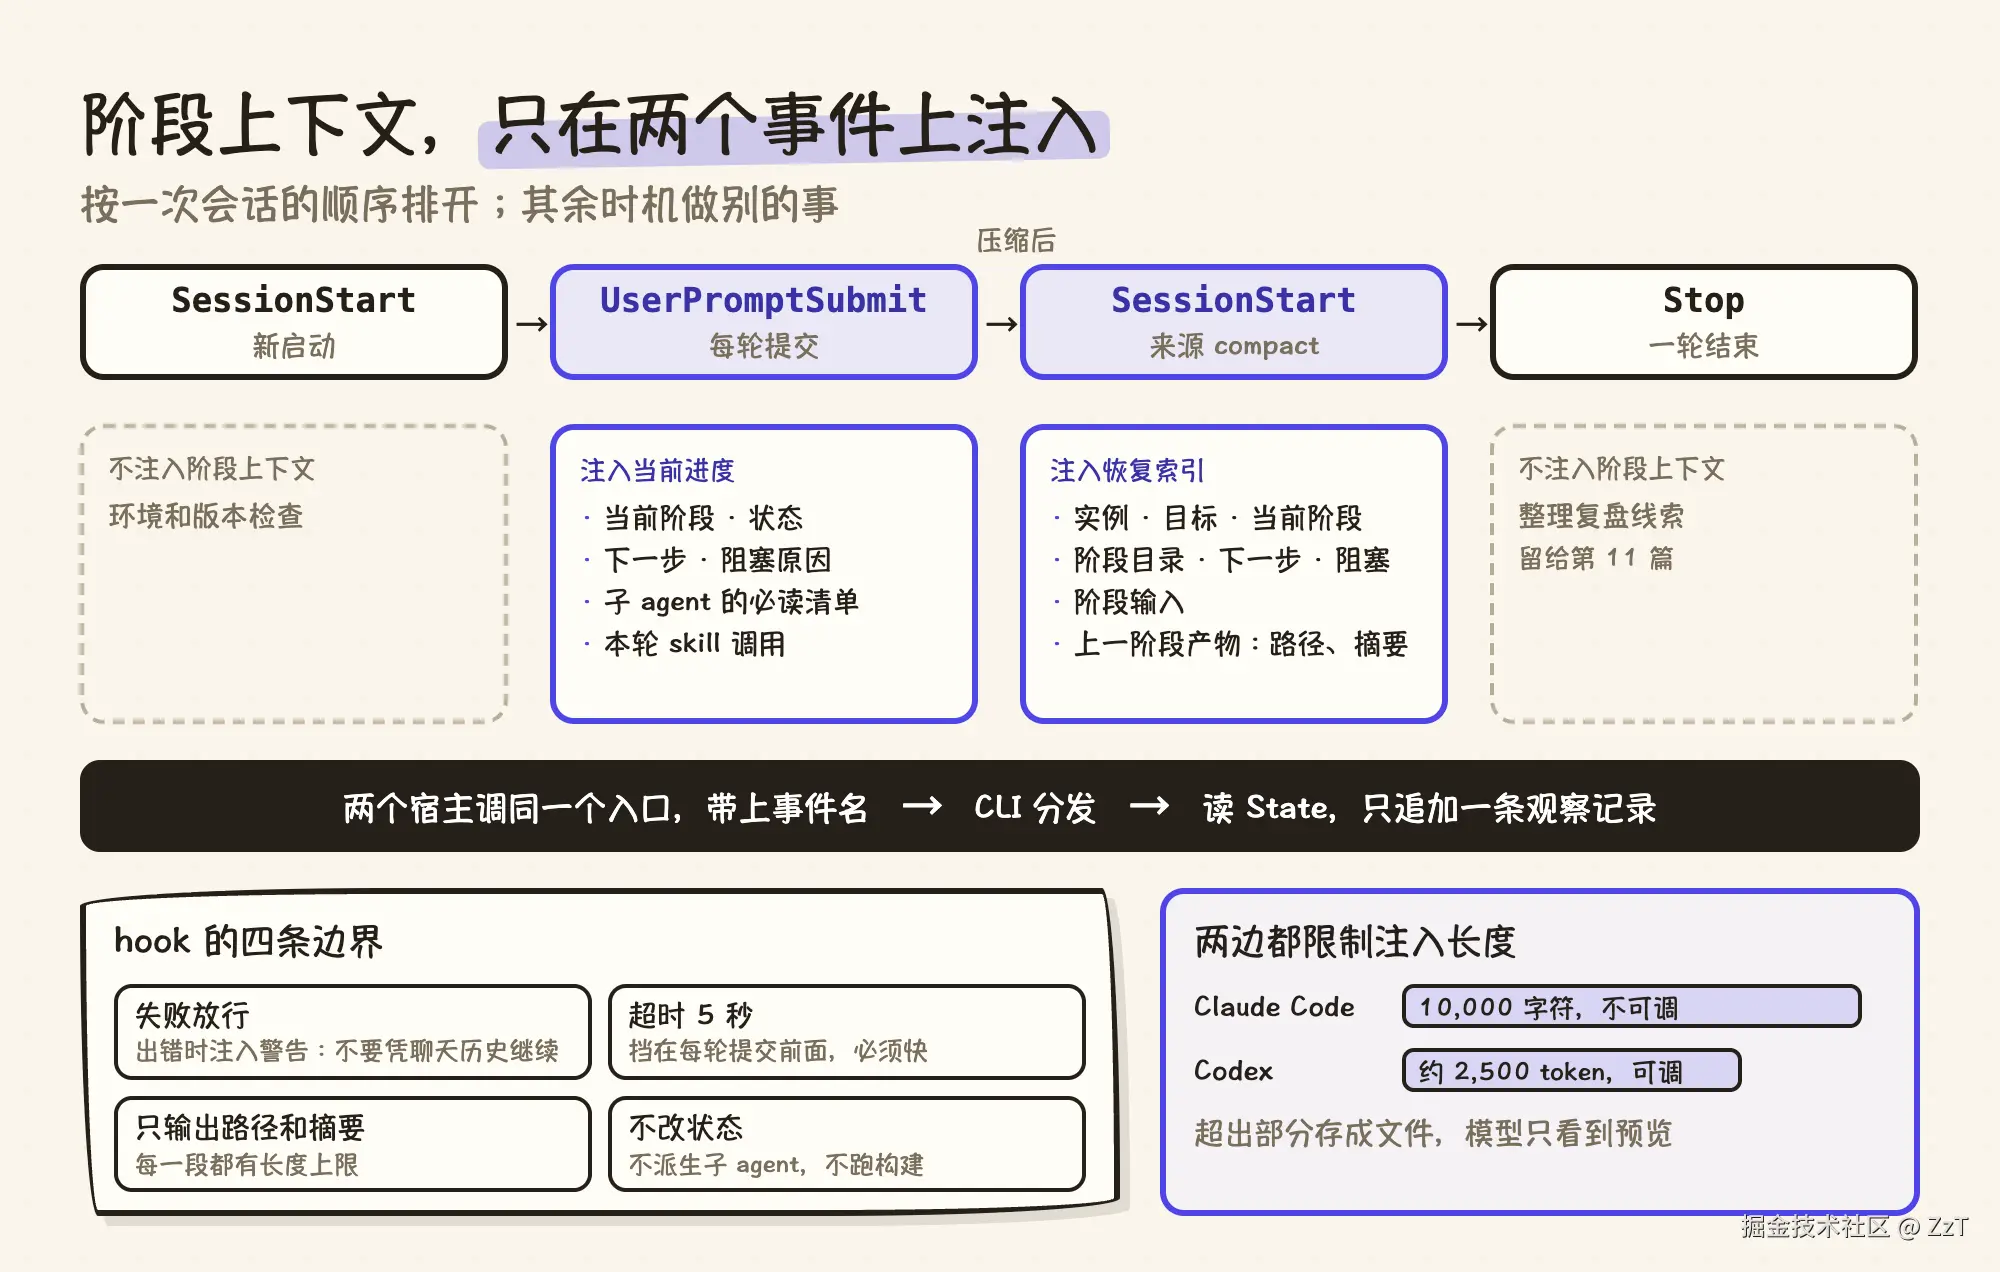
两个宿主的配置里,注入阶段上下文的 hook 调同一个入口,带上事件名,在 CLI 里分发。
和阶段上下文有关的是两个事件:
- SessionStart(
compact来源):注入恢复索引,包括实例、目标、当前阶段、阶段目录、下一步、阻塞原因、阶段输入、上一阶段产物的路径和摘要; - UserPromptSubmit:注入当前阶段、状态、下一步、阻塞原因、子 agent 的必读清单,以及上文讲的本轮 skill 调用。
另外两个时机做别的事:新启动时的 SessionStart 做环境和版本检查,Stop 整理复盘线索,留给第 11 篇。
每轮提交时注入的内容大致如下(裁剪过,中性命名):
text
<workflow-state>
当前阶段:设计
status: active
next_action: 按评审意见修订方案,再提交检查
subagent_readlists: ...
</workflow-state>
<skill-invocation>
phase_skill: design(路径与 hash)
atom_skills: component-reuse, code-search
skill_session: <阶段目录>/<会话记录>
先完整读取并执行阶段 skill,再由它按 skill 图显式调用适用的原子 skill。
</skill-invocation>
hook 的边界有四条:
- 失败放行:命令末尾吞掉错误、恒定正常退出,不依赖宿主的失败默认行为;入口内部出错时注入一段警告,要求 Agent 不要用聊天历史或其他实例的状态继续,先修复绑定或阶段状态;
- 超时短:阶段上下文的 hook 设 5 秒;
- 只输出路径和摘要:每一段都有长度上限;
- 不改状态:不派生子 agent,不跑构建。
长度上限是必需的。两个宿主都限制 hook 注入的长度,超出部分写到文件里,只给模型一个预览:
| Claude Code | Codex | |
|---|---|---|
| 识别压缩后的会话开始 | matcher 写 compact |
matcher 写 compact |
| hook 注入内容上限 | 10,000 字符,超出存文件,给路径和前 2,000 字符预览,不可调 | 默认约 2,500 token,可按 hook 调整,超出存文件,给首尾预览 |
| UserPromptSubmit 默认超时 | 30 秒 | 600 秒 |
| 同一事件的多个 hook | 并行运行 | 并发启动 |
| hook 的信任 | 接受工作区信任之后才运行 | 按 hook 定义的 hash 记录信任,改动后要重新审核 |
恢复索引按段截断,每段上限从几百到三千多字符不等,整体落在两边的上限之内。超出上限时模型只看到预览,索引后半段的内容就不一定能被读到。
回到标题:Agent 操作 CLI
阶段之间由 CLI 串:Workflow 定义顺序和依赖,Phase 定义每个阶段的输入、执行和输出,State 记录进度,检查给出结论。
阶段之内由 Agent 串:阶段 skill 按 skill 图调用原子 skill,Agent 通过 CLI 查询、登记、请求推进。
人在六个点上拍板,hook 在两个事件上提醒。
这个分工两头都有边界。CLI 约束中间产物的格式、去向和推进条件,防止 Agent 过度自由发挥;schema 和 hash 不做卡控,防止 CLI 过度死板。
从第 03 篇开始按阶段逐个展开,第一个是需求理解。