物流组的王姐每月要录两万张运单。字写得潦草的手写地址、被雨水洇过的快递面单、司机发来的手机照片------这些以前全靠她对着屏幕手工补录,一天四个小时。
九月我们试着把这块交给多模态模型做。原以为「拍一张照片就能读出所有字段」是现成能力,结果从第一版到敢把数据直接进 WMS,中间踩了三个坑。这篇按坑的顺序写,每个坑都带改前改后的数据。
一、先说测试集和第一版
测试集是真实生产环境里攒的四千张运单:八百张含手写地址,三百二十张有污损、折痕或反光。字段八个:单号、收件人、电话、省市、区县、详细地址、寄件人、备注。
第一版做法很朴素:把图片 base64 直接丢给视觉模型,提示词写「请识别运单上的所有字段」,要求返回 JSON。
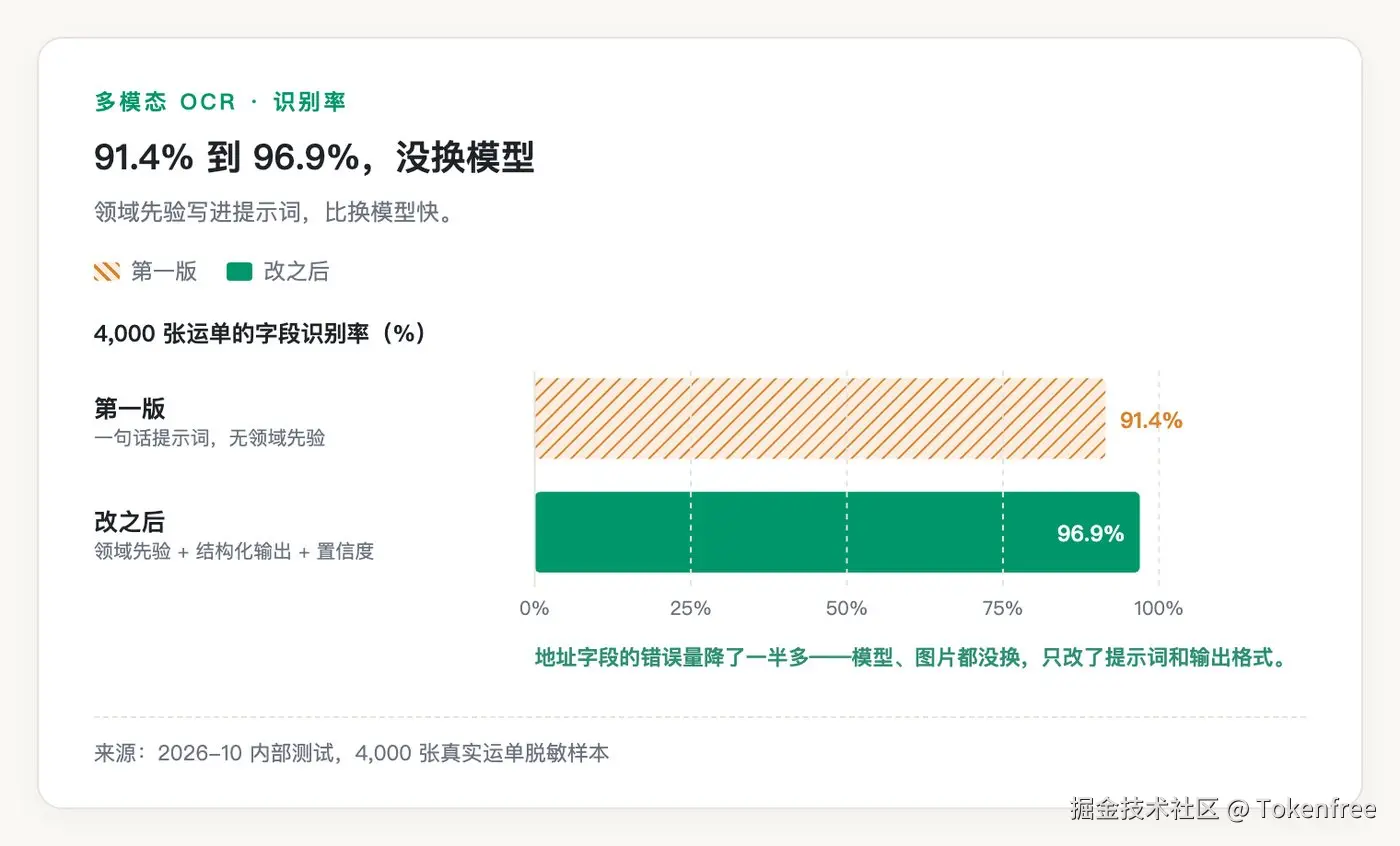
结果:字段识别率 91.4% ,看起来不错,但拆开看问题很大------所有错误里,地址字段占 62% 。而地址恰恰是王姐最不想手打的字段,一长串,错一个字整个包裹就可能送错地方。
二、坑一:通用提示词不认「运单」,手写和污损直接带偏
第一版的提示词只有一句话。模型把运单当成普通文档去读,遇到手写地址就猜,遇到污损就跳过去。
改法不是换更强的模型,而是把「领域先验」写进提示词:
- 告诉模型「这是中国快递运单,地址遵循省市区县逐级结构」;
- 每个字段给允许的格式:电话 11 位数字、单号是字母数字混合、省市必须是行政区划名;
- 加一句「地址字段如果看不清,把能确定的级别写出来,其余留空,不要编」;
- 返回结构化输出:每个字段带
confidence。
json
{
  "单号": {"value": "SF1234567890123", "confidence": 0.98},
  "省市": {"value": "广东省", "confidence": 0.99},
  "详细地址": {"value": "", "confidence": 0.31, "note": "手写且被污损覆盖"}
}
改完整体识别率 91.4% → 96.9% ,地址字段的错误量降了一半多。
这里有个容易忽略的点:大模型 API 调用层我们没换,一直走同一个 OpenAI 兼容入口(词元云,tokenfreeai.com),只改提示词和输出格式。同一个模型、同样的图片,领域先验到位了,识别率就是能上去。
三、坑二:PDF 整页往里丢,多页文件直接超时
第二周接进来的不是图片,是司机手机拍的 PDF------有的是一单一份,有的是十几页塞在一起。
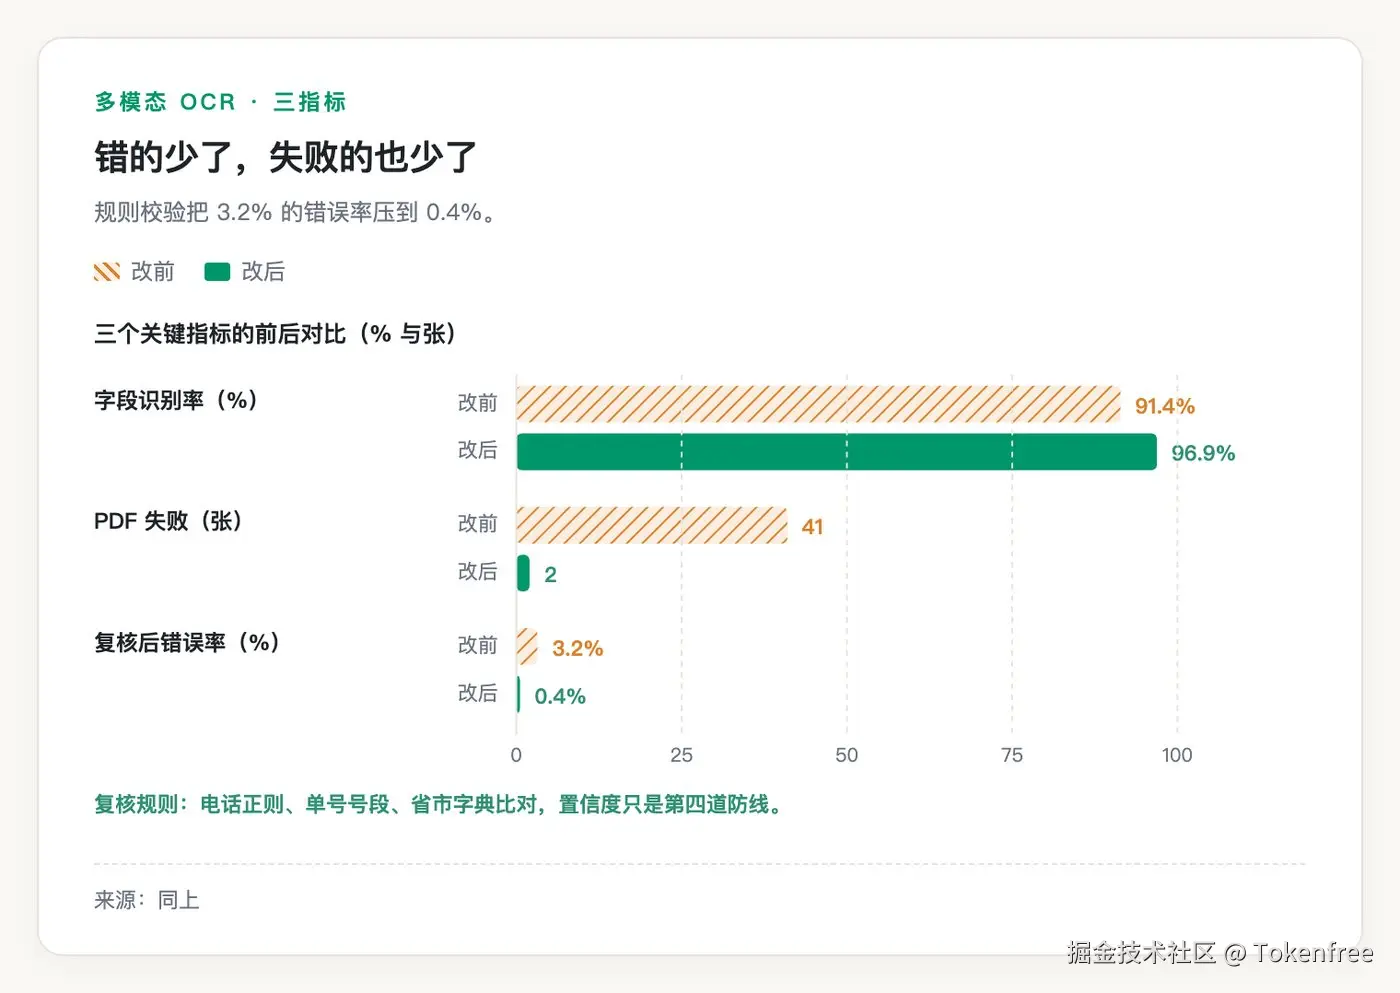
第一版直接把 PDF 文件丢给模型。五百张多页 PDF 里,41 张失败,要么超时,要么返回「文件过大」。原因是整页 PDF 对模型是「一张超长的图」,分辨率被压到看不清,token 还爆掉。
改法三步:
- 服务端先把 PDF 转成 PNG,按页拆开;
- 单页超 2000px 的按比例压缩到 2000px 内(实测 1600px 足够,识别率不掉);
- 每页单独调一次模型,结果按页汇总。
ini
import fitz  # PyMuPDF
def pdf_to_pages(pdf_bytes, max_px=2000):
    doc = fitz.open(stream=pdf_bytes, filetype="pdf")
    pages = []
    for p in doc:
        pix = p.get_pixmap(matrix=fitz.Matrix(2, 2))
        if pix.width > max_px:
            scale = max_px / pix.width
            pix = p.get_pixmap(matrix=fitz.Matrix(scale, scale))
        pages.append(pix.tobytes("png"))
    return pages
改完 500 张 PDF 里失败降到 2 张,而且能定位到具体是哪一页出了问题。
四、坑三:置信度高 ≠ 一定对,0.9 以上的字段照样错
这是最反直觉的一个坑。
我们当时想:既然每个字段都有 confidence,那把置信度低于 0.85 的挑出来人工复核不就行了?
结果抽检发现:置信度 ≥ 0.90 的字段里,仍有 3.2% 是错的。多发生在两种场景------单号里 0 和 O 看混、电话里 1 和 7 手写难分。模型对自己的「猜」很自信,但猜错了。
所以复核规则不能只看置信度,要叠加规则校验:
- 电话字段过一遍正则校验,不是 11 位数字直接进复核;
- 单号按各快递公司的号段规则校验,校验不过进复核;
- 省市字段和行政区划表比对,不在表里进复核;
- 最后才是置信度低于 0.85 的进复核。
四条叠加之后,进复核的比例约 11% ,而复核后的整体字段错误率从 3.2% 降到 0.4% 。
王姐现在不用一天录四小时了,每天只是上午点一遍那 11% 的复核队列,一个多小时。
五、改完之后
四千张运单,字段识别率 96.9%,规则叠加复核后错误率 0.4%。
几条可以直接抄的:
- 领域先验写进提示词,比换模型快;同一次调用里让模型给每个字段标置信度,但要当它是「参考值」,不是「保证值」;
- PDF 先转图拆页,别整页丢;控制单页分辨率,识别率不掉、成本还低;
- 置信度只是第四道防线,前面先上格式校验和字典比对;
- 模型调用层保持 OpenAI 兼容,以后换模型只改
model字段,业务代码不动。