20 个比特能装下多少行情?------实测拆解 Kronos 的 K 线分词器
任何「把 K 线当成一种语言」的模型,第一步都是把连续行情压成离散 token。 Kronos 的做法是用 20 个比特表示一根 K 线。
20 位看起来寒酸------总共约 105 万种组合,而一根 K 线有 6 个数字(开高低收量额)。 我把它彻底拆开测了一遍,三个结论都和直觉相反:
- 码字不是价格刻度(s1 索引与价格的秩相关是 −0.63,负的)
- s1 / s2 不按数据列分工(两者都编码全部 6 列,48% 冗余)
- 加位数没有用(理论精度比实测好 7000 倍,瓶颈在别处)
本文所有数字都可以用仓库里的脚本复现(日线数据,2016--2026,5 只股票)。
1. 机制:20 个只举手不说话的裁判
想象你有个朋友要告诉你某天 K 线长什么样。他不许写数字,只能举 20 张牌,每张牌是「正面」或「反面」。
20 张牌 → 220=1,048,576 种可能。
球面二值化(Binary Spherical Quantization)就是这套举牌规则。整条流水线只有一个动作值得注意:
6 维原始值z-score 6 维编码器 20 维 sign 20 位
规定只有一条:每个裁判只看自己那个数字的正负,不看大小。
bk={+1−1第 k 个数>0第 k 个数≤0
代码里就是 sign() 一个字,没有任何额外数学。
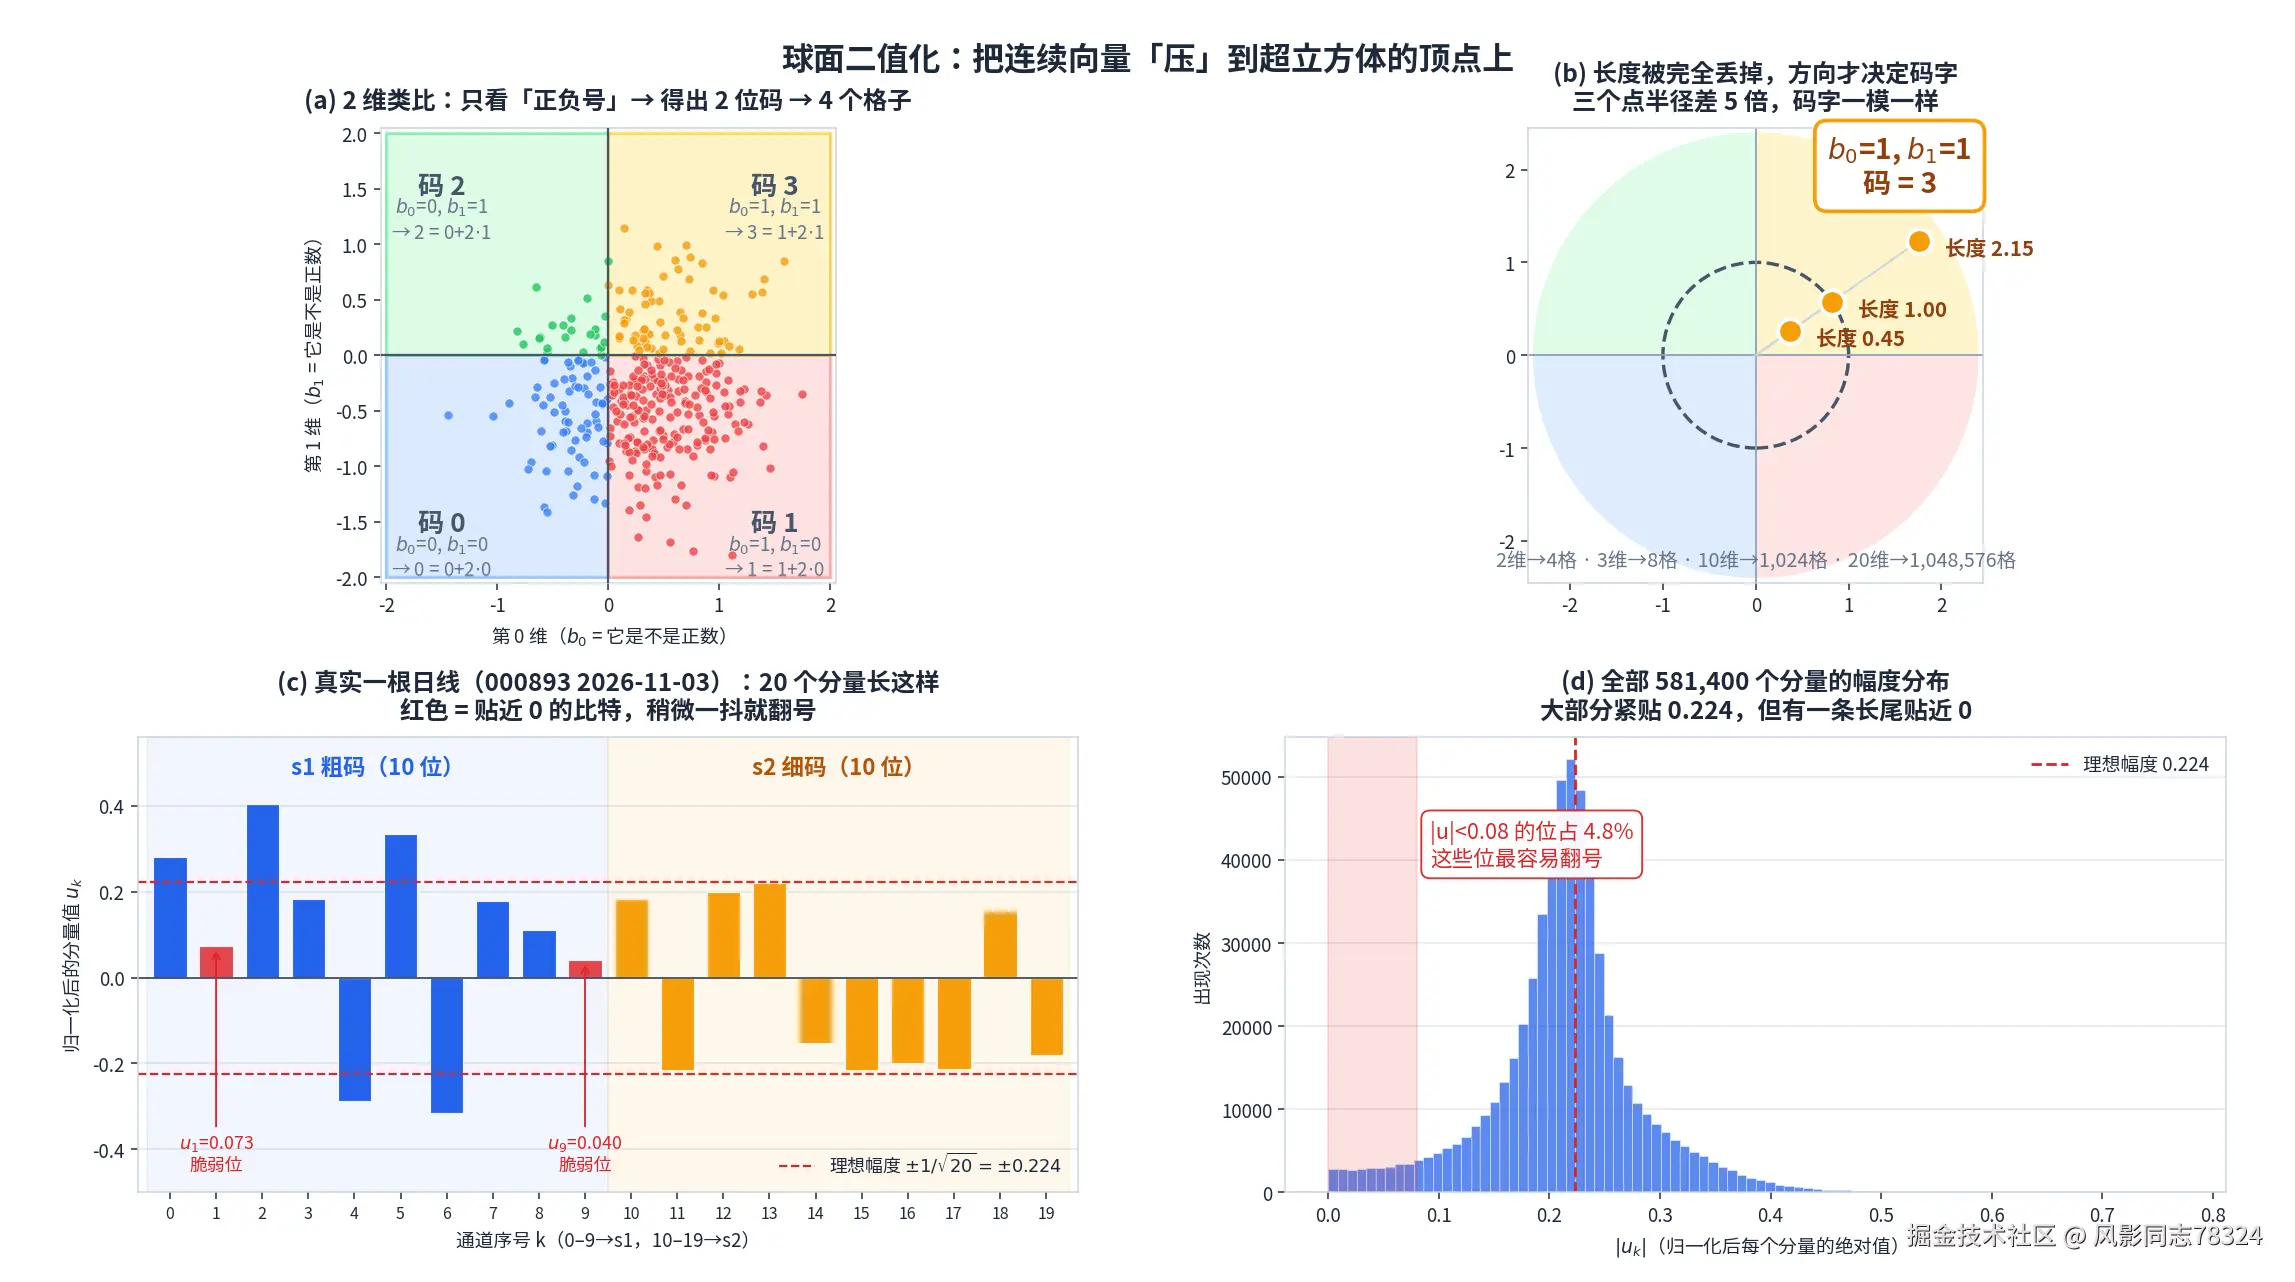
图 1 (a) 二维象限类比 (b) 长度被丢掉 (c) 真实一根日线的 20 个分量 (d) 分量幅度分布
为什么是「角落」
把 20 维缩到 2 维就很好理解:平面被坐标轴切成 4 个象限,每个点落在哪个象限,就对应一个 2 位码。
| 点在哪儿 | 第 0 位 b0 | 第 1 位 b1 | 码 =b0+2b1 |
|---|---|---|---|
| 左下 | 0 | 0 | 0 |
| 右下 | 1 | 0 | 1 |
| 左上 | 0 | 1 | 2 |
| 右上 | 1 | 1 | 3 |
维度升级就是格子数指数增长:
2 维 → 4 格 · 3 维 → 8 格 · 10 维 → 1,024 格 · 20 维 → 1,048,576 格
所谓「球面」,指的是码本住在半径 1 的球内接超立方体的顶点上。但这里有个我实测出来的反直觉点------
「球面归一化」对码字毫无影响
既然是"球面",直觉上会觉得 L2 归一化是在"去掉幅度、只留方向"。但 sign() 本来就尺度无关: 0.5 和 5000 的符号都是 +。
实测:
erlang
encoder 输出 ×1    vs ×100(都归一化)   → 100% 相同
encoder 输出 ×1    vs ×100(都不归一化) → 100% 相同
归一化 vs 不归一化                      → 100% 相同(7290 个位置全等)
归一化对离散码字零影响。 它影响的是训练期的两件事:commit loss 的目标幅度(把每维拉到 1/20 =0.2236 而不是 1.0),以及熵估计的温度尺度。
真正"丢掉量纲"的是前面那步逐窗口 z-score------把价格变成"偏离均值几倍标准差"。这一条是后面所有反直觉结论的根源。
2. 反直觉之一:码字不是价格刻度
我原本的假设
看到「s1 粗码 / s2 细码」这个命名,最自然的理解是:
s1 = 价格的整数部分,s2 = 价格的小数部分
听起来非常合理。但它完全错了。
三条反证
(a) s1 索引与价格的秩相关是负的
在 81 个窗口里算 s1 索引与归一化收盘价的 Spearman 秩相关:均值 −0.629 ,81 个窗口里只有 24.7% 达到 ∣ρ∣>0.7。
如果 s1 是价格分桶,这个数应该是 +1。
(b) 同一个 s1 覆盖 20 元的价格区间
s1=431 出现了 3 次,对应收盘价 73.02 ~ 93.38 元,跨了 20.36 元。
(c) 同一个完整 20 位码覆盖 16% 的价格区间
full=276399 出现了 6 次,收盘从 70.05 到 81.39 元。
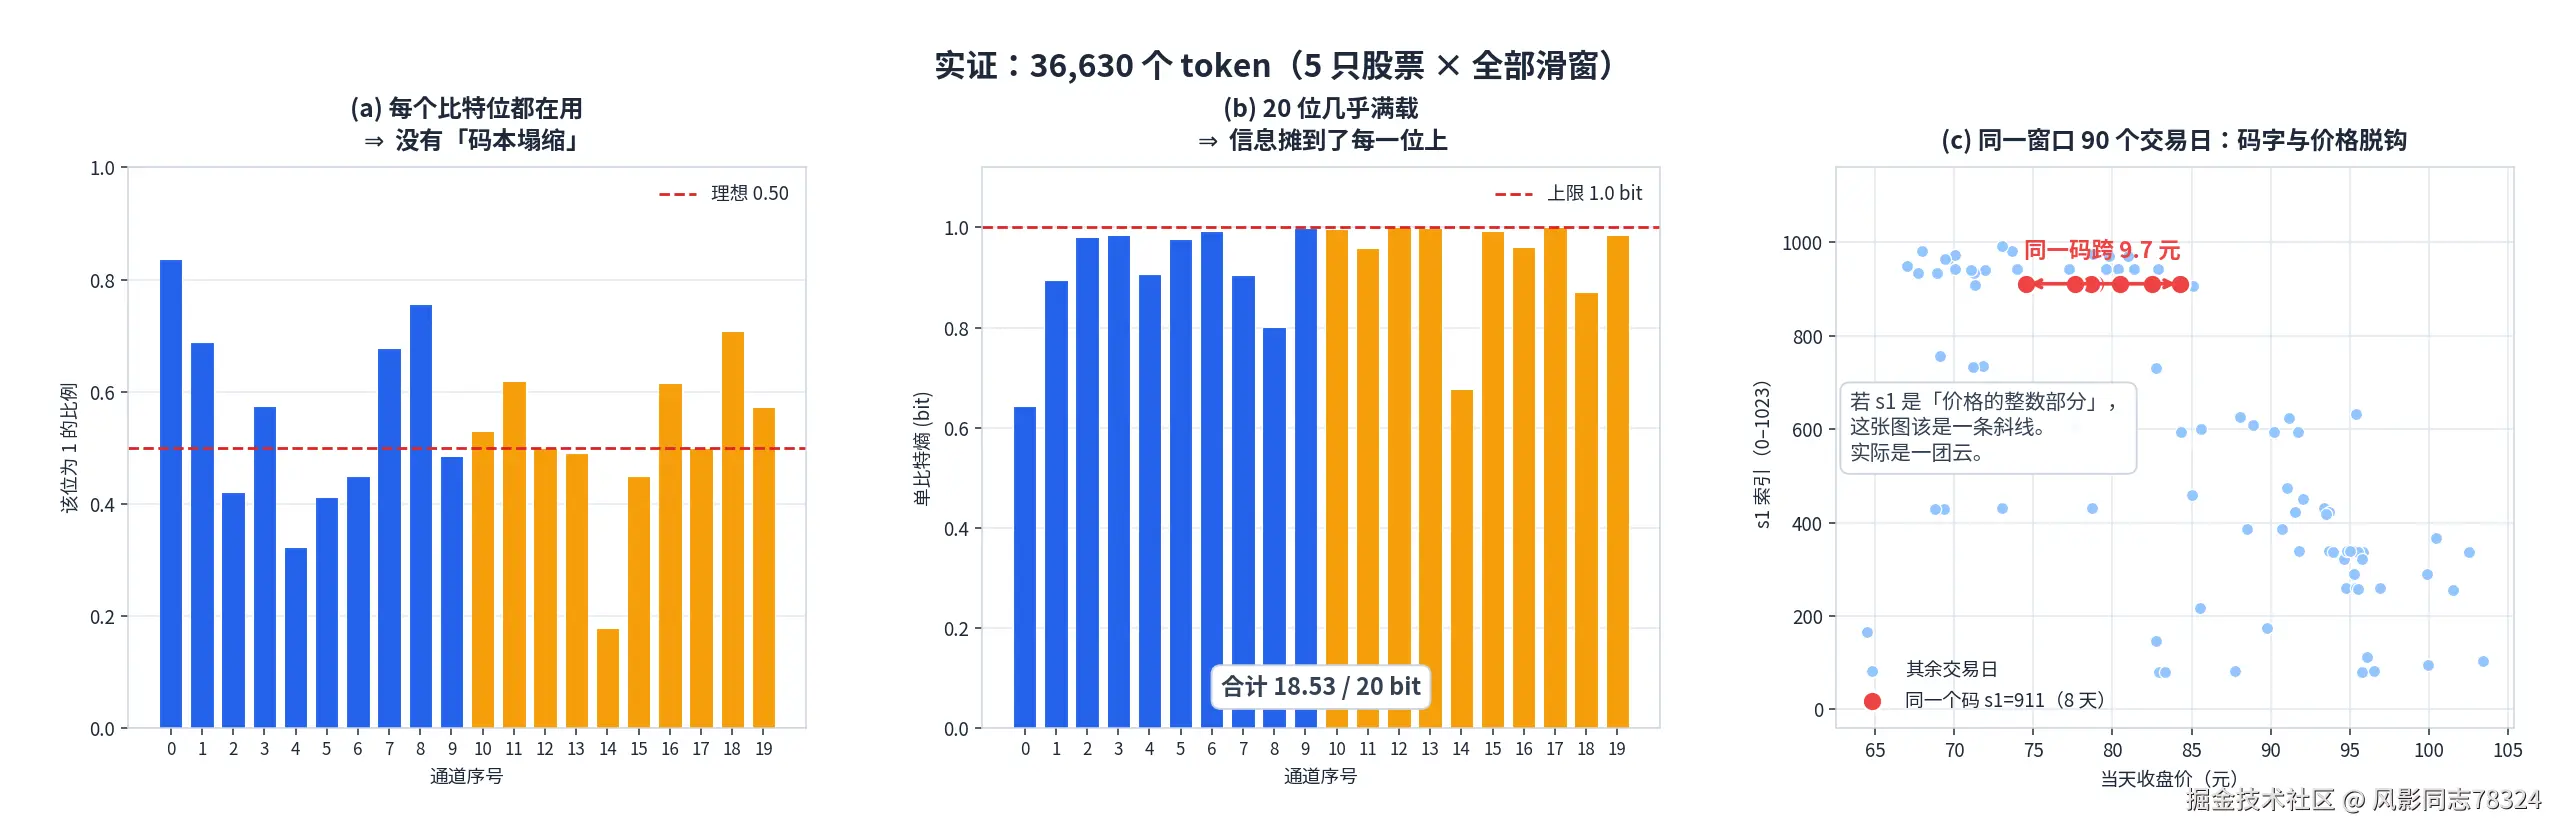
图 2 (a) 每个比特位为 1 的频率 (b) 单比特熵 (c) 同一个窗口里码字与价格脱钩
图 2(c) 是最直观的一张:横轴收盘价,纵轴 s1 索引。如果 s1 是价格分桶,这该是一条斜线;实际是一团乱云。
为什么?因为归一化是逐窗口的
μ、 σ 不是全历史固定值,而是每个 90 日窗口各算一次。后果就是:同一根 K 线的码字取决于它被放进了哪个窗口。
全历史里最极端的一个例子,交易日 2025-09-09,收盘 74.83 元 ,它同时落进了 3 个重叠窗口(回测按 stride=30 滑动),于是被编码了 3 次:
| 所在窗口的最后一天 | 该窗口 μ | 该窗口 σ | 归一化值 | s1 码 |
|---|---|---|---|---|
| 2025-09-10 | 61.36 | 3.77 | +3.576 | 942 |
| 2025-10-30 | 68.14 | 7.83 | +0.854 | 754 |
| 2025-12-11 | 76.15 | 9.59 | −0.137 | 594 |
完全相同的 6 个原始数字,三种归一化结果,三个不同的码。
- 在第一个窗口里它是「比均值高 3.58 个标准差」→ 暴力突破
- 在第三个窗口里它是「比均值低 0.14 个标准差」→ 什么都没发生
同一根 K 线,一个窗口说它炸了,另一个说它平淡。区别全在 μ,σ。
放大到全样本:把收盘价在 68~72 元之间的所有记录取出来------
152 个「同样价格」的样本,散落在 74 个不同的 s1 码上。
这不是缺陷,是设计
模型学的是「相对位置」,不是「绝对价位」。70 元在牛市顶部和熊市底部含义完全相反,绝对价格对预测没有信息量。
代价也很实在:
- 没法用码字反推价格
- 不能跨窗口比较码字------同一个码在两段行情里可能完全不同意思
- 回测时如果
stride < lookback(窗口重叠),同一个交易日的预测会略有差异。这不是随机性,是归一化参数的确定性差异
所以真正的翻译官不是码字本身,而是后面那个 post_quant_embed 线性层加解码器------它还能看前后 90 根 K 线的上下文,所以同一个码在不同上下文里能解出不同价格。
3. 反直觉之二:s1 / s2 不按数据列分工
又一个自然的假设
既然一根 K 线有 6 个数,那 20 位怎么分配?自然想法是:有些位管价格、有些位管成交量。
实测:没有这样的分工。
把 s1、s2 各切成 32 个等频箱(消除"组数不同"的偏差),看它们各自能解释某一列多少方差( η2,5 只股票、36,630 个 token):
| 列 | s1 | s2 | 联合 | 更强 |
|---|---|---|---|---|
| 开盘 | 0.420 | 0.613 | 0.703 | s2 |
| 最高 | 0.480 | 0.678 | 0.788 | s2 |
| 最低 | 0.450 | 0.674 | 0.780 | s2 |
| 收盘 | 0.491 | 0.707 | 0.830 | s2 |
| 成交量 | 0.656 | 0.595 | 0.855 | s1 |
| 成交额 | 0.639 | 0.598 | 0.851 | s1 |
两半都沾所有列 ,只是偏向不同:价格信息 s2 稍强,量额信息 s1 稍强。这个偏向很稳健------换 16/32/64 三种分箱数结论都不变,逐股票看股价四列 5/5 都是 s2 更强 、成交量 5/5 都是 s1 更强。
它们有多冗余
| 指标 | 值 |
|---|---|
| H(s1) | 4.740 bit(上限 5) |
| H(s2) | 4.246 bit |
| I(s1;s2) | 2.033 bit |
| 冗余度 | 47.9% |
约 52% 的信息互不重复。 所以 s1/s2 既不是「同一信号的粗版和细版」,也不是「各自负责几列」,而是一次 20 维旋转里被切开的两半。
为什么价格归 s2、量额归 s1
一个可能的解释在自相关:
| 列 | 归一化后 1 阶自相关 |
|---|---|
| 开盘 / 最高 / 最低 / 收盘 | 0.934 / 0.947 / 0.946 / 0.941 |
| 成交量 / 成交额 | 0.590 / 0.620 |
价格是平滑序列(自相关 0.93+),好猜 ------解码器看前后几根就能补出来;量额跳动大,难猜------必须由 token 本身携带。而 s1 携带得更多。
同一个道理也解释了重建误差的反差:
| 列 | s1 单独 R² | 全码 R² | s1 相对误差 | 全码相对误差 |
|---|---|---|---|---|
| 收盘 | 0.99965 | 0.99981 | 0.778% | 0.586% |
| 成交量 | 0.99172 | 0.99501 | 8.522% | 6.737% |
| 成交额 | 0.99133 | 0.99409 | 10.023% | 8.338% |
s1 单独就能把收盘价重建到 R²=0.99965(借上下文),但量额误差是价格的 10 倍以上(只能靠那 10 个比特硬扛)。
一个值得注意的副产品
用原始 s1/s2 索引算各衍生特征的解释力:
| 特征 | s1 | s2 |
|---|---|---|
| 量比 | 0.572 | 0.537 |
| 振幅 | 0.338 | 0.284 |
| 距 20 日均线 | 0.318 | 0.314 |
| 涨跌幅 | 0.195 | 0.220 |
量比是解释力最高的特征(0.57),比涨跌幅(0.20)高得多。 这个码对"今天放量还是缩量"的刻画,比对"今天涨还是跌"强得多。
4. 那为什么还要拆成两段
如果两半都编码全部信息,拆的意义是什么?答案在第二阶段的语言模型,不在分词器。
分词器用的是 20 维线性层,不查表。但语言模型需要词表 。以 Kronos-base( d=832)为例:
| 组成部分 | 拆成 s1+s2 | 不拆(20 bit 单表) |
|---|---|---|
| 输入嵌入 | 2×1024×832=1,703,936 | 1,048,576×832=872,415,232 |
| 融合层 | 1664×832+832=1,385,280 | --- |
| 双头输出 | 2×(832×1024+1024)=1,705,984 | 2×832×1,048,576=1,744,830,464 |
| 合计 | 4,795,200(占 base 的 4.69%) | ≈1.745B |
省掉 99.73% 的词表参数。
代价是每根 K 线要 2 次自回归------而且是有因果依赖的两次:
python
s1_logits = self.head(x)                              # 先预测 s1(无条件)
sibling_embed = self.embedding.emb_s1(sample_s1_ids)  # 采样出的 s1
x2 = self.dep_layer(x, sibling_embed)                 # cross-attention 看 s1
s2_logits = self.head.cond_forward(x2)                # 再预测 s2(条件于 s1)
horizon=10 天 → 20 步自回归。这是「4.8M 参数 vs 1.745B 参数」换来的。
5. 反直觉之三:加位数没有用
这是最值得记住的一条。
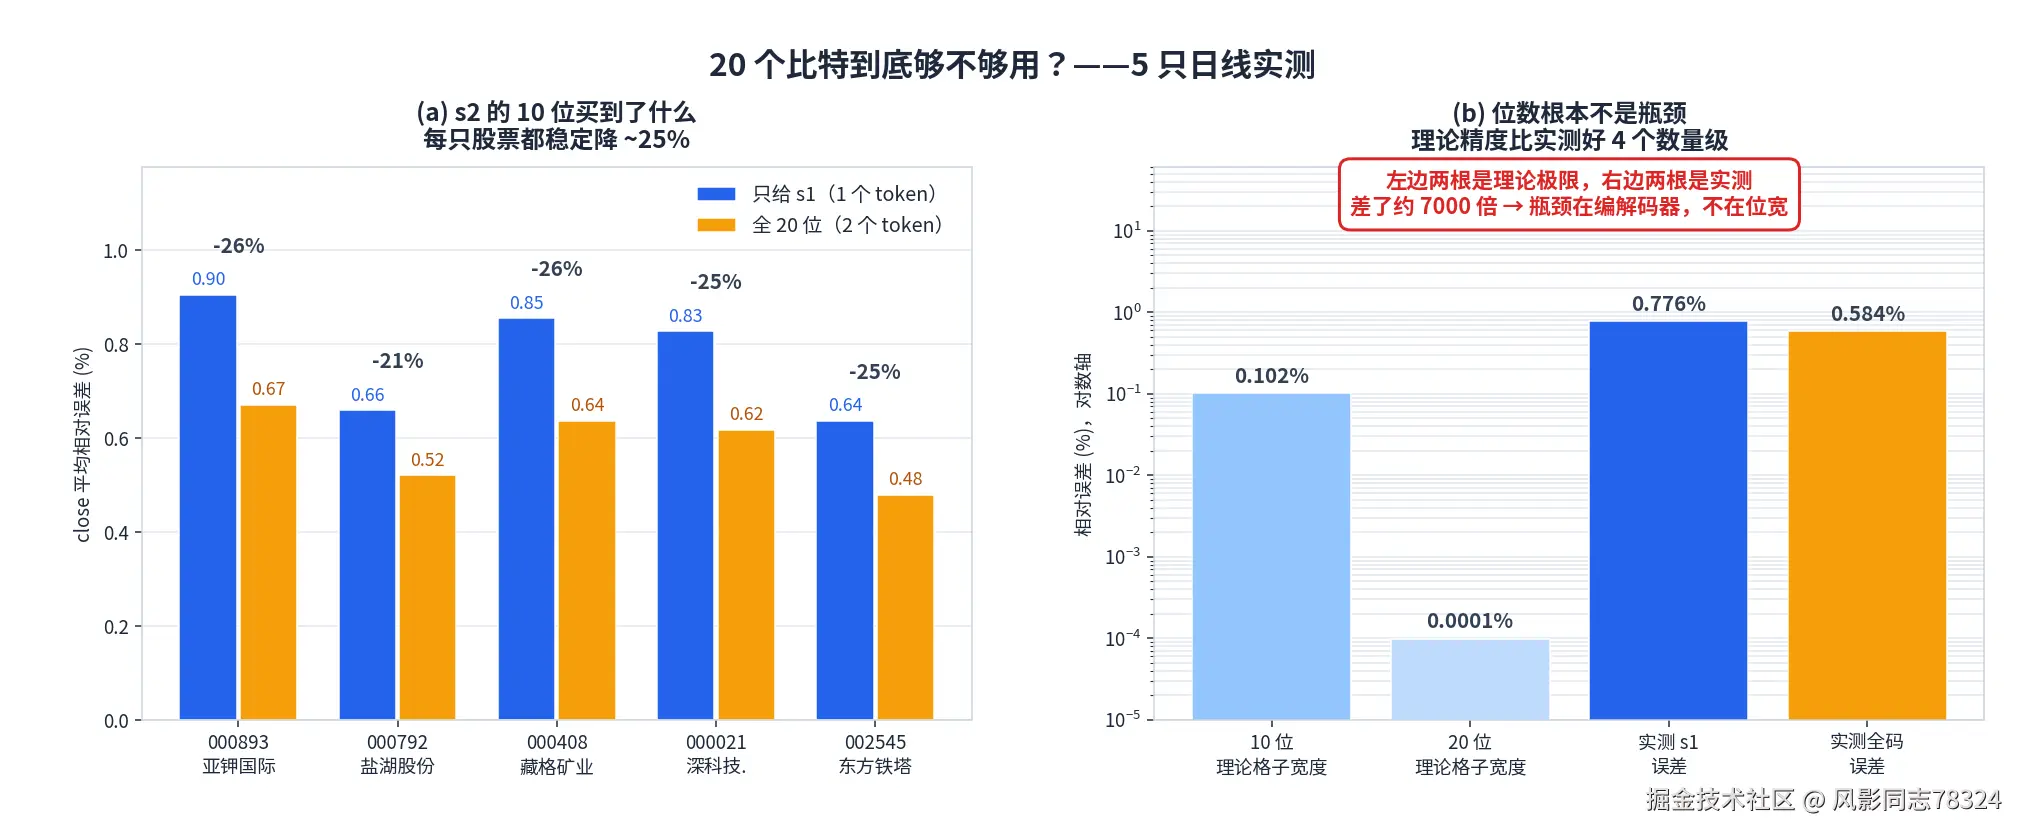
图 3 (a) s1 单独 vs 全 20 位的 close 重建误差 (b) 理论格子宽度 vs 实测误差(对数轴)
10 位 = 1024 格,覆盖 ±5σ(共 10σ):
每格宽度=102410σ=0.00977σ
折算成钱随波动放大,但相对精度稳定在 0.06%~0.22%:
| 股票 | 90 日 close 1σ | 每格折合 | 相对精度 |
|---|---|---|---|
| 000893 亚钾国际 | 10.36 元 | 0.101 元 | 0.120% |
| 000792 盐湖股份 | 16.33 元 | 0.160 元 | 0.081% |
| 000408 藏格矿业 | 38.19 元 | 0.373 元 | 0.059% |
| 000021 深科技 | 113.26 元 | 1.106 元 | 0.215% |
| 002545 东方铁塔 | 9.76 元 | 0.095 元 | 0.112% |
那如果加到 20 位呢?理论精度应该到 0.0001%。但实测只有 0.58%:
| 相对误差 | |
|---|---|
| 10 位理论格子宽度 | 0.102% |
| 20 位理论格子宽度 | 0.0001% |
| 实测 s1 误差 | 0.776% |
| 实测全码误差 | 0.584% |
理论精度比实测好约 7000 倍。
真正的瓶颈不是位宽,而是那个 3.96M 参数的小 Transformer------它要用 20 个数同时重建 O/H/L/C/V/A 六列。 再加比特只会让词表膨胀回 B 级参数,收益极低。
所以 s2 那 10 位只买到 21%~26% 的误差下降(5 只股票全部一致),而不是 1000 倍的精度提升。
6. 一根日线的完整流水线
把前面的公式压缩成一条线。算例:000893 亚钾国际,2026-11-03,收盘 70.05 元,窗口是前 90 个交易日。
| 步骤 | 输入 | 输出 | 关键数字 |
|---|---|---|---|
| ① z-score + clip | 收盘 70.05 | −1.382071 | μ=84.3722, σ=10.3629 |
| ② 编码器 | 6 维 × 90 根 | 20 维 | ∥z^∥=57,348.09 |
| ③ L2 归一化 | z^ | u, ∥u∥=1 | 每维幅度 ≈ ±0.2236 |
| ④ sign + ÷√20 | u | c=±0.223607 | 幅度全丢,只剩符号 |
| ⑤ 拆 s1/s2 | 前 10 / 后 10 位 | s1=943, s2=269 | S=943+1024×269=276,399 |
| ⑥ 解码 + 反归一化 | c | 70.6059 元 | 误差 0.79% |
第 ④ 步的逐位展开(这是最容易搞混的地方):
ini
k  :  0  1  2  3  4  5  6  7  8  9 | 10 11 12 13 14 15 16 17 18 19
u  : .281 .073 .405 .182 -.286 .335 -.316 .179 .111 .040 | .182 -.214 .199 .221 -.152 -.216 -.199 -.213 .156 -.180
b  : +1 +1 +1 +1 -1 +1 -1 +1 +1 +1 | +1 -1 +1 +1 -1 -1 -1 -1 +1 -1

s1 = 1·1 + 1·2 + 1·4 + 1·8 + 0·16 + 1·32 + 0·64 + 1·128 + 1·256 + 1·512 = 943
s2 = 1·1 + 0·2 + 1·4 + 1·8 + 0·16 + 0·32 + 0·64 + 0·128 + 1·256 + 0·512 = 269
位序:s1 是低 10 位,s2 是高 10 位。 依据是
bits_to_indices和indices_to_bits都用2 ** arange(0, 20),通道 0 对应 20。 很多二手资料把这个写反了。
验证:276399 & 1023 = 943 ✓ 276399 >> 10 = 269 ✓
7. 三个工程坑
坑一:码字与价格的秩相关是负的
见第 2 节。不要试图用码字反推价格,也不要跨窗口比较码字。想拿价格就用解码器,它带上下文。
坑二:4.85% 的比特在「掷硬币」
归一化后 ∣uk∣ 接近 0 的分量就是脆弱比特 ------编码器稍微一抖就翻号。全样本 732,600 个分量里,4.85% 落在 ∣u∣<0.08(理论幅度应该是 0.224)。
这带来量化噪声:单根日线约 0.6% 的相对误差。
坑三:clip 该留,「过滤量能尖峰」不该做
clip 把归一化值截断到 ±5σ。全样本触发率只有 0.075%,而且高度集中在量能两列:
| 列 | 触发比例 | 最大偏离 |
|---|---|---|
| 收盘 / 最低 | 0.000% | 4.6 ~ 4.8σ |
| 开盘 / 最高 | 0.011% / 0.005% | 5.7σ / 5.4σ |
| 成交量 / 成交额 | 0.213% / 0.221% | 7.5σ / 7.8σ |
它的作用不是"过滤",而是限制数值范围 :一个 +7.82σ 的成交额如果不截断,会让 encoder 的 20 个输出通道整体偏移,污染同一窗口里其余 89 天的编码;截断后那根 K 线照样参与预测。
但别把它理解成"该过滤量能尖峰"。实测反过来了:
| 量能分组 | 截面 IC | 趋势准确率 |
|---|---|---|
| Q1 缩量 | 0.0362 | 53.2% |
| Q5 放量 | 0.0701 | 54.9% |
放量日模型最准,IC 是缩量日的两倍。 缩量日基本是噪声(没人参与、零星撮合);放量才意味着信息进入市场。
真正该过滤的不是尖峰,是坏数据------比如后复权算出负价格的股票(我在实测中就碰到一只,它一个人把组合 alpha 的 t 值从 2.07 压到了 1.71)。
8. 这些发现对建模意味着什么
① 0.6% 的量化噪声是个隐性上限。 日线 IC 常在 0.05 量级,而 tokenizer 自带 0.6% 的重建误差------这也是为什么之前发现「把预测截断到 ±1 反而 IC 更高」:幅度信息是负价值的,方向排序才是有效的。
② 别指望加位宽。 20 位已经是 0.58%,瓶颈在 3.96M 的编解码器。要提精度,得改架构(比如给量额单独一个头),而不是加比特。
③ horizon 别拉太长。 每根 K 线 2 步,horizon=10 就是 20 步,误差会累积。超过 20 天基本没有实用价值。
④ 别把「量能大」当噪声剔掉。 这是流动性、信息量的代理变量,是模型最有效的状态。
9. 一句话总结
球面二值化 = 把连续向量按「方向」压到超立方体的顶点上,用顶点编号当 token。
它保证码本不被浪费(符号天然均匀,20 位实测熵 18.53/20 bit), 但它不保证码字有意义------位序是学出来的旋转,和价格的数值顺序无关。
真正把码翻译回行情的是解码器,而解码器一半靠码、一半靠上下文。
这三个反直觉其实指向同一件事:这套设计的重点是"让第二阶段的语言模型能高效工作",而不是"让人能读懂码字"。
复现
bash
# 三张图 → figures/bsq/
.venv/bin/python scripts/plot_bsq_intuition.py

# 位使用率 / 熵 / 误差 / R²
.venv/bin/python scripts/analyze_coarse_fine.py --lookback 90

# 归一化账、20 维 vs 6 列相关矩阵、同 bar 多窗口
.venv/bin/python scripts/analyze_code_semantics.py

# s1 / s2 分别关联哪些数据
.venv/bin/python scripts/analyze_s1_s2.py数据依赖:data/finetune_10y_hfq/*.csv(十年日线)+ pretrained/Kronos-Tokenizer-base。
更详细的版本 (逐步代入数字的公式推导、完整相关矩阵、位序不一致清单)见
bsq_explained.md。本文是它的叙事版。
附:几个对照数
| 项目 | 数值 |
|---|---|
| 20 位总熵 | 18.53 / 20 bit |
| 单比特熵 | 均值 0.9265,范围 0.642 ~ 1.000 |
| 位为 1 的频率 | 0.18 ~ 0.84(全部通着,无塌缩) |
| distinct s1 用掉 | 401 / 1024(39.2%) |
| distinct s2 用掉 | 195 / 1024(19.0%) |
| distinct 20 位用掉 | 1,301 / 1,048,576 |
| 脆弱比特( ∣u∣<0.08) | 4.85% |
| 价格重建相对误差 | 0.78% ~ 0.95%(s1)/ 0.59% ~ 0.79%(全码) |
| 量额重建相对误差 | 8.5% ~ 10.0%(s1)/ 6.7% ~ 8.3%(全码) |
| 词表参数(base) | 4.80M(拆)vs 1.745B(不拆) |