千问做了 96 道数学题,答对 11 道。剩下的 85 份答卷有个奇怪的共同点。每一份都写满了 32,768 个 token,直到系统截断输出。翻到答卷末尾,经常能看见同一段推理来回出现。光看分数,很难猜到这个小模型竟然花了这么多篇幅琢磨已经算过的事。诊断记录
这是 MIT CSAIL 团队做的一项实验。他们把开着思考模式的 Qwen3.5-0.8B 交给 GPT-6 Astra,让它直接改千问的权重,看能不能提高数学成绩。0.8B,也就是大约 8 亿个参数。面对这 85 份没写完的答卷,Astra 想先看看,千问反复想同一步的时候,里面究竟是哪部分在起作用。
它选了一道算工资的题,给同一道题写了两种后续。一个人周一工作 10 小时,周二 8 小时,还剩 20 小时要干,每小时挣 20 美元。两段都算出了总工时是 38 小时。一段接着算出工资是 760 美元,还换了个算法核对,200 加 160 再加 400,也是 760。另一段却在 38 小时这里停了下来。那 20 小时是总工时吗?是剩下的工时。过了一句,它又问,20 小时是总工时吗?实验里的两段原文
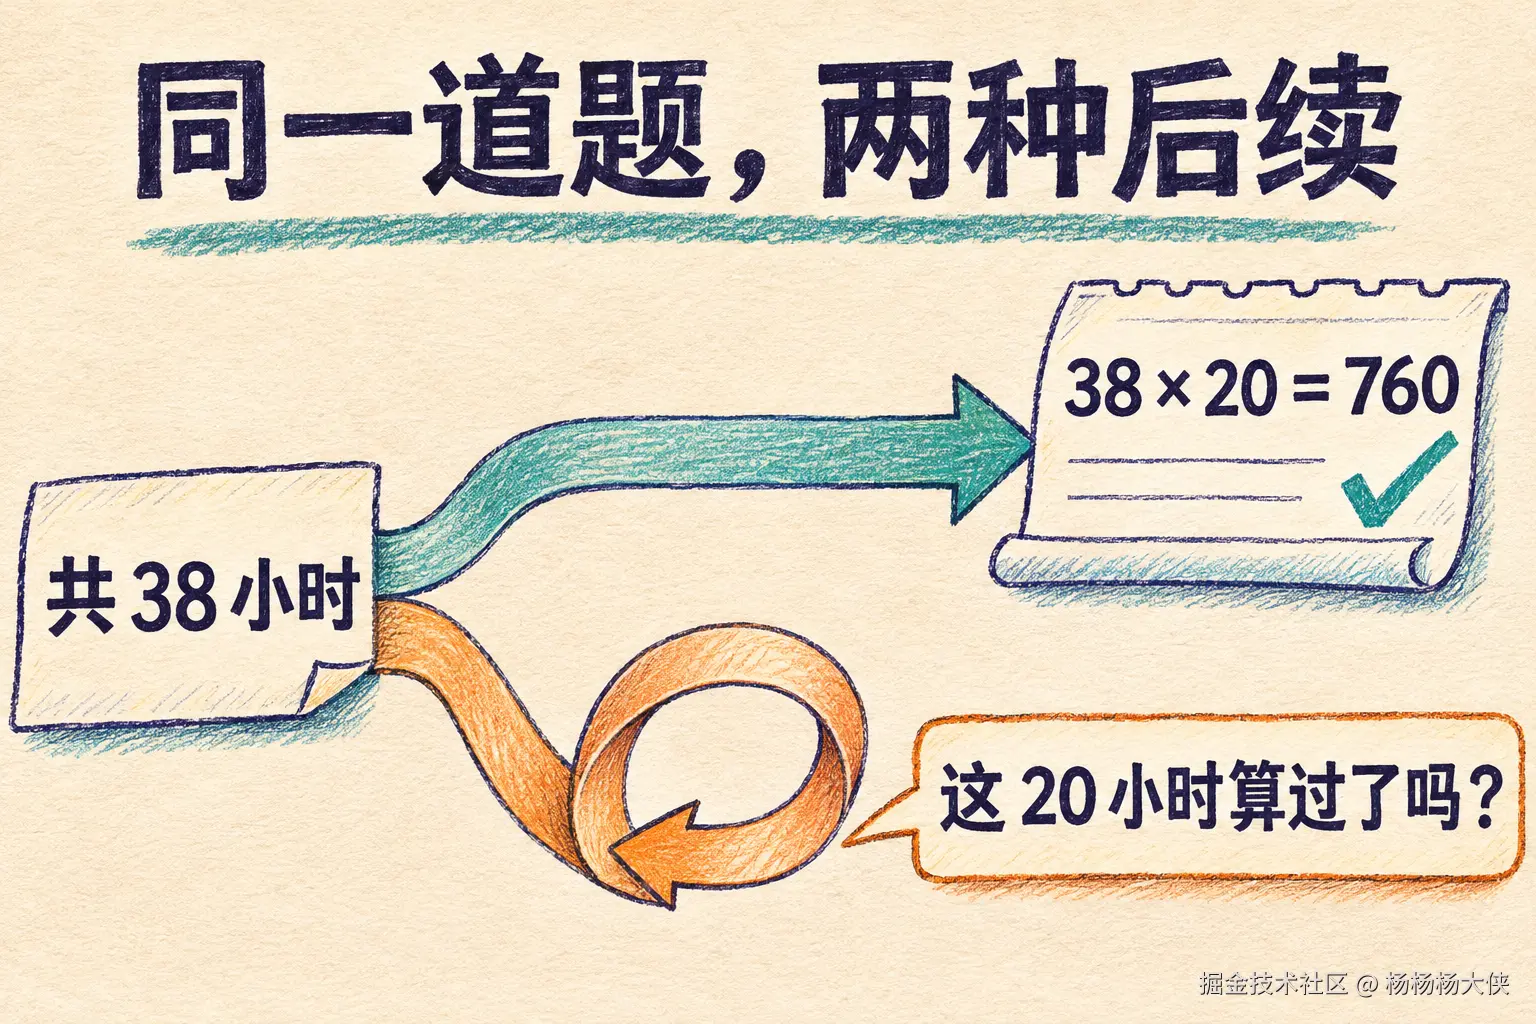
图 1 两段续写都是 Astra 为对照实验准备的。它让千问分别读进去,记录模型在两处的反应。
从 24 层里找出两层
工资题有意思的地方在于,两段文字里都有"再想一遍"。前一段是换个算法核对工资,后一段才是在同一处兜圈。为了把有用的验算和没完没了的重复分开,Astra 一共写了四对片段。每对的题目相同,两段解法从中途分开。对照片段与测量代码
千问读这些文字时,Astra 能用 Python 取出它每一层的内部状态。对每一层,它用读到重复片段时的那组数,减去读到正常片段时的那组数,再取四对样本的平均差。把这个差画成一支箭头,就容易理解后面的查找了。箭头指着状态发生偏移的方向,Astra 要找的是,模型里的哪些部件在顺着箭头使劲。
在千问的 24 层里,第 15 层和第 19 层的前馈网络尤其明显。不过,只知道层号还不够,每一层里又有很多神经元。Astra 给它们排了个序。一个神经元在重复时比正常验算时多活跃多少,乘上它的输出沿箭头方向有多大分量,就是它在这些样本上的贡献。这样一来,即便某个神经元非常活跃,只要它在两段文字里一样活跃,排名就不会靠前。
最后,两层里各选中了 64 个神经元。每个神经元对应输出矩阵里的一列,每列有 1,024 个数。文章里常被提到的 0.016% 就是这么来的。两层,每层 64 列,每列 1,024 个数,补丁一共涉及 131,072 个权重位置。权重筛选与补丁记录
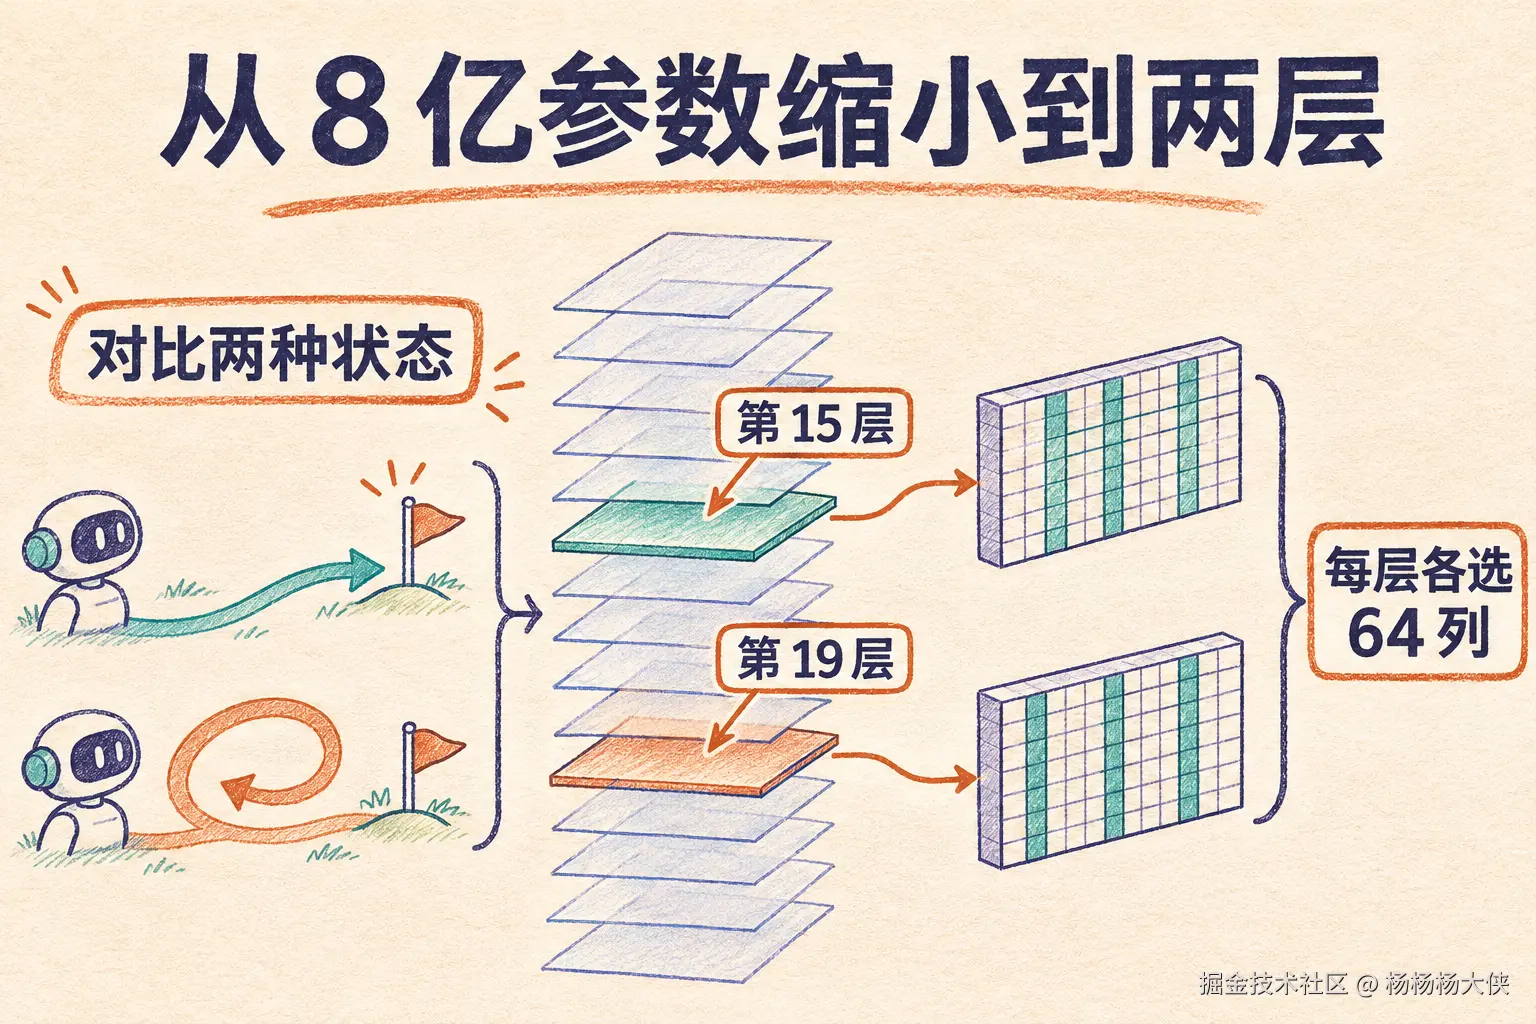
图 2 框出一列,是要调整这个神经元传给下一步的信号。格子里的色块只标位置,实际每层选了 64 列。
关掉一个神经元,只多答对了两道
Astra 试过一个很直接的办法,把第 19 层里一个特别可疑的神经元的输出关掉。原版和修改版各做同样的 32 道题,原版答对 3 道,修改版答对 5 道。样本这么少,下次再跑一次还能不能多答对两道,谁也说不准。况且,关掉它以后,这个神经元在正常解题时出过的力也一并丢了。逐轮实验记录
后来,Astra 把改动收窄到那支箭头指的方向,只把选中的列沿这个方向的分量往回调,跟它垂直的部分照旧。具体该往回调多少,就让新旧千问做同一批练习,看哪一版多答对了题。有一次加大力度后,修改版整体上确实答对得更多了,可是写完了却交错答案的也变多了。要是只统计有多少份答卷顺利写完,这些错卷也会算在进步里。不同力度下的答题结果
最后选定的系数是 6。比如,某一列沿箭头方向的分量原本是 +1,减掉它的 6 倍,就成了 −5。这个数字只用在选中的列,沿其他方向的分量不受影响。Astra 还在同样两层里换了个随机方向,和原方向垂直,改动幅度相近。这次没看到明确的收益。两次一比,才多了一条理由相信,前面找到的方向确实跟重复有关。修改公式与随机对照
补丁定下来后,原版和修改版做了 1,152 道之前没拿来挑补丁的练习题。579 道从错变对,5 道从对变错。细看那 579 道改对的题,有 576 道 原先都写到了长度上限。换到调整期间 Astra 没见过的 MATH-500 上,正确率从 7.9% 升到了 48.1%。研究者又用同样的方法去改另一款小模型 Gemma 3 270M。它本来就很少陷入重复,同样给 50 次前向测试,成绩只从 6.8% 变成 7.0%。千问的验证结果 · 两种模型的基准评测
手边没有一份做好的月报
Astra 可以放心地把两个版本拉来做题,因为练习册后面有答案。Google Research 的 Harness² 也会拿新旧两种做法来比,可它面对的往往是另一种工作。比如,你交给 Agent 一份订单文件,让它算本月的净销售额。你手头大概没有一份已经做好的月报给它批改。
这里的 harness ,指的是模型干活时用的提示词、工具说明、技能和脚本。Harness² 可以改这些东西,让同一个模型拿着同样的材料再做一次。候选流程可以同时试,也可以接着上一轮的结果再改。调整期间,AI 看得到用户要什么、文件里写了什么,也知道每一版具体做过什么。Harness² 论文 · 项目说明
还是拿月报打个比方。订单表上记着 10 万元,旁边还有一张退款表,记着 8,000 元。原流程只读了第一张表,就把 10 万元填进"净销售额"。新流程加了一步,打开文件先列出所有工作表。只要翻一下文件和运行记录,就能确认旧版确实漏看了退款,新加的这一步有用。至于月报能不能交,还得看最后那个数。10 万元扣掉 8,000 元,应当是 9.2 万元。如果新流程写的是 10.8 万元,它虽然找到了退款,却把账加反了。
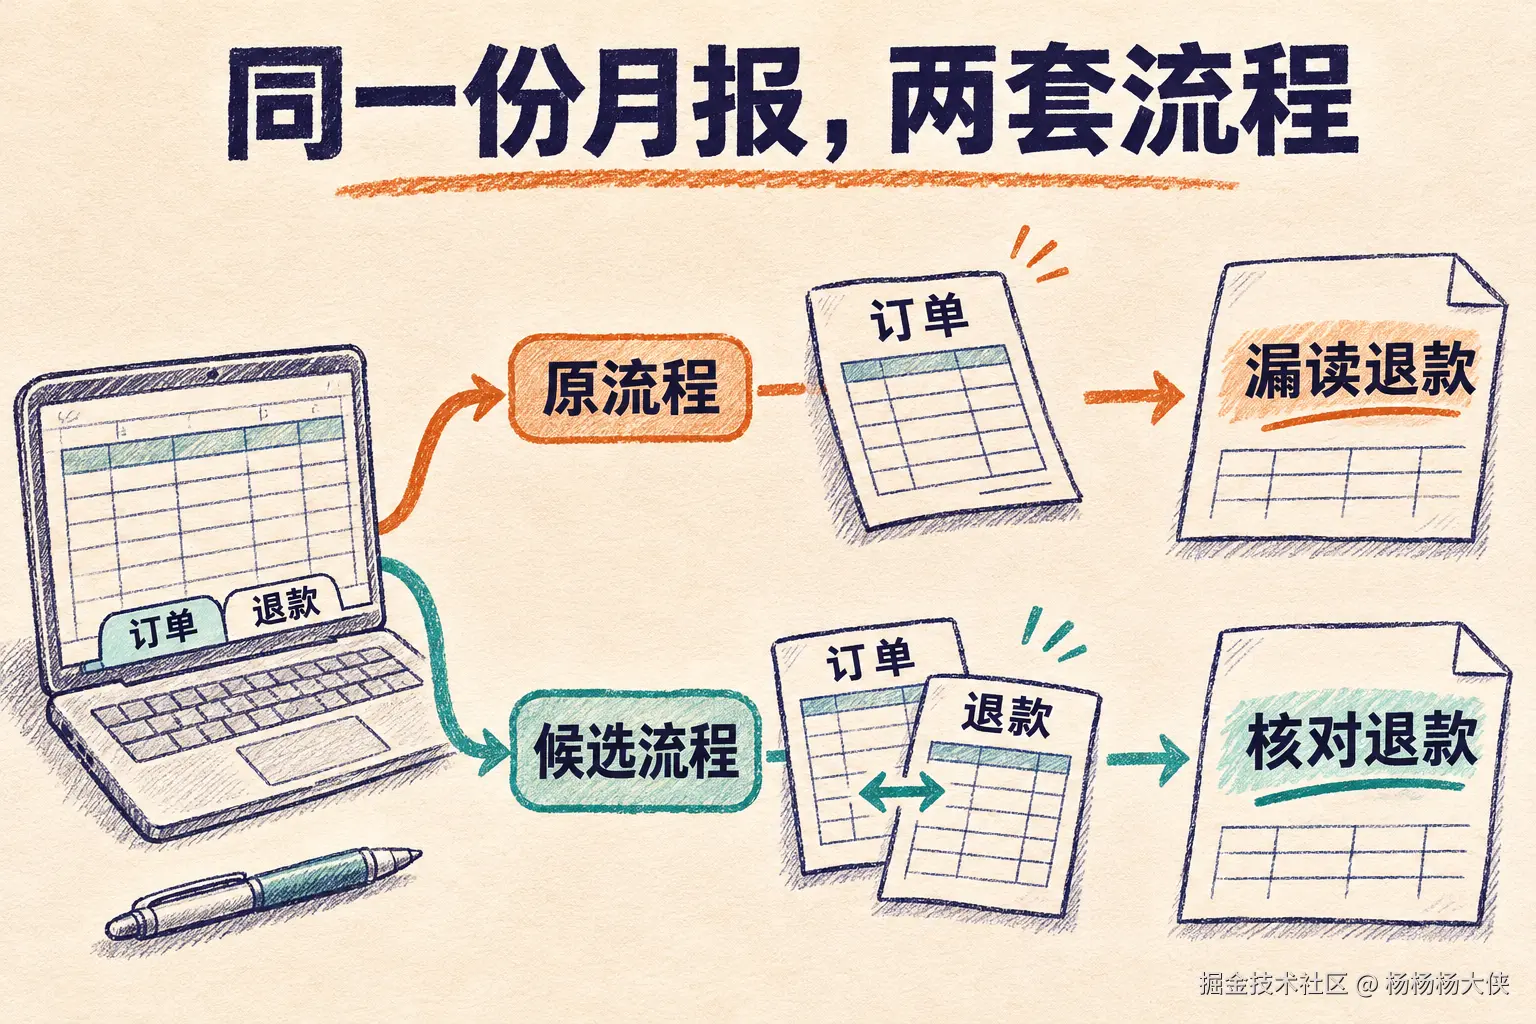
图 3 月报是个假设的例子。两条流程用同一份文件,因此"有没有读到退款表"有据可查。
论文里有个 JobBench 案例,和这个例子很像。Agent 要综合排期、场地、人工和预算几份材料,写一份备忘录。第一版写完就交了。不同文件里的数字没核对过,生成的文件也没重新打开检查。两套候选流程各补了一处。一套要求先清点手头的文件,给引用的数字标出来源,交付前用脚本重新打开文件检查。另一套给出了更具体的操作说明,告诉 Agent 怎么核对排期、场地、人工和预算。两套改法可以合用。再跑一遍,数字能跨文件对上,备忘录原先缺的部分也补了回来。论文中的案例与图 9
这份任务后来从 43.1 分涨到 77.8 分。AI 在挑流程时看不到这两个分数,当时能查的是哪份文件没读、哪笔数字找不到出处、哪部分该写却漏写了。能在记录里找到这种差别,就有理由留下这条改动。试了以后看不出它起过什么作用,也可以沿用旧办法。
Harness² 里的平方对应两层改进。这一轮做完了,系统会把有依据、下次可能还用得上的经验记下来。譬如,"算净额时先核对有哪些工作表"可以带到下个月,那 8,000 元当然不能。研究者还专门做过一次试验,保留每个任务里试跑和修改的步骤,只拿掉跨任务复用的经验库。在这组设置下,WorkBuddy-Bench 从 77.5 分降到 74.4 分,JobBench 从 36.0 分降到 34.2 分。经验库值不值得留,也有一组单独的对照。论文表 3
两份成绩单怎么读
| 比较环节 | Astra 改千问 | Harness² 改流程 |
|---|---|---|
| 谁和谁比 | 原版、修改版千问做同一批题 | 同一个模型用不同流程做同一项任务 |
| 挑改法时能看什么 | 练习题的标准答案、答题结果、是否写到上限 | 用户要求、原始材料、运行记录和实际交付的文件 |
| 什么时候判最终成绩 | 固定补丁,再用没见过的基准题打分 | 流程改完,交出结果,再按基准的评分规则评测 |
回到开头那道工资题。两个版本即使都算出 760 美元,也只是彼此一致。拿工时和时薪再算一遍,才能说它们都算对了。月报少一份现成的参考答案,却一样有账可查。一条流程有没有帮上忙,可以翻记录。要在 9.2 万元下面签字,还是得翻账本。