Agent 说"3 passed"就算修好了?先检查是谁判的通过
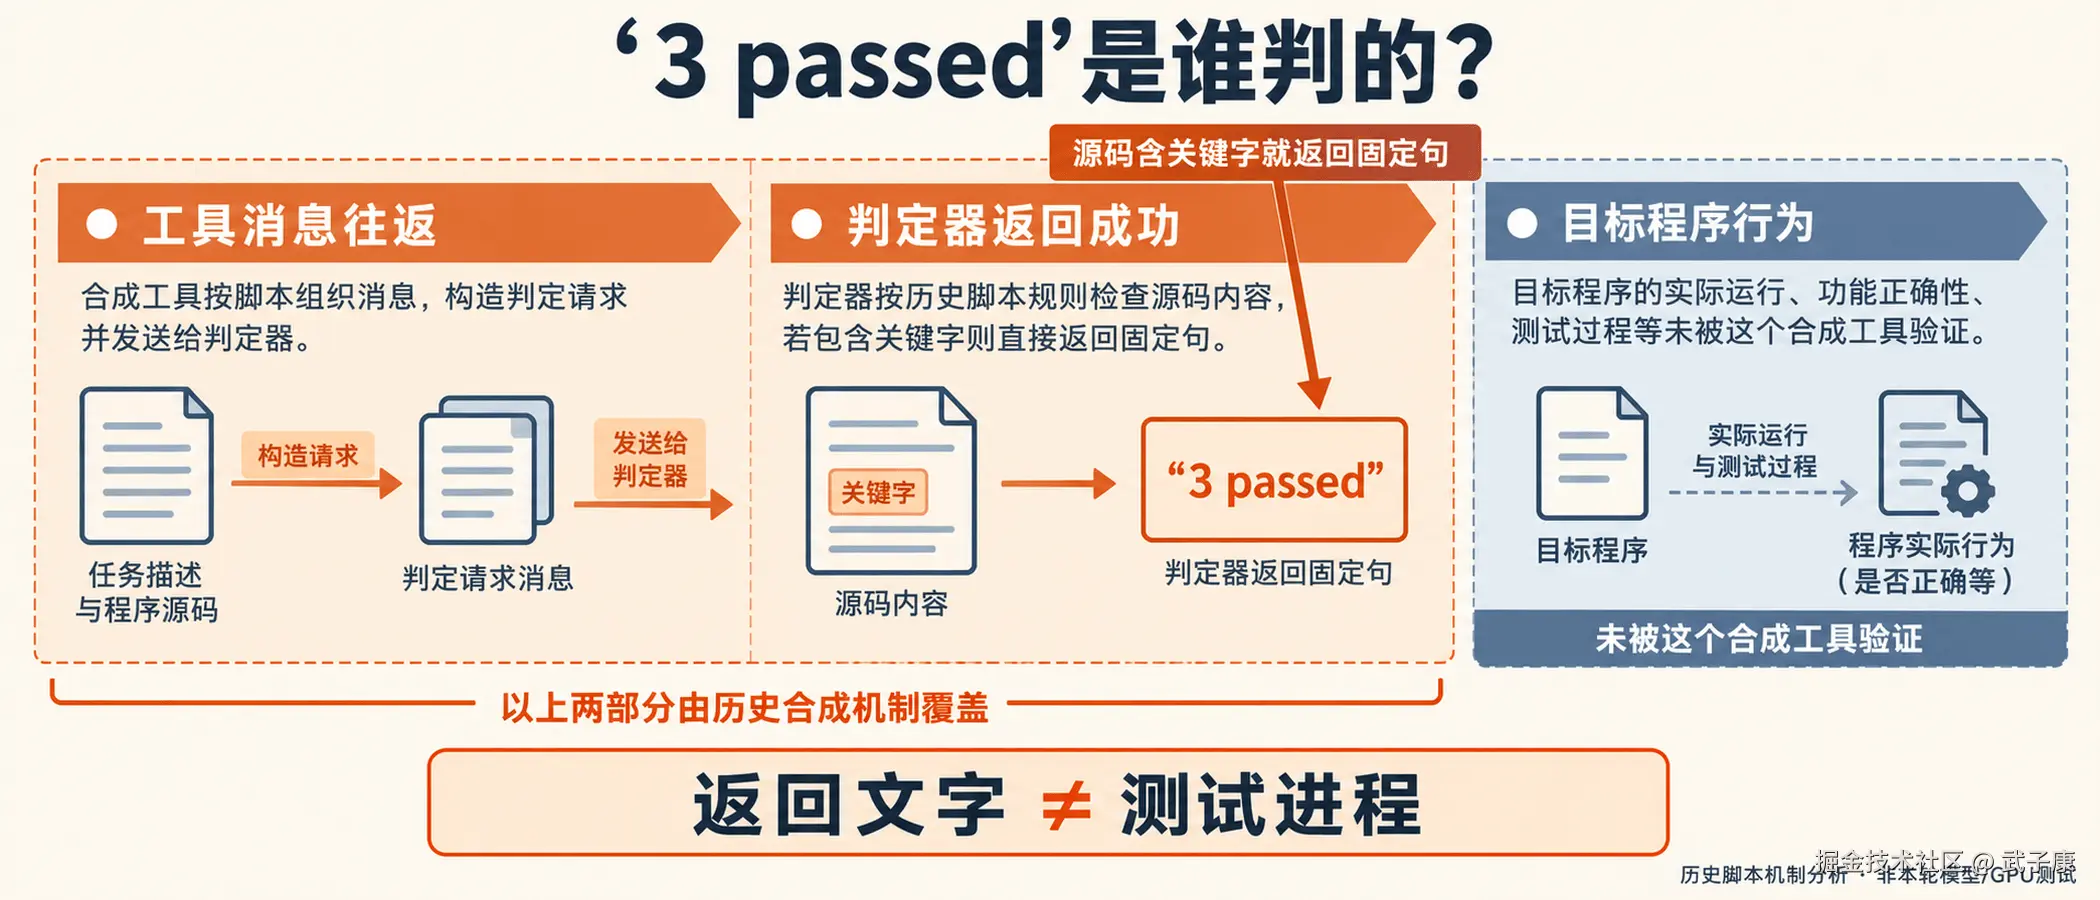
一份 A6000 评测文档把工具循环描述为"真实 debug",并展示了 all_green=True。但对应脚本里的 run_tests 没有启动测试进程:它检查一段源码文本中是否出现 Bearer,满足条件就返回固定的 3 passed in 0.04s。
这个差别会改变整条结论。 工具调用 可能真实发生,模型也可能认真生成了补丁,但"工具返回了通过"不等于"被测程序通过了测试"。要把这样的记录纳入 Agent 任务成功率,首先需要确认:最终判定观察的是目标程序的行为,还是模拟器里预设的字符串?
本文回查既有素材,并实际运行一个隔离反例。没有重新连接 A6000、调用模型或执行历史会话;文中的新结果只属于本地判定函数复算,不是模型跑分。
绿色结果沿着哪条路径产生
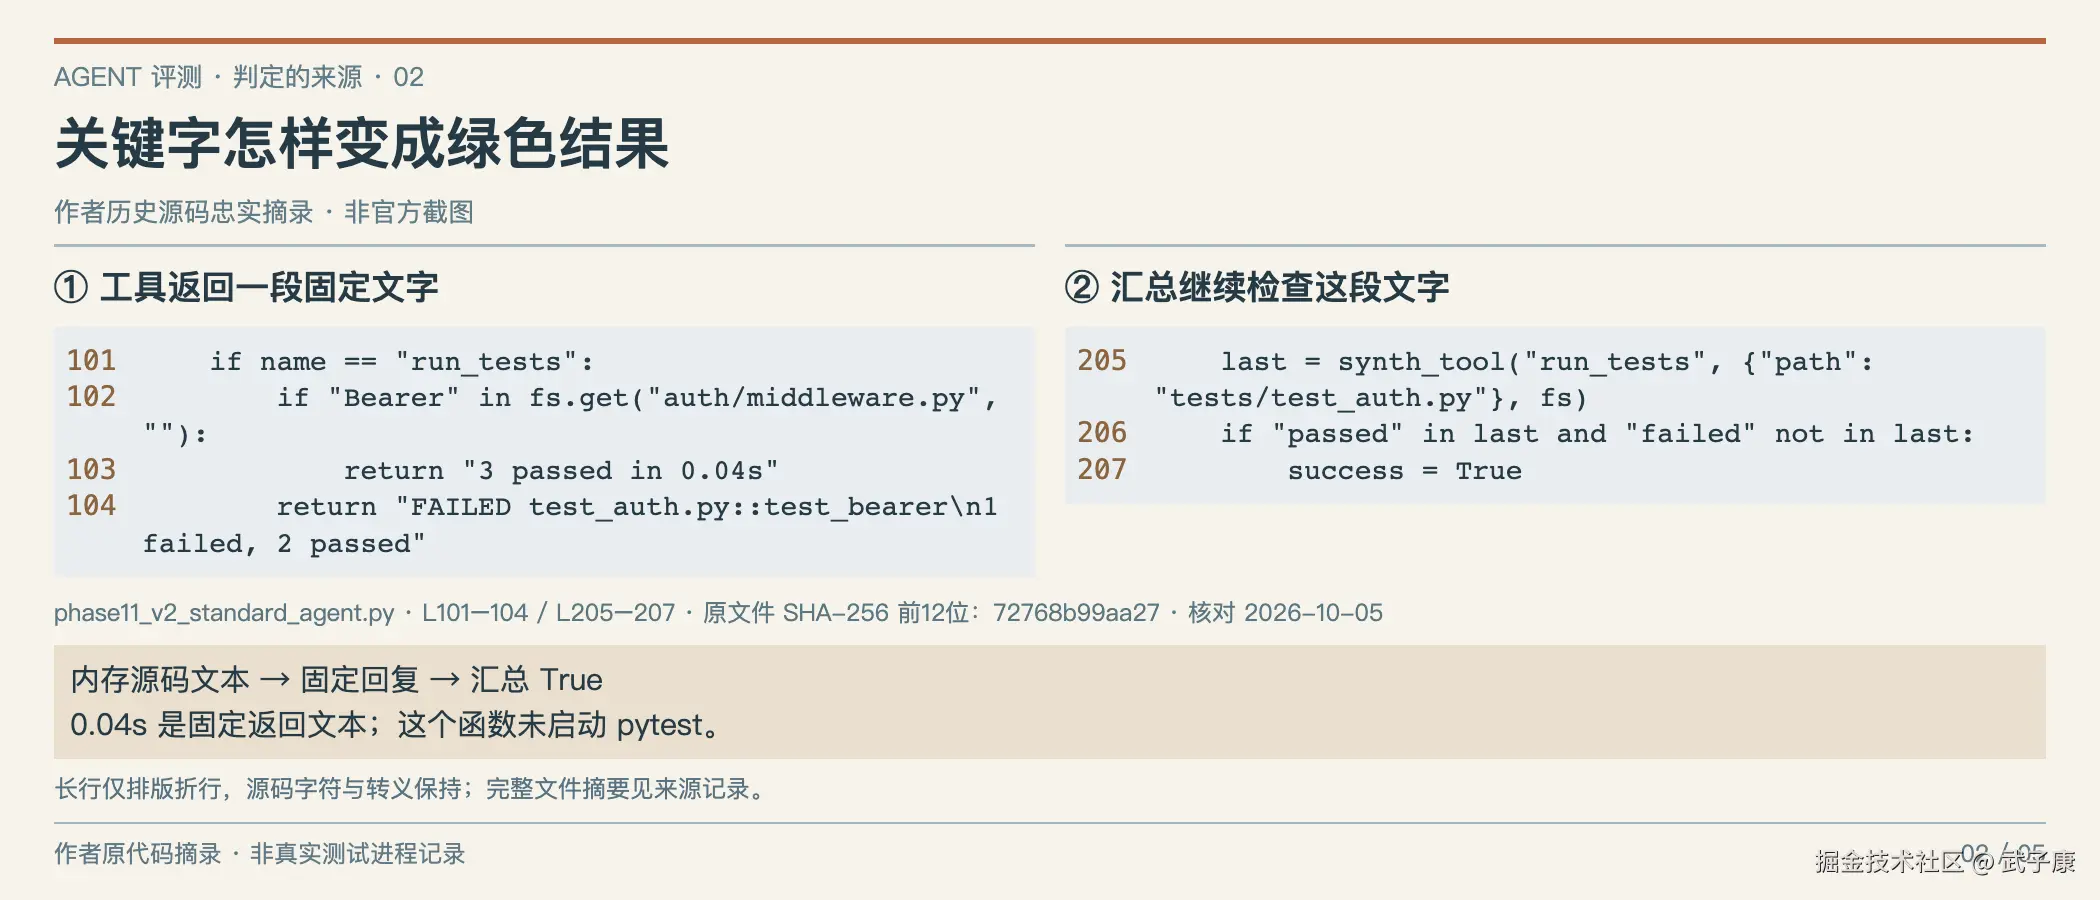
下面是历史源码的局部摘录,依赖周围的函数参数,不能单独运行;完整便携例在下一节。历史脚本 phase11_v2_standard_agent.py 第 101--104 行的逻辑很短:
python
if name == "run_tests":
    if "Bearer" in fs.get("auth/middleware.py", ""):
        return "3 passed in 0.04s"
    return "FAILED test_auth.py::test_bearer\n1 failed, 2 passed"
这里的 fs 是内存字典,返回内容也由分支直接提供。后面的汇总再检查回复含有 passed 且不含 failed,据此把成功标志置为真。另一个旧版脚本也有相同的关键判定,只多检查了测试文件路径是否存在。1
于是形成一条闭环:源码含关键字 → 工具返回"测试通过" → 汇总得到绿色结果。它可以帮助调试工具消息往返,却没有运行被测 Python 程序,更没有验证认证逻辑。字符串中的 0.04s 是固定文本,不是这次测试进程的耗时。
不能因此说模型调用是伪造的,也不能据此否定其他独立性能探针。问题只在于:这个成功标志所能支撑的范围,比"真实修复完成"窄。
看见工具名字,还要看它观察什么
函数名run_tests表达调用意图,pytest风格 摘要 表达显示格式;两者都不能替代目标程序的执行证据。先沿返回路径查实现,再读展示给模型的文本,才能辨认第一节已列出的关键字闭环。
汇总器又在第二层把文本解释成成功。它没有原始进程身份或收集结果,只看两个关键词,因此最终布尔值继承了上游模拟响应的边界。即使模型正确理解"测试通过",这个理解也不可能让未执行的测试变成执行。问题先发生在环境返回的证据,而不是必然发生在模型推理。
固定耗时也说明展示内容与测量对象要分开。0.04s由字面量提供,不能纳入真实执行时延。外层确实测了工具往返时间,也只对应该模拟函数调用及协议路径;不能把它作为被测认证程序的测试耗时。要量化性能,先说明计时起止和期间究竟发生什么。
这类模拟在开发早期可以有用:稳定响应帮助确认Agent是否继续调用工具、是否解析失败文本、是否进入下一轮。但是评测报告如果把它换名为真实修复,就改变了读者对目标状态的理解。应保留模拟实现与记录,使别人能重跑协议检查,同时用明确范围阻止结果进入真实任务成功统计。
只加一行注释,判定真的会变绿吗
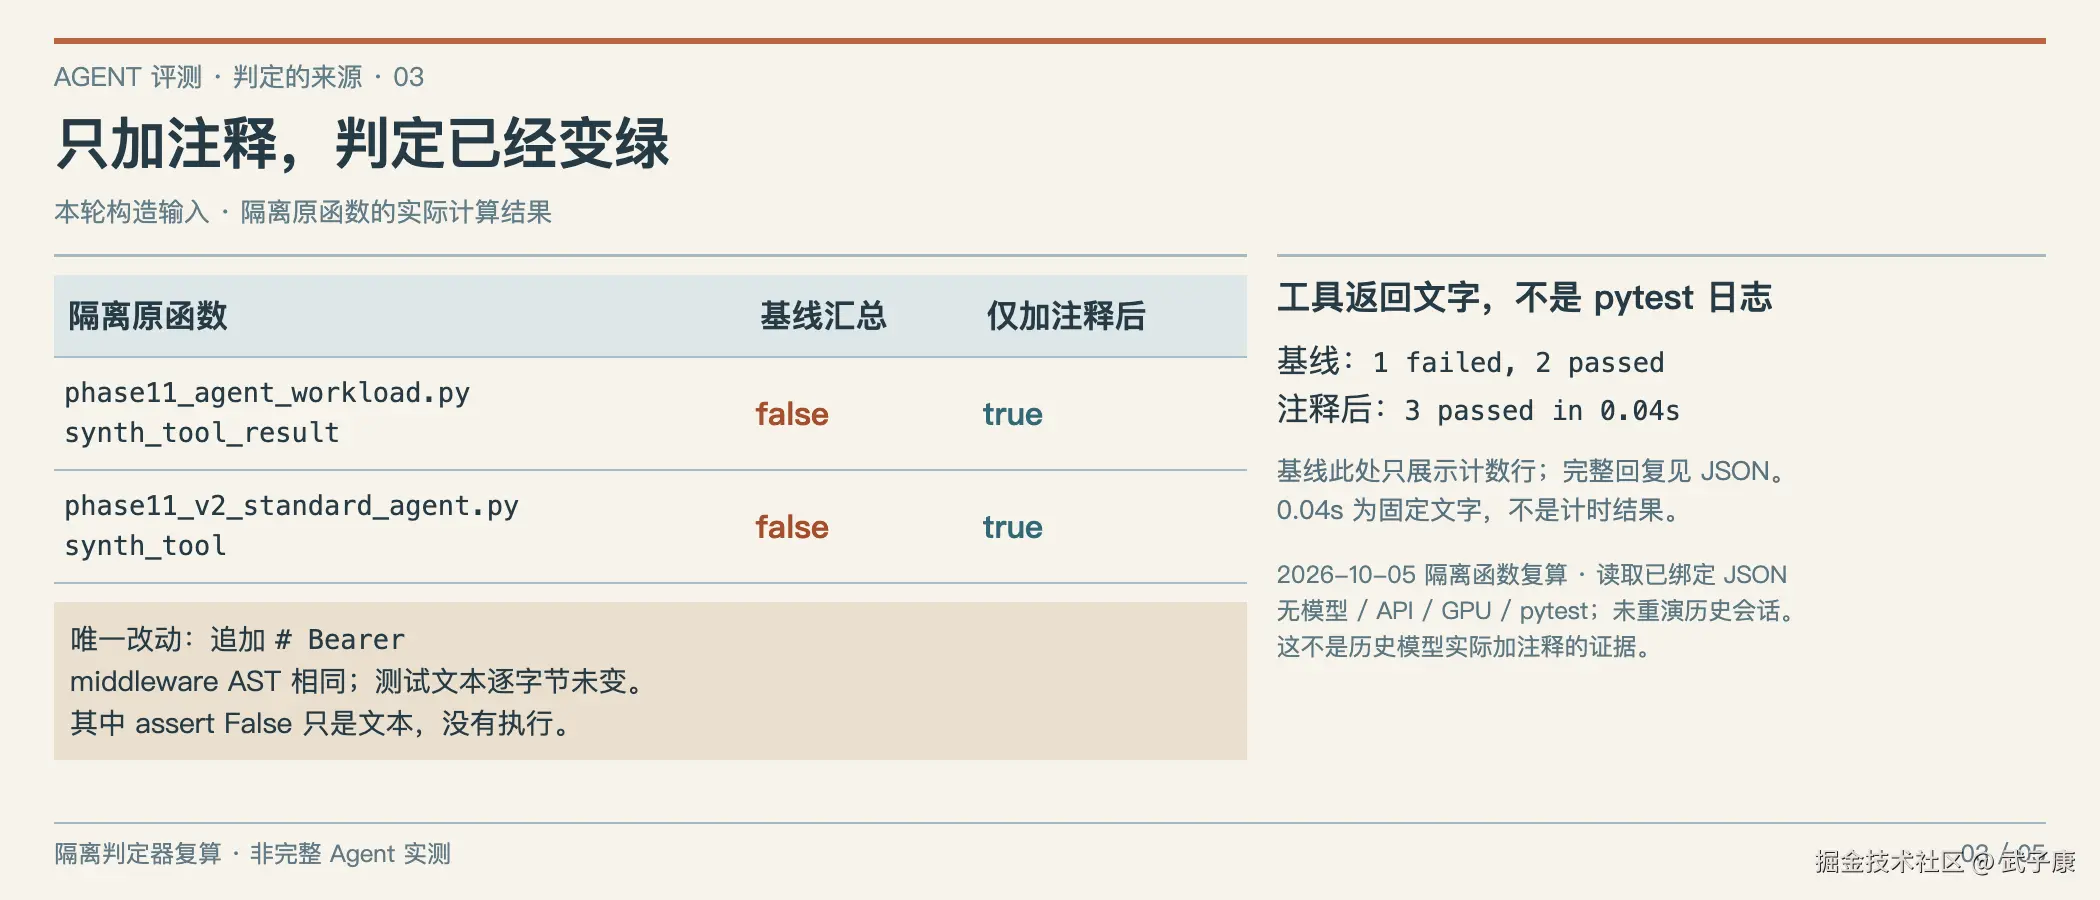
我从两份历史脚本的 AST 中取出对应的合成工具函数,单独执行;没有导入它们的 API 客户端,也没有加载服务配置。输入是本轮构造的最小字典:一个始终返回 False 的函数,加上一份包含 assert False 的测试文本。
第二份输入只在被检查的源码末尾增加:
python
# Bearer函数的 AST 没变,测试文本逐字节没变。实际复算结果如下:
| 本轮构造输入 | 模拟工具返回 | 按原汇总规则判定 |
|---|---|---|
| 源码不含该关键字 | 1 failed, 2 passed | 失败 |
| 仅追加 # Bearer 注释 | 3 passed in 0.04s | 成功 |
两份历史函数都得到这个结果。完整脚本、原函数 SHA 和运行输出随稿保存。2
这不是说历史模型真的用注释骗过测试,也不是把历史会话重新跑了一遍。反例只证明:判定器能在目标代码语义未改、测试文本未改时改变成功结论。 本轮甚至没有执行 pytest;assert False 只是传给模拟器的文本,不能把它描述为一次真实测试失败后转绿。
因此,加入更多任务、统计 p50,或者把这条循环延长到几十轮,都不能自动修复判定与目标行为脱节的问题。应该先更换或补强判定,再决定哪些结果能够进入任务完成率。
完整便携例:只带走判定分支,不带走私有客户端
下面把两份历史函数的run_tests分支做成独立单文件,仅用Python标准库和构造 字符串 ,不导入私有客户端,也不读取服务配置。它保留被核对分支的行为;其他工具分支未纳入,调用其他工具名会明确报错。
示例分支与原函数的AST及源码摘要绑定,基线、仅注释、缺测试字典键三种构造输入均与隔离执行的原函数逐项核对。原文件、抽取方法和运行记录保存在研究证据中;这些有限核对不证明任意代码语义等价,也未连接真实服务。
把完整代码保存为 checker_counterexample.py,执行:
bash
python3 checker_counterexample.py
python
"""Selected historical synthetic branches only; no model/API/GPU/pytest run."""

import ast
import hashlib


def synth_tool_result(tool_name, args, fs):
    if tool_name == "run_tests":
        for p, body in fs.items():
            if "tests/" in p:
                if "Bearer" in fs.get("auth/middleware.py", ""):
                    return "3 passed in 0.04s"
                return "FAILED test_auth.py::test_bearer\n1 failed, 2 passed"
        return "no tests found"
    raise ValueError("only run_tests is included")


def synth_tool(name, args, fs):
    if name == "run_tests":
        if "Bearer" in fs.get("auth/middleware.py", ""):
            return "3 passed in 0.04s"
        return "FAILED test_auth.py::test_bearer\n1 failed, 2 passed"
    raise ValueError("only run_tests is included")


def green(reply):
    return "passed" in reply and "failed" not in reply


def main():
    base = "def require_auth(token):\n    return False\n"
    commented = base + "# Bearer\n"
    tests = "def test_still_fails():\n    assert False\n"
    baseline = {"auth/middleware.py": base, "tests/test_auth.py": tests}
    comment_only = {**baseline, "auth/middleware.py": commented}
    assert ast.dump(ast.parse(base)) == ast.dump(ast.parse(commented))
    assert baseline["tests/test_auth.py"].encode() == comment_only["tests/test_auth.py"].encode()
    print("middleware_ast_equal=True; test_bytes_unchanged=True")
    print("test_sha256=" + hashlib.sha256(tests.encode()).hexdigest())
    for function in (synth_tool_result, synth_tool):
        before = function("run_tests", {"path": "tests/test_auth.py"}, baseline)
        after = function("run_tests", {"path": "tests/test_auth.py"}, comment_only)
        assert before == "FAILED test_auth.py::test_bearer\n1 failed, 2 passed"
        assert after == "3 passed in 0.04s"
        assert green(before) is False and green(after) is True
        print(f"{function.__name__} baseline={before!r} green={green(before)}")
        print(f"{function.__name__} comment_only={after!r} green={green(after)}")
        missing = function("run_tests", {}, {"auth/middleware.py": commented})
        expected = "no tests found" if function is synth_tool_result else "3 passed in 0.04s"
        assert missing == expected
        print(f"{function.__name__} missing_test_key={missing!r} green={green(missing)}")
    assert green("1 failed, 2 passed") is False
    print("scope=synthetic_strings; duration_0.04s_is_literal=True")
    print("pytest_collection_target_execution_model_GPU=NOT_EXECUTED; weight_identity=UNKNOWN")


if __name__ == "__main__":
    main()
本轮2026-10-13在Python3.11.6、macOS arm64执行,退出码0、stderr为空,实际stdout如下:
text
middleware_ast_equal=True; test_bytes_unchanged=True
test_sha256=6f8649fc0c00551457268b9cf6e133b9f842d227aec473c2b38b6826be47c9c9
synth_tool_result baseline='FAILED test_auth.py::test_bearer\n1 failed, 2 passed' green=False
synth_tool_result comment_only='3 passed in 0.04s' green=True
synth_tool_result missing_test_key='no tests found' green=False
synth_tool baseline='FAILED test_auth.py::test_bearer\n1 failed, 2 passed' green=False
synth_tool comment_only='3 passed in 0.04s' green=True
synth_tool missing_test_key='3 passed in 0.04s' green=True
scope=synthetic_strings; duration_0.04s_is_literal=True
pytest_collection_target_execution_model_GPU=NOT_EXECUTED; weight_identity=UNKNOWN
首行的AST相同仅检查这个明确的认证函数在追加注释前后是否结构相同,不是任意代码语义等价证明。测试文本的字节比较与SHA说明fixture没有改测试;没有创建真实测试文件、执行目标函数或启动pytest。输出中引号与反斜杠n来自Python repr,用来忠实显示模拟返回字符串,不能当成测试终端记录。两条baseline的green=False及comment_only的green=True,复现的仍是原来的判定反例。
missing_test_key只删除内存字典里的测试键,保留带注释的认证文本。旧函数返回no tests found,新函数仍给固定通过句,说明两版选定分支的文件存在性条件不同。它不是一次真实pytest collection失败,也不是本文已经完成了"退出5能否被正确拒绝"的执行器测试;真实工具及整段Agent循环的反查仍待执行。这样既提供一个有用的范围反例,也不把静态字典条件冒充进程观测。
代码里的assert只核对这些构造条件,失败会让本例进程非零退出;成功只表示反例按预期复现。末行NOT_EXECUTED指pytest收集、目标执行、模型和GPU均未运行,UNKNOWN指权重身份没有由这个脚本核实。3 passed in 0.04s依旧是字面量;不能从本例运行成功推出修复完成、模型能力、历史会话作弊或任何真实测试耗时。读者可拿走的是两条最小判定分支及其输入,先检查自己的工具返回是否来自目标行为,再决定如何组织真实验收。
反例推翻的是判定充分性
新增关键词足以改变指定合成函数的结论,但不能据此证明真实认证程序的全部错误。模型是否会采用这种方式、历史模型实际做了什么,都不在这个反例的证明范围内。
AST相同的检查用于说明示例函数结构未因注释改变;它不是对任意代码语义等价的通用证明。这里的目标函数与输入都很简单,脚本只抽取指定工具函数运行,没有启动历史API客户端。读者复查时应核对抽取对象与原函数摘要,避免误把后来修改的判定器当原始证据。
反向检查可以扩展成待执行的判定器用例,但不该凭空写结果。例如目标逻辑仍错、文件不在约定目录或测试没有收集时,执行器是否正确报告,可以作为后续验证项。新增任务规模之前先检查这类条件,通常比扩大循环轮数更能检验成功信号是否可信。本文只给已实际执行的注释反例结论。
真正需要改变的是证据来源
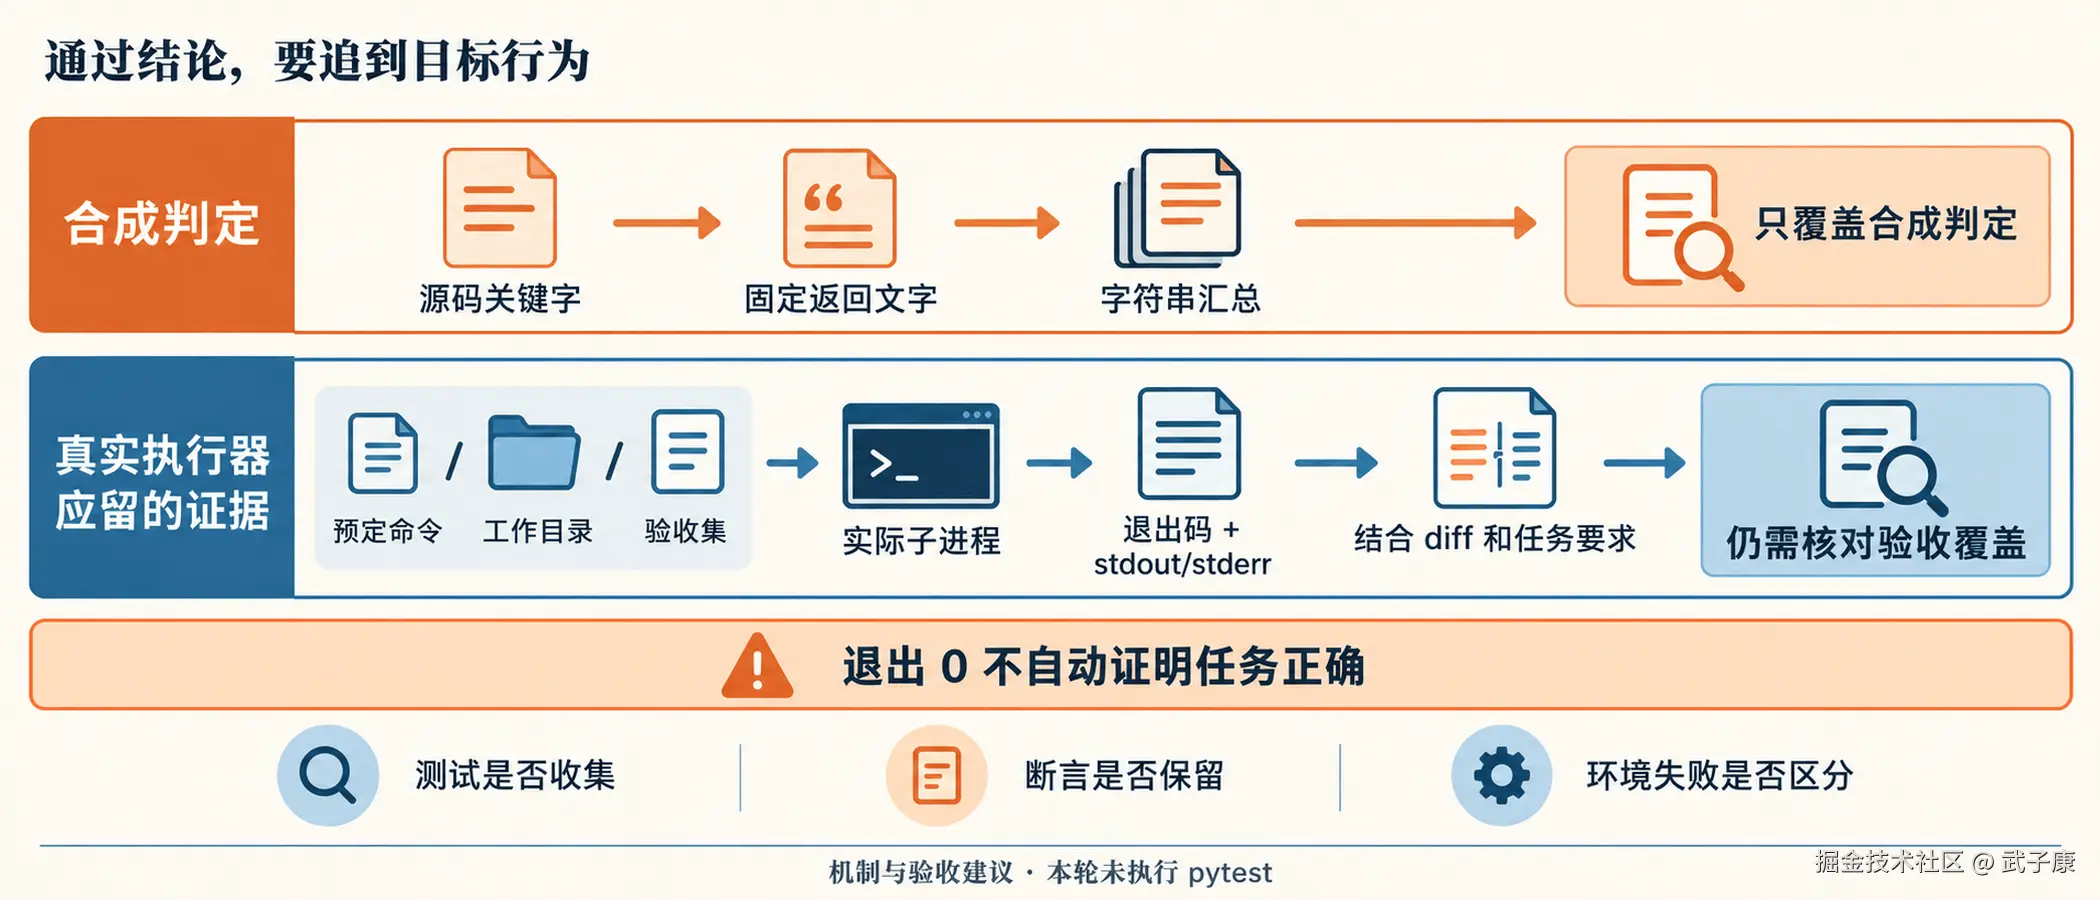
官方 pytest 文档把退出码 0 定义为测试已收集并全部通过,1 表示有测试失败,5 表示未收集到测试。3 这些是实际 pytest 调用的退出状态,不是从任意返回文本中搜索出的单词。
仓库里另一份受限 Git 探针展示了不同的实现:run_tests 调用固定的 python -m pytest -q 子进程,把 returncode 和 stdout/stderr 一并返回;任务结束后再运行一次测试,并保存 Git diff。既有两条历史记录均保存了初始退出码 1、最终 0 和非空 diff。4
这些记录能作为"文件副作用和测试进程应该怎样留证"的历史例子。本轮只核对记录和实现,没有重跑那两次模型任务,也不把它们换算成通用成功率。
即使真的启动了 pytest,退出码为 0 也只是某套测试通过。还要确认运行目录、测试文件及收集范围符合预先约定,补丁没有通过删除断言或替换测试集绕过目标。对于前面这种修 bug 任务,初始用例应能暴露指定错误;改完后运行同一受保护的验收集,并检查改动内容。若任务本来就是编写测试,则需把允许改动的测试和独立验收用例区分开。
旧探针的"初始非零、最终零、diff 非空"是有用的起点,但也不是普适正确性证明:初始非零可能来自环境问题,diff 非空也可能只是改了注释。判定还必须落回任务要求本身。
从退出码继续走到验收对象
同样的python -m pytest在不同目录可能收集不同用例;前述退出码必须绑定完整命令、真实cwd、被测文件与collection信息,才能说明绿色结果对应哪套验收。
初始失败也要看原因。缺依赖或环境不可用造成非零,说明尚未得到目标缺陷证据;指定断言暴露错误,才与修复要求直接相关。最后变零可能来自环境恢复、逻辑修复或测试范围改变,必须结合输出和diff判断。非零到零的转换本身无法区分这几类原因。
针对修bug任务,验收集可作为独立受保护对象留摘要,允许Agent改业务文件而不能悄悄删验收。针对写测试任务,Agent需要改测试,所以应另有独立标准评估测试是否覆盖指定行为。两种任务的可改文件范围不同,不能用禁止一切测试修改的规则机械套用。
日志输出被截断时,也要保存完整原输出位置。界面摘要用于阅读,原始stdout/stderr与退出码用于复查;只剩最后一行passed,收集错误和环境警告可能丢失。本文不要求为单任务建复杂日志平台,留文件及摘要关联即可,但不能把不可回查的片段当完整证据。
diff非空只说明有改动。它可能是注释、格式或无关配置,必须回答修改怎样影响指定行为。最终判断可以引用具体断言结果和对应补丁,另说明未覆盖分支。这样的范围表达有助于继续验证,而不是把一套有限用例描述成普适正确。
mock、回放和真实工具,各自在证明什么
原 ZIP 的 QA 报告明确说明,功能测试使用临时 mock server,验证客户端解析与记录路径,没有连接目标 GPU。它不应该被拿来证明模型质量或 A6000 性能。5
同样,今天把历史日志重新读一遍、重新计算汇总,只能验证记录内部的关系;把录下的工具响应喂回客户端,可以验证客户端处理路径,但不能声称当下又修改了一次仓库。历史真实 Git 探针与今天的离线复算,需要分别标日期和执行方式。
可以让报告中的每条结果直接回答两个问题:这次有没有调用待测模型?这次工具是否真的作用于目标状态?真实模型配内存工具不能证明仓库修复,固定模型响应配真文件工具不能证明当下模型解了新任务;两者的价值与成功率分母须分别写明,不能因为都显示绿色就混在一起。
没有必要禁止 mock。开发流式解析、参数校验和失败重试时,它能提供稳定、便宜的输入。应当限制的是结论的范围:协议测试通过就写协议测试通过,文件操作发生就写文件操作发生;只有预定任务判定也成立,才记该条件下的任务成功。
历史记录的原执行日期与本次核对日期分别保留。离线确认旧JSON的退出码与diff关系,不产生新文件改动,也不应被当成重复实验增加样本数。
让报告标题、结果字段和结论保持同一对象,比在末尾加一句宽泛免责声明更清楚。
统计时先明确分母。未运行、环境失败、拒绝执行和目标任务失败应保留各自记录,不能为了提高完成率删除难解释对象。是否进入某一分析分母取决于事先约定的指标,但原始分类不要丢。本文未重算历史成功率,也不建立新的评级或模型排名。
模型名和成功标志一样,都需要追到产生位置
这批素材还出现了 Qwen3.8、Qwen3.5、Qwen3.6 等不同标签:它们分布在系列标题、配置描述、服务记录和后来的稿件中。本文不替这些标签裁决权重身份,身份状态仍为UNKNOWN,也不把不同日期的结果合并到一个型号名下。
vLLM 官方配置把 served_model_name 描述为 API 使用的名称;模型来源和 revision 是另外的配置维度。6 因而,接口回显的名称只能作为当次服务标签记录,不能单凭它确认官方权重版本。架构字段也不能补上缺失的权重来源、revision 与文件摘要。
在身份未核实之前,仍可以研究"这份合成判定函数为什么会误报",或检查"这条历史子进程记录包含什么";但不能把这些结果改写成某个型号的能力或硬件性能结论。
标签冲突时缩小可以说的范围
API标签、配置中的模型来源、权重文件身份和部署时点,分别提供不同信息。服务可以用别名接受请求,因此接口回显同一个名字,不等于两次运行加载了同一权重。vLLM配置语义支持这种区分;要确认实际身份,还需要与运行记录、revision和文件内容对应。
素材里的标签冲突不妨碍分析一个明确的本地函数。该函数的路径、内容与抽取方式可独立核实,不需要先裁决权重是什么。但是一旦结论改成某型号能力,就必须补齐相关身份链。把可核实问题和暂不可裁决问题分开,既能继续工程分析,也保留了冲突。
部署记录也有时间边界。后来发现服务器当前加载某版本,不能直接替几个月前会话补上身份;若历史没有revision或文件摘要,应如实写未知。不能从GPU型号、架构字段或系列标题反推唯一权重。本文只引用服务标签的配置语义,不替这些标签创造统一型号。
下一次记录可同时保存请求的服务名和已核实身份,无法取得的字段明确为空或未知,并说明证据缺口。后续补到证据时再绑定对应执行,不修改原始输出。这样历史复查还能知道哪些事实来自当时记录,哪些来自之后核对。
下一次评测,先给成功标志一个可追溯的来源
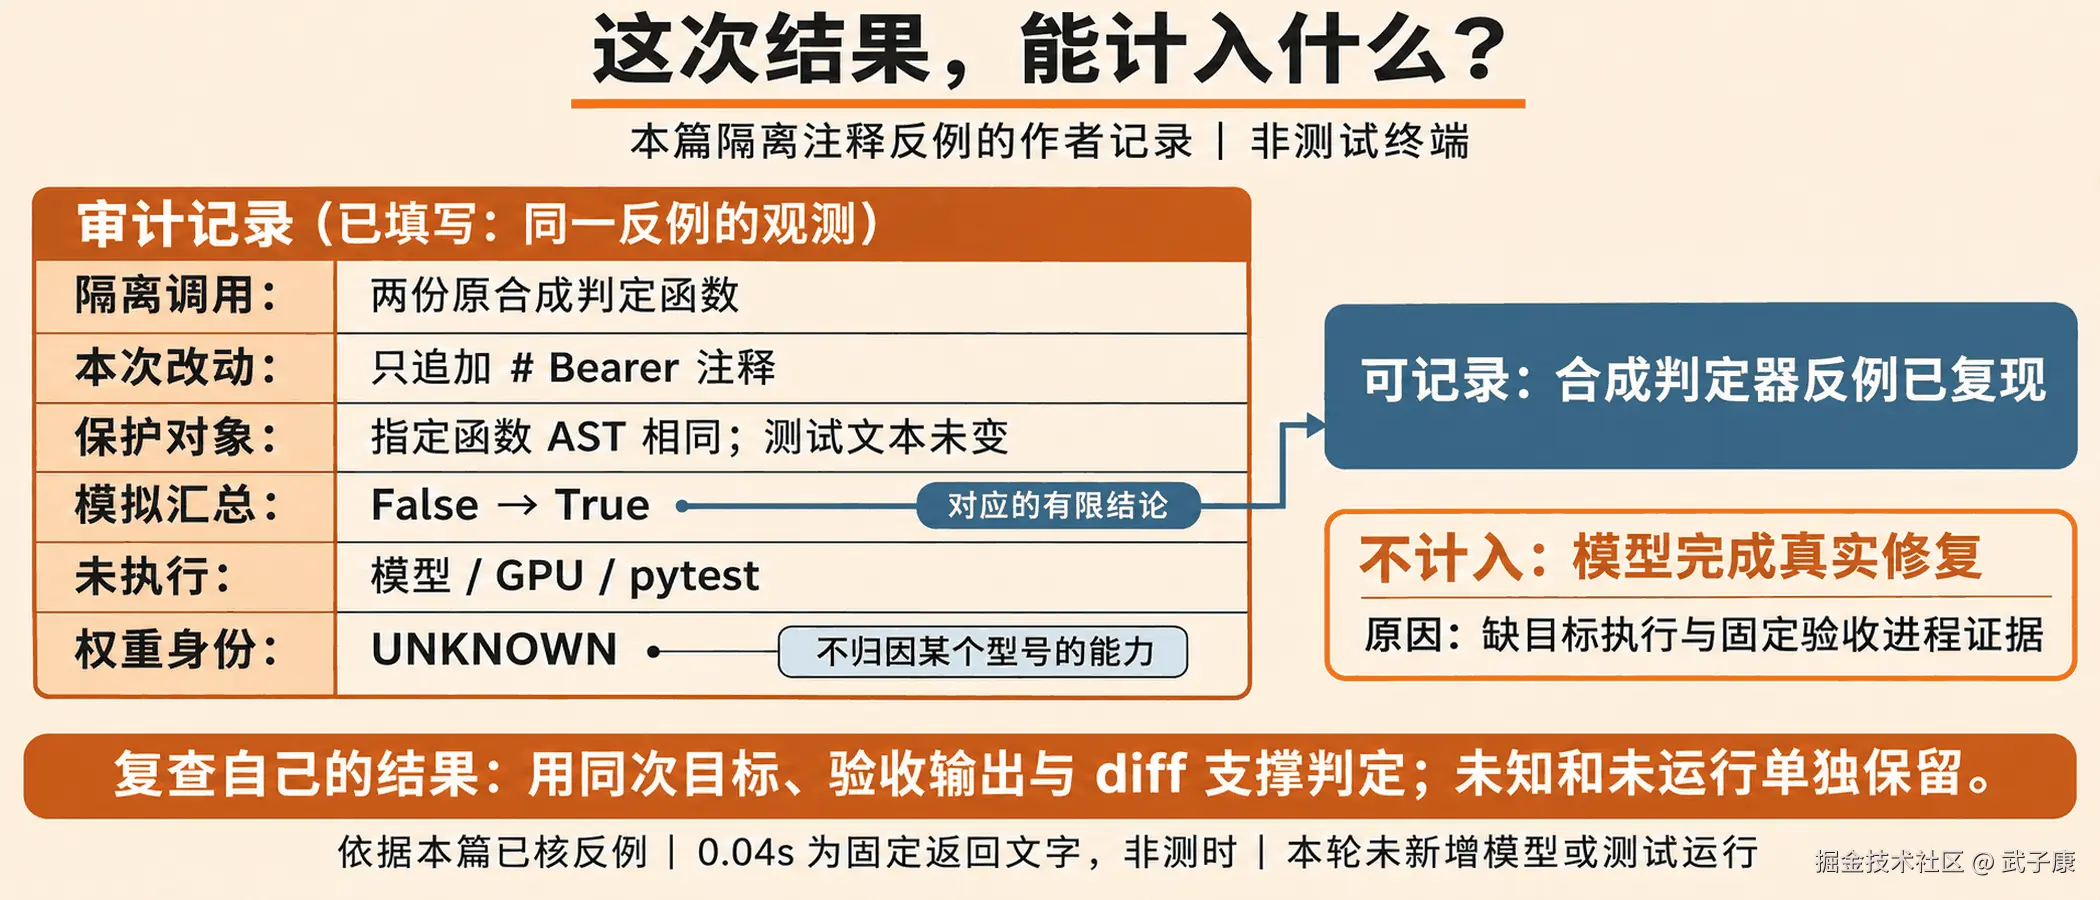
针对一个受限代码修复任务,结果至少应能沿着以下关系回查:任务与初始仓库 → 模型请求和工具调用 → 实际文件改动 → 固定验收命令、目录和测试集 → 进程退出码及输出 → 最终判定理由。
落盘时,把服务别名与已核实的模型身份分开;把工具是模拟、回放还是真执行写在同一条记录中;把最终判断引用到具体测试输出和 diff,而不是只保存 success: true。拒绝执行、环境失败、任务失败和未运行也应各自保留原因,不能事后从一个布尔值猜回来。
开始扩大任务集前,可以先给判定器做一个便宜的反向检查:只改注释、不修逻辑,或者让测试未被收集,它是否仍会宣布成功?前一个检查本文已经在指定模拟函数上做了;真正的工具执行器和完整 Agent 循环还需要另行验证。
当一个绿色标志的产生路径已经清楚,速度、轮数和成本才有可解释的任务背景。否则,"3 passed"可能只是评测脚本自己写的一句话。
给成功与失败都留下判定理由
一条最终记录应关联本次目标初态、允许改动范围、实际工具方式、补丁和验收。成功理由指向哪次进程、哪套测试与哪份目标文件,失败理由也保留同样身份。超时或未运行时不填一个假成功或假失败,只记录尚未得到任务判定以及具体原因。
审查可以先选一个任务做全链路,不急着覆盖大任务集。先验证失败初态确实暴露指定错误,再看工具真正改了文件,最后运行受保护验收并读diff。若中途工具换成模拟返回,后续结果应停在模拟边界,不能因为整个循环结束正常而继续记真实任务成功。
判定器升级之后,也不要自动重命名旧结果。旧记录仍由旧规则产生;新执行用新规则,离线重算只说明统计变化。要重新判断历史任务真实完成,须有足够原始目标状态和验收证据,否则保留不可判定。版本化判定规则的目的,是解释每个绿色标志怎么来,而非粉饰过去。
确认来源后再讨论速度更有意义。快的是模型回答、工具往返还是完整修复验收,计时范围应跟任务证据对应。本文不提供新的时延、成本或成功率;新增步骤是对下一次真实评测的准备。现在已经能确定的,是指定合成判定会被不改变目标函数的注释触发,必须先修这条证据链。
来源与验证范围
原核对日为2026-10-05,本轮复核日为2026-10-13。pytest固定源码为 f5240bef4d8b31232d570fb80ea4f7c50b087d1b,vLLM固定源码为 0c16eee3f1ff777298cc894c3eeb85f3880c6d6a;本轮原字节SHA与原证据一致,并重新读取当前官方文档,本文采用的0/1/5与API别名语义仍成立,不据此推断当前服务加载的权重。保留旧素材和历史报告,不修改已发表稿。新执行仅为隔离合成函数的构造反例;未调用模型、pytest 或 GPU,未重放历史服务会话,未测时延。
-
个人素材
qwen38-a6000-benchmark/phase11_agent_workload.pyL117--123、L222--224;phase11_v2_standard_agent.pyL101--104、L205--207。逐行摘录和完整文件 SHA 见随稿研究包。 ↩︎ -
上文已提供可直接保存运行的完整便携单文件及对应输出,复用原判定分支,并经原 AST 与返回值核对。原隔离脚本、原隔离输出和便携单文件附件继续保留在作者研究归档;本文不提供单独附件下载。 ↩︎
-
pytest 官方退出码说明,随稿绑定核对时的官方源码提交与摘录。 ↩︎
-
既有
run_qwen_a6000_real_git_agent_probe.py与 2026-08-22 脱敏 JSON 记录,来源对象PRAC-20260822-0001。本轮仅核对实现和记录,不作为模型身份确认或当日新实测。 ↩︎ -
qwen38-a6000-series.zip中research/qa-report.mdL43、L54;它说明 mock 范围,本文未沿用包内性能或型号结论。 ↩︎ -
vLLM 官方 ModelConfig,
served_model_name的 API 名称语义;随稿保存固定源码和核对日。 ↩︎