探针超时重构:从300秒总时长闹钟到空闲看门狗
一句话结论:一个跑在终端里的 Java 诊断探针,在两轮评测中经历了「11/14 通过」到「0/9 通过」的坠落,根因不是模型变慢,而是超时机制掐错了维度------它量的是"这次调用总共等多久了",而该量的是"多久没有动静了"。本文完整复盘这次缺陷的归因过程,并逐行走读修复后的全部源码:空闲看门狗怎么续期、超时后那条还在吐字的流怎么办、失败的花费怎么记账、中断时怎么给用户一个交代。
0. 先对齐术语
本文反复出现几个"土话",先给出业界标准名词对照,后文一律按标准名词使用:
| 本文土话 | 业界标准名词 | 一句话解释 |
|---|---|---|
| 总时长闹钟 | Request Timeout(请求级总超时) | 从请求发出起算一个固定截止时间,到点没完成即失败 |
| 空闲看门狗 | Idle Timeout(空闲超时,同 HTTP 的 Read Timeout 思想) | 只量"最近一次收到数据距今多久",与总时长无关 |
| 续期 | 滑动窗口(Sliding Window) | 每来一个数据包,把计时窗口从头重新数满 |
| 孤儿流 | Orphan Stream(孤儿请求/孤儿响应) | 调用方已放弃等待,但服务端仍在生成、回调仍在到达的那条流 |
| 隔离闸门 | Invalidation Flag(作废标志,读侧防护) | 不终止生产者,只让消费者拒绝转发迟到数据 |
| 降上下文重试 | Context Degradation(降级负载重试) | 重试时主动缩小请求体,提高慢环境下的成功率 |
| 四段兜底 | Fallback Exit(降级出口) | harness 用已采集数据替模型渲染一份"标记过的不完整报告" |
| 退出码 3 | Exit Code(与 1 语义分离) | "中断但有兜底输出"独立于"纯失败",供评测与 CI 分开统计 |
一个总览性的工程判断先放在这里:流式调用的超时语义应该对齐 HTTP 的读超时(read timeout),而不是请求超时(request timeout)------只要对端还在持续发数据,连接就是活的;判死的依据只能是"静默",不能是"总耗时"。
1. 现象:同一份代码,两种结局
我们给探针搭了套 promptfoo 评测:固定问句问探针,判分模型按 ground truth 打分。两轮评测之间探针代码一行没改,结局完全相反:
| 指标 | S5 全量(14 场景 ×1) | S6 复现率(3 场景 ×3) |
|---|---|---|
| 诊断中断 | 0 | 8 / 9 |
| 四段报告齐全 | 9 / 14 | 1 / 9 |
| 判分通过 | 11 / 14 | 0 / 9 |
| 单条耗时 | 0--606 秒(中位约 180) | 303--657 秒(均值约 386) |
| 中断样本耗时 | --- | 303 / 304 / 304 / 309 / 313 ... |
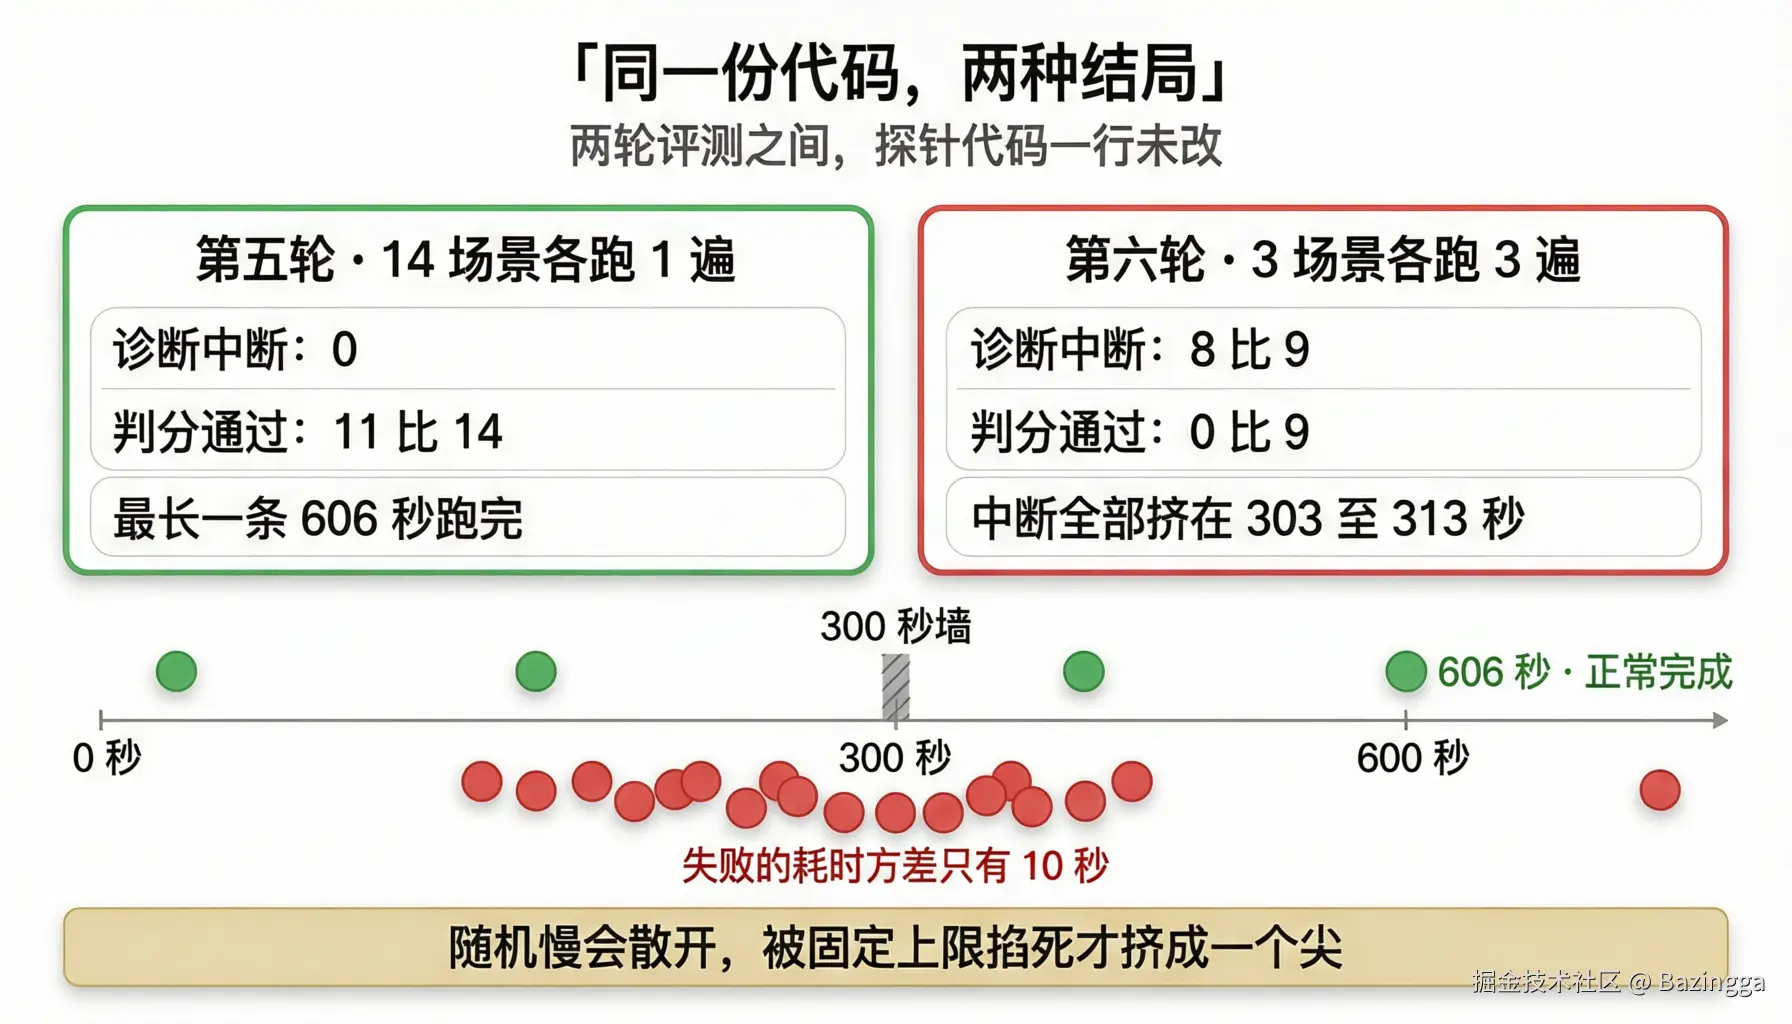
最扎眼的是最后一行:八次中断的耗时精确挤在 303--313 秒这个 10 秒宽的窗口里。随机性的慢会散开(像 S5 那样从 0 到 606 秒铺满整个轴),被一个固定上限掐死才会挤成一个尖。而 S5 里明明有一条 606 秒跑完并正常出报告的样本------同一个探针,为什么 600 秒能活、300 秒就死?
答案藏在更细的粒度上:探针的诊断是分段的,墙量的不是"整轮诊断耗时",而是"单次模型调用耗时"。606 秒那条样本是多次模型调用累加的结果,每次都没撞线;S6 那一小时上游变慢,单次调用被拖过了 300 秒,一撞即死。
再看中断样本内部的结构,八次中断死在两个完全不同的位置:
| 中断类型 | 次数 | 取证数 | 说明 |
|---|---|---|---|
| 第一拍就死 | 5 / 8 | 0 次工具调用 | 意图/计划那一拍没返回,stdout 只剩一行异常 |
| 做到一半死 | 3 / 8 | 8--12 次工具调用 | 证据已取齐,死在收口前,全部作废 |
这两类在"只看结果"的视角里长得一模一样(都是中断),但病因不同:零取证那一类靠重试 能救;证据已齐那一类重试未必成功,必须靠账本降级出口才救得回来。两类各占一半,决定了后面"重试"和"兜底"两件事都要做。
2. 修复前的代码:一把闹钟,四个缺陷
修复前的模型接入层(ProbeProvider)大约是这样(摘自修复前版本,保留原貌):
java
private static final int MAX_RETRIES = 3;
private static final long STREAM_TIMEOUT_SECONDS = 300;   // 一把总时长闹钟

public ModelReply chat(List<ProbeMessage> messages, List<ToolSpecification> specs,
                      Consumer<String> tokenSink) {
    long backoff = 2000;
    for (int attempt = 1; attempt <= MAX_RETRIES; attempt++) {
        try {
            return tokenSink == null ? callSync(messages, specs) : callStream(messages, specs, tokenSink);
        } catch (Exception e) {
            if (!rateLimited(e) || attempt == MAX_RETRIES) {   // ② 只认限流才重试
                throw new IllegalStateException("模型调用失败:" + messageOf(e), e);
            }
            sleep(backoff);
            backoff *= 2;
        }
    }
    throw new IllegalStateException("模型调用失败:重试耗尽");
}

private ModelReply callStream(List<ProbeMessage> messages, List<ToolSpecification> specs,
                              Consumer<String> sink) throws Exception {
    CompletableFuture<ChatResponse> future = new CompletableFuture<>();
    StringBuilder text = new StringBuilder();
    streaming.chat(request(messages, specs), new StreamingChatResponseHandler() {
        @Override
        public void onPartialResponse(String token) {
            sink.accept(token);
            text.append(token);          // token 一直在来
        }
        @Override
        public void onCompleteResponse(ChatResponse r) { future.complete(r); }
        @Override
        public void onError(Throwable e) { future.completeExceptionally(e); }
    });                                  // ③ 返回 void,无人持有句柄
    ChatResponse response = future.get(STREAM_TIMEOUT_SECONDS, TimeUnit.SECONDS);   // ① 总时长闹钟
    rememberUsage(response);             // ④ 在等待之后 → 超时路径走不到
    return toReply(response.aiMessage(), text.toString());
}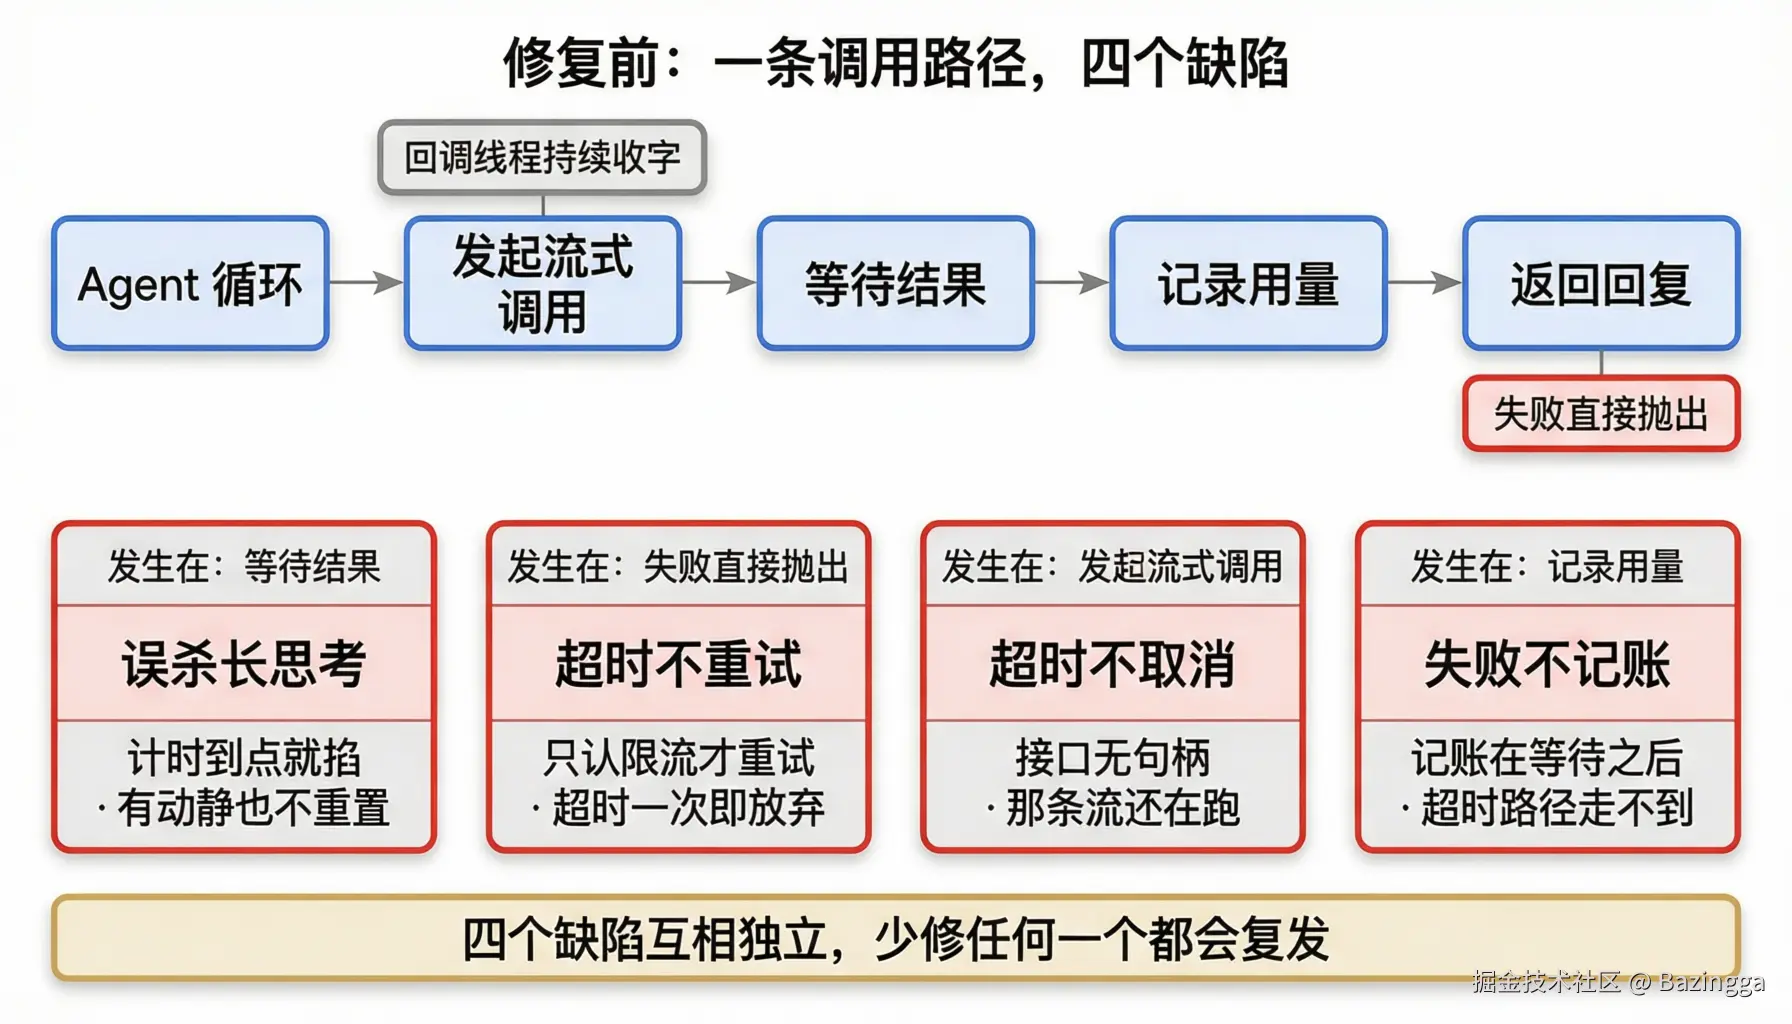
四个缺陷互相独立地叠在这条路径上:
- 掐错维度 :
future.get(300, SECONDS)的语义是"从这一刻起最多等 300 秒",它不知道、也不关心这 300 秒里流上有没有动静。token 哗哗地吐、只差 20 秒答完的调用,和连接彻底僵死、一个字都不来的调用,被同一把尺子掐死。 - 不重试 :重试条件只认限流(
rateLimited(e)判 429/Throttling),TimeoutException不在名单里 → 超时第一次撞线即放弃。重试代码明明存在,但对超时形同不存在。 - 不取消 :
streaming.chat(...)发起后返回void(用 javap 核对过 LangChain4j 1.4.0 的StreamingChatModel接口签名,就是void chat(ChatRequest, StreamingChatResponseHandler))------发起方没有任何句柄可以拿去关掉这次调用。 - 不记账 :
rememberUsage(response)在future.get的下一行,超时抛异常时根本执行不到 → 这笔已经烧掉的钱连内部统计都不出现。
还有一个隐蔽的时序讽刺:探针其实有两道像样的保护------失败熔断(按工具结果分类计数)和轮次/墙钟预算(每段最多 8 次调用、900 秒)。但这两道都只在"一次动作完成之后"才检查 :熔断数的是工具返回的结果对象,预算检查点在轮末。而超时发生在"问模型的那一瞬间"------这一轮根本没有"完成",既不产生可数的结果,也走不到轮末检查。细墙 300 秒先塌,于是接了降级机制的粗墙 900 秒永远没机会被检查。容错机制的覆盖面等于它的输入面,挂在"结果"上的保护,天生管不到"没有结果"的失败。
3. 掐错维度:两种慢,两把尺子
看到 300 秒这个数字,第一反应是"上游模型时延劣化,把超时调大就行"。这个判断对了一半:那一小时确实变慢了,但把结论停在这里会得出错误修法------把 300 改成 600,只是把误杀线后移:
- 慢但有进展的调用(在推理,token 一直来,只是需要 400 秒)依旧分不清"在思考"还是"已僵死";
- 真僵死的连接依旧要白等满 600 秒才被发现,检测反而更慢了。
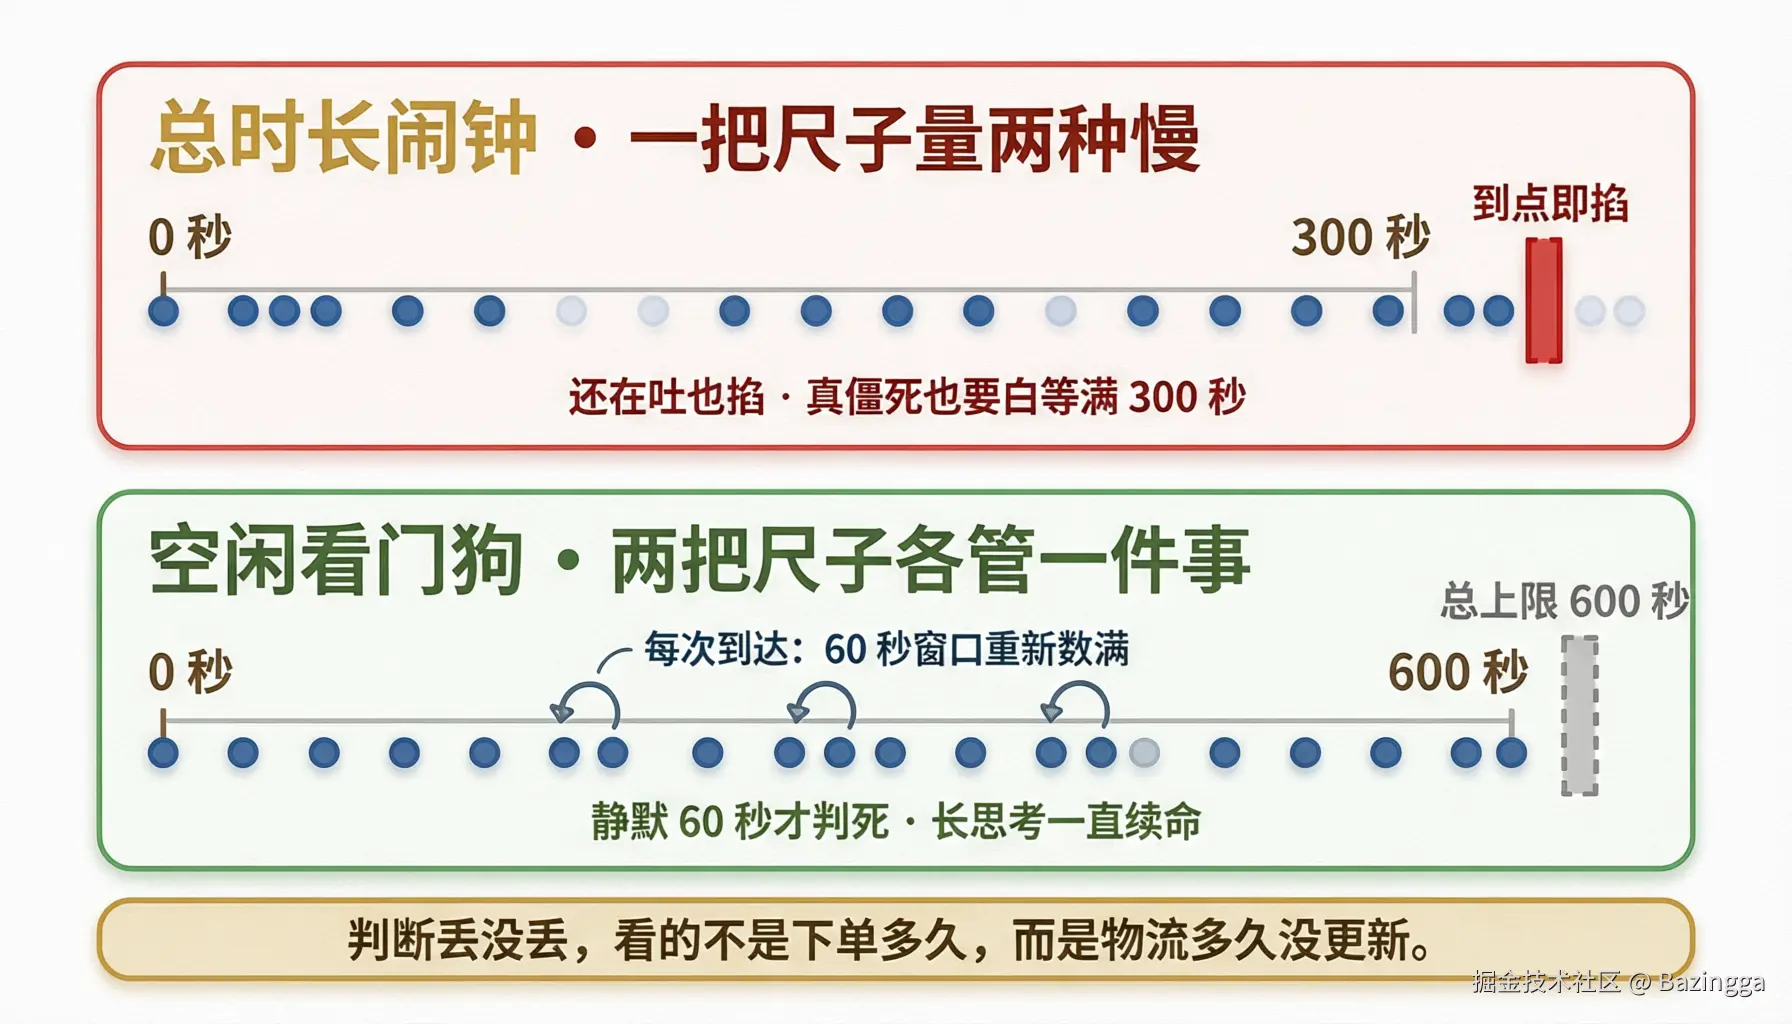
正确的量是静默时长:判断快递丢没丢,看的不是"下单多久了",而是"物流信息多久没更新"。这两种慢需要两把尺子分开量:
| 尺子 | 量什么 | 默认值 | 谁来兜底 |
|---|---|---|---|
| 静默窗口(Idle Timeout) | 距最近一次增量的时长 | probe.stream-idle-seconds = 60 |
专治真僵死:早退 |
| 总时长上限(Request Timeout) | 距调用发起的时长 | probe.stream-total-seconds = 600 |
专治无限拖尾:封顶 |
两把尺子缺一不可:只留静默窗口,理论上一个每 59 秒吐一个字、永远答不完的流会无限续命;只留总上限,就退回成旧闹钟。总上限同时也是 HTTP 客户端层(OkHttp)的 timeout 配置------应用层看门狗先掐,网络层超时是最后防线。
4. 看门狗的实现:续期到底怎么续
这是重构的核心,也把参数一次说清:怎么续、续多久、多长时间判定。
4.1 三个问题的直接回答
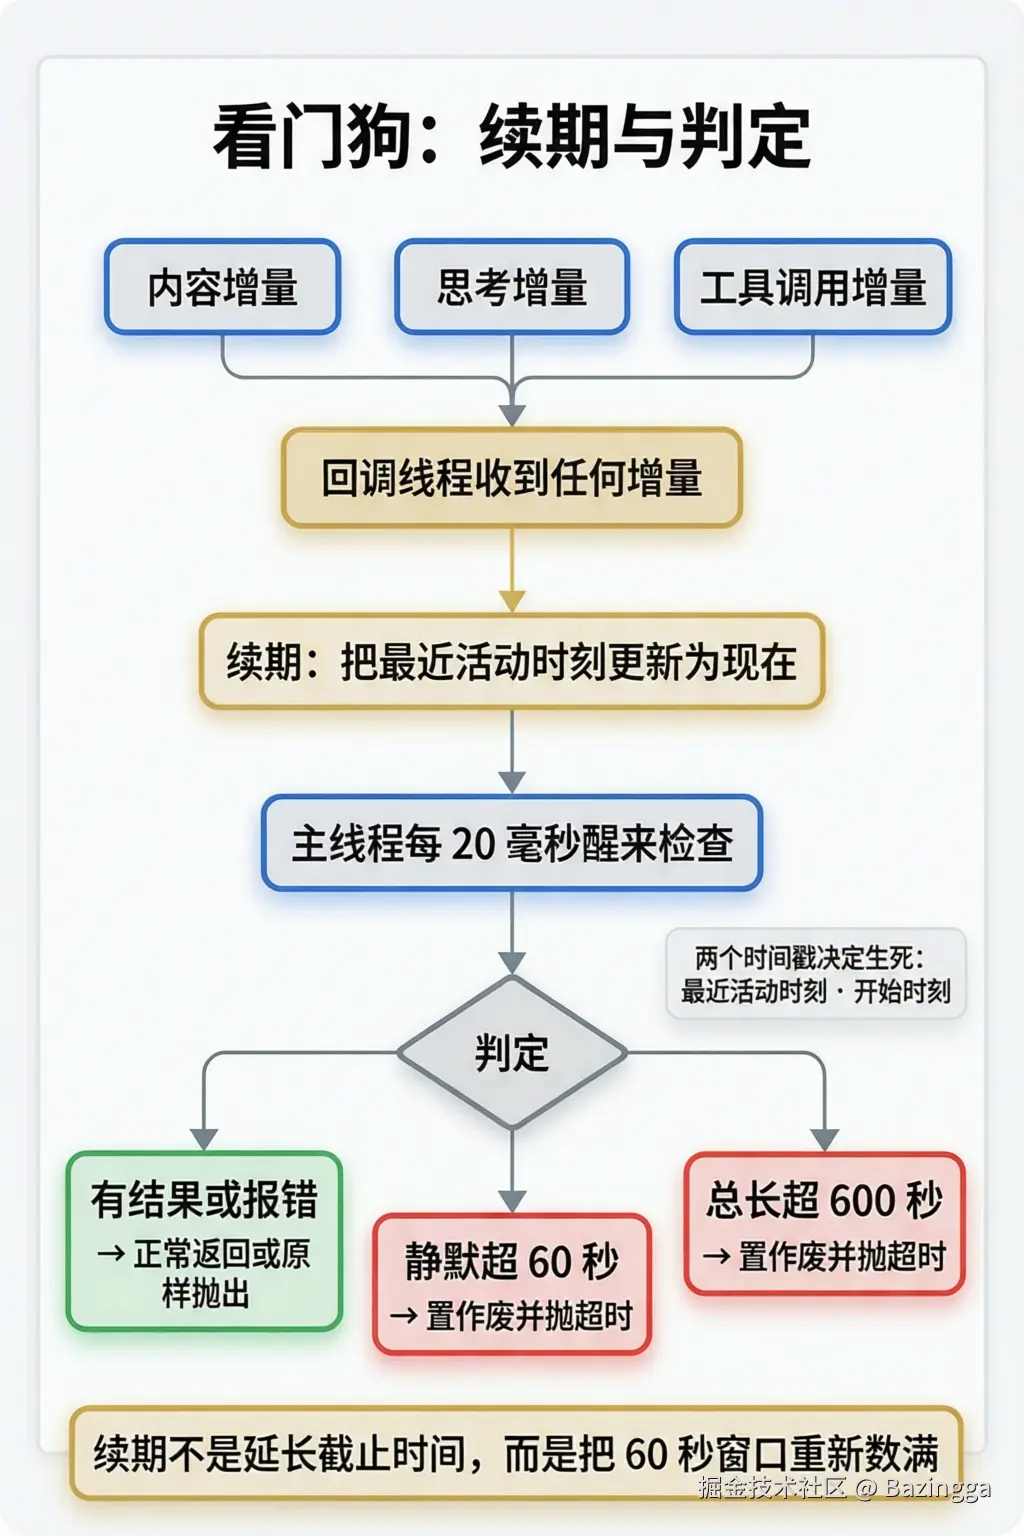
Q1:续期的触发条件是什么? 不是"期间有 token 消耗"这个累计事实,而是"最近一次增量到达的时刻"。每收到任何一个增量------正文增量、思考增量、工具调用增量都算------就续一次。
Q2:续期动作具体是什么? 一行赋值:把 lastActivityNanos 更新为 System.nanoTime()。没有计时器对象、没有闹钟重设、没有回调注册,就是写一个 volatile long。
Q3:每次续多久? 每次都把 60 秒的静默窗口从头数满。注意这是滑动窗口语义,不是"顺延固定截止时间"------不存在一个可以被推后的 deadline,只存在一个不断被刷新的"最近活动时刻"。续期次数没有上限(第 100 个增量照样续满 60 秒),无限续命的风险由总上限 600 秒封顶。
Q4:判定节奏多长? 等待方主线程每 20 毫秒醒来检查一次,每次检查比较两个时间戳(见下)。检测粒度 = 20ms 轮询 + 判定,实际退出时间会略超阈值(单测里 idle=1s 时实测 0.9--1.8 秒退出)。
4.2 全部源码:StreamGate
看门狗是一个 79 行的类,StreamGate,把"什么时候算失败、失败后那条流怎么处理、那笔账怎么记"收在一处:
java
public final class StreamGate {

    private final long idleNanos;
    private final long totalNanos;
    private final long startNanos = System.nanoTime();
    private volatile long lastActivityNanos = System.nanoTime();   // 每次增量刷新
    private volatile boolean abandoned;                            // 作废标志
    private volatile ChatResponse result;
    private volatile Throwable error;
    private volatile String partialText = "";                      // 半截输出(记账用)

    public StreamGate(long idleSeconds, long totalSeconds) {
        this.idleNanos = idleSeconds * 1_000_000_000L;
        this.totalNanos = totalSeconds * 1_000_000_000L;
    }

    /** 每收到一个增量(内容或思考)即重置静默计时。 */
    public void markActivity(String piece) {
        lastActivityNanos = System.nanoTime();      // ← 续期动作本体:滑动窗口重置
        if (piece != null) {
            partialText = partialText + piece;     // 顺手攒半截输出,失败估算用
        }
    }

    public void complete(ChatResponse response) { result = response; }
    public void fail(Throwable t) { error = t; }

    /** 超时后作废:迟到回调只记账不转发终端(API 层无取消句柄,只能自己拦)。 */
    public void abandon() { abandoned = true; }
    public boolean isAbandoned() { return abandoned; }
    public String partialText() { return partialText; }

    /** 等待完成:静默超 idle 或总时长超 total 即抛 TimeoutException;上游报错原样抛出。 */
    public ChatResponse await(long pollMillis) throws Exception {
        while (true) {
            if (error != null) {
                throw new IllegalStateException(String.valueOf(error.getMessage()), error);
            }
            if (result != null) {
                return result;
            }
            long now = System.nanoTime();
            if (now - lastActivityNanos > idleNanos       // 尺子一:静默超 60 秒
                    || now - startNanos > totalNanos) {  // 尺子二:总长超 600 秒
                abandon();                               // 置作废,此后迟到回调只记账
                throw new TimeoutException("流式响应静默或超时(idle " + idleNanos / 1_000_000_000L
                        + "s / total " + totalNanos / 1_000_000_000L + "s)");
            }
            Thread.sleep(pollMillis);                    // 20ms 轮询
        }
    }

    public ChatResponse await() throws Exception { return await(20); }
}
几个设计决策值得单独解释:
为什么手写轮询循环,而不用 future.get(timeout)? 因为要同时量两个维度。CompletableFuture.get(timeout) 只能表达一个截止时间,而静默窗口需要一个可以被另一条线程不断刷新的基准值------这天然是一个轮询比较结构,而不是一次性的阻塞等待。这也是整个重构最小的"形状变化":等待逻辑从"注册一个闹钟"变成"循环里比较两个时间戳"。
为什么 lastActivityNanos、result、error 都是 volatile? 因为它们是两条线程的通信信道:回调线程(LangChain4j 的流式回调跑在 OkHttp 的读线程上)写,主线程读。volatile 保证可见性------主线程下一次循环一定能看到回调线程刚写入的最新活动时刻。没有加锁,因为这里全是单写多读的简单字段,volatile 足够。
为什么 60 秒静默、600 秒总长这两个数? 静默 60 秒:上游正常吐字间隔通常在几十毫秒到几秒级,60 秒一个增量都没有基本可判死(这也是可配置项,实际压到多低需要结合上游长尾观察调整);总长 600 秒:取旧闹钟 300 秒的两倍------S5 实测有 606 秒跑完的正常样本,上限必须高过"正常的慢"。两者都通过 ProbeConfig 可配,与整轮诊断预算 diag.time-budget-seconds 解耦。
4.3 哪些信号算"活着":三个回调一个都不能漏
看门狗的活性判定覆盖三类增量,缺一类就会引入新 bug:
java
streaming.chat(request(messages, specs), new StreamingChatResponseHandler() {
    @Override
    public void onPartialResponse(String token) {
        gate.markActivity(token);                       // 正文增量:续期
        if (sink != null && !gate.isAbandoned()) {      // 作废后只记账不转发
            sink.accept(token);
        }
    }

    @Override
    public void onPartialThinking(PartialThinking thinking) {
        // 思考增量同样是活动:不认它就会把长思考误判成静默(新 bug 的入口)
        gate.markActivity(thinking == null ? "" : String.valueOf(thinking.text()));
    }

    @Override
    public void onPartialToolCall(PartialToolCall call) {
        gate.markActivity("");                          // 工具调用参数增量:也算活动
    }

    @Override
    public void onCompleteResponse(ChatResponse r) { gate.complete(r); }
    @Override
    public void onError(Throwable e) { gate.fail(e); }
});
ChatResponse response = gate.await();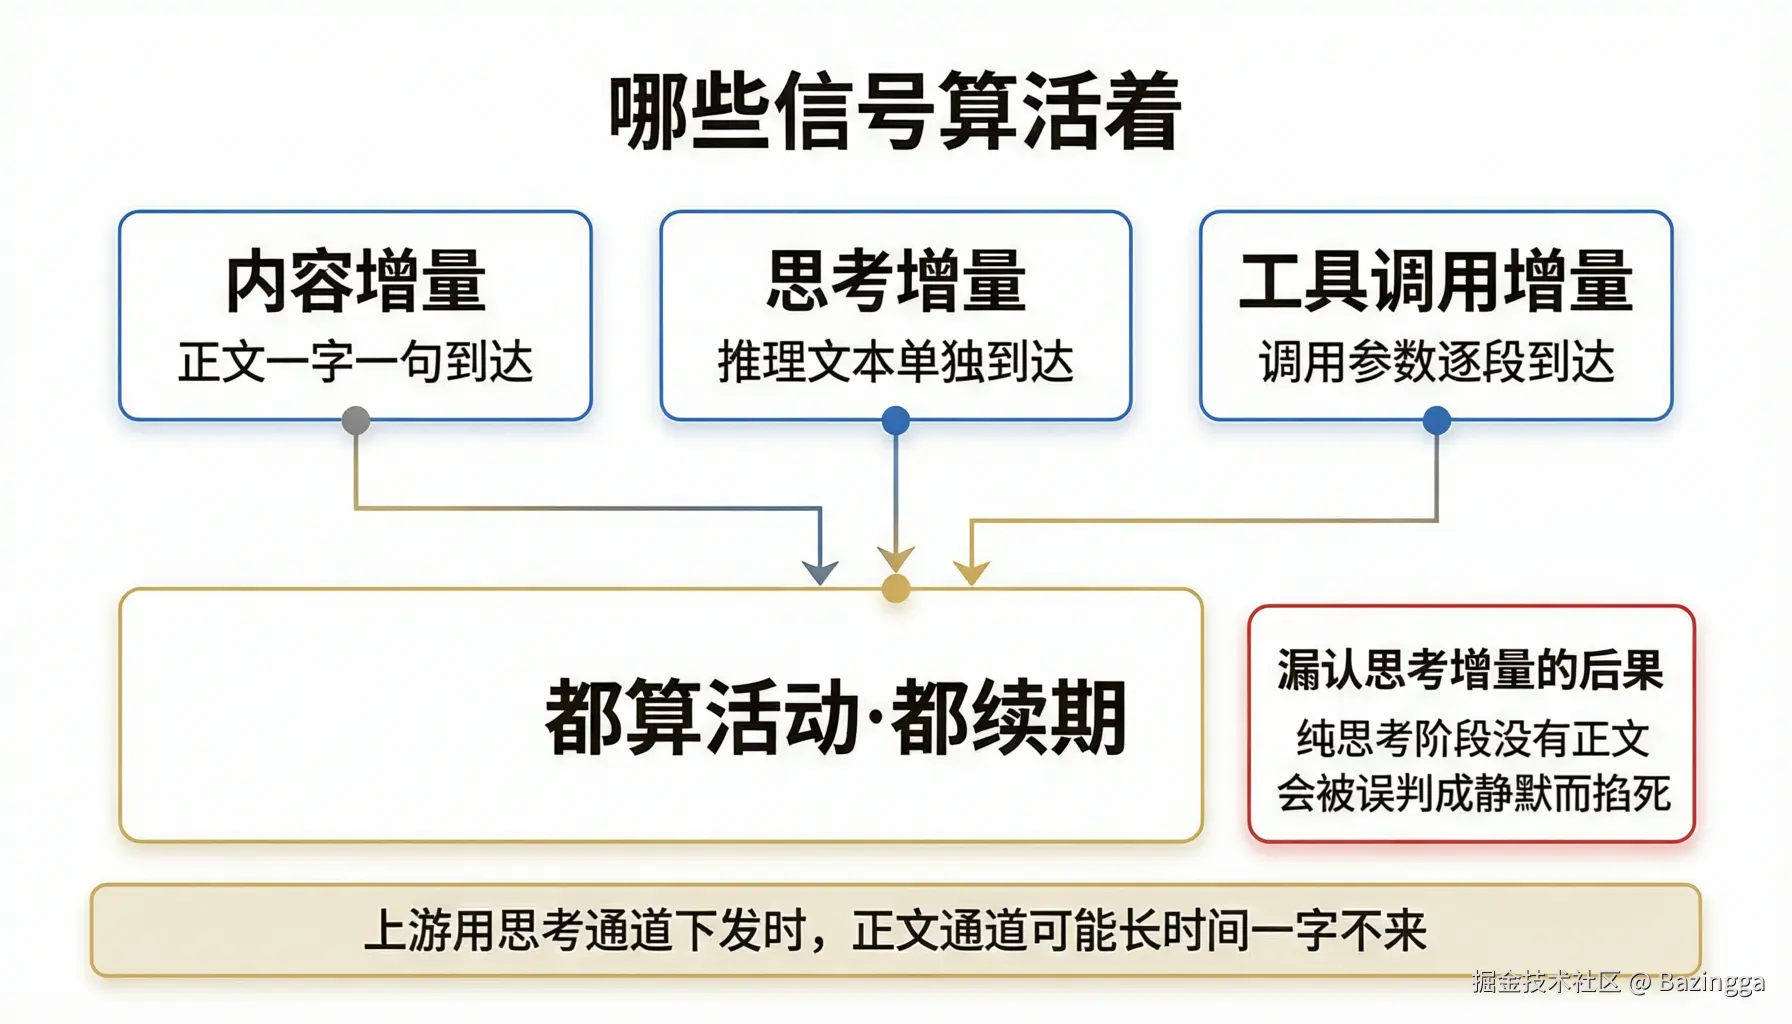
为什么必须认思考增量 :推理模型经常把整个推理过程放在 thinking 通道下发,正文通道可能几十上百秒一个字都不来。如果看门狗只认 onPartialResponse,那么一个思考了 61 秒、马上就要出正文的调用会被当成僵死掐掉------旧缺陷刚修完,立刻引入一个更隐蔽的新缺陷。这条不是理论推演:验收清单里专门写着"必须同时认 onPartialResponse 与 onPartialThinking,否则纯思考阶段会被误判成静默(这是新 bug 的入口)"。
5. 超时之后模型还在跑:取消做不到,隔离做得到
这是整个修复里最反直觉的一段。用户在超时后的直觉是"那把模型关掉啊"------但关不掉:
- 流式接口
StreamingChatModel.chat(request, handler)返回void(javap 核对过 LangChain4j 1.4.0 接口签名),发起方拿不到任何句柄; - 没有句柄,就没有
cancel()可调,没有Future可取消,没有Closeable可关闭。
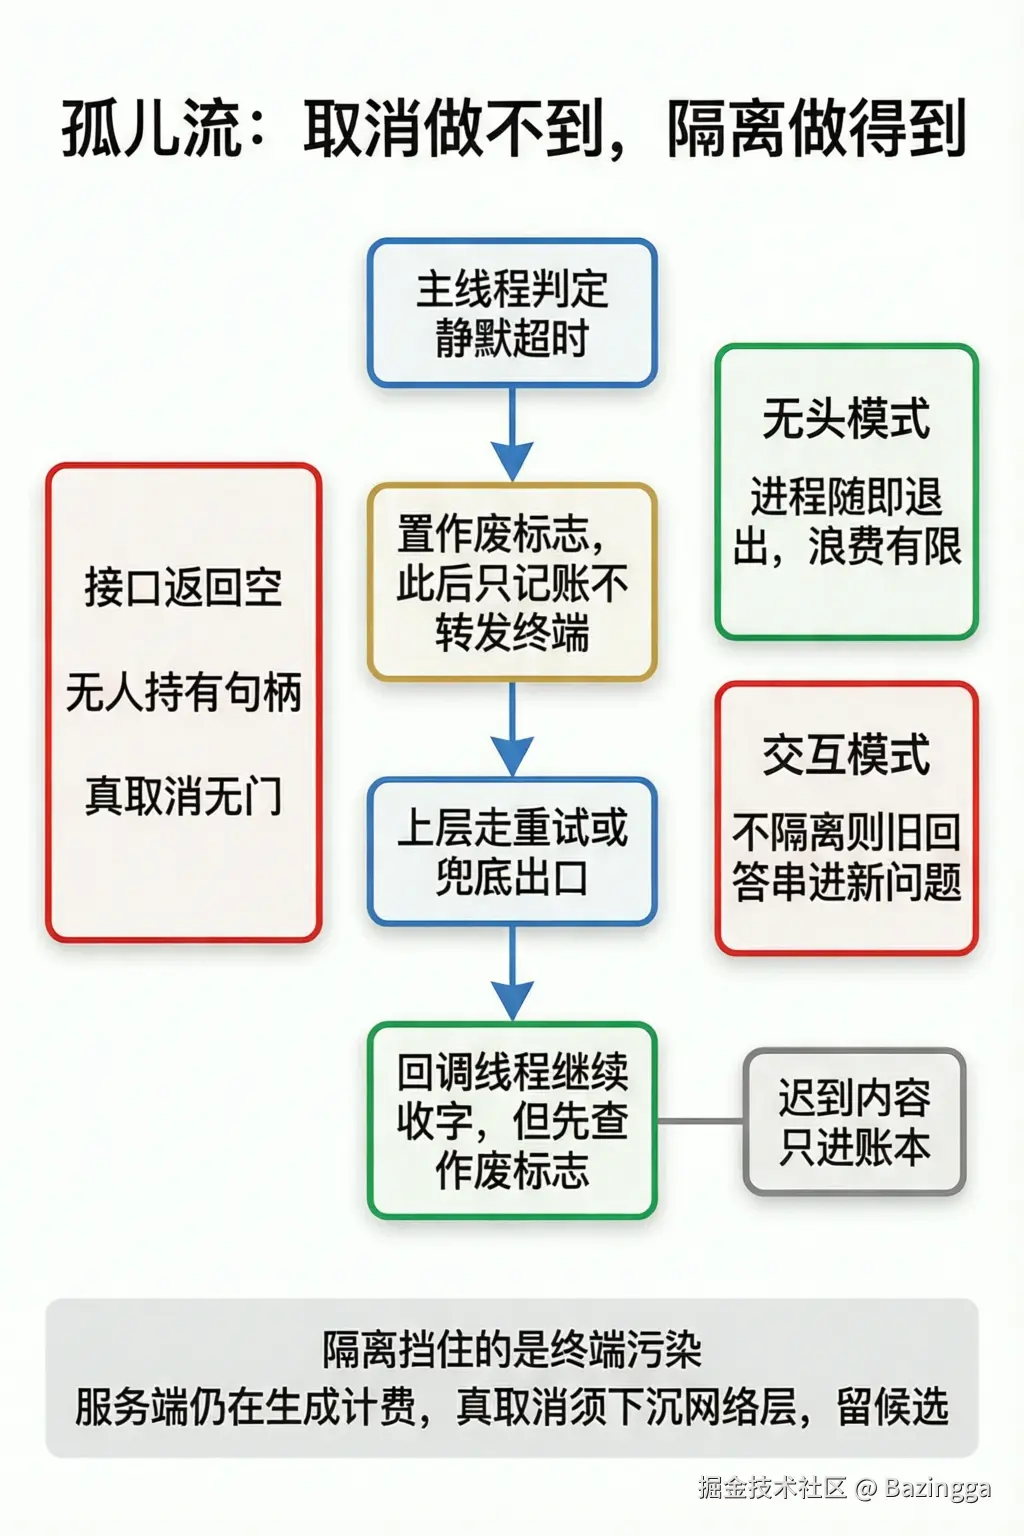
所以超时抛出时,那条流还活着:回调线程继续收 token、继续写当初传进去的 sink、服务端继续生成、继续计费。这条被调用方放弃了的流,就是"孤儿流"。
5.1 我们能做的:隔离,而不是取消
做法是给输出通道外包一层作废标志。超时判定一成立,await() 里先调 abandon() 置位 volatile 布尔,再抛异常;此后回调线程再收到迟到的 token 时,callStream 的回调里那行判断------if (sink != null && !gate.isAbandoned())------就把它拦在终端之外。迟到内容并非完全丢弃:markActivity 仍然往 partialText 里攒(供失败记账估算),只是不再转发给终端。
这个设计的价值按运行形态差别很大:
- 无头模式(一条命令跑完即退出):进程紧接着就退出了,孤儿流活不过几秒,隔离的意义有限;
- 交互模式(REPL 常驻):进程不退出。不隔离的话,那条流会继续往你正在敲字的终端里喷 token,和下一轮的问题混在一起------"上一轮的回答突然又开始往外冒"就是这个场景。隔离闸门专治这个。
5.2 诚实边界:隔离挡住了什么,没挡住什么
必须说清楚:隔离挡住的是"终端污染"和"重复转发",挡不住服务端继续生成和计费。迟到 token 只是只记账不转发,服务器那边该生成完还是生成完。真止损只有三条路:
- 下沉到 HTTP 客户端层做真取消 :绕开 LangChain4j 的 void 接口,自己持有 OkHttp 的
Call对象引用,超时时调call.cancel()断开 TCP 连接。上游若感知到连接断开,可能 提前停住生成(是否真停取决于上游实现,SSE 服务端不保证感知客户端断开)。这是彻底解法,但要侵入模型接入层、替换掉框架的流式封装------评估后判定收益不抵成本,留作候选; - 换用带取消语义的客户端 API:等上游框架提供 cancellation token / 请求取消能力,应用层零改动接入;
- 压 max_tokens:治本是缩短"最多烧多少",而不是"烧到一半掐掉"------对高频失败的复核/闭卷这类短输出通道已经这样做了。
当前实现的实际止损组合是三个动作叠加:早退 (静默 60 秒即放弃等待,不再陪着僵死连接白等 300 秒)+ 隔离 (迟到内容不转发)+ 不重投(失败后走降上下文重试或兜底出口,不再为同一条僵死流付费)。账单层面的 token 浪费由代码结构推断(回调链上没有中断点),未对账实测,这是登记在案的待验证项。
6. 重试:先分类,再降级
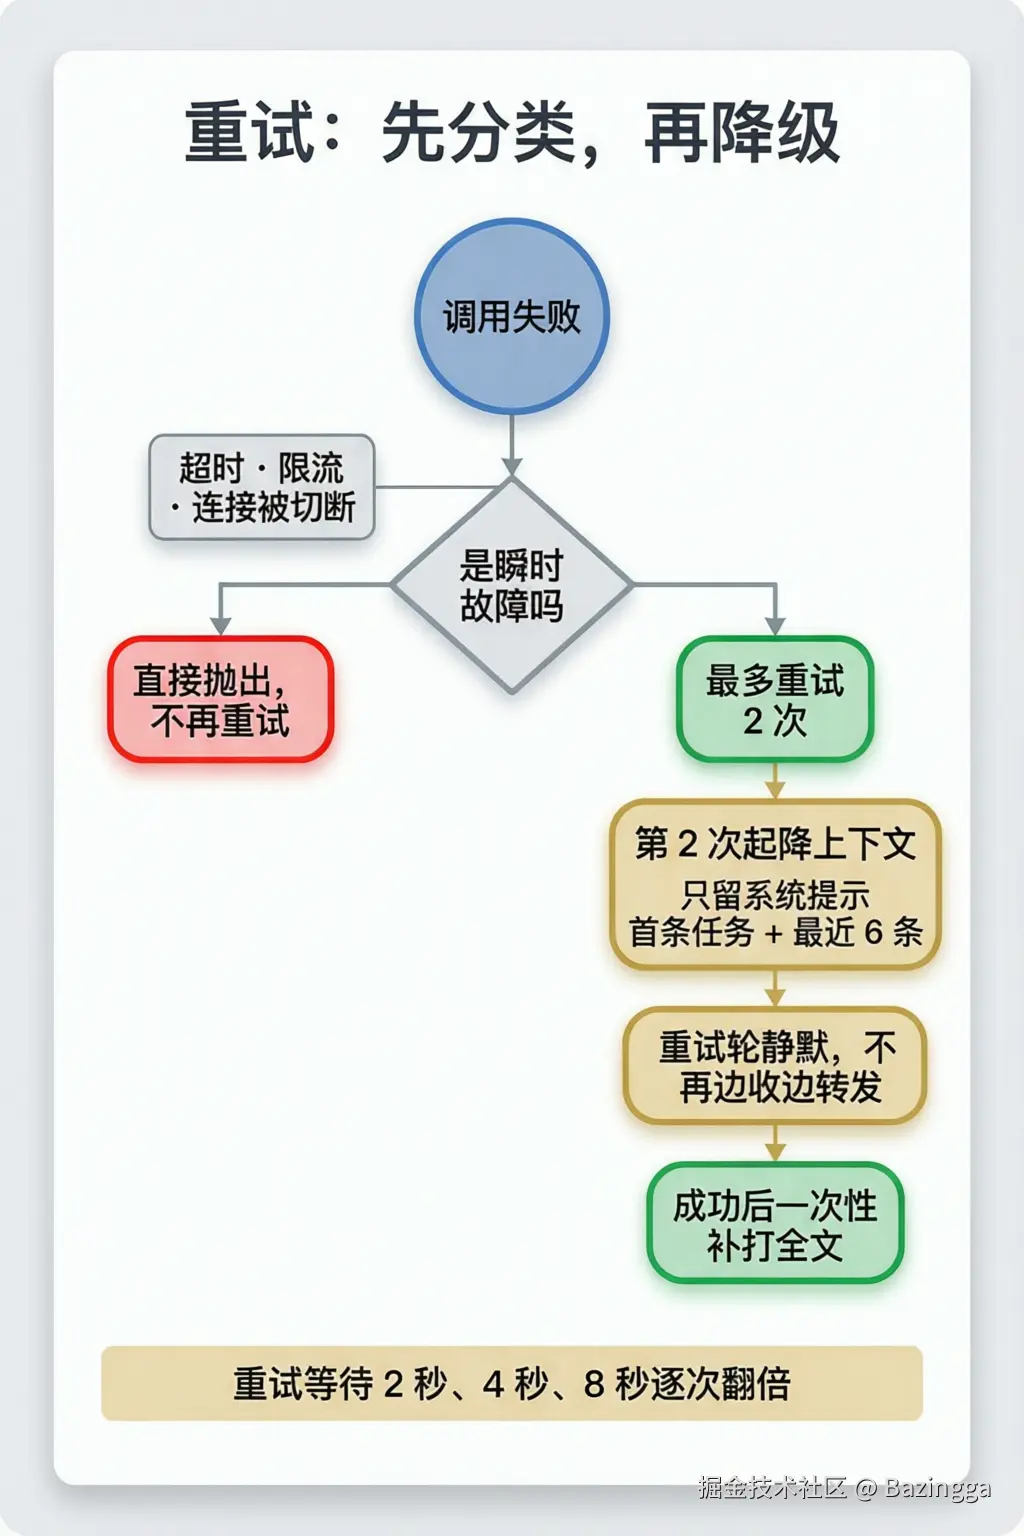
超时既然纳入可重试范围,第二个问题跟着来:拿什么重试?上游已经慢到超时了,原样再发一遍大概率再超时。所以重试不是简单 for 循环,分两步:先分类(什么错值得重试),再降级(重试时把请求体瘦身)。
java
public final class RetryPolicy {

    private static final int DEGRADED_TAIL = 6;

    /** 可重试的瞬时故障特征。 */
    private static final List<String> TRANSIENT = List.of(
            "429", "limit_requests", "Throttling", "timeout", "timed out", "静默",
            "EOF reached", "Connection reset", "Connection closed", "connection aborted",
            "stream was reset");

    public static boolean shouldRetry(Throwable e, int attempt, int maxAttempts) {
        if (attempt >= maxAttempts) {
            return false;                       // 最多 model.max-attempts(默认 3)次尝试
        }
        Throwable cur = root(e);
        if (cur instanceof java.util.concurrent.TimeoutException) {
            return true;                        // 超时:类型判定,必重试
        }
        String msg = cur.getMessage() == null ? cur.toString() : cur.getMessage();
        for (String marker : TRANSIENT) {      // 限流、连接切断:字符串特征判定
            if (msg.contains(marker)) {
                return true;
            }
        }
        return false;                           // 其它(鉴权失败、参数错等):永久错误,不重试
    }
    ...
}
名单里有两个实测换来的细节:
- "静默" 也在名单里:看门狗抛的 TimeoutException 消息是"流式响应静默或超时(idle 60s / total 600s)",字符串特征兜底保证任何路径抛出的看门狗超时都可重试;
- EOF / Connection reset 类错误是附带发现:修复前这类"连接被切断"也不在可重试名单里,会白死一次。它们和超时、限流同属瞬时故障,一并纳入。
6.1 降上下文:重试轮的请求体瘦身
java
/** 降上下文:系统提示 + 首条用户任务 + 最近若干条。 */
public static List<ProbeMessage> degrade(List<ProbeMessage> messages) {
    if (messages.size() <= DEGRADED_TAIL + 2) {
        return messages;                        // 本来就小,不降
    }
    List<ProbeMessage> out = new ArrayList<>();
    ProbeMessage system = messages.get(0);
    out.add(system);                            // 系统提示:行为规范,必留
    ProbeMessage firstUser = null;
    for (ProbeMessage m : messages) {
        if (m.role().equals("user")) {
            firstUser = m;                       // 原始任务:丢了就不知道在干什么
            break;
        }
    }
    if (firstUser != null) {
        out.add(firstUser);
    }
    int from = Math.max(0, messages.size() - DEGRADED_TAIL);
    for (int i = from; i < messages.size(); i++) {
        ProbeMessage m = messages.get(i);
        if (m != system && m != firstUser) {
            out.add(m);                          // 最近 6 条:当前推理现场
        }
    }
    return out;
}保留三类内容:系统提示 (不带它模型连四段格式都不遵守)、原始任务 (不带它模型不知道在诊断什么)、最近 6 条消息(当前推理现场,直接决定这一拍要输出什么)。中间的长历史------工具调用的大段结果、被证据板反复注入的账本------全部丢弃。直觉是:如果上游慢是因为请求体太大(首拍 5 次零取证暗示过这个风险),瘦身重试直接对症;如果是上游单纯抖动,瘦身也不亏。
6.2 重试轮的终端体验:静默 + 一次补打
重试轮有个容易忽略的细节------如果继续把 tokenSink 传下去,第一轮已打印半截的答案会再从头打一遍,两截混在终端里。所以重试轮传 null sink 静默收流,成功后一次性补打全文:
java
for (int attempt = 1; attempt <= maxAttempts; attempt++) {
    try {
        // 重试轮静默(避免半截答案重复刷屏),成功后一次性补打全文
        ModelReply reply = tokenSink == null
                ? callSync(current, specs)
                : callStream(current, specs, attempt == 1 ? tokenSink : null);
        if (attempt > 1 && tokenSink != null && !reply.text().isBlank()) {
            tokenSink.accept(reply.text());     // 补打
        }
        return reply;
    } catch (Exception e) {
        accountFailedAttempt(current);          // 失败也记账(见第 7 节)
        if (!RetryPolicy.shouldRetry(e, attempt, maxAttempts)) {
            throw new IllegalStateException("模型调用失败:" + messageOf(e), e);
        }
        if (tokenSink != null) {
            tokenSink.accept("\n⚠ 模型调用" + (isTimeout(e) ? "超时" : "限流") + ",第 "
                    + (attempt + 1) + " 次尝试" + (attempt >= 2 ? "(降上下文)...\n" : "...\n"));
        }
        if (attempt >= 2) {
            current = RetryPolicy.degrade(current);   // 第二次重试起降上下文
        }
        sleep(backoff);                          // 指数退避 2s → 4s → 8s
        backoff *= 2;
    }
}
用户在终端上看到的效果是:答案打到一半卡住 → 一行 ⚠ 模型调用超时,第 2 次尝试... → 短暂静默 → 完整答案一次性出现。知道发生了什么,且不被半截文本刷屏。
7. 失败也要记账
旧代码里 rememberUsage(response) 在 future.get 之后,超时路径走不到------成功的花费记得清清楚楚,失败的花费一笔都不记。这不只是少算点钱:两轮评测单条耗时从 180 秒涨到 386 秒,我们无法判断"是上下文撑大了还是上游降速",因为唯一能区分二者的失败轮 token 数恰好不存在。
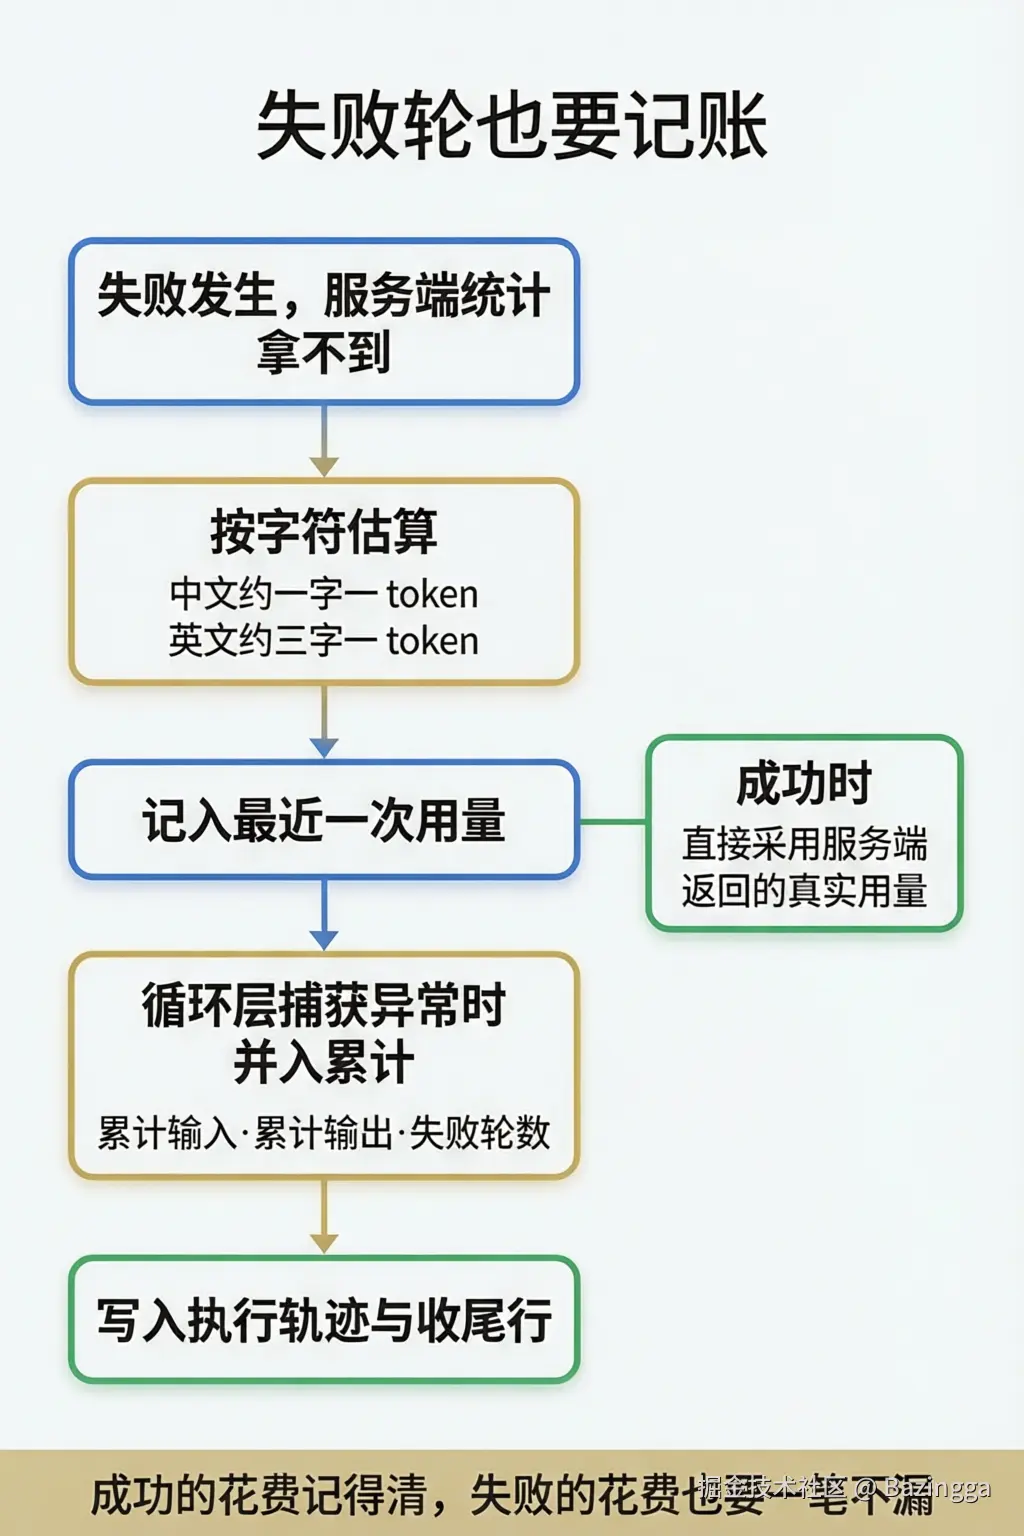
修复分两层。Provider 层:失败时若拿不到服务端统计,按字符估算补记:
java
/** 失败轮也记账:服务端统计拿不到时按估算补,至少让浪费可见。 */
private void accountFailedAttempt(List<ProbeMessage> messages) {
    if (lastIn == 0 && lastOut == 0) {
        lastIn = RetryPolicy.estimateInput(messages);   // 输入:整份请求体估算
        lastOut = RetryPolicy.estimateOutput(lastPartial);  // 输出:最近半截文本估算
    }
}
估算器是 CJK 感知的(TokenEstimator):中文约一字一 token,ASCII 约三字一 token。两条 volatile 字段 lastIn / lastOut 就是 Provider 向上暴露的用量通道,ProbeModel 接口为此加了两个 default 方法:
java
/** 最近一次尝试的用量(失败轮为估算值),供 Loop 记账。 */
default int lastInputTokens() { return 0; }
default int lastOutputTokens() { return 0; }
Loop 层:捕获模型异常的那一刻顺手并入累计------异常继续往外抛(让兜底出口接住),但账先记下:
java
long roundStart = System.currentTimeMillis();
ModelReply reply;
try {
    reply = model.chat(messages, specs, tokenSink);
} catch (RuntimeException e) {
    // 失败轮也要记账:否则超时那次白烧的钱永远看不见
    ctx.attrs().merge("usedIn", (long) model.lastInputTokens(), (a, b) -> (Long) a + (Long) b);
    ctx.attrs().merge("usedOut", (long) model.lastOutputTokens(), (a, b) -> (Long) a + (Long) b);
    ctx.attrs().merge("failedRounds", 1L, (a, b) -> (Long) a + (Long) b);
    throw e;
}
accountUsage(ctx, reply);        // 成功路径:服务端真实 usage
ctx.attrs().merge("rounds", 1L, (a, b) -> (Long) a + (Long) b);
ctx.attrs().merge("slowestRoundMs", System.currentTimeMillis() - roundStart,
        (a, b) -> Math.max((Long) a, (Long) b));   // 顺手记每轮耗时,供时延归因
一个诚实边界:超时那一轮的半截文本存在已作废的 gate 里,主线程抛异常后不再持有它的引用,lastPartial 记的是上一次成功轮的流式全文------所以第一次调用就超时的轮,输出估算只能是近似下界。这不影响它的用途(让浪费可见、量级可归因),但要知道它是估算不是对账。
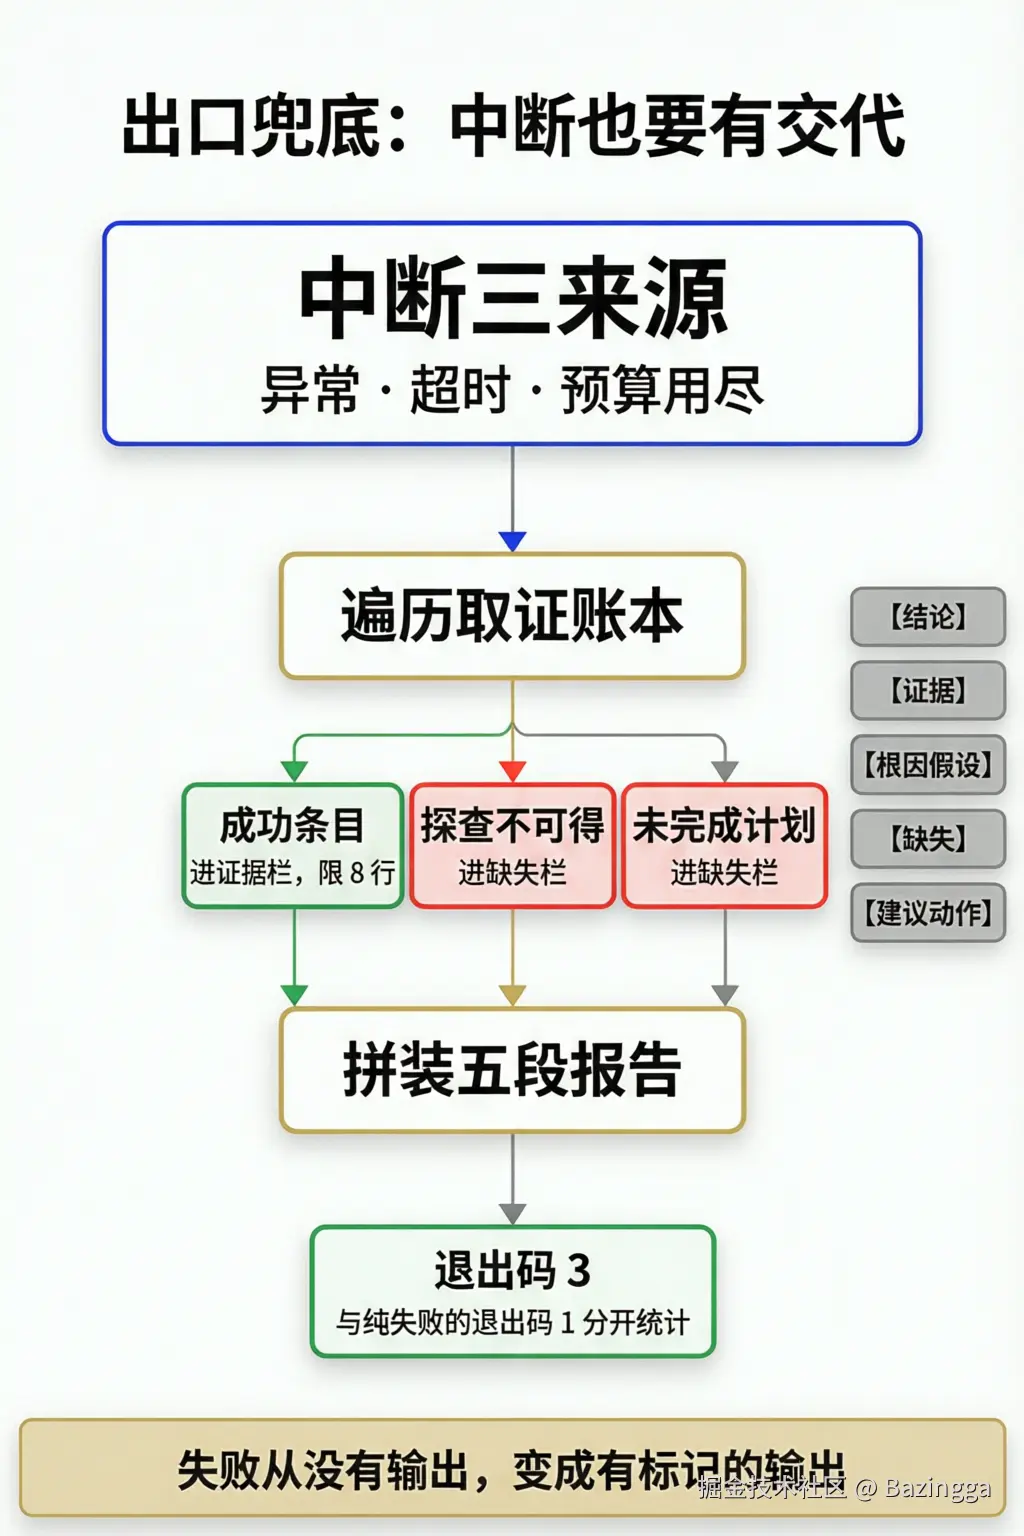
8. 出口兜底:中断也要有交代
最外层还有一个修复:异常抛到顶层时,旧代码只打印一行 ✗ 诊断中断:TimeoutException 就退出------用户拿到的是一行异常加空 stdout。S6 有一个样本:判分模型明确认可它引用的证据、没误判、没越权,内容满分,却因四段缺失判 0。四段全靠模型自觉遵守提示词,而中断的轮模型根本没来得及输出------harness 必须有出口兜底。
四段是探针的报告契约(FourSections):【结论】【证据】【根因假设】【建议动作(需人工执行)】,证据不足可加【缺失】段。兜底渲染器 ReportFallback 用已采集的账本替模型拼出这四段:
java
public static String render(String task, TraceStore store, String reason, List<String> openSteps) {
    List<TraceEntry> all = store == null ? List.of() : store.entries();
    List<String> proven = new ArrayList<>();
    List<String> missing = new ArrayList<>();
    for (TraceEntry e : all) {
        if (e.outcome() == Outcome.SUCCESS && proven.size() < MAX_EVIDENCE_LINES) {   // 证据栏限 8 行
            proven.add("- " + e.ref() + e.attribution() + " " + oneLine(e.head()));
        } else if (e.outcome() == Outcome.ENV_NEGATIVE) {   // 探查不可得 → 缺失栏
            missing.add("- " + e.ref() + e.attribution() + " 探查不可得:" + oneLine(e.head()));
        }
    }
    for (String step : (openSteps == null ? List.<String>of() : openSteps)) {
        missing.add("- 计划未完成:" + step);              // 未完成计划 → 缺失栏
    }
    StringBuilder sb = new StringBuilder();
    sb.append(FourSections.header(FourSections.CONCLUSION)).append('\n');
    sb.append("取证中断,结论不完整。中断原因:").append(reason == null ? "未知" : reason).append('\n');
    sb.append("(本段由 harness 依据已采集账本兜底渲染,非模型完整结论)\n\n");  // 显式"未收口"标记
    sb.append(FourSections.header(FourSections.EVIDENCE)).append('\n')
            .append(proven.isEmpty() ? "- (本轮无可采信取证记录)\n" : String.join("\n", proven) + "\n");
    ...
    sb.append(FourSections.header(FourSections.ACTION)).append('\n');
    sb.append("$ ./bin/probe diagnose -t \"").append(escapeQuote(task)).append("\"   # 重跑取证\n");
    ...
}
三个关键设计:
- 结论段显式自首:第一句就是"取证中断,结论不完整",第二行括注声明"由 harness 兜底渲染,非模型完整结论"------半份证据拼出来的判断必须一眼看出不是完整诊断,否则运维可能照着处置;
- 段名取自同一份契约 :兜底段名和提示词教模型的是同一套
FourSections常量。此前同一件事有三份写法(提示词写【】、中断兜底写分隔线、explain 写 Markdown 五段),判分只认【】------写错口径的通道必然 0 分,与模型能力无关; - 退出码 3 与 1 分离 :
ProbeMain顶层 catch 里渲染兜底后返回 3,纯失败仍返回 1------评测和 CI 可以把"中断但有交代"与"彻底崩了"分开统计:
java
} catch (Exception e) {
    System.out.println("✗ 诊断中断:" + rootMessage(e));
    System.out.println(ReportFallback.render(task, bundle.store(),
            e.getClass().getSimpleName() + ":" + e.getMessage(),
            bundle.orchestrator().openSteps()));
    // 退出码 3 = 中断但有兜底输出(1 留给纯失败),评测与 CI 可分开统计
    return 3;
}
"缺失"栏的数据源 openSteps() 挂在分段编排器上,暴露未完成的计划步骤------证据已齐但没来得及收口的那类中断,用户至少能看到"哪些查过、哪些没查、下一步补什么"。
9. 重构后的全景
把六层改动拼回一条路径,一次模型调用现在有四种结局,任何一条路都有出口:
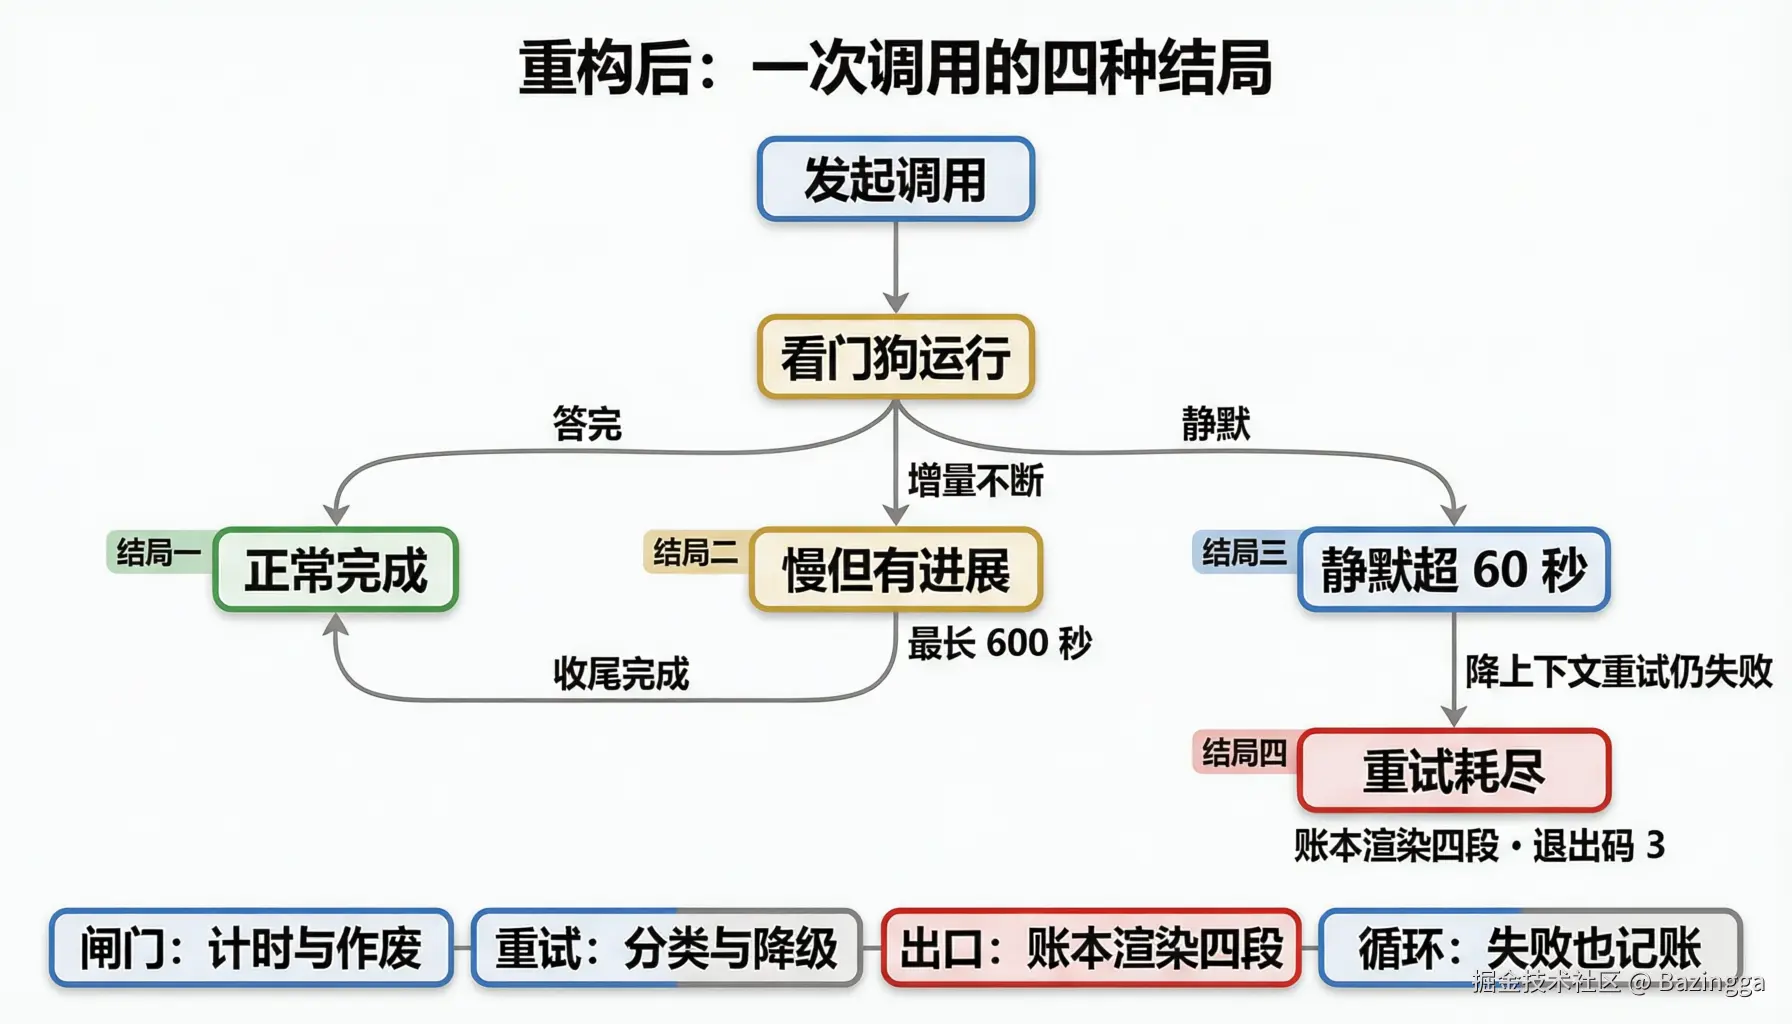
组件分工与参数速查:
| 组件 | 职责 | 关键源码 |
|---|---|---|
StreamGate |
双尺子计时 + 作废标志 + 半截文本 | provider/StreamGate.java(79 行) |
RetryPolicy |
瞬时故障分类 + 降上下文 + 失败估算 | provider/RetryPolicy.java(93 行) |
ProbeProvider |
编排:调用、重试循环、记账、静默/补打 | provider/ProbeProvider.java |
ReportFallback |
账本渲染四段兜底 | agent/ReportFallback.java(65 行) |
DiagnosticLoop |
失败轮并账 + 每轮耗时 | agent/DiagnosticLoop.java |
SegmentOrchestrator |
暴露未完成计划步骤 | agent/segment/SegmentOrchestrator.java |
| 配置项 | 默认值 | 语义 |
|---|---|---|
probe.stream-idle-seconds |
60 | 静默窗口:距最近一次增量多久判死 |
probe.stream-total-seconds |
600 | 总上限:单次调用封顶(同时是 HTTP 客户端层超时) |
model.max-attempts |
3 | 总尝试次数(含首次),第 2 次重试起降上下文 |
| 轮询间隔 | 20ms(硬编码) | await() 主线程检查频率 |
| 重试退避 | 2s 起,指数翻倍 | sleep(backoff); backoff *= 2 |
diag.time-budget-seconds |
900 | 整轮诊断预算,与单调用两把尺子解耦 |
10. 双向验收:怎么证明修对了
这类改动最容易"只验新能力、不验副作用"。看门狗尤其危险:阈值调小放过真卡死,调大又误杀长思考,两个方向的失败都很安静 。所以验收成对写,单测层面三个用例(StreamGateTest):
java
@Test
void 持续有增量时不被静默阈值掐死() throws Exception {
    StreamGate gate = new StreamGate(1, 30);          // idle=1s,故意压小
    // 后台线程 await(),前台每 120ms 喂一个增量,持续 2.4s
    for (int i = 0; i < 20; i++) {
        gate.markActivity("token" + i);
        Thread.sleep(120);
    }
    // 断言:全程没被掐------旧闹钟在 1s 就死了
    assertEquals(1L, done.getCount(), "持续吐增量却被掐了(看门狗掐错维度)");
}

@Test
void 真静默按空闲阈值退出() {
    StreamGate gate = new StreamGate(1, 60);          // 一个增量都不喂
    long t0 = System.currentTimeMillis();
    TimeoutException e = assertThrows(TimeoutException.class, gate::await);
    long cost = System.currentTimeMillis() - t0;
    assertTrue(cost >= 900 && cost < 1800, "应约 1s 退出,实测 " + cost + "ms");  // 不白等总上限
}

@Test
void 超时后孤儿回调被作废标记拦下() {
    StreamGate gate = new StreamGate(1, 60);
    assertThrows(TimeoutException.class, gate::await);
    assertTrue(gate.isAbandoned(), "超时必须置作废标志,此后迟到回调不得再转发终端");
}
第一个用例是旧缺陷的反证:同样的"持续喂增量",旧闹钟 300 秒必死,新看门狗续命到底;第二个用例证明真僵死早退------60 秒静默触发退出而不是陪到 600 秒总上限。
E2E 层面用假 LLM 桩构造僵死场景:scripts/fake-llm.py 里加了专门的僵死分支------先吐一个增量、然后不发结束标记挂住连接 120 秒,模拟"连上但不说话";同时把桩从单线程 HTTPServer 换成 ThreadingHTTPServer,否则僵死测试会阻塞后续请求:
python
if stream and "僵死" in body:
    self.send_header("Content-Type", "text/event-stream")
    self.end_headers()
    chunk = {"id": "stall", "choices": [{"index": 0,
               "delta": {"content": "先吐一点再卡住"}, "finish_reason": None}]}
    self.wfile.write(("data: " + json.dumps(chunk, ensure_ascii=False) + "\n\n").encode())
    self.wfile.flush()
    import time as _t
    _t.sleep(120)          # 不发 [DONE],模拟连接僵死
    return
实测结果(配置压到 idle=2s / attempts=3 以便快速触发):僵死连接 7 秒退出 (旧行为要陪满 300 秒)、重试提示 2 次、stdout 四段齐全、退出码 3。附带发现并修复:连接被切断(EOF/Connection reset)此前不在可重试名单,会白死一次------这是 E2E 跑出来后顺手并入 RetryPolicy 的。
完整验收矩阵(也是这类改动的通用清单):
| 方向 | 判据 | 构造方式 |
|---|---|---|
| 不误杀长思考 | 持续吐 token 到 500 秒不失败,正常收口 | 桩模型每 2 秒回一个增量、共 250 次后正常完成 |
| 能杀真僵死 | 静默后 60 秒内退出,不白等到总上限 | 桩模型发起后一个增量都不发 |
| 不丢账 | 失败轮 input/output 非零且进 trace | 同上,检查 trace 与收尾行 |
| 不串字 | 超时后后续增量不出现在终端 | 桩模型静默触发超时后继续吐 100 个增量 |
| 有出口 | 重试耗尽 → 四段齐全且标明中断原因,退出码 3 | 桩模型连续三次僵死 |
11. 可迁移的六条教训
- 流式调用的超时语义对齐"读超时"而非"请求超时":量静默,不量总长。总时长闹钟同时犯两个错------误杀慢而正常的推理、硬等才发现的僵死。
- 续期是滑动窗口,不是顺延截止时间:实现上只需要一个 volatile 时间戳,每次增量刷新;配一条不可续期的总上限封顶。两个时间戳、20 毫秒一轮询,79 行写完。
- 活性判定要覆盖全部增量通道:漏认思考增量,纯思考阶段就会被判静默------修超时修出新的误杀,是最容易踩的回归。
- 重试条件按错误类型分类,降级负载再投:超时、限流、连接切断同属瞬时故障;重试时主动瘦身请求体(系统提示 + 原始任务 + 最近几条),慢环境下成功率才真的提高。
- API 不给取消句柄时,止损用隔离实现:一个作废标志挡住迟到回调污染终端。同时诚实登记边界------隔离挡不住服务端计费,真取消要下沉网络层,评估收益不抵成本就留候选,别假装已经解决。
- 失败路径的记账和出口是修复的一部分,不是后续优化:没有失败轮的用量,"该抬上限还是加退避"这种决策只能靠猜;没有兜底出口,内容再对的诊断也会死在"没有输出"。一次超时缺陷的完整修复,是计时、重试、隔离、记账、出口五件事一起改------它们本来就是同一条失败路径上的五段。