上一篇解决了多轮对话里的指代和省略:先把「它多少钱」还原成独立 query,再送检索。但独立 query 也不天然适合检索。
用户说「设备老是卡住」,文档写的是「设备响应超时」;用户说「打印有黑道」,文档写的是「输出页面出现纵向条纹」。问题很完整,向量检索却可能因为措辞差异捞不到目标文档。
这类问题该做查询扩展:用 HyDE 或多 query 改写增加检索入口。这篇沿用前面的 pgvector + bge-m3 环境,给出最小实现、RRF 融合代码和一组分类型评测,最后说清两套方案怎么选。
一、先分清:查询重写和查询扩展不是一回事
这两个技术经常混在一起,实际解决的问题不同:
| 技术 | 输入的问题 | 目标 | 输出 |
|---|---|---|---|
| 查询重写(上一篇) | 「它多少钱」,离开上下文无法理解 | 补全指代和省略 | 一个独立 query |
| 查询扩展(本篇) | 「设备老是卡住」,语义完整但措辞不好检索 | 增加与用户措辞不同的检索入口 | 假设答案或多个 query 变体 |
多轮场景里两者可以串联:先重写还原意图,再判断是否需要扩展。 如果顺序反过来,先把「它多少钱」扩成三个没有主语的问题,后面只会更乱。
本篇评测里的 query 都已经是独立问题,只动查询扩展这一个变量。
二、HyDE:先写一段假设答案,再拿答案去检索
HyDE(Hypothetical Document Embeddings)的思路很直接:用户问题通常很短,知识库文档却很长,两者在语义空间里的形态差异很大。先让 LLM 生成一段「可能出现在文档里的答案」,再用这段文字做向量检索,缩小问题与文档之间的表达差异。
最小实现只需要一次额外的 LLM 调用:
python
HYDE_PROMPT = """请根据用户问题,写一段可能出现在企业知识库中的答案。
只用于检索,不要求事实完全正确,但不要新增具体型号、数字、日期或政策条件。
使用知识库文档常用的客观说明风格,80~120字,只输出答案正文。

用户问题:{query}
"""

def hyde_search(query: str) -> list[dict]:
    hypothetical_doc = llm_call(
        HYDE_PROMPT.format(query=query),
        model="cheap-small-model",
        temperature=0,
    )
    return vector_search(hypothetical_doc, top_k=20)
比如用户问「设备老是卡住」,假设答案可能写成「设备响应超时可能由网络连接、资源占用或任务队列阻塞导致」。这段文字比原 query 更容易靠近知识库里的故障排查文档。
这里有一条硬约束:假设答案只用于检索,不能作为事实上下文交给最终回答,更不能直接展示给用户。 HyDE 允许「猜」,最终答案必须以检索到的真实文档为准。
三、多 query:一次生成多个检索视角,用 RRF 合并结果
多 query 改写不生成答案,而是让模型给出几个保持原意的问法:
text
原 query:设备老是卡住
变体 1:设备响应缓慢或超时的常见原因
变体 2:设备运行过程中出现卡顿如何排查
变体 3:设备任务处理延迟的故障解决方法
实现上建议让模型直接返回 JSON,解析失败就退回原 query,别让一次格式异常拖垮整条检索链路:
python
import json

EXPAND_PROMPT = """将用户问题改写成3个适合知识库检索的不同问法。
要求:
- 保持原始意图,不新增条件、实体、型号或约束
- 分别覆盖术语表达、故障现象、处理动作三个角度
- 每个问法不超过60字
- 只输出JSON:{"queries": ["...", "...", "..."]}

用户问题:{query}
"""

def expand_queries(query: str) -> list[str]:
    raw = llm_call(
        EXPAND_PROMPT.format(query=query),
        model="cheap-small-model",
        temperature=0,
        response_format={"type": "json_object"},
    )
    try:
        candidates = json.loads(raw).get("queries", [])
    except (json.JSONDecodeError, AttributeError):
        candidates = []

    variants = []
    for item in candidates:
        q = item.strip()
        if q and q != query and len(q) <= 120:
            variants.append(q)

    # 原 query 永远保留,变体最多取3个
return [query] + variants[:3]注意最后一行:原 query 一定要参加检索。 只检索模型生成的变体,相当于把用户意图完全交给一次 LLM 调用;变体一旦跑偏,原始检索入口也没了。
多路结果别直接拼接,用 RRF 融合
每路各取 top20,按 chunk_id 去重并累加 RRF 分数:
python
def rrf_fuse(result_lists: list[list[dict]], k: int = 60,
             top_n: int = 5) -> list[dict]:
    scores: dict[str, float] = {}
    docs: dict[str, dict] = {}

    for results in result_lists:
        for rank, doc in enumerate(results, start=1):
            chunk_id = doc["chunk_id"]
            docs[chunk_id] = doc
            scores[chunk_id] = scores.get(chunk_id, 0.0) + 1.0 / (k + rank)

    top_ids = sorted(scores, key=scores.get, reverse=True)[:top_n]
    return [docs[chunk_id] for chunk_id in top_ids]


def multi_query_search(query: str) -> list[dict]:
    queries = expand_queries(query)
    # 生产环境用异步任务并行,避免把每路延迟简单相加
    result_lists = [vector_search(q, top_k=20) for q in queries]
    return rrf_fuse(result_lists, top_n=5)
这里继续使用第 26 篇的 RRF,而不直接相加向量相似度:不同 query 的分数分布不一致,排名比原始分数更稳。k=60 沿用前面的默认值,没必要先在这个参数上花精力。
四、实测:扩展有没有用,要看 query 类型
测试环境与前几篇一致:
text
PostgreSQL 16 + pgvector 0.8
embedding:bge-m3,1024 维,cosine 距离
每路召回 top20,RRF k=60,最终取 top5
扩展模型:同一个低价小模型,temperature=0
延迟统计包含查询扩展与检索,不含最终答案生成
评测集复用第 27 篇的 100 条独立 query 和 ground truth。原始 query 的 recall@5 是 86%。我把它们改写成更贴近一线用户的口语和模糊表达,人工确认意图及相关文档不变,再比较四种方案:
| 方案 | 总体 recall@5 | P95 延迟 | 每次扩展 Token |
|---|---|---|---|
| 改写后的原 query,不扩展 | 72% | 210ms | 0 |
| 纯 HyDE | 80% | 950ms | 约160 |
| 多 query + RRF | 84% | 1410ms | 约230 |
| 原 query + 多 query + RRF | 86% | 1480ms | 约230 |
分类型结果更有参考价值:
| query 类型 | 样本数 | 不扩展 | 纯 HyDE | 多 query + RRF | 保留原 query 的组合 |
|---|---|---|---|---|---|
| 术语错位型 | 40 | 65% | 78% | 80% | 83% |
| 模糊描述型 | 35 | 69% | 77% | 83% | 86% |
| 其他独立问题 | 25 | 88% | 88% | 92% | 92% |
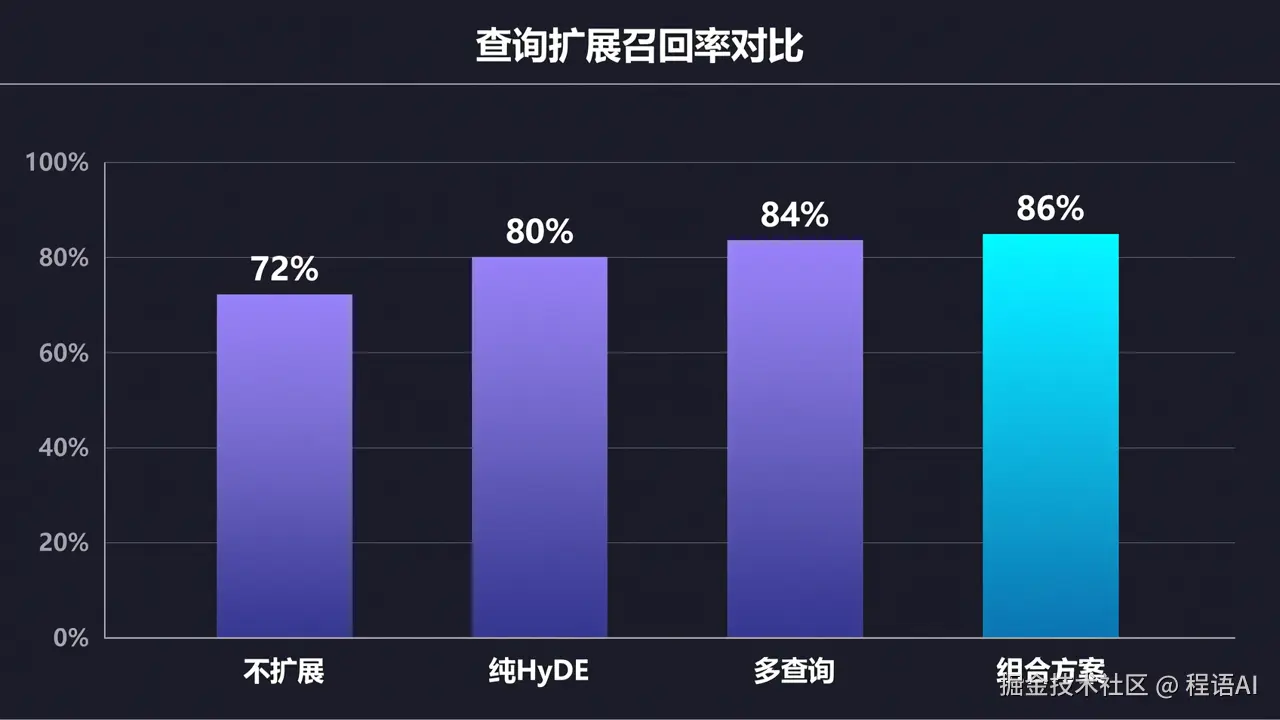
这组数据只代表当前设备知识库和评测集,不能当成通用基准。但有三个结论比较稳定:
- 查询扩展补的是措辞差异,对精确型号和错误码帮助有限。 后者仍应走第 26 篇的 BM25 混合检索。
- 多 query 的整体表现好于纯 HyDE,代价是更多检索请求和更高延迟。 语义空间里的「假设答案」有时也会带偏方向。
- 保留原 query 是便宜且有效的保险。 它只增加一路向量检索,在这次测试里把总体 recall@5 从 84% 拉到 86%,并减少了变体漂移造成的回退。
五、四个容易踩的坑
1. HyDE 把不存在的事实写进假设答案
用户问「A 产品为什么连不上」,模型可能假设成「A 产品连接超时与授权过期有关」。如果知识库里没有授权相关内容,检索就会被带到错误主题。
防御方法:prompt 禁止新增型号、数字和条件;线上记录假设答案与原 query;badcase 复盘时先看扩展文本,再怀疑 embedding。
2. 多 query 把一个问题扩成三个问题
「支持哪些部署方式」被扩成「支持私有化吗、支持国产系统吗、部署多少钱」,后两个问题已经改变原意。召回率可能上升,最终答案却会混入用户没问的内容。
防御方法:限制变体数量和长度,保留原 query,并把「不得新增约束」写进 prompt。涉及价格、日期、型号的 query,出现实体变化就直接丢弃该变体。
3. 只追求召回率,不看重复 chunk 和最终上下文
多路检索很容易把同一文档的相邻 chunk 全部送进 top5。recall@5 好看了,上下文窗口却被重复内容占满。
工程上可以在 RRF 后加一道文档级限流:同一 doc_id 最多保留两个 chunk,其余位置让给不同文档。若后面还有 reranker,先给 reranker 更宽的候选集,再做最终截断。
4. 所有 query 一律扩展
原本就检索得很好的问题,也要白付一次 LLM 调用和几路检索延迟。更合理的方式是先跑原 query,满足以下条件再扩展:
- 原 query 短且缺少明确实体;
- 首路检索分数低于历史同类型 query 的正常区间;
- 日志中属于高频术语错位或模糊描述类型;
- 首路结果进入低置信拒答流程之前,给一次扩展补救机会。
阈值不要拍脑袋,按第 27 篇的分类型评测集分别标定。
六、选型与组合:我现在的默认方案
| 场景 | 建议 |
|---|---|
| 多轮追问、指代和省略严重 | 先做查询重写,别直接扩展 |
| 用户措辞口语化、术语错位明显 | 原 query + 2~3 个变体 + RRF |
| 问题很短,文档以完整说明文为主 | 可以试 HyDE,但假设答案只用于检索 |
| 型号、错误码、条款号精确匹配 | 向量 + BM25,查询扩展不是主解 |
| 原 query 已有稳定高召回 | 直接检索,不增加延迟 |
| 实时性要求高、调用量很大 | 只对低置信 query 触发扩展 |
当前项目里的默认链路是:
text
多轮 query
  → 指代消解 / 查询重写
  → 原 query 先检索
  → 低置信时生成 2~3 个变体
  → 原 query 与变体并行召回
  → RRF 融合
  → rerank
  → 生成与答案评估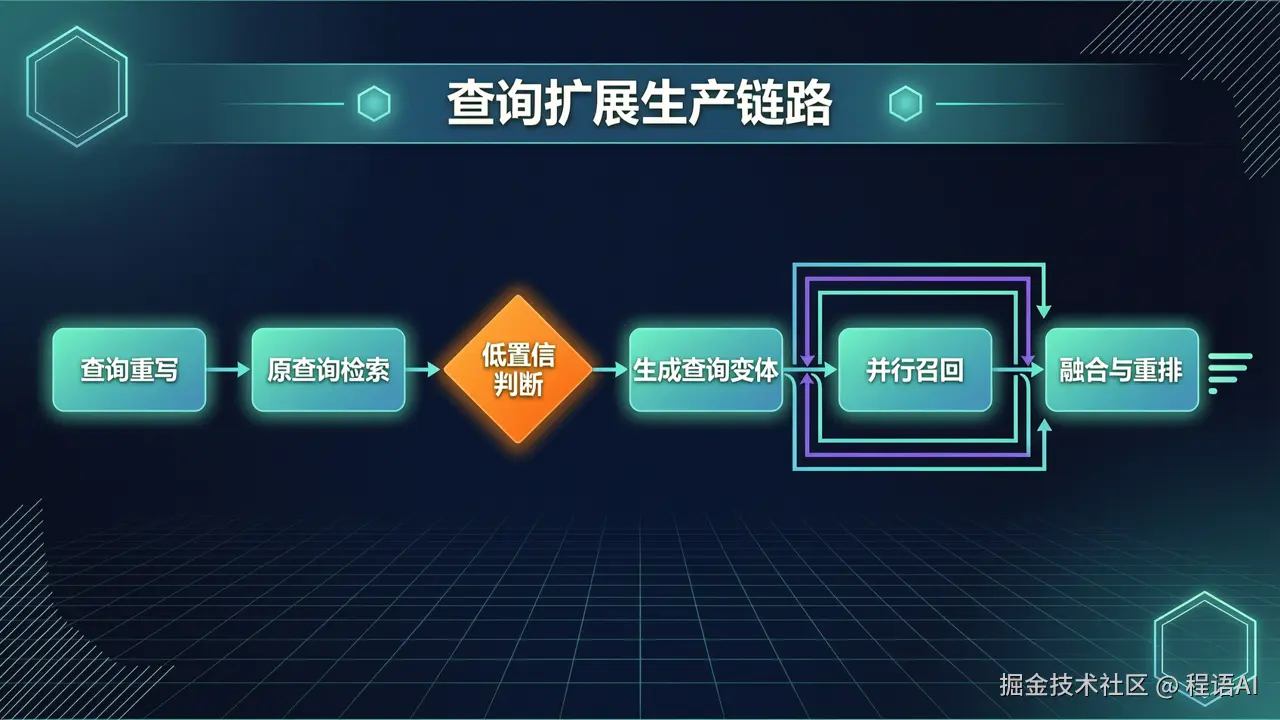
一句话总结:HyDE 和多 query 都在增加检索入口,真正需要控制的是意图漂移与额外延迟。保留原 query、分类型评测、只对低置信请求触发扩展,比单纯堆更多变体更重要。
原文首发于公众号「程语AI」。我是成风,十几年研发,现一人公司做 AI 应用工程化,欢迎评论区交流。