集中式与分布式数据库怎么选?从架构原理到电科金仓的实践思考
一、数据库架构选型,不能只看数据量
做过几年后端开发的人,应该都遇到过类似的问题:业务刚开始的时候,一台数据库服务器就能满足需求,随着用户量增加、业务模块增多,数据库逐渐成为系统的性能瓶颈。这时候,团队往往会考虑增加服务器、部署集群,甚至直接引入分布式数据库。
但这里有一个容易被忽略的问题:数据库架构升级,并不意味着一定要从集中式切换到分布式。
集中式与分布式并不是简单的性能高低关系,而是两种不同的资源组织和数据管理方式。集中式数据库强调统一的数据管理、事务处理和资源调度;分布式数据库则通过多个节点共同承担数据存储和计算任务,以解决单节点在容量、吞吐量及扩展能力方面的限制。
如果业务规模不大,却提前采用复杂的分布式架构,可能会给开发和运维带来不必要的负担。反过来,如果业务已经发展到单机无法承载的程度,仍然坚持使用单节点架构,也会逐渐暴露出容量、并发和可用性方面的问题。
所以,数据库选型不能只问一句「哪种架构性能更好」,而应该先弄清楚业务真正遇到了什么问题。 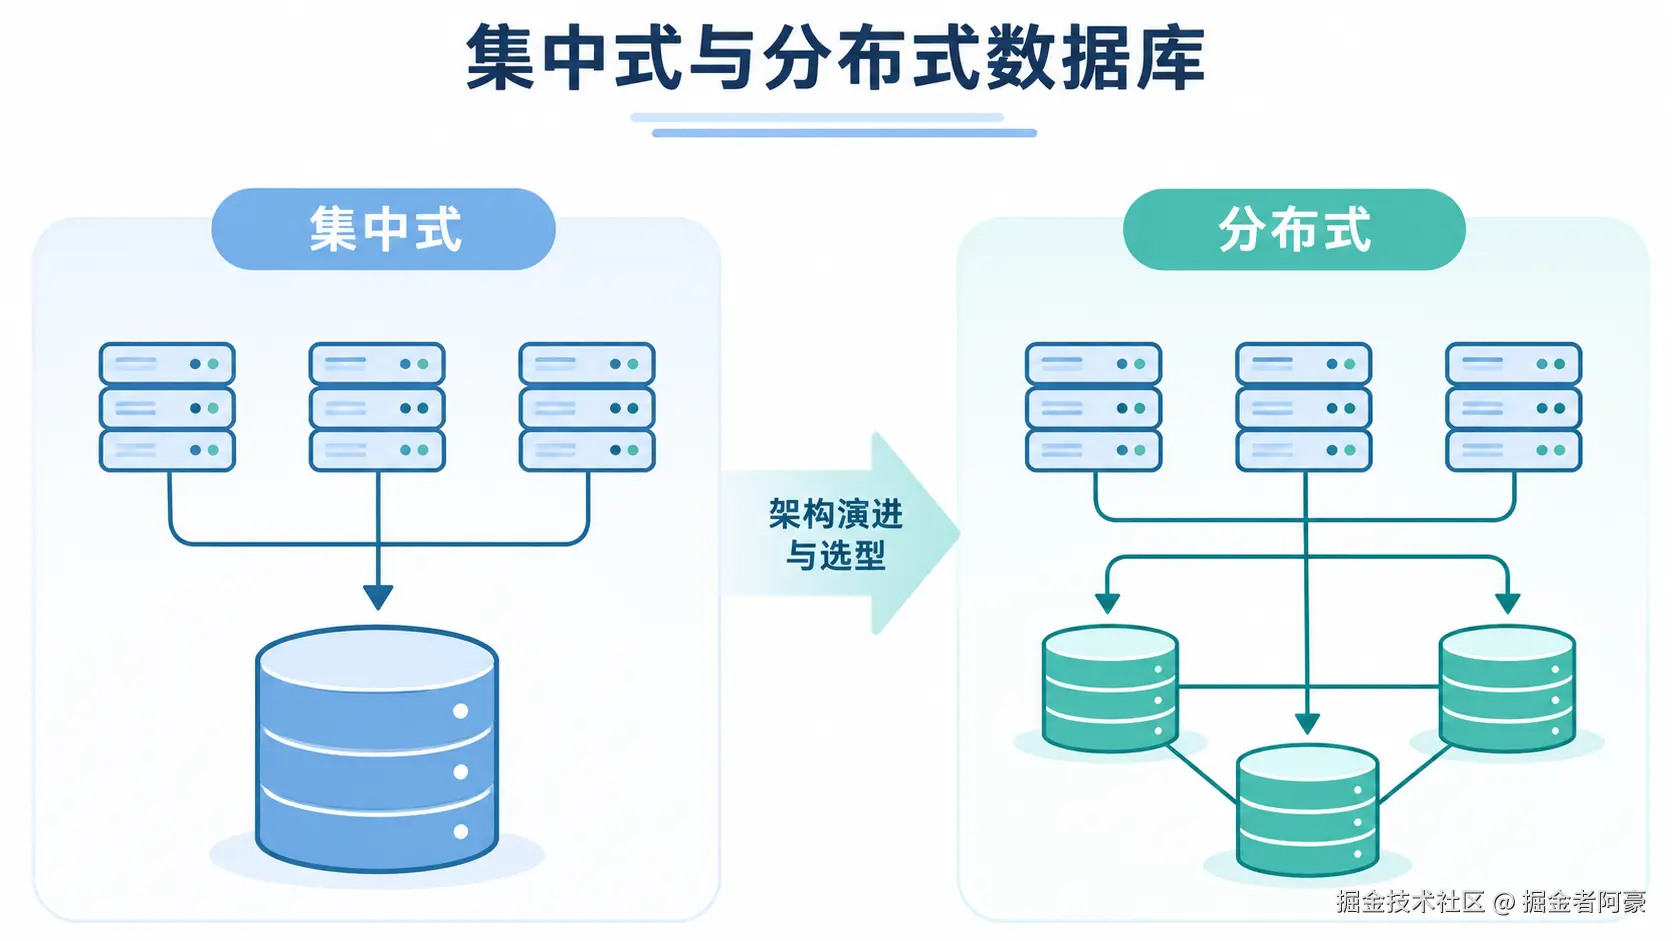
二、集中式数据库:把数据和事务管理放在一个体系内
集中式数据库可以理解为由一个数据库实例统一管理数据、事务、索引、日志及存储资源。即使部署了主备节点或者多个数据库服务实例,其核心数据管理方式仍然可能属于集中式架构。
一个比较典型的集中式数据库部署结构如下:
sql
                 业务应用层
                     |
              负载均衡 / 应用服务
                     |
                     v
             +---------------+
             |   数据库服务   |
             |               |
             | SQL解析与执行  |
             | 事务管理       |
             | 索引管理       |
             | 缓存管理       |
             +---------------+
                     |
                     v
             +---------------+
             |   数据存储     |
             | 数据文件       |
             | 日志文件       |
             +---------------+
从开发角度看,集中式架构最大的特点就是简单。
应用程序通过一个数据库连接地址访问数据库,SQL 的执行、事务提交、索引维护以及数据一致性管理都由数据库自身完成。开发人员不需要关心某条记录究竟存放在哪台物理服务器,也不需要在业务代码中处理跨节点事务。
例如,一个普通的订单系统:
sql
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    order_no VARCHAR(64) NOT NULL,
    user_id BIGINT NOT NULL,
    amount DECIMAL(12, 2) NOT NULL,
    status VARCHAR(20) NOT NULL,
    create_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);

CREATE INDEX idx_orders_user_id
ON orders(user_id);

CREATE INDEX idx_orders_create_time
ON orders(create_time);
创建订单时,需要同时写入订单表、订单明细表,并扣减用户账户余额。
在集中式数据库中,可以直接使用本地事务完成:
sql
BEGIN;

INSERT INTO orders (
    id, order_no, user_id, amount, status
) VALUES (
    10001, 'ORD202611060001', 20001, 199.00, 'CREATED'
);

UPDATE account
SET balance = balance - 199.00
WHERE user_id = 20001
  AND balance >= 199.00;

-- 应用程序需要检查 UPDATE 影响行数
-- 如果余额不足,则执行 ROLLBACK

COMMIT;
这里需要注意,实际业务中不能只执行 UPDATE 就直接提交,还需要判断账户更新是否成功。如果没有更新到记录,应当回滚整个事务。
这类业务非常适合集中式数据库,因为订单创建和账户扣款之间存在明确的事务关系,使用数据库原生事务就可以完成一致性控制。
集中式架构的优势主要体现在以下几个方面:
1. 事务管理相对简单
数据由统一的数据库体系管理,事务边界清晰,跨表关联、锁管理、索引维护等操作可以由数据库统一处理。
2. SQL 开发成本较低
常见的 JOIN、GROUP BY、子查询、聚合函数等操作,可以按照正常的关系数据库开发方式使用,不需要额外考虑数据分片位置。
3. 运维体系相对成熟
备份、恢复、日志管理、性能分析、索引优化和容量规划等工作都有比较成熟的处理方式。
当然,集中式架构也有明显的限制。
首先是资源上限。无论服务器配置多高,CPU、内存、磁盘 I/O 和网络带宽始终存在物理上限。当多个业务同时争抢数据库资源时,性能可能出现明显波动。
其次是扩展方式受到限制。增加 CPU、内存或者更换高性能存储,通常属于纵向扩展。虽然能够缓解一部分压力,但硬件升级存在成本和性能天花板。
最后是单点风险。单机数据库如果没有完善的高可用机制,一旦发生硬件故障、操作系统异常或者数据库进程崩溃,就可能影响整个业务系统。
需要强调的是,集中式不等于单机,也不意味着无法实现高可用。通过主备、共享存储集群、读写分离等方式,集中式数据库同样可以构建多节点部署架构。
三、分布式数据库:让多个节点共同承担数据库工作
当单个数据库节点逐渐无法满足业务需求时,就需要考虑分布式架构。
分布式数据库的核心思路,是把原本集中在一个节点上的数据存储和计算任务,合理分配到多个节点上。
例如,一个电商平台已经积累了数亿条订单数据,订单写入量和查询量持续增长。如果所有订单都集中存放在同一个数据库节点上,随着数据量和并发量不断增加,数据库的存储、索引维护和查询处理压力也会越来越大。
此时可以考虑按照用户 ID 或订单业务维度进行数据拆分。
css
                  业务应用层
                      |
                      v
               数据库访问入口
                      |
                      v
              分布式路由管理层
                      |
          +-----------+-----------+
          |           |           |
          v           v           v
      数据节点1    数据节点2    数据节点3
          |           |           |
      用户数据A    用户数据B    用户数据C
      订单数据A    订单数据B    订单数据C
假设按照用户 ID 进行 Hash 分片,可以采用如下逻辑:
arduino
public int getShardIndex(Long userId, int shardCount) {
    return Math.floorMod(userId.hashCode(), shardCount);
}
假设目前有三个数据节点:
| 用户ID | Hash计算结果 | 对应节点 |
|---|---|---|
| 10001 | 2 | 节点3 |
| 10002 | 0 | 节点1 |
| 10003 | 1 | 节点2 |
| 10004 | 2 | 节点3 |
这只是一个用于说明分片原理的简单示例,真实生产环境还需要考虑数据分布、节点扩缩容、分片迁移以及路由元数据管理等问题。
采用分片之后,不同节点可以分别承担一部分数据存储和请求处理工作,从而缓解单节点的资源压力。
不过,分布式数据库并不是把数据库简单地安装在三台服务器上就可以了。真正需要解决的是多个节点之间的协作问题。
例如:
- 数据应该如何分片?
- SQL 请求应该路由到哪个节点?
- 多个节点同时修改数据时如何保证一致性?
- 某个节点发生故障后如何恢复?
- 跨节点查询和事务应该如何处理?
- 增加节点时如何迁移已有数据?
这些问题都需要数据库系统提供相应的机制。
1. 数据分片策略
常见的分片方式包括 Hash 分片、范围分片和列表分片。
Hash 分片:
通过分片键计算数据所属节点,通常有利于数据均匀分布。
适合用户数据、订单数据等需要分散存储的业务。
范围分片:
按照某个字段的取值范围划分数据。
例如按照订单创建时间划分:
节点1:2024年及以前
节点2:2025年
节点3:2026年
这种方式便于按时间管理数据,但需要关注热点问题。如果所有新增数据都进入最新时间段对应的节点,就可能出现节点负载不均衡。
列表分片:
按照预先定义的字段值进行数据分配。
例如按照业务区域划分:
节点1:华东、华南
节点2:华北、东北
节点3:西南、西北
这种方式适合业务区域相对固定、查询具有明显地域特征的场景。
实际项目中,分片策略没有统一答案。选择分片键时,应该重点分析业务查询条件、数据增长速度以及跨分片关联需求。
2. 分布式事务
这是分布式数据库中比较重要的一项技术。
在集中式数据库中,订单和账户可以通过一个本地事务完成更新。但如果订单表和账户表分别位于不同节点,就不能简单地认为一个本地事务能够保证两个节点同时提交。
此时需要引入分布式事务协调机制。
一个典型的两阶段提交过程如下:
css
          事务协调者
               |
       第一阶段:Prepare
          /         \
         v           v
      数据节点A    数据节点B
         |           |
      准备成功     准备成功
         |           |
         +-----+-----+
               |
       第二阶段:Commit
          /         \
         v           v
      提交事务A    提交事务B
第一阶段,协调者向参与事务的节点发送准备请求,各节点执行事务操作,但暂时不正式提交。
第二阶段,协调者根据参与节点的反馈决定提交还是回滚。
这种机制能够帮助多个节点共同完成事务,但也会带来额外的网络通信、协调等待以及故障恢复成本。
因此,分布式事务并不是没有代价的。业务设计时应该尽可能减少跨分片事务,让高频关联的数据尽量分布在相同节点。
四、伪分布式、分库分表与原生分布式有什么区别?
实际项目中,经常有人把多台数据库服务器组成的集群直接称为分布式数据库,这种说法并不完全准确。
从架构实现上看,至少需要区分以下几种情况。
| 架构类型 | 主要特点 | 是否属于真正的分布式数据管理 |
|---|---|---|
| 单机集中式 | 单节点管理数据和事务 | 否 |
| 主备集群 | 多节点保障数据冗余和故障切换 | 不一定 |
| 读写分离 | 写入和查询分配到不同节点 | 不一定 |
| 应用层分库分表 | 应用或中间件负责数据路由 | 属于分布式部署方案,但不是原生分布式内核 |
| 原生分布式数据库 | 数据分片、路由、事务和节点协作由数据库体系管理 | 是 |
这里特别说一下伪分布式。
所谓伪分布式,通常是指系统在部署层面使用了多个节点,但数据管理、事务处理或者计算任务仍然存在较强的集中依赖。
例如,开发人员在应用程序中维护三个数据库连接,根据用户 ID 手动选择数据源。这种方案虽然使用了多台数据库服务器,但数据路由、跨库查询和事务协调仍然需要应用程序或者中间件承担。
它能够解决一部分容量问题,却不等于具备完整的分布式数据库能力。
另外,读写分离也不能直接等同于分布式架构。
读写分离主要解决的是读请求对写入资源的竞争问题。多个副本可以分担查询压力,但数据本身通常仍然由一个主要写入体系负责管理,并没有因此实现数据水平拆分。
理解这几个概念,对后续数据库选型非常重要。
五、集中式与分布式,实际项目应该怎么选?
我个人比较认同一个观点:数据库架构应该跟着业务复杂度走,而不是跟着技术热点走。
如果只是为了追求分布式架构而进行改造,最终很可能出现业务代码复杂了,运维成本增加了,性能却没有明显提升的情况。
可以从以下几个维度进行判断:
| 评估维度 | 更适合集中式 | 更适合分布式 |
|---|---|---|
| 数据规模 | 单节点能够承载 | 单节点存储能力不足 |
| 并发压力 | 单节点资源仍有余量 | 单节点计算资源成为瓶颈 |
| 事务需求 | 跨表事务较多 | 可以按业务边界拆分数据 |
| 查询特点 | 多表关联、复杂 SQL 较多 | 查询具有明显分片键 |
| 扩展需求 | 以纵向扩展为主 | 需要横向扩展 |
| 运维能力 | DBA 团队规模有限 | 具备集群管理能力 |
下面通过三个常见业务场景来说明。
场景一:企业内部管理系统
例如 OA、ERP、人事管理、财务管理等系统。
这类系统通常具有以下特点:
- 业务数据之间关联较多。
- 事务一致性要求比较高。
- 数据增长速度相对可控。
- 查询以业务管理和统计为主。
对于这类系统,我更倾向于优先选择集中式数据库。
通过合理配置服务器资源、索引优化、SQL 优化以及高可用集群,通常就能够满足业务需求。
如果一开始就引入复杂的分片架构,反而可能增加开发和运维难度。
场景二:大型互联网交易平台
例如电商订单、支付交易、用户中心等系统。
当订单数据达到数亿甚至更高规模,单个数据库节点已经无法同时满足存储和并发处理需求时,就可以考虑分布式架构。
例如按照用户 ID 或订单 ID 进行数据分片,将不同业务数据分配到多个节点。
但这里有一个重要前提:业务必须具备合理的数据拆分方式。
如果订单、账户、支付、库存之间存在大量强一致性事务,那么拆分之后就需要重新设计事务边界,不能只考虑数据库层面的扩展。
场景三:工业物联网与数据分析平台
工业物联网平台往往需要接入大量设备,每台设备持续产生采集数据。
假设有10万台设备,每台设备每分钟产生一条记录,那么每天的数据量就是:
ini
100000 × 60 × 24
= 144000000 条
也就是每天约1.44亿条记录。
这种场景除了数据量大,还存在持续写入、时间范围查询、历史数据分析等需求。
如果全部使用单个数据库节点处理,随着业务发展,存储和计算压力都会不断增加。
此时可以根据设备编号、采集时间或者业务区域设计数据分布策略,同时将实时写入和历史分析任务进行合理隔离。
对于这种业务,分布式架构就具有比较明显的应用价值。
六、电科金仓:集中式与分布式并不是二选一
前面讨论了集中式和分布式的基本原理,接下来结合电科金仓的 KingbaseES 产品体系来看,数据库厂商是如何处理不同业务规模和架构需求的。
在实际项目中,我认为比较值得关注的一点是:数据库不应该要求所有业务都使用同一种部署模式。
有些系统需要稳定的事务处理,有些系统需要读写扩展,还有一些系统需要面对海量数据和复杂分析任务。不同业务对数据库的要求并不相同。
KingbaseES 采用集中式与分布式一体化架构,在集中式数据库能力基础上,进一步扩展分片管理、分布式执行、分布式事务和全局事务一致性等能力,从而支撑不同类型的集群部署。
从产品体系来看,可以重点关注以下几个组件。
1. KingbaseES:集中式数据库基础能力
KingbaseES 是电科金仓的核心数据库产品,面向企业级业务系统,能够承载事务处理、数据分析以及多种业务数据管理需求。
对于大多数常规业务系统,可以先从集中式部署开始。
例如:
yaml
Java业务系统
      |
      v
数据库连接池
      |
      v
KingbaseES
      |
      v
业务数据存储
在业务规模尚未达到单节点资源瓶颈之前,合理规划数据库参数、索引、连接池和 SQL,往往比直接进行分布式改造更有实际意义。
2. KES RAC:共享存储集群
如果业务对数据库可用性和并发处理能力有较高要求,可以关注 KES RAC。
RAC 采用共享存储集群架构,多个数据库实例通过共享存储访问同一份数据。
yaml
             应用访问层
                  |
             集群访问入口
                  |
          +-------+-------+
          |               |
          v               v
       数据库节点A     数据库节点B
          |               |
          +-------+-------+
                  |
                  v
              共享存储
它与普通主备模式存在区别:多个数据库实例可以共同访问共享数据,并通过集群机制实现节点之间的协作。
这种架构适合对业务连续性要求较高,同时希望通过多个计算节点提升数据库服务能力的场景。
需要注意,共享存储本身也会成为架构设计的重要部分,存储性能、网络链路以及节点间协调机制都需要纳入评估。
3. KES RWC:读写分离集群
如果数据库主要问题不是存储容量不足,而是查询请求过多,那么可以考虑读写分离。
KES RWC 是基于 KingbaseES 提供的读写分离集群方案,通过将读请求和写请求合理分配到不同节点,降低主节点的查询负载。
例如:
yaml
                 应用系统
                     |
                     v
                数据库访问层
                     |
              +------+------+
              |             |
              v             v
           写请求         读请求
              |             |
              v             v
           主节点       只读节点集群
                            |
                     +------+------+
                     |             |
                     v             v
                   从节点1       从节点2
在 Java 项目中,读写分离通常需要关注事务上下文。
例如,订单创建成功后立即查询订单,如果读请求被路由到尚未同步完成的副本,就可能出现短暂的数据不一致现象。
因此,实际使用时不能简单地把所有 SELECT 语句都发送到从节点。对于事务中的查询、刚刚写入的数据以及对实时一致性有要求的请求,需要结合产品提供的路由策略进行处理。
4. KES TDC:事务型透明分布式集群
如果业务既需要分布式扩展,又希望尽量保留原有数据库应用开发方式,可以进一步关注 KES TDC。
KES TDC 是使用 KES 作为节点的存算分离分布式集群组件,面向需要应用开发兼容,同时需要横向扩展能力的 TP 类业务场景。
根据官方产品资料,TDC 支持计算节点和存储节点分别扩展,并提供在线扩容、缩容能力。
这类架构的价值在于,业务系统不必完全按照传统应用层分库分表的方式自行维护数据路由,而是由数据库集群体系承担相应的分布式管理工作。
对于已经运行多年的业务系统来说,这一点比较重要。
数据库架构升级不仅要考虑性能,还要考虑原有 SQL、事务逻辑和应用代码的改造成本。
5. KES Sharding 与 KES ADC:面向不同类型的扩展需求
除了事务型分布式集群,电科金仓还提供了其他分布式扩展能力。
KES Sharding 是基于 KingbaseES 数据库多集群架构的高扩展分布式集群组件,主要面向需要更大规模数据管理和水平扩展的业务。
例如物联网采集、海量业务数据存储等场景,可以结合实际数据分布特点规划集群架构。
而 KES ADC 更偏向分析型分布式集群,支持大规模并行计算,适合大规模 AP 或混合 TP 的 AP 场景。
两者关注的重点并不完全相同:
- Sharding 更关注数据分布、容量扩展和业务数据管理。
- ADC 更关注分析计算和多节点并行处理能力。
如果业务主要是高频交易,不能因为 ADC 支持并行计算就直接拿它替代事务型数据库集群。反过来,如果业务主要是海量数据分析,也不应该只从 OLTP 的角度进行架构设计。
七、一个实际的架构演进思路
假设现在需要建设一个企业级业务平台,初期只有用户管理、订单管理、商品管理和统计分析几个模块。
刚开始的数据量并不大,可以先使用集中式 KingbaseES 承载核心业务。
随着业务发展,逐步出现以下变化:
- 订单查询增加,数据库读压力明显上升。
- 用户和订单数据持续增长,存储容量逐渐增加。
- 每天产生大量业务统计数据,分析查询开始影响交易业务。
- 系统需要支持更高的可用性,不能因为单节点故障影响正常交易。
这时候就可以考虑分阶段演进,而不是一次性重构所有数据库架构。
yaml
          第一阶段:集中式
                 |
                 v
          KingbaseES 单机
                 |
          业务规模持续增长
                 |
                 v
        第二阶段:高可用与读扩展
                 |
          +------+------+
          |             |
          v             v
       KES RAC        KES RWC
          |             |
          +------+------+
                 |
          数据规模继续增长
                 |
                 v
          第三阶段:分布式扩展
                 |
          +------+------+
          |             |
          v             v
       KES TDC       KES Sharding
          |
          v
       分析业务增长
          |
          v
        KES ADC
上面是一个用于说明架构演进思路的示意图,并不是要求项目必须按照这个顺序部署,也不意味着所有组件都需要同时使用。实际架构应根据业务负载、产品版本、授权范围和部署条件进行组合。
这里还有一个很重要的经验:架构演进应该以监控指标为依据。
例如:
| 监控指标 | 需要关注的问题 |
|---|---|
| CPU 使用率 | 是否存在持续性的计算资源瓶颈 |
| 内存使用率 | 缓存、排序及执行计划是否占用过多内存 |
| 磁盘 IOPS | 数据读写是否受到存储性能限制 |
| 慢 SQL 数量 | 是否存在低效 SQL 或索引缺失 |
| 活跃连接数 | 连接池配置是否合理 |
| 锁等待时间 | 是否存在事务竞争或热点数据 |
| 数据增长速度 | 当前存储容量还能支撑多久 |
| 查询响应时间 | 是否需要读写分离或分析负载隔离 |
例如,如果数据库 CPU 长期处于高位,但实际数据量并不大,首先应该检查 SQL 执行计划、索引和查询方式,而不是直接增加分片节点。
如果主要问题是大量报表查询占用数据库资源,则读写分离或者分析型集群可能更有价值。
如果主要问题是数据容量已经超过单节点的合理承载范围,那么就应该考虑水平扩展。
技术方案一定要对应实际问题,这比单纯追求架构复杂度更重要。
八、总结:没有最好的数据库架构,只有更合适的选择
集中式与分布式数据库并不是互相替代的关系,它们解决的是不同阶段、不同类型的业务问题。
集中式架构在事务处理、SQL 开发和运维管理方面具有明显优势,适合大多数规模可控、业务关联较多的系统。
分布式架构则更适合面对海量数据、持续增长的并发请求以及需要横向扩展的业务场景,但同时也会带来数据分片、分布式事务、节点协调和故障恢复等方面的复杂度。
对于开发人员来说,真正需要掌握的不是如何把系统设计得足够复杂,而是能够根据业务特点识别数据库瓶颈,并选择合适的解决方案。
从电科金仓 KingbaseES 的产品体系来看,集中式数据库、高可用集群、读写分离以及分布式集群能力形成了相对完整的技术体系。不同场景可以根据业务需求选择对应的架构,而不是让所有系统都走同一条技术路线。
我个人在做系统架构设计时,更倾向于先保证业务模型清晰、事务边界合理、SQL 执行高效,再根据真实的性能数据决定是否需要进行集群扩展。
毕竟,数据库架构最终服务的还是业务。能够稳定运行、方便维护,并且在业务增长时有明确的扩展路径,才是一个真正值得采用的架构方案。