2026-10-05·编排与协作·Plan 系统
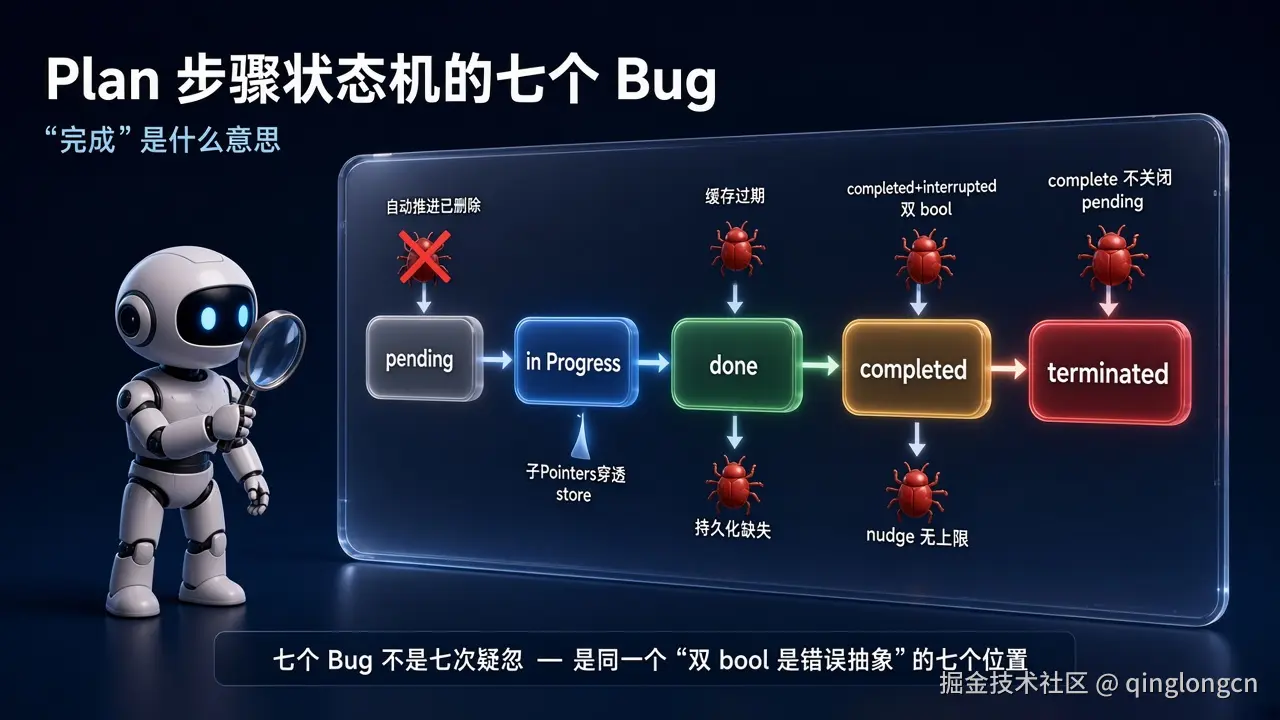
一个 Plan 步骤从 pending 到 done 看起来很简单。但在真实的 Agent 系统中,'完成'的语义出奇地复杂------模型说完成了就算完成吗?引擎要验证吗?验证失败怎么办?'完成'之后还能改吗?这篇文章讲七个真实 Bug,每一个都指向状态机设计的通用教训。
一个看似简单的状态迁移
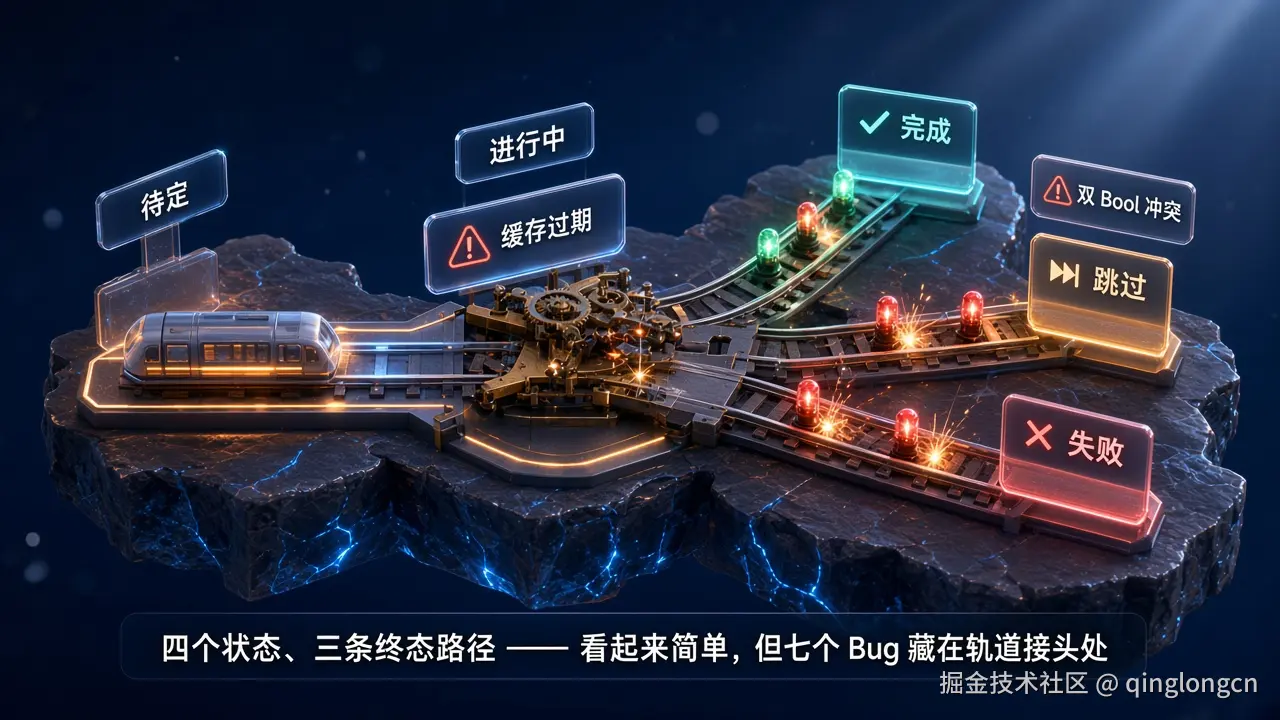
Plan 步骤的生命周期,第一眼看上去不过是:
bash
pending → in_progress → done
                      → skipped
                      → failed
五个状态、三条终态路径。写成代码不到 20 行。
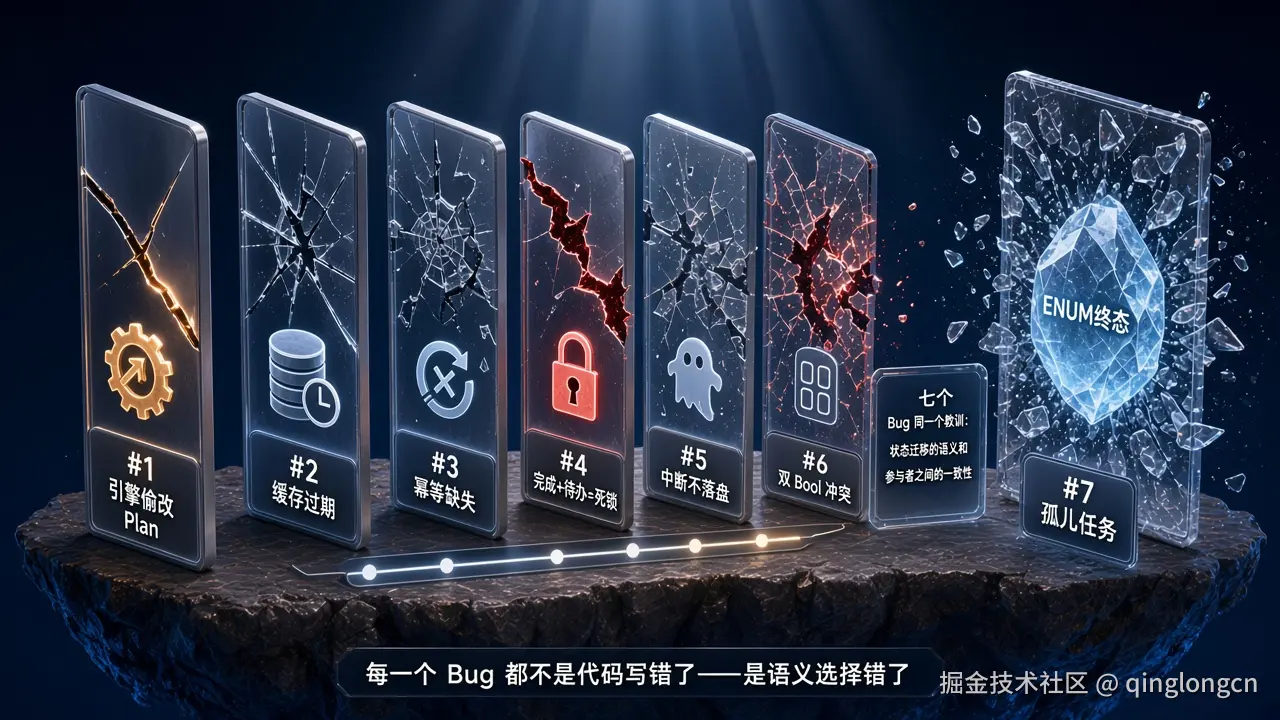
然而,在一个真实的 Agent 引擎中------模型自主决定何时标记完成、引擎负责持久化和事件发射、前端负责渲染进度------这个看似简单的状态机引发了七个 Bug。每一个都不是代码写错了("编译通过了"),而是语义选择错了。
这篇文章按时间顺序讲这七个 Bug------不是为了批评过去的设计决策(每一个在当时的上下文中都看起来合理),是为了提炼状态机设计的通用教训。
七个 Bug 的时间线和影响一览:
| # | Bug | 症状 | 影响范围 | 发现方式 |
|---|---|---|---|---|
| 1 | 引擎偷偷改 Plan(auto-advance) | 恢复后状态不一致 | Run 中断恢复场景 | 用户报告恢复后步骤"倒退" |
| 2 | 过期缓存引发非法迁移 | "illegal transition: pending → done" | 委派场景 | 共享 SessionID 的子 Agent 触发 |
| 3 | 同状态重试报错 | CycleDetector 误终止整个 Run | 所有标 done 场景 | 模型冗余确认时触发 |
| 4 | complete + pending = 死锁 | pending 步骤被静默遗弃 | 模型提前声明完成 | 前端显示"完成"但进度只到 60% |
| 5 | 中断不持久化 | 刷新后 Plan "复活" | 所有 Plan 中断场景 | 用户关闭重开页面 |
| 6 | 双 Bool 非法组合 | 引擎说 Completed,前端说 Interrupted | nudge 耗尽后 plan(complete) | 事件和状态脱节 |
| 7 | 异常终止不终结 Plan | Plan 永久显示"进行中" | 11 种非正常终止路径 | 前端"死任务"永不消失 |
如果你在设计 Agent 的任务编排、工作流引擎、或者任何涉及"多步骤、多参与者、异步执行"的系统------这些教训可能帮你绕过同一类坑。
Bug #1:引擎偷偷改 Plan
症状
模型完成步骤 A 后,有时会发现步骤 B 的状态不是预期的 pending,而是 in_progress------但模型从未显式地把 B 标记为 in_progress。
根因
引擎有一个"auto-advance"逻辑------步骤 A 完成时自动激活下一步 B。这个逻辑修改的是内存中的 Plan 状态,不落盘。
后果是:模型看到的 Plan 状态和持久化的不一致。如果 Run 在此时中断并恢复,恢复后的 Plan 回到了持久化的版本(B 还是 pending),而模型的对话上下文里记着 B 是 in_progress。
教训
Plan 状态的唯一写入者应该是模型(通过 plan 工具),引擎不应该偷偷修改。
这和"Plan 从 DAG 退回线性清单"一章的核心结论一致------引擎不该替模型做认知判断。"下一步是什么"是一个认知决策,即使答案看起来很显然("线性清单的下一个 pending 步骤"),也应该由模型做。
auto-advance 最终被完全删除。引擎的职责简化为:接收模型的 plan 工具调用 → 校验状态迁移合法性 → 持久化 → 发射事件。不做任何隐式推进。
Bug #2:过期缓存引发"非法迁移"
症状
在委派(delegation)场景中------父 Agent 委派一个子 Agent 执行子任务,两者共享同一个 SessionID------子 Agent 尝试将步骤标记为 done 时,引擎报错 "illegal transition: pending → done"。
根因
Plan 状态通过 per-run Metadata 缓存读取。委派场景中,父 Agent 已经将步骤推进到 in_progress,但子 Agent 的缓存里还是旧的 pending 状态。子 Agent 尝试从 pending 直接跳到 done------这在状态迁移表中是非法的(必须经过 in_progress)。
教训
Plan 工具必须从权威存储(TaskStore)直读,不能走 per-run 缓存。
修复后,plan 工具的每次操作都走 load → mutate → save 路径,中间通过锁串行化。返回深拷贝(不是 store 内部指针),防止一个调用方的修改穿透到 store 绕过锁。
通用规则:多参与者共享的状态必须有单一权威源,且每次操作都从权威源读最新值。 per-run 缓存适合只读数据,不适合可变共享状态。
Bug #3:同状态重试报错
症状
模型调用 plan(update, step-3, done),步骤 3 已经是 done。引擎返回错误:"terminal state"。
这看起来合理------done 是终态,不该重复迁移。但后果不合理:CycleDetector 检测到相同的工具调用产出相同的错误,将其计入 identical call streak。几次之后触发 CycleDetector 终止。
模型因为"多标记了一次完成"被终止了整个 Run。
根因
同状态迁移(done → done)不是错误------是幂等成功。在网络请求重试、多轮对话中的冗余确认等场景中,幂等性是基本要求。
教训
修复很简单:done → done 返回 "already done (no-op)",不报错。
但引申出的设计原则是:在 Agent 系统中,错误消息的措辞直接影响模型的后续行为。 "terminal state" 这种报错会让模型产生困惑------它不知道这是"你做了不该做的事"还是"你已经做了这件事"。而 "already done (no-op)" 清楚地告诉模型:你要做的事已经生效了,继续就好。
错误文本附带迁移引导(比如 "Set status=in_progress first")可以进一步帮助模型从非法迁移中恢复,而不是盲目重试。
Bug #4:complete + pending 步骤 = 死锁
症状
模型调用 plan(action=complete) 声明 Plan 完成。但 Plan 中还有 pending 步骤。
引擎把 Plan.Completed 设为 true。
此时 Plan 进入一个奇怪的状态:Completed = true,但 3/5 步骤还是 pending。 前端渲染这种状态为"已完成"(因为 Completed=true),但进度条只到 60%(2/5 步骤 done)。
更糟糕的是,引擎有一个 nudge 机制------当 Run 即将结束但 Plan 还有 pending 步骤时,注入一条提示"你还有未完成的步骤"。这个 nudge 有一个门控:!Plan.Completed。
Completed=true 短路了 nudge。 Pending 步骤被静默遗弃------没有 nudge 提醒模型、没有前端警告、没有错误日志。
根因
complete 的语义不够清晰。它到底是"所有步骤都完成了"(final),还是"我觉得可以了"(declaration)?
模型的意图是后者------"虽然还有几步没做,但我认为任务已经完成了"。但引擎和前端都把它当成前者处理。
教训
最终的修复引入了一个新行为:plan(complete) 收口所有剩余 open 步骤。当模型声明 Plan 完成时,所有仍处于 pending 或 in_progress 的步骤被一并标记为 done(treated as "模型认为不需要做了")。
这确保了 Plan 的终态是一致的------不会出现 "Completed + pending" 的矛盾状态。
通用规则:状态机的终态必须是全局一致的。 如果一个"完成"状态允许子组件仍处于"未完成",那它不是真正的终态------它是一个矛盾体,会在每个消费它的地方(前端、nudge、统计、导出)引发不同的 Bug。
Bug #5:中断不持久化,Plan "复活"
症状
Run 被中断(用户取消或 CycleDetector 终止),前端通过 SSE 收到 EventPlanInterrupted 事件,正确显示"Plan 已中断"。
用户关闭页面重新打开,Plan 又变成了"进行中"。
根因
Interrupted 状态只走了 SSE 事件通道,没有写入 Plan 结构体 。Plan 结构体中根本没有 Interrupted 字段------这个状态只存在于事件流中。
getSessionPlan 端点返回的 Plan 数据不包含中断标记。页面刷新后重新拉取 → Plan "复活"为上一次持久化的状态(进行中)。
教训
每一种终态都必须被持久化。 SSE 事件是实时通道,不是持久化层。如果一个状态变更只走事件不落存储,它就是"短暂的真相"------断连或刷新后消失。
这个 Bug 其实暴露了一个更深层的设计问题------当时 Plan 的终态只有 Completed 一种。Interrupted 作为终态不存在于数据模型中。修复它不只是"加个字段"------需要重新思考 Plan 的终态集合。
Bug #6:双 Bool 的非法组合
症状
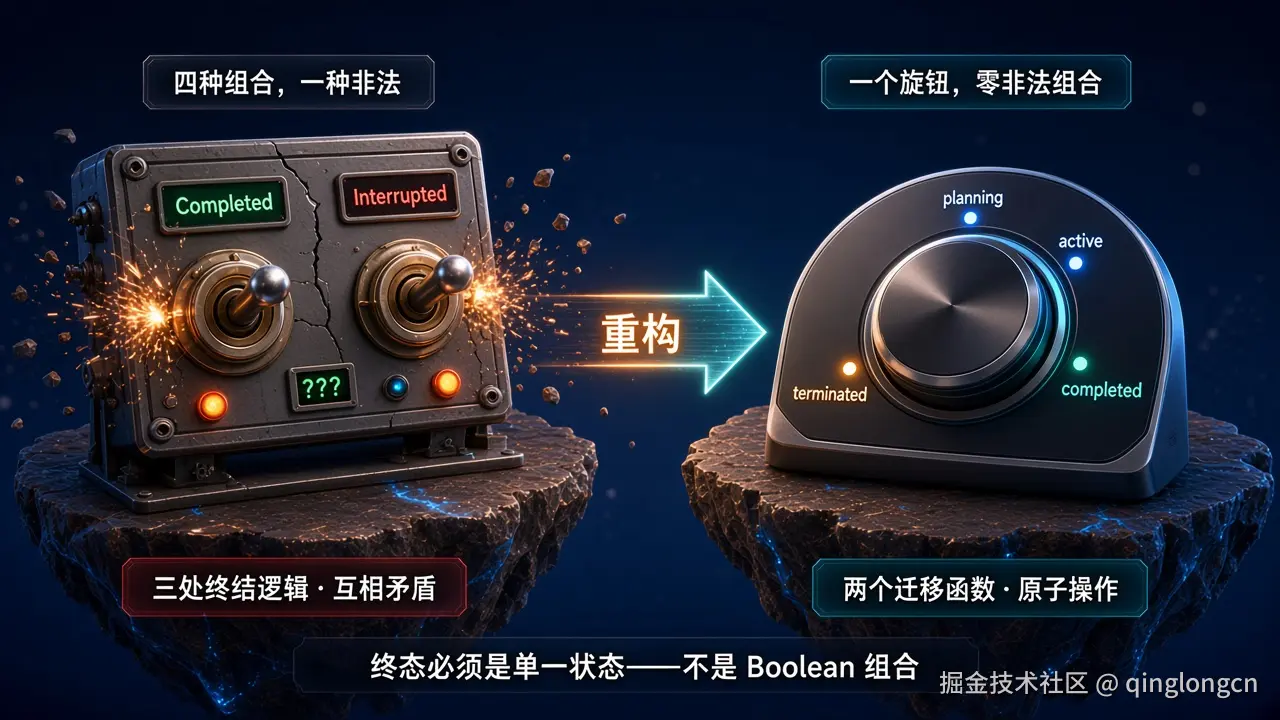
修了 Bug #5 之后,Plan 有两个 Boolean 字段:Completed 和 Interrupted。
四种组合中有一种是非法的:Completed=true && Interrupted=true------一个 Plan 不可能同时"完成了"和"被中断了"。
但没有什么能阻止这种组合出现。
实际发生的场景:模型先 plan(complete) → Completed=true,然后 nudge 耗尽 → 引擎尝试设 Interrupted=true。此时迁移表拒绝了 completed → interrupted 的迁移,但 EventPlanInterrupted 已经无条件发射了------因为发射和迁移的代码不在同一个路径中。
结果:引擎状态是 Completed,前端事件说 Interrupted。 前端显示"中断",而引擎仍然认为 Plan 是成功完成的。
根因
双 Boolean 是错误的数据模型。Completed + Interrupted 有四种组合,其中一种是非法的。更糟糕的是,终结逻辑散在三处代码中(nudge 耗尽、Run 结束、plan(complete)),每处各自判断互相矛盾。
教训
终态必须是枚举,不是 Boolean 组合。
最终的重构把双 Bool 替换为一个 PlanStatus 枚举------四个值:
planning:初始化,模型还在生成 Planactive:Plan 生成完成,正在执行completed:模型声明完成(plan(complete)或所有步骤 done)terminated:异常终止(Run 中断、nudge 耗尽、验证失败)
加上两个迁移函数:ApplyCompletion()(active → completed)和 ApplyTermination(reason)(active → terminated)。迁移表校验合法性------terminated → completed 是合法的(恢复后重新完成),completed → terminated 是非法的。
事件发射和状态迁移在同一个原子操作中------迁移成功才发射事件,失败只 Warn 不发射。这消除了"状态说 A、事件说 B"的脱节。
通用规则:如果一个数据模型用多个 Boolean 表达互斥状态,迟早会出现非法组合。 枚举 + 迁移函数是更安全的设计------非法迁移在编译期(类型系统)或运行时(迁移表校验)被拒绝,而不是留给每个消费者自己判断。
Bug #7:Run 异常终止不终结 Plan
症状
Run 因为各种原因异常终止------预算用尽、CycleDetector 检测到循环、上下文错误、引擎内部 panic 恢复------但前端 Plan 显示 "5/6 进行中"。永远。
根因
异常终止路径(共 11 种非 end_turn 的终止原因)只发射 EventRunEnd,不处理 Plan 状态。Plan 在 Run 异常终止后保持最后一次持久化的状态------通常是 "active" + 若干 pending 步骤。
Plan 变成了"死任务"------永远不会完成,永远不会被标记中断。 前端没有渲染"死任务"的逻辑,所以它就静静地显示"进行中"。
教训
每一种 Run 终止路径都必须检查 Plan 并收口。 如果 Run 结束了但 Plan 还有 pending 步骤,必须发射 Plan 终结事件(terminated 或 completed)。
修复在 Run 结束的 defer 中统一补发:非 end_turn 终止 + 有 pending 步骤 → ApplyTermination(run_interrupted) + EventPlanInterrupted。只有 end_turn + nudge 耗尽路径除外(那里已经有自己的终结逻辑,避免重复发射)。
通用规则:父生命周期的终结必须递归终结所有子生命周期。 Run 是 Plan 的父生命周期------Run 结束时,Plan 必须被终结。这和进程退出时必须清理子进程、HTTP 请求结束时必须关闭响应体是同一个原则。
七个 Bug 的统一视角
回顾这七个 Bug,可以提炼出几条跨越它们的统一教训:
教训一:Agent 系统中的状态机比传统软件复杂得多
传统状态机的状态迁移由确定性事件驱动------用户点击按钮、定时器到期、网络消息到达。事件的含义是明确的。
Agent 系统的状态迁移由 LLM 的工具调用 驱动。这带来两个特殊挑战:
- 幂等性要求更高------模型可能在不同轮次中重复同一个调用(因为上下文窗口中有重复信息),同状态迁移必须是安全的
- 错误消息直接影响后续行为------模型会"学习"错误消息中的模式,不合适的报错措辞会引导模型走向错误的策略
教训二:终态必须是闭合的、持久化的、全局一致的
- 闭合:终态集合用枚举表达,非法组合在类型系统或迁移函数中被阻止
- 持久化:每种终态都必须写入存储,不能只走事件通道
- 全局一致:终态内部不能有矛盾("完成 + pending 步骤")
教训三:事件发射必须和状态迁移在同一个原子操作中
Bug #6 的直接原因是事件先发射、状态迁移后执行。当迁移被拒绝时,事件已经不可撤回地告诉了前端一个虚假的状态。
先迁移,成功后才发射。
教训四:父子生命周期必须递归终结
Run 结束 → Plan 必须终结。Plan 终结 → 所有 pending 步骤必须收口。不能留下"孤儿"状态------那些看起来还在"进行中"但永远不会有进展的步骤。
这和分布式系统中的租约(lease)超时机制是同一个原理:如果一个活动没有明确的 owner 在推进它,它必须在有限时间内被清理。
行业中类似的问题
Plan 状态机的复杂性不是我们独有的。
2026 年的一篇 ICSE 论文("Are Solved Issues in SWE-bench Really Solved Correctly?")发现,SWE-bench 上 7.8% 的"通过"补丁实际上没通过开发者测试套件,29.6% 的补丁与参考答案有行为差异。"通过"的语义比想象中复杂得多------通过局部测试 ≠ 通过完整测试 ≠ 行为正确。
Temporal(workflow 引擎)的一篇博文记录了 Grid Dynamics 从 LangGraph 迁移到 Temporal 的过程。核心问题之一是 LangGraph 依赖 Redis 做状态管理------"We had to carefully manage the lifecycle and expiration of state, ensuring common requests weren't accidentally wiped out by newer cache updates." 状态过期、竞态条件、重启后丢失------和我们 Plan 缓存过期引发的 Bug #2 是同一类问题。
Docker 在 2026 年 6 月的一篇博文中复盘了 Kiro 删除 AWS 生产环境的事故(2025 年 12 月)。Amazon 事后推行了"controlled friction"------每次变更需要两人签批。这和我们 auto-verify 回滚的教训指向同一个方向:自动执行的决策(删除环境/回滚步骤状态)必须有人或模型在回路中确认。
一个更直接的案例是"Silent Starvation"论文中描述的规划-执行脱钩:规划层做了 452 次选择,执行层执行了 0 次,7 天没有错误信号。Plan 看起来在推进,实际一步没走------和我们的 0/14 问题在形式上同构。
总结
Plan 步骤状态机不是一个 20 行代码就能搞定的东西。在一个 LLM 驱动、多参与者(模型 + 引擎 + 前端)、支持中断和恢复的系统中,它需要:
- 枚举终态而不是 Boolean 组合
- 单一权威存储而不是 per-run 缓存
- 原子的状态迁移 + 事件发射
- 递归的生命周期终结
- 对 LLM 友好的错误消息措辞
- 幂等的同状态迁移
- 持久化每一种终态
七个 Bug,同一个教训:状态机的复杂性不在状态数量------在状态迁移的语义和参与者之间的一致性。
你现在能做什么
1. 终态用枚举,不用 Boolean 组合。 如果你的系统有"完成""中断""失败"等终态------定义一个枚举类型(completed | terminated | failed),不要用 isCompleted: bool + isInterrupted: bool。四种组合中必有一种非法,迟早有人触发它。
2. 同状态重试返回"已完成"而非报错。 Agent 重复标记 done 应该是幂等成功("already done, no-op"),不是错误。否则 CycleDetector 会把冗余的确认动作当成死循环。
3. 事件发射和状态迁移写在同一个函数里。 不要先发事件再改状态------如果状态迁移被拒绝,事件已经不可撤回地告诉前端一个虚假的状态。先迁移成功,再发射事件。
4. 父生命周期结束时遍历所有子生命周期。 Run 结束 → 检查 Plan 是否有 pending 步骤 → 有则收口。不要留下"看起来还在进行中但永远不会推进"的孤儿状态------前端会把它渲染成永久的"进行中"。
5. 错误文案要带"下一步建议"。 "terminal state" 让模型困惑------它不知道该怎么办。"already done (no-op)" 或 "Set status=in_progress first" 告诉模型接下来可以做什么。在 Agent 系统中,错误消息的措辞直接影响模型的后续行为。
引用来源
- ICSE 2026, "Are 'Solved Issues' in SWE-bench Really Solved Correctly?" --- dl.acm.org/doi/abs/10....
- Temporal Blog, "From prototype to production-ready agentic AI: Grid Dynamics" --- From prototype to production-ready agentic AI solution: A use case from Grid Dynamics | Temporal
- Docker Blog, "AI Coding Agent Horror Stories: The Agent That Deleted Production" --- AI Coding Agent Horror Stories: The Agent That Deleted Production | Docker
- "Silent Starvation: Dependency Deadlock and Planning Loop Failure Modes" --- zeltrex.com/papers/silent-starvation-2026.pdf
- arXiv:2606.14589, "When Errors Become Narratives: A Longitudinal Taxonomy of Silent Failures in a Production LLM Agent Runtime"
- Orchestrik, "AI Agent State Management: Why Stateless Agents Fail" --- AI Agent State Management: Why Stateless Agents Fail --- Orchestrik
- eClips Tech, "State Management in Agentic Workflows" --- State Management in Agentic Workflows: The Problem Nobody Designs For | eClips Tech