一批路测图片,需要找出施工、行人横穿和恶劣天气;一批商品图片,需要补齐类别与属性;一段段录音,需要整理成可以检索和分析的文本。模型给出判断后,这些结果还要和原始数据一起进入筛选、复核或数据集整理的下一步。
把这些任务连起来,流程其实很直观:读取数据 → 预处理 → AI 判断 → 检查结果 → 写出。 当处理对象从几条样本扩展到一批文件,这条流程还需要照顾并发调用、限流恢复和结果关联。
在 EMR Serverless Ray 中,Ray Data AI(ray.data.ai)将模型调用作为 Python 数据管道中的一个处理步骤。通过 Dataset 的 .ai 访问器,文本摘要、图片与视频理解、向量化、语音转写和候选重排,都可以与读取、过滤和写出组合使用。下面先介绍批量处理的几个特点,再看各个函数的用法和业务示例。
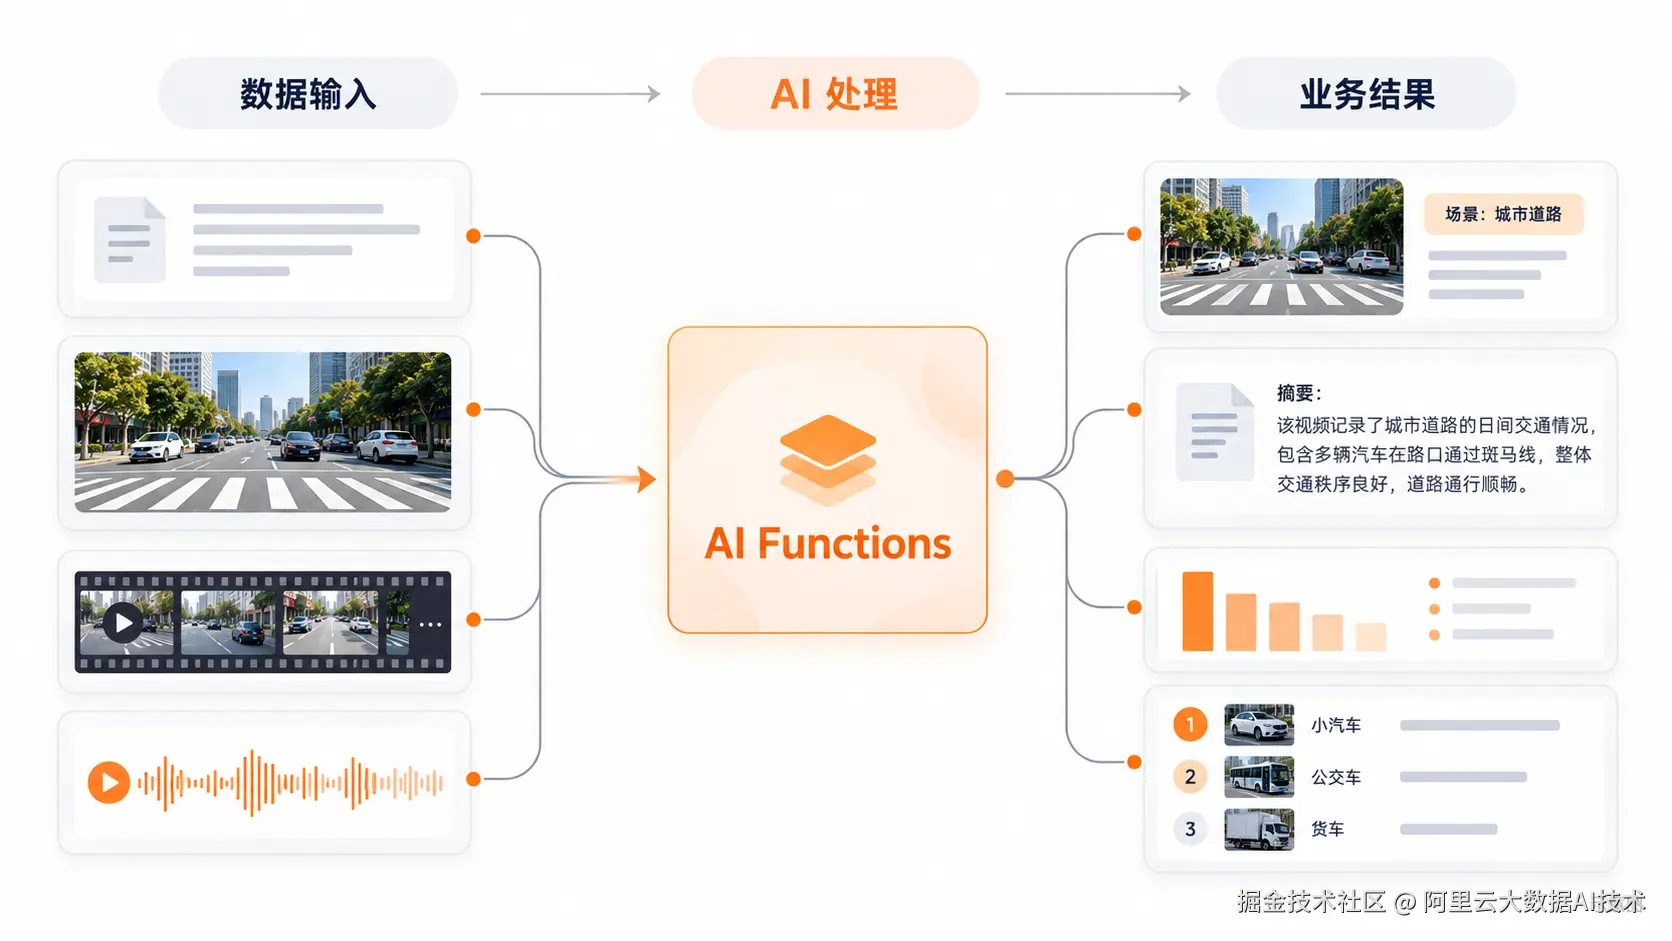
AI 处理与读取、转换、筛选和写出组合,形成完整的数据处理流程。
AI Function 的优势
EMR Serverless Ray 的 AI Function 将模型调用与分布式数据处理结合,提供从数据准备、并发调用到结果处理和用量观察的完整能力:
管道集成。 将数据读取、清洗、筛选、AI 推理和结果写出串联在同一份 Python 作业中,统一处理文本、图片、视频和音频等数据。可以先清洗文本、过滤低质量图片或整理视频帧,再调用模型完成摘要、打标、向量化等任务,最后按业务需要写出结果。AI 步骤可与现有的 Dataset 转换和自定义处理逻辑组合,利用 Ray 的分布式数据处理能力承接批量任务,减少跨系统导出、结果回填和中间文件维护,形成可复用的数据处理流程。
并发与容错。 平台通过异步并发重叠多个请求的网络与模型响应等待时间,减少逐条调用的空等,提高批量处理吞吐。运行中根据服务反馈自适应调整并发与发送节奏,在尽量利用可用服务额度的同时平滑发送请求。遇到请求过快导致的 HTTP 429 限流时,会自动退避重试,并在服务恢复后逐步恢复发送速率;常见网络抖动和临时服务错误也会按策略重试,减少短暂故障对任务的影响。大多数场景可直接使用默认设置,无需自行编写并发调度与限流恢复逻辑。
结果关联。 AI 函数会保留原有输入列,并将结果写入指定列,使业务 ID、原始文本或媒体地址与模型结果一并保留,便于追溯。后续可按需提取正文、向量或排名信息,继续筛选、分析和写出。例如,商品审核可同时保存商品 ID、图片地址和审核标签,供后续检索与复核。需要在某条模型请求失败后继续处理其他数据时,可选用相应的 try 入口,将重试后仍失败的行结果置空,保留其他行的处理结果,方便后续检查和处理。
用量统计。 作业日志会自动汇总模型请求数和服务上报的 token 用量,便于了解批量任务的调用规模,并比较不同模型、提示词和输入数据的用量变化。普通结构体结果还可通过 token_usage() 在代码中查看汇总用量,用于任务评估与成本分析;raw 和 rerank 调用的用量可从作业日志查看。结合处理行数和执行时间,可以评估数据处理流程的用量与效率。统计以模型服务实际返回的信息为准,未上报的字段保留为空,最终费用以模型服务账单为准。
AI 函数用法
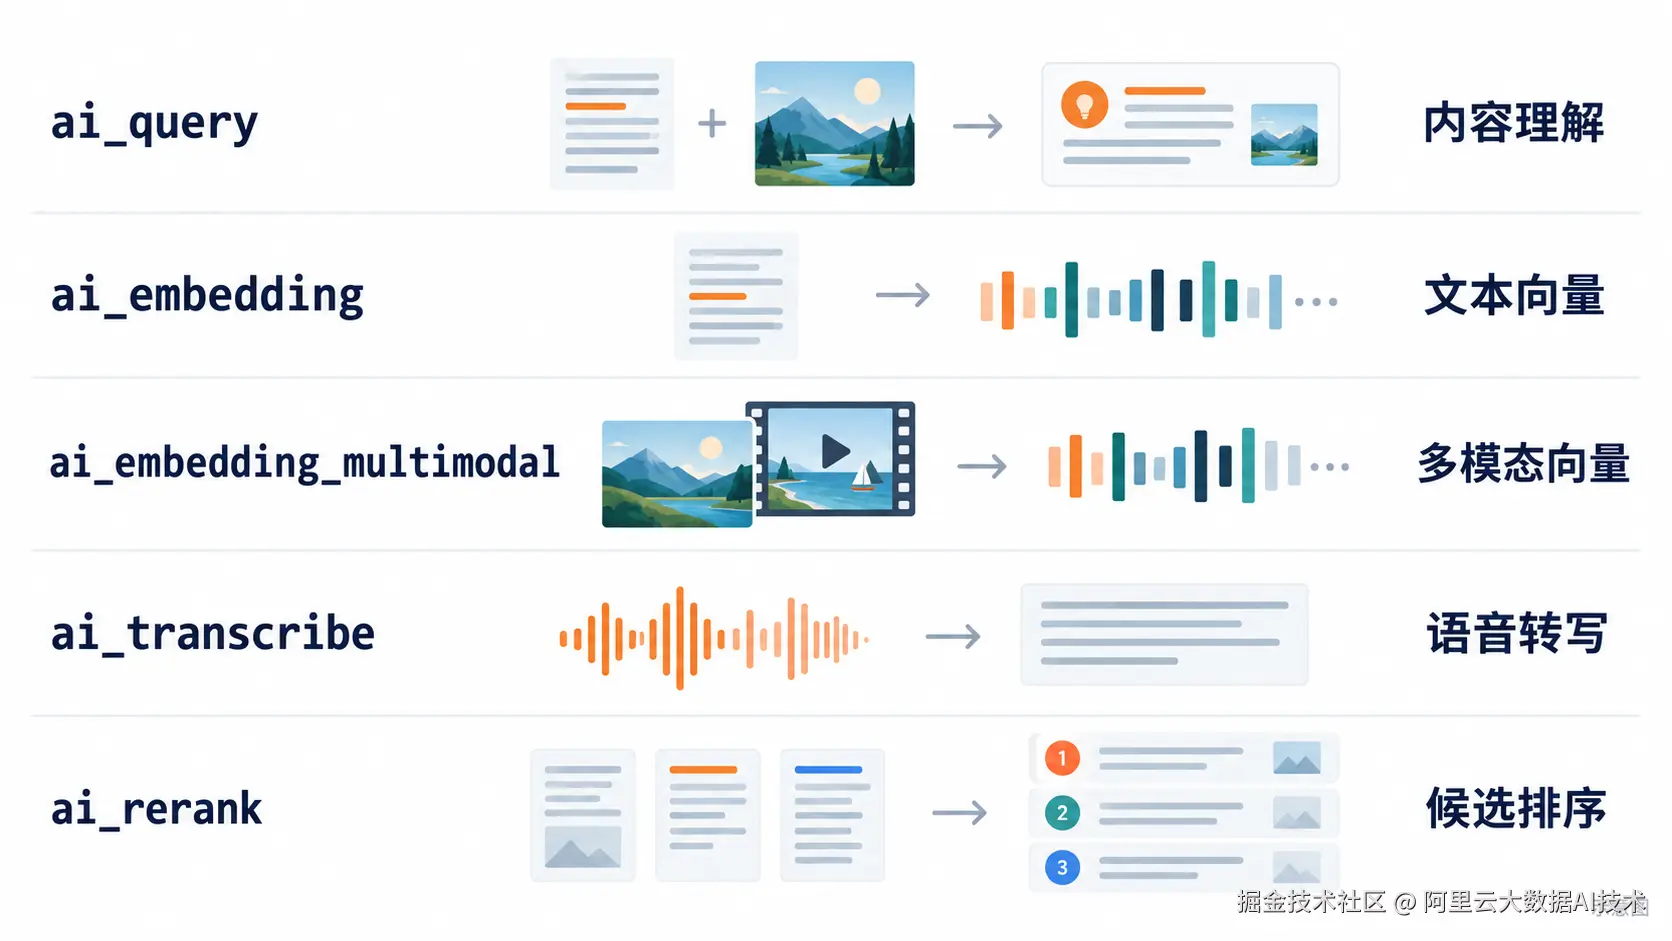
根据任务选择函数:内容理解、向量化、语音转写或候选重排。
适用范围:包含 ray.data.ai 扩展的 EMR Ray 运行环境。本文按 EMR Serverless Ray 最新版本接口编写;使用前请确认集群镜像已包含相应功能。
本文示例通过 service_name 指定工作空间中已登记的模型服务。示例名称需与实际配置一致,可用模态、输入大小、向量维度和服务额度以目标模型能力为准。
python
import ray
import ray.data.ai
from ray.data.expressions import col, lit

ray.init()
数据参数使用 col("列名") 引用每行的输入,使用 lit(value) 表示常量。例如,prompt=col("text") 逐行读取文本,prompt=lit("概括图片内容。") 为每行使用同一提示词。不能用裸字符串替代这两种表达方式。
output_col="answer" 指定结果列名;原有列会保留,同名结果列会被替换。返回的 Dataset 可以继续筛选、提取字段和写出。
根据希望得到的结果,可以选择不同的 AI 函数:生成正文、创建向量、转写音频,或重排候选。各函数的用途和结果读取方式如下:
| 函数 | 用途 | 普通结果的读取方式 |
|---|---|---|
ai_query |
生成、问答、图片与视频理解 | 结果结构体的 content 字段 |
ai_embedding |
单段或数组文本向量化 | 结果结构体的 embedding 字段 |
ai_embedding_multimodal |
图片、视频或文本向量化,取决于模型支持范围 | 结果结构体的 embedding 字段 |
ai_transcribe |
单音频语音转写 | 结果结构体的 content 字段 |
ai_rerank |
对每行的候选集重排 | 排名 JSON 数组字符串 |
ai_query
例如,输入表里已经有文章 ID 和正文,希望为每篇文章补上一句摘要。下面这段代码完成读取、生成摘要和写出,同时保留 ID,便于后续关联业务数据:
python
ds = ray.data.read_parquet("oss://<bucket>/corpus/raw_text.parquet")

answers = ds.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=col("text"),
    output_col="answer",
    options={
        "system_message": "你是文本摘要专家,用一句话概括核心观点。",
        "temperature": 0.3,
    },
)

summaries = answers.select(
    col("id"),
    col("answer").struct["content"].alias("summary"),
    col("answer").struct["error"].alias("error"),
)
summaries.write_parquet("oss://<bucket>/corpus/summarized/")
此例假设输入包含 id、text 两列。answer 是结果结构体,其中 content 为模型正文,error 为失败信息,还包含模型上报的 token 用量。
content 默认是字符串。需要 JSON 结果时,可在提示词中说明要求,再按业务需要解析和检查。
ai_embedding
为知识库准备数据或开展语义检索时,可以先把文本转换成向量。下面沿用前面的文本 Dataset,为每条记录生成向量,并保留原始 ID:
python
embeddings = ds.ai.ai_embedding(
    service_name="text-embedding-v4",
    input=col("text"),
    output_col="emb",
)
vectors = embeddings.select(
    col("id"), col("emb").struct["embedding"].alias("vector")
)
文本向量化可选择 text-embedding-v4 或 qwen3.7-text-embedding,通过 service_name 指定相应模型服务。 emb.embedding 是生成的向量。默认每行输入一段文本,得到一维向量;每行有多个文本时,设置 input_type="string_list" 并传入字符串数组,得到按输入顺序排列的二维向量。
输入为 None 时,该行结果也为 None。
ai_embedding_multimodal
以图搜图等任务需要先为图片准备向量。下面读取图片索引,将每张图片的向量附加到数据中,供后续建立检索索引使用:
python
image_index = ray.data.read_parquet("oss://<bucket>/products/image_index.parquet")
image_embeddings = image_index.ai.ai_embedding_multimodal(
    service_name="tongyi-embedding-vision-plus",
    data=col("image_uri"),
    data_type="uri",
    output_col="emb",
)
ai_embedding_multimodal 用于图片、视频或文本向量化,结果位于 emb.embedding。每行输入一个媒体或一段文本;文本输入使用 data_type="text",支持范围以所选模型为准。
用于同一检索任务的向量,应保持模型和向量配置一致。
ai_transcribe
会议录音、访谈和业务音频可以先转成文字,再继续做摘要、分类或检索。下面按音频索引逐条转写:
python
audio_index = ray.data.read_parquet("oss://<bucket>/recordings/audio_index.parquet")
transcripts = audio_index.ai.ai_transcribe(
    service_name="qwen-audio-3.0-asr-flash",
    data=col("audio_uri"),
    data_type="uri",
    output_col="transcript",
    options={"language": "zh"},
)
每行处理一个音频,识别文本位于 transcript.content。需要翻译或摘要时,可将转写文本继续传给 ai_query。
ai_rerank
检索得到一组候选后,可以根据用户的问题再排一次顺序,把更相关的内容放到前面。下面从三条商品描述中选出与通勤背包最相关的两条:
python
candidates = ray.data.from_items([{
    "query": "适合通勤的背包",
    "documents": ["轻便双肩电脑包", "大容量旅行箱", "折叠雨伞"],
}])
ranked = candidates.ai.ai_rerank(
    query=col("query"),
    documents=col("documents"),
    service_name="qwen3-vl-rerank",
    options={"top_n": 2, "return_documents": True},
    output_col="ranked",
)
每行提供一个 query 和一组候选,结果是按相关性排列的 JSON 数组字符串,包含原始候选下标 index 和分数 relevance_score。除文本外,也支持模型允许的图片 query 及文本、图片、视频候选。
使用 top_n 指定返回数量;设置 return_documents=True 可同时返回候选原文。
多模态理解
图片与视频理解可使用 qwen3.7-plus、qwen3.8-max 等模型,通过 service_name 指定相应模型服务。
给商品图片补齐类别后,就可以继续按类目筛选、统计或抽样复核。下面直接读取图片索引,将图片地址交给模型;提示词既可以来自每行数据,也可以使用统一常量:
python
images = ray.data.read_parquet("oss://<bucket>/products/image_index.parquet")
labels = images.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=lit("判断图片中的商品类别,并说明判断依据。"),
    data=col("image_uri"),
    data_type="uri",
    output_col="label",
)
生产媒体推理使用 uri,多图或视频帧使用 uri_list。binary / binary_list 仅用于功能测试,不可用于生产;大规模使用时性能较差。
从文件目录读取媒体时,设置 include_uris=True 输出完整的 uri 列,再通过 data=col("uri") 传入 AI Function。
单个视频使用 data_type="uri",传入带 .mp4、.mov 等后缀的视频地址。例如,每行传入一个视频地址,生成内容概述:
python
videos = ray.data.from_items([
    {"video_uri": "oss://<bucket>/videos/demo.mp4"},
])

video_analysis = videos.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=lit("概括这段视频的主要内容,并按时间顺序列出关键事件。"),
    data=col("video_uri"),
    data_type="uri",
    output_col="video_analysis",
)

video_analysis.select(
    col("video_uri"),
    col("video_analysis").struct["content"].alias("summary"),
).show()
示例沿用前文的初始化与导入,请将视频地址替换为实际地址。每行处理一个视频,模型正文位于 video_analysis.content。所选模型服务需支持视频理解,视频格式、时长和大小以模型要求为准。
已经抽帧的视频,也可以将同一视频按时间排序的图片 URI 放在一行列表中:
python
video_analysis = video_index.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=col("question"),
    data=col("frame_uris"),
    data_type="uri_list",
    options={"list_data_type": "video"},
    output_col="video_analysis",
)
此例假设 video_index 包含 question 和 frame_uris 两列;每行的 frame_uris 按时间顺序存放同一视频的图片帧。
一份合同往往需要结合前后页面才能读完整。PDF 各页已经转换成图片时,可以按页序组成图片列表,让模型一起提取需要的信息:
python
contracts = contract_pages.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=lit("提取合同中的甲方、乙方、金额和有效期,按 JSON 返回。"),
    data=col("page_uris"),
    data_type="uri_list",
    options={"list_data_type": "image"},
    output_col="contract",
)
contract_pages 需预先包含 page_uris 列,每行存储一份文档的有序页面 URI。模型正文仍在 contract.content 中,业务可自行解析 JSON 并检查字段和数值。页面数量和图片大小应符合目标服务的输入限制。
实战案例
前面的示例展示了不同的模型调用方式。把调用前的筛选和调用后的结果处理接起来,就形成了完整流程:下面一个案例先检查图片质量再识别场景,另一个案例让模型帮助筛选有价值的视频帧。
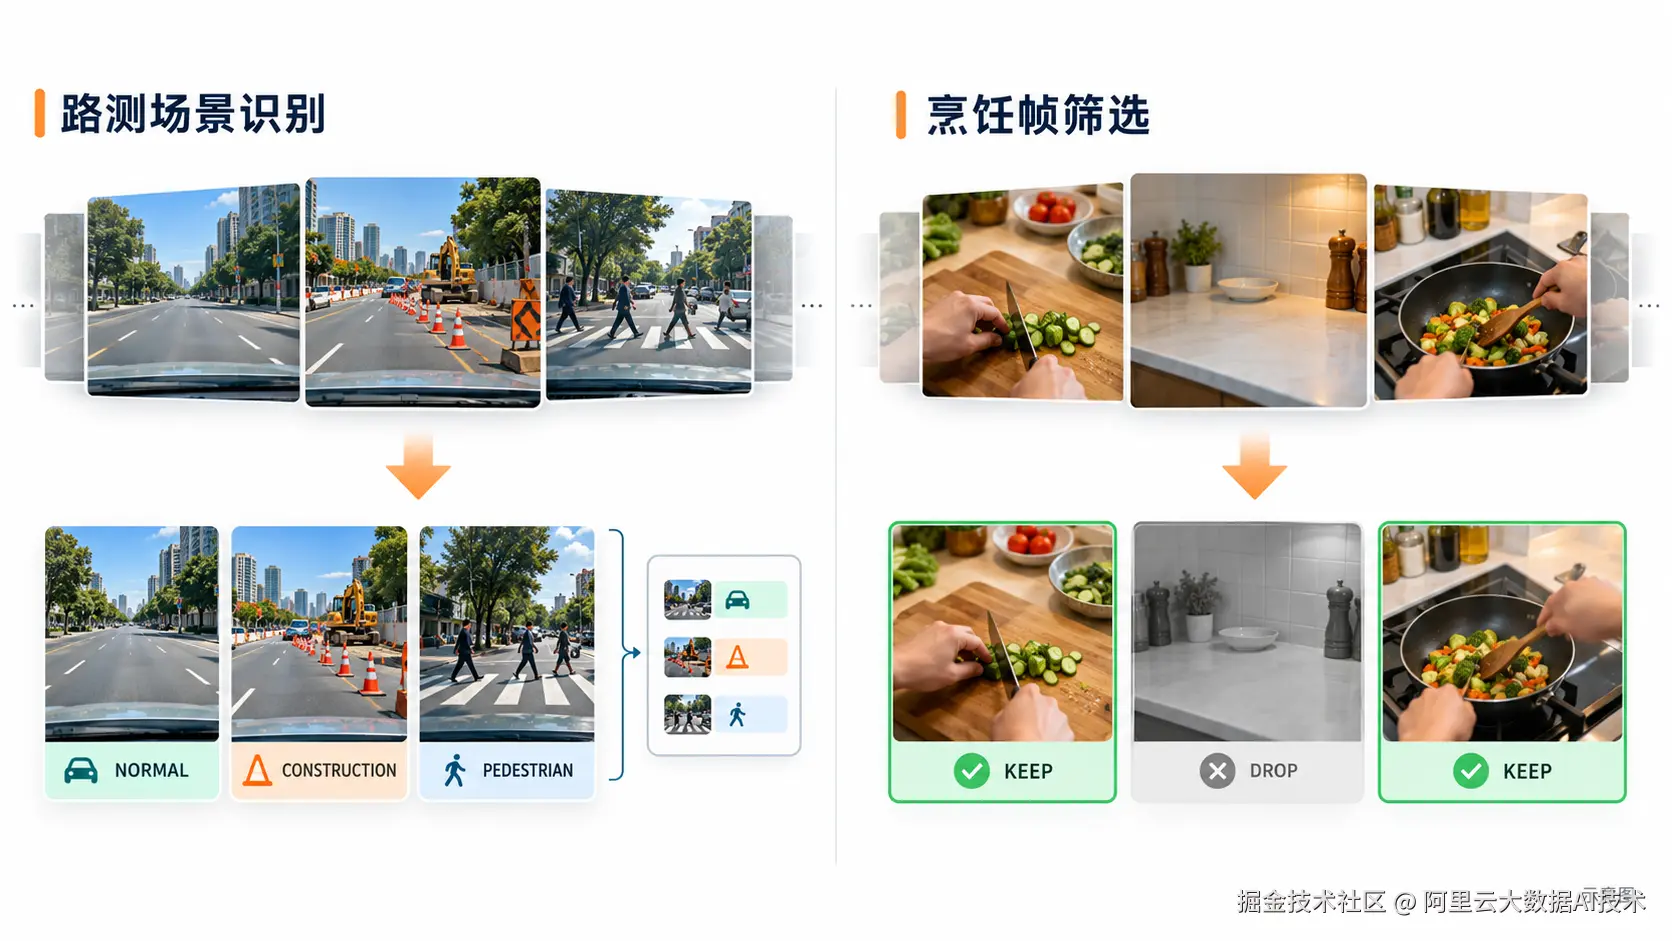
路测图片生成场景标签;已抽取的烹饪帧按操作内容筛选。
路测场景识别
路测图片里,正常道路画面占了很大一部分,施工、行人横穿和事故等场景更值得单独整理。可以先用图片质量规则筛掉分辨率过低、过暗或低对比度的画面,再让模型识别场景,把图片 URI 与标签一起留下,供后续检索和数据集整理使用。
以下代码沿用前文初始化,先检查图片质量,再将符合要求的图片 URI 交给模型。
python
import pandas as pd

INPUT_PATH = "oss://<bucket>/autonomous/camera_frames/"
OUTPUT_PATH = "oss://<bucket>/autonomous/scene_labels/"

images = ray.data.read_images(
    INPUT_PATH,
    include_uris=True,
    file_extensions=["jpg", "jpeg", "png"],
)

def filter_quality(batch: pd.DataFrame) -> pd.DataFrame:
    keep = []
    for image in batch["image"]:
        height, width = image.shape[:2]
        gray = image.mean(axis=2) if image.ndim == 3 else image
        brightness = float(gray.mean())
        contrast = float(gray.var())
        keep.append(
            width >= 1280 and height >= 720
            and 25 <= brightness <= 230 and contrast >= 100
        )
    return batch.loc[keep].reset_index(drop=True)

qualified = images.map_batches(
    filter_quality, batch_format="pandas"
).select_columns(["uri"])

labeled = qualified.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=lit(
        "判断图片属于哪个道路场景,只返回以下一个标签:"
        "NORMAL、PEDESTRIAN_CROSSING、CONSTRUCTION、"
        "EMERGENCY_VEHICLE、ACCIDENT、BAD_WEATHER。"
    ),
    data=col("uri"),
    data_type="uri",
    output_col="scene_label",
)

output = labeled.select(
    col("uri"),
    col("scene_label").struct["content"].alias("label"),
    col("scene_label").struct["error"].alias("error"),
)
output.write_parquet(OUTPUT_PATH)
质量阈值和标签集合可按业务调整。输出保留 error 字段,便于后续检查和处理失败行。
流水线为:读取图片 → 质量过滤 → AI 场景识别 → 写出 URI 与标签索引。
烹饪关键帧筛选
整理具身智能数据时,一段烹饪视频抽出的图片里,既有切菜、下锅等操作,也有等待和静止画面。对于已经抽取的帧,可以让模型继续筛选包含锅具、食材处理或手部操作的画面,为后续数据集整理提供候选帧索引。
python
FRAME_INDEX_PATH = "oss://<bucket>/cooking_videos/frame_index/"
OUTPUT_PATH = "oss://<bucket>/cooking_videos/kept_frame_index/"

# 输入索引的 uri 列指向已经抽取的图片帧。
frames = ray.data.read_parquet(FRAME_INDEX_PATH).select_columns(["uri"])

judged = frames.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=lit(
        "判断图片是否包含有效的烹饪操作画面,"
        "如锅具、食材处理或手部操作。"
        "包含只返回 KEEP,不包含只返回 DROP。"
    ),
    data=col("uri"),
    data_type="uri",
    output_col="answer",
)

rows = judged.select(
    col("uri"),
    col("answer").struct["content"].alias("decision"),
    col("answer").struct["error"].alias("error"),
)
kept = rows.filter(
    lambda row: row["error"] is None
    and isinstance(row["decision"], str)
    and row["decision"].strip().upper() == "KEEP"
)
kept.write_parquet(OUTPUT_PATH)
此例只保留正文为 KEEP 且没有错误的记录。输出为帧 URI 与判断结果组成的 Parquet 索引,原图片仍保留在原位置。
模型选择
下表列出本文示例所使用的模型清单。您也可以在 AI 中心自行选择满足业务需求的模型服务。
| 能力 | 函数 | 模型服务示例 |
|---|---|---|
| 文本、图片及视频理解 | ai_query |
qwen3.7-plus、qwen3.8-max |
| 文本向量化 | ai_embedding |
text-embedding-v4、qwen3.7-text-embedding |
| 图片向量化 | ai_embedding_multimodal |
tongyi-embedding-vision-plus |
| 语音转写 | ai_transcribe |
qwen-audio-3.0-asr-flash |
| 文本及多模态候选重排 | ai_rerank |
qwen3-vl-rerank |
失败处理与用量
需要在某行模型调用失败后继续处理其他数据时,可以选择相应的 try_ 入口,例如 try_ai_query 或 try_ai_embedding,失败行返回 None。模型服务配置、输入列等问题仍需修正。
需要保留模型服务的原始响应字段时,可以使用对应的 _raw 入口,例如 ai_query_raw。raw 结果为 JSON 字符串,可按服务返回格式解析。
构建 Dataset 后,在查看或写出结果时才会开始处理。需要多次查看、统计和写出同一份推理结果时,先调用 materialize(),再复用返回的 Dataset。
作业日志会自动汇总模型请求数和 token 用量,包括 raw 调用的用量。
在代码中,可用 token_usage() 汇总普通结果结构体中的用量;raw 和 rerank 的字符串结果可通过作业日志查看用量。
需要检查、汇总并写出同一份推理结果时,可以这样组织:
python
texts = ray.data.from_items([{"text": "请简述什么是向量检索。"}])
cached = texts.ai.ai_query(
    service_name="qwen3.7-plus",
    prompt=col("text"),
    output_col="answer",
).materialize()

print(cached.ai.token_usage(output_col="answer"))
cached.write_parquet("oss://<bucket>/inference/results/")
后续查看、统计和写出都使用物化后的 cached,即可复用这份推理结果。
模型未返回的用量字段会显示为空,最终费用以模型服务账单为准。
扩展到你的业务
真实业务里,模型调用前后往往还有自己的处理规则:清洗文本、计算字段,或者运行本地模型。这些逻辑也可以加入同一条管道,与内置 AI 函数组合使用。
通过继承 BaseOperator 并实现 process_row(),即可使用 .ai.apply() 接入自定义处理逻辑。例如,给文本增加长度列:
python
from ray.data.ai import BaseOperator

class TextLength(BaseOperator):
    def process_row(self, row):
        return len(row["text"])

with_length = ds.ai.apply(TextLength, output_col="text_length")
需要接入 HTTP 处理步骤时,也可使用 .ai.apply_http() 扩展管道。
同样的用法也可以用于下面这些场景,选择与手头业务最接近的一项,就能开始组织自己的数据流程:
| 场景 | 主要输入 | 使用的能力 |
|---|---|---|
| 商品图批量审核与属性提取 | 图片 URI | ai_query |
| 合同与多页文档信息提取 | 有序页面图片 URI 列表 | ai_query 多图输入 |
| 用户评论分类与摘要 | 文本 | ai_query |
| RAG 知识库向量化 | 文本或分段文本数组 | ai_embedding |
| 短视频内容理解与打标 | 视频 URI 或有序帧列表 | ai_query 视频输入 |
| 图片相似检索 | 图片 URI | ai_embedding_multimodal |
| 录音整理与后续摘要 | 音频 URI、转写文本 | ai_transcribe 与 ai_query |
| 检索候选排序 | query 与候选集 | ai_rerank |
可以先拿一份现成的文本表、图片索引或录音列表,选一个具体目标:生成摘要、补齐标签,或者整理成可检索的向量。先用一小批数据跑通读取、AI 处理和写出,检查业务结果、失败行、用量和耗时,再逐步扩大规模。
当图片有了标签、录音有了文字、文本有了向量,下一步的筛选、分析和检索就有了可以使用的数据。把这些步骤接回同一条 Ray 数据管道,就可以从一次模型调用,走向可反复运行的业务流程。