TL;DR :斯坦福 Ré 组的最新工作把「基准测试会像软件一样腐烂」变成了一个可测量、可维护的工程问题------他们提出基准维护债务 概念,用「智能体审计 + 人工把关」的持续验证流程给 Terminal-Bench 2.0 做体检,结果约 30% 的任务带缺陷 ;修复版 2.1 让 19 个智能体的整体准确率上涨超 10 个百分点,个别模型榜位移动 3 名。更扎心的是:一半以上的失败试验其实是超时,把时间预算拉长后,20 个百分点的 harness 差距几乎消失。
先问一个可能戳到你的问题:你上个月盯着的那个 Agent 榜单,今天还准吗?
做 agent 的朋友对这套流程太熟了:新模型发布 → 官网贴出 SWE-Bench / Terminal-Bench 分数 → 你默默把自己的 agent 和它对齐 → 榜单成为 roadmap。但很少有人想过:那个基准本身,可能已经悄悄烂掉了。发布时千锤百炼的任务,几个月后可能因为依赖的包升级了、API 改版了、网页下线了而跑不起来;更隐蔽的是,模型变聪明之后会找到基准设计者当年没想到的合法解法------然后被一个过时的验证器判负。
这不是假设,而是斯坦福 Crystal Zhou、Scott Linderman 和 Christopher Ré 在这篇新论文里实测出来的现状。他们给这种「分数与真实能力之间的裂缝」起了个名字:基准维护债务(benchmark maintenance debt)------和软件的技术债一模一样,不发版修复,它只会越滚越大。
资源(想自己动手的先收藏)
- 论文:arXiv 2611.08417
- Terminal-Bench 仓库:GitHub · harbor-framework/terminal-bench
🧊 基准到底是怎么烂的?
论文把一个可执行智能体任务拆成五件事:指令 (给 agent 看的题面)、环境 (Docker 镜像)、oracle (已知正确的参考解法)、测试 (agent 停下后跑的评分代码)、资源(CPU/内存/时间预算)。每一件都会烂,而且烂法各有各的花样。
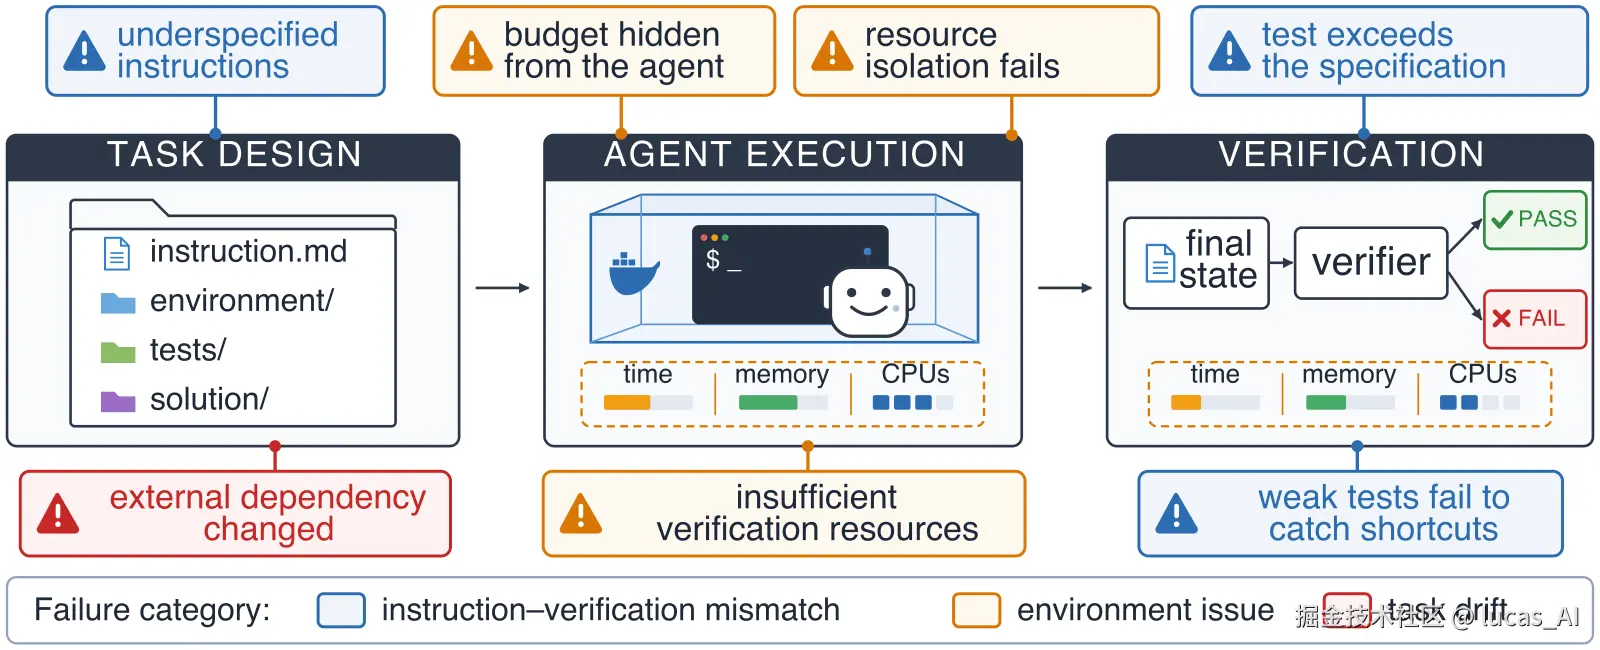
论文把缺陷归成三类,你可以对照自己踩过的坑:
- 指令--验证不匹配:题面和评分标准说的是两回事。最典型的例子是一个数据库优化任务:题面只说「优化查询」,评分代码却偷偷要求输出文件字节级不变------ agent 干得再好,一个字节没对齐就判零分。
- 任务漂移:任务依赖外部世界的状态(包版本、公共 API、网页内容),发布之后世界变了,任务也跟着变了。
- 环境问题:任务本身没毛病,但内存给少了、时间给紧了,正确解法都跑不完。
听起来离谱,但数据就是这么写的:Terminal-Bench 2.0 发布前经过了人工审查、LM 辅助审计和红队测试,属于「出生即巅峰」的基准------发布后几个月,issue 区还是积累了 50 多条任务缺陷报告。一次性验证,防不住持续腐烂。
🛠️ 斯坦福的修法:把基准当代码管
那怎么办?论文的答案朴素得漂亮:既然基准像软件,就用维护软件的方式来维护它------持续集成、缺陷分类、修复验证、版本发布,一样不少。
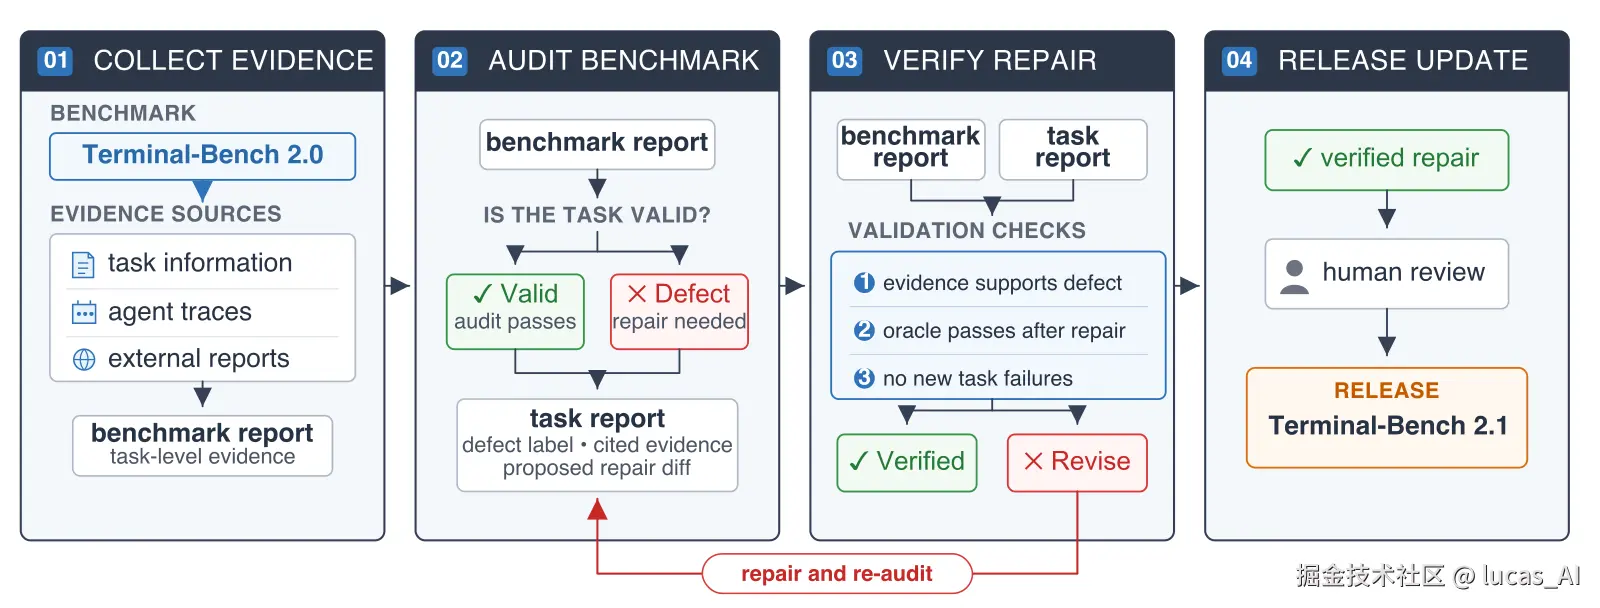
具体流程是三个智能体接力,最后由人类把关:
- 证据收集 agent:汇总三路证据------任务静态文件、历史 agent 执行轨迹、社区 issue 报告,整理成结构化的证据档案。它只负责「摆事实」,不做判断。
- 审计 agent:按一套动作导向的量规给任务打缺陷标签(就是上面那三类,外加「无缺陷」),并给出修复建议。
- 验证 agent :唱反调的角色------复核证据、挑战标签、实际重跑 oracle 参考解法。这一步很关键: pilot 阶段发现光靠审计员打标签,任务漂移的检出很不可靠,而「参考解法跑不跑了」是确定性的硬信号。
- 人类维护者:修复以带完整证据的 draft PR 提交,人审通过才进版本。
这套流程靠谱吗?论文拿两个顶级编码智能体(Claude Code 跑 Opus 4.6、Codex 跑 GPT-5.4)当独立审计员做了交叉验证:两者在全部 89 个任务上的缺陷分类一致度 κ=0.80------不同审计员看同一批任务,结论基本一致,说明量规是稳定的、不是玄学。便宜的模型只能做「有没有问题」的二分判断,「问题出在哪类」还是得靠强模型加 oracle 重跑。
🔍 体检结果:三成任务带伤
对 Terminal-Bench 2.0 全量 89 个任务跑完这套流程,结果是 28 个任务确认需要修复(约 1/3),其中 14 个是这次审计新发现的,另外 14 个与此前社区报告、Terminal-Bench Verified 审计的发现重叠。修复随 Terminal-Bench 2.1 一起发布。
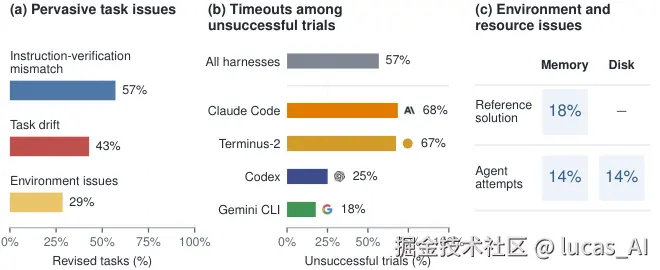
按修复约定,三类缺陷各有各的修法:不匹配的把约束显式写进题面(或放宽过严的验证器);漂移的把依赖钉死版本或干脆移除;环境问题则设一条可行性下限 ------参考解法和评分器必须在预算内 1.5 倍冗余地跑通。这条「1.5 倍」规则值得抄走:既防基础设施噪声造成假阴性,又不会大改任务难度,关键是可审计------比拍脑袋调参数强多了。
📈 修完之后,榜单发生了什么?
论文重跑了 19 个智能体在两个版本上的完整评测,结论可以概括成一句话:整体排序稳如老狗,个体分数天翻地覆。
- 排序相关性 Spearman ρ=0.958------榜单前十还是那批人,模型强弱的大格局没变。
- 但整体准确率上移超过 10 个百分点 ,个别智能体榜位移动 3 名,单个分数最多变动 12 个百分点。
- 提升最猛的集中在指令--验证不匹配的修复上:5 个任务的通过率从 ≤15% 修到 >50%------之前不是 agent 不会做,是基准不认账。
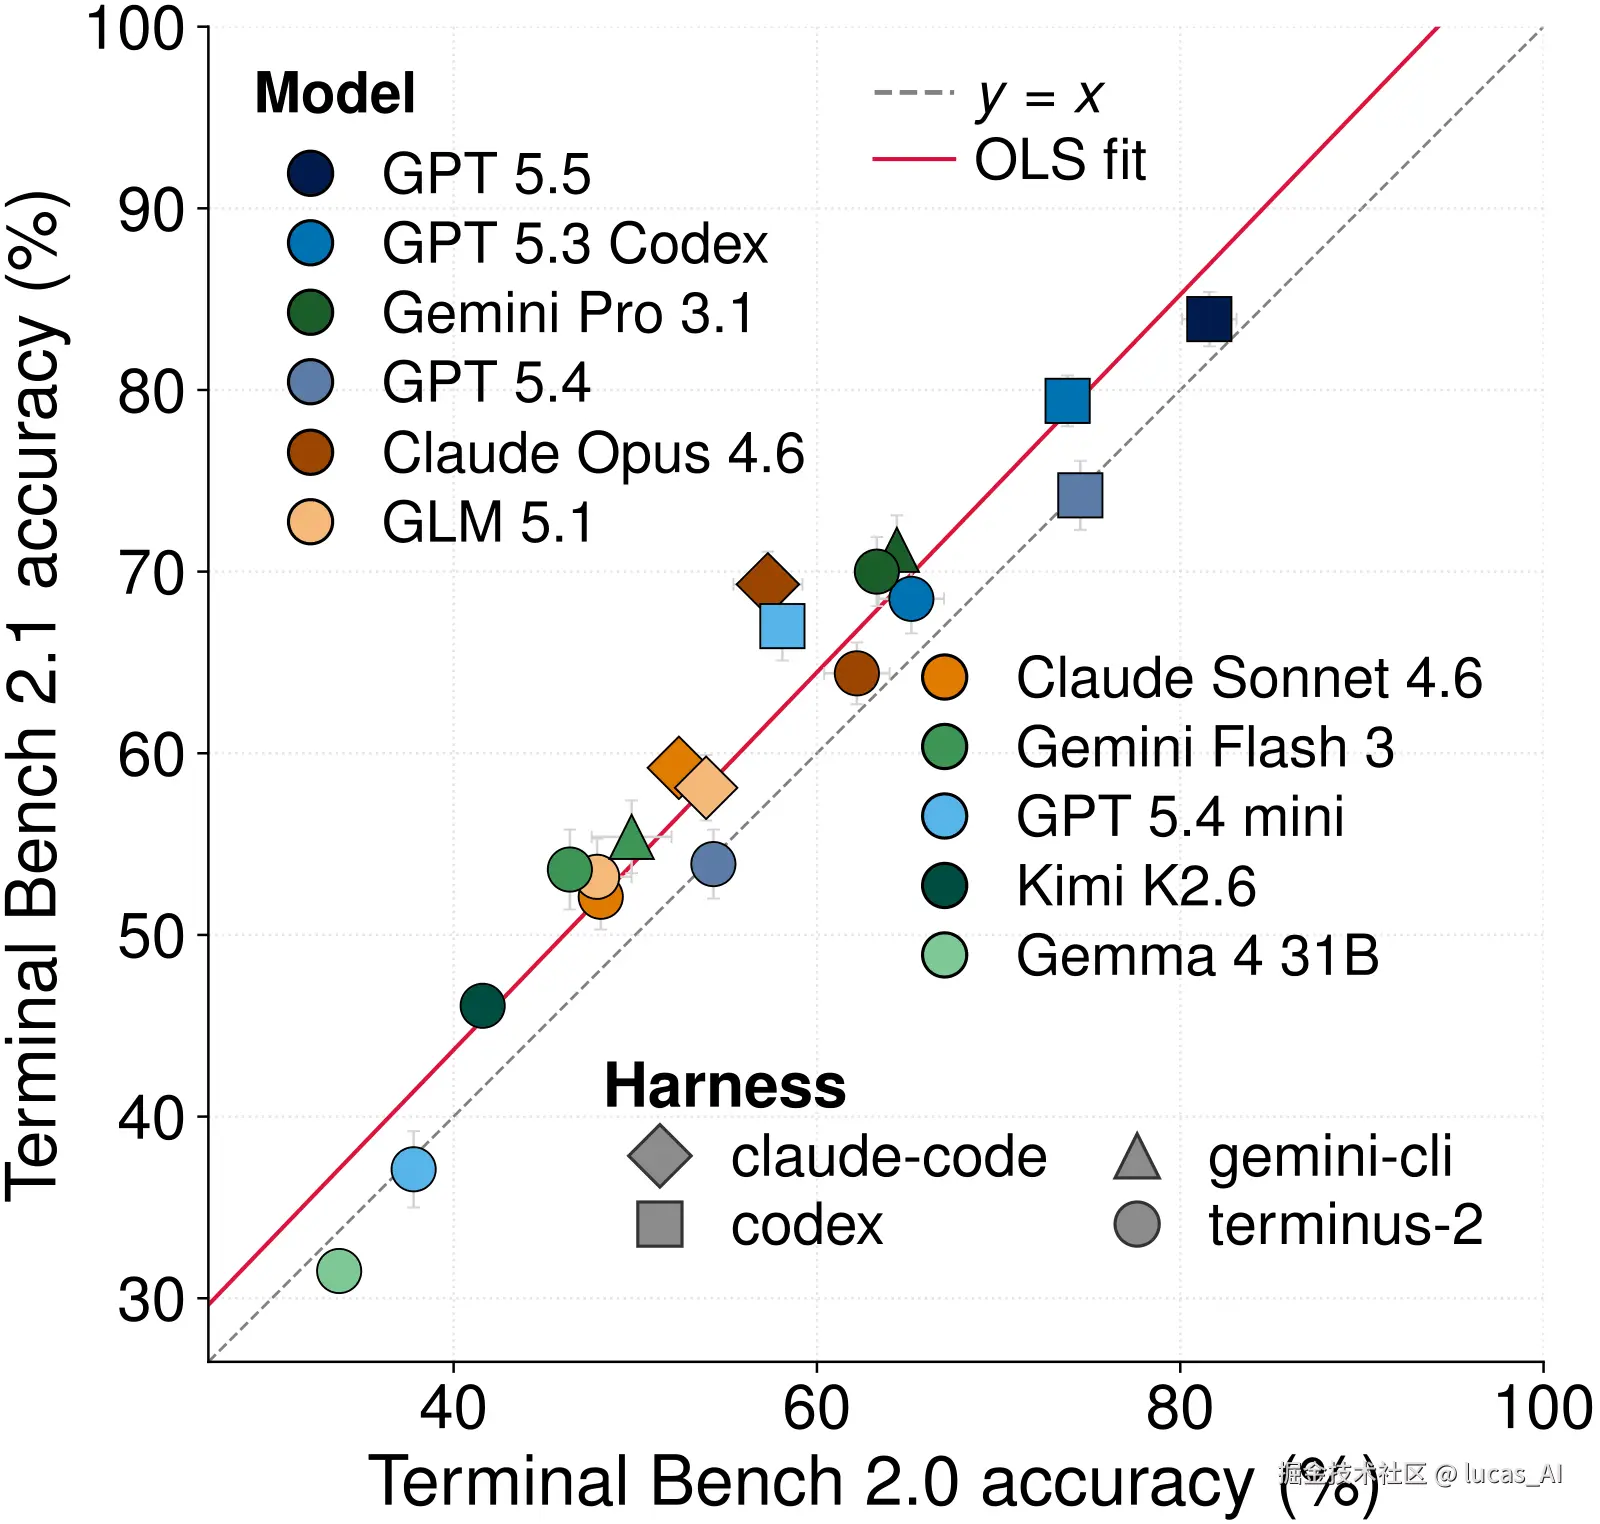
我的读法是:这个结果对「刷榜焦虑」是一种解药,也是一副清醒剂。解药在于------基准修复不会让强弱格局洗牌,头部模型的领先是真的;清醒在于------任何两个分数接近的模型之间的比较,都可能因为基准版本翻转。下次引用分数,记得问一句:哪个版本?
⏱️ 最扎心的发现:时间预算才是隐藏 boss
如果说任务修复还在意料之中,那论文关于资源预算的发现就真的有点颠覆了。
默认时间预算下,19 个智能体的失败试验里超过一半是超时------claude-code harness 下这个比例高达 68%。也就是说,你以为模型「不会做」的题,很多只是「没做完」。
论文做了一个狠实验:把时间预算拉到原来的 32 倍,看覆盖率怎么变。结果:
- GPT 5.4 在 Codex 和 Terminus-2 两个 harness 之间有约 20 个百分点的差距------时间拉长后差距几乎被抹平;
- GPT 5.4 mini 的 30 个点差距,缩到只剩 5 个点;
- 大预算下超时基本消失,剩下的失败才是真不会。
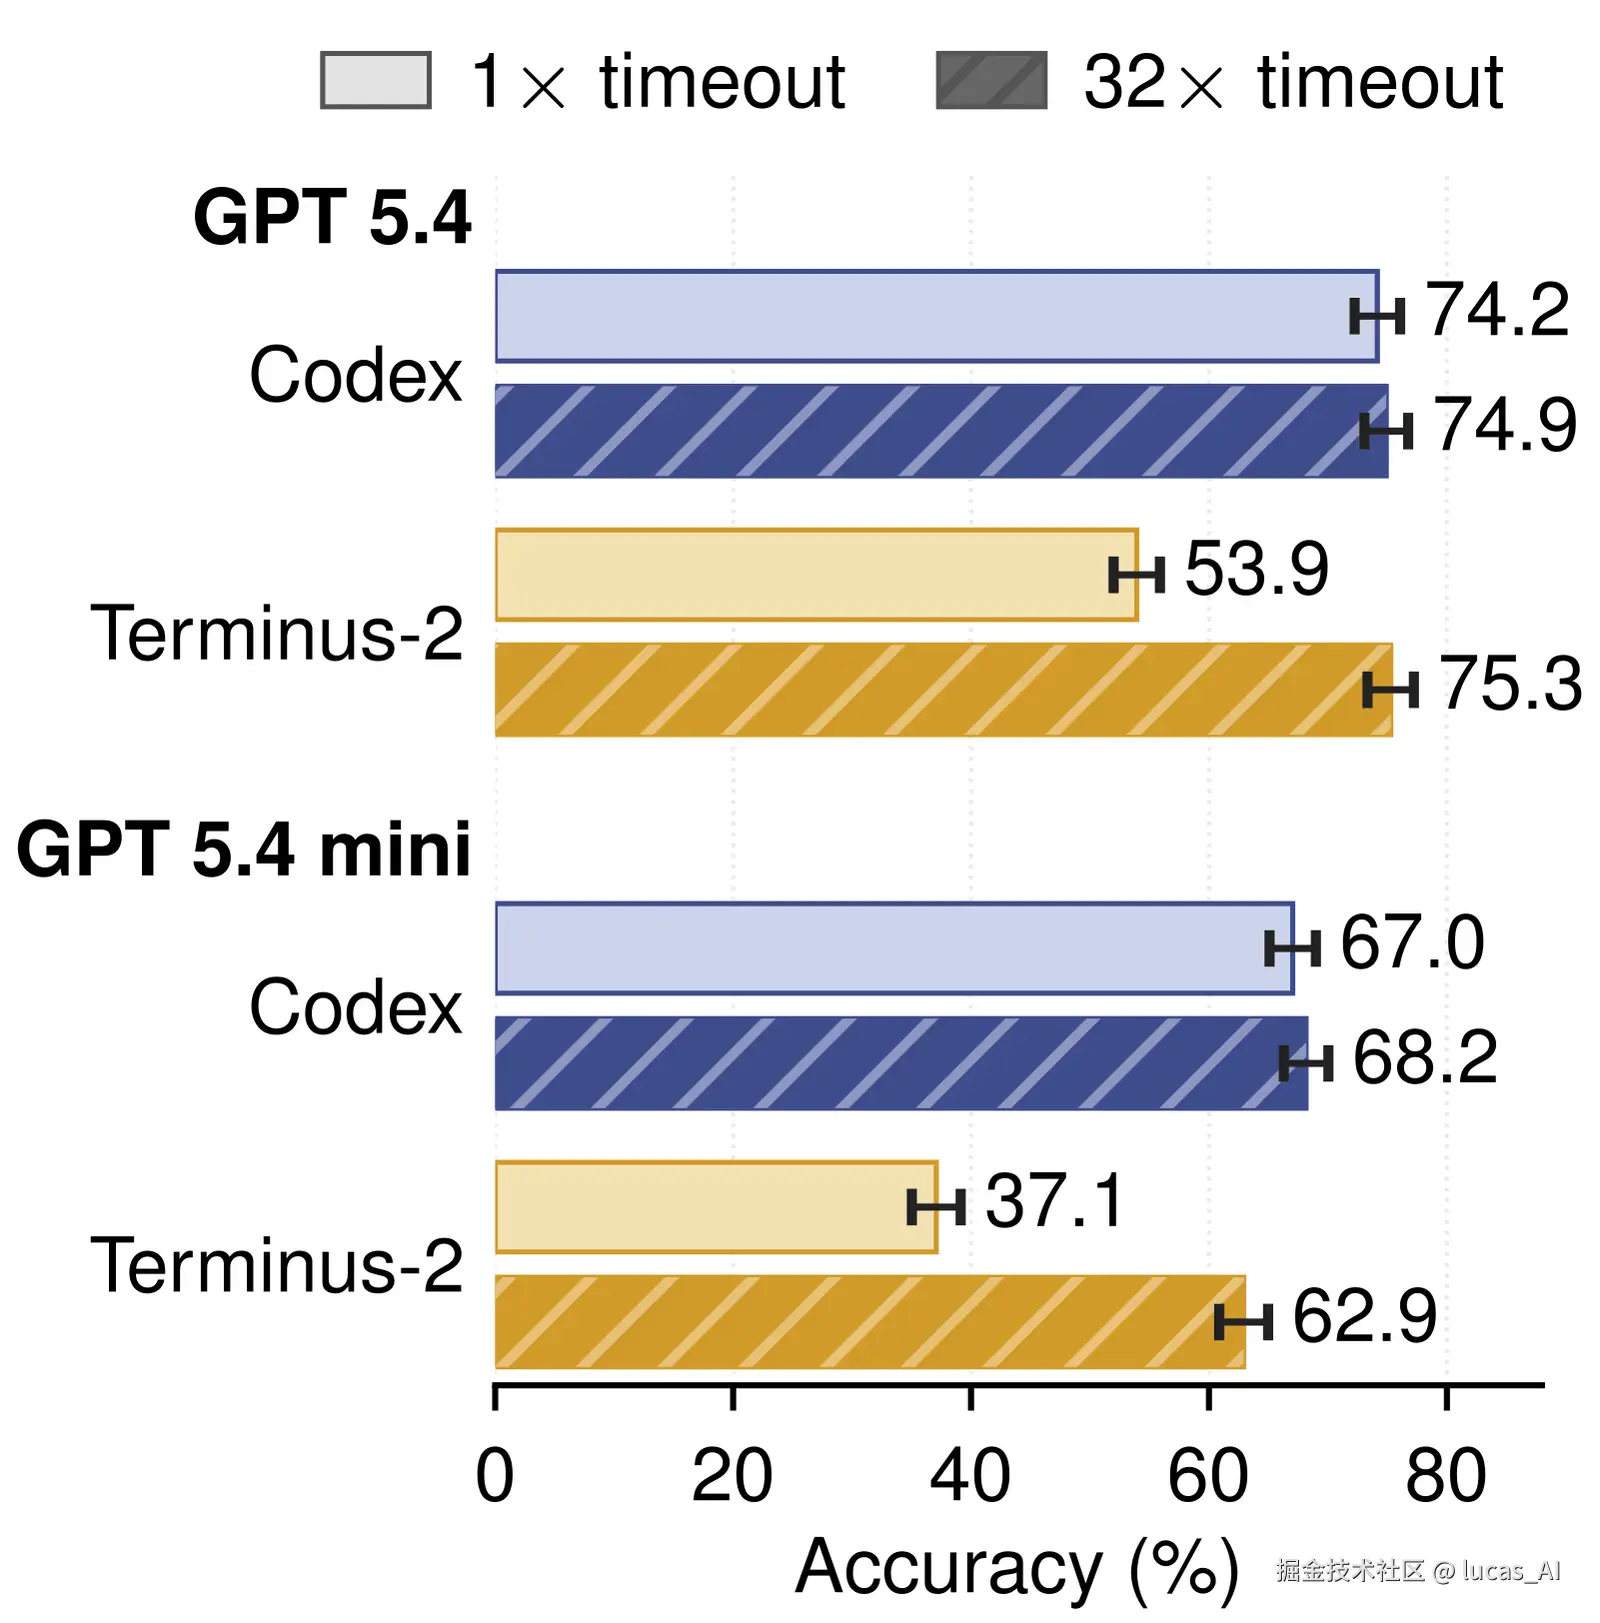
换句话说:固定时间预算是测量规范里的一个任意操作点,而它可能在系统性地「冤枉」慢但强的选手。你看到的很多「harness 差距」,本质是速度差距。这对所有做 agent 评测的人是一条硬建议:报告分数时必须同时报告 harness 和资源预算,有条件就做预算敏感性检验------否则你量到的可能只是「谁跑得快」,不是「谁更聪明」。
💡 对你的评测体系意味着什么?
这套思路完全可以抄进自己团队的内部评测,我总结四条可执行的:
- 把基准当代码管:版本号 + 任务级 digest + 公开的变更记录,每次发布都是带 changelog 的 numbered release。
- 审计量规直接拿走用:四类缺陷标签(无缺陷 / 指令--验证不匹配 / 任务漂移 / 环境问题)+ 三条修复约定,论文里写得明明白白。
- 给资源预算设可行性下限:参考解法 1.5 倍冗余跑通是底线,预算即难度,改预算要留痕。
- 重跑 oracle 检测漂移:审计员的判断会漂,但「参考解法跑不跑得通」是确定性信号,定期自动跑一遍最便宜。
内部评测集往往比公开基准更缺乏维护------没人盯 issue、没有社区报告,腐烂得更安静。这篇论文的流程就是给这些「黑屋评测」的一剂处方。
🧊 泼冷水时间
好话说完了,几个该打问号的地方也要摆出来:
- 「三成有缺陷」站在前人肩上:28 个修复任务里,11 个来自 Terminal-Bench Verified 此前审计、5 个来自公开 issue,真正新发现的只有 14 个。标题数字震撼,但增量发现是「一半的一半」。
- 工作流的评估有点循环:修复集本身就有工作流参与构建,57.1% 精确率 / 71.4% 召回率衡量的是「与终版的一致性」,不是独立发现缺陷的能力。
- 静默漂移仍是盲区:oracle 重跑能抓「参考解法挂了」的漂移,抓不住「参考解法还能跑、但任务已经变味」的漂移------论文没有讨论这种情况的检出率。
- 成本没有披露:三个智能体接力 + 32 倍时间扫描,算力开销可想而知,论文对复现成本只字未提。
🤔 理性看待
这篇论文的价值不在某个惊艳的技术,而在它把一件大家都隐隐感觉到的事变成了流程和数字:基准会腐烂、腐烂可分类、修复有章法、修复会改变结论但不改变格局。「Terminal-Bench 2.1 是一个检查点,而不是终点」------论文结尾这句话,值得每个维护评测体系的人裱起来。
对普通开发者,takeaway 就一条:下次看到任何 benchmark 分数,先问版本、harness 和时间预算。三个问题问完,你会避掉大半的无效比较。