最近整理办公与开源工具推荐站,DBX 放在首推位置,我想先看看它用起来怎么样。功能清单很长,先从一个能核对答案的小任务开始:打开本地 SQLite 库,统计每位客户的已完成订单金额。
从新建连接、浏览表,到编辑、格式化和执行 SQL,整个流程都走通了,查出的三行数据也与样例基准一致。模型配置好后,又试了自然语言生成 SQL 和连续追问。两轮生成的语句都没手动改过,执行结果也都正确。
环境与测试范围
| 项目 | 本次环境 |
|---|---|
| 测试日期 | 2026 年 11 月 6 日基础查询;11 月 7 日补测 AI |
| 系统 | Windows 11 家庭中文版,Build 26200,系统缩放 125% |
| DBX 下载版本 | v0.6.67,Windows x64 portable |
| EXE 文件版本 | 0.6.67-beta.20261105.1 |
| 数据 | 本地 SQLite,3 位虚构客户、6 笔虚构订单 |
| 本次验证 | 连接、查表、SQL 格式化、只读汇总查询、两轮自然语言生成 SQL 与执行 |
| AI 环境 | 用户预先完成模型配置;DBX 模型选择器显示 MiniMax-M3,使用 Ask · 通用问答 |
软件可以从 DBX 官网下载,这次使用的版本对应 v0.6.67 发布记录。发布标签和 EXE 文件版本写法不同,表里都记下来了,复现时可以对照。
这篇只记录小样本下的使用体验。MySQL、PostgreSQL、远程连接、大表性能和数据导出都还没测,也没有拿其他数据库客户端来做对比。
从一个 SQLite 文件开始
用提前准备好的 sample.sqlite,把连接名称设为 DBX-Review-20261106,接下来按这几步操作:
- 点击顶部"新建连接"。
- 在"轻量数据库"分类选择 SQLite,进入下一步。
- 填写连接名称,用文件选择框打开样例库。
- 点击"测试",界面显示"连接成功",再"保存并连接"。
- 展开新连接下的
main → 表,可以看到customers和orders。
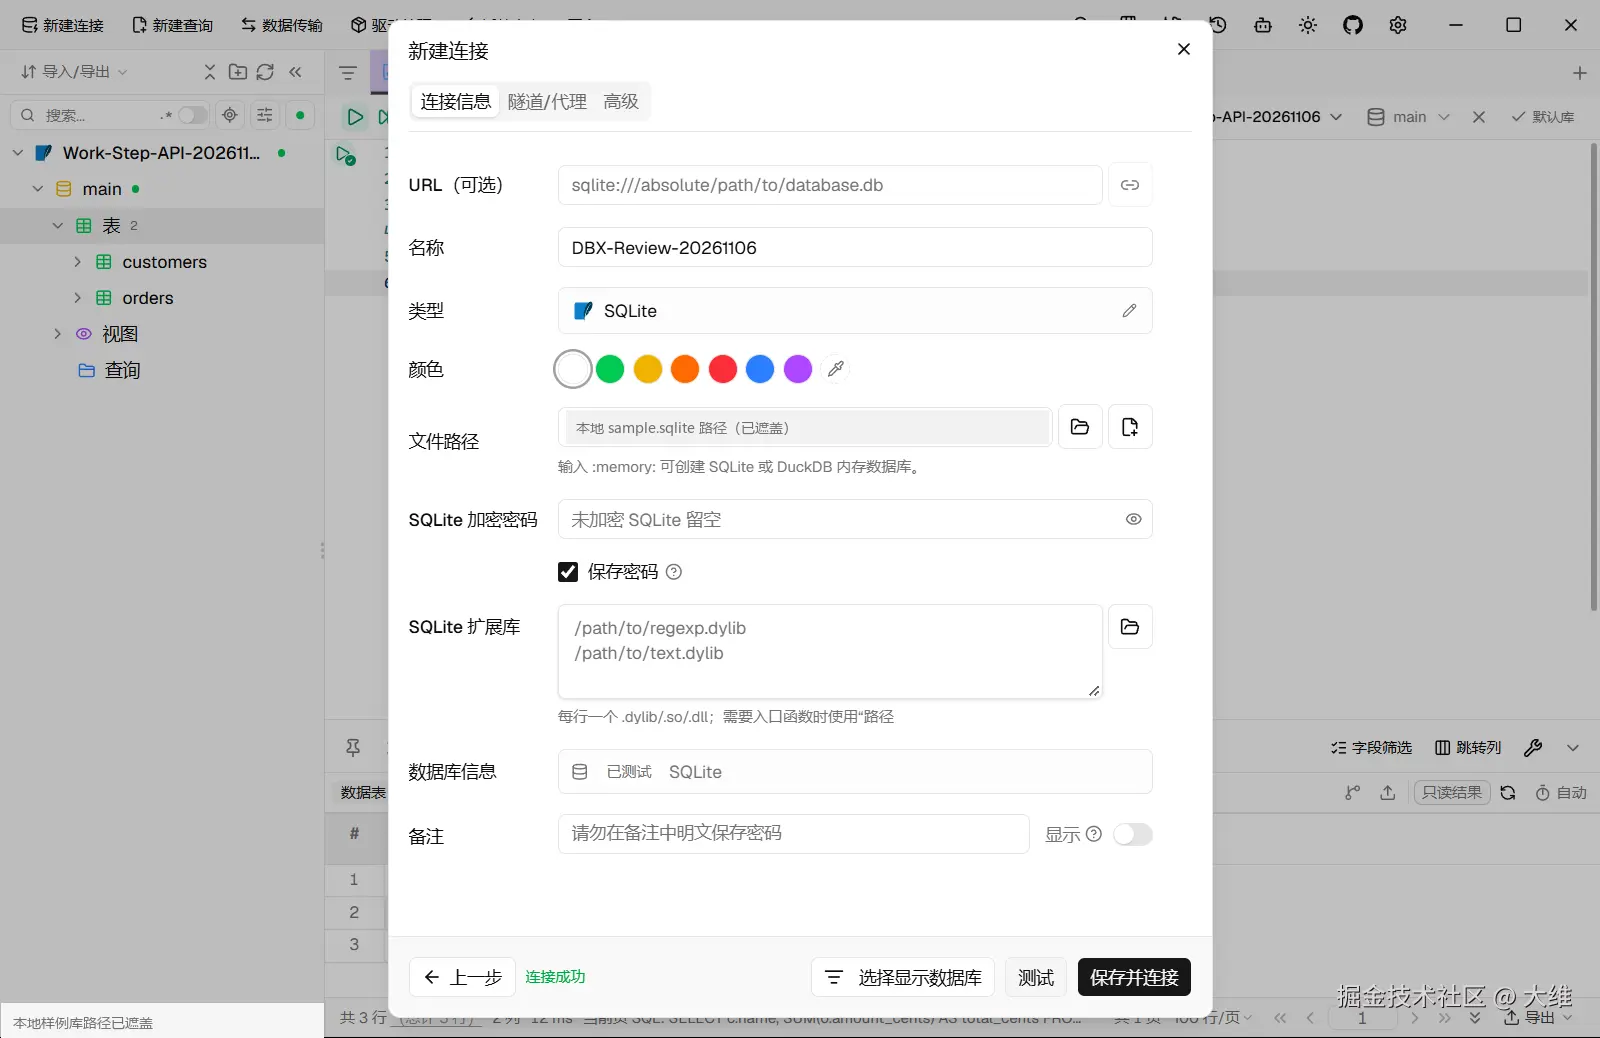
打开这个 SQLite 文件不需要额外启动数据库服务器,过程中也没遇到要另装 SQLite 驱动的步骤。连上以后,双击 orders 就能看到订单。
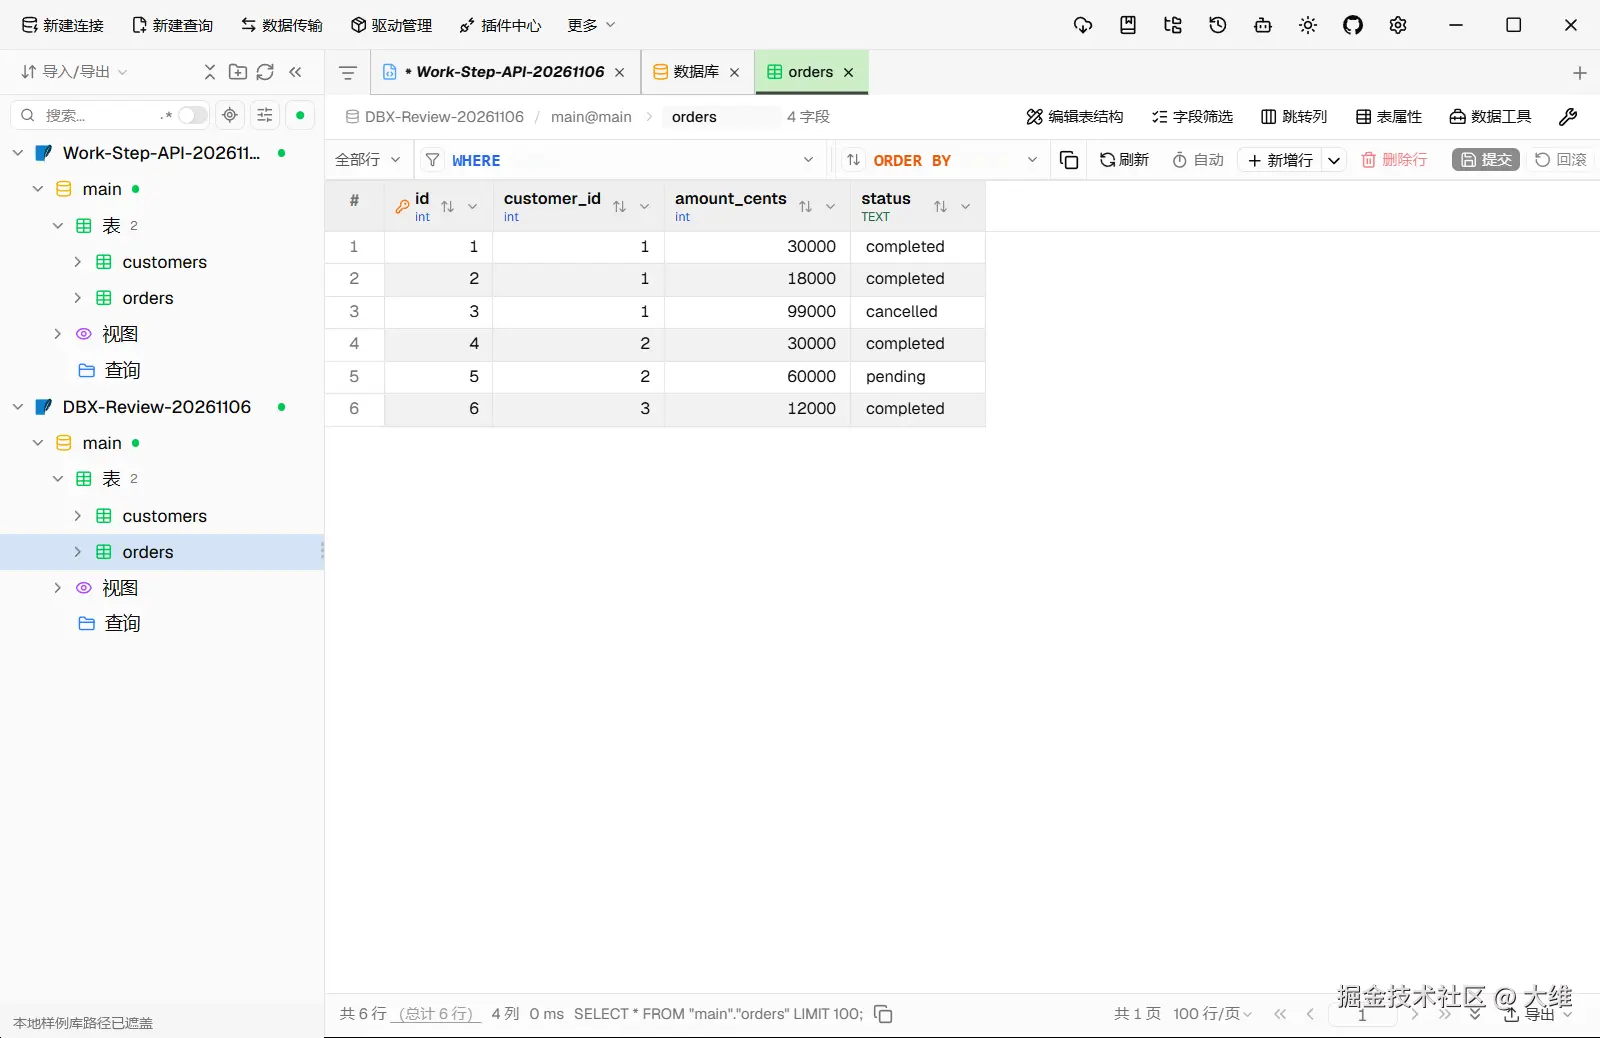
样例里故意留了两笔容易算错的订单:客户 1 有一笔 99000 分的 cancelled 订单,客户 2 有一笔 60000 分的 pending 订单。这两笔都不该计入汇总。有了它们,才能检查 SQL 是否按要求过滤了订单,光是运行成功还不够。
查出三行数据,再对照原始订单
在当前连接里新建查询,输入下面的 SQL。样例金额按整数分保存;语句按订单状态筛选,关联客户表后汇总、排序。
sql
SELECT c.name, SUM(o.amount_cents) AS total_cents
FROM customers AS c
JOIN orders AS o ON o.customer_id = c.id
WHERE o.status = 'completed'
GROUP BY c.id, c.name
ORDER BY total_cents DESC, c.name;
点一下格式化按钮,单行语句就会排成方便阅读的多行 SQL。执行后,结果出现在编辑器下方:
| 客户 | total_cents(分) | 换算为元 |
|---|---|---|
| 星河工作室 | 48000 | 480.00 |
| 青山设计 | 30000 | 300.00 |
| 远帆咨询 | 12000 | 120.00 |
DBX 显示的是前两列,最后一列换算为元,方便阅读。
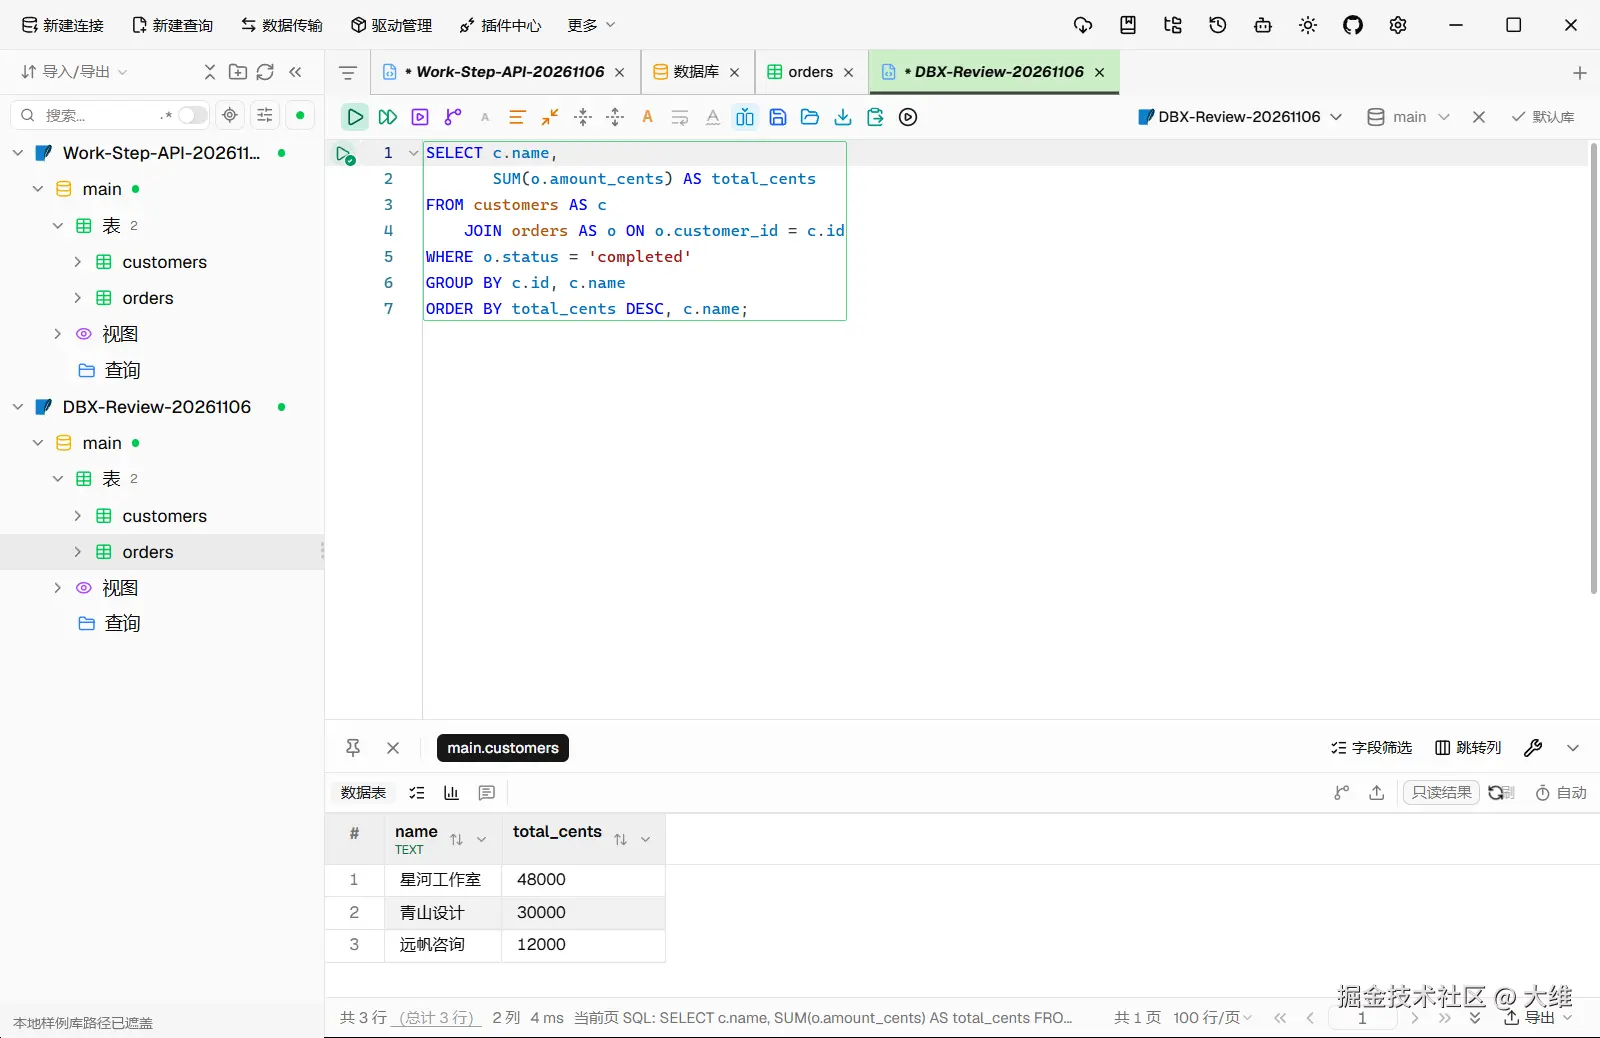
对照原始订单:星河工作室是 30000 + 18000 = 48000 分;青山设计只算 completed 的那笔 30000 分;远帆咨询是 12000 分。两笔待处理或已取消的订单都被排除了,金额也按降序排列,结果对得上。
状态栏显示"总计 3 行"和"4 ms"。这个样例太小,单次显示的耗时说明不了大表性能。从启动软件到首次看到数据花了多久,也没有计时,因此这里没有速度排名。
配好模型后,让它生成同一个查询
第一天查看 AI 设置时,模型还没配好。第二天配置完成后,从顶部机器人图标打开对话栏,已经能选到 MiniMax-M3。新建对话、选中样例连接和 main 库后,用 Ask · 通用问答提交下面这段需求。
请针对当前 SQLite 样例库生成一条只读 SELECT 查询,不要执行或修改数据。表结构是 customers(id, name) 和 orders(id, customer_id, amount_cents, status),orders.customer_id 关联 customers.id。请按客户汇总 status 为 completed 的订单金额,只返回客户名称 name 和合计 total_cents,金额保持整数分,按合计降序、客户名称升序排列;pending 和 cancelled 订单不要计入。请给出可执行 SQL,并简短解释过滤、关联和金额单位。
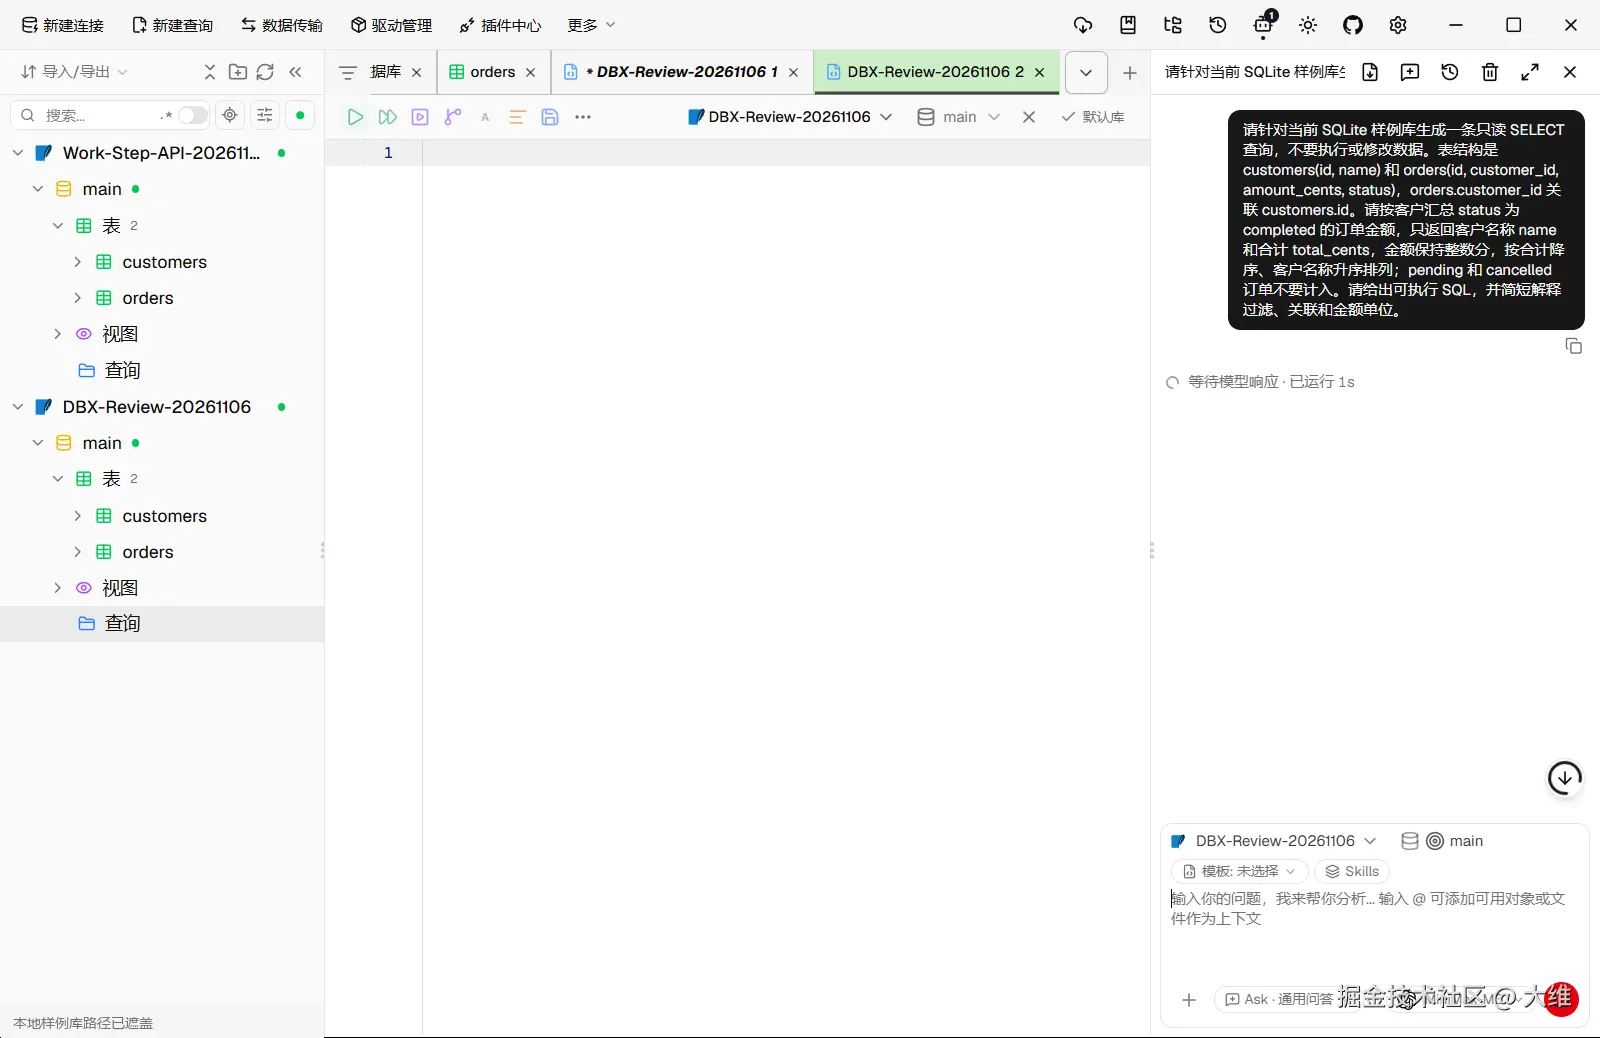
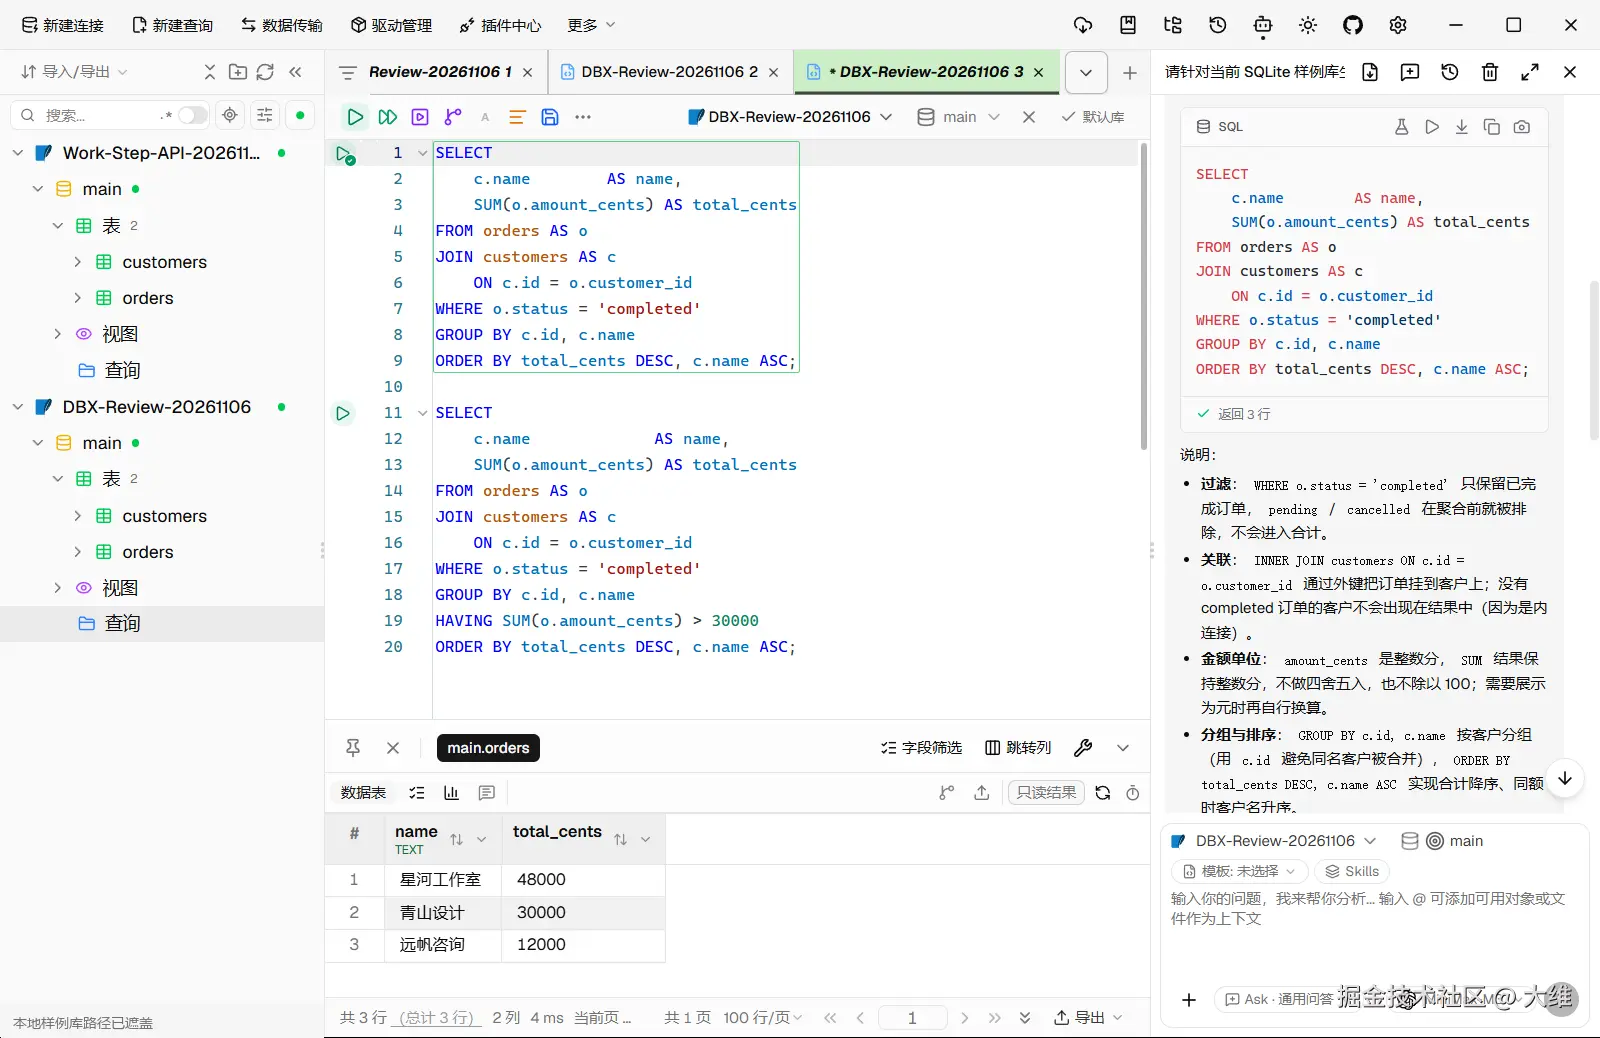
这段提示词给了表结构和统计口径,没有给预期的三行答案。首轮回复中的主查询如下:
sql
SELECT
    c.name AS name,
    SUM(o.amount_cents) AS total_cents
FROM orders AS o
JOIN customers AS c
    ON c.id = o.customer_id
WHERE o.status = 'completed'
GROUP BY c.id, c.name
ORDER BY total_cents DESC, c.name ASC;
写法和前面手写的 SQL 略有不同,关联、状态过滤、整数分单位和排序都一致。回复也解释了为什么要在聚合前排除 pending/cancelled,以及按客户 ID 分组可以避免合并同名客户。
确认语句是只读 SELECT 后,点击代码卡上的"立即执行",DBX 提示"返回 3 行"。切到对应查询页核对,仍然是星河工作室 48000、青山设计 30000、远帆咨询 12000 分。这条 SQL 没有手动修改,也没有让模型重新生成。
继续追问:严格大于 30000 分
接着沿用这轮对话,不再重复表结构,只加一个条件:
沿用刚才只统计 completed 订单的口径,只保留合计 total_cents 严格大于 30000 分的客户,仍返回 name、total_cents,排序保持不变。只生成只读 SQL,不执行,不修改数据;简短说明应该在聚合前还是聚合后筛选。
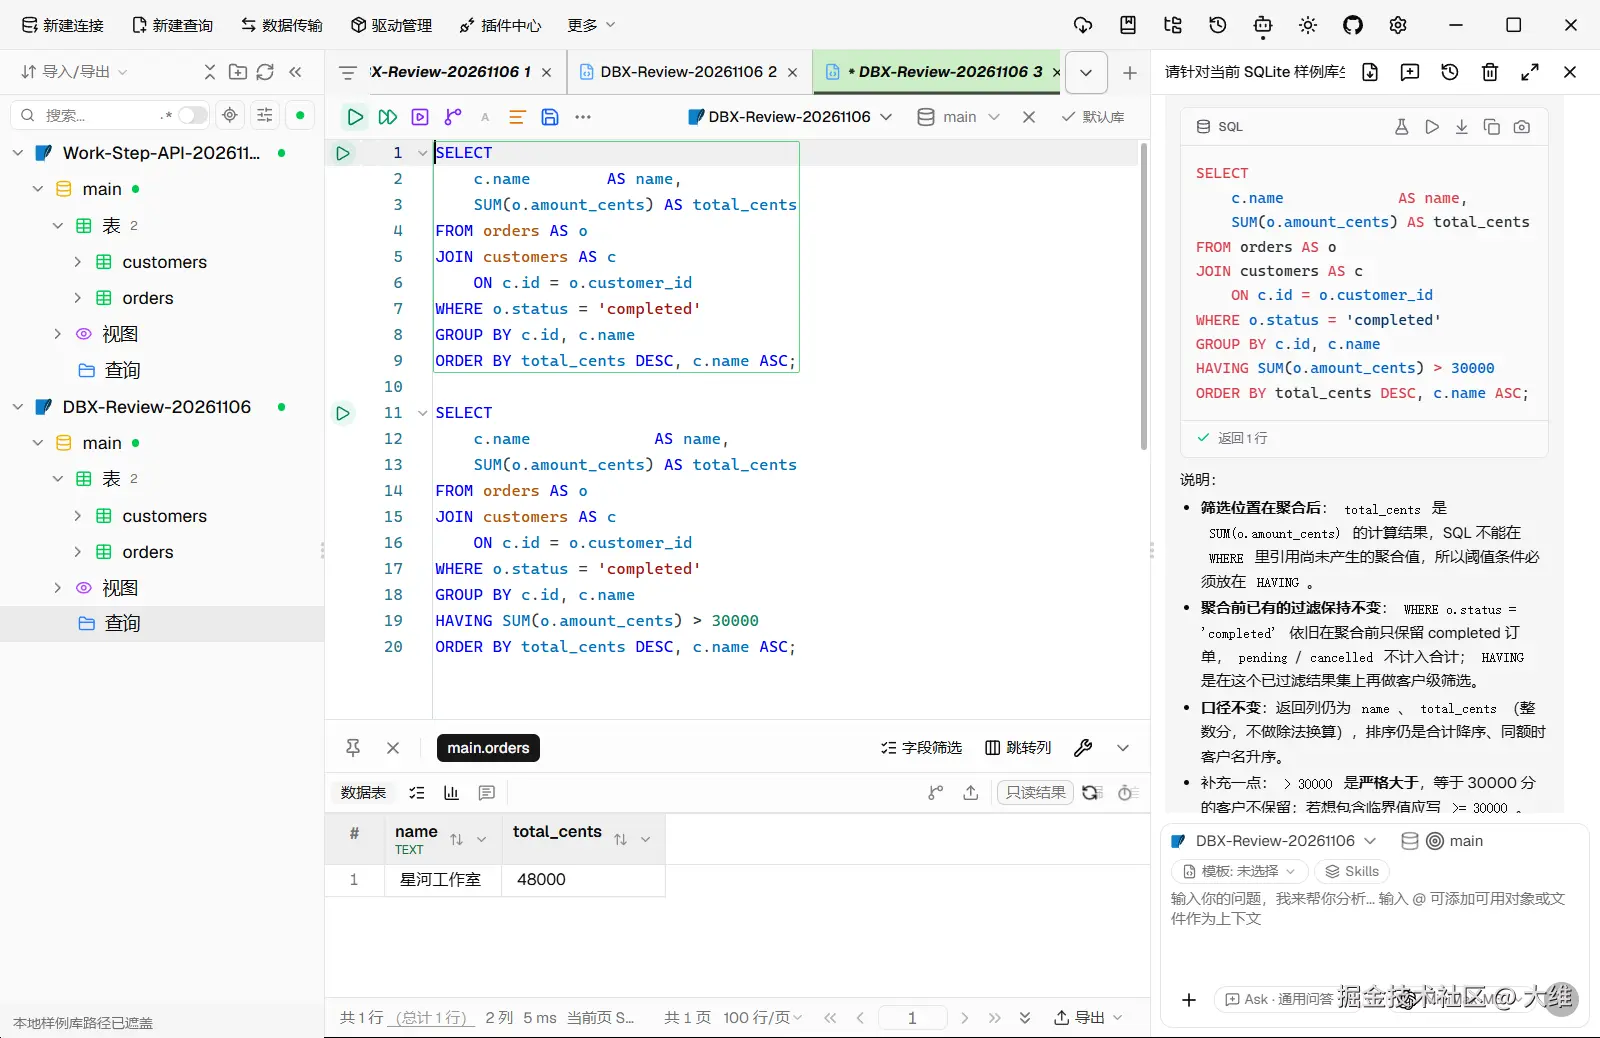
回复保留了原来的 WHERE 条件,在 GROUP BY 后加上:
sql
HAVING SUM(o.amount_cents) > 30000"合计金额"要在聚合后筛选,所以这里用了 HAVING。回复也明确说明,等于 30000 分的客户不会保留。检查语句并执行后,结果只剩星河工作室,48000 分。青山设计正好是 30000 分,被排除在外,边界条件也处理对了。
这次 AI 体验的收益与限制
用下来省事的地方,是提需求、看解释、检查 SQL 和执行都能在 DBX 里完成,少了在聊天工具和数据库客户端之间复制语句的步骤。追问时只补充条件,原来的统计口径也保留了下来。两轮各生成一次,手动修改 SQL 都是 0 次。当然,这只说明这两个小任务完成得怎样,算不上通用准确率。
这两轮也遇到几处需要留意的细节:
- 首轮除了主查询,还给了"保留所有客户、无已完成订单时合计为 0"的另一种写法。这次只执行了主查询,扩展版本没有验证。点代码卡之前,要先看清它采用的统计口径。
- 这次使用"应用到编辑器"和"立即执行"时,产生了另一个查询标签页,原先可见的结果还是旧的。从"已打开的标签页"里找到对应页面后,才核对了新结果。看执行结果时得先确认当前是哪一个标签页。
- 回复夹带了一些英文标记文本,SQL 和后面的解释仍然可用,但读起来有些干扰。目前还没查明是模型输出格式的问题,还是客户端的兼容渲染问题。
- 这次测试前已经配好了模型,下载软件后仍需要完成配置才能问数。测试没有查看或更改密钥,也没核实服务账单、实际费用和生成耗时;模型名称按 DBX 选择器的显示记录。
整个过程是"自然语言生成只读 SQL → 检查语句 → 点击执行 → 核对结果",由当前对话通过 UFO 一步步操作,并非交给 DBX 的 Agent 模式自动完成。写入操作、复杂业务库、模型自动发现未知表结构,以及不同模型之间的效果差异,都还没测。
哪些地方顺手,哪些地方需要留意
回到最开始的 SQLite 查数任务,左侧看库表、中间写 SQL、下方核对结果,这个布局用起来顺手。几个步骤可以在一个界面接着做,不必来回打开多个工具;格式化后的查询和结果放在同一张截图里,也容易说明问题。
顶部的几个操作只有图标,第一次找格式化按钮时花了些工夫,没有文字按钮直观。AI 对话框虽然在界面上,模型还得另外配置才能使用。记录版本时,也要一起看发布标签和 EXE 文件版本。
还要交代一下操作方式:这次通过 UFO 单步接口控制 Windows,每一步都先看截图,再决定下一步。快速输入多行 SQL 时,曾出现换行丢失;改成单行输入,再用 DBX 格式化,就能执行了。这是自动化输入过程中出现的问题,具体原因还没定位,不能据此判断日常手动输入也会丢换行。文中的查询结果,都是调整输入方式后在 DBX 界面执行、核对得到的。
如果你平时也要打开本地 SQLite 文件、写汇总 SQL、核对结果,可以试试这套流程。模型配好、表结构给清楚后,这两个小任务里生成的 SQL 都能直接运行。至于开箱配置要花多少工夫,其他数据库兼容得怎样,大数据量和复杂业务下表现如何,还得继续测。
附:可复现的虚构样例
想自己跑一遍,可以建一个全新的空 SQLite 测试库,执行下面的初始化 SQL,再运行前面的汇总查询。名称和订单都是虚构的。
sql
BEGIN;
CREATE TABLE customers (id INTEGER PRIMARY KEY, name TEXT NOT NULL);
CREATE TABLE orders (
  id INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL REFERENCES customers(id),
  amount_cents INTEGER NOT NULL,
  status TEXT NOT NULL CHECK (status IN ('completed', 'pending', 'cancelled'))
);
INSERT INTO customers VALUES
  (1, '星河工作室'), (2, '青山设计'), (3, '远帆咨询');
INSERT INTO orders VALUES
  (1, 1, 30000, 'completed'),
  (2, 1, 18000, 'completed'),
  (3, 1, 99000, 'cancelled'),
  (4, 2, 30000, 'completed'),
  (5, 2, 60000, 'pending'),
  (6, 3, 12000, 'completed');
COMMIT;
你用数据库工具时,最常卡在连接、写 SQL,还是核对结果?欢迎在评论里说个具体例子。如果用过 DBX 的 AI 功能,也可以聊聊选了什么模型、遇到过什么问题。
我整理的办公与开源工具目录里还有 DBX、ArtCraft、DSH-Go 等产品入口,资料介绍和实际测试分开标明。有使用场景或遇到的问题,可以提交工具反馈。Issue 需要登录 GitHub,不方便的话,在文章评论区交流也可以。
截图均来自本轮 DBX 窗口实测,只裁去窗口外黑边并遮盖本机文件路径,未改动查询语句、数据或执行结果。