GEO 不是新数据类型。TYPE 返回 zset,ZSCORE 拿到一个 52 位整数,坐标被编码进 ZSet 的 score 里------记住这一句,后面所有坑都有解释。
本篇只回答三件事:坐标怎么变成 52 位、这个精度到底是多少;GEOSEARCH 的 COUNT、ANY、分页有哪些真实边界;生产上 member 怎么设计、过期怎么做、什么时候该换 ES。
1. 编码:52 位整数与三个叫 geohash 的东西
三个同名不同义的东西,先分清楚,后面的精度讨论才有意义。
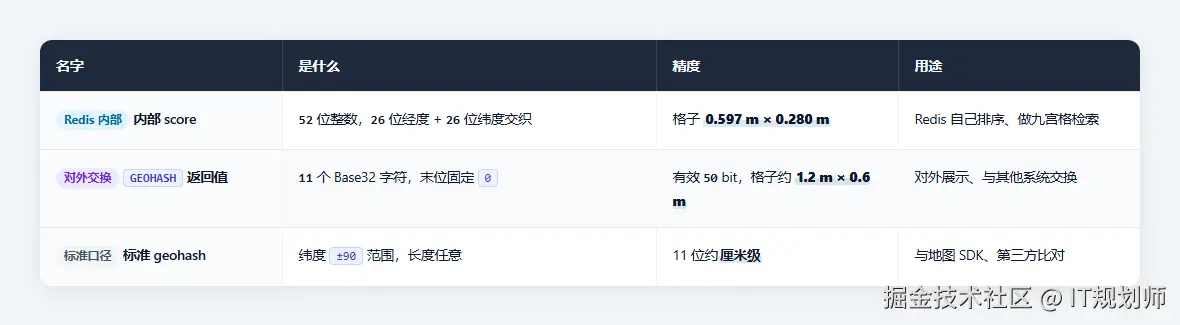
三者之间只有一条转换通道:GEOPOS。字符串不能反推 score,score 也不能当字符串用。
1.1 三步编码,和它决定的格子尺寸
写入那一刻做三件事:
- 归一化。经度按 -180, 180 映射到 26 位整数,纬度按 -85.05112878, 85.05112878 映射到 26 位整数。纬度上限不是 ±90,是 Web Mercator(EPSG:900913)的数学边界------按 ±90 编码会让极区在地图投影上被拉到无法使用,官方文档的说法是「极区附近不可索引」。
- 交织。纬度从最低位开始放偶数位,经度放奇数位,得到 52 位整数,源码里是
interleave64。顺序别记反:低位是纬度,不是经度。 - 把这个整数写进 ZSet 的 score。
格子尺寸由位数直接决定:经度 360° / 2^26 约 5.36e-6°,赤道处 0.597 m;纬度 170.102° / 2^26 约 2.53e-6°,0.280 m。所以一个 52 位格子的实际尺寸是 0.597 m × 0.280 m------官方口径里的「0.6 米」指经度方向这个数,两个方向的格子不是正方形。
纬度越高,经度方向的格子实际越窄:赤道 0.597 m,北纬 31 度(上海)约 0.51 m,北纬 60 度约 0.30 m。
GEOPOS 返回的是格子中心,不是原始坐标。这是量化不是误差,而且不可逆。
1.2 交织带来的副作用:Z 阶曲线不连续
第 2 步的交织不是随便填位,它把二维平面压成一维时留下了结构性缺陷:相邻的两个格子在一维 score 上未必相邻。
原因在位的层级。同一层级的四个格子(左、右、左下、右下)按 Z 字形排,横向相邻的两个格子在 score 上差 1;但跨到下一层,同一父格子里左下与右上这两个对角格子,score 可能差出几千。表现出来就是:两个点实际相距几十米,score 隔着很远。
这就是「自己截 geohash 前缀做范围过滤」必然漏点的原因------前缀相同确实相近,但前缀不同的也可能是紧挨着的邻居。Redis 的解法是九宫格补偿:查到中心格后,把周围 8 个格子的区间一起扫,再按实际距离过滤。这也是 GEOSEARCH 比单格 ZRANGEBYSCORE 慢、且开销随纬度变化的原因。
1.3 GEOHASH 为什么是 1.2 米,不是 0.6 米
这一段有两个流传很广的误解:标准 geohash 11 位约等于厘米级,于是有人以为 Redis 也是厘米;另一种是「11 位只是把 52 bit 无损地表达出来」。两个都不对。
源码 geohashCommand 做三步:用内部范围把 score 解码回经纬度 → 用标准 geohash 的范围(纬度 ±90)重新编码成 26 位 → 输出 11 个 Base32 字符,第 11 个无条件写 '0'。源码注释原话:We have just 52 bits, but the API used to output an 11 bytes geohash. For compatibility we assume zero.
11 个 Base32 字符理论上是 55 位,末位强 0 之后有效信息只剩 50 位,每轴各 25 位,格子线性放大一倍:内部范围下 1.194 m × 0.561 m,标准范围下 1.19 m × 0.59 m。对外说 1.2 m × 0.6 m 就够了。
三条结论:
- 它不是把 52 位搬出来,而是解码后重编码,用的是另一套纬度范围,位与位不对应。
- 它和 score 不能互推。要坐标用
GEOPOS,要字符串用GEOHASH,两条路不交叉。 - 官方那句「no precision is lost compared to the internal 52-bit representation」只在「城市级检索够用」这个量级上成立,不能读成逐位无损。
一个可核对例子:Palermo 的 WITHHASH 是 3479099956230698,标准 geohash 是 sqc8b49rnyt,GEOHASH 返回 sqc8b49rny0------前 10 位相同,末位被强成 0。
GEOHASH 的两个性质官方也写明:从右边截短仍指向同一片区域,只是精度下降;前缀相近说明位置相近,反之不成立。
1.4 精度账:真正该担心的是坐标系
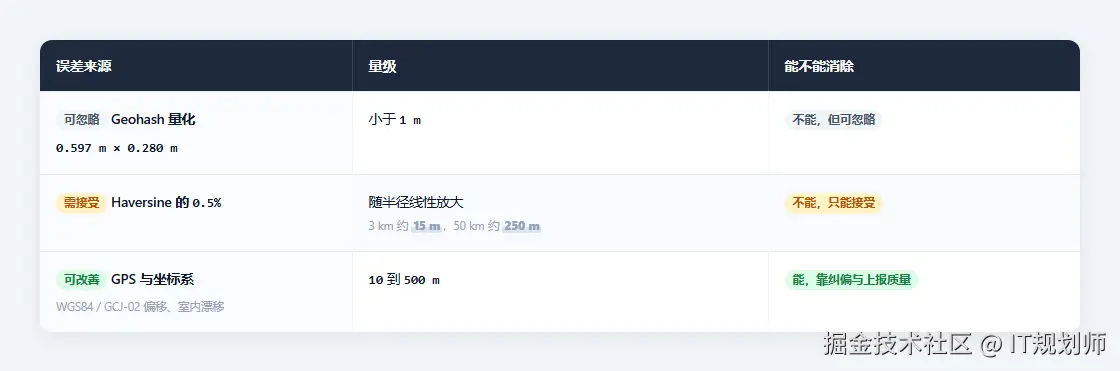
0.5% 这个数字来自球面近似:GEODIST 与 GEOSEARCH 的距离都走 Haversine,半径取平均地球半径 6372797.560856 m,而不是 WGS84 椭球。球面与椭球的大圆距离本身就有偏差,所以这个误差是半径的比例而不是固定值------半径越大绝对误差越大,相对误差不变。
3 km 半径下 0.5% 是 15 m,比 0.6 m 的量化误差大 25 倍。与其优化编码精度,不如先把坐标系对齐:同一份坐标,WGS84 与 GCJ-02 之间的偏移就是几十到几百米,比编码精度大三个数量级。
1.5 亲手验证
redis
# 两个相距约 14.6 m 的点,用来验证一个格子能装下几个点
DEL geo:verify
GEOADD geo:verify 121.4737 31.2304 p1
GEOADD geo:verify 121.4738 31.2305 p2

# 类型永远是 zset,不是 geo
TYPE geo:verify
# score 是 52 位整数,与官方示例逐位一致
ZSCORE geo:verify p1
# 两个点共同前缀 7 位,末位都被强成 '0'
GEOHASH geo:verify p1 p2
# 反查坐标:给的是格子中心,不是原值
GEOPOS geo:verify p1
# 两点实距约 14.63 m;单位可换 km / ft / mi,缺省是 m
GEODIST geo:verify p1 p2 m
# 只有 2 个成员时仍是 listpack
OBJECT ENCODING geo:verify预期:zset / 4054803464923741 / wtw3sjq6q20 与 wtw3sjqdbe0 / 与写入值只差小数点后五六位 / 14.6345 附近 / listpack。
要在应用层自己算 score(批量导入时预估排序),必须按内部范围实现 interleave64,不能用任何标准 geohash 库:
python
# 内部范围:纬度上限是 Web Mercator 边界,不是 +/-90,用错就与 Redis 对不上
LON_MIN, LON_MAX = -180.0, 180.0
LAT_MIN, LAT_MAX = -85.05112878, 85.05112878
# 每轴 26 位,两个 26 位交织成 52 位
STEP = 26

# 位交织:把有效位「摊开」,位与位之间留一个空位给另一轴
def spread(v):
    v &= 0xFFFFFFFF
    v = (v | (v << 16)) & 0x0000FFFF0000FFFF
    v = (v | (v << 8)) & 0x00FF00FF00FF00FF
    v = (v | (v << 4)) & 0x0F0F0F0F0F0F0F0F
    v = (v | (v << 2)) & 0x3333333333333333
    v = (v | (v << 1)) & 0x5555555555555555
    return v

def geo_score(lon, lat):
    lo = int((lon - LON_MIN) / (LON_MAX - LON_MIN) * (1 << STEP))
    la = int((lat - LAT_MIN) / (LAT_MAX - LAT_MIN) * (1 << STEP))
    # 纬度占低位起的偶数位,经度占奇数位
    return spread(la) | (spread(lo) << 1)

# 期望输出:4054803464923741
print(geo_score(121.4737, 31.2304))
2. 命令:边界比用法重要
text
# 语法骨架:[] 可选,<> 必选,| 二选一
# 中心点:FROMMEMBER 用集合内已有成员,FROMLONLAT 直接给经纬度
# 范围:BYRADIUS 圆 / BYBOX 矩形,单位必须写(m|km|ft|mi)
# 排序:不写 ASC/DESC 时顺序不保证;ANY 会牺牲顺序换速度
GEOSEARCH key
  <FROMMEMBER member | FROMLONLAT longitude latitude>
  <BYRADIUS radius m|km|ft|mi | BYBOX width height m|km|ft|mi>
  [ASC | DESC] [COUNT count [ANY]]
  [WITHCOORD] [WITHDIST] [WITHHASH]
2.1 GEOADD:参数顺序与返回值三口径
参数顺序是 经度 纬度 member,跟中文口语「北纬 39、东经 116」正好相反。写反的后果不是报错------两个值都还在合法范围内就照样成功,点位落到地球另一边。纬度范围是 -85.05112878 到 85.05112878,超出报 ERR invalid longitude,latitude pair;经度同理。
返回值有三种口径,混用会让监控指标全错:
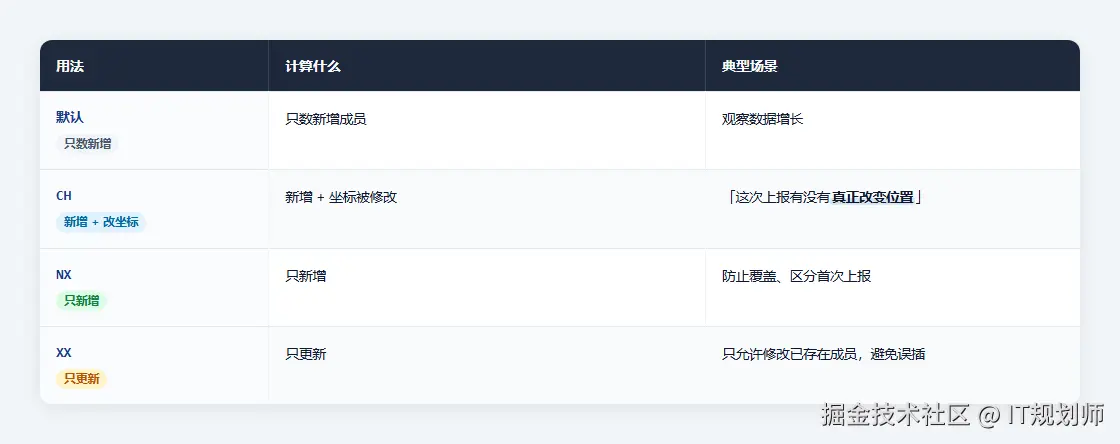
一个实际影响:司机每 3 到 5 秒上报一次,默认返回值几乎永远是 0,因为成员没新增。拿默认返回值当「上报成功数」做监控,这个指标恒为零,出故障时看起来像上报全丢了。加 CH 才有意义------但它也只能告诉你位置变了,不能告诉你上报被拒。
2.2 COUNT 与 ANY:最容易被「优化」掉的一处
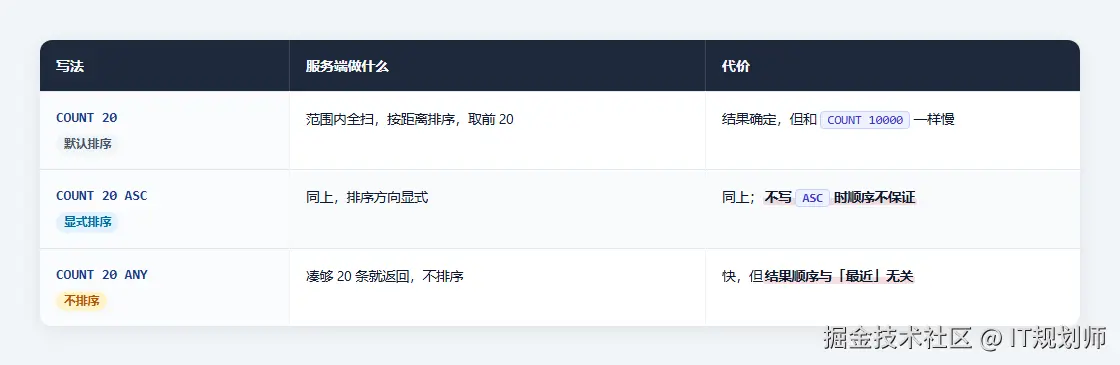
关键在「COUNT 限制的是返回数量,不是扫描量」。带 COUNT 不带 ANY 时,服务端先把范围内所有命中收集起来、排序、再截断,还可能为此额外申请内存。所以「大范围 + 小 COUNT」是伪优化:半径从 3 km 扩到 10 km,COUNT 5 的开销涨十几倍,拿到的还是 5 条。
想快只能加 ANY,代价是放弃「最近的 N 个」。ANY 只适合两类场景:布尔判断(有没有人、有没有商家),以及后续还要按别的字段精排的粗筛。
FROMMEMBER 的成员不存在时直接报错 could not decode requested zset member,不是返回空数组。这个区别要写进客户端错误处理:抛异常说明中心点丢了(查上报链路),返回空说明整个 key 没了或范围内真没人(查分片与过期)。
2.3 分页:没有 OFFSET
GEOSEARCH 没有 OFFSET 参数,这是设计取舍不是缺陷------加 offset 就要在服务端跳过前 N 个,而排序成本已经按全量算了。三种做法:
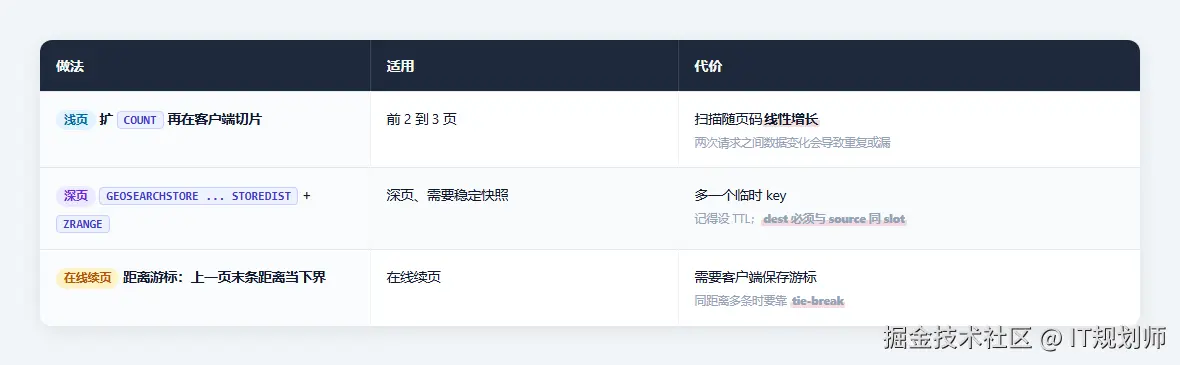
STOREDIST 的两种后果必须分清:不加,目标 key 的 score 仍是 geohash 整数,ZRANGE 排的是 Z 阶序,最近的商家可能出现在第二页;加了,score 变成距离,ZRANGE 才是按距离翻页,但这个 key 不再是空间索引,不能再 GEOSEARCH。
redis
# 第 1 步:3 km 内前 200 个商家落到临时 key,STOREDIST 让 score 变成距离(km)
GEOSEARCHSTORE geo:tmp:req8f3a1 geo:shop:food:shanghai FROMLONLAT 121.4737 31.2304 BYRADIUS 3 km ASC COUNT 200 STOREDIST
# 第 2 步:设 30 秒 TTL,客户端崩了也不留垃圾 key
EXPIRE geo:tmp:req8f3a1 30
# 第 3 步:翻第 2 页(第 20 到 39 名),按 score 升序就是按距离升序
ZRANGE geo:tmp:req8f3a1 20 39 WITHSCORES
不加 STOREDIST,第一步那条命令的结果就是「最近的商家排在第二页」------ZRANGE 按 geohash 大小排,而 geohash 大小和距离无关。这个反例在附录 A 有可判定的验证。
2.4 其余边界
GEODIST缺省单位是米,任一成员不存在返回 nil,不是 0。nil和「距离为 0」在客户端很容易混:同一坐标的两个点返回0.0000,成员不存在返回空。判断「这个人还在不在」不能看距离是不是 0。- 三个
WITH选项有成本。WITHDIST每个命中算一次 Haversine,WITHCOORD每个命中解码一次,WITHHASH最便宜(直接带出 score)。返回上百条时,只取真正要用的那个。 - 没有
GEODEL,删除用ZREM------因为它本来就是 ZSet。 GEORADIUS家族自 6.2 起标记废弃,且是@write命令:主从切换、只读副本上都不能用。迁移到GEOSEARCH时注意单位大小写:6.x 的extractUnitOrReply用strcmp,只认小写;7.0 起换成strcasecmp,KM也认,报错文案也从「please use m, km, ft, mi」变成「please use M, KM, FT, MI」。- 版本升级不需要迁移数据,RDB/AOF 格式没变;反过来从 7.x 降到 6.x,代码里写大写的
KM会变成语法错误。
2.5 客户端(.NET)三个坑
csharp
// count 必须配 order:Ascending 才是「最近的 count 个」,只给 count 是「任意 count 个」
var nearest = await db.GeoSearchAsync(
    "geo:shop:food:shanghai", 121.4737, 31.2304,
    new GeoSearchCircle(3, GeoUnit.Kilometers),
    count: 20, demandClosest: true, order: Order.Ascending,
    options: GeoRadiusOptions.WithDistance);

// FROMMEMBER 版本:成员不存在会抛异常,客户端把它当空列表处理就会误判成「附近没人」
var around = await db.GeoSearchAsync(
    "geo:shop:food:shanghai", (RedisValue)"shop:101",
    new GeoSearchCircle(3, GeoUnit.Kilometers),
    count: 20, demandClosest: true, order: Order.Ascending);

// 布尔判断:demandClosest:false 才会拼上 ANY;此时 count 必须是正数,否则驱动直接抛 ArgumentException
var hit = await db.GeoSearchAsync(
    "geo:shop:area:101", 121.4737, 31.2304,
    new GeoSearchBox(4000, 3000, GeoUnit.Meters),
    count: 1, demandClosest: false);
StackExchange.Redis 的 GetGeoSearchMessage 里写得很直白:if (!demandClosest) { if (count < 0) throw new ArgumentException(...); ...Add(ANY); }。所以「不排序」和「必须给 count」是同一件事的两面,想省一个参数就会撞上异常。
三个参数的行为差异整理一下:demandClosest 默认 true,等价于服务端拼 ASC;order 为 null 时不拼排序,只有 count 生效,结果就是「任意 count 个」。所以「最近的 20 家」必须 demandClosest: true 加 order: Order.Ascending 同时给,只给一个都不够稳。
3. 建模:四条铁律
3.1 member 只放不可变标识
member 是 ZSet 的成员,改 member 等于换人:旧成员留在里面变成幽灵------地图上多出一个永远不移动、也不消失的点。所以昵称、头像、状态这些会变、又检索不上的字段,一律外置到 Hash 或 String。
text
# 位置索引:一个城市一个 key,member 只放不可变 ID
geo:user:online:{city}:{bucket}   ZSet,member = u:{id},score = Geohash
# 状态外置:会变的字段不进 member,多一次 GET 但省掉幽灵
user:profile:{id}                 Hash,nickname / avatar / last_active
代价是两次查询,但一次 MGET 就够,只多一次往返。相比「把昵称拼进 member」,省掉的不只是内存:member 改了要 ZREM 旧的再 GEOADD 新的,两次写之间有窗口期,那个窗口里同一个人会同时出现在两个位置。
member 的长度有第二重影响:每个点的 SDS 是 8 + 长度 向上取整,u:1001 约 16 B,而 user:1001:nickname:张三 能到 40 B 以上,一亿点就是 2 GB 的差价。中文 member 还有编码问题------不同客户端用 UTF-8 与 GBK 分别写入,看起来一样、字节不同,于是同一个人变成两个成员。
3.2 时效:TTL 幂等不等于成员过期
EXPIRE 作用在 key 上,不是成员。这件事决定了 GEO 的时效只有三条路:
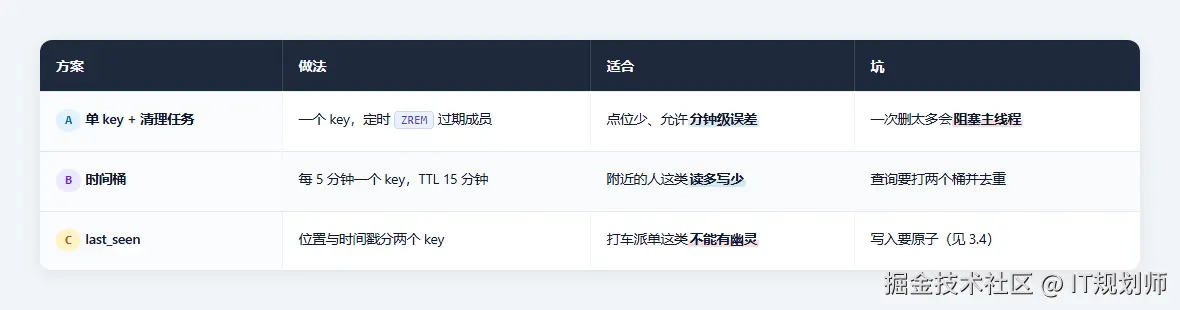
方案 B 有个容易写错的地方:每次上报都对「当前桶」EXPIRE 是安全的,因为桶名随分钟变,旧桶不再被续期,TTL 永远 15 分钟;而在方案 A 里对同一个 key 反复 EXPIRE,等于让 key 永不过期------EXPIRE 的语义是「重置」不是「累加」。
可见窗口要提前算清:查询打「当前桶 + 上一桶」,一个 20:15 上报的用户,在 20:20 和 20:25 的查询里都能被捞到,到 20:30 就消失。所以「在线」的定义其实是「最近 10 到 15 分钟上报过」,不是「现在还连着」。要更长窗口就多打一个桶,代价是每次多一次检索和一轮去重。
redis
# 写当前桶;桶名即分桶时刻,同一 5 分钟内的上报落进同一个 key
GEOADD geo:user:online:sh:202611081620 121.4737 31.2304 u:1001
# TTL 给 3 个桶的长度(5 x 3 = 15 分钟),旧桶自然过期,不需要定时任务
EXPIRE geo:user:online:sh:202611081620 900
两个桶之间的去重规则要写死:同一个人两桶都有位置时,取当前桶那条。不能「取距离更近的」------他在旧桶的位置完全可能更近,那样等于把过期坐标当成最新位置。
3.3 分片:按查询维度,不按 ID
GEOSEARCH 是单 key 命令,一个 GEO key 全落在一个 slot 上。「一个 key 装全国」的下场是单节点内存高、单线程查询慢、扩容搬一个大 key。分片是必须的,但维度必须跟查询维度一致:按城市分片,不要按用户 ID 哈希------后者查一次「附近的人」要打所有分片,合并排序的开销远超省下的内存。
需要多 key 的命令只有 GEOSEARCHSTORE,它要求 dest 与 source 同 slot。解法是给 dest 用与 source 相同的 hash tag:
redis
# source 与 dest 用同一个 hash tag,既保证同 slot,又不会把全国数据挤进一个 slot
GEOSEARCHSTORE geo:shop:tmp:{shanghai}:req8f3a1 geo:shop:food:{shanghai} FROMLONLAT 121.4737 31.2304 BYRADIUS 3 km ASC COUNT 200 STOREDIST
hash tag 的定义常被用反:只有第一个 {...} 里面 的内容参与 slot 计算,{} 空的不生效,一个 key 里有多个 {} 只认第一个。所以 geo:{sh}:food 与 geo:{sh}:tmp 同 slot,而 geo:sh:{food} 与前者不同 slot------花括号位置错一个字符,集群里就是两个 slot。
两个边界要提前想清楚:跨 180 度经线(斐济这类区域)的经度回绕会被拆成两个相距很远的区间,做法是按东西经两条 key 存、查两次合并;极区纬度超过 85.05 不可索引,66 到 85 度之间经线收敛,同一半径下候选集明显变大------真做极区业务,别用 GEO。
3.4 上报乱序:坐标是覆盖写
GEOADD 不比较时间,谁最后到谁生效。GPS 上报走 HTTP 或 MQ,网络抖动会让旧坐标后到,把新坐标覆盖掉。表现是地图上车辆回跳、派单距离算错、乘客看到的目的地距离突然变远。
解法是旁边存一份时间戳,写入前比较,用 Lua 把「比较 + 写入」做成原子操作:
lua
-- KEYS[1] = geo key, KEYS[2] = lastseen key(同 slot,用 hash tag 保证)
-- ARGV[1] = member, ARGV[2] = lon, ARGV[3] = lat, ARGV[4] = 上报时间戳(毫秒)
-- 返回:1 = 已写入,0 = 旧消息丢弃,-1 = 坐标非法
local lon = tonumber(ARGV[2])
local lat = tonumber(ARGV[3])
-- 范围校验必须在写之前:Redis 的 Lua 出错不回滚,先写后校验会留下脏数据
if lon == nil or lat == nil
   or lon < -180 or lon > 180
   or lat < -85.05112878 or lat > 85.05112878 then
  -- 坐标非法:一个字段都不写
  return -1
end
-- 取已存的时间戳,比新上报的新则丢弃(相等也丢,以先到为准)
local last = redis.call('ZSCORE', KEYS[2], ARGV[1])
if last and tonumber(last) >= tonumber(ARGV[4]) then
  -- 旧消息,丢弃
  return 0
end
-- 先写事实(坐标),再写元数据(时间戳):顺序反了,一次 GEOADD 失败就永久丢掉该用户后续上报
redis.call('GEOADD', KEYS[1], ARGV[2], ARGV[3], ARGV[1])
redis.call('ZADD', KEYS[2], ARGV[4], ARGV[1])
return 1
写入顺序是这个脚本唯一需要记的点。Redis 的 Lua 出错不回滚:如果反过来先写 lastseen,一旦 GEOADD 因坐标非法抛错,时间戳已经前进了,此后该用户所有合法上报都会被判成「旧消息」永久丢弃。把范围校验放在最前面,等于把这个风险提前掐死。
返回 0 的计数本身就是「客户端乱序率」的监控指标。客户端还可以再上一层:给每条上报带单调自增 seq,服务端按 seq 丢过期消息,比时间戳更稳------时间戳依赖客户端时钟,时钟回拨或时区配错会让整套判重失效,seq 只依赖客户端自己递增。
4. 三个场景
4.1 附近的人
需求:5 km 内最近 20 个在线用户,按距离升序,支持上滑加载,不显示自己。
redis
# 查当前桶 + 上一桶,两次检索用同一个 FROMLONLAT,距离可直接比较
GEOSEARCH geo:user:online:sh:202611081620 FROMLONLAT 121.4737 31.2304 BYRADIUS 5 km ASC COUNT 60 WITHDIST
# COUNT 取终值 3 倍:两桶各取 60,合并去重后仍够 20
GEOSEARCH geo:user:online:sh:202611081615 FROMLONLAT 121.4737 31.2304 BYRADIUS 5 km ASC COUNT 60 WITHDIST
COUNT 取 3 倍而不是 2 倍:两桶有重叠的人、有要排除的自己,20 条结果实际可能来自 30 到 40 个不同成员,2 倍在密集城区会不够。3 倍是经验值,代价是每桶多扫 40 条,5 km 半径下可以接受。
完整实现:
csharp
public sealed class NearbyService
{
    // 连接复用:同进程共用一个 ConnectionMultiplexer
    private readonly IDatabase _db;
    // 城市维度:写入与查询必须落在同一个城市的 key 上
    private readonly string _city;

    public NearbyService(IConnectionMultiplexer mux, string city)
    {
        _db = mux.GetDatabase();
        _city = city;
    }

    // 桶名对齐到 5 分钟的整数刻度,同一刻度内的上报落进同一个桶
    // 用 UTC 而不是本地时间:夏令时切换当天不会出现重复桶名或跳桶
    private static string BucketKey(string city, DateTime utc, int minutes = 5)
    {
        var t = new DateTime(utc.Year, utc.Month, utc.Day, utc.Hour,
                             utc.Minute / minutes * minutes, 0, DateTimeKind.Utc);
        return $"geo:user:online:{city}:{t:yyyyMMddHHmm}";
    }

    // 上报:只写当前桶。重复设 TTL 是幂等的------同一个桶的 TTL 永远是 15 分钟
    // (3 个桶的长度,见 3.2),旧桶不再被续期,所以不会无限延长
    public async Task ReportAsync(long userId, double lon, double lat)
    {
        var key = BucketKey(_city, DateTime.UtcNow);
        // Batch:GEOADD 与 EXPIRE 一次往返发出
        var batch = _db.CreateBatch();
        var add = batch.GeoAddAsync(key, lon, lat, $"u:{userId}");
        var exp = batch.KeyExpireAsync(key, TimeSpan.FromMinutes(15));
        batch.Execute();
        // 必须 await 结果,否则异常被吞
        await Task.WhenAll(add, exp);
    }

    // 查询:当前桶 + 上一桶,keys 顺序是「新 -> 旧」,合并时先到先得
    // afterKm 是续页游标(上一页最后一条的距离),首页传 null
    public async Task<List<NearbyUser>> NearbyAsync(long selfId, double lon, double lat,
                                                    double radiusKm = 5, int take = 20,
                                                    double? afterKm = null)
    {
        var now = DateTime.UtcNow;
        var keys = new[]
        {
            // [0] 当前桶
            BucketKey(_city, now),
            // [1] 上一桶
            BucketKey(_city, now.AddMinutes(-5))
        };
        var self = $"u:{selfId}";

        // 两桶并发查,仍是一个 Batch 一次往返
        // count 取 take * 3,为合并去重留出余量
        var batch = _db.CreateBatch();
        var tasks = keys.Select(k => batch.GeoSearchAsync(
            k, lon, lat, new GeoSearchCircle(radiusKm, GeoUnit.Kilometers),
            count: take * 3, demandClosest: true, order: Order.Ascending,
            options: GeoRadiusOptions.WithDistance)).ToArray();
        batch.Execute();
        var pages = await Task.WhenAll(tasks);

        // 当前桶优先:两桶都有位置时取当前桶那条,不能「取距离更近的」
        // ------旧桶的位置完全可能更近,那样会把过期坐标当成最新
        var merged = new Dictionary<string, double>();
        foreach (var page in pages)
        {
            foreach (var r in page)
            {
                var member = r.Member.ToString();
                // 不显示自己
                if (member == self) continue;
                // 续页游标:跳过上一页末条的距离,避免重复(见 2.3)
                if (afterKm.HasValue && (r.Distance ?? double.MaxValue) <= afterKm.Value) continue;
                // 当前桶已命中,旧桶同名记录直接丢
                if (merged.ContainsKey(member)) continue;
                merged[member] = r.Distance ?? double.MaxValue;
            }
        }

        // 合并后统一排序、截断,不能在各自 key 里先截断再合并
        return merged
            .OrderBy(kv => kv.Value)
            .Take(take)
            .Select(kv => new NearbyUser(kv.Key, kv.Value))
            .ToList();
    }
}

// 注意单位:GeoUnit.Kilometers 下 Distance 就是公里,字段名别写成 Meters
public record NearbyUser(string Member, double Kilometers);游标有个细节:<= 会把上一页最后一条自己删掉,所以下一页从第二条开始;同一距离有多个人时会一起被跳过,可能少返回几条。要避免就加二级键(距离相同时按 member 字典序),游标带成「距离 + member」两段。
4.2 外卖与打车:差别在时效和状态
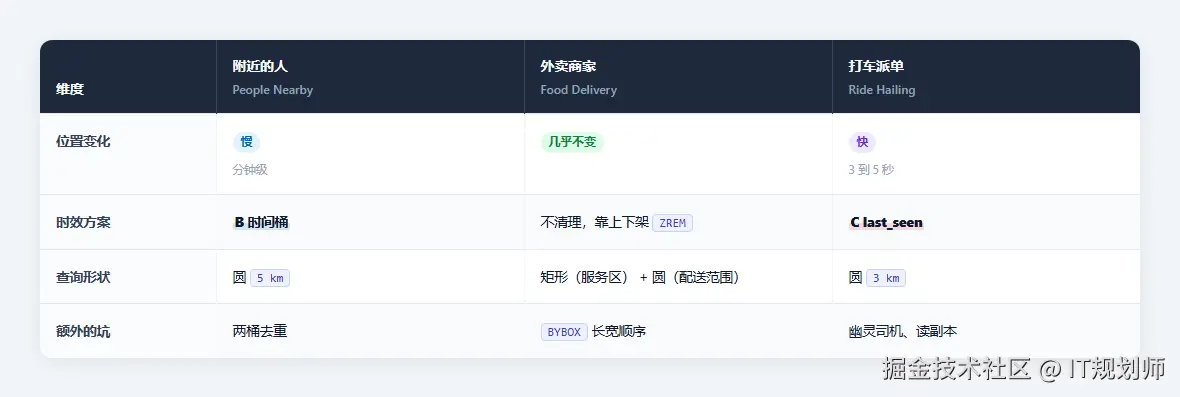
外卖的服务区判定用 BYBOX,参数顺序是 width height:width 沿经度方向、height 沿纬度方向。正方形服务区写反了看不出来,三公里长、一公里宽的那种就会判错------用户在服务区外 400 米却被判成覆盖。
打车派单还有一条铁律:读主库。副本延迟几秒,派给一个刚下线的司机就是一次掉单加一次客诉。判「司机还在线」不能只看 GEO 里有没有这个人,还要看 lastseen 是否在阈值内、status 是否 available,三样都过才派。
5. 容量:一个点多少钱
5.1 单点成本拆解
text
# 64 位系统、skiplist 编码下的粗估;member 越长 SDS 越大
单点字节 = 24 (dictEntry) + 8 (桶位) + (8 + member长度) (SDS,向上取整) + 64 (跳表节点)
# 乘数 1.2 到 1.5 是余量:dict 扩容 + 内存碎片
总内存 = 点位数 x 单点字节 x (1.2 到 1.5)四项的来源:dictEntry 24 B 是「key 指针 + value 指针 + next 指针」;桶位 8 B 是哈希表里的指针位;SDS 是 8 + 长度,短串的 sdshdr8 头只有 3 B,按 8 对齐后仍按 8 算;跳表节点 64 B 是 zskiplistNode 的平均成本------值指针、score、后退指针,加上平均 1.33 层的「前进指针 + 跨度」。
member 是 u:1001 这种短串,单点约 100 到 110 B。三个规模的量级(参考值,必须按自己的 member 长度和副本数实测替换):
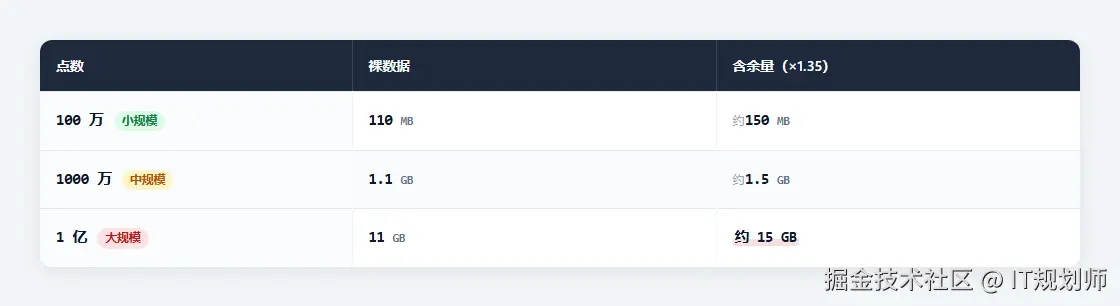
上面的数字不含副本。三个副本就是三份内存,MEMORY USAGE 量出来的是单实例单 key,别忘了乘。
5.2 从 listpack 到 skiplist:一次不可逆的升级
GEO key 就是 zset,编码规则也一样:成员数不超过 zset-max-listpack-entries(默认 128)、单个 value 不超过 zset-max-listpack-value(默认 64)时是 listpack,超了就转 skiplist。转换是单向的------删到 3 个成员也不会退回去。
这带来两件事。小集合比公式算的更省,3 个点的 demo 实例可能只占几百字节;一旦跨过阈值,每点立刻多出约 64 B 跳表节点,而这一步在业务低峰的压测里往往复现不出来。压测数据要按目标规模造,别拿 3 个点的结论推广到 300 万点。
5.3 大 key 的四重代价
单 key 超过 50 万点后:
- 单线程耗时 :
GEOSEARCH大范围扫描更明显,一个请求占住主线程,同实例所有命令排队。 - 迁移卡顿:集群搬迁按 key 搬,搬这个大 key 的时候整槽数据都在等。
- 内存碎片 :长期增删后碎片率上升,
MEMORY USAGE与实际 RSS 越差越多。 - 删除阻塞 :
DEL同步释放,几百万点的 key 会卡秒级;换UNLINK走后台线程。
50 万不是硬指标,判断标准是你的 P99 和运维动作能不能承受:GEOSEARCH 的 P99 已经在 10 ms 以上,分片就该往下切。
性能数字自己测:redis-benchmark 压 GEOSEARCH,看 INFO commandstats 里的 usec_per_call,再用 SLOWLOG GET 10 抓超阈值请求,LATENCY DOCTOR 看延迟尖峰的成因。只压一条命令、一个 key 得到的数字不能当集群容量用------真实的慢往往来自同实例上的其他命令。
6. 选型:什么时候该换
6.1 六维对比
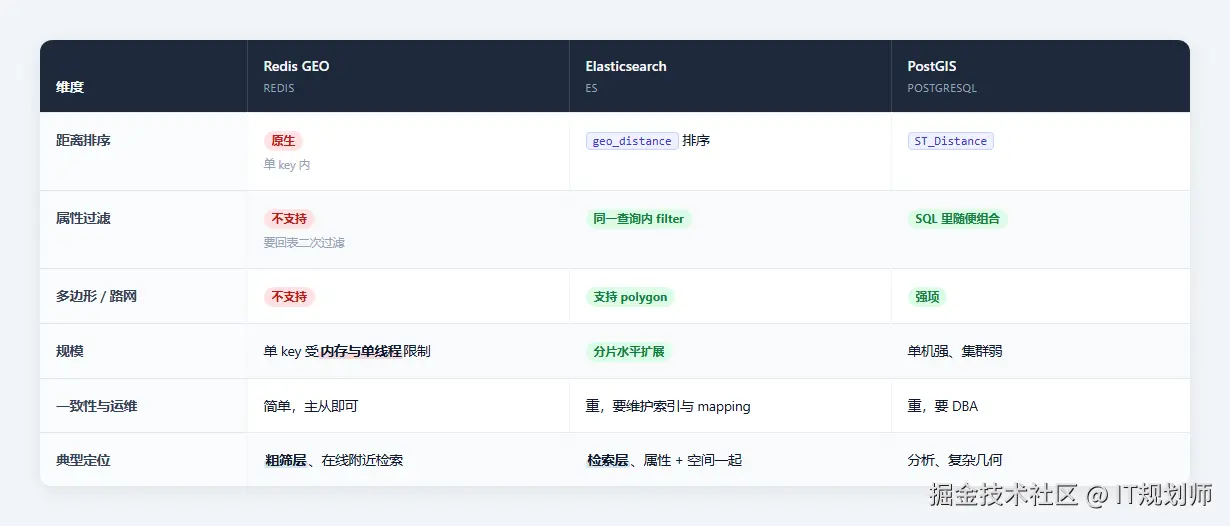
最容易被忽略的是「属性过滤」这一行。GEO 的返回只有 member 和可选的距离/坐标/hash,没有任何过滤能力。所以「3 km 内、评分 4.5 以上、现在营业」这种查询,GEO 只能先给 200 个候选,剩下的条件要靠应用层或 ES 补。
6.2 决策顺序
先问「除了距离还要不要过滤」。只要距离和排序,GEO 够用且最便宜:一次往返、无额外系统、延迟毫秒级。要评分、营业状态、配送费一起排,走两段式------GEO 取前 200 个 ID,ES 在这 200 个上加 filter 再精排,最后应用层混合排序。
两段式的代价要算清:多一次跨系统调用(通常 5 到 20 ms),多一层失败处理(ES 挂了是降级成纯 GEO 结果还是返回空)。GEO 放前面是因为它便宜,且天然做完「按距离截断」,把 200 个 ID 传给 ES 比让 ES 从全量里排省得多。
6.3 迁移信号
三个信号出现就该迁:查询里开始出现「按属性过滤后再排」的需求;单 key 逼近 50 万点且分片已切到城市以下;需要多边形围栏或路网距离。
迁移不是重写------先双写(GEO 与 ES 同时写,以 GEO 为准)、再灰度读(按流量比例切,对照两边结果差异)、最后切。GEO 保留为粗筛层是最省事的过渡形态,也是很多团队最终停下来的形态:ES 负责精排,GEO 在它前面挡掉 99% 的候选。
7. 坑点与清单
7.1 十二个坑
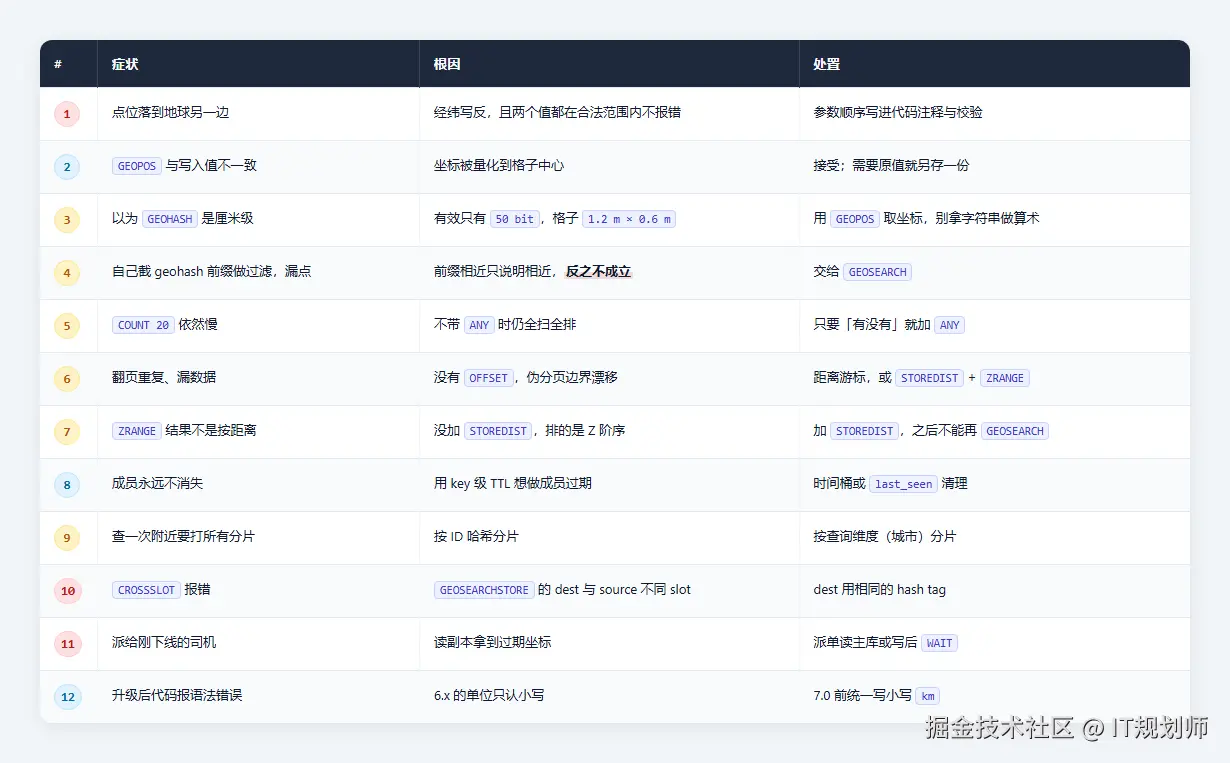
这十二条有个共性:全部来自同一个误判------把 GEO 当成一个空间数据库。它不是。它是一个带 52 位编码的 ZSet,只做「按范围找、按距离排」这一件事,其余全部要自己做。
7.2 复盘:翻页重复 60%
现象:附近的人上滑加载,第二页有 60% 的用户和第一页重复,客诉是「划到底全是重复的人」。
排查:日志里两次请求的 COUNT 分别是 20 和 40,服务端把 GEOSEARCH 当成了 offset 分页------每次扩大 COUNT 再在客户端切片。两次请求间隔 2 秒,期间有新上报、有新桶切换,集合变了,切片边界跟着漂移,第一页的尾部被第二页重新捞到。
两个根因叠在一起:一是没有 OFFSET 时用「扩 COUNT 切片」冒充分页,二是没有显式 ASC,返回顺序本身不保证------
修法:改成距离游标,上一页最后一条的距离作为下一页的下界,客户端过滤掉 <= 游标 的记录;同时显式 ASC。重复归零,代价是同距离多用户时要加 tie-break 字段。
事后补的监控:每次请求记 COUNT、START、返回条数,画「翻页请求的 COUNT 增长曲线」。
7.3 上生产清单
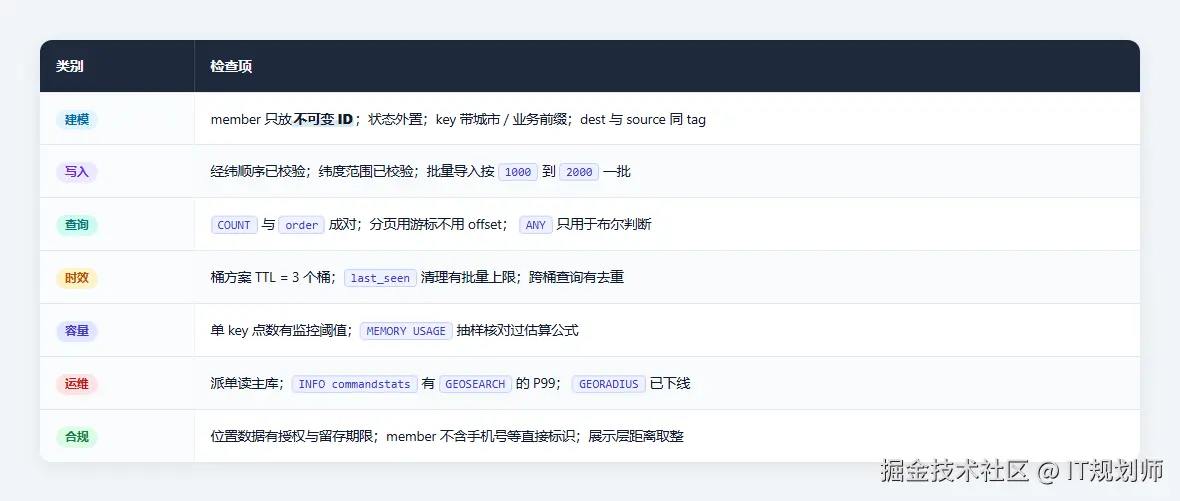
上线前至少做两次压测,两次造数规模不同。一次按目标规模(比如 300 万点)造满,量 GEOSEARCH 的 P99 和 MEMORY USAGE,验证公式与阈值;一次造「热区」------把 30% 的点塞进 1 km 见方,模拟商圈高峰。只做前者会在真实业务上翻车,因为 GEO 的耗时和范围内命中数正相关,不是和总点数。
7.4 如果只记五条
- GEO 是 ZSet,score 是 52 位整数,格子 0.597 m × 0.280 m。
GEOHASH的 11 位有效只有 50 bit,格子 1.2 m × 0.6 m,且不能反推 score。COUNT限制的是返回数量,不是扫描量;要「最近 N 个」必须显式ASC,只要「有没有」才用ANY。- 没有
OFFSET;深页用GEOSEARCHSTORE ... STOREDIST+ZRANGE,在线续页用距离游标。 - TTL 只管整个集合;成员级过期只能靠时间桶或 last_seen 清理。
范围之外的事------路网距离、多边形围栏、按属性过滤------不在 GEO 的能力边界内,换 ES 或 PostGIS,或把 GEO 降级成粗筛层。
附录 A:验证脚本
每段都能单独跑;块内
#开头是注释行,redis-cli不识别,按条执行时跳过。
redis
# 数据:官方示例两个点,外加同纬线上相隔 4.48 度的两个点(用来演示半径截断)
DEL geo:sicily
GEOADD geo:sicily 13.361389 38.115556 Palermo 15.087269 37.502669 Catania
GEOADD geo:sicily 12.758489 38.788135 edge1 17.241510 38.788135 edge2

# 不带 COUNT:返回全部命中并按距离升序;200 km 内只有 Palermo 和 Catania(edge 点在 279.7 km 外)
GEOSEARCH geo:sicily FROMLONLAT 15 37 BYRADIUS 200 km ASC
# 带 COUNT 不带 ANY:仍排序,取最近 1 个,必定是 Catania(56.4413 km)
GEOSEARCH geo:sicily FROMLONLAT 15 37 BYRADIUS 200 km ASC COUNT 1
# 带 COUNT ANY:凑够 1 个就返回,顺序不保证,可能是 Palermo
GEOSEARCH geo:sicily FROMLONLAT 15 37 BYRADIUS 200 km COUNT 1 ANY
redis
# 对照组:同一次检索,一条不加 STOREDIST,一条加
DEL geo:k1 geo:k2 geo:sicily
GEOADD geo:sicily 13.361389 38.115556 Palermo 15.087269 37.502669 Catania

# 不加 STOREDIST:score 仍是 Geohash 整数,ZRANGE 排的是 Z 阶序,最近的 Catania 在第二
GEOSEARCHSTORE geo:k1 geo:sicily FROMLONLAT 15 37 BYRADIUS 250 km ASC COUNT 2
ZRANGE geo:k1 0 -1 WITHSCORES

# 加 STOREDIST:score 变成距离,ZRANGE 才是按距离翻页
GEOSEARCHSTORE geo:k2 geo:sicily FROMLONLAT 15 37 BYRADIUS 250 km ASC COUNT 2 STOREDIST
ZRANGE geo:k2 0 -1 WITHSCORES预期:geo:k1 两个 score 是 3479099956230698 与 3479447370796909(最近的 Catania 在后);geo:k2 是 56.4413 与 190.4424,顺序反过来。顺手再验一次 GEOSEARCH geo:k2 FROMLONLAT 15 37 BYRADIUS 250 km ASC:加了 STOREDIST 之后这个 key 已不是空间索引,这条查询拿不到有意义的结果,正好印证 2.3 的说法。