💡 一句话总结:SwarmEvolve 让 450 个 AI agent 不写一个字、在潜空间(模型的向量思考空间)里推理并用 KV cache 直接「传念头」,把 LLM 进化式程序搜索的吞吐量拉高 5-13 倍------单卡一小时的效果,别人要六小时。做 agent 系统、进化搜索或者想低成本玩 AI 科学发现的人,这篇都值得读。
导语:跑过 AlphaEvolve 的都知道那种感觉
先问一个可能戳到你的问题:你有没有盯着终端,看着一个进化搜索框架一小时只吐出 80 多个候选程序,而你的 GPU 利用率倒是拉满了?
搞过 FunSearch、AlphaEvolve 或者 OpenEvolve 这类「LLM 进化搜索」(让大模型当变异和交叉算子,一代代改进程序)的人,应该都体会过这种煎熬:框架效果确实惊艳------能找到新数学构造、能优化矩阵乘法------但速度慢得让人心疼。为什么?因为每个 agent 每一步都要生成一大段文本思维链(Chain-of-Thought,让模型把推理过程逐字写出来),单个程序 20 到 35 秒就烧出去了,一小时的预算里根本跑不出多少代。
更糟的是,想让结果好就得加多样性,加多样性就得堆 agent,堆 agent 上下文就爆炸------解档案、评估反馈、agent 之间的聊天记录全要塞进提示词。这是个越努力越贵、越贵越跑不动的死循环。
Brown 大学 Jiang 和 Karniadakis 的这篇 SwarmEvolve(arXiv:2611.08483,2026 年 11 月)给了一个相当「狠」的答案:干脆别让 agent 说话。450 个 agent 一批全部在向量空间里静默思考,互相之间直接传 KV cache(模型推理时缓存的键值中间结果),summarizer 汇总时才落成文字。结果:吞吐量提升 5-13 倍,中位 3-8 分钟达到基线跑满 60 分钟的分数,一个 8B 的开源小模型还改写了 AlphaEvolve 用前沿大模型找到的 3 个数学构造。
想自己动手试?
- 📄 论文:arXiv 2611.08483
- 💻 代码:GitHub · Qile-J/SwarmEvolve
- 🧩 AlphaEvolve 公开结果:GitHub · google-deepmind/alphaevolve_results
🤔 这篇论文到底想解决什么问题?
把话说明白一点:LLM 进化搜索是个好东西,但它的经济学不成立。
这类框架的基本玩法是:给一个大模型一个数学或工程问题,让它写程序解,算分,好的留下当「父本」,再让模型变异、杂交出下一代。FunSearch 用这套流程找到了新 cap set 构造,AlphaEvolve 甚至改进了 4×4 复矩阵乘法------都是真结果,不是吹的。
但你要是真跑过就知道账有多难看。文字思维链是逐字生成的自回归过程,一个像样的推理 20-35 秒;你要跑出多样性,一轮得生成几十上百个候选;候选之间还要互相看、互相评,上下文越滚越长。最后就是你花一小时 GPU 时间,换来不到 200 个候选程序------而开放数学问题需要的搜索规模,比这大得多。
那怎么办?论文作者的思路非常直接:问题出在「文字」上,那就把文字拿掉。近年有一条潜空间推理(latent reasoning)的研究线:让模型把上一层的隐藏态(hidden state,模型内部的向量表示)直接回灌成下一步输入,在连续向量空间里「思考」,全程不解码成文字。另一条是多 agent 通信线:LatentMAS 已经证明多个 agent 可以互传 KV cache 而不是文本消息。SwarmEvolve 把这两样东西接进了进化搜索,然后问了一个很野心的问题:一群不说话的低成本 agent,能不能让搜索又快又好?
🛠️ 它的思路是什么?
整体流程一句话:维护一个程序档案,每轮放出 10 群、每群 45 个潜空间 agent 去研究父程序,过滤掉想法雷同的,让每个群的「总结者」读完队友的 KV cache 写出一个新程序,打分入档,循环往复。
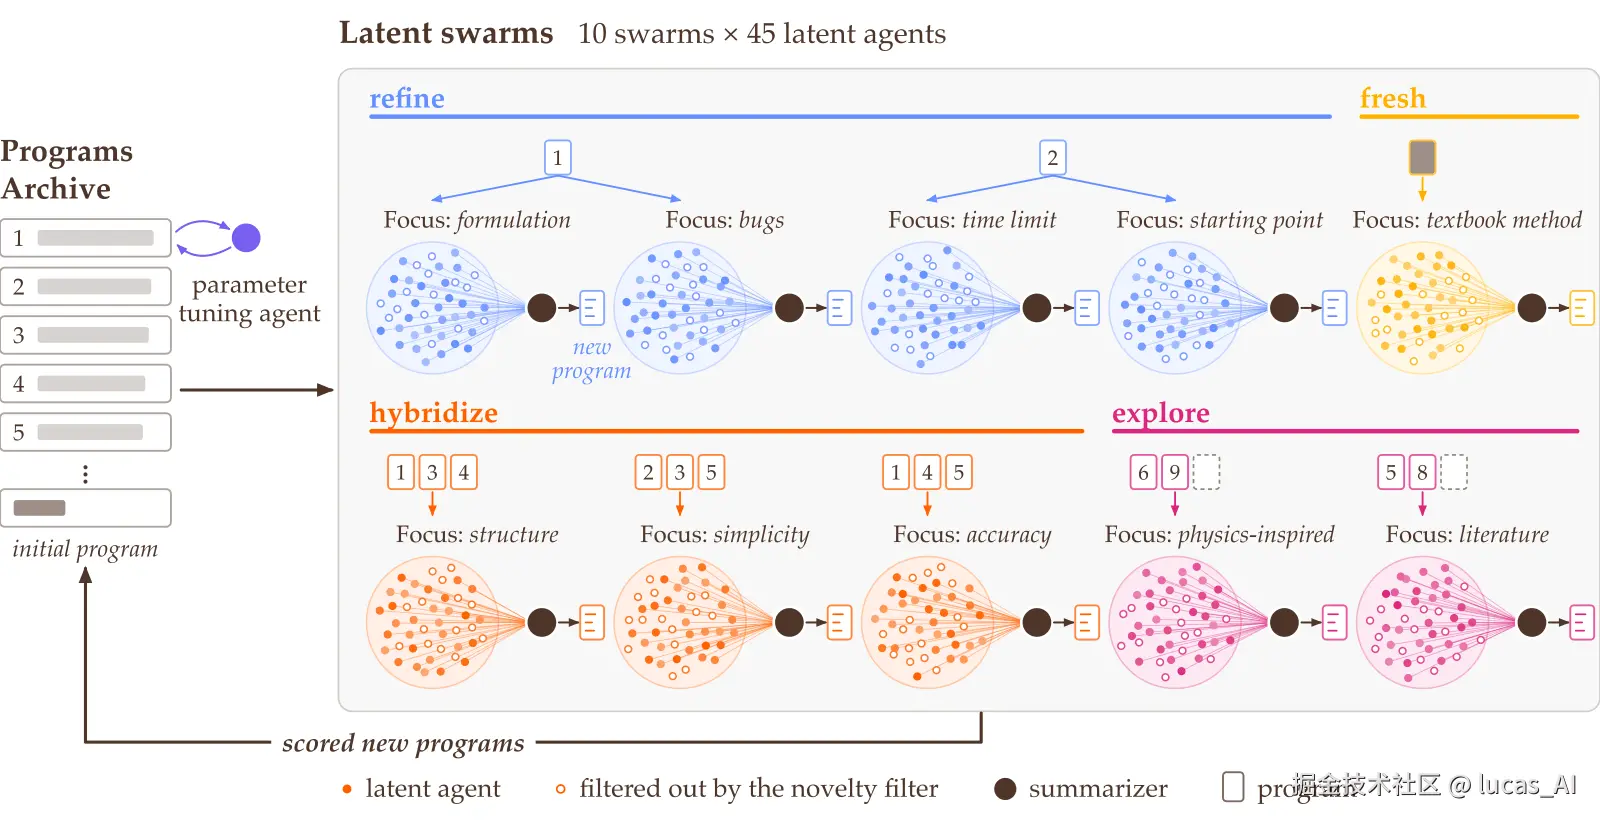 图说:每轮 10 个 swarm 各领一个侧重方向(精炼/杂交/探索/重启),群内 45 个 agent 静默思考,空心圆是被新颖性过滤淘汰的 15 个,summarizer 读完剩余 30 个的 KV cache 写出新程序。
拆开看几个关键机制,每个都挺巧。
第一,静默思考。 每个潜空间 agent 读完问题陈述、自己的 focus 提示(比如「从第一性原理推理」「质疑程序的一个假设」)和分到的父程序后,走 40 个潜步:把最后隐藏态乘一个对齐矩阵 Wa 映回输入嵌入空间,再喂回模型。这个矩阵不用训练------它就是个岭回归闭式解,让每个词元的输出嵌入尽量映回自己的输入嵌入。效果是模型在向量空间里「打腹稿」,一个潜步只是一次单位置前向传播,450 个 agent 一批并行,总共几秒钟。
第二,KV cache 当传声筒。 这是全文最漂亮的工程决策。群内 30 个被保留 agent 的 KV cache 直接拼接成 summarizer 的上下文------注意,是「直接读」,不需要先把思考翻译成文字。谁都在同一模型上跑,KV cache 天然同构;并行推理时大家位置都从 0 开始,就用 RoPE(旋转位置编码)的旋转矩阵把各自的 key 平移到拼接后的正确位置。summarizer 一次性看到 30 份完整思考轨迹,等于做了一次 30 路想法的杂交------这就是进化算法里的 crossover,只不过发生在向量空间里。
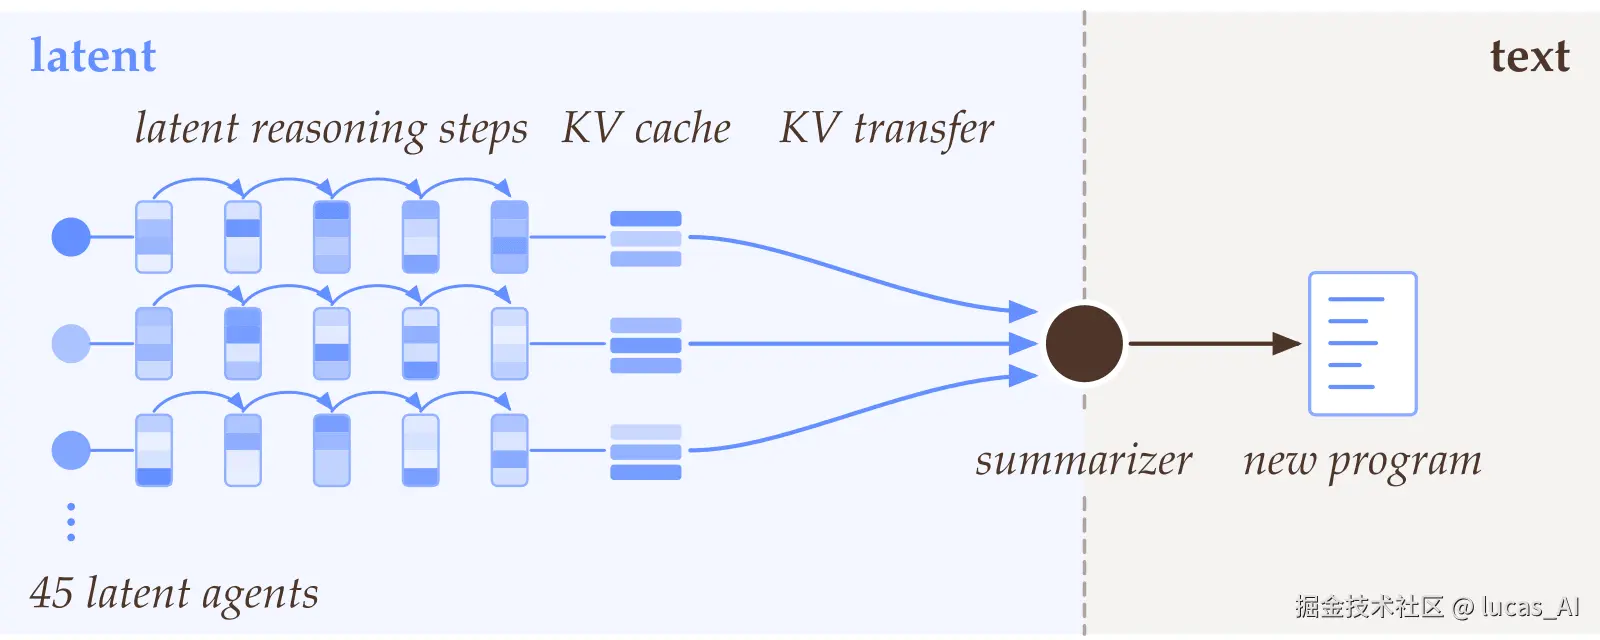 图说:每个 agent 在嵌入空间递归思考、把过程存成 KV cache;summarizer 读拼接后的 cache 写出文字程序。
第三,新颖性过滤不花一分钱。 进化搜索最怕群体思维趋同。以前的做法(比如 ShinkaEvolve)要外挂一个嵌入模型算相似度,再叫 LLM 当裁判判断重复。SwarmEvolve 直接用每个 agent 40 步隐藏态的均值向量当它的「想法指纹」,中心化、归一化后用贪心最远点选择留 30 个扔 15 个------纯 GPU 上的向量运算,几秒搞定。
第四,群型分工。 10 个 swarm 不是乱编的:4 个精炼群盯档案前二名反复打磨,3 个杂交群从前十名随机抽程序搞融合,2 个探索群去翻冷门角落,1 个重启群只看初始题面、强制从零想新招。exploitation 和 exploration 的配比是进化搜索的老话题,这里用「群型」把它工程化了。还有个细节见品味:精炼群采样温度 0.3(求稳),探索和重启群 0.8(求野)。
为什么会想到用「数量」换质量?作者的逻辑是:既然单个潜 agent 便宜到几秒钟一个,那就别纠结「一个 agent 想得多深」,直接上 450 个从不同角度看问题的 agent------多样性靠并发硬堆,选择性靠过滤,综合性靠 summarizer。整套系统零训练,全靠推理期机制。
📈 效果到底怎么样?
数字说话。21 个问题上(16 个数学题直接取自 AlphaEvolve 附录 B,5 个科学计算题是作者自设计的,都是单 GPU 60 分钟、每题 3 个随机种子):
- 平均分:三个模型规模全第一------Qwen3 8B 拿 0.804,三个 SOTA 基线分别是 0.693、0.642、0.700。分数定义是「目标值 ÷ AlphaEvolve 发表构造的值」,超过 1 就是打赢了 AlphaEvolve。
- 吞吐量:一小时评估 734 个程序,基线是 158 / 99 / 81------5 到 13 倍的差距。
- 速度:中位 3-8 分钟(8B 模型)达到基线 60 分钟的最佳分。
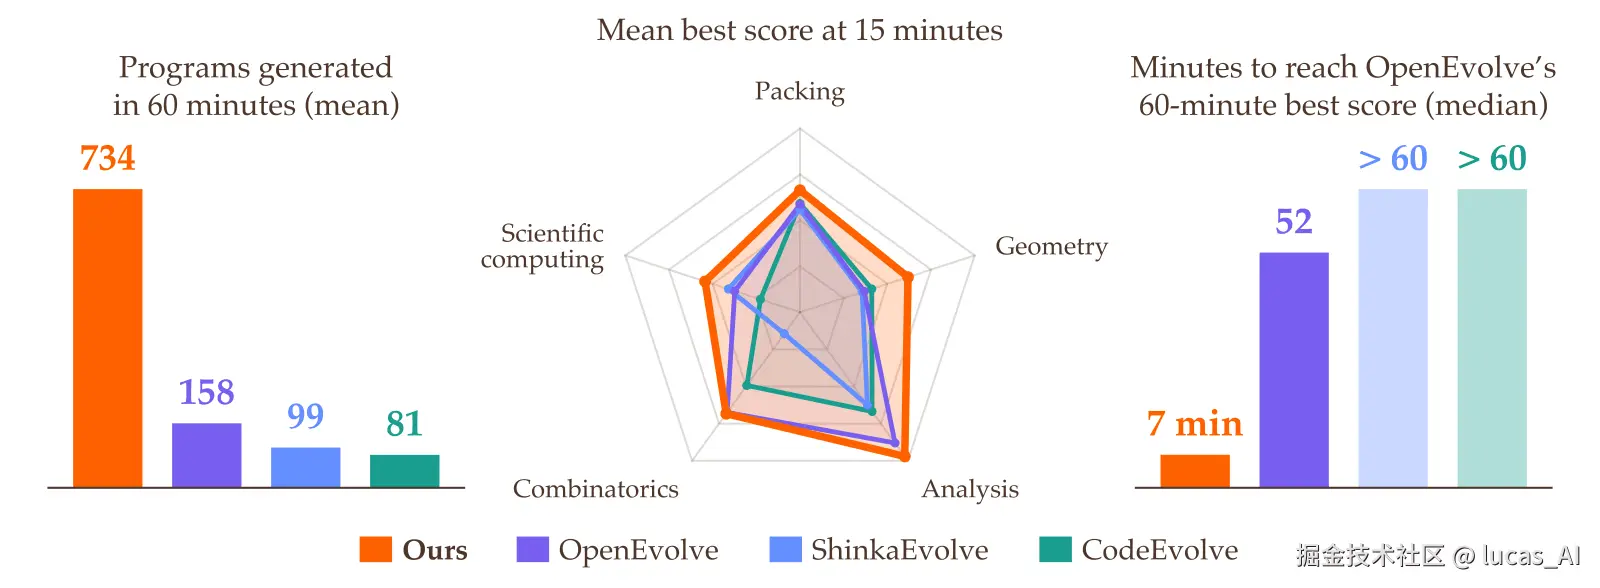 图说:左图是每小时生成的程序总数,中间是 15 分钟时的平均最佳分,右边是达到 OpenEvolve 60 分钟分数所需的分钟数------大多落在个位数到十几分钟。
最有冲击力的对比是这个:Qwen3 8B 的平均分(0.804)高于所有基线用 32B-FP8 跑出来的成绩。小模型配上高吞吐搜索,赢了大模型配低吞吐搜索。换个角度理解,这套框架某种程度上把「模型不够大」的劣势用「搜得足够多」补回来了。
还有一个让数学圈会心一笑的结果:冻结的 Qwen3 8B 在 3 个问题上改进了 AlphaEvolve 用前沿 Gemini 模型发表的构造------26 个圆装箱问题直接摸到了人类已知最优的半径和(2.635983,Packomania 记录),二阶和三阶自相关不等式的界也被推高。各基线只有 1 个题做到。
时间去哪了?附录 B 的分解表特别诚实:三个基线把 57%-87% 的 GPU 时间烧在文本推理上,而 SwarmEvolve 只花 11% 在潜推理加潜通信上,66% 的时间全在「写程序」这个产出环节。提速的秘密不是玄学,就是把浪费在「打字」上的时间省下来了。
诚实地讲,也不是处处赢:Kissing number(d=11)这类难题上 60 分钟没追上基线(图里的空心圈),零散几个题被反超。「更快达到同等分数」是中位行为,不是逐题保证。
💡 为什么你要关心?
就算你不做数学发现,这篇论文里有三样东西是能直接搬走的:
- KV cache 广播通信:多 agent 系统里 token 账单最重的就是「互相转述」。让 agent 直接互读 KV cache,通信成本降一个量级------只要你家 agent 跑在同一个模型上,这个模式今天就能抄。
- 隐藏态新颖性过滤:需要给生成结果查重、保多样性的场景(合成数据、测试用例生成、RAG 查询改写),用模型自带的隐藏态算距离,省掉外挂 embedding 模型。
- 「短思考 + 高并发」的性价比路线:与其在一个大模型上跑一次深度长推理,不如在一堆小模型 agent 上并发短思考再汇总------这篇的消融数据给了这条路线一个扎实的支撑点。
再往大里看,这篇论文把 AI 科学发现的入场券从「大厂预算」降到了「实验室预算」:一张 L40S、一个开源 8B 模型、一小时,就能在前沿模型的构造记录上再前进一步。这种算力民主化的价值,可能比具体数字更深远。
🧊 理性看待
热情之余有两处要冷静。第一,归因要看仔细:消融表显示 40 token 的短文本推理分数(0.796)和潜空间推理(0.804)几乎打平,真正的差距在吞吐(663 vs 734)。所以潜空间机制的主要贡献是系统层面的------450 份思考能装进一个上下文、过滤免费、通信零翻译------而不是「agent 想得更聪明了」。第二,对比全部限于 Qwen3 家族,基准题与初始程序直接继承自 AlphaEvolve/OpenEvolve 生态,「在别人的基准上针对性设计」的优势成分难说为零;加上「超越 AlphaEvolve」取的是 3 个种子里的最好结果,当成方向性信号看就好,别当普适结论。另外论文自己承认的硬边界也得记着:KV cache 通信要求所有 agent 同模型、要求标准 attention 架构(线性注意力、Mamba 这类固定状态模型玩不了),显存还随 agent 数线性涨。