2026 年的头部大模型,在上下文窗口这个数字上几乎打成了平手,旗舰产品清一色停在 100 万 token 上下。真正拉开差距的,是模型能把多少内容用好、一次能写多长,以及开发者实际能拿到多大的窗口。下面把官方数据、第三方评测和社区声音放在一起梳理。
📏 先把概念讲透
上下文窗口与最大输出是两个不同的数
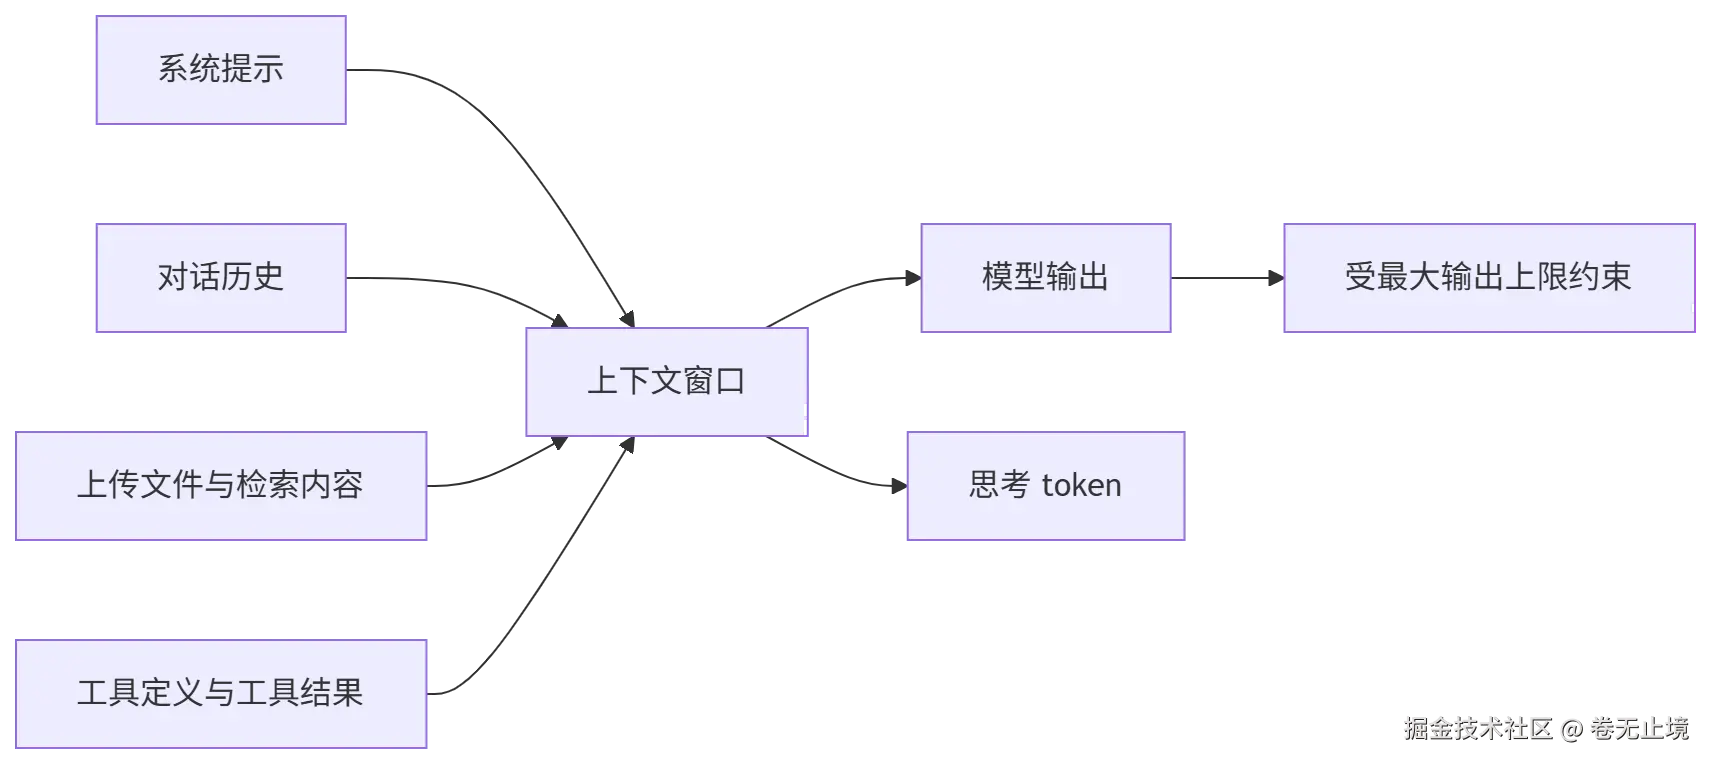
上下文窗口指模型单次请求里能同时看到的 token 总量。系统提示、对话历史、上传文件、工具返回结果,连同模型自己的回答,都要挤进这个空间。最大输出(常见参数名是 max_tokens)则是模型单次回答最多能写多少。一个模型能读 100 万 token,单轮却可能只能写 12.8 万 token。
可以把这层关系写成一个简单的预算式:
N输入+N输出≤N窗口
推理型模型还有一笔额外开销。Anthropic 的文档说明,当前模型的思考 token 和普通输入一样占用窗口。
一个 token 大约有多长
token 是文本切块后的单位,英文里平均约为 0.75 个单词。按这个比例粗算,12.8 万 token 约等于 9.6 万词,相当于一本厚实的技术书或一份很长的合同。100 万 token 约 75 万词,足以装下整个代码仓库或一年的聊天记录。写代码时要多留余量,因为符号和空白的切分效率比散文低。不同厂商的分词器各不相同,同样是 100 万 token,所容纳的文本量并不完全一致。
📊 主流模型的数据对比
旗舰模型一览
BenchLM 的对比文章横向比较了四款旗舰,数据以 4 月的快照为基础,9 月有更新。
| 模型 | 上下文窗口 | 最大输出 | 输入价格(每百万 token) | 缓存价格 |
|---|---|---|---|---|
| Gemini 3.1 Pro | 1,000,000 | 64,000 | 2 美元(200K 以内),4 美元(超过 200K) | 未列出 |
| GPT-5.5 | 1,000,000 | 128,000 | 5 美元 | 批处理约 2.5 美元,缓存可省 90% |
| Claude Opus 4.7 Adaptive | 1,000,000 | 64,000 | 5 美元 | 0.5 美元(90% 提示缓存) |
| DeepSeek V4 Pro | 1,000,000 | 384,000 | 1.32 美元(高峰时段) | 0.044 美元(缓存命中) |
这张表有两处值得细看。输入窗口已经没有区分度,四家都是 100 万。输出上限却差出了 3 到 6 倍,DeepSeek V4 Pro 的 38.4 万远高于同行。需要一次生成完整报告、大型代码迁移或批量文档改写的场景,这个差距无法靠堆提示词弥补。
定价结构同样有门道。Gemini 3.1 Pro 是这组里唯一按窗口位置分档计价的,超过 20 万 token 后输入单价翻倍。Claude 靠 90% 的提示缓存把有效输入价压到约 0.5 美元。DeepSeek 的缓存命中价比未命中便宜 96.7%,是这组里最低的。
最新一代的补充信息
Upsolve 在 9 月核查、11 月发布的文章显示,最新一代已经往前迈了一步。GPT-5.6 的窗口为 105 万 token,Claude Opus 5 与 Sonnet 5 为 100 万,Gemini 3.1 Pro 仍是 100 万。 另一份时间线文章指出,GPT-5.6 Sol 的最大输出同样是 12.8 万,并说明目前公开的最大窗口已经达到千万 token 量级。
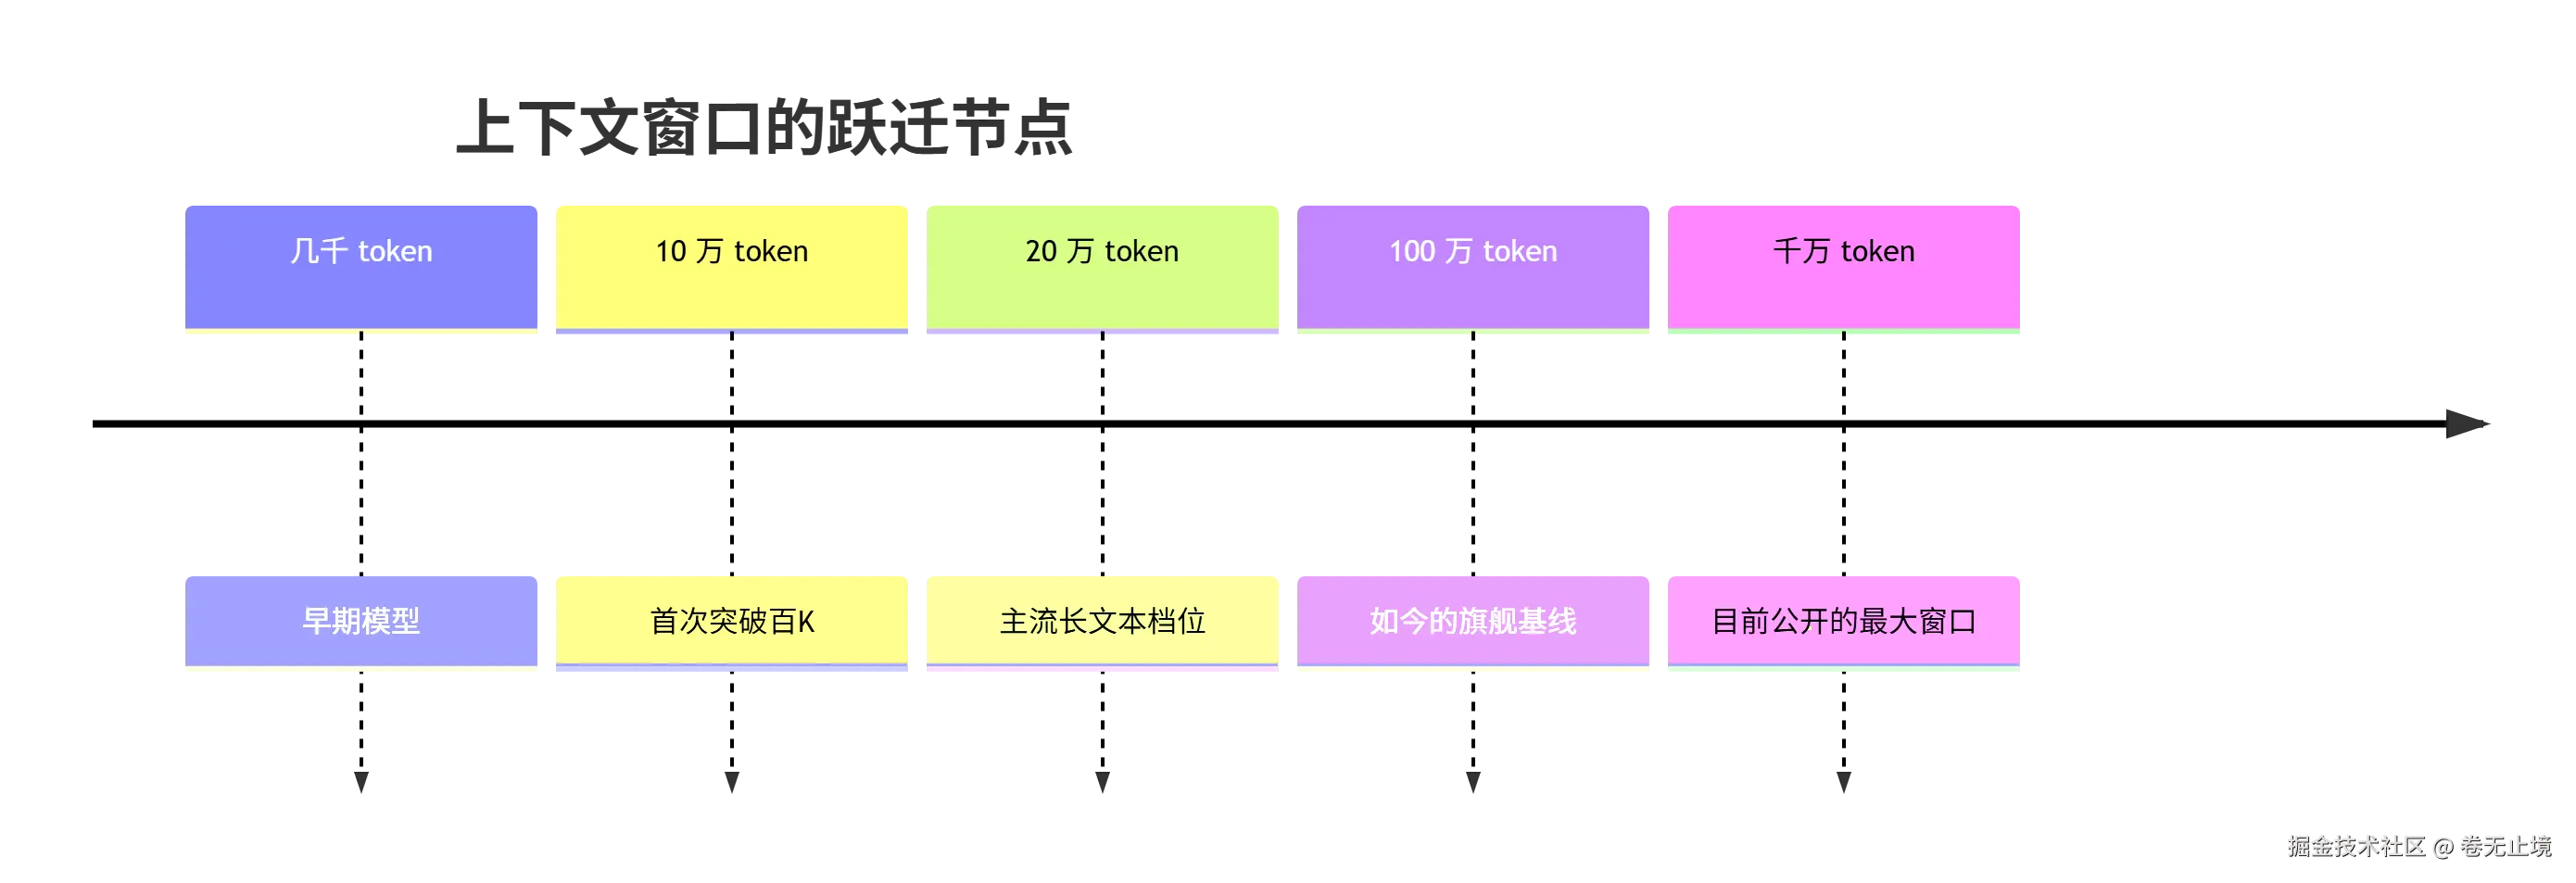
这条时间线只是示意,具体年份请以参考资料中的官方节点为准。
谁真能把窗口用满
标称值相同,实际表现却不同。BenchLM 的结论是,Gemini 3.1 Pro 在 50 万到 100 万 token 区间的有效上下文得分最强,GPT-5.5 在 LongBench v2 与 MRCRv2 上得分最高。Claude Opus 4.7 则被评价为中等长度交互的甜蜜点。
AIMultiple 的 VELC-Bench 考察模型在长文本中找到某个指标、与论断比对并判断真伪的能力。参测模型包括 Claude Fable 5(测试长度 85 万 token)、GPT-5.5、Gemini 3.1 Pro Preview 与 Gemini 3.5 Flash(均为 100 万 token)。这类测试比单纯的大海捞针更接近真实工作,因为模型既要检索,又要精确比较。
🗣️ 社区怎么说
第一类声音,上下文腐烂
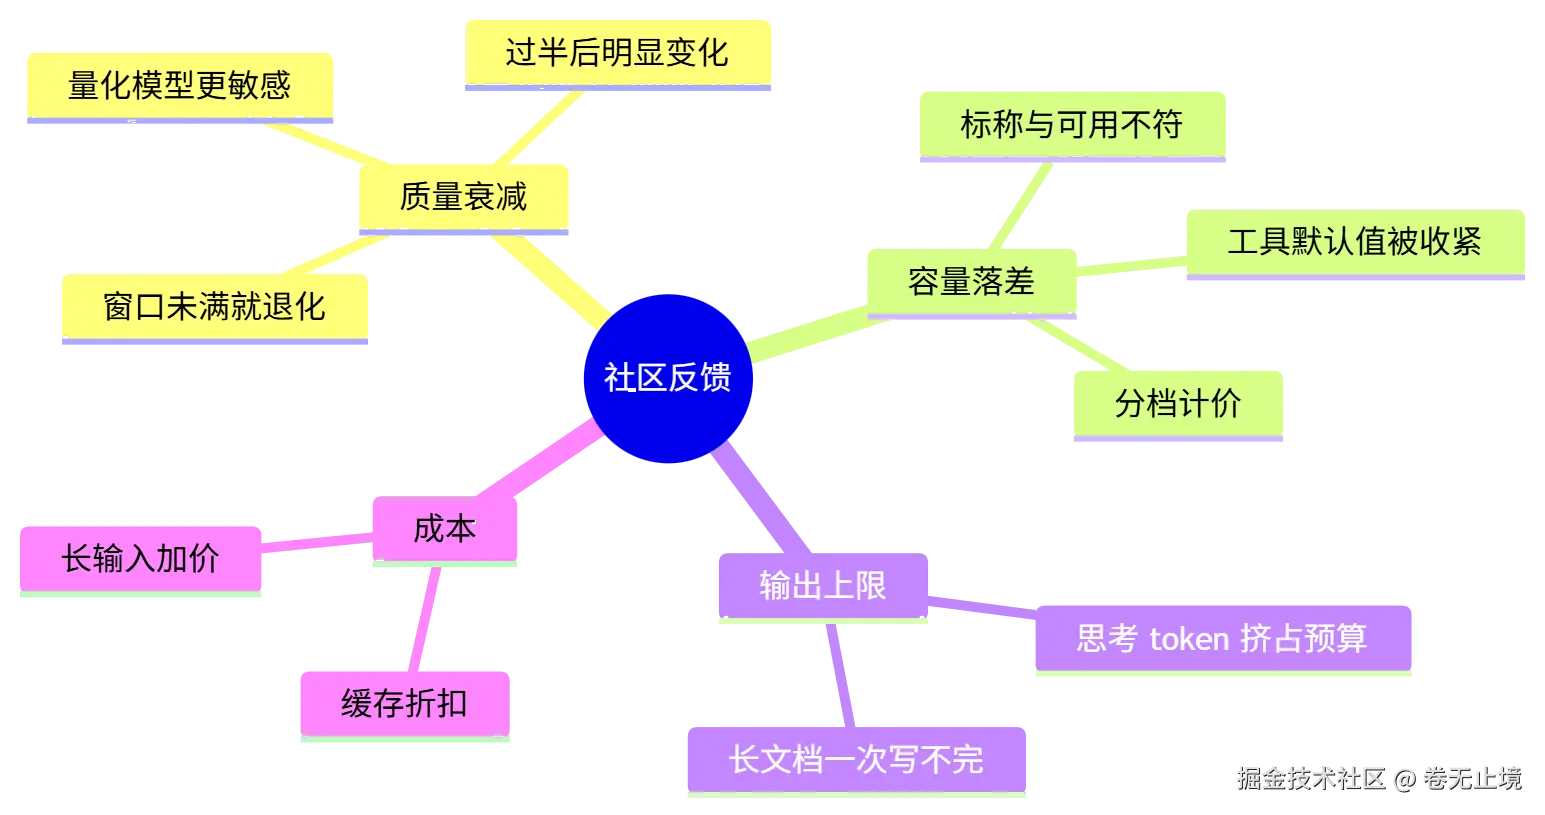
最集中的抱怨叫 context rot。r/AI_Agents 上有帖子认为,智能体做到一半就垮掉,多半是这个原因,更让人意外的是,退化在窗口远没塞满时就已经开始。帖中引用了 Chroma 对 18 个模型的测试。 Upsolve 的总结说得更直白,Chroma 测的 18 个模型里(包括 GPT-4.1、Claude 4 和 Gemini 2.5),每一个都随输入变长而变得更不可靠,往往在窗口用掉一小半时就露出苗头。
Product Talk 的文章给出了一条经验法则,窗口超过 50% 时,模型的表现开始出现可感知的变化,具体退化方式取决于塞满的程度。
第二类声音,窗口依然是硬伤
r/singularity 上有一篇热帖,标题大意是上下文窗口仍然是个巨大的问题。发帖者引用了《Effective Long-Context Scaling of Foundation Models》,强调预训练数据里有大量长文本,并不是长上下文能力强的关键。 换成日常说法就是,数字再大,模型也未必真的记得住。
本地部署圈的体感也一致。r/LocalLLaMA 有用户在跑 Midnight Miqu v1.5 的 EXL2 量化版,发现越接近上下文上限,输出质量越差,于是发帖追问这是不是模型的固有现象。 这说明退化并不只是闭源大模型的问题,开源模型加量化的组合同样会遇到。
第三类声音,厂商和工具偷偷把窗口收小
开发者的不满还落在产品层面。Upsolve 引用 InfoWorld 的报道提到,OpenAI 的 Codex 把 GPT-5.6 默认限制在 27.2 万 token,远低于模型 100 万以上的规格,引发了开发者的不满。该文还指出,消费级应用、智能体框架和定价档位常常让你拿不到 API 的最大值。
社区关切一览
💡 实用建议与小结
选型时可以这样权衡
- 做超长输入检索与分析,Gemini 3.1 Pro 在有效上下文评测里表现最强,但超过 20 万 token 要承担加价。
- 需要单次生成超长内容,DeepSeek V4 Pro 的 38.4 万输出上限几乎没有对手,GPT-5.5 的 12.8 万居第二。
- 反复调用同一份长资料,Claude 的提示缓存和 DeepSeek 的缓存命中价能显著省钱。
- 使用 Codex 之类的工具,先确认默认窗口,别默认等于模型规格。
把上下文当预算管,而不是当仓库
Upsolve 把这套思路叫作 context engineering,认为放进窗口的内容和组织方式,比窗口本身的容量更重要。 结合社区的经验,几个习惯很管用。把关键信息放在开头和结尾,定期总结并清理历史,别等到超过一半再动手。长任务拆成多轮,每轮只带必要材料。
一句话收尾,100 万 token 的数字已经不稀奇,能在 20 万甚至 50 万 token 处依然靠谱,才是现在的硬功夫。不过需要提醒一点,本文引用的榜单多为二手汇总,各家模型迭代很快,下单前最好回到官方文档核对最新数值。
参考资料
Advertised vs Effective Context Windows What 1M-Token Claims Hide benchlm.ai/blog/posts/...
LLM Context Window Growth Timeline Milestones Current Sizes by Provider and Official Sources hidekazu-konishi.com/entry/llm_c...
Context Window Sizes GPT-5.6 Claude Gemini and Grok 2026 upsolve.ai/blog/contex...
VELC-Bench Verification on Long Context Benchmark aimultiple.com/ai-context-...
Context window is still a massive problem www.reddit.com/r/singulari...
Context rot is why your agent falls apart halfway through a task www.reddit.com/r/AI_Agents...
Context Rot Why AI Gets Worse the Longer You Chat www.producttalk.org/context-rot...
Does Model Output Inherently Degrade as Context Fills www.reddit.com/r/LocalLLaM...