RAGFlow 是 InfiniFlow 团队开源的检索增强生成(RAG)引擎。它最初以深度文档理解 立身,如今的定位已经扩展到了面向智能体的数据库。下面从项目定位、发展原因、优势、开发活跃度和主要特点几个方面展开。
🧭 项目定位与演进脉络
它到底是什么
大模型常常一本正经地胡说八道,RAG 就是给它配一个资料库。回答问题前先去检索相关内容,再让模型依据这些内容作答,答案就有了出处。
RAGFlow 做的是这条流水线的完整工程化。官方文档把它描述为基于深度文档理解的开源 RAG 引擎,面向复杂文档构建企业级工作流,并强调回答要带有可追溯的引用。,
项目当前的自我介绍已经升级为 agent-native database,也就是面向智能体的数据库。这个说法表明,它不再只想做知识库问答,而是想成为智能体取用上下文的底层基础设施。
版本演进时间线
从公开的更新记录看,近几个月的节奏相当紧凑。
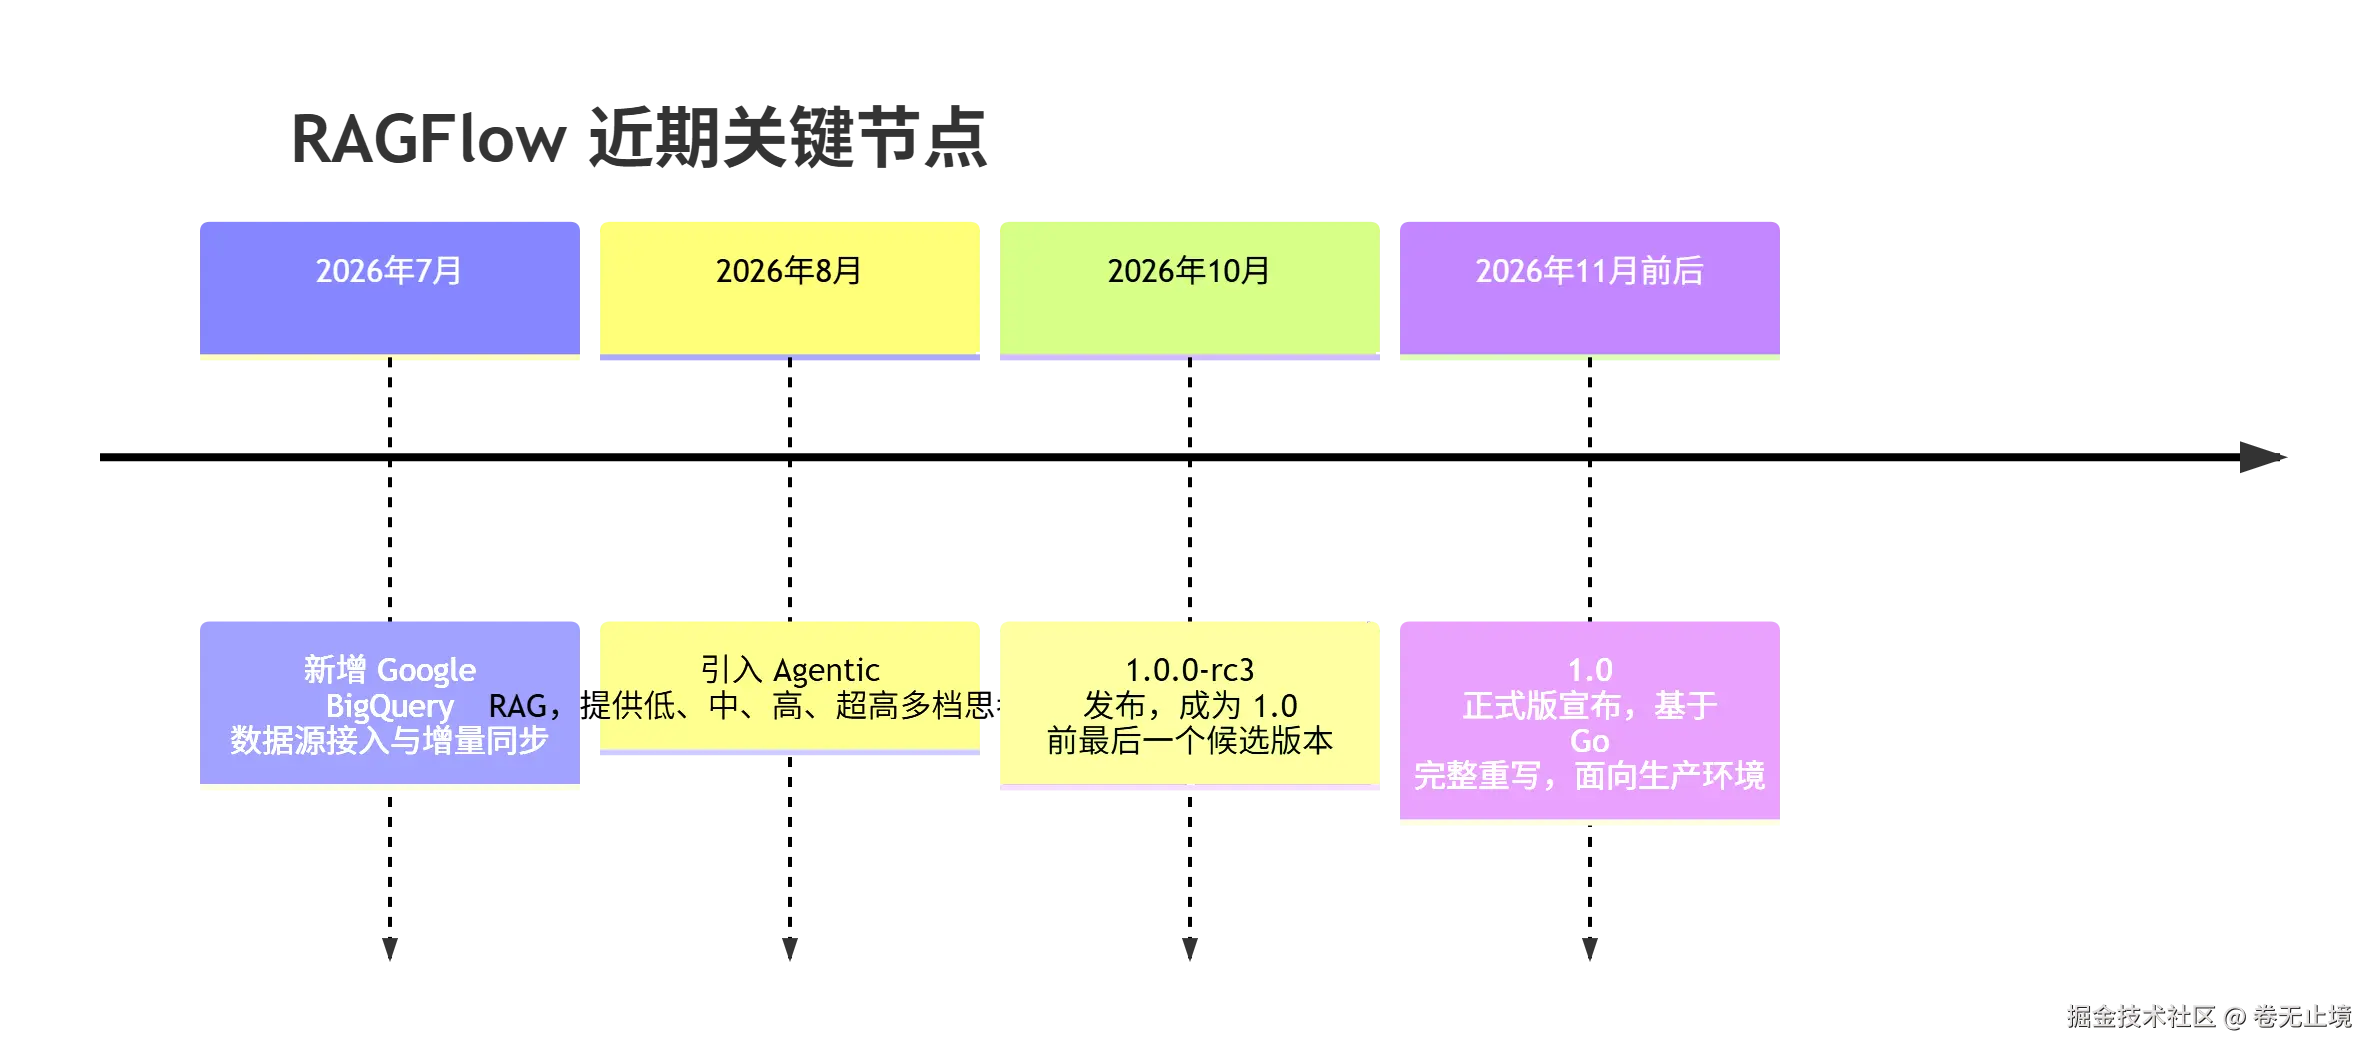
这条线索来自项目主页的更新日志、官方发布说明与 GitHub 发布页。, ,
🔍 为何能发展至今
抓住了 RAG 落地的真痛点
很多团队做 RAG,第一道坎不在模型,而在文档。PDF 里有表格、多栏排版、扫描件和图片,直接丢给通用切分器,出来的往往是一堆断句残片,检索质量自然差。
RAGFlow 一开始就把赌注压在深度文档理解上,即先把版面看懂,再谈切块和检索。早在项目发布初期,社区就把它概括为基于 OCR 与文档解析的 RAG 引擎,并在 LocalLLaMA 等社区引发讨论。
这个切口很准。它解决的是一个人人都会撞上、又没人愿意啃的苦活。
持续跟随技术风向
一个开源项目能活多久,要看它能否不断换挡。RAGFlow 的几个动作值得留意。
- 从单纯的问答检索,走向 Agentic RAG,让模型自己规划检索与推理步骤,并提供不同强度的思考模式。
- 数据接入不断扩张,连 BigQuery 这类数据仓库也支持增量同步,说明它在向企业数据现场靠拢。
- 1.0 版本基于 Go 完整重写,明显是在为生产环境的性能与稳定性做长期打算。
社区与传播
项目在 Reddit、LinkedIn 等平台都有持续的讨论和推荐,技术博主常把它作为深度文档理解类 RAG 的代表来介绍。这类自发传播为项目带来了稳定的新用户。
💡 核心优势与主要特点
一张图看懂工作流
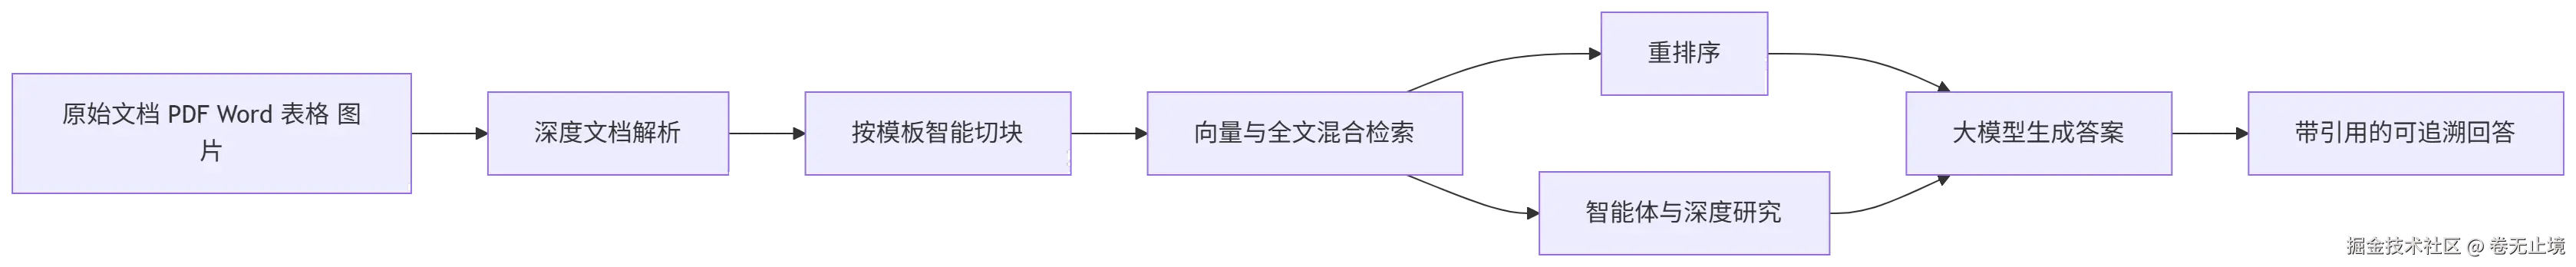
优势与特点速览
| 维度 | 表现 | 意义 |
|---|---|---|
| 文档理解 | 针对复杂版面、表格做深度解析 | 提升检索源头质量 |
| 引用溯源 | 回答附带有据可查的出处 | 降低幻觉,便于核对 |
| 能力范围 | 支持网络搜索、深度研究等 | 超出传统问答 |
| 智能体能力 | Agentic RAG,多档思考模式 | 按问题难度调配算力 |
| 数据接入 | 多种数据源,支持增量同步 | 贴近企业真实数据 |
| 生产就绪 | 1.0 采用 Go 重写 | 追求性能与稳定 |
以上要点综合自项目主页、官方文档与发布说明。
表格里最能拉开差距的是前两项。多数 RAG 框架在检索与生成环节大同小异,真正决定体验的,是进入知识库之前文档被处理成了什么样,以及答案能不能被验证。
📈 开发是否活跃
结论很明确,非常活跃。理由有三条。
- 发布节奏密集。 1.0.0 经历了 rc2、rc3 等多个候选版本,rc3 于 2026 年 10 月 30 日发布,被官方称为 1.0 之前的第三个也是最后一个候选版本。
- 社区在追问进度。 GitHub 上有用户专门询问 1.0 预计发布时间,维护者回应称按计划约一个月内推出,并先发布后续候选版本。社区的期待和维护者的回应,都说明项目处于热度很高的迭代期。
- 功能持续上新。 从 7 月的 BigQuery 数据源到 8 月的 Agentic RAG,每个月都有实质性功能落地,而不是只修补小问题。
另外,官方发布页宣布 1.0 已可用于生产,这对观望中的企业用户是个明确信号。
🧪 上手路径与选型建议
想快速体验,官方快速入门文档给出了从部署到创建知识库的完整流程,通常用容器方式即可拉起服务。
bash
# 获取源码后进入 docker 目录,用 compose 启动服务
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker
docker compose up -d
具体的版本标签、硬件要求与配置项,以官方快速入门文档为准。
适合选用 RAGFlow 的场景大致有这些。
- 资料以 PDF、扫描件、带表格的报告为主,对解析质量要求高。
- 需要答案可追溯,用于合规、研究或客服审核。
- 计划往智能体、深度研究方向演进,希望一个平台覆盖。
如果只是处理几份纯文本,轻量框架已经够用,RAGFlow 的完整栈会显得偏重。这是取舍,不是缺陷。
🎯 总结
RAGFlow 之所以能走到今天,靠的是三件事。它从文档解析这个最痛的环节切入,持续把握 Agentic RAG 等技术风向,又以 1.0 的 Go 重写表明了长期投入的决心。开发节奏之快,从候选版本的连续发布和社区对 1.0 的追问中看得很清楚。对需要在复杂文档上做出可信问答的团队,它是目前最值得认真评估的开源选项之一。
📚 参考资料
RAGFlow is an agent-native database: a Retrieval-Augmented Generation engine,GitHub 项目主页,github.com/infiniflow/...
RAGFlow, the deep document understanding based RAG engine,Reddit r/LocalLLaMA 讨论,www.reddit.com/r/LocalLLaM...
Quickstart,RAGFlow 官方文档,ragflow.io/docs
Open-Source RAG Engine for Deep Document Understanding,LinkedIn 推荐文章,www.linkedin.com/posts/avi-c...
Releases · infiniflow/ragflow,GitHub 发布页,github.com/infiniflow/...
Releases,RAGFlow 官方发布说明,ragflow.io/docs/releas...
Any Estimated Release Date for RAGFlow 1.0? #21126,GitHub Issue,github.com/infiniflow/...