工程 Agent 怎么压缩上下文,又怎么保留事实
从组装请求到压缩重建
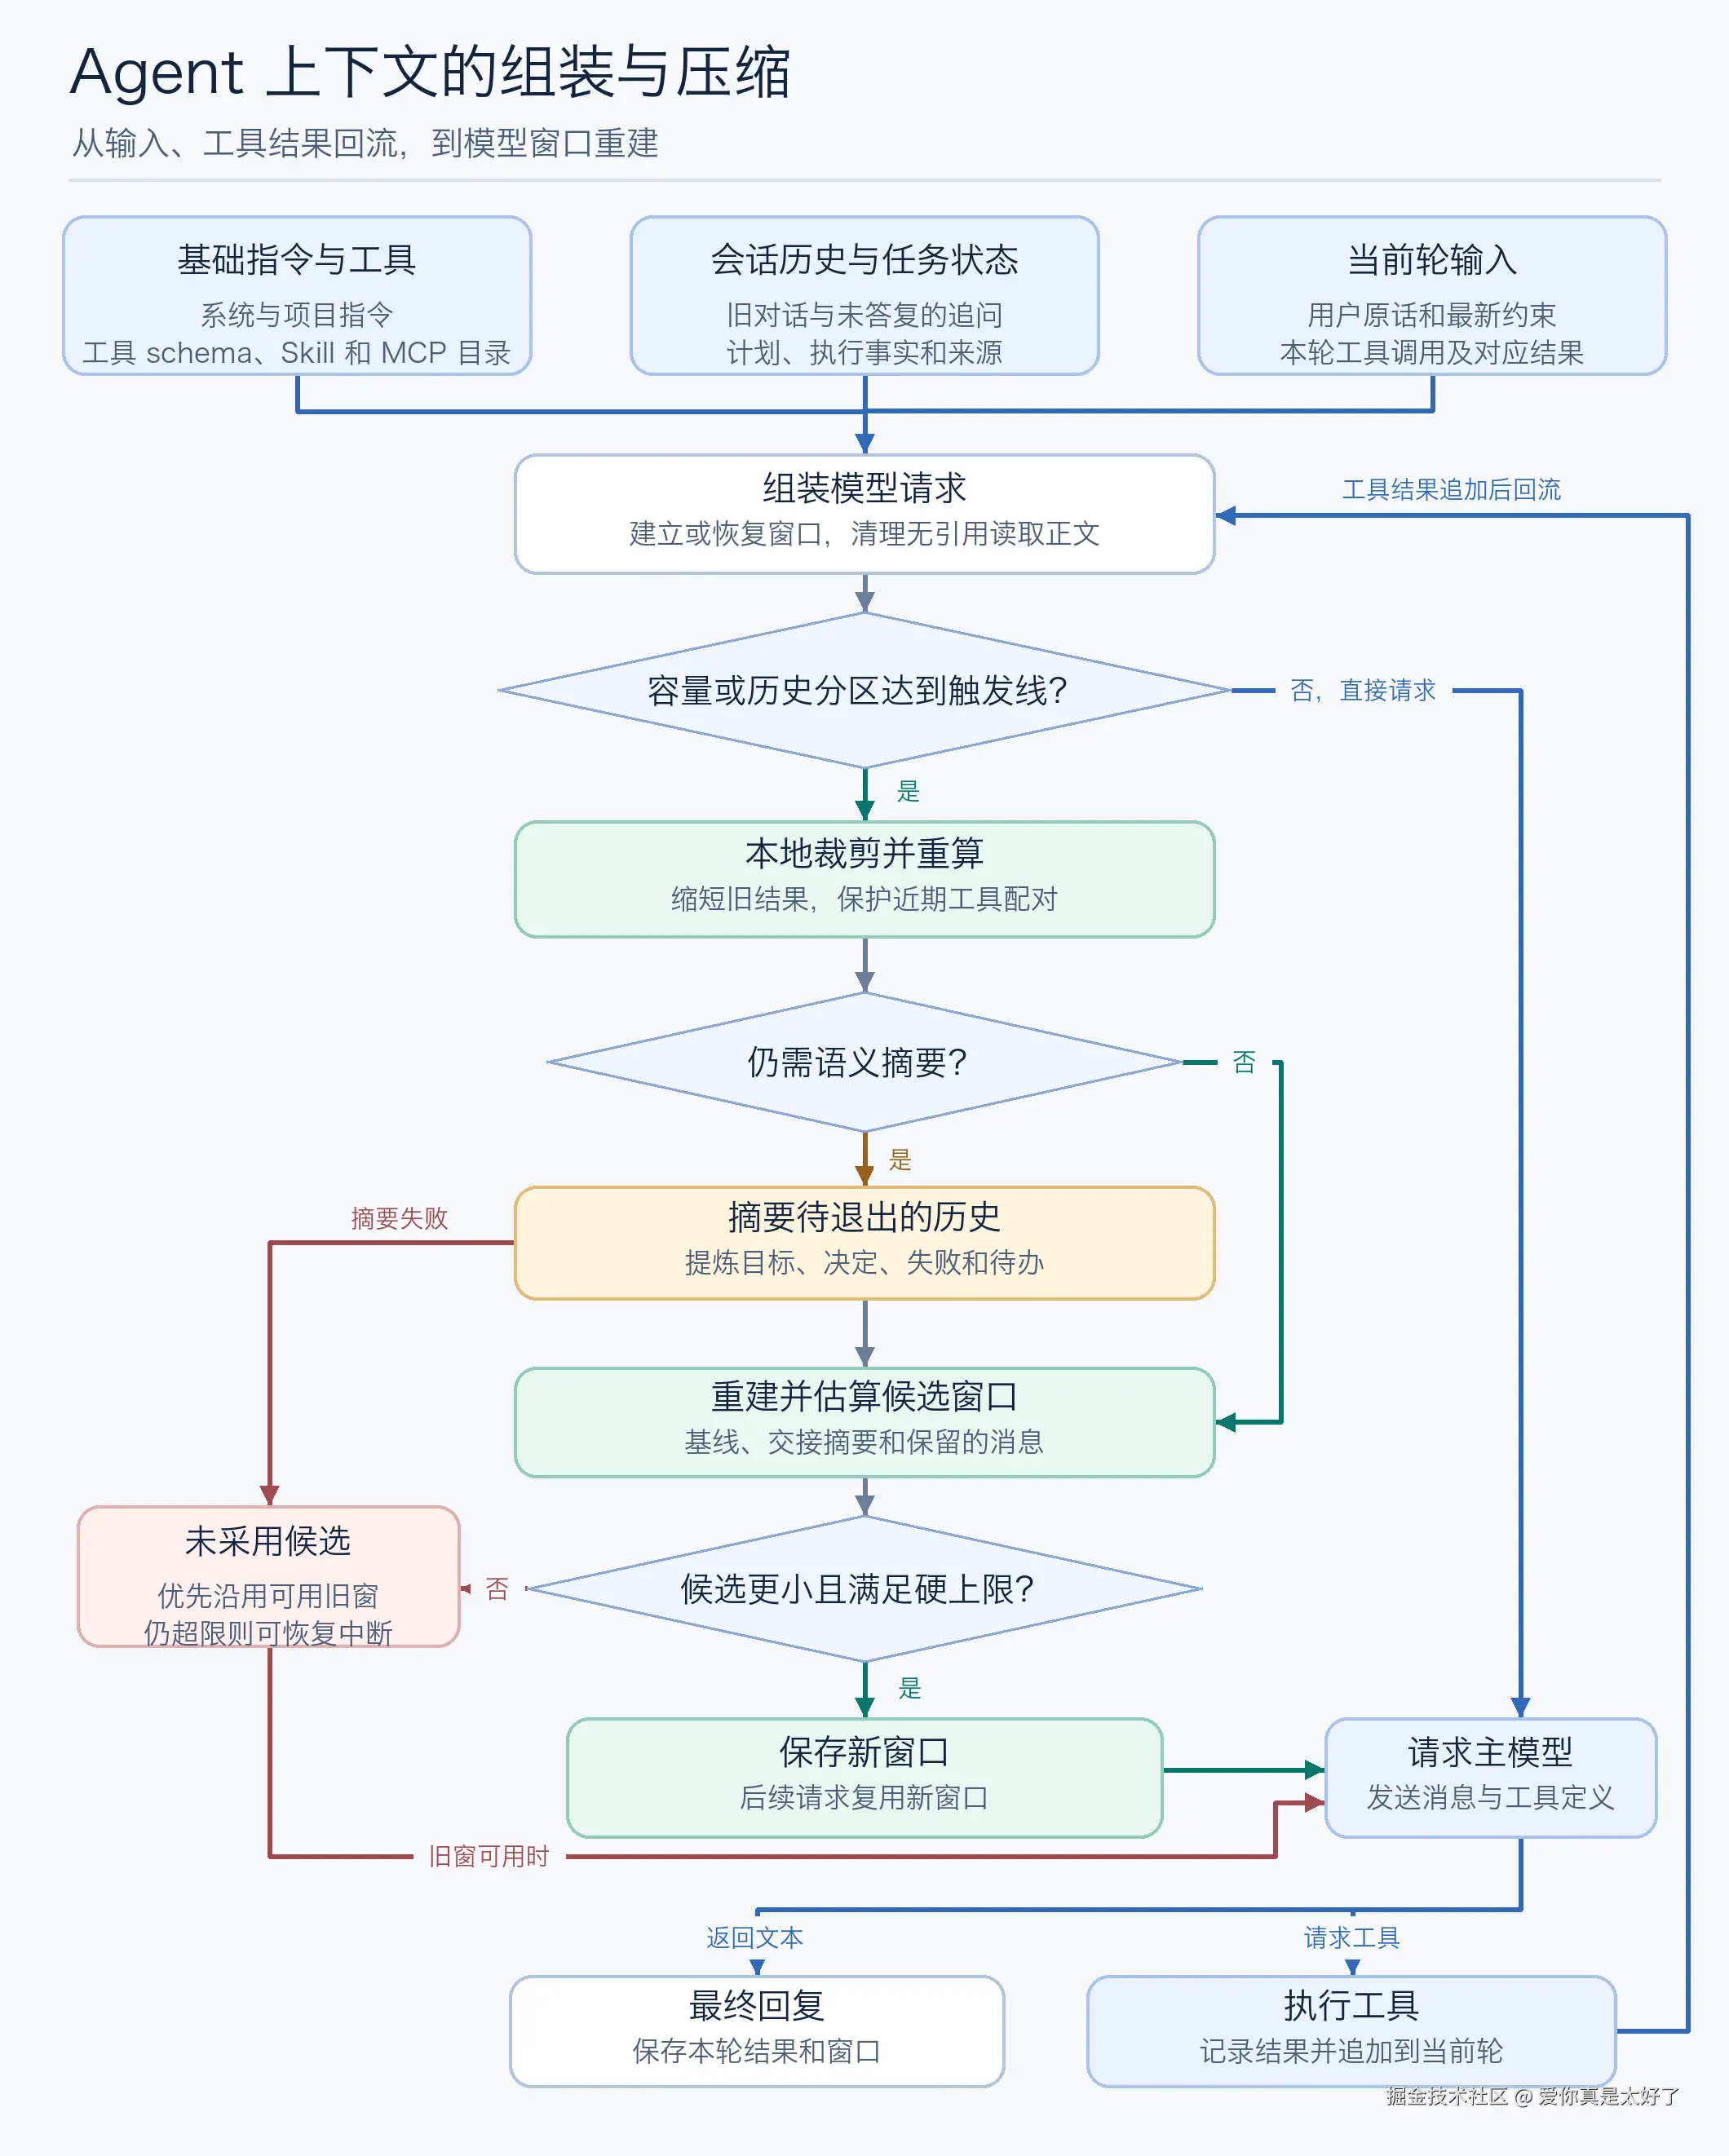
每次工具结果返回后,Agent 都会重新检查下一次模型请求的预算。图里的「保存新窗口」是通过检查后才执行的步骤。压缩候选在此之前只是一份待选的模型输入。
模型上下文由什么组成
| 内容 | 典型数据 | 管理方式 |
|---|---|---|
| 基础指令和工具 | 系统提示词、项目指令、工具 schema、Skill 和 MCP 目录 | 尽量保持前缀稳定,能力目录按需展开 |
| 会话历史和任务状态 | 旧对话、历史工具事实、计划、未完成事项 | 按预算保留,历史事实附带来源 |
| 当前轮 | 用户原话、最新约束、工具调用和结果 | 原话优先保留,工具调用和结果成组处理 |
运行时把用户输入和工具结果写入持久化事件,再从中组装模型这一刻需要看到的内容。压缩改变的是后续请求发送的内容。事件账本提供独立的核查来源。
先清旧正文,再决定要不要做摘要
1. 分开检查容量和历史预算
| 检查项 | 以 300,000 token 窗口为例 |
|---|---|
| 容量触发线 | 输入估算加输出预留达到窗口的 80%,也就是 240,000 token,开始整理。 |
| 输入硬上限 | 如果预留 8,192 token 输出,发送前估算输入须在 291,808 token 内。 |
| 历史软上限 | 会话历史单独按 16,384 token 计量。历史超限时,即使整窗还有余量,也会尝试整理历史。 |
输入估算同时计入工具 schema 和多模态输入。用同一套估算比较压缩前后,再用服务商返回的用量核对实际请求。触发整理和发起摘要请求是两个步骤,本地裁剪能腾出足够空间时可以直接进入下一次模型请求。
2. 先做确定性清理
- 回收无引用正文。
session-context.read_payloads集中存放部分历史文件片段、搜索命中和目录条目。历史事实通过read_payload_ref共用正文。建窗、恢复旧窗口、压缩重建时,按剩余session-context和session-facts中的引用清理这个池。 - 缩短旧工具输出。 预算仍紧张时,优先处理可裁剪的旧结果。完全相同的观察可以引用已有结果,长输出可以留下头尾、错误行和来源。近期工具交换按调用与结果成组保留,裁剪发生在模型看到的副本上,核查仍可追溯到原始工具记录。
下面用项目里的清理函数演示。事实消息仍引用 live。另一条历史记录已经退出,正文还留在池里。
python
import json

from tsm_agt.core.session_history import prune_unreferenced_read_payloads
from tsm_agt.ports import Message, MessageRole, TextBlock


def history_message(message_id, data):
    return Message(message_id, MessageRole.USER, (TextBlock(json.dumps(data)),))


facts = history_message("session-facts-demo", {
    "boundary": "historical_runtime_facts",
    "summary": {"execution_events": [
        {"result": {"observation": {"read_payload_ref": "live"}}},
    ]},
})
metadata = history_message("session-context-demo", {
    "boundary": "session_conversation_projection",
    "read_payloads": {
        "live": {"content": "def parse_config(): ..."},
        "orphan": {"matches": ["旧搜索命中"]},
    },
})

retained_facts, retained_metadata = prune_unreferenced_read_payloads((facts, metadata))
assert retained_facts == facts
assert set(json.loads(retained_metadata.text)["read_payloads"]) == {"live"}
用出问题的窗口做离线回放,固定 300K 窗口和 63 个工具定义,只清理 72 份无引用正文。以下是同一次请求的估算对照。
| 指标 | 清理前 | 清理后 |
|---|---|---|
| 预计总输入 | 71,161 | 43,548 |
| 其中会话历史 | 34,221 | 6,608 |
| 是否触发历史压缩 | 是 | 否 |
这个窗口在容量线上有充足余量,反复触发的是历史分区的软上限。若每次摘要后仍把同一份旧正文装回去,下次模型请求就会再次遇到相同的历史超限。
3. 只摘要准备退出窗口的部分
需要进一步缩减时,压缩器先划出保留区。当前请求和任务状态优先保留,近期消息从末尾按组选取。默认保留底线是 8 条消息,遇到多条工具调用及结果同组时,会把整组留下。准备退出或缩减的旧消息进入摘要输入。
摘要输入会过滤工具目录和推理块,为重复结果留来源引用。估算仍超限时,长工具字段的裁剪尺度按 4,000、1,000、256 字符逐级收紧。摘要请求禁用工具,默认输出上限为 2,048 token,并要求交代用户目标、已做的操作、失败和下一步。原来已记录的工具事实继续按各自的来源校验。
例如,旧测试输出可以很长。下面构造一次失败的工具调用,用实际的摘要输入预处理函数保留退出码、错误行和 call_id。
python
from tsm_agt.core.summary_source import prepare_summary_source
from tsm_agt.ports import Message, MessageRole, ToolCall, ToolCallBlock
from tsm_agt.ports import ToolResult, ToolResultBlock

call = ToolCall("check-1", "core.run_command", {"argv": ["pytest", "-q"]})
result = ToolResult(
    call.call_id,
    False,
    {"exit_code": 1, "stdout": "运行中\n" * 300 + "AssertionError: expected 200"},
    error_code="PROCESS_EXIT_NON_ZERO",
)
messages = (
    Message("call", MessageRole.ASSISTANT, (ToolCallBlock(call),)),
    Message("result", MessageRole.TOOL, (ToolResultBlock(result),)),
)
rows, _ = prepare_summary_source(messages, tool_text_chars=256)
observed = rows[-1]["content"][0]
assert observed["data"]["exit_code"] == 1
assert observed["data"]["stdout"]["source"] == "check-1"
assert observed["data"]["stdout"]["error_lines"] == ["AssertionError: expected 200"]
4. 重建候选窗口,再决定是否采用
候选窗口由当前基础指令、可用的交接摘要、保留的历史和本轮工具交换组成。重建后再清理一次无引用正文,并用实际要发送的消息与工具定义重新估算。
- 候选更小且满足硬上限时,保存新窗口并继续执行。
- 候选没有变小而旧窗口仍可用时,沿用旧窗口。摘要失败时也优先保留可用旧窗,失败后进入短暂冷却。
- 候选超硬上限时,先释放额外保留的可选内容并重算。仍无法放下时,保留历史并记录可恢复中断。
排查压缩时可以对照两个事件。context.summary_completed 表示摘要请求已完成。context.compacted 记录实际采用的新窗口及前后估算。两条事件分开看,才能辨别一次摘要是否真的腾出了空间。
压缩重写了部分前缀,下一次请求可能少命中一些 Prompt Cache。稳定指令仍可复用的范围取决于实际请求。评估成本时要把这次摘要调用和接下来几轮的输入费一起算。 OpenAI Prompt Caching
Hermes 的内置压缩器也先处理旧工具结果,再按 token 预算保留尾部并摘要中段。Codex 的原生压缩路径用筛选后的消息和服务端返回的压缩项重建窗口。两种做法都把大段旧工具流水移出了后续请求。 Hermes 压缩设计 · Codex 窗口重建 · OpenAI Compaction
怎样尽量保证压缩后的信息可核验
-
保护用户原话和当前工具交换。 用户的最新请求、仍未答复的追问、明确约束直接保留。工具调用与结果按
call_id配对,模型还没消费的结果优先保留,避免继续执行时拿不到刚请求的数据。 -
分开保存模型归纳和运行时证据。 摘要里的「测试通过」是模型表述。能核对的证据是具体命令、退出码、观测到的结果,以及它们关联的调用记录和代码版本。旧文件结果可以保留路径、行范围和
sha256来标明版本。证据缺失时,将状态标为待核实。下面的证据只表明命令以1退出,失败原因还需查对应输出。json{ "call_id": "call-test-demo", "argv": ["python", "-m", "pytest", "-q", "tests/test_router.py"], "exit_code": 1, "output_observed": true, "source_event_sequence": 42 } -
用同一批任务对照评估。 固定模型、推理强度和工作区快照,比较压缩前后的版本。重点覆盖中断后继续、根据旧结果改文件、测试失败后继续修复。用实际文件 diff、独立测试和工具事件评判结果。先检查用户要求、工具配对、审批和验证事实,再比较 token、摘要次数和耗时。
压缩率反映窗口腾出了多少空间。任务能否准确接续,要看模型是否仍然知道用户要什么、哪些结果已经发生、哪些事情还待验证。