「高并发实测」系列第 7 篇。
环境声明:Redis 7.4.11 单体(Docker,无持久化)、Java + Lettuce Pipeline(c=16 = 16 个并发连接,batch=50 = 每次往返打包 50 条命令)、每轮 5s 预热 + 10s 采样,Hash/ZSet/Set 三组共 47 轮(String 的 12 轮来自系列第 1 篇,见文末目录),每轮用
OBJECT ENCODING回查编码确认没测错对象。本地/自建环境,绝对吞吐受客户端影响,请关注相对差距。关键配置实测值:hash-max-listpack-entries=512、hash-max-listpack-value=64(7.4.11 默认)。网上流传的 Redis 优化口诀里,有一条特别流行:"控制 field 数量保住 listpack"。我测完 59 轮的结论是:这条口诀建立在一个混淆之上,而它让你忽视的另一个操作,差了 30 倍。
〇、一分钟带走版
| 流行说法 | 实测结论 | 关键数字 |
|---|---|---|
| HSET 在 listpack 上快 20+ 倍,要"保住 listpack" | 数量假象 :那是 50 field vs 500 field 的差距,混了两个变量;修正阈值语义后的公平对照(只差 1 条、同值长)下 hashtable 反超 +8.8%~+38% | 交错配对 5 轮中位 |
| SMEMBERS / HGETALL "慢一点而已" | 大结果集的全量读取是数量级差距 :本组配置下 约 34 倍(476K vs 14K ops/s)------由成员数、成员长度、编码、响应量共同作用 | 476K vs 14K ops/s |
| Set 应该存字符串 | 本组配置下整数集合各项吞吐更高(SREM +46%、SRANDMEMBER +102%)------但成员数/内容不同,不能单独归因于 intset 编码 | 21 轮数据 |
| ZADD 在大 ZSet 上会慢? | 500m skiplist 反而比 50m listpack 快 11%------非公平对照,机制解释降为可能因素 | 139K vs 126K |
一句话:"刻意保小"不是银弹;真正要防的是大结果集的全量读取------那是数量级的差距。
一、背景:编码是"凑"出来的,且单向不可逆
Redis 的内部编码(int/embstr/raw、listpack/hashtable、listpack/skiplist、intset/listpack/hashtable)由数据自动决定,无法显式指定 。想测某个编码,只能靠 member/value 的类型、数量、长度去"凑",然后每轮用 OBJECT ENCODING 验证。
三个必须先说清的性质:
- 转换单向不可逆:listpack 转 hashtable 后,删数据也不会转回来。所以"先塞大量数据再删掉保 listpack"这种操作从机制上就不成立。
- 阈值语义要精确 :以 Hash 为例,转换由两个配置共同触发 ------
hash-max-listpack-entries(7.4.11 默认 512 )和hash-max-listpack-value(默认 64B )。field 数超过 512、或任一 value 超过 64B,都会转 hashtable。网上资料常把 128 当成 Hash 的阈值------那是 ZSet 的 listpack 条目阈值,本文写作时就踩了这个混淆(详见第三节)。 - Set 的编码与内容天然耦合 :整数成员才可能 intset,字符串成员不可能 intset------Set 无法做到"同内容只换编码"的公平对照,这是 Set 编码测试的方法论边界。
二、假象层:HSET"快 23 倍"是怎么来的
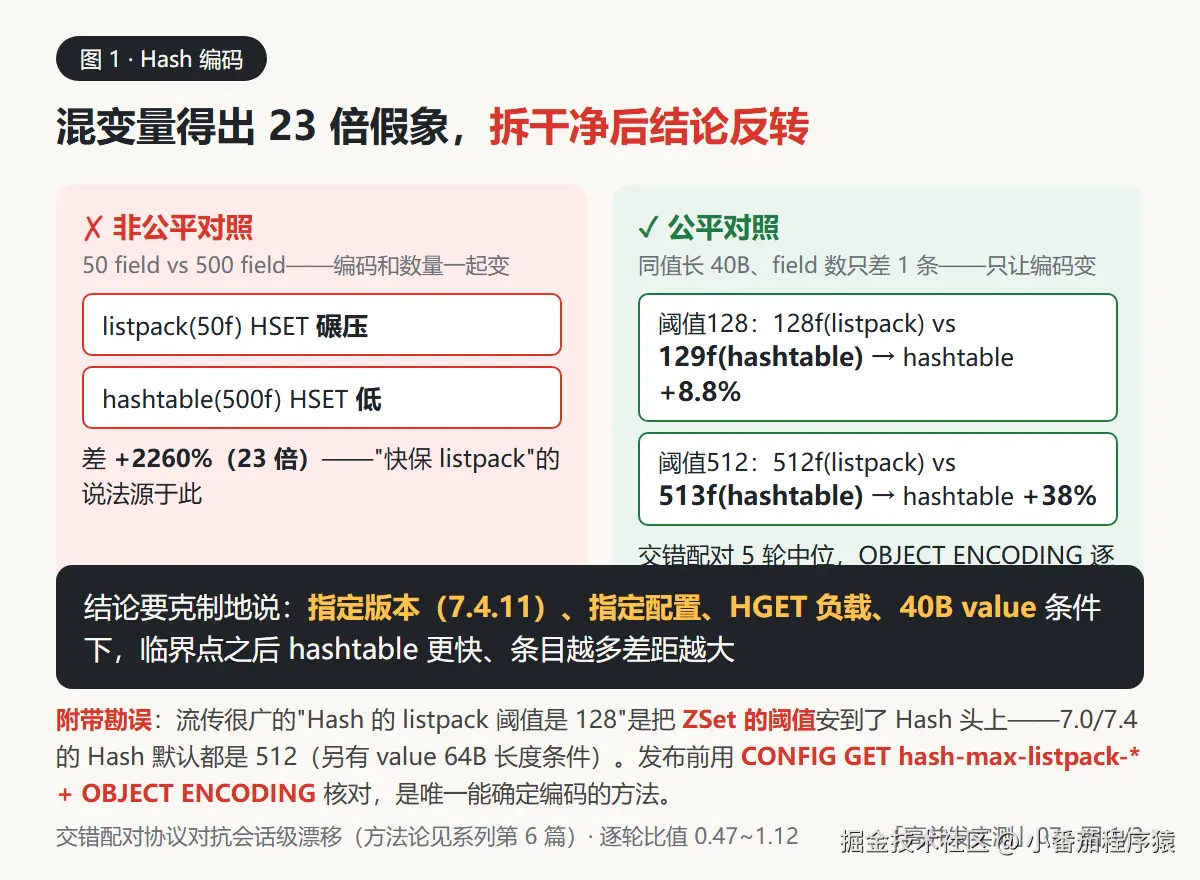
先看一组真实数据(非公平对照):
| 操作 | listpack(50 field) | hashtable(500 field) | 差距 |
|---|---|---|---|
| HSET | 碾压 | 低 | +2260% |
50 field 的 listpack 对 500 field 的 hashtable,HSET 快 2260%------折合 23 倍。"listpack 性能远超 hashtable"的说法多半源于这类对比。
但这个对照混了两个变量 :编码不同,field 数量也差 10 倍。listpack 赢,有多少是编码的功劳、有多少只是"它只有 50 条"?
三、公平对照:把变量拆干净之后
要公平,必须只让编码变 。Hash 可以做到:固定 value 长度(40B,≤64B 不触发长度转换),把 field 数压到阈值两侧,让"条目数"单独触发编码转换:
- 配置 A:
hash-max-listpack-entries=128(CONFIG SET 显式设定)→ 128f = listpack,129f = hashtable - 配置 B:
hash-max-listpack-entries=512(7.4.11 默认)→ 512f = listpack,513f = hashtable
两组都用 OBJECT ENCODING 逐侧验证编码。采样协议升级为交错配对(每轮交替采样两个配置、每两轮换顺序,按轮算比值取中位)------因为共享宿主上同一配置前后两轮能差 4 倍,非交错的单会话名次不可信(系列第 6 篇的方法论,在这里被迫实战了一次)。
口径说明(客户端不同) :本节公平对照由 python 单连接 pipeline(batch=50) 采集------与 47 轮主数据的 Java Lettuce c=16 不是同一个客户端 ,绝对吞吐不可比。但本节只引用比值(listpack/hashtable 的逐轮比),不引用绝对值------比值与方向在不同客户端间可比。
| 对照 | listpack 侧 | hashtable 侧 | 逐轮比值(listpack/hashtable) | 中位 |
|---|---|---|---|---|
| A:阈值 128,128f vs 129f | 基线 | 基线 | 0.797 / 1.000 / 0.883 / 1.117 / 0.919 | 0.919 |
| B:阈值 512,512f vs 513f | 基线 | 基线 | 0.723 / 0.468 / 0.473 / 1.068 / 0.890 | 0.723 |
两个阈值下,hashtable 侧都更快:A 组 hashtable 快约 8.8%,B 组(512 条的 listpack,O(N) 扫描更贵)快约 38%。逐轮比值在 0.47~1.12 间波动------漂移真实存在,交错配对把它的方向性洗了出来。
结论要克制地说 :在"指定版本(7.4.11)、指定配置、HGET 随机 field 负载、40B value"的条件下,临界点之后的 hashtable 吞吐高于 listpack,且条目越多差距越大。"刻意分片/限容去保 listpack"在本次观察里没有收益------但分片会改变键数量、网络往返和内存占用,本文没测那些,不把这句话外推成普遍规律。
一条写作时就踩到的勘误 :流传很广的"Hash 的 listpack 阈值是 128"是把 ZSet 的阈值安到了 Hash 头上 ------7.0/7.4 的 Hash 默认都是 512,128 只在显式 CONFIG SET 后才出现。发布前用
CONFIG GET hash-max-listpack-*+OBJECT ENCODING核对,是本文唯一能确定编码的方法。
四、Set:整数集合更高,SMEMBERS 差了 30 倍------但归因要拆开
Set 的编码阶梯(以 7.4.11 实测为准):全整数成员走 intset (条目数阈值 set-max-intset-entries=512);字符串成员走 listpack/hashtable(条目数阈值依 set-max-listpack-* 配置,本文以每轮 OBJECT ENCODING 实测为准)。21 轮数据:
| 操作 | intset(50 整数) | listpack(50 字符串) | hashtable(500 长串) | intset vs hashtable |
|---|---|---|---|---|
| SADD | 364K | 346K | 311K | +17% |
| SISMEMBER | 379K | 345K | 329K | +15% |
| SREM | 448K | 449K | 307K | +46% |
| SRANDMEMBER | 522K | 530K | 258K | +102% |
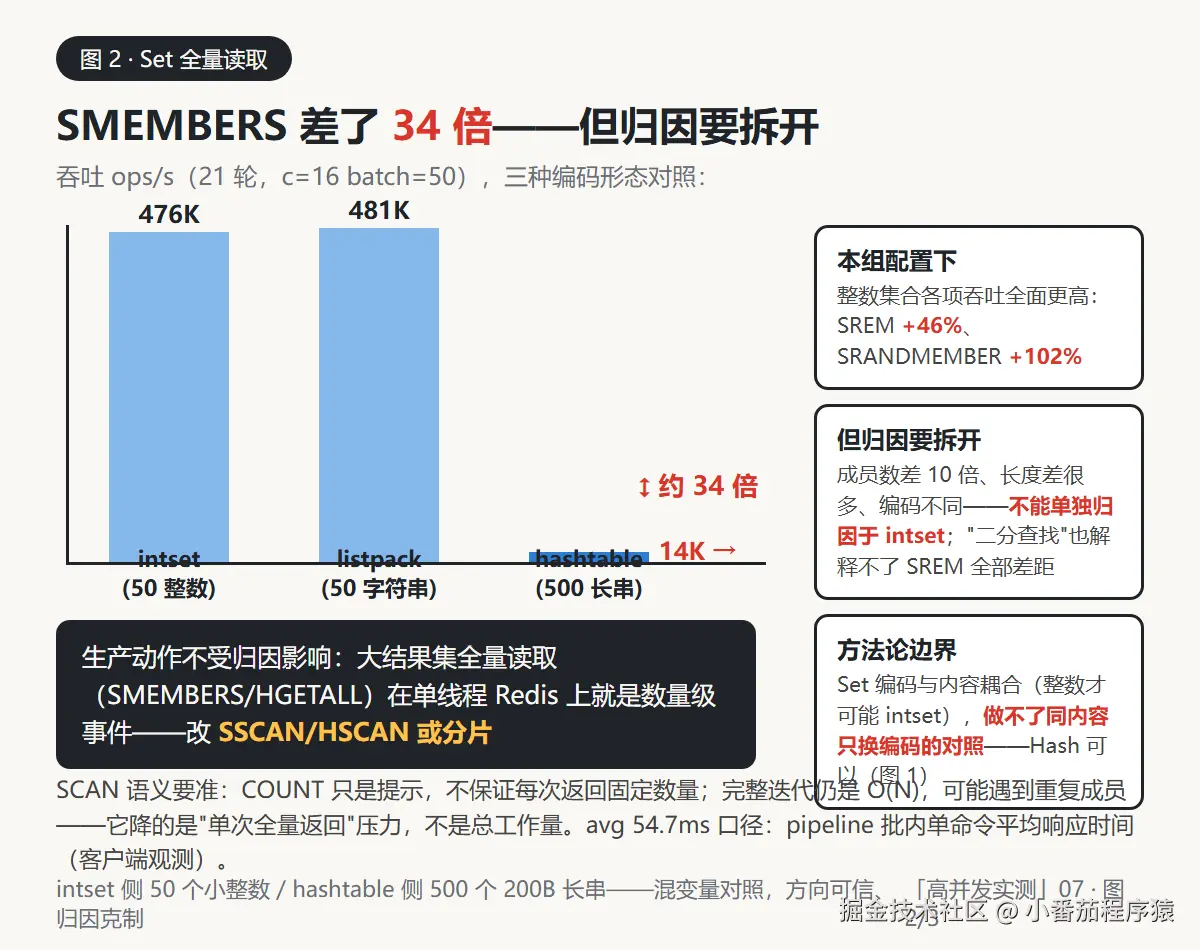
| SMEMBERS | 476K | 481K | 14K | 约 34 倍 |
先说这组数据的边界 :intset 侧是 50 个小整数,hashtable 侧是 500 个 200B 长串------成员数差 10 倍、成员长度和响应字节数也差很多,编码只是差异之一 。而且 Set 的编码与内容天然耦合(整数才可能 intset),无法做"同内容只换编码"的公平对照------这是 Set 编码测试的方法论边界,无法绕过。
所以结论只能这样下:在本次"小规模整数集合 vs 大规模长字符串集合"的配置下,整数集合各项吞吐全面更高 (SREM +46%、SRANDMEMBER +102%);由于成员数与内容不同,不能单独归因于 intset 编码("二分查找"也只能解释查询类操作,解释不了 SREM/SRANDMEMBER 的全部差距)。要严格比较编码,需要保持成员数、内容和负载相同、仅用配置触发编码------Set 做不到,Hash 可以(第三节)。
SMEMBERS 的 34 倍同理 :它是"成员数 × 成员长度 × 编码 × 响应量 × 客户端解码"的共同结果,不能单独归因于 hashtable 编码(原文"dict 遍历逐个 dictEntry 分配返回对象"是实现层推测,本文没有分配器或 Redis 端 profile 证据,已降级)。但生产动作不受归因影响 :无论差距来自哪几成,大结果集的全量读取(SMEMBERS/HGETALL)在单线程 Redis 上就是数量级事件(avg 54.7ms------口径:pipeline 批内单命令平均响应时间,客户端观测值;c=16 × batch=50 下在途约 800 条,不是单请求 RTT)------改 SSCAN/HSCAN,或按业务分片。
SSCAN/HSCAN 的语义要说准:COUNT 只是提示,不保证每次恰好返回固定数量;完整迭代仍是 O(N),迭代过程中可能遇到重复成员。它降低的是"单次全量返回"的压力,不是总工作量,更不是硬性时间上限。
五、ZSet:skiplist 快 11%------先说明这不是公平对照
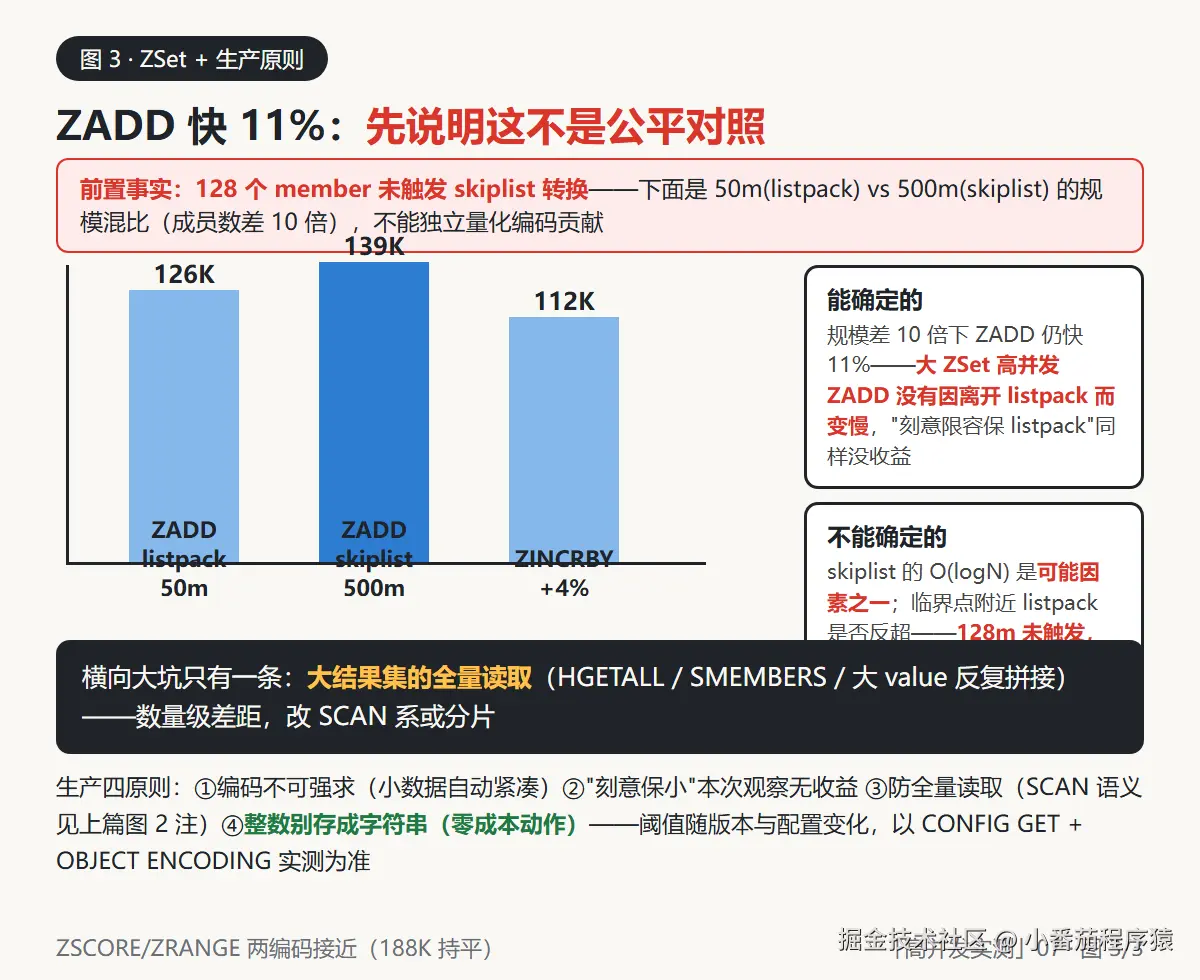
128 个 member 未触发 skiplist 转换 (本节最重要的前置事实),所以下面是"50m listpack vs 500m skiplist"的规模混比:
| 操作 | listpack(50m) | skiplist(500m) | 差距 |
|---|---|---|---|
| ZADD | 126K | 139K | skiplist +11% |
| ZSCORE | 300K | 299K | 接近 |
| ZRANGE | 188K | 188K | 接近 |
| ZINCRBY | 112K | 116K | skiplist +4% |
在规模差 10 倍的前提下,ZADD 仍快 11%------skiplist 的 O(logN) 定位是可能因素之一,但这组数据不能独立量化它的贡献 (member 数、内存布局同时在变)。能确定的只有:大 ZSet 的高并发 ZADD 没有因为"离开 listpack"而变慢 ------"刻意限容保 listpack"在 ZSet 上同样没有收益。临界点附近 listpack 是否反超(Hash 上观察到的现象)在 ZSet 上没测到(128m 未触发转换),不下结论。
六、横向共性:真正要防的是"全量读取"
| 维度 | String | Hash | ZSet | Set |
|---|---|---|---|---|
| 小数据最优 | embstr | listpack | listpack | intset/listpack |
| 临界点反超 | --- | hashtable +8.8%~+38%(本文公平对照) | 未触发,未测到 | 混变量,未单独归因 |
| 真正的大坑 | raw 反复拼接 | 大结果集 HGETALL | --- | 大结果集 SMEMBERS |
四条生产原则:
- 编码不可强求:小数据自动落进紧凑编码,是福利不是任务;
- "刻意保小"在本次观察中没有收益:临界点之后大编码反超(Hash 公平对照 +8.8%~+38%),且 7.4.11 的默认阈值已让"保 listpack"的适用范围比流传说法更窄;
- 真正要防的是大结果集全量读取(HGETALL/SMEMBERS/大 value 反复拼接)------数量级差距(本组约 34 倍),改 SSCAN/HSCAN(注意迭代语义)或分片;
- 整数别存成字符串:本次配置下整数集合全面更高------虽不能单独归因编码,但这个动作零成本。
七、局限(发前认账)
- 所有数据为单会话批次(每配置 5s 预热 + 10s 采样),绝对吞吐受客户端(Pipeline 打包/序列化)压低,只看相对差距,别与 redis-benchmark 对比
- 公平对照只在 Hash 上完成(count 触发 + 同值长 40B + 交错配对 5 轮);Set 因编码与内容耦合无法做同内容对照,ZSet 的 128m 未触发转换
- 共享宿主的会话级漂移显著(同配置前后两轮可差 4 倍),交错配对只消除方向性偏差,逐轮比值仍有 0.47~1.12 的波动
- 未测 jemalloc/libc 分配器差异与 lazyfree 配置;"dict 遍历逐条分配"为实现层推测,无 profile 证据
- 未测集群/分片形态(跨槽影响另见系列场景 7);分片的收益与代价(键数量、网络往返、内存)本文均未测,"分片"建议仅指大结果集拆分方向
- String 的 12 轮数据来自系列第 1 篇(juejin.cn/post/768117...),本文未重跑;44/128/512 阈值随版本与配置变化,以
CONFIG GET hash-max-listpack-*+OBJECT ENCODING实测为准
系列目录
| 篇 | 主题 | 链接 |
|---|---|---|
| 1 | Redis String 三种编码实测:juejin.cn/post/7681171487518097442 | juejin.cn/post/7681171487518097442 |
| 2 | 把最重的库改回同步,QPS 反而涨了 38%:juejin.cn/post/7683387359011110975 | juejin.cn/post/7683387359011110975 |
| 3 | Agent 工程化:可观测/舱壁/熔断:juejin.cn/post/7684615074136981544 | juejin.cn/post/7684615074136981544 |
| 4 | RAG 评测三层反转:juejin.cn/post/7694123609883869227 | juejin.cn/post/7694123609883869227 |
| 5 | AI Agent 落地全景:juejin.cn/post/7697500325121998848 | juejin.cn/post/7697500325121998848 |
| 6 | 线程池到底设多大?4 台机器实测:juejin.cn/post/7702914241569849379 | juejin.cn/post/7702914241569849379 |
| 7 | 本文:Redis 编码横向实测 |