一份能编译、能压测、能交接的规格,比一份读起来很爽的清单值钱。清单告诉你「应该做什么」,规格要回答五件事:上限是多少、由谁守、超了返回什么、代价是什么、怎么证伪。下面每一段都按这五问写,凡是答不上来的句子,一律不写。
这也是本文唯一的方法论。高并发的文章很容易写成「加强监控、做好限流、注意缓存」------每句都对,每句都无法执行;读者读完还是不知道自己那台机器该配 60 还是 600。规格的写法相反:先算出一个数,再把这个数钉进配置、钉进代码、钉进验收脚本,最后写清这个数在什么条件下失效。
一、先把目标写成可计算的数
SLO 不是 QPS,是尾延迟 + 爆炸半径。本站点取四个数:P99 ≤ 200 ms、P99.9 ≤ 250 ms、未受控错误率 < 0.1%、受控拒绝单列统计。
为什么不用平均值:平均值把「1% 的用户等了 1.2 s」摊平成「大家都等了 12 ms」,而真正决定用户是否流失的正是那 1%。为什么 P99 压在 200 ms 之内:入口预算就是 200 ms 的硬 deadline,尾巴必须落在预算里。为什么再加一条 P99.9 ≤ 250 ms:留 50 ms 给 GC 暂停、线程池调度与 NUMA 抖动;若 P99.9 长期顶到 250 ms,说明预算本身不够,而不是「偶发抖动」------这时该改预算或改容量,不该发一条「忽略抖动」的告示。
错误预算由此可算:30 天 = 2,592,000 s,三副本集群 3,000 RPS × 0.1% = 777.6 万个请求,换算成时间就是 43.2 分钟的全站停摆(单实例 1,000 RPS 对应 259.2 万次,同样是 43.2 分钟------比值不随规模变)。这个数的意义在于把「要不要发版」从争论变成算术:一次发布若预期吃掉 40 万请求的额度,一个月就只剩两次机会。错误预算也是唯一能约束「多加一个功能」的东西------功能不占预算,功能引入的故障占。
判据必须能被执行,否则等于没写。P99.9 在 k6 里的合法写法是 p(99.9),写成 p(999) 不会更严格,只会被当作未知阈值静默忽略;一个永远不会触发的阈值,和没写阈值是同一种状态。同理,「超限必返回 429」这种判据也不成立:deadline 排在限流之前时,等 permit 等到预算耗尽的请求会返回 504,实测 150 并发下 429 只占受控拒绝的约八成(90 / 114),剩下两成是 504。判据要按真实顺序写,而不是按愿望写。
四个数之间还要能互相对账,否则它们只是四个漂亮的数字。P99 与 deadline 对账:尾巴必须小于预算,否则所谓「200 ms 承诺」只是在描述一个不存在的世界。错误率与错误码对账:0.1% 的分母必须是「全部请求」,分子必须只含 500,把 429/503/504 算进去就等于把主动降级记成系统故障,团队于是不敢在洪峰时拒绝------这是最常见的口径腐败。容量与延迟对账:1,000 RPS 与 45 ms 是两个互相定义的数,改一个另一个必须重算,单独改就得到一组自相矛盾的配置。
最后是爆炸半径。1,000 RPS 是单实例 的设计容量,不是集群容量;三副本集群的目标是 3,000 RPS,压测时要把目标速率改掉并把 BASE_URL 指向负载均衡,否则会拿集群指标去优化单实例。限流键必须是全局单键还是按租户分区,决定了「一个坏客户能否拖垮全站」------示例用全局单键,因为它只是示例,生产必须换成按 API Key 或租户分区。
二、六道边界:一条请求要穿过六次判决
高并发不是「更快」,是在有限资源上决定谁先失败 。一条 POST /v1/orders 依次穿过六道边界,每道只回答一个问题:
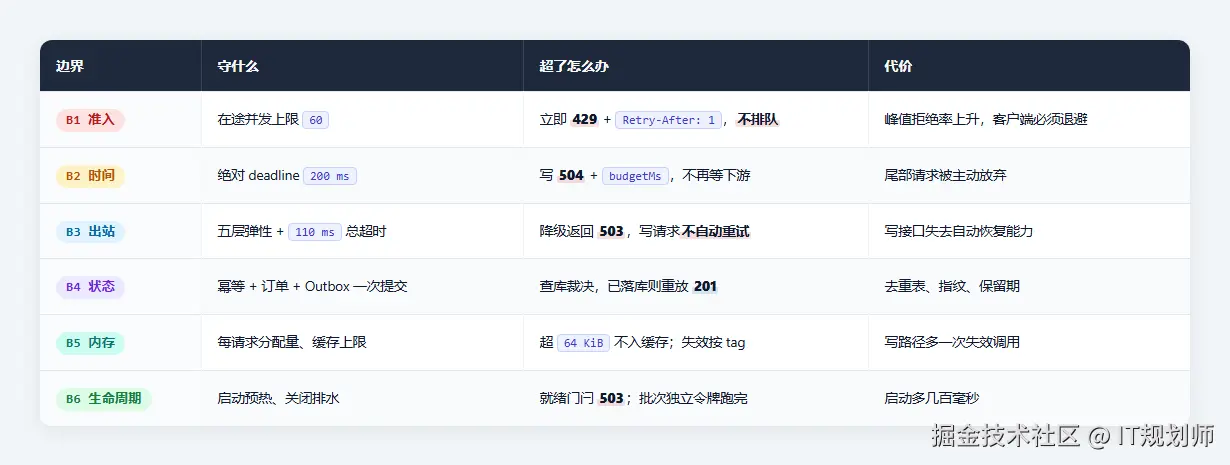
60 这个数不是拍的 。L = λW:目标 1,000 RPS,饱和态下每请求占用 45 ms,得 45 个在途;再加 15 个排队位吸收抖动,取 60。45 ms 的构成大致是:SQLite 单写者串行约 8 ms、下游查询平均 12 ms(上限 110 ms,但均值远低于上限)、序列化与校验约 6 ms、线程池与调度开销约 10 ms,其余为抖动。这不是精确测量,而是预算分摊------它的用途不是准确,而是让「某个环节变慢」时能立刻看出是哪一段吃掉了余量。
注意 45 ms 是饱和态 ,不是空载的 3--5 ms。空载时 L = λW 得 3--5 个在途,拿这组数据定上限,得到的是个位数并发,峰值一进来立刻 429;容量的分母永远是「你打算承受的那个 W」,代入哪个数就要对它负责。60 也不是「刚好够」:45 个在跑、15 个在等,排队位本身是设计的一部分,不是浪费。
QueueLimit = 0 是这套设计里最反直觉的一条:排队把「拒绝」转换成「等待」,而等待会拉长 W,W 又抬高 L,形成正反馈。超限时立刻 429 加 Retry-After,是把背压交还给调用方;客户端若不退避,会用自己的重试把 429 放大成雪崩------所以 429 的契约里,退避不是建议而是义务。
四对边界会互相抵消,必须逐对对账:
- B1 × B2:deadline 在限流之前,被拒请求也带预算语义,代价是本该 429 的变成 504;反过来则排队时间不受预算约束。两种都对,但判据只能按实际顺序写。
- B2 × B3 :预算递减必须严格------
200 > 150 > 110 > 40,且110 ≥ 2×40 + 10(一次重试 + 退避)。任一处倒挂,内层超时永远轮不到触发。 - B4 × B6 :投递产能
200 条 / 100 ms = 2,000 事件/s,必须 ≥ 写入速率 1,000/s,否则积压线性增长;批次与轮询频率任意一项被调小,都是定时炸弹。 - B4 × B5 :失效必须在提交成功之后,且用
CancellationToken.None;提前失效会引入脏读,用预算令牌会在超时后留下陈旧缓存。
每道边界都要有观测点,否则无法证明它真的生效:B1 看 rejected_by_concurrency 与 429 计数;B2 看 budget_exhausted 与 504 的 budgetMs;B3 看 downstream_unavailable、fallback_served 与重试率;B4 看幂等冲突/重放数与 Outbox 积压量;B5 看 cache_invalidated、命中率与分配速率;B6 看就绪时长与排水期丢单数。指标不是装饰,它是这六道边界的存在证明。
顺序也值得解释一遍,因为换顺序的代价往往比换参数更大。B1 在 B2 之前:先决定「要不要接这个请求」,再决定「给它多少时间」------反过来,被预算判死的请求还占着一个并发位,等于把拒绝成本付了两次。B2 在 B3 之前:入口的绝对时刻必须比出站更早到期,否则内层永远等不到。B4 与 B5/B6 的关系不是先后,而是「谁保证谁」:幂等保证重放不产生副作用,缓存失效与 Outbox 都依赖这个保证才能在提交后安全执行。六道边界不是六个独立功能,是一条有向依赖链,链上任一处顺序错了,整条链就会在下游表现为「偶发 500」这种最难查的现象。
判断边界是否真的生效,有个便宜的检验:删掉它,看断言是否变红 。把 B1 的并发限制调成无限,150 并发用例应当出现 500 或 499;把 B2 换成 HttpClient.Timeout 的 100 s 默认值,budget 用例应当从 504 变成长时间挂起。若删掉之后测试还是全绿,那条边界只是文档里的装饰。
三、落地:八个要点,每点都对应一段能编译的代码
1. 配置即断言。 有界量只有一个来源;启动时若组合矛盾,直接让服务起不来。这比在评审会上争论「200 ms 够不够」便宜得多,也比上线后半夜发现「Timeout 写成了默认 100 s」便宜得多。常见错法是「配置项写在 JSON 里,代码却用字面量」,于是改了配置毫无效果------判据是每个常量都能被 grep 到一处代码读取。
csharp
// ---- 0. 唯一的配置源:所有有界量从这一节读取,构建期一次、启动期校验 ----
var capacitySection = builder.Configuration.GetSection(CapacityOptions.Section);
var capacity = capacitySection.Get<CapacityOptions>() ?? new CapacityOptions();

builder.Services.AddOptions<CapacityOptions>()
    .Bind(capacitySection)
    .ValidateDataAnnotations()
    .Validate(o => o.RequestBudgetMs > o.OutboundLeaseMs,
        "入口 deadline 必须大于 HttpClient.Timeout")
    .Validate(o => o.OutboundLeaseMs > o.OutboundTotalMs,
        "HttpClient.Timeout 必须大于弹性管道总超时")
    .Validate(o => o.OutboundTotalMs > o.OutboundAttemptMs,
        "出站总超时必须大于单次尝试超时")
    .Validate(o => o.OutboundTotalMs >=
        (o.RetryMaxAttempts + 1) * o.OutboundAttemptMs + o.RetryMaxAttempts * o.RetryDelayMs,
        "出站总超时必须容纳所有尝试与退避")
    .Validate(o => o.CircuitBreakerSamplingSeconds * 1000 >= 2 * o.OutboundAttemptMs,
        "熔断采样窗口必须显著大于单次尝试超时")
    .Validate(o => o.L2CacheMinutes * 60 > o.L1CacheSeconds,
        "L1 必须短于 L2")
    .Validate(o => o.ShutdownDrainSeconds < 25,
        "排水窗口必须小于 HostOptions.ShutdownTimeout")
    .ValidateOnStart();
2. deadline 用绝对时刻,不用四个计时器。 计时器串联会把每层超时叠加成 400 ms;绝对时刻只认「还剩多少」。时钟必须单调:用墙钟算剩余预算,一次 NTP 回拨就能让预算凭空变长或变负,所以全程走 TimeProvider 的 GetTimestamp / GetElapsedTime。全请求只建一个租约,端点复用,避免 1,000 RPS 下每秒上千个定时器------那与「减少每请求分配」的目标直接冲突。
3. 超时判定按「谁取消」,不按「是否耗尽」。 这是本项目唯一一个真 bug:租约定时器按 Remaining(略小于 200 ms)建立,异常抛出到过滤器求值之间还有调度延迟,用 budget.IsExhausted 判定会与定时器赛跑,180 并发下约 1.4% 的预算取消逸出成 500------而 500 是唯一计入错误预算的 5xx,等于系统自己制造错误额度。修法是把判据绑定到「这个 token 是否真的被取消」,与时钟无关,也就没有赛跑窗口。
csharp
        // 判定依据必须是"这次取消由谁发出",不能是"此刻预算是否已耗尽":
        // 租约定时器按 Remaining(略小于 RequestBudgetMs)建立,异常抛出到过滤器求值
        // 之间还有线程池调度延迟,用 IsExhausted 判定会与定时器赛跑,
        // 一部分预算取消会逸出成 500(实测 180 并发下约 1--3%)。
        catch (OperationCanceledException) when (lease.Token.IsCancellationRequested)
        {
            // 客户端真断开:不写响应,交回 Kestrel(会得到 499),也不计入服务端错误
            if (context.RequestAborted.IsCancellationRequested) throw;
            if (!context.Response.HasStarted)
                await WriteBudgetExhaustedAsync(context, metrics);
}另一个易错点是不要覆盖 RequestAborted 。把预算令牌写回 RequestAborted,Kestrel 会把「服务端主动放弃」当成「客户端断开」,于是你承诺的 504 变成 499,契约当场失效。做法是把令牌放进 HttpContext.Items 下传,端点用 context.GetBudgetToken() 取。
4. 出站弹性五层全部显式赋值。 平台默认是 30 s 总超时、10 s 单次、3 次重试且基础退避 2 s、熔断采样 30 s、限流 1,000 permits------放进 200 ms 预算里,效果不是容错,是把一次下游抖动放大成全站排队。本项目改成 110 ms 总超时、40 ms 单次、1 次重试、10 ms 起指数退避加抖动、熔断采样 10 s,并关掉不安全方法的重试:默认连 POST 都重试,而一次重试就是第二笔订单。
即使取值与平台默认相同(如限流 1,000),也要显式写出。因为「默认值没改」这件事本身不可审计:升级包之后默认值可能变,而代码里看不出你依赖过它。
5. 幂等靠数据库唯一约束,不靠 Exists()。 先查再插是典型 TOCTOU。正确做法是直接插入,用主键冲突做唯一裁判:新增返回 201 + Location,重放返回同一条响应。要点是只把唯一约束冲突当成并发同键(SQLite 19 / Postgres 23505 / SQL Server 2627),其他数据库故障必须冒泡,否则会把连接中断误判成「已下单」。
csharp
        // 两种「结果未知」:唯一约束冲突(并发同键)与提交/取消赛跑(预算恰好耗尽)。
        // 两者都用「查一次已落库的事实」裁决,而不是假设失败。
        // 判据同样不按 budget.IsExhausted(会与租约定时器赛跑),而按 token 是否真的被取消。
        catch (Exception ex) when (IsConcurrentDuplicate(ex) ||
            (ex is OperationCanceledException && token.IsCancellationRequested))
        {
            // 只把唯一约束冲突当成并发同键:示例按 SQLite 19 过滤,
            // 生产改用 Postgres 23505 / SQL Server 2627;其他 DbUpdateException 必须冒泡。
            db.ChangeTracker.Clear();
            var existing = await db.Idempotency.AsNoTracking()
                .FirstOrDefaultAsync(x => x.Key == key, CancellationToken.None);
还有一个常被忽略的设计收益:用 UUID v7 在写库之前 生成订单 ID,响应 JSON、幂等记录、订单、Outbox 就能一次 SaveChanges 原子落库,于是「插入 InProgress → 提交业务 → 回写结果」这条中间态链路整条消失。消除的不是几行代码,是一整类「卡住的中间态」故障,以及配套的补偿状态机。代价是 ID 暴露毫秒级时间戳:订单号可接受,邀请码之类不可接受。
指纹要按规范化后的请求体计算。直接序列化原始 JSON,字段顺序或空白差异会让同一业务请求算出不同指纹,重放被误判成冲突。冲突返回 409 而不是 400,因为「键已用于不同请求体」是业务语义,不是格式错误。
6. 缓存只有一层时要说清楚。 HybridCache 的单飞只在实例内 成立,3 副本部署时热点 key 过期会各自回源一次。主缓存是默认 MemoryCache 时,注册 AddDistributedMemoryCache() 也不会被当作二级缓存------两层缓存必须有一层在进程外(Redis)才成立。示例只有 L1(20 s),L2CacheMinutes 保留,是为了换成 Redis 后它就是 L2 TTL,「L1 必须短于 L2」这条断言也能在换环境前被机器拦住。
写路径一律在提交成功后按 tag 失效。只打 tag 不失效,读到的永远是 TTL 内的旧值;提前失效则可能因为事务回滚而留下脏读。缓存还要设载荷上限(示例 64 KiB):超限条目不进缓存,这是 B1 在内存维度的同构物------不加,一个返回巨大对象图的接口就能把 L1 撑爆。负结果也会被缓存,若引入可预测 ID,必须给负结果更短的 TTL。
7. Outbox 保证本地原子 + 至少一次。 事件与业务同事务落库,消除「库写了消息没发」;投递器崩溃会重复发送,所以消费端必须幂等。排序用可排序的时间戳而不是 Guid:uniqueidentifier 在关系型库里的比较顺序与 .NET Guid.CompareTo 不同,OrderBy(Id) 看起来是时间序,实际不是。3 副本部署时取批要换成原子认领(SKIP LOCKED / UPDLOCK, READPAST / 租约字段 + 受影响行数检查),否则三个副本会抢同一批消息。
批次与轮询频率要一起算:单批 200 条、100 ms 一轮等于 2,000 事件/s,是写入速率的两倍余量。只调其中一个(比如把批次改成 100 而轮询不动)就把产能砍半,积压会在几十分钟后变成「消息延迟 1 小时」这种没人能解释的现象。
8. 冷启动要付在接流量之前。 200 ms 预算下,第一批请求会被自己的 deadline 杀掉:System.Text.Json 元数据、EF 模型、端点绑定、验证器、弹性管道的首次 JIT 加起来 220--290 ms。做法是「构建 → 静态预热 → 监听 → 内部探针 → 置就绪 → 导流」,/health/ready 在预热期返回 503,LB 因此不会把流量导到还在付冷启动成本的实例。
探针要选无副作用路径(非法 body → 400、不存在的 id → 404、OpenAPI → 200),最后再用一条成功路径触发 SaveChanges 与缓存失效的 JIT------它会留下一条固定键的示例订单,生产应改用只读探针端点。内部 HttpClient 必须 UseProxy = false,否则在配了 HTTP_PROXY 的环境里,预热请求会打到代理而不是自己。实测首请求从 220--290 ms 降到 27--48 ms,后续 3--5 ms。
最后是错误码,它是这套设计唯一对外可见的部分:201 成功、400 请求不合法、409 业务冲突、429 我们主动拒绝、503 依赖不可用、504 我们放弃等待、500 内部故障。取消域(OperationCanceledException)永远不落 500 ,否则预算取消会被算进错误预算;客户端真断开时不写响应,交回 Kestrel 记 499。对外只回 traceId,绝不回异常消息与连接串;日志用消息模板而不是字符串插值,否则结构化字段丢失、无法按 traceId 聚合。
四、验收:让整份规格可以被证伪
测量分三层,各回答不同问题:微基准 (BenchmarkDotNet)回答「两段代码差多少纳秒、分配差多少字节」;功能验收 (HTTP 断言脚本)回答「每条契约分支是否真的产生了约定结果」;负载压测(k6 / NBomber + 故障注入)回答「饱和点在哪、故障怎么传播」。混用这三层是最常见的自欺:拿微基准的 40 ns 收益去宣布线上更快,或只用一次健康下游的平均吞吐去宣布容量达标。
功能层用零依赖脚本跑五个场景,共 24 条断言,全部可一条命令复现:
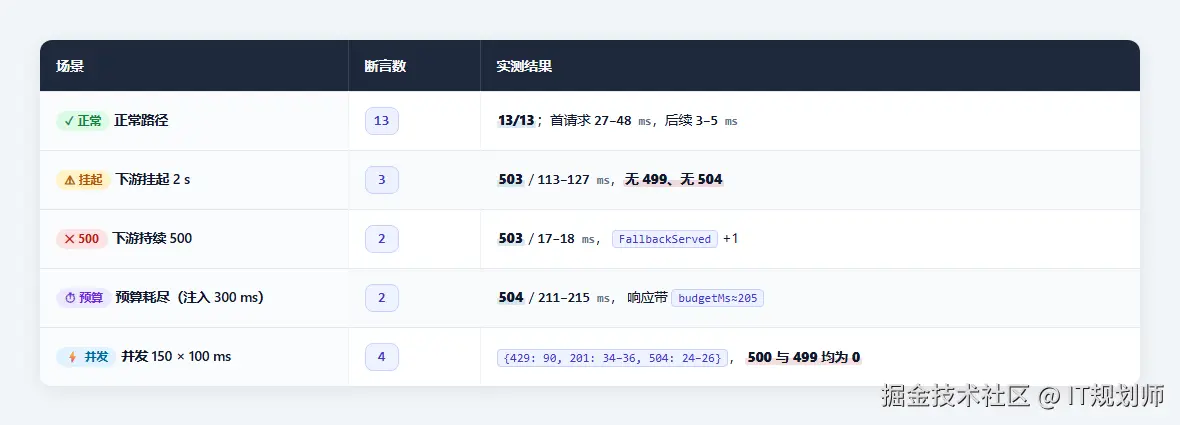
第五行是新增的:串行断言永远碰不到 60 的并发上限,所以「B1 到底生不生效」原本是一道不可证伪的边界------文中写着 429,脚本里却没有一条 429 断言。补了 150 线程 + Barrier 的并发用例后,429 才第一次被观测到。另一条并发用例反过来证明了 R0 级 bug 的修复:两轮各 180 并发加 300 ms 注入,Status=500 计数都是 0,而修复前每轮有 4--5 次。
压测不能只测健康流量。k6 用 ramping-arrival-rate 表达 RPS(把 VU 当 RPS 是最常见的误用),稳定期跑到 1,000 RPS 观察 P99 是否随时间漂移,过载阶段再拉到 1,500 观察 429 是否受控。阈值只对 201 的耗时生效:把 429/503/504 也算进「预期响应」,受控拒绝的耗时会把 P99 稀释成一个没有物理含义的混合数。两个自定义 Trend 分开记成功与拒绝,http_req_failed 在过载阶段会接近 1------那是设计如此,不要拿它当报警。
断言本身也有写法。一条好断言必须能红过一次:从没红过的断言,无法区分「契约被守住了」与「断言根本没跑」。本次改造中有三条断言原本恒绿------它们只检查 200 响应体里的字段,而故障场景返回 503,字段自然不存在,循环一次都没进。修法是断言 503 状态下「响应体不含内部字符串」这种否定式条件,并在日志里打印实际状态码。同理,断言里不要写「等待 5 s 后成功」这种宽松上限:宽松上限会把「第 4,900 ms 才成功」也算通过,而预算契约早已破产。
还有一个更隐蔽的问题:断言不该依赖运行顺序。五个场景共用一个数据库文件时,前一个场景留下的订单会让后一个场景的「冲突数为 0」偶然成立。做法是每个场景用独立 dbPath(或用 --reset 重置),让断言只读自己造的数据。
测不出来的必须写清楚测不出来 :本机没有 k6,arrival-rate 压测未跑,所以饱和态 W = 45 ms 仍是设计假设,签 SLO 前必须用压测回填;多副本 Redis 的缓存一致性与 SIGTERM 排水需要编排环境;FakeTimeProvider 的时钟注入单测尚未补。这三条写在验收章里,而不是藏在脚注------验收章的价值不在于列了多少绿勾,而在于诚实地列出还有多少格是灰的。
五、代价与推翻条件
每条决策都写清「什么条件下我错了」,这比写清「为什么对」更能约束后来者:
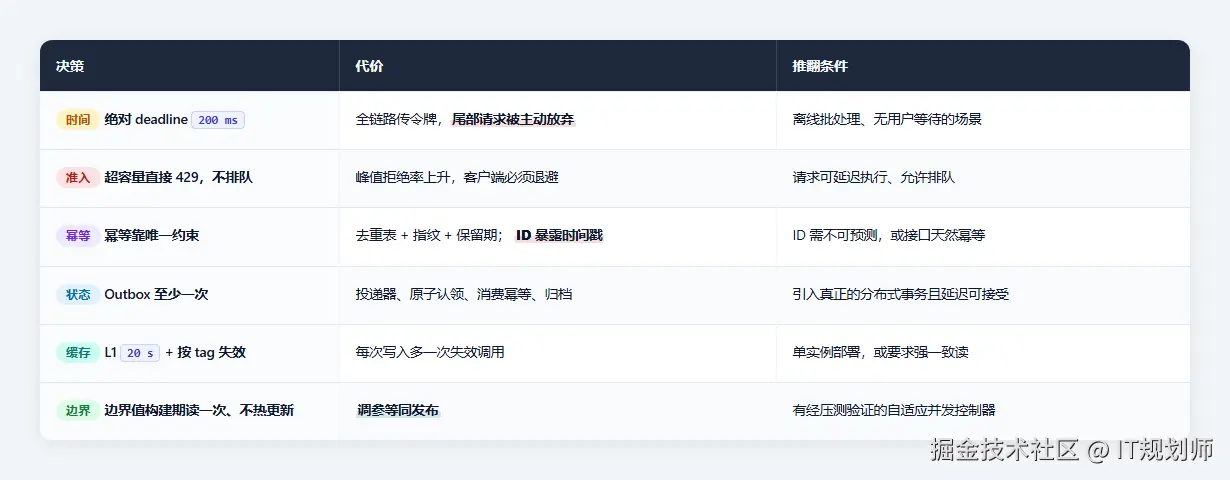
还有三类边界必须承认:
- 平台默认值会变,而默认值不可审计 。OpenAPI 3.1 在 .NET 10 已经是默认(.NET 11 起默认 3.2),把它写成「需要显式开启的特性」是说反了方向;
AddValidation()只校验已绑定参数,不拒绝请求体里的未映射字段,需要「未知字段即拒绝」就得自己开。凡「平台优化了什么」与「平台定义了什么」混着写的地方,都是未来的错误源。 - 弹性不是越健壮越好。200 ms 预算里塞进 2 s 退避,等于把一次下游抖动放大成一次全站排队;默认的 30 s 总超时更是直接把 SLO 击穿。
- 单实例语义不能直接平移 。限流是全局单键的,任何人打满 60 并发就能让全站 429;缓存单飞不跨实例;Outbox 取批靠轮询。上生产前必须替换:SQLite → Postgres / SQL Server(约束错误码 19 → 23505 / 2627)、L1 → Redis、mock 下游 → 真实
SocketsHttpHandler、Console Exporter → OTLP、启动删库 → 迁移 + 鉴权。
这套方法的适用边界也要说清:它适合「有明确 SLO、请求可被拒绝、下游可降级」的在线服务。对必须全部成功的批处理、对延迟不敏感的离线任务,硬 deadline 与 429 都是负资产------拒绝一个可以慢慢做的任务,只会把问题推给上游重试。
版本本身也是约束。.NET 8 与 .NET 9 同在 2026-11-10 终止支持(STS 的 24 个月标准期,没有「延长」这回事),.NET 10 是 2025-11-11 起的 LTS、支持到 2028-11-14。这个日期不是背景知识,而是配置的一部分:升级窗口一旦落在 EOL 之后,安全补丁停发,SLO 里的「未受控错误率」就失去了分母之外的另一半含义。锁定运行时与包版本、并在升级前后保留 P99 与分配速率基线,属于与 deadline 同级的架构约束,不是运维细节。
附录 A:十个关键常量
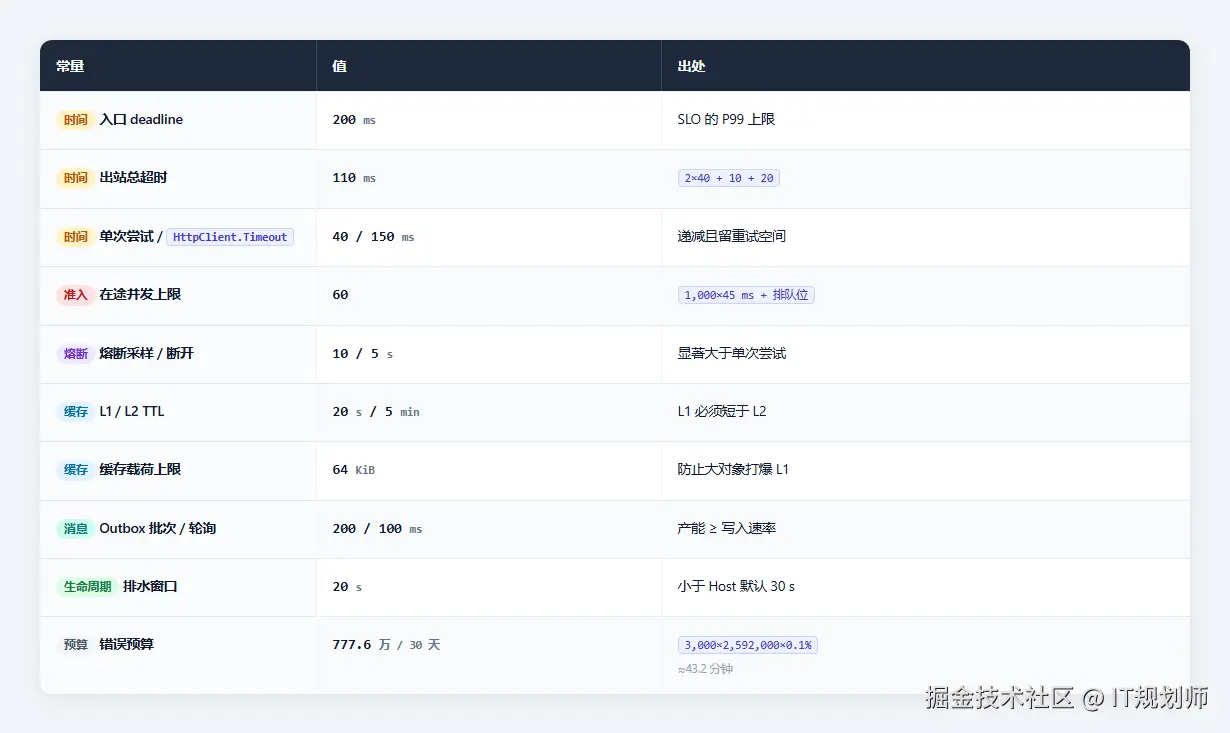
附录 B:上线前十二条自检
- SLO 表把「未受控错误」与「受控拒绝」分两列,阈值、回滚、压测三处口径一致。
- 每个常量都能被
grep到一处代码读取,没有硬编码字面量。 ValidateOnStart覆盖预算倒挂:200 > 150 > 110 > 40且110 ≥ 2×40 + 10。- 五层弹性全部显式赋值,写请求的自动重试已关闭。
- 幂等靠数据库唯一约束,提供程序有真实事务(不是 InMemory)。
- 重放返回 201 +
Location,与首次响应一致;「已提交但响应丢失」有查库兜底。 - deadline 只用单调时钟,不覆盖
Context.RequestAborted,全请求只有一个租约。 - 取消域不落 500;500 有独立计数器;对外只回
traceId。 - 缓存失效在提交之后,且用
CancellationToken.None;没有把同进程分布式缓存当 L2。 - Outbox 与业务同事务,排序用时间戳,批次 × 轮询频率 ≥ 写入速率。
/health/ready在预热期为 503,内部探针禁用系统代理。- 代码注释写在被注释行的上一行,且代码块与工程逐字一致。
配套工程 (NET10_订单服务参考实现_v3.1.zip)