把整页 HTML 丢进模型,token 往往先被导航、脚本和样式吃掉一截,真正要总结的正文反而被冲淡。2026-11-11(北京时间)我用 SandBase 目录里的 Firecrawl 单页接口,抓了官方文档页 Firecrawl Scrape,拿到 454,158 字符 的 Markdown,再写进兼容 E2B 的沙箱跑了一段抽取脚本。这次单页调用的结算成本是 USD 0.000000 :目录原价每次 USD 0.0075 ,被记成 100% 的 free_quota 折扣;沙箱的创建、运行和停止,按当天定价页和产品 FAQ,目前不碰余额。若一上来就整站 crawl,模型卡写明是首 call 即计费,而且按页算------那是另一条账。
下面按当天公开定价页、模型卡,以及这一次真实请求来跟做。数字都以当天页面和结算记录为准,不把抄来的表当成永久价目。
1. 为什么先转 Markdown,而不是把 HTML 直接塞进模型
我做过几次「把网页丢给模型做摘要」的失败实验,卡住的地方几乎一样:
- 原始 HTML 里有导航、页脚、样式和脚本。模型要先在噪音里找正文,上下文窗口被占掉,摘要还容易把侧栏链接当成要点。
- 自己写解析器,每个站点一套选择器,文档站一改主题就失效。
- 页面是前端渲染的,
curl直接拉到的常常是空壳,还得自己挂无头浏览器。
所以这条路径被拆成两步更清楚:先把已知的公开页面收成带元数据的 Markdown,再在隔离环境里做抽取或总结。 前一步解决「正文从哪来、源地址和状态码是什么」;后一步解决「这段文本怎么清洗、标题怎么列、要不要再交给模型」。两步不要混在一次随便拼出来的提示词里。
2. 先看目录,再决定调哪条 Firecrawl 端点
SandBase 的 Firecrawl 目录当天能看到五条能力:单页 Scrape、URL Discovery(map)、Web Search、整站 Crawl、Batch Scrape。我这次只要已经知道的一页公开文档 ,所以走同步的 firecrawl/scrape。不必另开 Firecrawl 开发者账号,一把 SandBase API Key 就能调。搜目录、读 schema 和价格,定价页写明不计费;调用成不成功,再看 Activities 或任务成本。
当天(2026-11-11,北京时间)我核对过的口径如下。金额按目录或模型卡原文写 USD,不用美元符号。
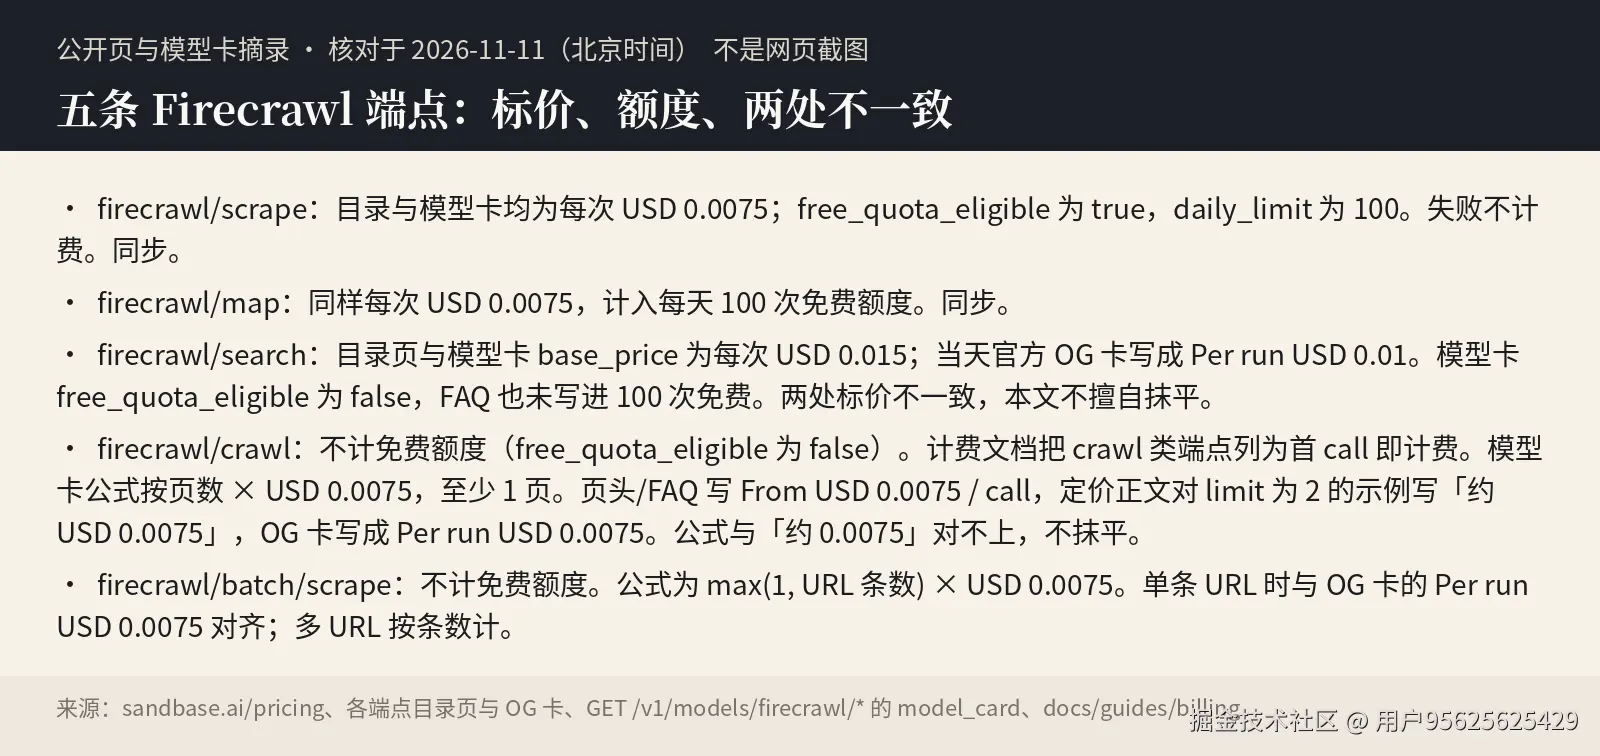
| 端点 | 模式 | 当天标价 | 是否计入每天 100 次免费 | 计费方式 |
|---|---|---|---|---|
firecrawl/scrape |
同步 | 目录、模型卡与 OG 卡均为每次 USD 0.0075 | 计入。模型卡 free_quota_eligible 为 true,free_quota_daily_limit 为 100;目录页也写了「First 100 calls per day free」 |
成功按次;失败不计费,目录页写明目标不存在也不计费 |
firecrawl/map |
同步 | 每次 USD 0.0075 | 计入,口径与 scrape 相同 | 按次 |
firecrawl/search |
同步 | 目录页与模型卡 base_price 为每次 USD 0.015 ;当天官方 OG 卡写成 Per run USD 0.01 |
不计。模型卡 free_quota_eligible 为 false,FAQ 也未写进这 100 次 |
两处标价不一致,本文不擅自抹平;对账以结算记录为准 |
firecrawl/crawl |
异步 | 页头 / FAQ 写 From USD 0.0075 / call;定价正文对 limit 为 2 的示例写「约 USD 0.0075」;OG 卡写成 Per run USD 0.0075 |
不计。模型卡 free_quota_eligible 为 false。计费文档把 crawl 类端点列为首 call 即计费 |
模型卡公式是 max(1, max(completed, 返回条数)) × 0.0075,也就是按页、至少 1 页。公式与「约 0.0075」对不上,不抹平 |
firecrawl/batch/scrape |
异步 | 页头写 From USD 0.0075 / call;OG 卡写成 Per run USD 0.0075 | 不计(free_quota_eligible 为 false) |
模型卡公式是 max(1, URL 条数) × 0.0075。单条 URL 时与 0.0075 对齐,多 URL 按条数计 |
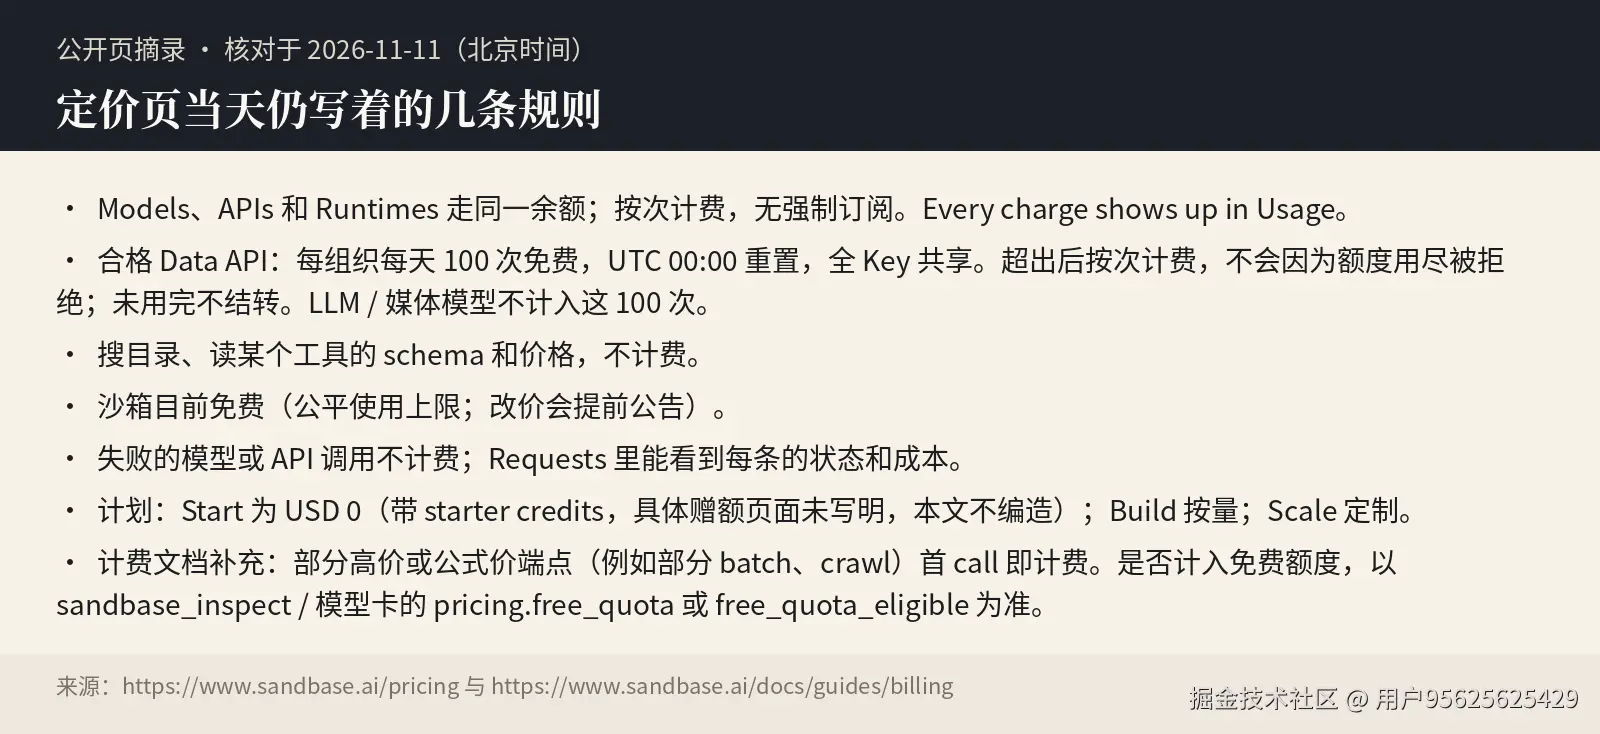
合格 Data API 的免费额度是按组织共享 的,每天 100 次,UTC 00:00 重置,组织下全部 Key 一起算;不是每个端点各 100 次。超出后按次计费,不会因为额度用尽被拒绝,未用完也不结转。LLM 和媒体模型不计入这 100 次。计费文档还写了一条总原则:部分高价或公式价端点(例如部分 batch、crawl)从第一次调用就开始计费,是否合格要看 pricing.free_quota(模型卡上是 free_quota_eligible)。
选型一句话:已经有公开 HTTPS 地址、只要这一页的 Markdown,用 scrape;要先列出站点上还有哪些链接,用 map;关键词还没指向具体页,才用 search(且当天它更贵,也不在免费额度里);只有明确要整站或一批已知 URL 时,再上 crawl 或 batch,并且按公式把页数乘进去。
3. 跟做一:单页 scrape,看真实返回字段
目标页我选了 Firecrawl 自己的英文文档 Scrape,避免把国内社交应用当案例。这是一页公开文档,不要求登录。
当天模型卡里的输入 schema 只接受三个字段:
url(必填):要抓的 HTTPS 地址proxy(必填):枚举里只有basic,默认也是basicformats(可选):枚举里只列出了markdown
目录 README 另外写过:若在 formats 里请求,还可能返回 data.html / data.links / data.screenshot。这和当天 schema 枚举不一致。我没有按官方 Firecrawl 文档去传 html、json、branding 这些供应商侧选项,只传了 schema 明确允许的值。Markdown 在 README 里是默认输出,即使省略 formats 按文档也会给 Markdown;我这次显式写了 "formats": ["markdown"]。
请求很短:
bash
export SANDBASE_API_KEY='你的密钥'

curl -sS -X POST "https://api.sandbase.ai/v1/api/firecrawl/scrape" \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://docs.firecrawl.dev/features/scrape",
    "proxy": "basic",
    "formats": ["markdown"]
  }'
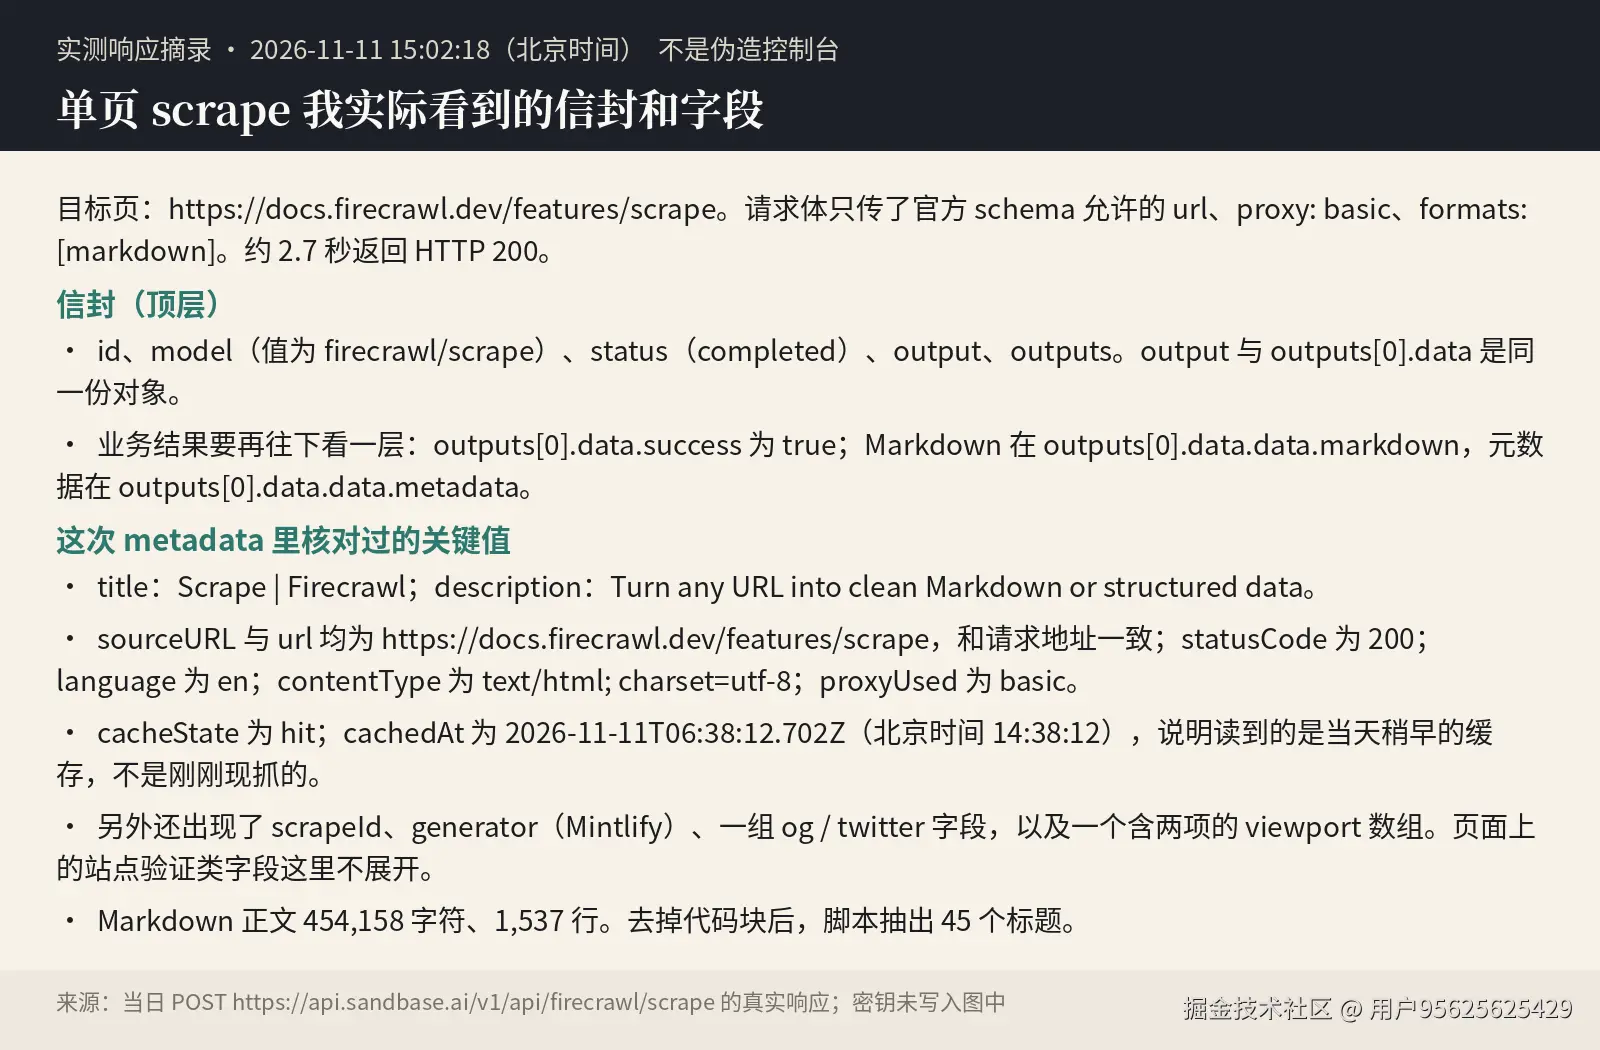
我在 2026-11-11 **15:02:18(北京时间)**发出这次请求,HTTP 200 ,耗时约 2.7 秒 。响应头里有 x-task-id,值和信封里的 id 相同:c88a3450-dd7d-4c38-883c-96274fa428cb。
3.1 先分清信封和业务载荷
顶层我实际看到的键只有五个:id、model(值为 firecrawl/scrape)、status(值为 completed)、output、outputs。其中 output 和 outputs[0].data 是同一份对象。
业务结果还要再往下看一层。路径是:
text
outputs[0].data.success          → true
outputs[0].data.data.markdown    → 页面正文(Markdown 字符串)
outputs[0].data.data.metadata    → 源页面元数据
两个 data 分属不同容器:外面一层是 SandBase 的输出槽,里面一层才是 Firecrawl 的业务载荷。不要在 outputs[0].data.markdown 这个位置空等字段。文档示例里展示的 success / data 根结构,对应的是里面那一层,不是完整信封。
3.2 这次 metadata 里真正出现的字段
下面只记我当天在响应里看到、并且核对过取值的字段,不把 README 表格未曾出现的值补进去。
| 字段 | 这次的值 | 我用来确认什么 |
|---|---|---|
title |
`Scrape | Firecrawl` |
description |
Turn any URL into clean Markdown or structured data |
文档站自己的一句话说明 |
language |
en |
语言代码 |
sourceURL |
https://docs.firecrawl.dev/features/scrape |
源地址;要和请求里的 url 分开存,遇到跳转时它们可能不同。这次两者一致 |
url |
与 sourceURL 相同 |
响应里另给的页面地址 |
statusCode |
200 |
页面的 HTTP 状态,不是外层 API 的 200。先看信封成功,再看这个字段 |
contentType |
text/html; charset=utf-8 |
源页面类型 |
proxyUsed |
basic |
实际用的代理档,与请求一致 |
cacheState / cachedAt |
hit / 2026-11-11T06:38:12.702Z(北京时间 14:38:12) |
这是缓存命中,内容来自当天稍早的副本,不是 15:02 刚刚现抓的 |
scrapeId |
01a1c96a-1b47-7401-a139-4b1c8cad1cfc |
这一页抽取的供应商侧 ID |
generator |
Mintlify |
文档站生成器 |
此外还出现了一组 og:* / ogTitle 这类开图字段、twitter:* 字段,以及一个含两项的 viewport 数组。站点验证类字段我见到了,但不在文章里展开。concurrencyLimited 这次为 false。
不要只看外层 HTTP 200 就认定「页面可用」。可靠的顺序是:HTTP 成功,且 status 为 completed,且业务 success 为 true,且 metadata.statusCode 落在你自己接受的 2xx,且 markdown 不是空字符串。缓存命中只说明速度快,不证明内容是此刻最新的;需要更「新」时,当天的 SandBase schema 并没有列出官方 Firecrawl 文档里的 maxAge 一类参数,就不要从供应商文档里抄过来碰运气。
3.3 Markdown 长什么样
这次 data.markdown 长 454,158 字符、1,537 行。开头并不是一个干净的一级标题,而是文档站自己的索引提示,然后才进入正文。下面这段是原文开头的摘录,不是控制台截图:
markdown
> ## Documentation Index
>
> Fetch the complete documentation index at: [/llms.txt](https://docs.firecrawl.dev/llms.txt)
>
> Use this file to discover all available pages before exploring further.

[Skip to main content](https://docs.firecrawl.dev/features/scrape#content-area)

Scrape turns any URL into clean Markdown or structured data for AI agents,
including JS-heavy pages and dynamic apps.

- It manages complexities: proxies, caching, rate limits, js-blocked content
- Handles dynamic content: dynamic websites, js-rendered sites, PDFs, images
- Outputs clean markdown, structured data, screenshots or html.
标题在 metadata.title 里是 Scrape | Firecrawl,但正文开头没有对应的 # Scrape。后面大量代码示例里还有 # pip install firecrawl 这种注释,如果按「行首是 #」去抽标题,会把注释也算进去。这正是下一步要进沙箱、而不是把整段 Markdown 原样灌给模型的原因:先清洗,再总结。
4. 跟做二:把 Markdown 丢进沙箱做抽取
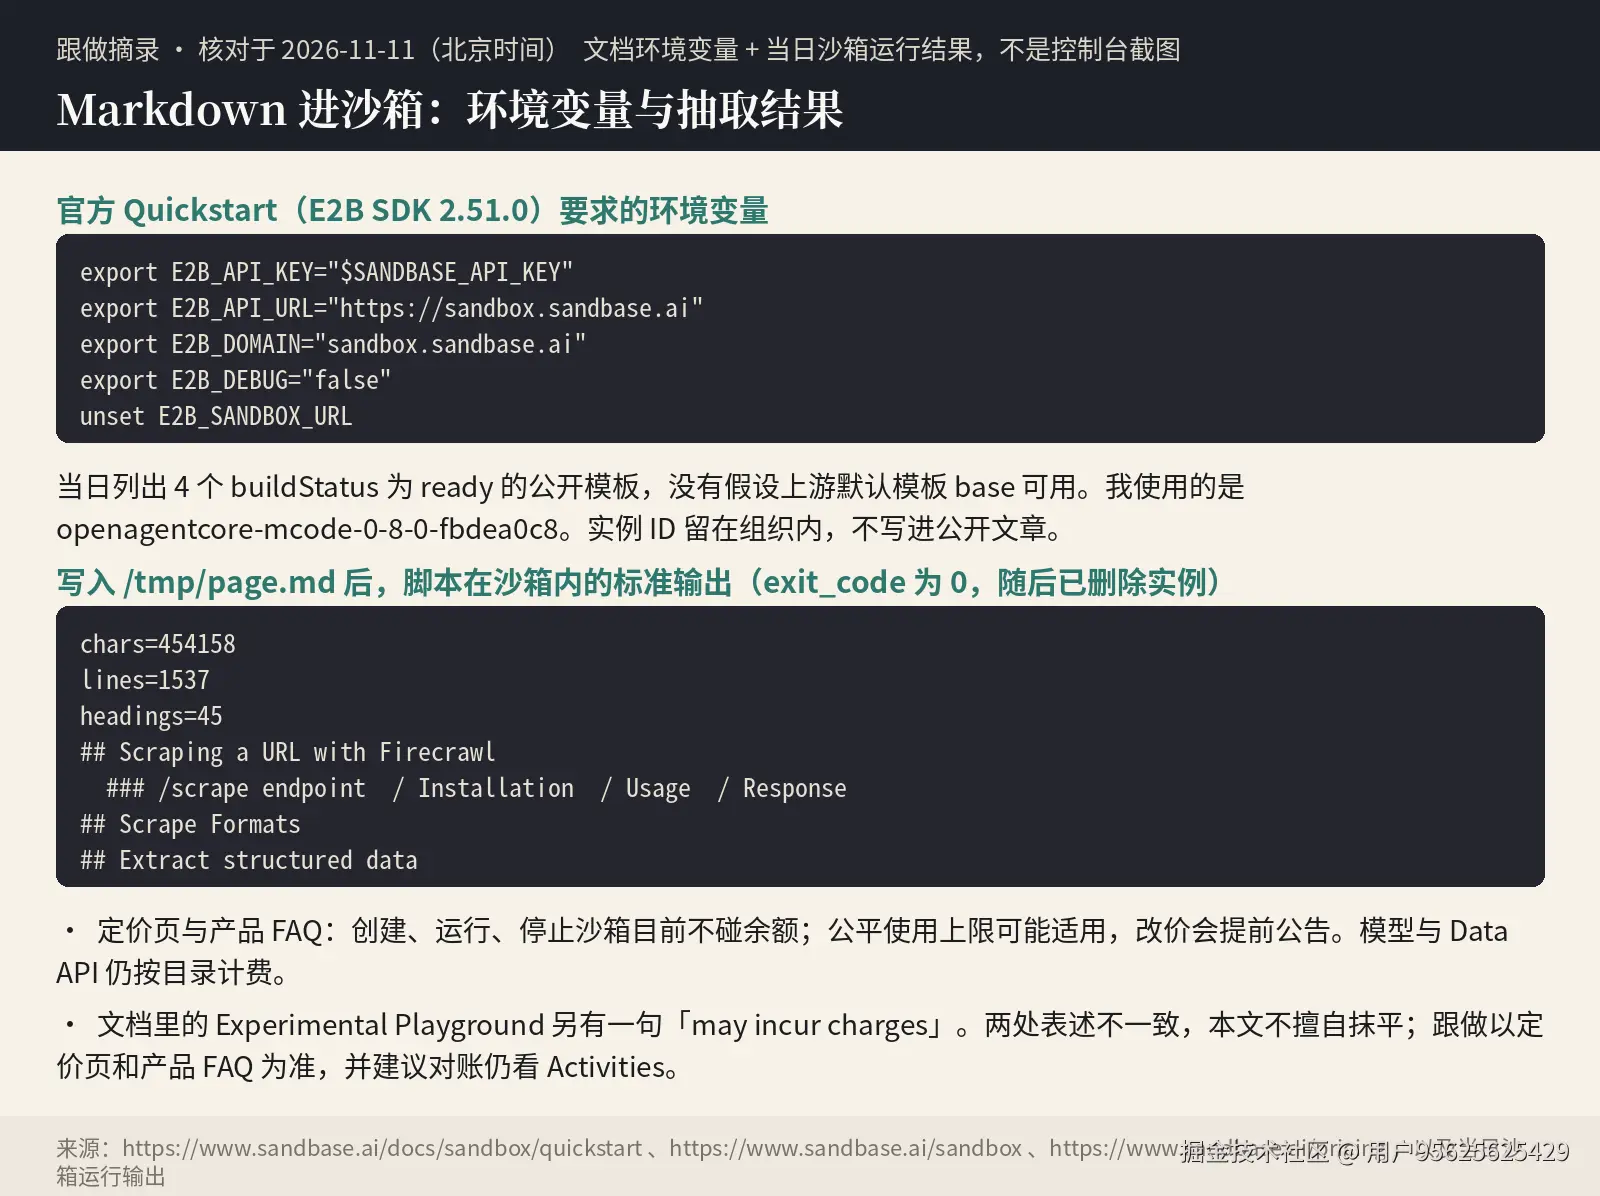
模型可以直接读这段 Markdown,但 45 万字符远远超出大多数摘要任务的需要。我更想先在隔离环境里跑一段短脚本:去掉代码块,抽出标题,再取正文前几段。SandBase 的沙箱是 E2B 兼容网关,端点是 https://sandbox.sandbase.ai,官方文档针对的是 E2B JavaScript / Python SDK 2.51.0,用的还是同一把 SandBase Key。
定价页和产品 FAQ 当天的原话是:创建、运行、停止沙箱目前不碰余额;公平使用上限可能适用,改价会提前公告。模型或 Data API 若在沙箱任务里被调用,仍按目录计费。需要记下的分歧是:文档里的 Experimental Playground 另有一句 "Operations connect to sandbox.sandbase.ai and may incur charges." 两处表述不一致,我不擅自抹平;跟做以定价页和产品 FAQ 为准,对账仍看 Activities。
环境变量按 Sandbox quickstart 来,两个地址都要设。只设 E2B_DOMAIN 时,SDK 2.51.0 会自己拼出一个带 api. 前缀的主机,容易打错地方。E2B_SANDBOX_URL 不要设成控制面地址,调试开关保持关闭:
bash
python -m pip install 'e2b==2.51.0'

export E2B_API_KEY="$SANDBASE_API_KEY"
export E2B_API_URL="https://sandbox.sandbase.ai"
export E2B_DOMAIN="sandbox.sandbase.ai"
export E2B_DEBUG="false"
unset E2B_SANDBOX_URL
模板不要假设上游默认的 base 一定存在。我用这把 Key 调用了文档给出的列表接口:
bash
curl --fail --silent --show-error \
  'https://sandbox.sandbase.ai/v2/templates?limit=100' \
  -H "X-API-Key: $E2B_API_KEY"
当天看到 4 个 buildStatus 为 ready 的公开模板。我选了 openagentcore-mcode-0-8-0-fbdea0c8(把返回里的 templateID 赋给下面的变量)。实例 ID 留在组织内,不写进公开文章。
抽取脚本很短,只做三件事:去掉围栏代码块,清洗 Mintlify 标题前的锚点链接,再打印标题和正文节选。
python
# summarize_md.py
import re, sys
from pathlib import Path

def strip_fences(text: str) -> str:
    return re.sub(r"```.*?```", "", text, flags=re.S)

def headings(text: str):
    out = []
    for line in strip_fences(text).splitlines():
        m = re.match(r"^(#{1,6})\s+(.*)$", line.strip())
        if not m:
            continue
        raw = re.sub(r"^\[.*?\]\([^)]*\)\s*", "", m.group(2)).replace("\\", "").strip()
        if raw:
            out.append((len(m.group(1)), raw))
    return out

path = Path(sys.argv[1])
text = path.read_text(encoding="utf-8")
hs = headings(text)
print(f"chars={len(text)}")
print(f"lines={text.count(chr(10))+1}")
print(f"headings={len(hs)}")
print("--- headings (first 20) ---")
for level, title in hs[:20]:
    print(f"{'  '*(level-1)}{'#'*level} {title}")
创建沙箱、写入文件、跑命令、最后删除,可以按官方 Quickstart 的 Sandbox.create / files.write / commands.run / Sandbox.kill 来写。我实际做的是:把上面的 Markdown 写到沙箱的 /tmp/page.md(读回长度仍是 454,158),再执行 python3 /tmp/summarize_md.py /tmp/page.md。exit_code 为 0,随后删除了实例。标准输出如下(这是当天沙箱里的真实输出,不是本地冒充的控制台图):
text
chars=454158
lines=1537
headings=45
--- headings (first 20) ---
  ## Scraping a URL with Firecrawl
    ### /scrape endpoint
    ### Installation
    ### Usage
    ### Response
    ### Response metadata and status codes
  ## Scrape Formats
  ## Extract structured data
    ### /scrape (with json) endpoint
    ### Extracting without schema
    ### JSON format options
  ## Extract brand identity
    ### /scrape (with branding) endpoint
    ### Response
    ### Branding Profile Structure
    ### Combining with other formats
  ## Extract product data
    ### /scrape (with product) endpoint
    ### Response
    ### Product object structure
去掉代码块之后,标题从「按行首 # 粗算」变成了 45 个,结构已经能当一份目录用。正文节选里,脚本先碰到文档索引的引用块,真正的导语是那句 "Scrape turns any URL into clean Markdown or structured data for AI agents..."。到这一步,再决定要不要把清洗后的标题加导语 送给模型做摘要,token 会少很多,来源仍然留在 metadata.sourceURL 里。
5. 这条路径当天要花多少钱,以及要对哪几处
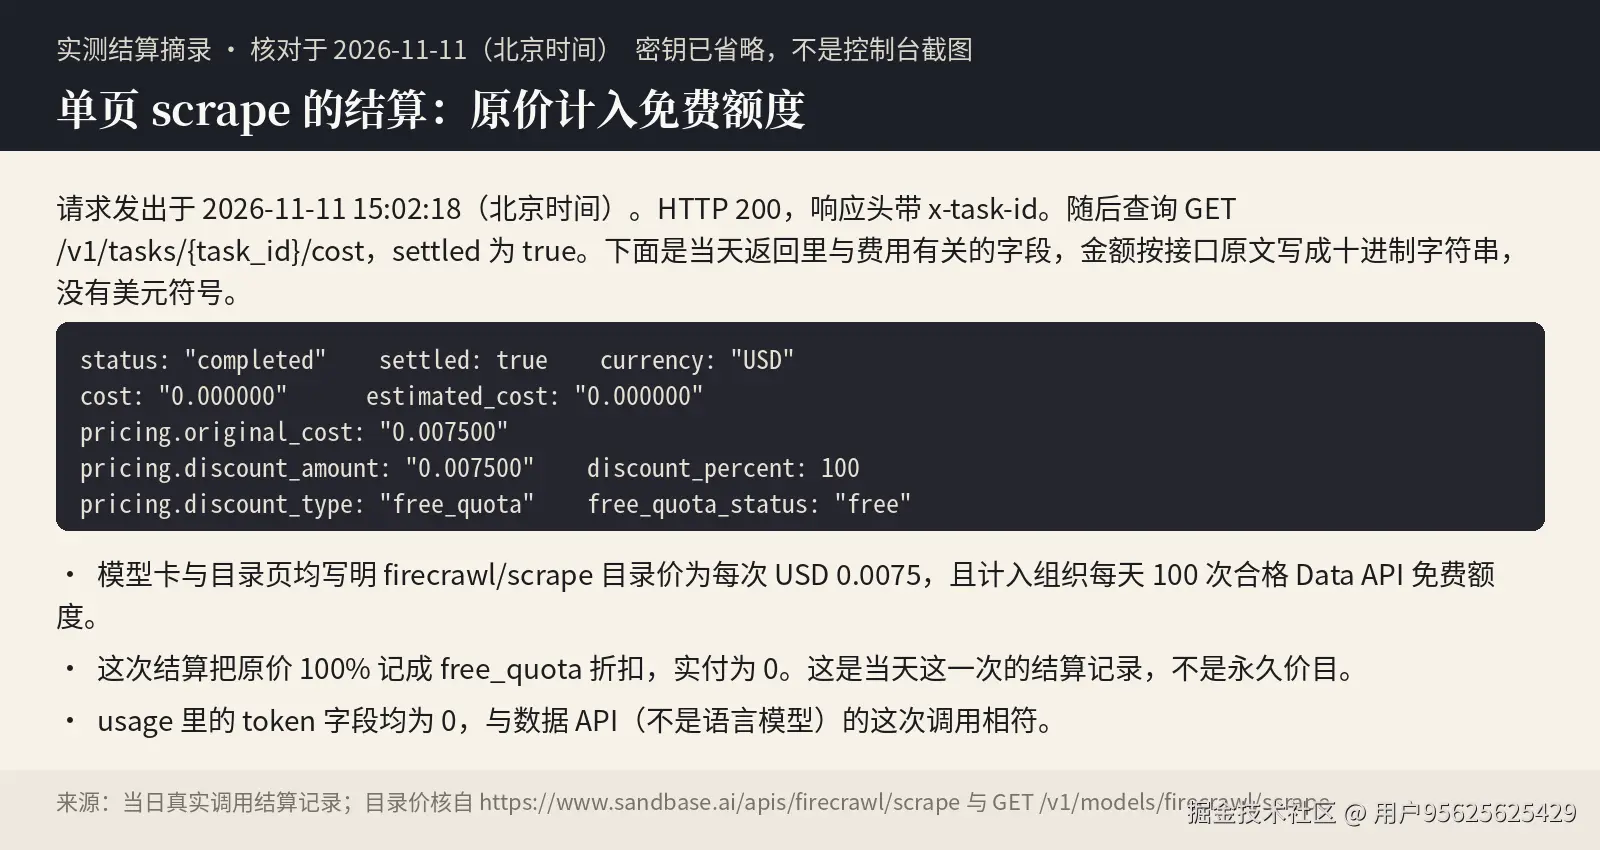
单页这次我把 x-task-id 拿去查了 GET /v1/tasks/{task_id}/cost。返回里 settled 已是 true,和费用有关的字段如下(金额是接口给出的十进制字符串):
json
{
  "id": "c88a3450-dd7d-4c38-883c-96274fa428cb",
  "status": "completed",
  "settled": true,
  "currency": "USD",
  "cost": "0.000000",
  "estimated_cost": "0.000000",
  "usage": {
    "prompt_tokens": 0,
    "completion_tokens": 0,
    "total_tokens": 0,
    "cached_tokens": 0,
    "cache_creation_tokens": 0,
    "reasoning_tokens": 0
  },
  "pricing": {
    "original_cost": "0.007500",
    "discount_amount": "0.007500",
    "discount_percent": 100,
    "discount_type": "free_quota",
    "free_quota_status": "free"
  }
}
读法很直接:目录原价是 USD 0.0075 ,这次被记成免费额度折扣,实付为 0。usage 里的 token 全是 0,和「这是一次数据 API,不是语言模型」相符。文档约定:settled 为 true 之前,不要拿 cost 对账;任务记录是操作查询,不是会计账本。长期对账仍走控制台 Activities → Usage。
若当天组织已经用完 100 次合格额度,同样一次 scrape 就会按目录价从余额扣 USD 0.0075(模型卡没有另给公式,按次计)。额度用尽不会把请求拒掉。失败的调用不计费。
需要单独盯的是另外几条端点:
- 不要用 crawl 的心态去估 scrape。 crawl 当天不计免费额度,模型卡按页计费。页面上「约 USD 0.0075」和公式并不完全一致,预算请按公式把页数乘进去,并以结算为准。
- batch 也不计免费额度,按提交的 URL 条数计,至少按 1 条。
- search 当天更贵,也不在免费额度里;OG 卡上的 USD 0.01 和目录上的 USD 0.015 还对不上,不要只看开图卡片做预算。
- 沙箱目前免费,不等于后面若把 Markdown 再送给某个收费模型也免费。模型和 Data API 仍按目录走同一余额,每一笔应出现在 Usage 里。
6. 我会怎么选
我会把这条路径用在「已经有一个公开 URL,要把它变成可引用的 Markdown,再做摘要或抽取」的场合。自己维护无头浏览器、为每个文档站写解析器,我不会作为默认选项。SandBase 这边的便利是一把 Key 能先读目录和 schema(不计费),再调 scrape,必要时把文件丢进目前免费的沙箱,最后在任务成本或 Activities 里对上结算。
我不会这么用:
- 还没确认目标页,就先开 crawl 或 batch,把免费额度和按页计费混在一起估。
- 把官方 Firecrawl 文档里的
formats、maxAge、代理档原样抄到 SandBase 请求里。当天 schema 只明确接受basic和markdown。 - 只看外层 HTTP 200,或把缓存命中当成「此刻最新」。
- 需要登录才能看的页面。目录写明:要登录或返回错误的页面会失败,并且失败不计费------但这不是去绕过访问限制的理由,只抓公开页,并遵守站点条款。
一页文档跟做到这里就够用了。若下一步是「先看这个文档站还有哪些页面,再挑几页 scrape」,应该先走 firecrawl/map,而不是把 limit 拉大交给 crawl。map 当天和 scrape 一样计入那 100 次免费额度,单价也是每次 USD 0.0075。