开发者大会内核能力与智能运维专场里,孙文奇讲的存储性能和张昊演示的 PL/SQL 全链路诊断,各对应一份官方材料,2026 年 10 月的《Kingbase 存储性能优化》和《Kingbase PL/SQL 全链路性能诊断》。存储那份给了五处内核改造,64 位事务号、原地更新引擎、增量检查点、并行回放、透明压缩表,每处都带实测数字。诊断那份给了一套四件工具和两个完整案例。数据库性能优化在这两份材料里分成两条线走,内核把性能问题的来源逐个消掉,工具把剩下的问题逐个找出来。
PL/SQL 为什么是性能黑盒
材料把 PL/SQL 的诊断难处归成三个不知。整体耗时高的时候,不知道哪一行代码耗时最高、哪个函数是热点,这是代码层盲区。定位到某条 SQL 之后,不知道它为什么走了异常的执行计划,这是 SQL 层瓶颈。执行态夯死的时候,不知道当前执行到了哪里,这是未开监控时的执行态透视问题。三个不知对应哪里慢、为何慢、在干嘛三个问题。
材料给出的解法是四件工具各管一段。KWR 扩展出语句级 PL/SQL 热点下钻,低损耗可视化展示语句级调用关系,快照时间分段可以比较历史情况,解答哪里慢、何时慢。PLProfiler 走插桩采集,做到函数级与代码行级的热点定位。PLTrace 是轻量化运行诊断,无需预先开启,极低损耗透视当前执行位置,专治长时间运行迟迟不结束的语句。SQL Monitor 做实时 SQL 诊断,看实时执行计划、执行状态和 CPU 与 IO 资源消耗。
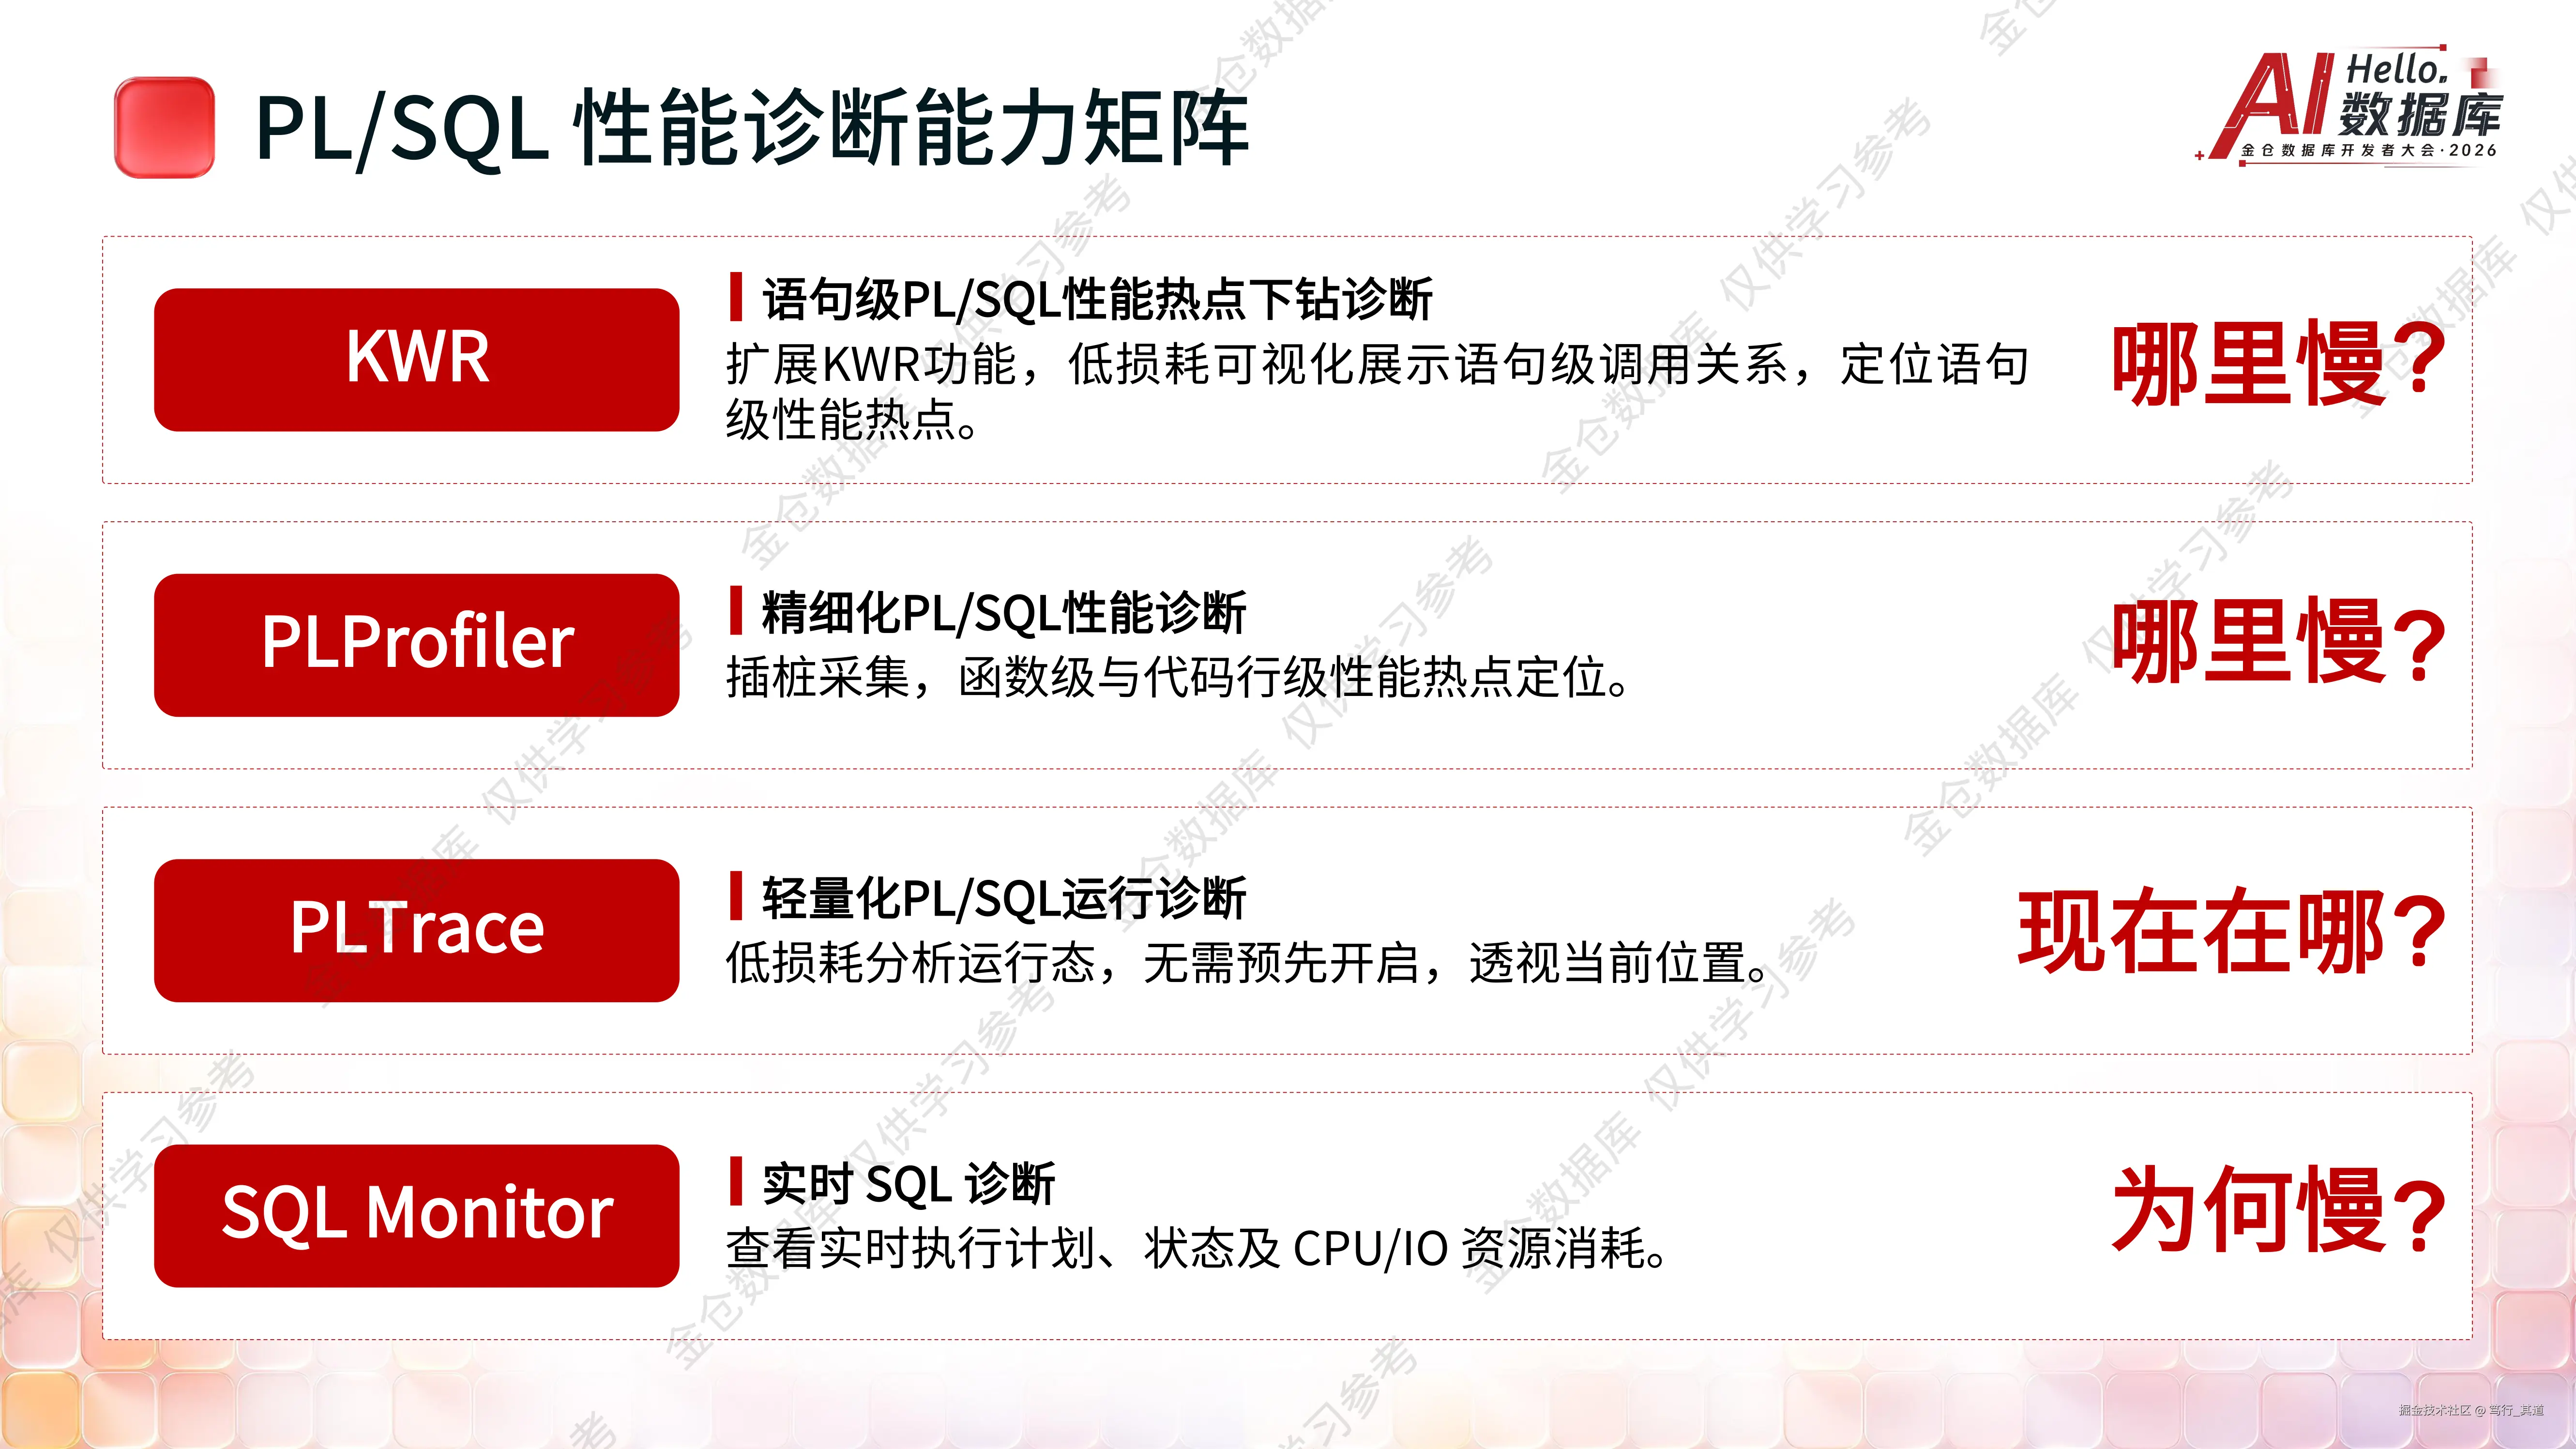
KWR 负责语句级热点下钻,PLProfiler 负责函数级与代码行级定位,PLTrace 透视当前执行位置,SQL Monitor 看实时执行计划与资源消耗,四件工具分别回答哪里慢、哪里慢、现在在哪、为何慢。*
案例一,TPS 降了 26% 的一路下钻
案例一的场景是简化版的商品购买加积分结算业务。随业务规模扩大,商品数量和订单数量增加,业务的执行效率快速下降。日常巡检用 KWR 的历史快照做性能比对,对比基线快照,当前快照的 TPS 降幅达到 26%。
第一步用 KWR 报告的 TOP SQL 子报告做 PL/SQL 下钻。按数据库时间排序的 SQL 语句列表里,顶层语句的数据库时间是 480.99 秒,执行了 69987 次,点击箭头往下钻,展开后的子语句调用仍然按性能热点从高到低排序,展开到语句调用底层,确认热点是一条查询语句。KWR 到这一层拿不到更深的执行计划信息,材料里的衔接是换工具。
第二步用基于日志的 kbbadger 报告拿执行情况。执行计划没有选择索引扫描,执行节点实际返回的元组数和过滤行数证明索引扫描更好。查下来是查询涉及的关系表没有创建对应的索引,建了 CREATE INDEX idx_biz_customer ON biz_customer_profiles (customer_code) 之后性能优化明显。再看新的 KWR 报告,TPS 得到一定恢复,但仍然不及预期,说明还有别的问题。
第三步沿新的性能热点继续下钻。KWR 语句级调用关系统计到层级 3 出现了明显的数据库时间空洞,语句级到此为止,换能提供代码行级信息的 PLProfiler。plsql_plprofiler 报告的火焰图里直观找到热点函数,函数的 self_time 是 118273.07 毫秒,行级统计显示 LOOP 块执行了 31843 次、耗时 117 秒。此处业务按分期天数循环处理累加的资金占用费,计算代价高,循环次数还随分期天数上升持续增加。修复方式是把循环计算转换成求和公式,业务逻辑上完全等价。改完再对比基线快照,TPS 恢复到预期标准。
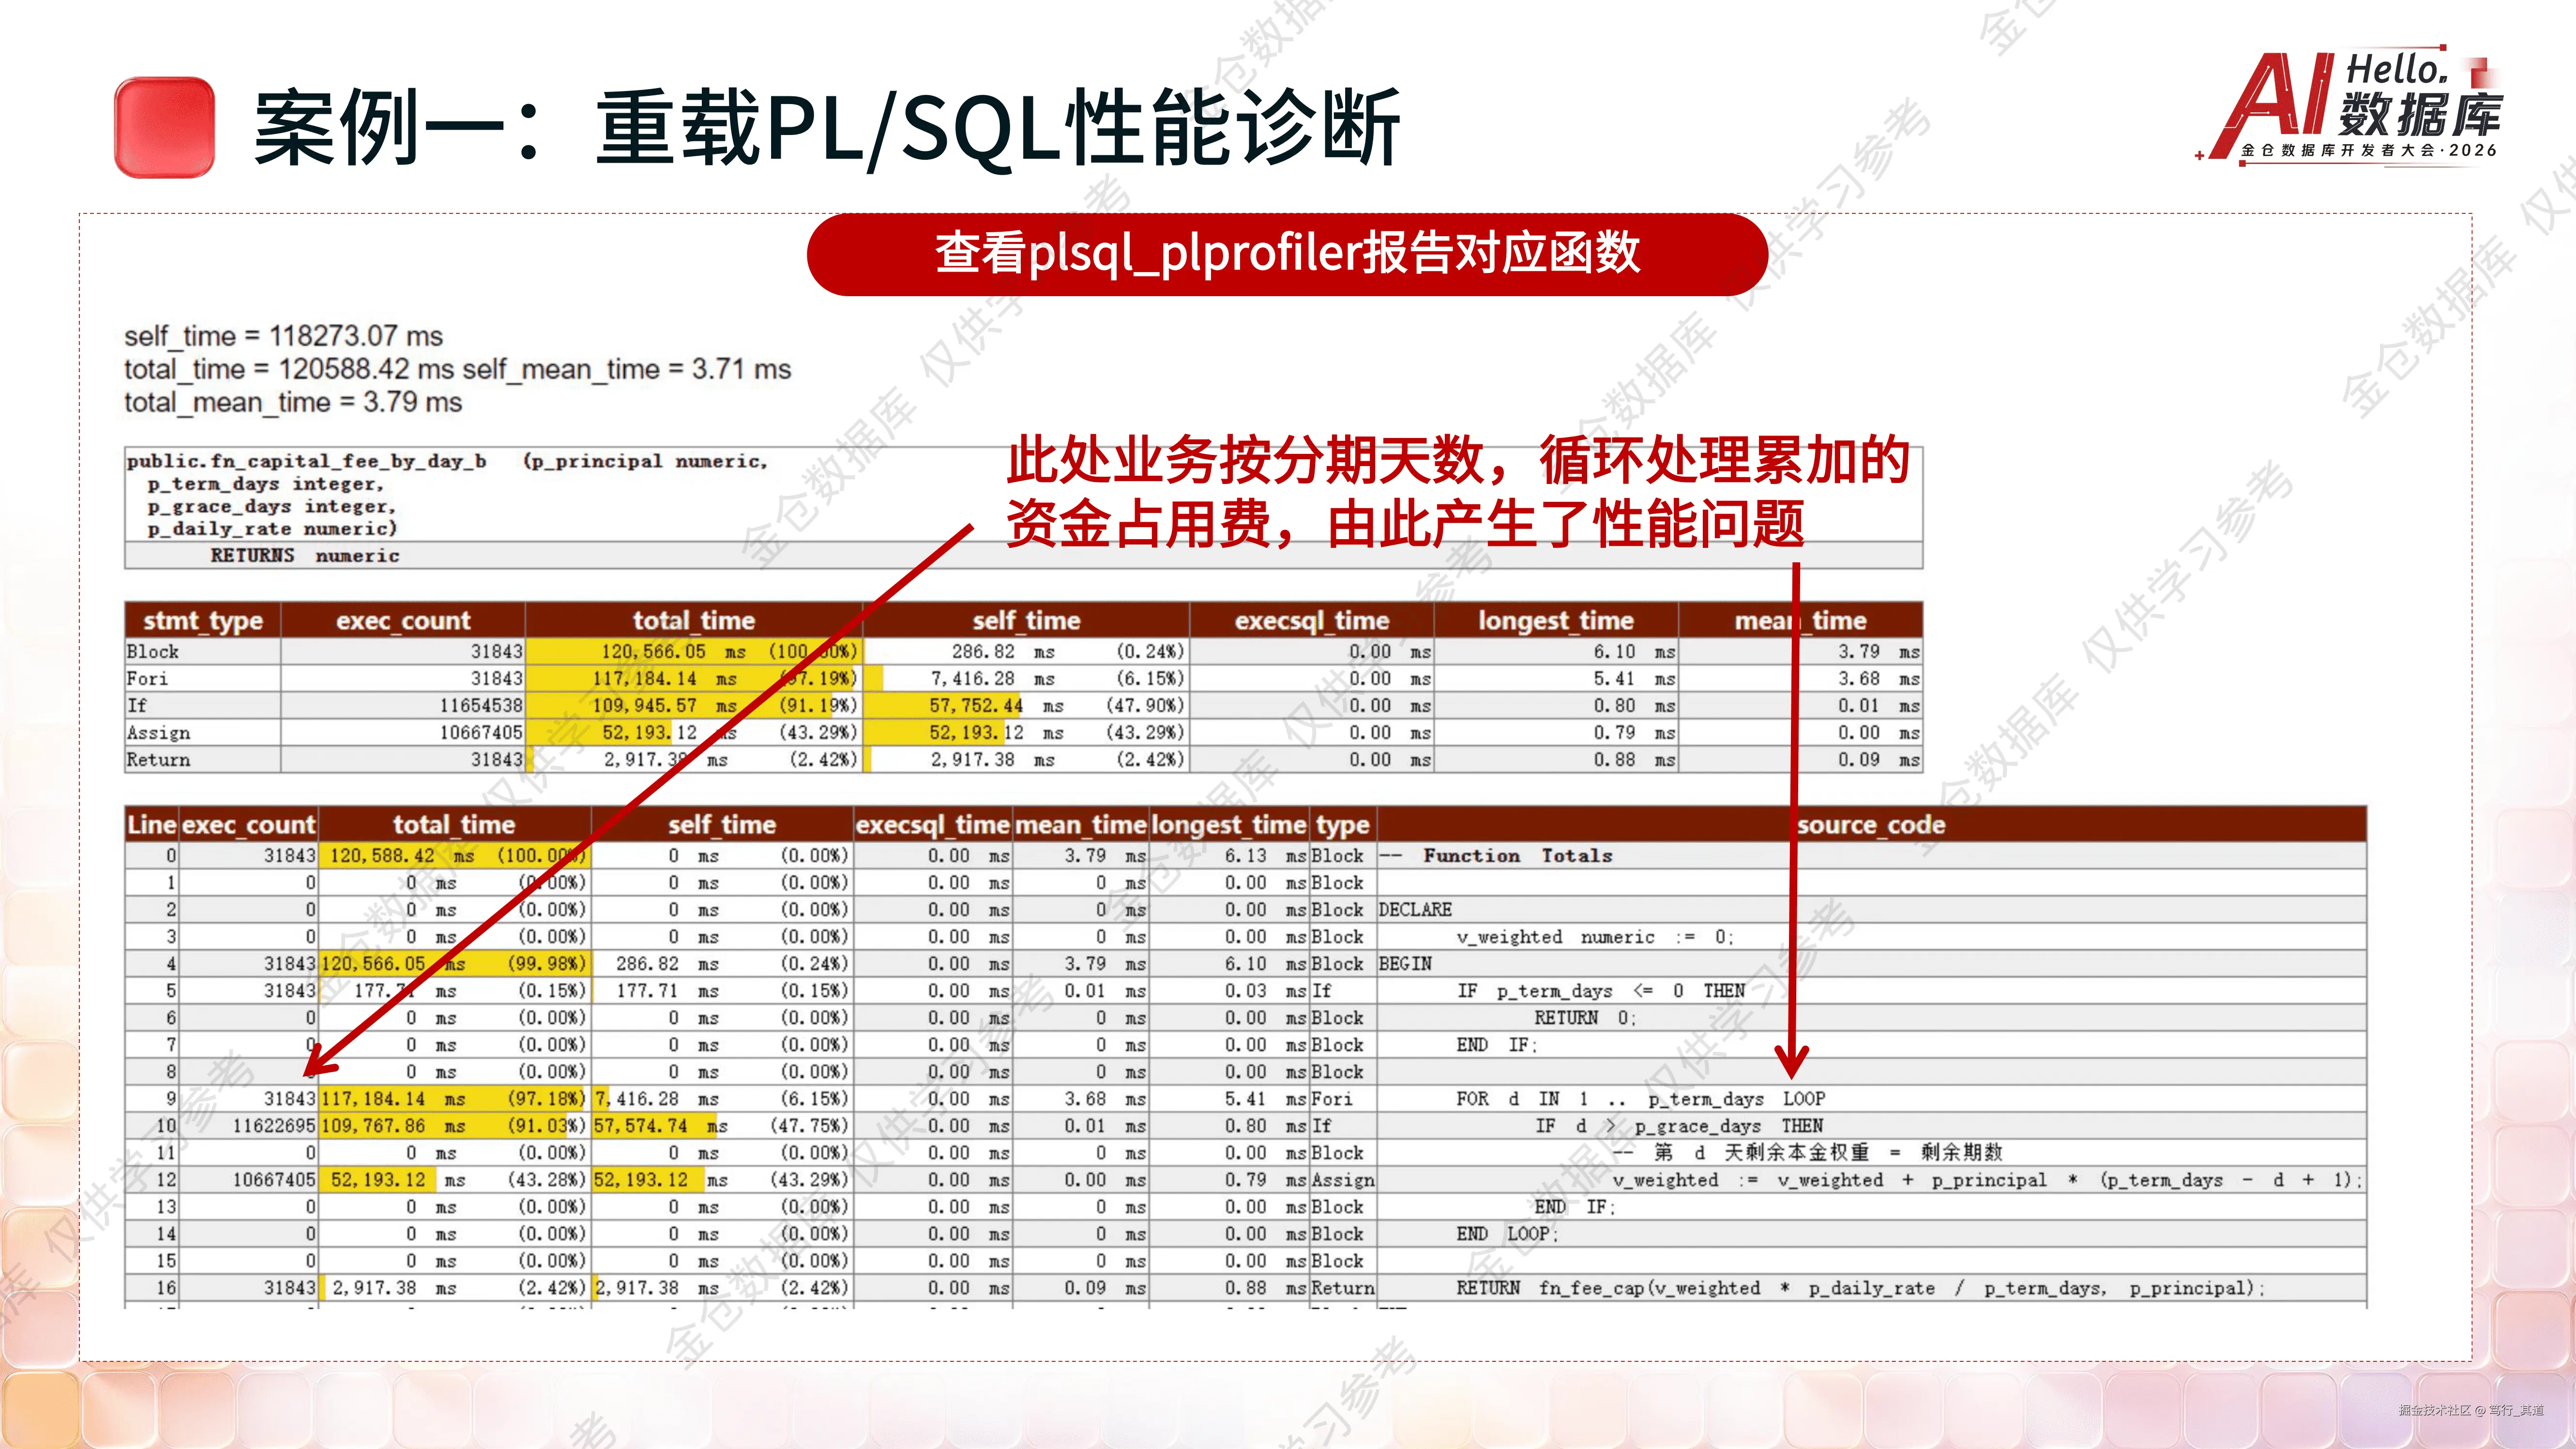
上半部分是函数级统计,热点函数的 self_time 为 118273.07 毫秒;下半部分下钻到代码行,LOOP 块执行 31843 次、耗时 117 秒,根因是按分期天数循环累加资金占用费。*
案例二,夯死 309 秒的在线定位
案例二没有监控预埋。巡检用动态视图 sys_stat_activity,间隔 5 秒定时刷新,发现并行日终结算业务的会话执行时间明显超长,这个业务用 PL/SQL 函数并行计算各员工业绩。常规的统计工具为了维持业务性能稳定,都在事务或子事务完成后才写入执行信息,执行中的业务内部状态看不到,这是材料里给的使用 PLTrace 的理由。
从视图里拿到异常进程的 PID,用这个 PID 调用 PLTrace,查到该 PL/SQL 位于第 8 层函数调用,对应第 5 行,进程正在执行一条查询语句,这条语句已经执行了 309 秒。接着在 SQL Monitor 里对这条语句生成实时执行报告,等待占比不高,主要看执行计划。自底向上分析,从表 order.payment 参与 Nested Loop 开始,预估成本和实际成本出现明显差距,该节点实际返回行数远超优化器预期。
再通过系统表确认 payment 的表统计信息,上一次 ANALYZE 已经超过 1000 秒,payment 表的实际元组数远超优化器预估。在一个数据波动较大的业务里,这极大可能导致路径规划错误,优化器选错了连接顺序和连接方式。修复是手动对指定表执行 ANALYZE,并配置更频繁的自动 ANALYZE。修复后的执行计划里 payment 表的预估成本和实际执行成本基本相同,业务稳定在 60 秒内执行完成。
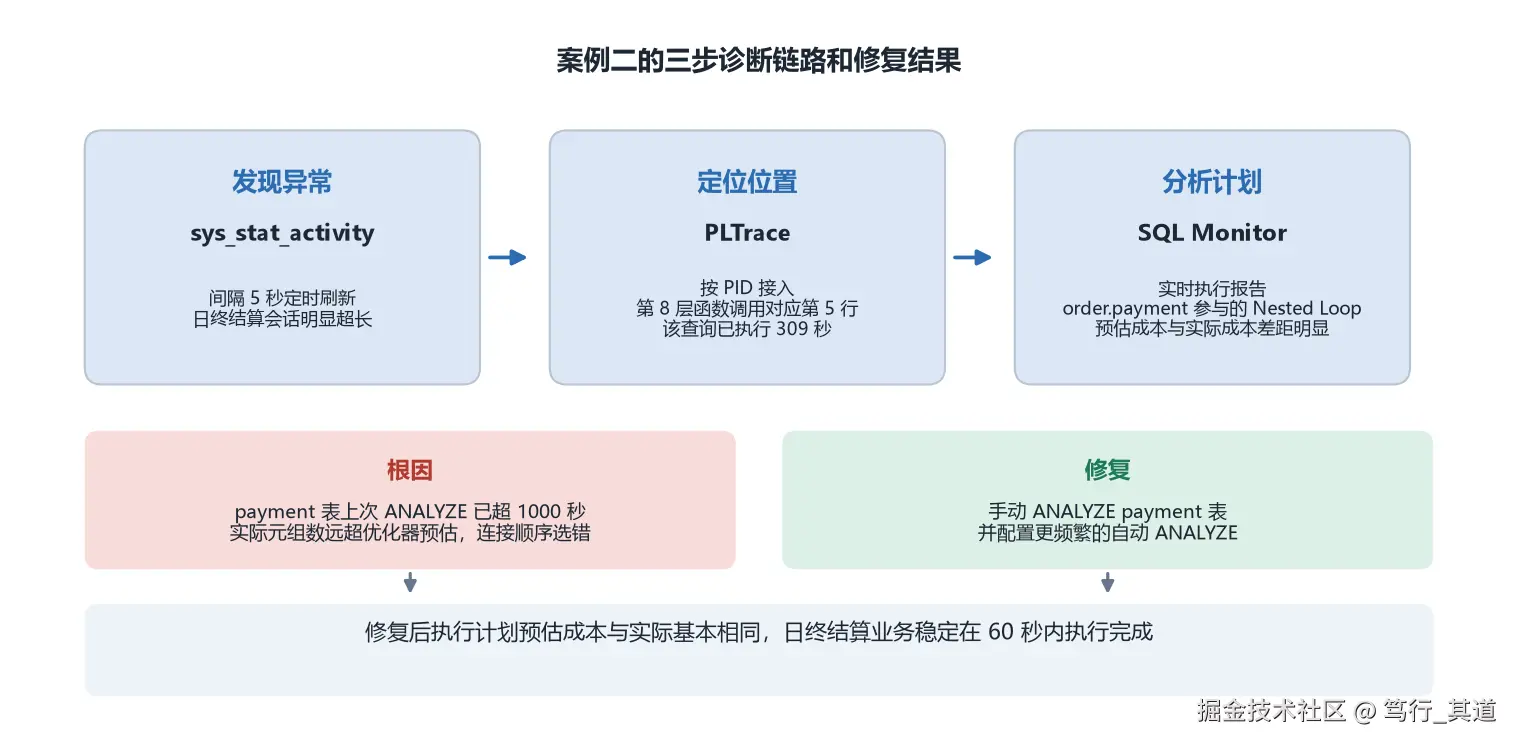
sys_stat_activity 发现超长会话,PLTrace 按 PID 定位到第 8 层函数调用对应第 5 行、查询已执行 309 秒,SQL Monitor 的实时执行报告暴露 Nested Loop 的成本预估偏差,根因是 payment 表超过 1000 秒未 ANALYZE,修复后业务稳定在 60 秒内完成。*
64 位事务号和页冻结
存储材料的第一处改造针对事务号回卷。事务 ID 为 32 位,约 20 亿上限,高并发事务场景里事务 ID 快速增长,不及时回收就会因回卷导致业务中断,而回收用的 vacuum 操作本身占服务器资源,高写入场景运维压力巨大。KingbaseES 的做法是事务 ID 计算采用 64 位,页上用 64 位存储本页事务基线,行事务存 32 位偏移,基线随本页数据变化动态调整,内存里读取行事务信息时即时计算出 64 位事务号,页内事务跨度不超过 40 亿的阈值,超过时进行页冻结。效果是事务 xid 最大支持到 2 的 60 次方,消除溢出风险,把必要的整体冻结变成可延迟执行的分散冻结。存储结构向下兼容,升级工具只对元数据重写,数据页随着首次修改改写为新页面格式。
原地更新引擎和 Undo 版本链
第二处改造针对 MVCC 死元组。多版本机制产生大量旧版本死元组,长事务会阻塞清理,表和索引体积膨胀,扫描性能下降,回收空间要么 vacuum full 封锁代价大,要么 autovacuum 调度参数复杂难调。原地更新引擎把新旧版本分离,旧版本放进 Undo Log 区域,众多 UNDO ZONE 支持事务并发,ZONE 由便于回收的连续小文件组成,每个新版本指向 Undo 中的旧版本形成版本链,一致性读沿版本链追溯到当前快照对应的可见版本,Btree 的元组直接带可见性信息,无需回表判断。堆表只保留最新版本,从根源消除膨胀。材料给的实测是长事务场景 TPS 从 129 提到 8527,提升 660%,短事务场景从 1290 提到 1712,提升 132%,堆存储引擎的 TPS 曲线在有长事务时快速衰减,原地更新引擎保持稳定。
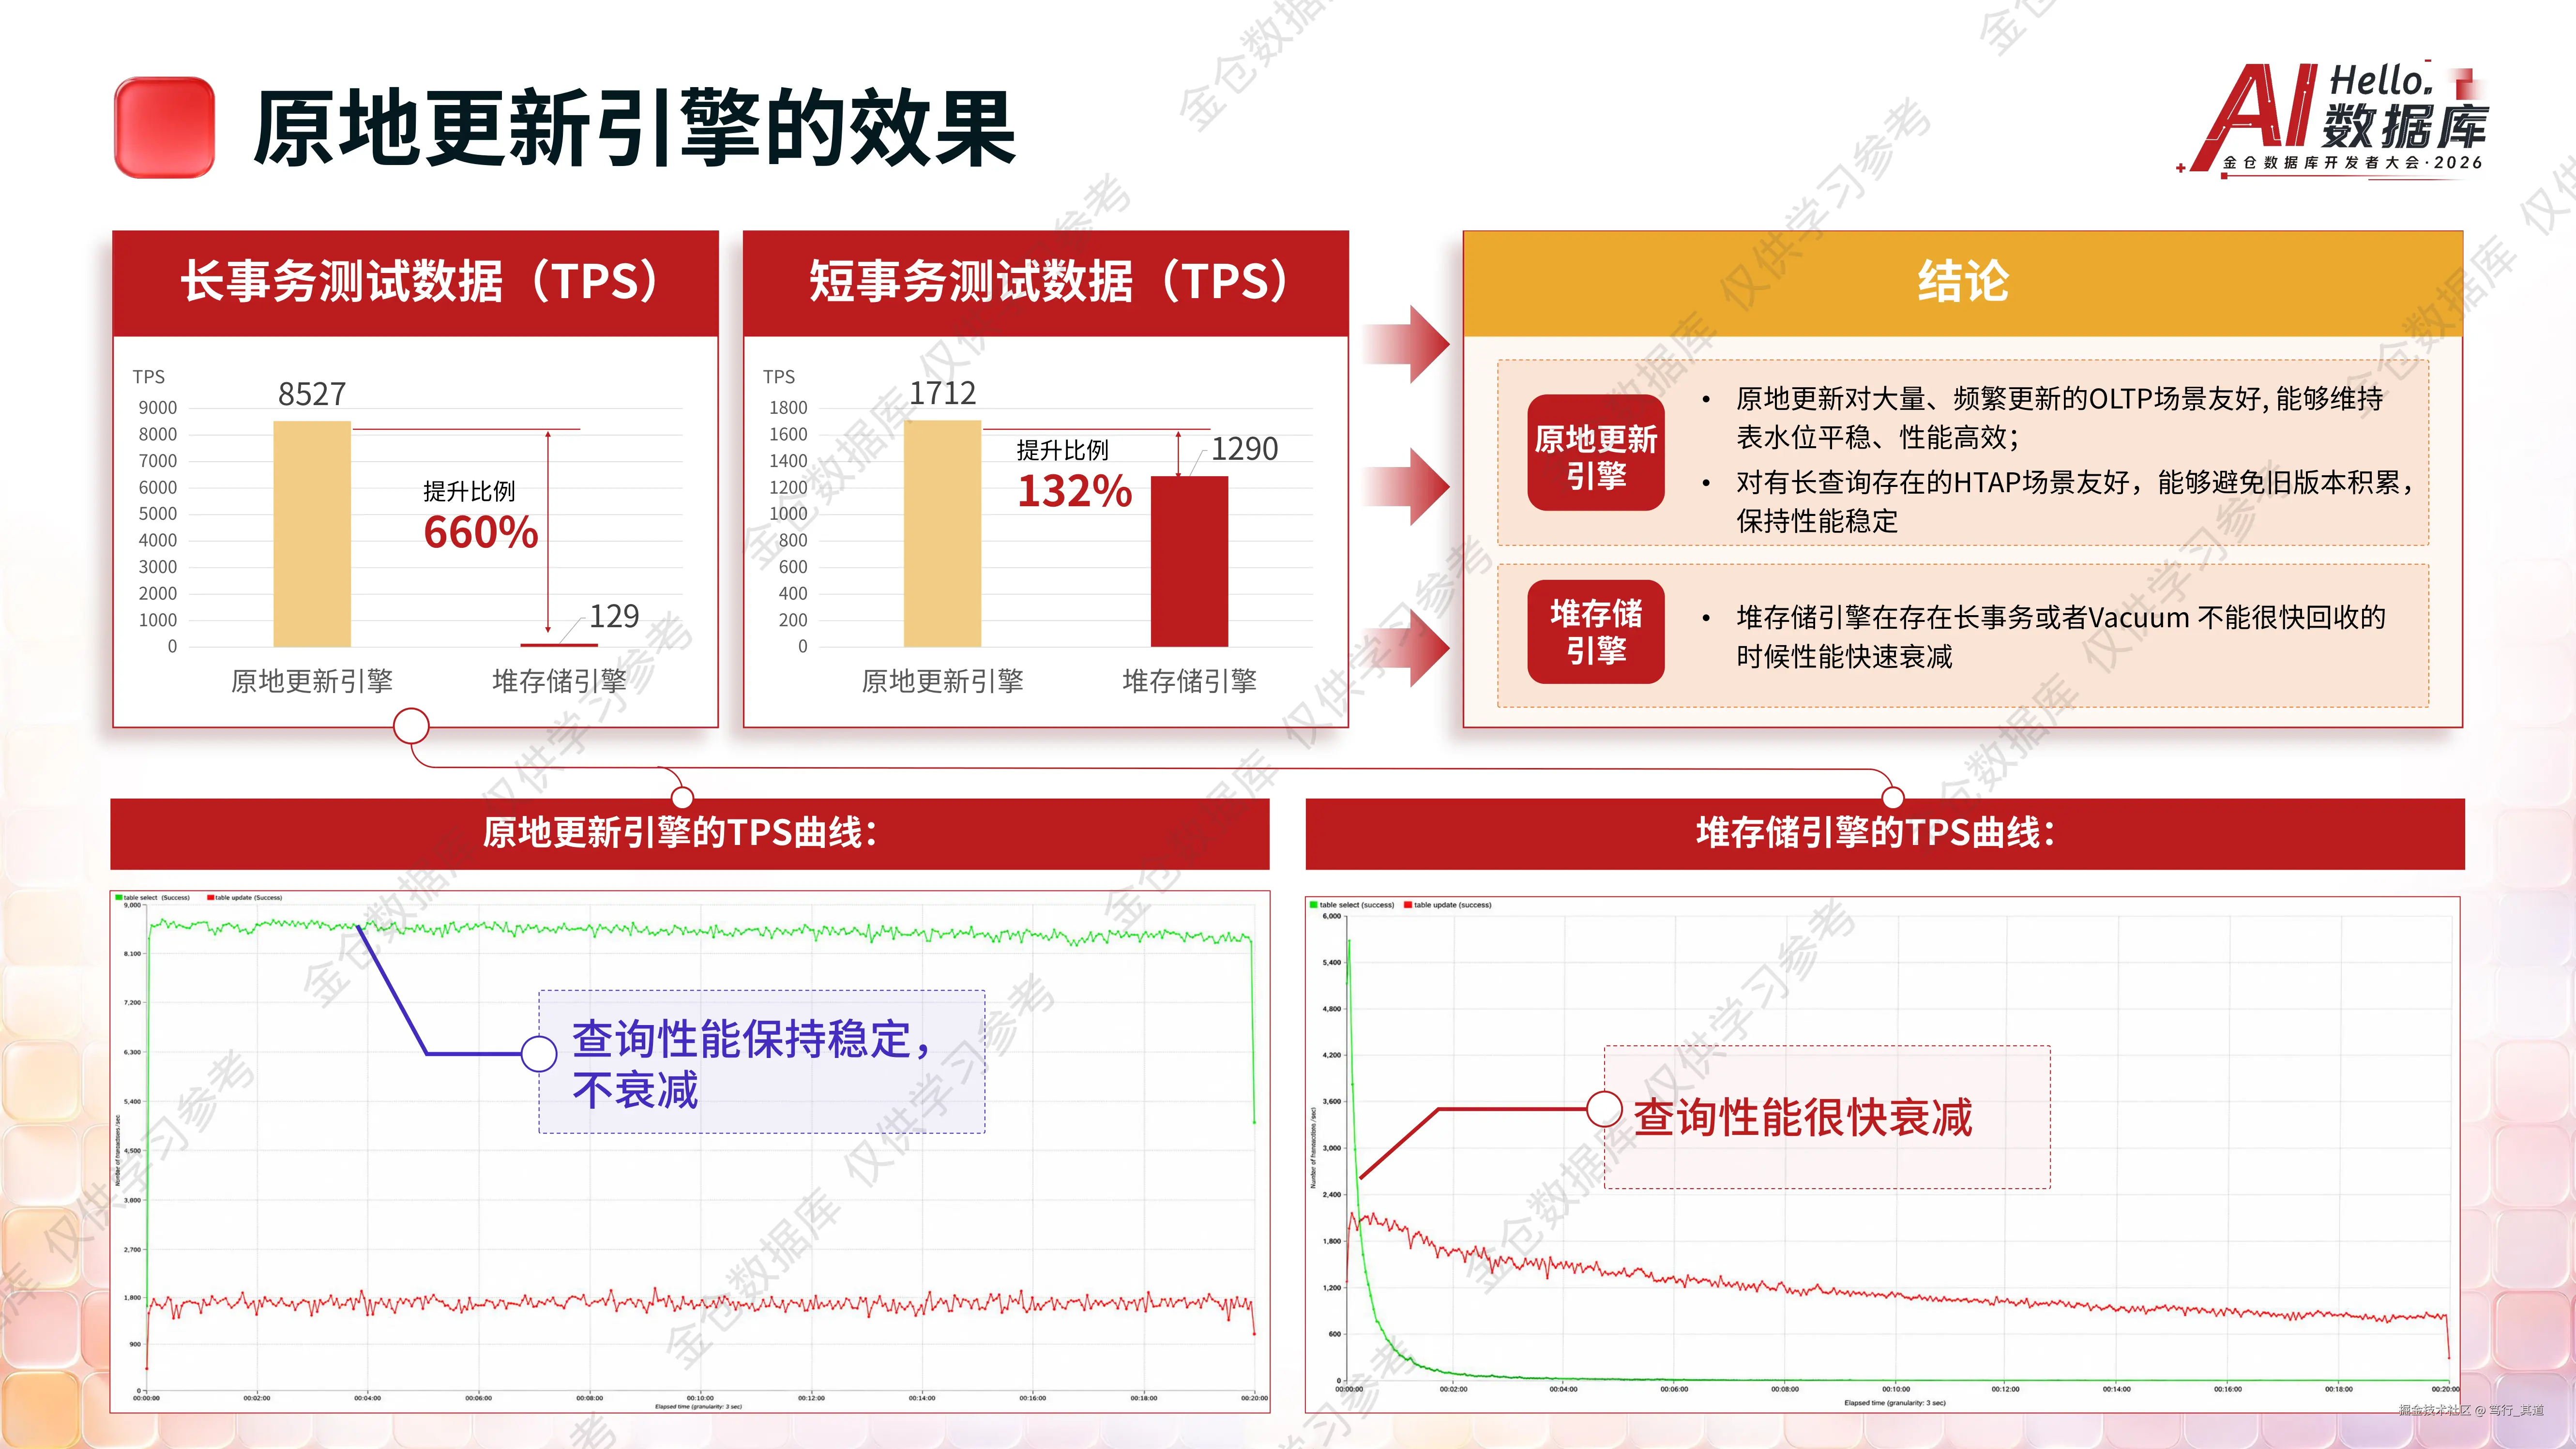
长事务测试中原地更新引擎 TPS 为 8527,堆存储引擎为 129,提升 660%;短事务测试为 1712 对 1290,提升 132%。下方两条曲线显示原地更新引擎查询性能保持稳定,堆存储引擎很快衰减。*
增量检查点和有序脏页队列
第三处改造针对检查点的 IO 冲击。全量检查点触发时集中刷脏页,IO 压力骤增,检查点后页面首次修改要写入完整页面镜像,产生 WAL 写放大,执行期间查询延迟明显飙升,长期运行性能曲线呈锯齿状。增量检查点通过 LSN 有序队列维护页面变脏的顺序,脏页按 LSN 排序入全局环形队列,Ordered Writer 进程定时按序刷新,队列头的 Redo 位置直接作为新检查点的恢复位置,检查点无需再做页面落盘,数据页双写解决断页写问题,降低检查点后的 WAL 全页写。实测条件是 TPCC 1000 仓、100 并发、20 分钟,平均 tpmC 从 437824 提到 467639,提升 6.8%,WAL 大小从 306G 降到 65G,减少 79%,磁盘写总量降低 45%,瞬时 tpmC 抖动的标准差从 33% 降到 12%,CPU 和内存没有明显变化。
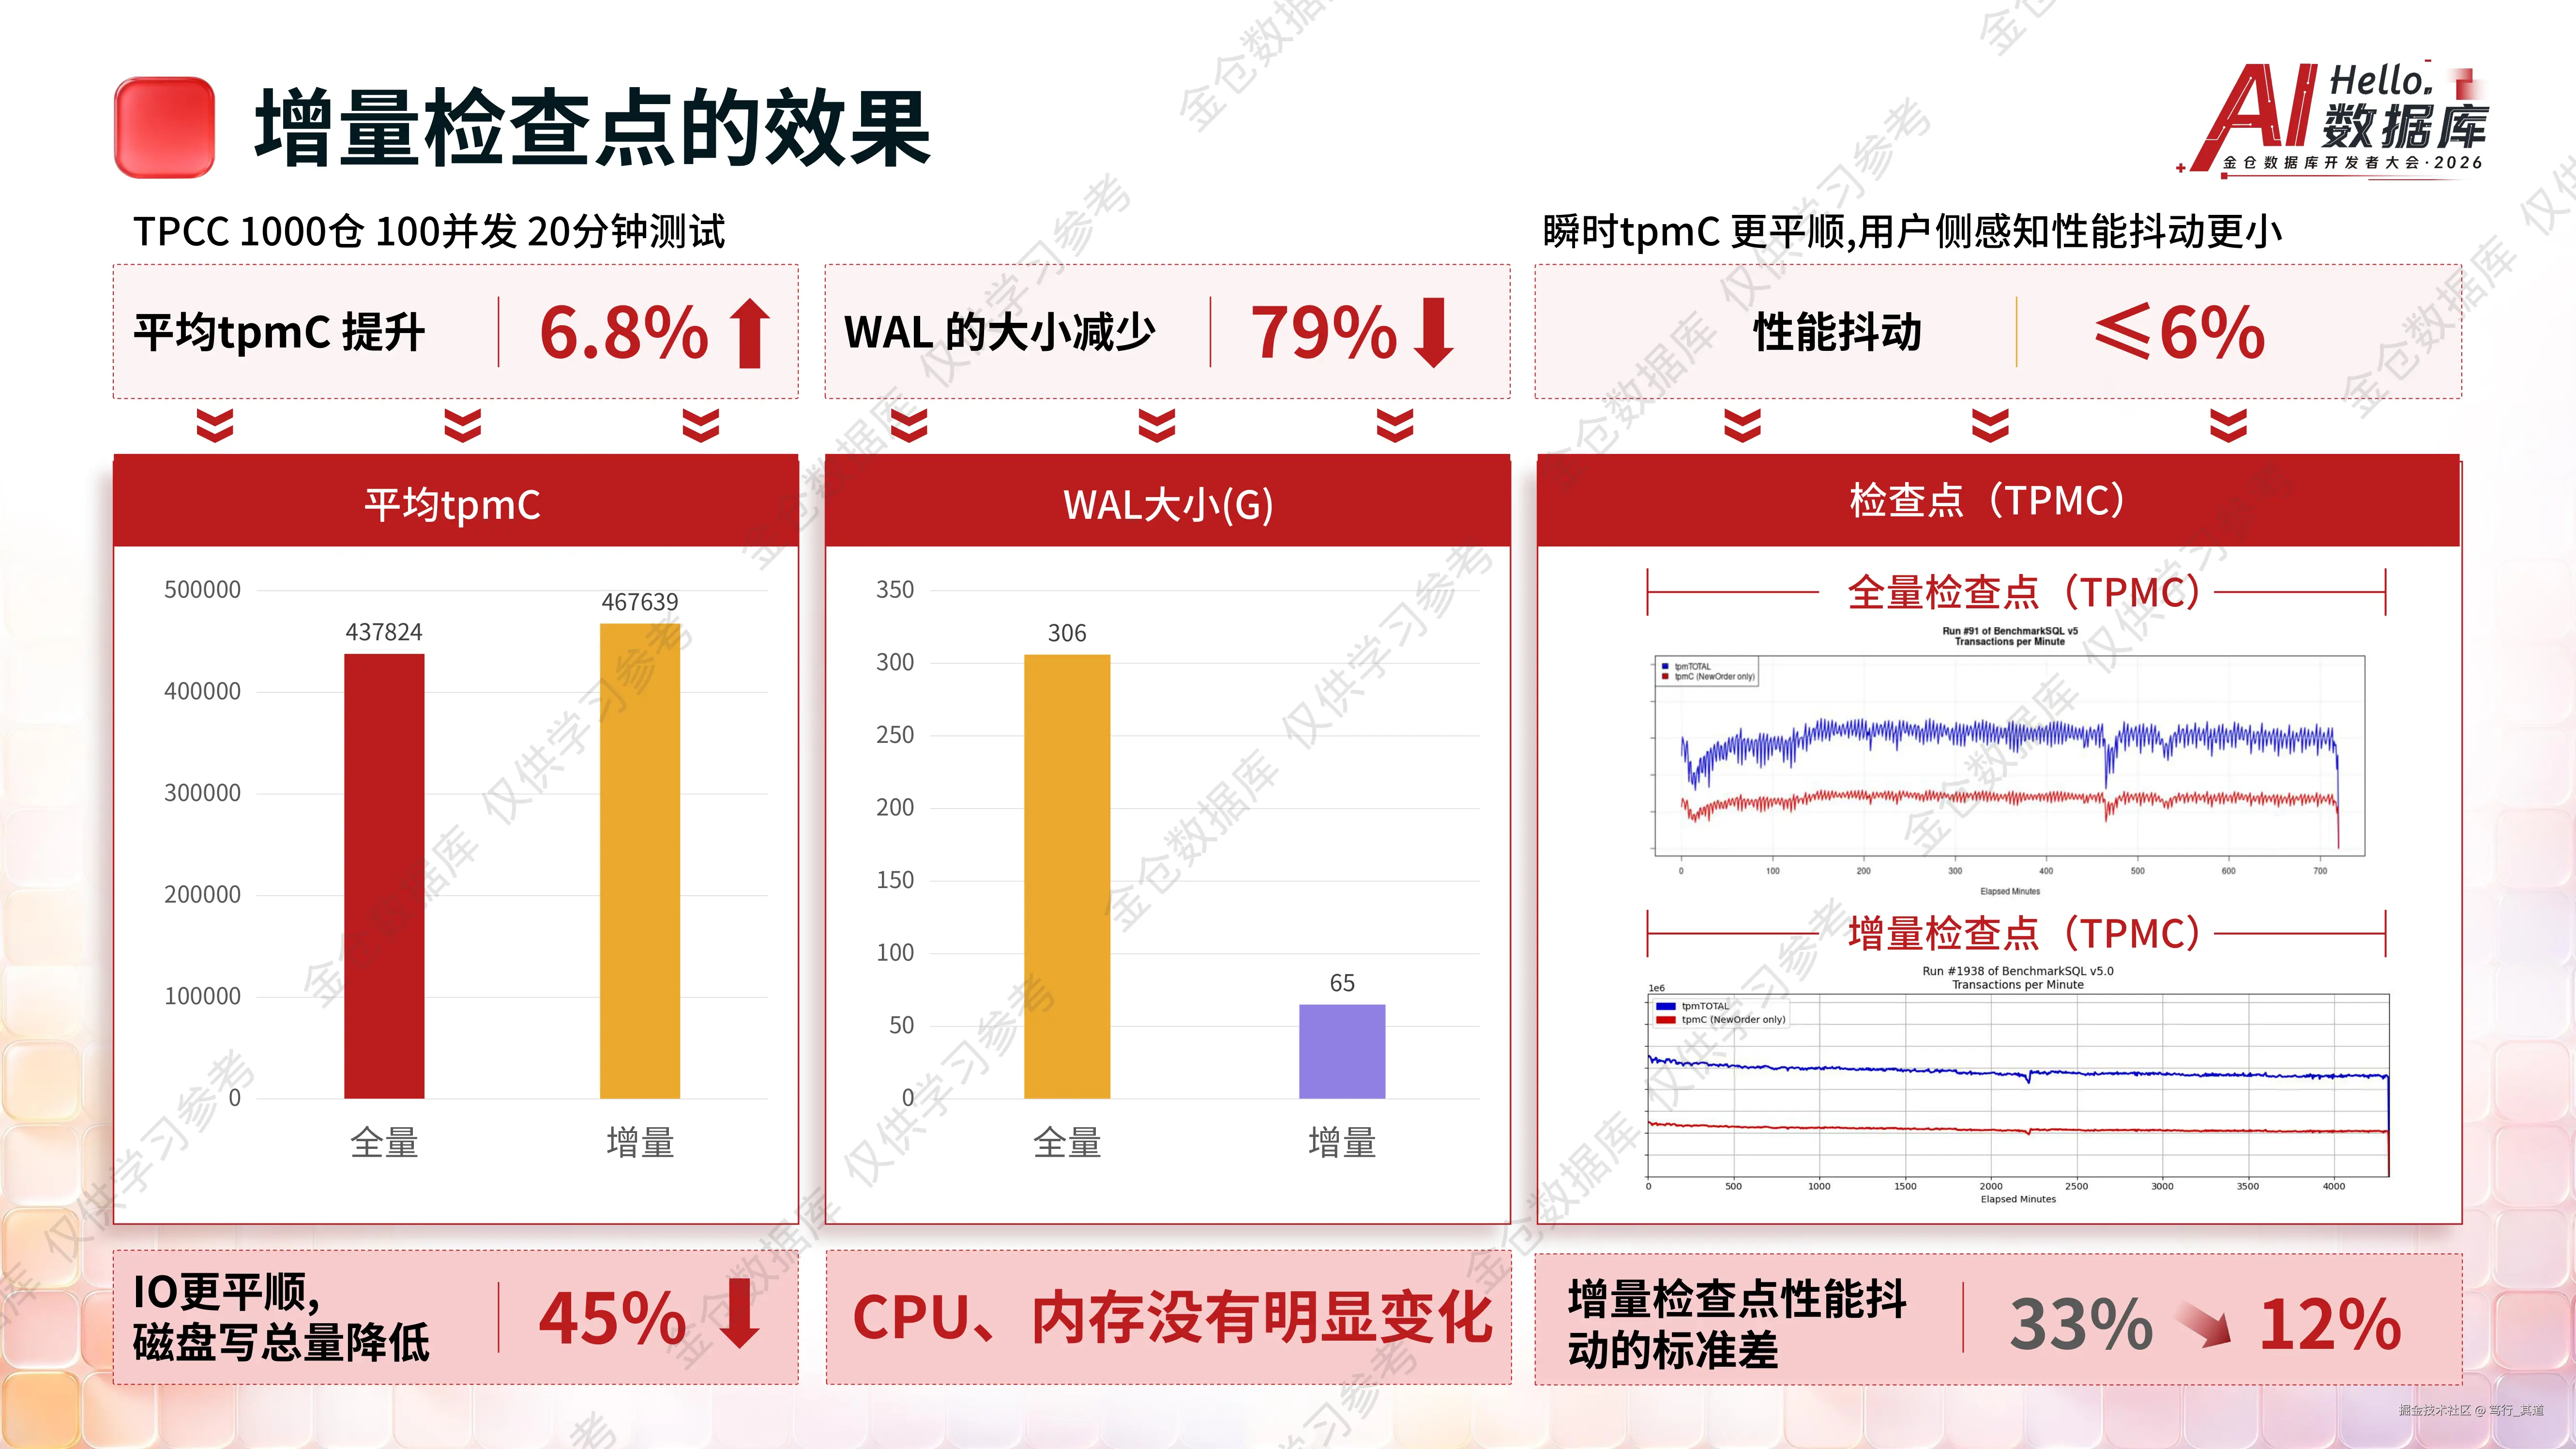
TPCC 1000 仓 100 并发 20 分钟测试,平均 tpmC 提升 6.8%,WAL 大小减少 79%,磁盘写总量降低 45%,性能抖动标准差从 33% 降到 12%,全量与增量检查点的瞬时 tpmC 曲线对比显示增量更平顺。*
并行回放和主备延迟
第四处改造针对主备同步。主机多个进程同时生产 WAL,备机只有一个进程消费,WAL Redo 回放只能单进程串行执行,故障恢复时间长,RTO 难以压缩,备库回放速度跟不上主库写入,主备延迟随业务量扩大。并行回放把日志读取和回放逻辑拆开,解码后的记录进入共享内存环形 Buffer,分发到多个回放进程,以 Block 为单位分别执行,识别 Block 之间的依赖性保证数据完整性,事务记录按序回放保证事务一致性,共享内存 Buffer 减少内存拷贝,级联、主备 remote write、remote apply 等现有机制不受影响。TPCC 测试在 remote_apply 模式下,串行回放 tpmC 为 277195,并行回放提到 615897,4 个回放进程时从 349867 提到 777473,OLTP 更新密集型负载的主备同步性能提升 20% 到 40%,备机 CPU 得到充分利用。
透明压缩表和 extent 组织
第五处改造针对大表的存储成本。没有块级压缩能力时只能针对字段压缩,关系库里元组长度通常不高,字段级压缩效果差,大表磁盘开销大,只能依赖底层存储压缩。透明压缩表在数据块级别压缩,支持 PGLZ、ZSTD 和 LZ4 三种算法,覆盖普通表、分区表、toast 表和各种索引类型。关系按 extent 划分,一个 extent 为 128 个页,前 127 页是数据空间,尾页存放前 127 块的地址信息,压缩节约的空间通过 punch hole 机制释放回文件系统,压缩前还提供字节转换和差分预处理手段发挥压缩效果。应用完全无感知,磁盘空间占用显著降低,缓存命中率提升,大表和归档表场景收益尤其明显。
两条线的分工
回头看这两份材料的结构。诊断线的四件工具按粒度排列,KWR 语句级、PLProfiler 代码行级、PLTrace 运行态、SQL Monitor 实时态,两个案例各走了一条完整链路,案例一从 KWR 快照比对走到求和公式改写,案例二从 sys_stat_activity 走到 ANALYZE 配置。内核线的五处改造各对应一类慢性问题,事务号回卷、死元组膨胀、检查点抖动、主备延迟、大表成本,材料里每一处都给了改造前的痛点清单和改造后的实测数字。工具解决已经发生的问题,内核减少问题发生的来源,两份材料放在一起看,正好覆盖数据库性能优化的两条线。