Web 接口返回的数据、后台导出的报表以及配置文件和日志,很多都采用 JSON 格式。JSON 适合存储和传输数据,但如果需要逐条核对、筛选或汇总,直接查看文本就不太方便了。转换为 Excel 后,数据可以按行列排列,还能利用 Excel 的筛选、排序和公式等功能进行进一步处理。
本文将介绍如何使用 Python 读取 JSON 数据,并通过 Spire.XLS for Python 将其写入 Excel 工作簿,涵盖基本转换、嵌套数据处理、表格格式设置和批量转换等常见场景。
为什么要将 JSON 转换为 Excel?
将 JSON 转换为 Excel,主要是为了方便查看、分析和共享数据:
- 方便查看数据: JSON 通常采用嵌套结构,字段较多时不容易快速核对。转换为 Excel 后,每条记录占一行,每个字段对应一列,数据更加直观。
- 便于数据分析: 转换后的数据可以直接使用 Excel 的筛选、排序、求和和数据透视表等功能,无需额外编写处理脚本。
- 方便共享和交付: Excel 是常见的数据交换格式。将 JSON 自动转换为
.xlsx文件,可以减少手动复制和整理数据的工作量。
简单来说,转换过程就是将 JSON 中的数据整理成适合 Excel 表格展示的结构。下面从基本操作开始。
环境准备
本文使用 Spire.XLS for Python 创建 Excel 工作簿、写入单元格数据并保存文件。JSON 数据则通过 Python 标准库 json 读取,无需安装额外的解析库。
首先,执行以下命令安装 Spire.XLS:
bash
pip install Spire.XLS然后导入所需模块:
python
import json
from spire.xls import *
from spire.xls.common import *
基本流程:读取 JSON 并写入 Excel
首先来看最常见的情况:JSON 文件由多个字典组成,每个字典代表一条记录,字段名称和结构基本一致。
Python 标准库中的 json.load() 可以直接读取 JSON 文件,并将其转换为 Python 字典或列表。读取数据后,创建一个 Excel 工作簿,将字段名称作为表头,再逐条写入对应的单元格。
下面的示例演示了这一过程:
python
import json
from spire.xls import *
from spire.xls.common import *

inputFile = "data.json"
outputFile = "data.xlsx"

# 读取 JSON 文件
with open(inputFile, "r", encoding="utf-8") as f:
    records = json.load(f)

# 创建工作簿并获取第一张工作表
workbook = Workbook()
sheet = workbook.Worksheets[0]

# 使用第一条记录的键作为表头
headers = list(records[0].keys())
for col, key in enumerate(headers, start=1):
    sheet.Range[1, col].Text = key

# 从第二行开始写入数据
for row, record in enumerate(records, start=2):
    for col, key in enumerate(headers, start=1):
        sheet.Range[row, col].Text = str(record.get(key, ""))

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()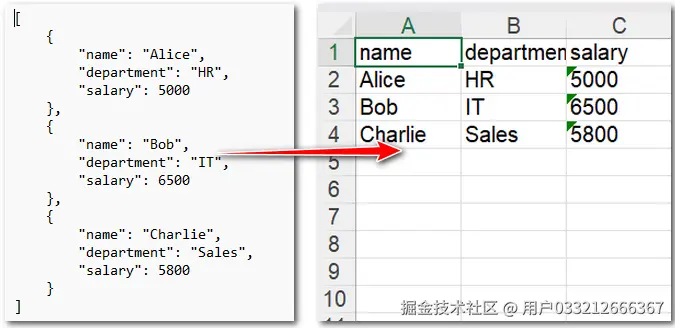
这里使用 sheet.Range[行, 列] 定位单元格,行号和列号都从 1 开始。例如,Range[1, 1] 对应 Excel 中的 A1 单元格。
代码将字段名称写入第一行,后续记录从第二行开始排列。由于 Text 属性用于设置文本,因此示例使用 str() 将 JSON 中的值转换为字符串后再写入单元格。
需要注意,这种写法适用于 JSON 根节点为非空列表,且列表元素为字典的情况。如果 JSON 数据结构不同,就需要根据实际内容调整读取和写入方式。
固定 Excel 列顺序
在实际业务中,不同 JSON 文件可能包含相同的字段,但字段出现的顺序不一定一致。如果直接使用第一条记录的键作为表头,生成的 Excel 列顺序就可能随原始数据变化。
如果希望每次转换都使用相同的列顺序,可以提前定义字段列表,而不是直接读取 records[0].keys()。
例如,将用户数据中的 id、name、email 和 department 按照指定顺序写入 Excel:
python
import json
from spire.xls import *
from spire.xls.common import *

inputFile = "users.json"
outputFile = "users.xlsx"

with open(inputFile, "r", encoding="utf-8") as f:
    records = json.load(f)

workbook = Workbook()
sheet = workbook.Worksheets[0]

# 指定 Excel 列顺序
columns = ["id", "name", "email", "department"]

for col, name in enumerate(columns, start=1):
    sheet.Range[1, col].Text = name

# 写入数据
for row, record in enumerate(records, start=2):
    for col, name in enumerate(columns, start=1):
        value = record.get(name, "")
        sheet.Range[row, col].Text = "" if value is None else str(value)

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()
这里通过 columns 明确指定了表头和列顺序。写入数据时,使用 record.get(name, "") 获取对应字段。如果某条记录缺少指定字段,就会以空字符串填充,避免因键不存在而导致程序报错。
这种方式尤其适合批量转换结构相似的数据文件,可以确保不同文件生成的 Excel 表格具有一致的列布局,方便后续合并和比较。
处理嵌套 JSON:将层级结构展开为表格
前面的示例都以简单的键值对为基础,但实际 JSON 数据经常包含嵌套结构。例如,用户记录中可能包含 address 对象,订单数据中可能包含商品列表。如果直接将这些对象或列表转换为字符串写入单元格,得到的内容可能包含额外的括号、引号等符号,不方便单独筛选和分析。
更实用的做法是先将嵌套字典展开为普通键值对,并对列表值进行适当处理,再写入 Excel。
一种简单的处理方式是使用点号连接父级和子级键名。例如,将 address 对象中的 city 和 zip 展开为 address.city 和 address.zip。
下面通过递归函数实现这一操作:
python
import json
from spire.xls import *
from spire.xls.common import *

inputFile = "/sample.json"
outputFile = "/orders.xlsx"

with open(inputFile, "r", encoding="utf-8") as f:
    records = json.load(f)

# 递归展开嵌套字典
def flatten(record, prefix=""):
    items = {}

    for key, value in record.items():
        composed = f"{prefix}{key}"

        if isinstance(value, dict):
            items.update(flatten(value, composed + "."))
        elif isinstance(value, list):
            items[composed] = ", ".join(map(str, value))
        else:
            items[composed] = value

    return items

flat_records = [flatten(record) for record in records]

# 收集所有字段,作为 Excel 表头
all_keys = []
for record in flat_records:
    for key in record.keys():
        if key not in all_keys:
            all_keys.append(key)

workbook = Workbook()
sheet = workbook.Worksheets[0]

# 写入表头
for col, name in enumerate(all_keys, start=1):
    sheet.Range[1, col].Text = name
    sheet.Range[1, col].Style.Font.IsBold = True

# 写入展开后的数据
for row, record in enumerate(flat_records, start=2):
    for col, name in enumerate(all_keys, start=1):
        value = record.get(name, "")
        sheet.Range[row, col].Text = "" if value is None else str(value)

sheet.AllocatedRange.AutoFitColumns()

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()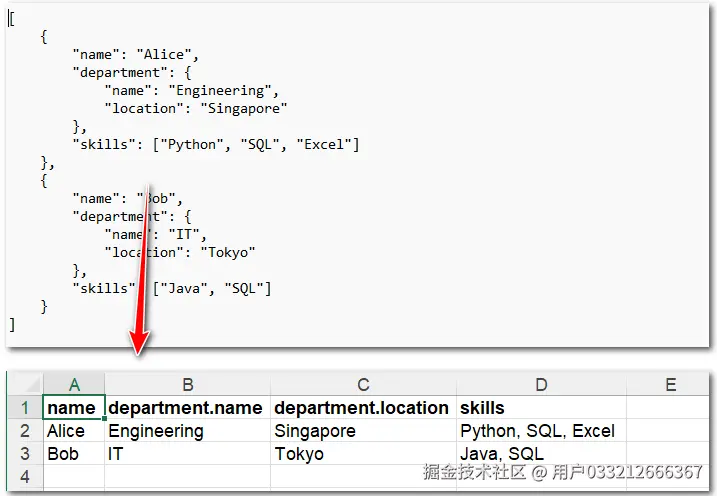
这段代码还有几个值得注意的地方:
-
使用所有字段的并集作为表头。 不同记录可能包含不同的嵌套字段。如果只读取第一条记录的键,可能会遗漏后续记录中的字段。通过遍历所有展开后的记录,可以确保出现过的字段都被纳入表头。
-
可以手动指定需要的字段。 如果不需要导出所有数据,可以直接定义目标字段列表,例如
["id", "address.city", "address.zip"],只写入指定列。 -
将列表元素合并为字符串。
flatten()除了递归展开字典,还会识别列表,并使用", ".join(map(str, value))将列表中的元素拼接起来。例如,["Python", "SQL", "Excel"]会转换为Python, SQL, Excel,写入同一个 Excel 单元格,避免出现列表原有的方括号和引号。
给 Excel 表头添加格式
数据写入完成后,可以进一步调整表格样式,让表头和普通数据更容易区分。
Spire.XLS 提供了 Style.Font 属性,可以设置单元格文字的字体样式。下面以固定列顺序的用户数据为例,为表头添加粗体和文字颜色:
python
import json
from spire.xls import *
from spire.xls.common import *

# (省略:JSON 读取与工作簿创建部分)

columns = ["id", "name", "email", "department"]

for col, name in enumerate(columns, start=1):
    sheet.Range[1, col].Text = name

    # 设置表头字体
    sheet.Range[1, col].Style.Font.IsBold = True
    sheet.Range[1, col].Style.Font.Color = Color.get_CadetBlue()

# 写入数据
for row, record in enumerate(records, start=2):
    for col, name in enumerate(columns, start=1):
sheet.Range[row, col].Text = str(record.get(name, ""))其中,IsBold 用于设置文字是否加粗,Color 则用于指定字体颜色。通过这两个属性,就能让表头在数据区域中更加醒目。
如果需要进一步调整表格样式,还可以根据实际需求设置字体大小、背景填充和对齐方式等属性。
自动调整 Excel 列宽
JSON 中的字段值长度可能相差较大。如果使用默认列宽,较长的内容可能无法完整显示。可以在写入数据后调用 AutoFitColumns(),根据内容自动调整列宽。
python
import json
from spire.xls import *
from spire.xls.common import *

# (省略:JSON 读取、数据写入与表头格式设置部分)

# 根据内容自动调整列宽
sheet.AllocatedRange.AutoFitColumns()

workbook.SaveToFile(outputFile, ExcelVersion.Version2013)
workbook.Dispose()
这里的 AllocatedRange 表示工作表中已分配的单元格区域。相比手动指定单元格范围,使用它可以适应不同数据量的情况。调用 AutoFitColumns() 后,各列宽度会根据内容自动调整,减少数据显示不完整的问题。
批量转换文件夹中的 JSON 文件
如果需要转换的 JSON 文件较多,可以结合 Python 标准库 os 遍历文件夹,逐个读取并生成对应的 Excel 文件。
下面的示例会遍历 json_files 文件夹中的 JSON 文件,并将转换结果保存到 excel_files 文件夹中:
python
import json
import os
from spire.xls import *
from spire.xls.common import *

inputFolder = "./json_files"
outputFolder = "./excel_files"

if not os.path.exists(outputFolder):
    os.makedirs(outputFolder)

for name in os.listdir(inputFolder):
    if not name.lower().endswith(".json"):
        continue

    inputPath = os.path.join(inputFolder, name)
    outputPath = os.path.join(
        outputFolder,
        os.path.splitext(name)[0] + ".xlsx"
    )

    with open(inputPath, "r", encoding="utf-8") as f:
        records = json.load(f)

    workbook = Workbook()
    sheet = workbook.Worksheets[0]

    # 使用第一条记录的键作为表头
    columns = list(records[0].keys())

    for col, key in enumerate(columns, start=1):
        sheet.Range[1, col].Text = key
        sheet.Range[1, col].Style.Font.IsBold = True

    # 写入数据
    for row, record in enumerate(records, start=2):
        for col, key in enumerate(columns, start=1):
            value = record.get(key, "")
            sheet.Range[row, col].Text = "" if value is None else str(value)

    sheet.AllocatedRange.AutoFitColumns()
    workbook.SaveToFile(outputPath, ExcelVersion.Version2013)
    workbook.Dispose()
代码通过 os.listdir() 获取目录中的文件,并使用 endswith(".json") 筛选 JSON 文件。转换时,每个文件都会创建一个新的 Workbook,完成数据写入和保存后,再调用 Dispose() 释放资源。
这里的示例沿用前面介绍的简单字典列表结构。如果文件夹中的 JSON 结构不完全一致,或者包含嵌套对象,需要根据实际数据调整字段提取和写入逻辑。
实用技巧与注意事项
使用 Python 将 JSON 转换为 Excel 时,可以留意以下几点:
注意 JSON 的数据结构。 本文的基本转换和批量处理示例适用于由字典组成的非空列表。如果 JSON 根节点是单个字典,或者数据包含多层嵌套结构,需要先根据实际情况调整处理逻辑。
根据需求决定列顺序。 如果只需要导出指定字段,可以提前定义列名列表,而不必直接使用 JSON 中的全部键。这样也能保证多份文件转换后的列顺序一致。
注意单元格的数据类型。 示例使用 Text 属性将数据写入单元格,因此会将数字、日期等值转换为文本。如果后续还需要在 Excel 中进行数值计算,应根据数据类型选择合适的单元格赋值方式。
读取 JSON 时指定编码。 使用 encoding="utf-8" 可以正确读取包含中文等非 ASCII 字符的 JSON 文件,减少乱码问题。
批量处理时及时释放资源。 每个工作簿保存完成后调用 Dispose(),避免处理大量文件时持续占用内存和其他资源。
总结
使用 Python 将 JSON 转换为 Excel,可以先通过标准库 json 读取数据,再借助 Spire.XLS 创建工作簿并将字段和值写入对应的单元格。对于结构简单的数据,可以直接将字典键作为表头;如果需要统一列顺序,可以提前指定字段列表;遇到嵌套字典,则可以先递归展开,再写入 Excel。完成数据转换后,还可以根据需要设置表头样式、自动调整列宽,或结合 os 批量处理文件夹中的 JSON。通过这些方法,可以将原本不便查看的 JSON 数据整理成更直观、易于分析和共享的 Excel 表格。