上周帮朋友做模拟面试,被问到一道老牌场景题:"如果让你从零设计一套对外开放的 API 接口,你会怎么做?"
这题几乎是大厂后端面试的必考题,但大部分人答不好------要么上来就堆 @PostMapping,要么把 RESTful 八股背一遍就完事。我在实际项目里从零搭过两套开放平台,也救过不少"接口裸奔"的火,这篇文章就把完整的答案拆开揉碎讲清楚:从设计原则、契约规范,到安全、幂等、限流、可观测,每个点都配上生产可用的代码。
无论你是准备面试,还是真的要给团队搭一套 API,这篇都能直接用。
一、先别急着写代码:动手前的四件事
实际开发中我们经常遇到一种情况:需求一来,打开 IDEA 就是干。结果接口写完,前端说字段不对,安全说没鉴权,运维说没法监控------返工三遍。
所以第一件事是澄清场景,我会先问四个问题:
- 谁调用? 内部服务、前端,还是第三方开放平台?这直接决定安全等级。
- 并发量级? QPS 是 100 还是 10 万?决定要不要网关限流、缓存、异步。
- 一致性要求? 能不能容忍重复下单、少扣一次库存?决定幂等做到什么程度。
- 迭代节奏? 接口会不会频繁变更?决定版本策略和兼容方案。
这四点没问清楚就动手,大概率返工。面试里也是一样------先澄清是加分项,上来就写 Controller 是减分项。
基于这四问,我给自己定了五条设计铁律,后面所有方案都围绕它们展开:
- 语义清晰:见名知意,符合 RESTful 规范,最大化降低对接成本;
- 容错优先:默认外部调用不可靠,幂等、限流、降级全部前置设计;
- 安全底线:鉴权、脱敏、防篡改、防重放,一层不能少;
- 可观测可治理:接口上线第一天就要能监控、能排查、能管控;
- 兼容迭代:支持平滑版本升级,绝不强制客户端同步改造。
二、一张图看清:一个请求要过几道关
API 设计不是写一个接口,而是覆盖「接入 → 业务 → 治理 → 运维」的全生命周期。一个请求从客户端打到数据库,要过这些关:
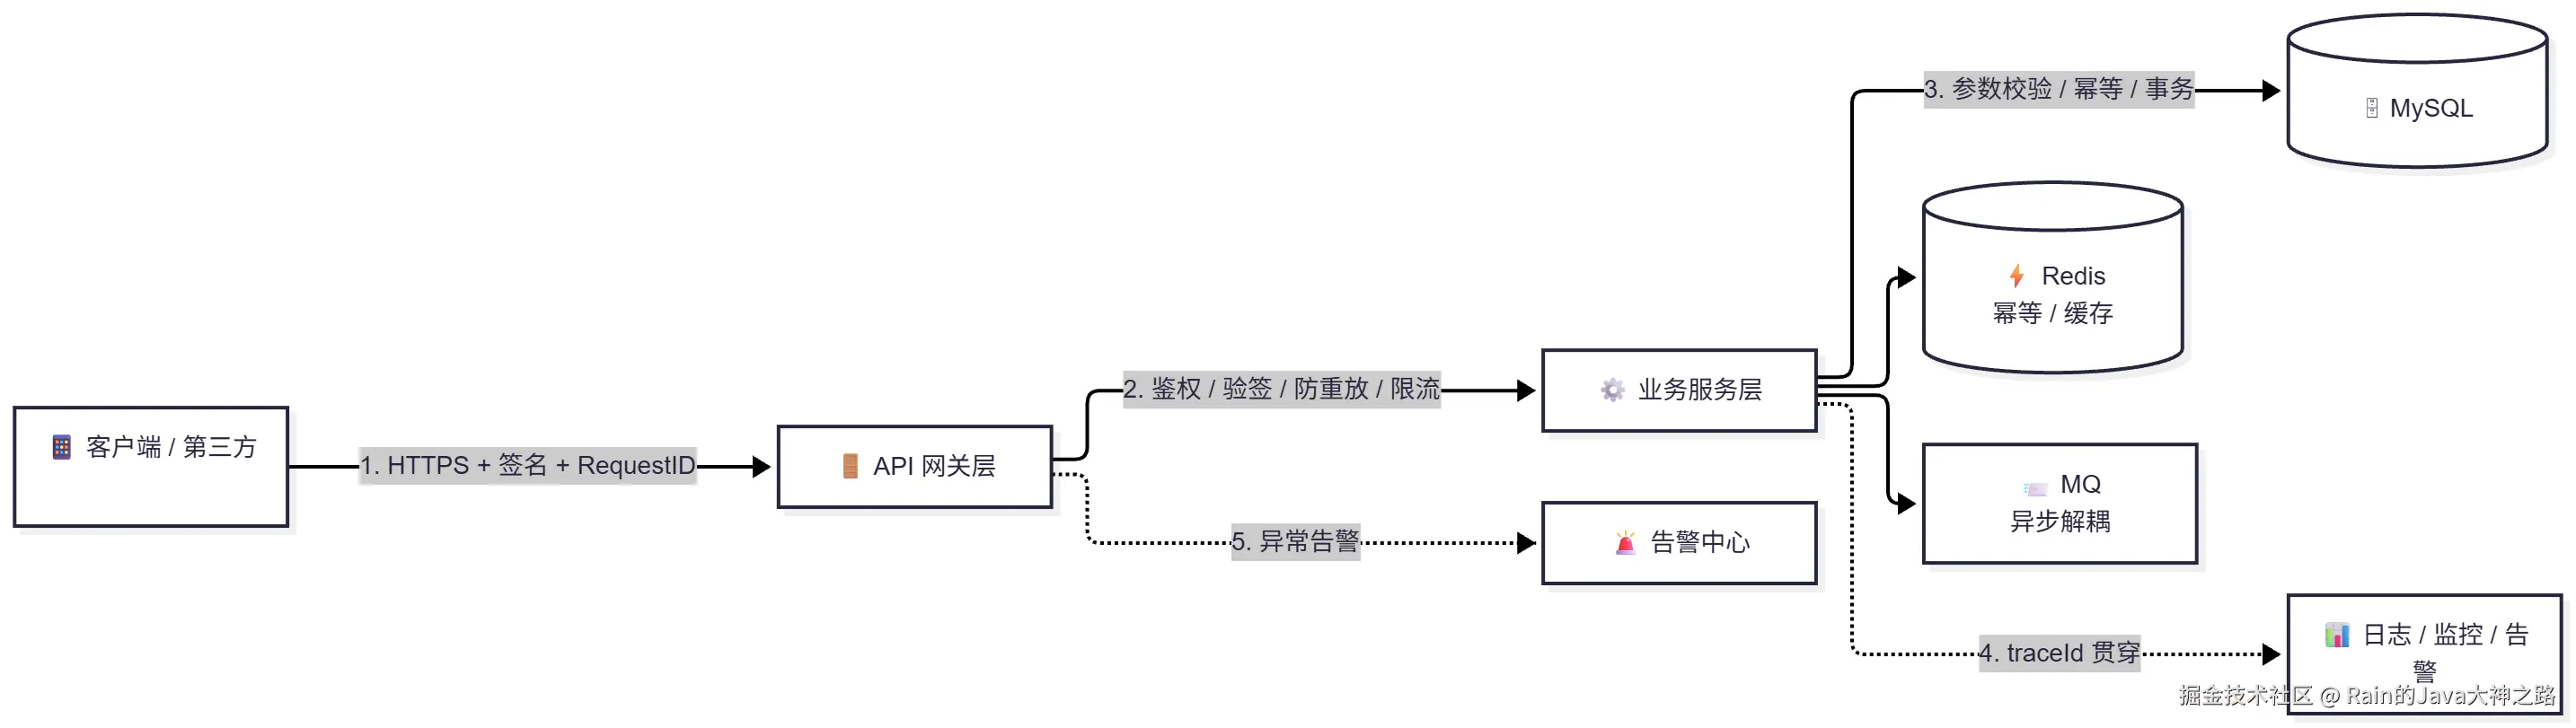
各层的职责划分:
| 架构层级 | 核心职责 | 关键技术点 |
|---|---|---|
| 接入层(网关) | 流量入口、统一管控 | HTTPS、路由转发、身份鉴权、全局限流、黑白名单、灰度 |
| 业务层(服务) | 业务逻辑、接口语义 | RESTful 规范、统一返回体、参数校验、幂等控制、异常处理 |
| 治理层 | 稳定性保障 | 限流熔断、降级兜底、链路追踪、指标监控 |
| 交付层 | 对接与维护 | OpenAPI 文档、SDK、版本管理、错误码规范、变更通知 |
一句话原则:能放网关的别放业务,能在入口拦住的别打到数据库。
下面逐层拆解。
三、契约设计:接口"长什么样",先立规矩
契约是调用方看到的第一张脸,这一层决定接口"好不好用"。
3.1 RESTful 资源建模,外加一个务实例外
核心规则就几条:
- 资源用名词复数 ,动作用 HTTP Method 表达:
GET查、POST增、PUT全量改、PATCH局部改、DELETE删; - 路径层级不超过 3 级 ,
/users/{id}/orders到头了; - 统一小写 ,多单词用短横线:
/user-info而不是/userInfo; - 版本号放 URL 路径:
/api/v1/xxx。
以订单为例:
| 动作 | 方法 | URL | 幂等 |
|---|---|---|---|
| 创建订单 | POST |
/api/v1/orders |
否,靠 requestId 做幂等 |
| 查询订单 | GET |
/api/v1/orders/{id} |
是 |
| 分页查询 | GET |
/api/v1/orders?pageNo=1&pageSize=20 |
是 |
| 取消订单 | POST |
/api/v1/orders/{id}/cancel |
是(状态机保证) |
| 修改备注 | PATCH |
/api/v1/orders/{id} |
否 |
反面教材见过太多了:
text
# ❌ 动词进路径、命名风格混乱
POST /api/v1/getUserInfo
POST /api/v1/createOrder
GET  /api/v1/DeleteUser
💡 务实比教条重要 :纯 RESTful 遇到复杂场景会很别扭。取消订单、支付这类"动作",直接用
/orders/{id}/cancel反而更清晰;批量查询、导出这种条件复杂的场景,退化为POST /api/v1/orders/batch-query也完全可以------还能避免 GET 参数超长。
HTTP 方法的语义差异,面试也常考:
| 方法 | 语义 | 幂等 | 安全 | 典型状态码 |
|---|---|---|---|---|
GET |
查询资源 | ✅ | ✅ | 200 / 404 |
POST |
创建资源 | ❌ | ❌ | 201 / 409 |
PUT |
全量更新 | ✅ | ❌ | 200 / 412 |
PATCH |
局部更新 | ❌ | ❌ | 200 |
DELETE |
删除资源 | ✅ | ❌ | 204 / 404 |
3.2 统一返回体:前端最感激你的设计
所有接口返回格式完全统一,调用方一套解析逻辑通吃:
json
{
  "code": 0,
  "message": "success",
  "data": { "orderId": "1001", "status": "CREATED" },
  "traceId": "a1b2c3d4",
  "timestamp": 1717888888888
}
Java 侧的实现,泛型 + 静态工厂方法,业务代码极简:
java
/**
 * 统一返回体
 * 亮点:code 是业务码(与 HTTP 状态码解耦),traceId 随响应返回,排障利器
 */
@Data
public class Result<T> {
    private int code;        // 业务状态码
    private String message;  // 面向人的提示
    private T data;          // 业务数据,失败为 null,禁止裸 null 歧义
    private long timestamp;  // 便于排查时序
    private String traceId;  // 🔥 全链路追踪 ID

    public static <T> Result<T> ok(T data) {
        return build(ErrorCode.SUCCESS, data);
    }

    public static <T> Result<T> fail(ErrorCode ec) {
        return build(ec, null);
    }

    private static <T> Result<T> build(ErrorCode ec, T data) {
        Result<T> r = new Result<>();
        r.code = ec.getCode();
        r.message = ec.getMsg();
        r.data = data;
        r.timestamp = System.currentTimeMillis();
        r.traceId = MDC.get("traceId");   // 从日志上下文取,与链路对齐
        return r;
    }
}错误码要分段管理,别乱编号,看到码的第一段就知道问题出在哪一层:
| 区间 | 含义 | 示例 |
|---|---|---|
0 |
成功 | SUCCESS |
1xxxx |
参数/校验类 | 10001 参数缺失、10002 重复请求 |
2xxxx |
权限/安全类 | 20001 未登录、20002 无权限 |
3xxxx |
业务类 | 30001 库存不足 |
4xxxx |
系统/第三方 | 40001 系统繁忙、40002 RPC 超时 |
按模块分(2xxxx 用户、3xxxx 订单)或者用阿里风格的 A0400/B0500 前缀也都可行,团队统一就好,核心是业务码与 HTTP 状态码解耦、每个码文档化。
💡 返回码双层设计 :HTTP 状态码表达传输层语义(200/401/429/500),方便网关和基础设施统一处理;body 里的
code表达业务语义,方便调用方精确定位。
3.3 分页:游标分页,别踩深分页的坑
所有列表接口必须强制分页 ,上限 size <= 100,禁止无 limit 全表查询。但普通分页有个经典坑:
sql
-- ❌ 深分页:limit 100000, 20,数据库要扫描并丢弃前 10 万行
-- ✅ 游标分页:用上次的最后一条 id 做游标
SELECT * FROM orders
WHERE user_id = ?
  AND id < ?        -- cursor:上一页最后一条的 id
ORDER BY id DESC
LIMIT 20;
游标分页没有 offset,配合索引就是一次范围扫描,性能天差地别。C 端无限滚动场景用它准没错。
3.4 参数校验:第一道业务防火墙
校验的原则三条:脏参数绝不允许穿透到 Service 打数据库。落地方式:
- 参数不超过 6 个,超出就封装 DTO;
- 用
@Valid+ JSR-303 注解做声明式校验; - 校验失败统一走全局异常,返回明确错误码。
java
@Data
public class CreateOrderReq {
    @NotNull(message = "用户ID不能为空")
    private Long userId;

    @NotBlank(message = "商品编码不能为空")
    private String skuCode;

    @Min(value = 1, message = "购买数量至少为1")
    @Max(value = 999, message = "单次购买不得超过999")
    private Integer count;

    @NotBlank(message = "幂等令牌不能为空")
    private String requestId;   // 👈 幂等/防重的钥匙,后面详聊
}分组校验也很实用:新增不校验 id,更新必须校验 id,一个 DTO 两种场景:
java
@PostMapping("/users")
public Result<Long> create(@RequestBody @Validated(CreateGroup.class) UserCreateReq req) { ... }

@PutMapping("/users/{id}")
public Result<Void> update(@PathVariable Long id,
        @RequestBody @Validated(UpdateGroup.class) UserUpdateReq req) { ... }
Controller 保持薄,业务逻辑放 Service:
java
@RestController
@RequestMapping("/api/v1/orders")
@Validated
public class OrderController {

    @Resource
    private OrderService orderService;

    @PostMapping
    @Idempotent(key = "#req.requestId", expire = 30)
    public Result<OrderVO> createOrder(
            @RequestHeader("X-Request-Id") String requestId,
            @Valid @RequestBody CreateOrderReq req) {
        return Result.ok(orderService.createOrder(req, requestId));
    }

    @GetMapping("/{id}")
    public Result<OrderVO> detail(@PathVariable Long id) {
        return Result.ok(orderService.detail(id));
    }
}
3.5 全局异常处理:千万别把堆栈甩给前端
所有异常收敛成同一种响应格式,而且要分层处理:
java
@Slf4j
@RestControllerAdvice
public class GlobalExceptionHandler {

    /** 参数校验异常:精准定位到字段,前端能直接标红 */
    @ExceptionHandler(MethodArgumentNotValidException.class)
    public Result<Void> handleValid(MethodArgumentNotValidException e) {
        String msg = e.getBindingResult().getFieldErrors().stream()
                .map(f -> f.getField() + ": " + f.getDefaultMessage())
                .collect(Collectors.joining("; "));
        log.warn("参数校验失败 msg={}", msg);
        return Result.fail(ErrorCode.PARAM_ERROR.withMsg(msg));
    }

    /** 业务异常:可预期,WARN 级别,不打 error 堆栈污染告警 */
    @ExceptionHandler(BusinessException.class)
    public Result<Void> handleBiz(BusinessException e) {
        log.warn("业务异常 traceId={} code={}", MDC.get("traceId"), e.getCode());
        return Result.fail(e.getErrorCode());
    }

    /** 兜底异常:堆栈只进日志,对外只给 traceId */
    @ExceptionHandler(Exception.class)
    public Result<Void> handleUnknown(Exception e, HttpServletRequest req) {
        String traceId = MDC.get("traceId");
        log.error("系统异常 uri={} traceId={}", req.getRequestURI(), traceId, e);
        return Result.fail(ErrorCode.SYSTEM_ERROR.withMsg("系统繁忙,请稍后重试[" + traceId + "]"));
    }
}
⚠️ 这条是安全红线:生产环境把异常堆栈返回给调用方,等于把系统架构、依赖版本拱手送给攻击者。堆栈只进日志,对外的永远是"系统繁忙 + traceId"。用户报障甩过来一个 ID,你直接查全链路日志,效率拉满。
能把参数异常 / 业务异常 / 系统异常分开处理的人,面试官一看就知道线上排过障。
四、安全设计:别只会说"加 HTTPS"
很多人以为 HTTPS 就够了。其实 HTTPS 只解决传输层窃听,应用层的参数篡改、身份伪造、重放攻击,它一个都管不了。记住一句话:
🔐 加密 ≠ 防篡改,签名 ≠ 保密。 加密只能防"看得到",签名才能防"改得了",防重放才能防"发两遍"。
我的方案是四道防线,层层递进:HTTPS 传输加密 → JWT/OAuth2 身份认证 → 参数签名防篡改 → 时间戳 + nonce 防重放。
4.1 签名 + 防重放的完整链路
给每个合作方发 AppKey + AppSecret,调用方把参数按字典序排序拼接,连同 timestamp、nonce、请求体摘要一起算 HMAC-SHA256 签名:
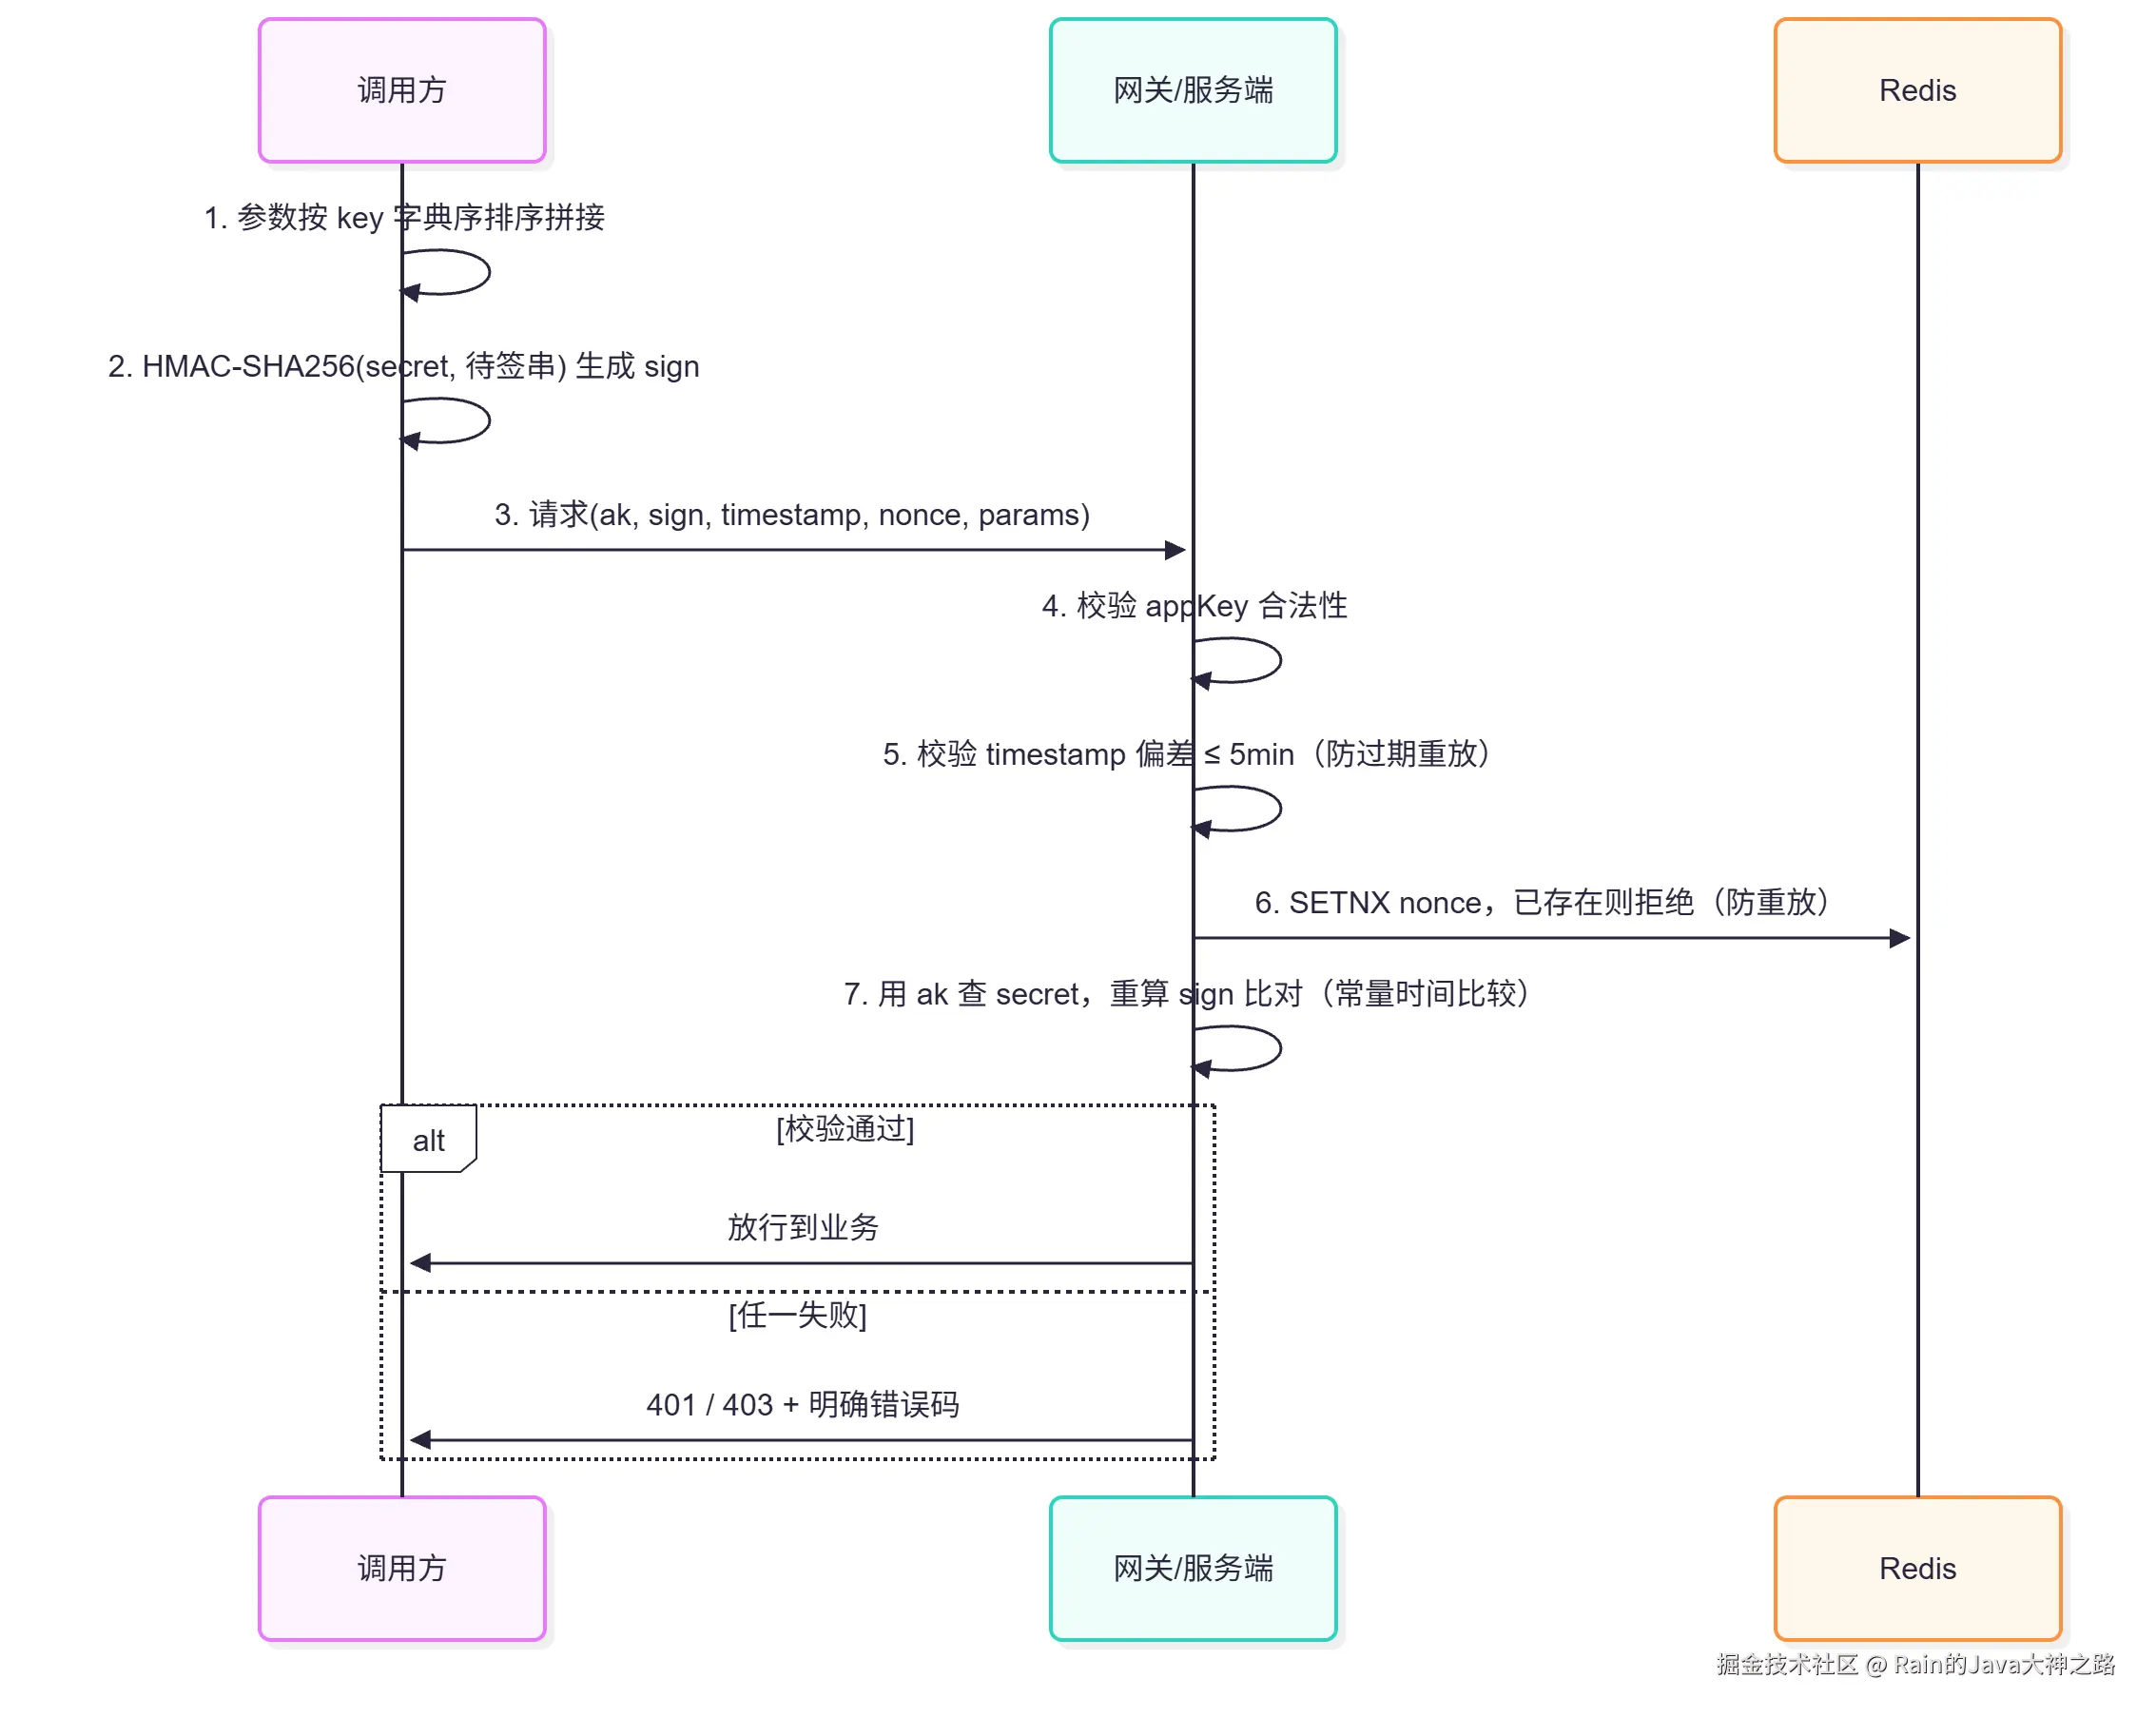
签名工具类核心代码:
java
public final class SignatureUtil {

    /** 1. 参数按字典序拼接:k1=v1&k2=v2(空值、sign 本身不参与) */
    public static String buildSignContent(Map<String, String> params) {
        return params.entrySet().stream()
                .filter(e -> StringUtils.hasText(e.getValue()) && !"sign".equals(e.getKey()))
                .sorted(Map.Entry.comparingByKey())
                .map(e -> e.getKey() + "=" + e.getValue())
                .collect(Collectors.joining("&"));
    }

    /** 2. HMAC-SHA256 签名(比 MD5 更抗长度扩展攻击) */
    public static String sign(String content, String secret) {
        try {
            Mac mac = Mac.getInstance("HmacSHA256");
            mac.init(new SecretKeySpec(secret.getBytes(StandardCharsets.UTF_8), "HmacSHA256"));
            return Hex.encodeHexString(mac.doFinal(content.getBytes(StandardCharsets.UTF_8)));
        } catch (Exception e) {
            throw new BusinessException(ErrorCode.SIGN_ERROR);
        }
    }

    /** 3. 常量时间比较,防时序攻击 ⭐ */
    public static boolean safeEquals(String a, String b) {
        return MessageDigest.isEqual(a.getBytes(StandardCharsets.UTF_8),
                                     b.getBytes(StandardCharsets.UTF_8));
    }
}服务端校验,顺序很重要:先身份 → 再时效 → 再防重 → 最后验签,出错时最容易定位是哪一步挂的:
java
public boolean verify(SignRequest req) {
    // ① appKey 是否合法
    String secret = appKeyRepo.getSecret(req.getAppKey());
    if (secret == null) throw new BusinessException(ErrorCode.APP_KEY_INVALID);

    // ② timestamp 是否在有效窗口内(±5 分钟),防过期重放
    long diff = Math.abs(System.currentTimeMillis() - req.getTimestamp());
    if (diff > 5 * 60 * 1000) throw new BusinessException(ErrorCode.REQUEST_EXPIRED);

    // ③ nonce 一次性:Redis SETNX 原子占位,同一个包只能用一次
    String nonceKey = "sign:nonce:" + req.getAppKey() + ":" + req.getNonce();
    Boolean first = redis.opsForValue().setIfAbsent(nonceKey, "1", Duration.ofMinutes(6));
    if (Boolean.FALSE.equals(first)) throw new BusinessException(ErrorCode.REPLAY_ATTACK);

    // ④ 服务端按同一规则重算签名并比对(签名材料包含 body 摘要,防请求体篡改)
    String raw = buildSignContent(req.getParams()) + req.getTimestamp() + req.getNonce()
            + DigestUtils.sha256Hex(req.getBody());
    String expect = SignatureUtil.sign(raw, secret);
    if (!SignatureUtil.safeEquals(expect, req.getSign())) {
        throw new BusinessException(ErrorCode.SIGN_MISMATCH);
    }
    return true;
}
几个容易忽略但含金量很高的细节:
⭐ 技术亮点一 :
MessageDigest.isEqual做常量时间比较 。普通equals是逐字符短路返回的,攻击者可以根据响应耗时逐字节"猜"签名------这叫时序攻击。常量时间比较堵死这条路。⭐ 技术亮点二 :nonce 必须落 Redis,只验签不验 nonce 等于没防重放。签名再对,人家把抓到的合法请求原样重发一万次,你照样崩。
⭐ 技术亮点三 :大请求体别把整段文本拼进签名串,CPU 会飙。对 body 算个 SHA-256 摘要再参与签名即可。
⭐ 技术亮点四 :nonce 的
SETNX是原子操作;如果非要用EXISTS+SETEX两步走,记得包进 Lua 脚本,否则并发下两个相同 nonce 可能都通过判断------典型的 check-then-act 竞态。
4.2 其他必答的安全点
| 风险 | 解决方案 | 关键点 |
|---|---|---|
| 越权访问 | 每次查询校验数据归属 | 别只信前端传的 userId,从登录态取并校验 owner |
| SQL 注入 | MyBatis #{},禁止 ${} |
Code Review 卡点 |
| 敏感数据泄露 | 手机号/身份证/银行卡脱敏 | 返回和日志都要脱敏 |
| 恶意刷接口 | 网关限流 + 验证码 + IP 黑名单 | 区分正常用户限流和恶意攻击 |
| 密钥安全 | AppSecret 配置中心管理,定期轮换 | 禁止硬编码、禁止固定密钥 |
脱敏别在业务代码里零散处理,容易漏。用 Jackson 自定义序列化器 + 注解,声明式搞定:
java
@Sensitive(SensitiveType.PHONE)   // 序列化时自动变成 138****5678
private String phone;
五、幂等设计:这道题拉开差距的地方
聊到这里,好用的部分讲完了,接下来是"崩不崩"的部分。幂等是重中之重,也是面试官最爱深挖的点。
先厘清一个高频误区:幂等 ≠ 并发控制。并发控制解决"同时改",幂等解决"改多次"。幂等的本质是------同一个请求执行 1 次和执行 100 次,系统状态完全一样。就像电梯按钮,你按 10 次也只来一部电梯。
重复请求从哪来?一定要答全:
- 🙋 前端重复提交:按钮没置灰、用户狂点;
- 🌐 网络超时重试:客户端没收到响应,自动重发;
- 🚪 网关/RPC 自动重试:Nginx、Feign 超时重传;
- 📨 MQ 重复消费:at-least-once 语义决定消息可能投递多次。
不做幂等的后果不用我多说:重复下单、重复扣款、重复发券------每一个都是 P0 事故。
5.1 五大方案怎么选
| 方案 | 适用场景 | 优点 | 坑点 |
|---|---|---|---|
| 🥇 唯一索引 | 创建类(下单、支付流水) | 最简单,数据库兜底最稳 | 依赖业务唯一键(如 biz_no) |
| 🥈 Token 预领取 | 前端防重复提交 | 提交前先拿 token,天然只生效一次 | 需额外一次请求 |
| 🥉 状态机 + 乐观锁 | 更新类(订单流转) | 带条件 UPDATE 天然幂等,最稳 | 需严谨设计状态流转 |
| Redis SETNX / Lua | 通用场景 | 性能好,可做成注解零侵入 | 要注意失败释放、原子性 |
| 分布式锁 | 通用兜底 | 灵活 | 注意锁粒度、超时、可重入 |
实战里我的标准搭配是:Redis 前置拦截 + 数据库唯一索引兜底,双保险。Redis 挂了还有唯一索引兜着。
5.2 注解式幂等:AOP + Redis Lua(生产级实现)
自己手写每个接口的幂等逻辑太蠢,封装成注解,业务代码零侵入:
java
@Target(ElementType.METHOD)
@Retention(RetentionPolicy.RUNTIME)
public @interface Idempotent {
    String key();                   // 幂等键,支持 SpEL:#req.requestId
    long expire() default 30;       // 令牌有效期(秒)
    String message() default "请求正在处理,请勿重复提交";
}
切面实现,用 Lua 脚本保证原子性,还区分了「处理中」和「已完成」两种状态:
java
@Aspect
@Component
@RequiredArgsConstructor
public class IdempotentAspect {

    private final StringRedisTemplate redis;

    // ✅ Lua 保证「判断 + 占位」原子执行,杜绝并发下的 check-then-act 漏洞
    private static final DefaultRedisScript<Long> SCRIPT = new DefaultRedisScript<>("""
        local v = redis.call('GET', KEYS[1])
        if v == 'PROC' then return -1 end          -- 处理中
        if v == 'DONE' then return -2 end          -- 已完成
        redis.call('SET', KEYS[1], 'PROC', 'EX', ARGV[1])
        return 1
        """, Long.class);

    @Around("@annotation(idem)")
    public Object around(ProceedingJoinPoint pjp, Idempotent idem) throws Throwable {
        String key = "idem:" + SpelParser.parse(idem.key(), pjp);
        Long r = redis.execute(SCRIPT, List.of(key), String.valueOf(idem.expire()));

        if (r == -1) throw new BusinessException(ErrorCode.REPEAT_PROCESSING, idem.message());
        if (r == -2) return Result.ok(null);   // 🎯 幂等成功:直接返回,不重复执行

        try {
            Object ret = pjp.proceed();
            redis.opsForValue().set(key, "DONE", idem.expire(), TimeUnit.SECONDS);
            return ret;
        } catch (Throwable t) {
            redis.delete(key);   // ⚠️ 失败必须释放,否则接口永久堵死
            throw t;
        }
    }
}
用法一行注解:
java
@PostMapping("/pay")
@Idempotent(key = "#req.orderNo", expire = 60)
public Result<PayVO> pay(@Valid @RequestBody PayReq req) { ... }
⭐ 答出这三点就赢了 :① 用 Lua 保证"判断 + 占位"的原子性;② 区分「处理中」和「已完成」两种状态;③ 异常必须删 key------这是我之前踩过的真坑,第一次请求失败后 key 还在,用户修正参数重试永远被拒绝,接口等于废了。
💡 更进一步的体验优化:成功后把响应结果整个缓存进 key 里,重复请求直接返回首次的结果。用户重复点击下单,拿到的是同一个订单号,而不是一句冷冰冰的"请勿重复提交"。
5.3 状态流转场景:状态机 + 乐观锁
更新类接口(订单支付、取消),最稳的方案是把"判断状态"和"更新"合并成一条带条件的 SQL:
sql
-- 只有当前状态是"待支付"时才允许流转为"已支付"
UPDATE orders
SET status = 'PAID', update_time = NOW(), version = version + 1
WHERE id = #{id} AND status = 'UNPAID' AND version = #{version};

-- 影响行数为 0:说明状态已变更(重复请求或非法请求),直接返回,不重复发货
由数据库保证原子性,天然扛并发,比"先查后改"安全得多。
5.4 前端防重:Token 预领取
还有一个常被问到的变体------进入表单页时先领一个一次性 Token:
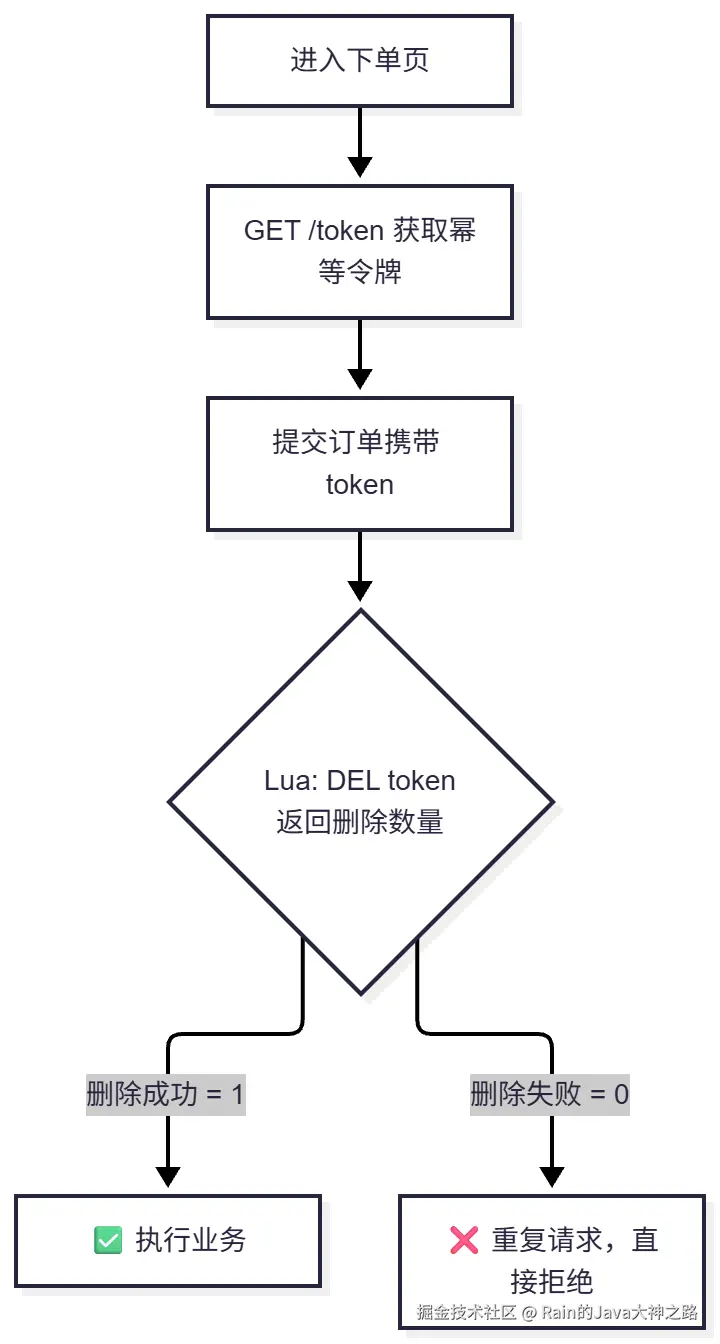
为什么用 DEL 而不是 GET + DELETE?一行 Lua 搞定原子判断加删除,连分布式锁都省了。用对数据结构,少写十行业务。
最后补一个概念辨析:防重提交是事前减少重复请求,幂等是事后保证结果一致,两者配合使用,不是二选一。
六、限流与降级:接口活着才是硬道理
公网 API 不限流,等于把家门钥匙挂在门口。
6.1 分布式限流:Redis + Lua 令牌桶
单机限流用 Guava RateLimiter 够了,集群环境必须上 Redis + Lua。令牌桶的好处是平滑限流且允许一定突发:
lua
-- KEYS[1]=桶key  ARGV: rate(每秒生成)、capacity、now(ms)、requested
local b = redis.call('HMGET', KEYS[1], 'tokens', 'ts')
local tokens = tonumber(b[1]) or tonumber(ARGV[2])
local ts     = tonumber(b[2]) or ARGV[3]
local now    = tonumber(ARGV[3])
tokens = math.min(ARGV[2], tokens + (now - ts) / 1000 * ARGV[1])  -- 按时间差补充令牌
if tokens < tonumber(ARGV[4]) then
    return 0                                    -- ⛔ 令牌不足
end
redis.call('HMSET', KEYS[1], 'tokens', tokens - ARGV[4], 'ts', now)
redis.call('EXPIRE', KEYS[1], 60)
return 1
计算全部在 Redis 内完成,分布式、无误差。同样封装成 @RateLimit(qps = 100) 注解 + AOP,业务无感。
6.2 固定窗口的坑:临界突刺
面试如果被问"为什么不用固定窗口计数",画个图就赢了:
text
固定窗口缺陷(临界突刺):
        │← 窗口1 →│← 窗口2 →│
   100个│         │100个    │
   请求 │█ █ █ █ █│█ █ █ █ █│
────────┴─────────┴─────────┴──→ t
              ↑
        窗口交界处:1秒内可能放过 200 个请求!💥
滑动窗口:请求时间戳连续记录在 ZSet 中,任意1秒内统计值都不会超阈值 ✅
滑动窗口用 Redis ZSet 实现,Lua 一把梭:
lua
local key = KEYS[1]
local now = tonumber(ARGV[1])
local window = tonumber(ARGV[2])
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)   -- 踢出窗口外的旧记录
local count = redis.call('ZCARD', key)
if count < tonumber(ARGV[3]) then
    redis.call('ZADD', key, now, now .. '-' .. math.random())
    redis.call('PEXPIRE', key, window)
    return 1
end
return 0
6.3 限流维度与降级兜底
限流要分层:AppKey 总量 → 接口级 → 用户级 → IP 级,超限返回 HTTP 429 + Retry-After 头,调用方一看就知道多久后再试。达到 80% 阈值就告警,准备扩容。
降级和隔离也不能少:
- 熔断降级 :内部服务慢了,Sentinel/Resilience4j 熔断器打开,非核心接口直接返回缓存的兜底数据,不死扛导致雪崩;注意核心接口不能降级;
- 线程池隔离:核心接口独立线程池,避免非核心接口拖垮整个服务;
- 超时与重试风暴 :上游抖动时重试会放大流量压垮下游,超时时间阶梯化,重试用指数退避 + 抖动,并且只重试幂等接口。
七、性能设计:好用还要跑得快
| 优化点 | 做法 |
|---|---|
| 📄 分页强制化 | 禁止无 limit 全表查询,上限 size <= 100,深分页改游标分页 |
| 🎯 按需返回 | 支持 fields=id,name 字段裁剪,别动辄返回 50 个字段 |
| 📦 大列表压缩 | Nginx 开 gzip,返回体减小 70%+ |
| 🚀 缓存 | 高频读接口加 Redis 分层缓存,注意缓存穿透/击穿/雪崩 |
| 🖼️ 大文件 | 走 OSS 直传,接口只返回 URL |
| 🔗 批量接口 | POST /users/batch-get,避免 N 次循环调用 |
| 📤 大数据导出 | 分批处理,避免 OOM;异步导出走文件下载 |
八、兼容与演进:今天的设计别坑明天的自己
接口一旦上线就是"产品",对外就是一份合同,不能随便改。版本方案对比:
| 方案 | 示例 | 评价 |
|---|---|---|
| URL 路径(推荐) | /api/v1/users → /api/v2/users |
最直观,网关最好路由,日志排查方便 |
| Header | Accept: application/vnd.app.v2+json |
更"优雅",URL 干净,开放平台常用,但排查成本高 |
| 请求参数 | /users?version=2 |
不推荐,容易漏 |
兼容原则一张表:
| 原则 | 做法 |
|---|---|
| 🧷 只增不改不删 | 禁止改字段含义/类型、禁止删字段;新增字段默认可空 |
| 🔄 版本升级 | 小改加字段走 v1;破坏性变更升 v2 |
| ⏳ 废弃过渡期 | 旧版本至少保留 3~6 个月(至少一个季度),响应头加 Deprecation 和 Sunset 字段,提前邮件周知,并监控旧版本调用量 |
| 🎚 灰度发布 | 网关按 AppKey 或 userId % 100 路由到新版本,支持秒级回滚 |
| 🤝 契约测试 | 出参变更先过消费者契约测试(如 Spring Cloud Contract) |
| 📜 枚举兜底 | 枚举新增值时,老调用方要有兜底分支(else -> UNKNOWN) |
还有一个隐蔽的坑:接口出参用 VO,别直接吐 Entity。
java
// ❌ 反面教材:直接返回 Entity,数据库加个字段全接口炸裂,还可能泄露内部字段
@GetMapping("/user/{id}")
public User getUser(@PathVariable Long id) { ... }

// ✅ 正确姿势:VO 隔离 + Swagger 文档注解
@Operation(summary = "查询用户详情")
@GetMapping("/api/v1/users/{id}")
public Result<UserVO> getUser(@PathVariable Long id) { ... }
九、可观测性:出事了能快速定位
接口上线只是开始,能不能快速排障才是生死线。三件套:
- 🆔 TraceID 全链路透传 :网关/入口生成 → MDC → 线程池透传(
TaskDecorator+TransmittableThreadLocal)→ MQ 消息头透传 → 随响应返回给调用方。一条grep定位问题,跨系统扯皮时甩 ID 就完事; - 📊 日志分层 :
access.log(耗时/状态码/入参摘要)+biz.log(关键状态变更)+error.log,日志里必带traceId、userId、requestPath、method、costTime; - 📈 监控告警:QPS、P99 延迟、错误率、错误码分布、限流拒绝数、幂等命中数、慢 SQL、线程池/连接池水位上 Grafana 大盘;错误率 > 1%、P99 > 500ms 即时告警。
文档也别忽视:代码即文档 ,用 SpringDoc/Knife4j 注解自动生成 OpenAPI 文档,接口改了文档自动更新,永不脱节。变更必须提前通知,上线前前后端一起接口评审 + Mock 联调。对外的开放平台,最好再提供 Java/Python SDK,把签名、重试、幂等注入都封装好------对接方十行代码搞定接入,粘性自然就高。
十、两个进阶场景,答出来直接封神
10.1 面试官追问:"高并发下单怎么设计?"
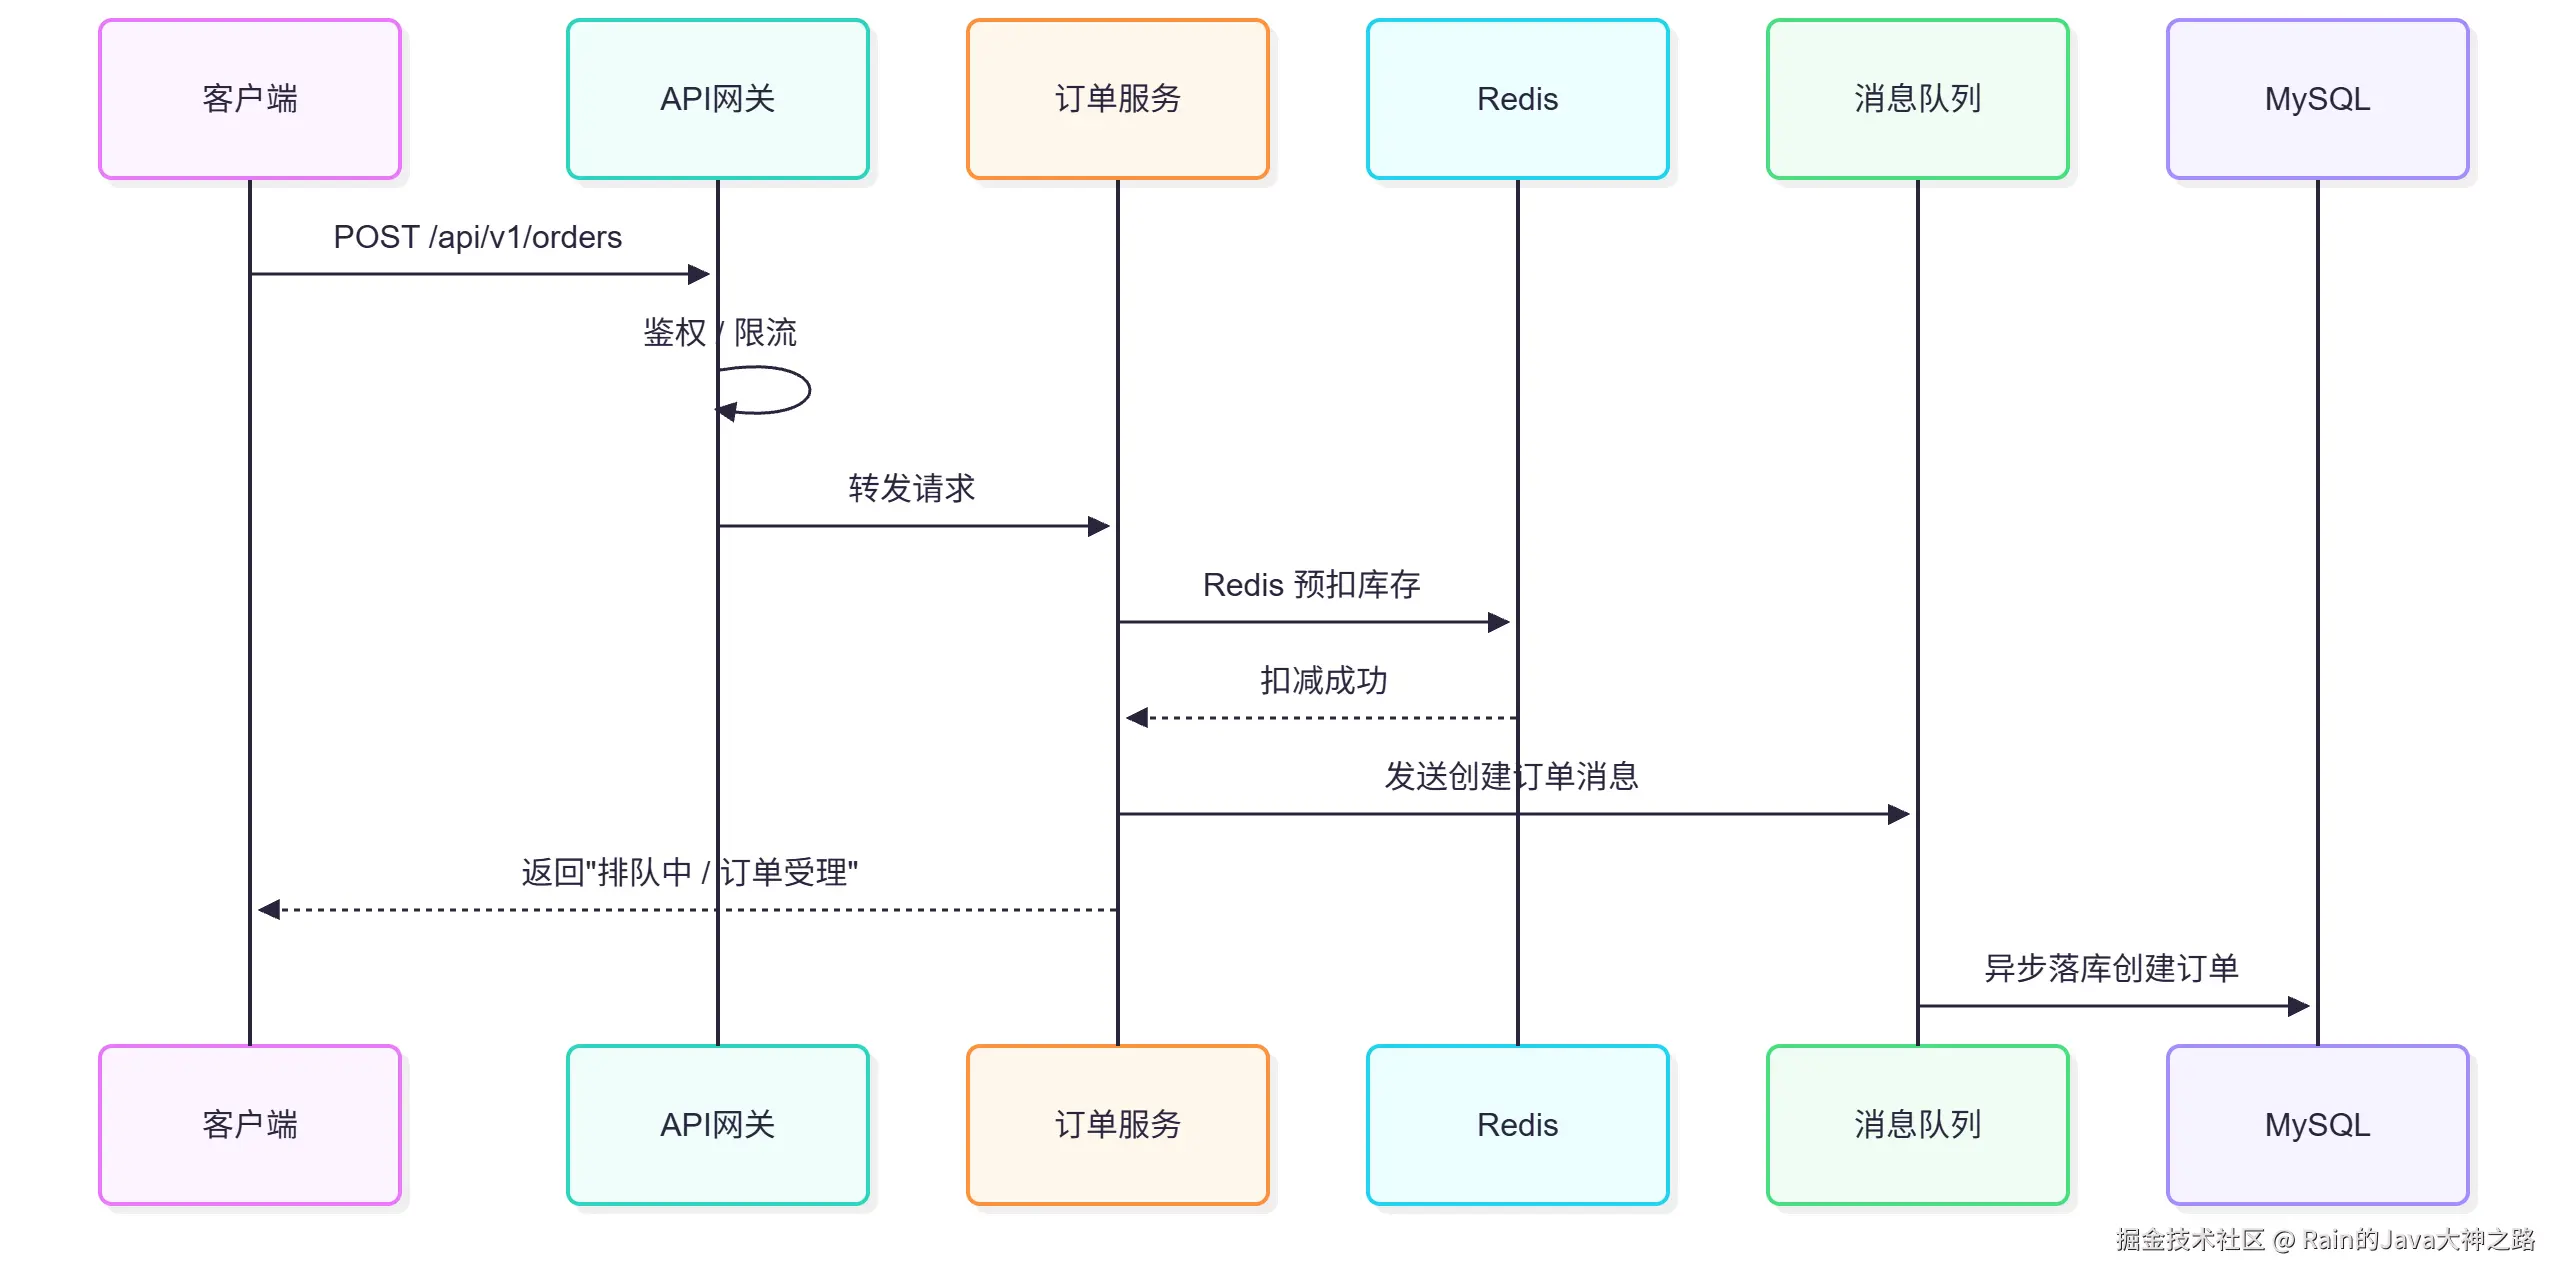
核心思路五步:网关限流先挡一波 → Redis 预扣库存挡住大部分无效请求 → MQ 异步创建订单削峰 → 数据库最终写入保证一致 → 用户轮询或查询接口获取结果。再往下追问一致性,就聊本地消息表 / RocketMQ 事务消息 / 第三方回调的"状态机 + 主动查询 + 定时补偿"。
10.2 面试官追问:"导出大报表耗时很长,接口怎么设计?"
绝不同步阻塞。 接口立即返回 202 Accepted,body 里给一个 taskId,调用方用 /api/v1/tasks/{taskId} 轮询进度;对方有回调能力的话,支持提前注册 webhook,任务完成主动通知。体验拉满,还不占用连接数。
十一、技术难点速查总表(建议收藏)
| # | 技术难点 | 典型现象 | 解决方案 | 关键要点 |
|---|---|---|---|---|
| 1 | 重复提交/幂等 | 重复扣款、重复下单、重复发货 | Token/Lua 幂等 + 唯一索引兜底 + 状态机 | Lua 保证原子;区分处理中/已完成;异常必须删 key |
| 2 | 幂等判断非原子 | 高并发下 GET+SET 之间被打穿 | Redis Lua 脚本或 SET NX EX 一条命令 |
杜绝 check-then-act 竞态 |
| 3 | 请求被重放/篡改 | 合法请求被截获重发、金额被改 | HTTPS + HMAC-SHA256 签名 + timestamp + nonce | nonce 必须落 Redis;签名含 body 摘要;常量时间比较 |
| 4 | 垂直/水平越权 | A 用户查到 B 用户数据 | 鉴权注解 + 数据归属校验 | 每次查数据校验 owner,别信前端传的 id |
| 5 | 高并发雪崩 | 秒杀/大促接口被打垮,级联影响下游 | 网关令牌桶限流 + Sentinel 熔断降级 + 线程池隔离 | 429 + Retry-After;阈值压测得出;核心接口不降级 |
| 6 | 限流突刺 | 固定窗口临界双倍放行 | ZSet 滑动窗口 / 令牌桶 Lua | 热点 key 拆分 + 本地短窗预占 |
| 7 | 超时与重试风暴 | 上游抖动,重试放大流量压垮下游 | 超时阶梯化 + 指数退避 + 抖动重试 + 熔断 | 只重试幂等接口 |
| 8 | 事务与幂等一致性 | 先落库还是先删幂等 key? | 幂等 key 与业务同库同事务优先;跨库则"先占位 → 业务 → 终态标记",异常删 key | key 的 TTL 要大于业务最大处理时长 |
| 9 | 深分页/大结果集 | LIMIT 100000,20 拖垮 DB |
游标分页 + 覆盖索引;异步导出走文件 | 列表接口禁止全量返回 |
| 10 | 版本不兼容 | 改字段导致老客户端崩溃 | URL 版本化 + 只增不改不删 + 契约测试 + 灰度 | 旧版本保留过渡期,监控调用量 |
| 11 | 敏感数据泄露 | 日志/响应暴露手机号、身份证 | 脱敏注解序列化 + VO 隔离 + 全局异常兜底 | 返回和日志都脱敏;绝不回传堆栈 |
| 12 | 数据一致性 | 库存扣了订单没建 | 本地消息表 / RocketMQ 事务消息 / 最终一致性 | 第三方回调用状态机 + 主动查询 + 定时补偿 |
| 13 | 跨服务排障难 | 出问题日志成孤岛,定位靠猜 | 统一 traceId 贯穿(MDC + TTL + MQ header)+ 全量日志 + 告警 | 响应头返回 traceId 给调用方 |
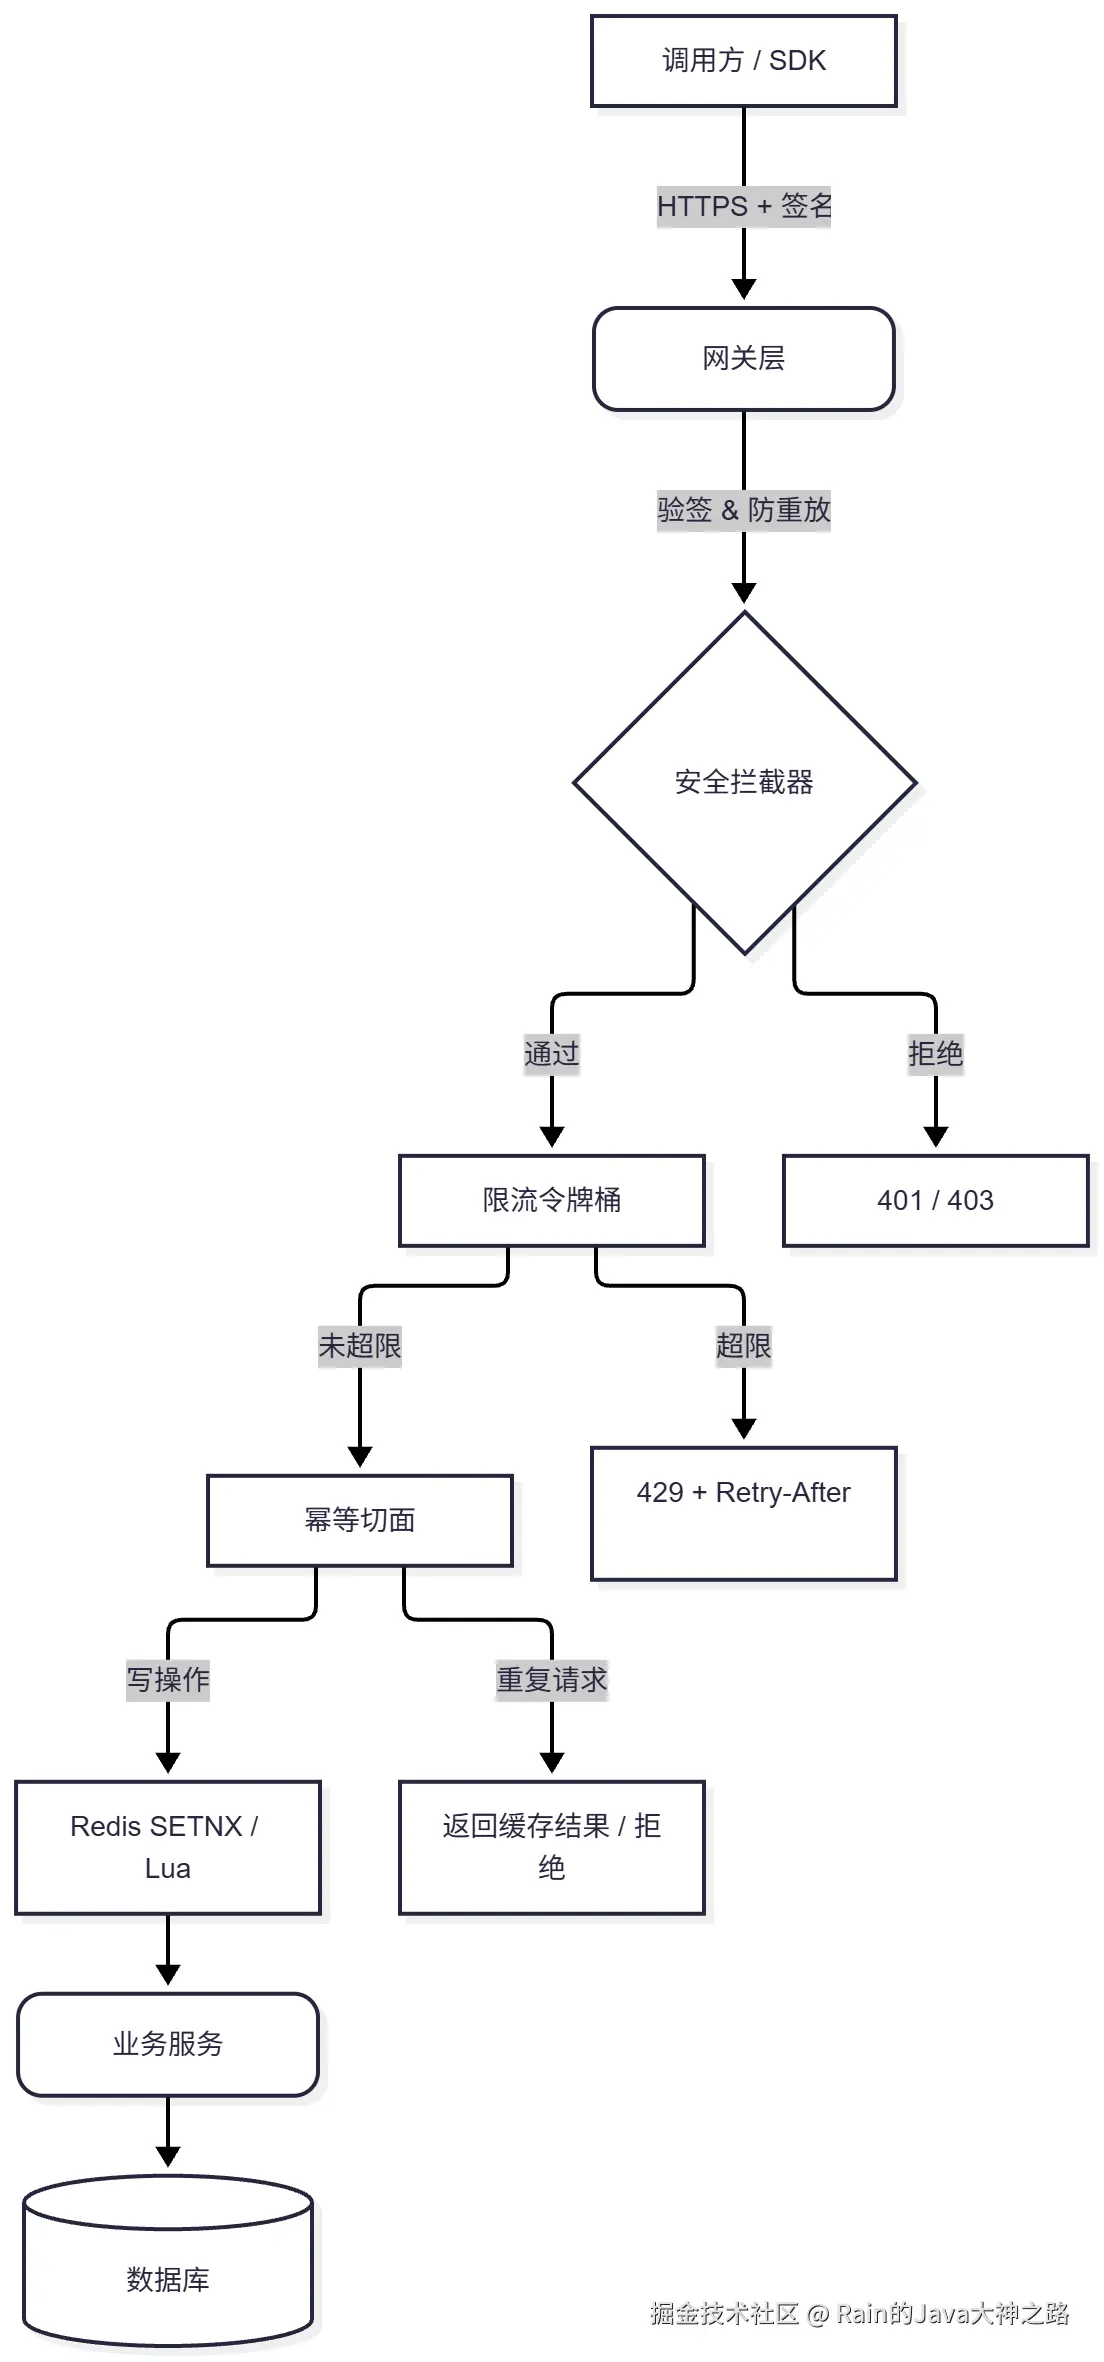
最后放一张防御体系全景图,把核心几道防线串起来:
十二、面试官高频追问(提前备好,直接加分)
| 追问 | 一句话回答 |
|---|---|
| GET 和 POST 怎么选? | 查询/幂等用 GET,变更用 POST;GET 可缓存,URL 会被日志/CDN 记录且有长度限制(浏览器实现而非协议规定),敏感参数绝不走 GET |
| 返回码用 HTTP 状态码还是业务码? | 双层:HTTP 表达传输层语义(200/401/429/500),body 里 code 表达业务语义,方便网关统一处理 |
| 接口超时了,钱扣没扣? | 超时 ≠ 失败。用唯一业务流水号做幂等,让调用方安全重试;同时提供对账查询接口兜底 |
| 如何保证消息/请求顺序? | 业务层面尽量设计成无序;必须顺序则按 bizId 路由到同一分区/串行队列 |
| 幂等 key 过期了但业务还没完成? | key 的 TTL 要大于业务最大处理时长;超长业务用「处理中」状态 + 异步轮询结果接口 |
| 调用方坚持自己生成幂等 key,怎么防冲突? | 强制加 AppKey 租户前缀,如 app_123:order_submit:xxx,隔离租户防伪造撞库,同时限制 key 总长度 |
| 突发 10 倍流量怎么办? | 限流 + 熔断 + 降级(返回兜底/缓存数据)+ MQ 异步削峰 + 弹性扩容 |
| 限流算法怎么选? | 单机用 Guava RateLimiter;分布式用 Redis + 令牌桶 Lua;要绝对平滑用 ZSet 滑动窗口 |
| 幂等和防重提交的区别? | 防重是事前减少重复请求,幂等是事后保证结果一致,两者配合使用 |
| REST 和 GraphQL 怎么选? | 内部聚合查询多、字段裁剪需求强用 GraphQL;通用 CRUD 用 REST 更省心 |
| gRPC 和 REST 怎么选? | 内部服务间高吞吐、强契约用 gRPC/Dubbo;跨团队、跨语言、浏览器友好用 REST + JSON |
| 接口响应慢怎么排查? | traceId 串链路 → SkyWalking 看哪一跳慢 → 慢 SQL / GC / 锁竞争逐个排除 |
结尾:一张速记卡 + 三句大实话
考前 3 分钟,扫一眼这个六字诀:
text
╔══════════════════════════════════════════════════════╗
║  API 接口设计 · 六字诀                                 ║
╠══════════════════════════════════════════════════════╣
║  契  → 契约先行:OpenAPI 文档即代码                     ║
║  路  → 资源路由:RESTful 名词复数 + /v1 版本            ║
║  核  → 参数校验:DTO + @Valid,脏参数不进 Service       ║
║  安  → 安全防护:JWT + 签名 + 加密 + 防重放(四防线)   ║
║  幂  → 幂等一致:Token / 唯一索引 / 状态机             ║
║  观  → 可观测演进:TraceID + 监控 + 版本兼容            ║
╚══════════════════════════════════════════════════════╝
如果这篇文章对你有帮助,点个「赞」和「在看」,也可以关注我的公众号,后面会持续更新这个「场景设计题」系列------分布式事务、秒杀系统、短链设计都在排队了。
最后分享三句我压箱底的大实话:
- 好的 API 设计,本质是在设计一个不可信网络下的可靠契约------对外友好、对内可控;
- 幂等必须有兜底且异常要放锁,任何变更都要向后兼容------这两条是我用线上事故换来的;
- 落地建议:别想着一步到位,先把统一返回体 + 全局异常 + 幂等注解这三件套接入你们项目,一晚上就能搞定,收益立竿见影。
互动时间:你们项目里的接口幂等是怎么做的?是 Redis 拦截、唯一索引,还是压根没做靠运气?有没有被重复请求坑过的经历?评论区聊聊,我挨个回。